KPI-Monitoring-Dashboard: Design und Implementierung
|
6
min. Lesezeit

Die meisten Ratschläge zu einem KPI-Monitoring-Dashboard setzen an der falschen Stelle an. Teams feilen an Diagrammstilen, Farbpaletten und Layout-Rastern und wundern sich dann, wenn Stakeholder den Zahlen nicht mehr vertrauen. In Unternehmensumgebungen scheitern Dashboards meist nicht, weil sie schlecht aussehen, sondern weil sich die darunterliegenden Daten in ihrer Struktur verändern, veralten oder von der fachlichen Definition abweichen, von der alle ausgegangen sind.
Ein Dashboard kann optisch sauber und operativ gefährlich zugleich sein. Wenn ein Finanzteam, ein CRM-Workflow und ein Marketingmodell dieselbe KPI jeweils unterschiedlich berechnen, kann das Diagramm poliert wirken, während die Entscheidung, die es stützen soll, bereits kompromittiert ist. Deshalb beginnt verlässliches Monitoring mit Vertrauen, nicht mit Dekoration, und deshalb verhalten sich die stärksten Dashboards weniger wie Scorecards und mehr wie Kontrollsysteme.
Inhaltsverzeichnis
Warum die meisten KPI-Monitoring-Dashboards scheitern
Das häufigste Fehlermuster ist simpel. Teams bauen ein Dashboard, das vollständig aussieht, und nehmen dann an, dass die bloße Existenz von Diagrammen eine stabile zugrunde liegende Metrik bedeutet. Tatsächlich wird ein KPI-Monitoring-Dashboard oft in dem Moment fragil, in dem sich Upstream-Daten verschieben, eine Transformation geändert wird oder eine Geschäftsregel umgeschrieben wird, ohne dass jemand die Definitionsebene aktualisiert.
Eine hübsche Ansicht kann tiefe operative Probleme verbergen. Eines der deutlichsten Beispiele ist die Lücke zwischen dem, was Nutzer sehen, und dem, was die Datenpipeline tatsächlich tut. Wird das Dashboard aus einem nächtlichen Reload-Zyklus mit aufbewahrter Historie gespeist, wie im öffentlichen KPI-Leitfaden des Los Angeles County, agiert es bereits als operatives System und nicht als statischer Bericht, denn sein Wert entsteht aus Kontinuität, Historie und kontrollierter Aktualisierung, nicht allein aus der Darstellung (KPI-Dashboard-Benutzerhandbuch des Los Angeles County).
Stille Drift zerstört Vertrauen
Stille Drift ist schlimmer als ein kaputtes Diagramm, weil sie sich nicht bemerkbar macht. Ein Diagramm mit fehlenden Daten wirkt verdächtig, doch ein Diagramm mit leicht falscher Logik sieht oft normal genug aus, um jede Prüfung zu bestehen. Genau das ist die Gefahr in Unternehmensumgebungen, besonders wenn verschiedene Teams dieselbe KPI aus unterschiedlichen Quellsystemen berechnen.
Vertrauen stirbt lange bevor das Diagramm kaputt aussieht.
Die praktische Antwort besteht darin, das Dashboard als überwachtes Produkt zu behandeln, nicht als statisches Artefakt. Das bedeutet, Eingangsdaten, Definition und Nutzungsmuster gemeinsam im Blick zu behalten. Die Nutzung zählt, weil der Wert eines Dashboards oft daran gemessen wird, ob die vorgesehenen Nutzer es über einen definierten Zeitraum öffnen. Leitfäden zur Adoption erfassen typischerweise wöchentlich aktive Betrachter, die Wiederkehrrate über mehrere Wochen, das Exportvolumen und wie oft das Dashboard in Business Reviews zitiert wird (Leitfaden zur Dashboard-Adoption).
Ein Dashboard, zu dem niemand zurückkehrt, sagt Ihnen meist etwas. Entweder sind die Daten veraltet, die Definitionen verwirrend oder das Layout versteckt das Signal hinter zu viel Rauschen. Als praxisnahe Qualitätsperspektive eignet sich der interne Beitrag warum Datenprobleme immer wieder Konflikte verursachen und wie sich die Datenqualität verbessern lässt, denn Konflikte über Daten sind oft in Wahrheit Konflikte über Vertrauen, Verantwortung oder Lineage.
Metriken auswählen, die echtes Handeln auslösen
Ein Dashboard voller Vanity-Metriken ist schlimmer als ein leerer Bildschirm. Es erzeugt die Illusion von Kontrolle und lässt die Verantwortlichen ohne jeden Hebel zurück. Wählen Sie KPIs, die sich einer geschäftlichen Konsequenz, einem Schwellenwert und einem namentlich benannten Owner zuordnen lassen.
Beginnen Sie mit der Entscheidung, nicht mit dem Diagramm. Fragen Sie, welche Maßnahme folgen soll, wenn sich die KPI bewegt, wer sie ergreifen soll und wie groß die Veränderung sein muss, bevor sie Aufmerksamkeit verdient. Sind diese drei Antworten unklar, gehört die Metrik in einen Bericht, nicht in ein Monitoring-Dashboard.

Die Metrik um die Entscheidung herum aufbauen
Eine nützliche KPI leistet drei Dinge. Sie bildet ein Geschäftsergebnis ab statt bloßer Aktivität. Sie hat einen Warnbereich und einen kritischen Bereich. Und sie hat einen menschlichen Owner, der handeln kann, wenn die Metrik eine Grenze überschreitet.
Diese Struktur entspricht praxisnahen Empfehlungen für Management by Exception, bei dem jede KPI einen Zielwert, einen Warnschwellenwert und einen kritischen Schwellenwert hat. Zudem spricht sie dafür, die Hauptansicht auf etwa 5 bis 10 KPIs zu beschränken, damit das Dashboard nicht zu einem visuellen Rückstau wird (Best Practices für KPI-Dashboards von Domo). Es geht nicht darum, Informationen zu minimieren. Es geht darum, Aufmerksamkeit für die Anomalien freizuhalten, die Handeln verdienen.
Praxisregel: Wenn eine Metrik keine Reaktion auslöst, ist sie keine Monitoring-KPI, sondern ein Referenzwert.
OKRs und KPIs erfüllen unterschiedliche Aufgaben. Ein OKR beschreibt eine Richtung oder ein Ziel. Eine KPI prüft, ob sich das System wie erwartet verhält. Der Leitfaden für Führungskräfte zu OKR vs. KPI hilft Teams, Ambition und operative Kontrolle auseinanderzuhalten.
Verantwortung ist ebenso wichtig wie die Metrik selbst. Leitfäden für Echtzeit-KPI-Dashboards empfehlen statische Grenzwerte, die an die geschäftliche Auswirkung gekoppelt sind, sowie einen verantwortlichen Owner, damit ein Rückgang zur Eskalation führt statt zu passiver Beobachtung (Leitfaden für Echtzeit-KPI-Dashboards). Wird ein Schwellenwert überschritten und niemand weiß, wer für die Reaktion zuständig ist, dokumentiert das Dashboard nur das Versagen.
Für Teams, die neben dem Monitoring auch ein Qualitätsreporting aufbauen, ist der Ansatz von digna für Data-Quality-Reporting hilfreich, weil er strukturierte Belege über lose Interpretation stellt. Das ist entscheidend, wenn die KPI Audit, Finanzen oder regulierte Prozesse betrifft.
Layouts für Management by Exception gestalten
Die stärksten Dashboards bleiben ruhig, bis sich etwas ändert. Stabile Metriken sollten im Hintergrund bleiben, und das Layout sollte die Aufmerksamkeit auf die wenigen Signale lenken, die Handeln erfordern. Dieser Ansatz passt zur Arbeitsweise von Operations-Teams: kurze Sitzungen, hoher Druck, wenig Toleranz für Rauschen.
Management by Exception funktioniert, weil niemand fünfzig Anzeigen überfliegen und ihnen gleiches Gewicht beimessen kann. Das Layout muss die Signale priorisieren, bevor der Nutzer sie sieht. Klare Schwellenwerte, zurückgenommene stabile Metriken und ein einziger, eindeutiger Fehlerzustand übernehmen diese Arbeit für den Betrachter.

Für selektive Aufmerksamkeit gestalten
Platzieren Sie nur die operativ wichtigsten Indikatoren in der Hauptansicht und verschieben Sie unterstützende Diagnosen tiefer nach unten. So wird das Dashboard nicht zu einer Wand gleichgewichteter Kacheln, auf der nichts heraussticht.
Alert Fatigue ist der Zielkonflikt, den Sie im Auge behalten müssen. Wird jede Metrik als Notfall behandelt, wird keine mehr gehört. Warn- und Paging-Schwellenwerte geben dem Signal Bedeutung, wenn ein Alert tatsächlich auslöst, und das Team reagiert sorgfältiger, weil die Eskalation spezifisch ist.
Ein gutes Layout macht auch Stabilität sichtbar. Bleibt eine KPI innerhalb ihres Zielkorridors, ist das eine nützliche Information, denn sie zeigt dem Team, wo es keine Zeit investieren muss. Leitfäden für Unternehmen formulieren denselben Punkt auf andere Weise: Versteckte Definitionen, veraltete Aktualisierungen und fehlende Verantwortlichkeiten sind typische Fehlerquellen in einer überfüllten Hauptansicht (Best Practices für KPI-Dashboards von Domo).
Eine praxistaugliche Struktur gliedert die Ansicht nach Dringlichkeit.
Obere Ebene: die KPIs, die sofort geprüft werden müssen, wenn sie einen Schwellenwert überschreiten.
Mittlere Ebene: Trendkontext und unterstützende Vergleiche.
Untere Ebene: Drill-downs, Lineage und Diagnose.
Diese Hierarchie harmoniert gut mit internen Qualitäts-Workflows, besonders wenn ein Team die Data-Quality-Dashboards von digna als Diagnoseebene unter den fachlichen Metriken nutzt. Das Dashboard wird dann zum Einstieg in die Analyse statt zur Sackgasse.
Alerting und Data-Observability-Kontrollen implementieren
Eine KPI ist nur so verlässlich wie die Pipeline, die sie speist. Deshalb muss Alerting unterhalb der Business-Ebene ansetzen, wo sich Aktualität, Schema, Volumen und Null-Raten prüfen lassen, bevor fehlerhafte Daten ein Management-Dashboard erreichen. Sind diese Kontrollen etabliert, hört der Monitoring-Stack auf, reaktives Theater zu sein, und beginnt, wie ein Incident-System zu arbeiten.
Das stärkste Muster, das ich gesehen habe, ist eine Kontrollkette, die den Daten durch jede Stufe folgt. Zuerst werden die Pipeline-Stufen aufgelistet. Dann werden die Fehlerarten definiert, etwa fehlende Dateien, Duplikate, Schema Drift oder veraltete Ladevorgänge. Anschließend werden die Prüfungen als ausführbare Abfragen kodiert und die Ergebnisse gespeichert, sodass jeder Lauf einen historischen Datensatz hinterlässt.
Prüfungen in Belege für Incidents verwandeln
Historische Prüfergebnisse sind wichtig, weil Teams damit Trendverläufe sehen und nicht nur einzelne Fehler. Ein einmaliger Alert sagt Ihnen, dass heute etwas kaputtgegangen ist. Eine gespeicherte Historie zeigt, ob das Problem wiederkehrt, sich ausweitet oder zwischen Stufen wandert. Das ist eine weit bessere Grundlage für Eskalationen.
Die Observability-Ebene sollte sich zudem direkt auf bekannte Kontrollsäulen abbilden lassen. Data Observability wird üblicherweise nach Aktualität, Verteilung, Volumen, Schema und Lineage gegliedert. Diese Säulen entsprechen Aktualitätsprüfungen, Anomalieerkennung, Vollständigkeitsprüfungen, der Erkennung struktureller Änderungen und der Herkunftsverfolgung (Säulen der Data Observability). In der Praxis lassen sich diese Säulen leichter steuern, wenn die Prüfungen explizit sind und Ownern zugeordnet werden.
Ein gutes Kontrollset ist spezifisch. Empfehlungen zum Data-Quality-Monitoring sehen Prüfungen auf Aktualität, Zeilenvolumen, Schema Drift, Nullwerte in Pflichtspalten, Eindeutigkeit von Primärschlüsseln sowie zulässige Werte oder Wertebereiche vor – ausgeführt bei der Ingestion, nach der Transformation und erneut an der Serving-Tabelle, mit blockierenden Prüfungen bei jeder Ausführung und täglichen Abgleichsjobs (Best Practices für Datenqualität). Genau diese Denkweise passt auch zu KPI-Systemen, denn das Dashboard sollte nie der erste Ort sein, an dem fehlerhafte Daten sichtbar werden.
Leiten Sie jeden Befund an einen namentlich benannten Owner weiter. Wenn niemand verantwortlich ist, wird der Alert zu Rauschen.
Schema-Monitoring verdient eine gesonderte Betrachtung, denn strukturelle Änderungen können nachgelagerte Logik zerstören, selbst wenn die Zeilenzahlen unauffällig aussehen. Forschung zu Observability-Systemen beschreibt Alerts, die auslösen, sobald sich Metadaten in Quelltabellen ändern, sodass hinzugefügte, entfernte oder geänderte Strukturen erkannt werden, bevor Reporting-Annahmen brechen (Forschung zum Monitoring von Schemaänderungen). Diese Kontrolle ist besonders wichtig in Finanzwesen, Gesundheitswesen, Telekommunikation und öffentlichem Sektor, wo die Kosten eines stillen Reportingfehlers weit höher sind als die Kosten einer lauten Prüfung.
Eine praxisnahe interne Referenz für diese Ebene ist die Data Observability von digna, denn diese Kategorie vereint Aktualität, Validierung, Anomalieerkennung und Schema-Tracking in einer operativen Ansicht.
Ansichten für unterschiedliche Stakeholder-Teams zuschneiden
Ein einziges Dashboard passt selten zu allen Stakeholdern. Data Engineers brauchen Fehlersignale, Analysten brauchen Kontext, und Führungskräfte brauchen eine kompakte Ansicht, die Entscheidungen unterstützt, ohne dass sie sich durch Pipeline-Rauschen kämpfen müssen. Wer allen drei Gruppen denselben Bildschirm gibt, sorgt dafür, dass technischen Nutzern die nötigen Details fehlen und fachliche Nutzer in überflüssigen Informationen untergehen.
Das bessere Muster ist eine einzige gesteuerte Metrikebene mit rollenspezifischen Ansichten darüber. So bleiben die KPI-Definitionen einheitlich, während jedes Team genau den Detailgrad sieht, auf dessen Basis es handeln kann.
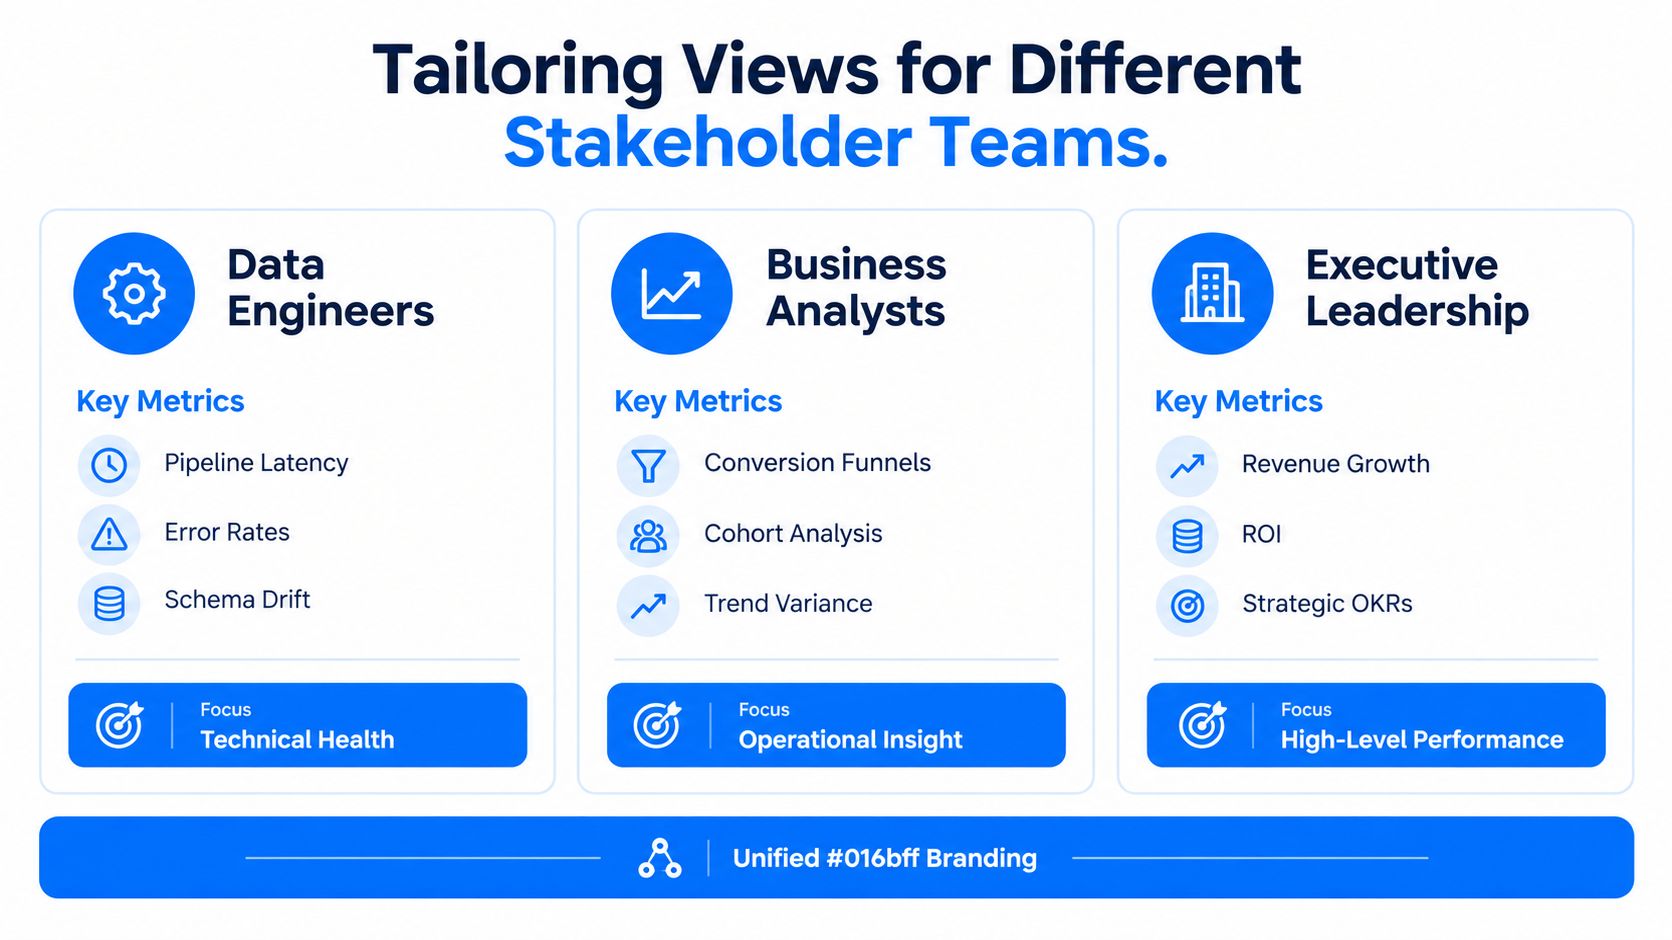
Engineer, Analyst, Führungskraft
Data Engineers brauchen technische Health-Signale. Sie müssen sehen, ob Ladevorgänge verspätet sind, Schemas sich geändert haben, Prüfungen fehlschlagen oder eine Lineage-Annahme gebrochen ist. Ihre Ansicht sollte die Pipeline offenlegen, nicht nur das fachliche Ergebnis. Ist die ausgelieferte Metrik falsch, brauchen sie einen schnellen Weg zurück zur Quelle.
Business-Analysten brauchen Kontext, den sie erklären können. Trends, Abweichungen und operative Muster sind wichtig, eine Wand aus Infrastruktur-Rauschen dagegen nicht. Sie brauchen genug Lineage- und Definitionsdetails, um zu erklären, warum sich die KPI bewegt hat, ohne die Metrik von Grund auf rekonstruieren zu müssen.
Führungskräfte brauchen ein kompaktes Leistungsbild. Sie wollen eine kleine Auswahl an Indikatoren, die zeigt, ob das Geschäft auf Kurs ist, abdriftet oder unter Druck steht. Exportieren sie die Zusammenfassung in Folien und bauen sie anderswo neu auf, trägt die Management-Ansicht die Entscheidung nicht.
Rollenspezifische Nutzung ist ein besseres Signal als pauschale Zugriffszahlen. Wird die Engineering-Ansicht bei Incidents ignoriert, exportieren Analysten ständig eine bereinigte Metrik in Tabellenkalkulationen oder umgehen Führungskräfte das Dashboard zugunsten einer separaten Zusammenfassung, dann erfüllt die Ansicht nicht die Aufgabe, für die sie gedacht ist.
Eine sinnvolle Struktur für die Ansichten ist einfach.
Engineers: Pipeline-Latenz, Schema Drift, fehlgeschlagene Prüfungen, Lineage-Brüche.
Analysten: Trendabweichungen, Kohortenmuster, Metrikkontext, Erklärung von Ausnahmen.
Führungskräfte: eine knappe Zusammenfassung der geschäftlichen Lage mit klarem Schwellenwertstatus.
Eine praxisnahe Referenz für den Aufbau eines solchen rollenbasierten Setups ist Self-Service Analytics von digna. Self-Service funktioniert nur, wenn die gesteuerte Ebene darunter vertrauenswürdig genug ist, dass verschiedene Nutzer daraus schöpfen können, ohne die Metrik in ihrer eigenen Tabellenkalkulation nachzubauen.
Metrik-Governance und semantische Integrität sichern
Das gefährlichste Dashboard ist das, das richtig aussieht und dabei das Falsche berechnet. Das passiert, wenn KPI-Definitionen zwischen Finanz-, Marketing-, CRM- oder operativen Systemen auseinanderdriften und niemand fortlaufend prüft, ob dasselbe Label noch dieselbe Berechnung bedeutet. Ab diesem Punkt ist das Diagramm keine Single Source of Truth mehr, sondern eine Quelle der Verwirrung.
Metrik-Governance ist die fehlende Ebene in vielen Dashboard-Programmen. Teams stecken oft ihre gesamte Energie in Layout und Schwellenwerte und lassen die semantische Ebene unüberwacht. So entsteht eine Lücke, in der eine KPI optisch stabil bleiben kann, während sich die zugrunde liegende Logik ändert – genau so schleichen sich Audit- und Entscheidungsrisiken ein.
Die Definition steuern, nicht nur die Darstellung
Eine ernsthafte Monitoring-Strategie braucht einen Weg, Definitionsdrift zu erkennen. Das bedeutet, Streitigkeiten über die maßgebliche Datenquelle, veraltete Daten, Änderungen an Upstream-Transformationen und Abweichungen in der Geschäftslogik zu verfolgen, bevor sie sich über Berichte ausbreiten. Das ist besonders in regulierten Umgebungen wichtig, wo inkonsistente KPI-Logik Compliance-Probleme verursachen kann, lange bevor ein visueller Trend verdächtig wirkt.
Der praktische Schritt besteht darin, Metrikdefinitionen wie Produktions-Assets zu behandeln. Versionieren Sie sie, dokumentieren Sie sie und achten Sie darauf, wann ein nachgelagerter Konsument nicht mehr mit der maßgeblichen Berechnung übereinstimmt. Das ist kein Visualisierungsproblem, sondern ein Problem der semantischen Integrität.
Unabhängige Leitfäden haben bereits vor widersprüchlichen Metriken, Streitigkeiten über die maßgebliche Datenquelle, veralteten Daten und fehlendem operativem Kontext gewarnt. Das führt zum selben Schluss: Das tiefere Problem ist Governance, nicht der Rahmen des Dashboards. Für Unternehmen ist das Risiko größer, weil verschiedene Teams dieselbe KPI aus unterschiedlichen Systemen beziehen und oft erst bemerken, dass sie sich widersprechen, wenn ein Business Review oder ein Audit es aufdeckt. Ein nützlicher interner Anker zu diesem Thema ist der dbt Semantic Layer bei digna, denn im Semantic Layer entscheidet sich, ob konsistente Definitionen zusammenhalten oder auseinanderfallen.
Der praktische Standard ist einfach.
Definieren Sie die KPI einmal.
Verfolgen Sie, wo sie wiederverwendet wird.
Lösen Sie einen Alert aus, wenn sich ihre Bedeutung ändert.
Dokumentieren Sie den Owner, der die Änderung freigibt.
Ist diese Disziplin etabliert, wird das Dashboard glaubwürdig genug für den operativen Einsatz. Ohne sie ist selbst die sauberste Oberfläche nur eine sehr polierte Art, Mehrdeutigkeit zu verbreiten.
Wenn Sie ein KPI-Monitoring-Dashboard aufbauen möchten, das stille Drift erkennt und nicht nur hübsche Diagramme liefert, arbeiten Sie mit digna. Die Data-Quality- und Observability-Funktionen von digna helfen Teams, Aktualität, Validierung, Schemaänderungen und Geschäftsmetriken in ihrer eigenen Umgebung zu überwachen. Besuchen Sie digna, um zu sehen, wie es sich in einen gesteuerten Monitoring-Stack einfügt.
Wenn die KPIs auf dem Dashboard Geschäftsmetriken wie Umsatz, Bestellungen oder Transaktionszahlen sind, lässt sich dieselbe Ausnahmelogik direkt auf die Metriken selbst anwenden: das Business Monitoring von digna lernt das normale Muster jeder Metrik und meldet eine Verschiebung, bevor sie die Management-Ansicht erreicht.
Häufig gestellte Fragen
Wie viele KPIs sollte ein KPI-Monitoring-Dashboard zeigen?
Beschränken Sie die Hauptansicht auf etwa 5 bis 10 KPIs. Jede davon sollte einen Zielwert, einen Warnschwellenwert, einen kritischen Schwellenwert und einen namentlich benannten Owner haben. Unterstützende Trends und Diagnosen gehören in tiefere Ebenen, damit die wenigen Signale, die Handeln erfordern, nicht zwischen gleichgewichteten Kacheln untergehen.
Warum verlieren Nutzer das Vertrauen in KPI-Dashboards?
Meist nicht, weil die Diagramme schlecht aussehen. Vertrauen schwindet, wenn Daten veralten, sich Schemas im Upstream ändern oder Teams dieselbe KPI in Finanz-, CRM- und Marketingsystemen unterschiedlich berechnen. Stille Drift ist die eigentliche Gefahr, denn eine leicht falsche Zahl sieht immer noch normal genug aus, um jede Prüfung zu bestehen.
Was bedeutet Management by Exception im Dashboard-Design?
Es ist ein Layout-Ansatz, bei dem stabile Metriken optisch zurückhaltend bleiben und nur KPIs, die einen Schwellenwert überschreiten, Aufmerksamkeit auf sich ziehen. Eine obere Ebene enthält Metriken, die sofort geprüft werden müssen, eine mittlere Ebene liefert Trendkontext, und eine untere Ebene bietet Drill-downs und Lineage für die Diagnose.
Welche Datenprüfungen sollten laufen, bevor eine KPI das Dashboard erreicht?
Prüfen Sie Aktualität, Zeilenvolumen, Schema Drift, Nullwerte in Pflichtspalten, Eindeutigkeit von Primärschlüsseln und zulässige Wertebereiche. Führen Sie die Prüfungen bei der Ingestion, nach der Transformation und erneut an der Serving-Tabelle aus, und speichern Sie jedes Ergebnis, damit wiederkehrende oder wachsende Probleme im Zeitverlauf sichtbar werden.
Wie verhindert man, dass eine KPI-Definition zwischen Teams auseinanderdriftet?
Behandeln Sie Metrikdefinitionen als Produktions-Assets. Definieren Sie jede KPI einmal, versionieren und dokumentieren Sie sie, verfolgen Sie jede Stelle, an der sie wiederverwendet wird, und lösen Sie einen Alert aus, wenn eine nachgelagerte Berechnung nicht mehr mit der maßgeblichen übereinstimmt. Ein namentlich benannter Owner sollte jede Änderung an der Definition freigeben.


