Zeilen in einer Datei zählen: schnelle Methoden für jedes Betriebssystem
|
5
min. Lesezeit

Sie blicken auf eine Logdatei, einen CSV-Export oder eine Pipeline-Eingabe, und die Zählung weicht um eins ab. Im Editor sieht die Datei einwandfrei aus, doch das Skript behauptet etwas anderes – und diese winzige Abweichung kann einen Ladevorgang, eine Validierungsprüfung oder ein Deployment-Gate zum Scheitern bringen.
Die Ursache ist meist kein defektes Tool, sondern ein Definitionsproblem. Zeilen in einer Datei zählen klingt einfach, bis Zeilenumbrüche, fehlende abschließende Zeilenumbrüche, Windows- und Unix-Konventionen sowie die Wahl der Kodierung verändern, was „eine Zeile“ überhaupt bedeutet.
Inhaltsverzeichnis
Die versteckte Falle bei einfachen Zeilenzählungen
Ein typisches Fehlermuster tritt auf, wenn eine Datenpipeline eine saubere Datensatzanzahl erwartet und dann eine Datei ohne abschließenden Zeilenumbruch eintrifft. Der Editor zeigt eine letzte Zeile an, doch die Zählung auf der Kommandozeile stimmt nicht damit überein. Diese Lücke genügt, um in einem Importjob einen Fehlalarm auszulösen oder eine Aktualitätsprüfung falsch erscheinen zu lassen.
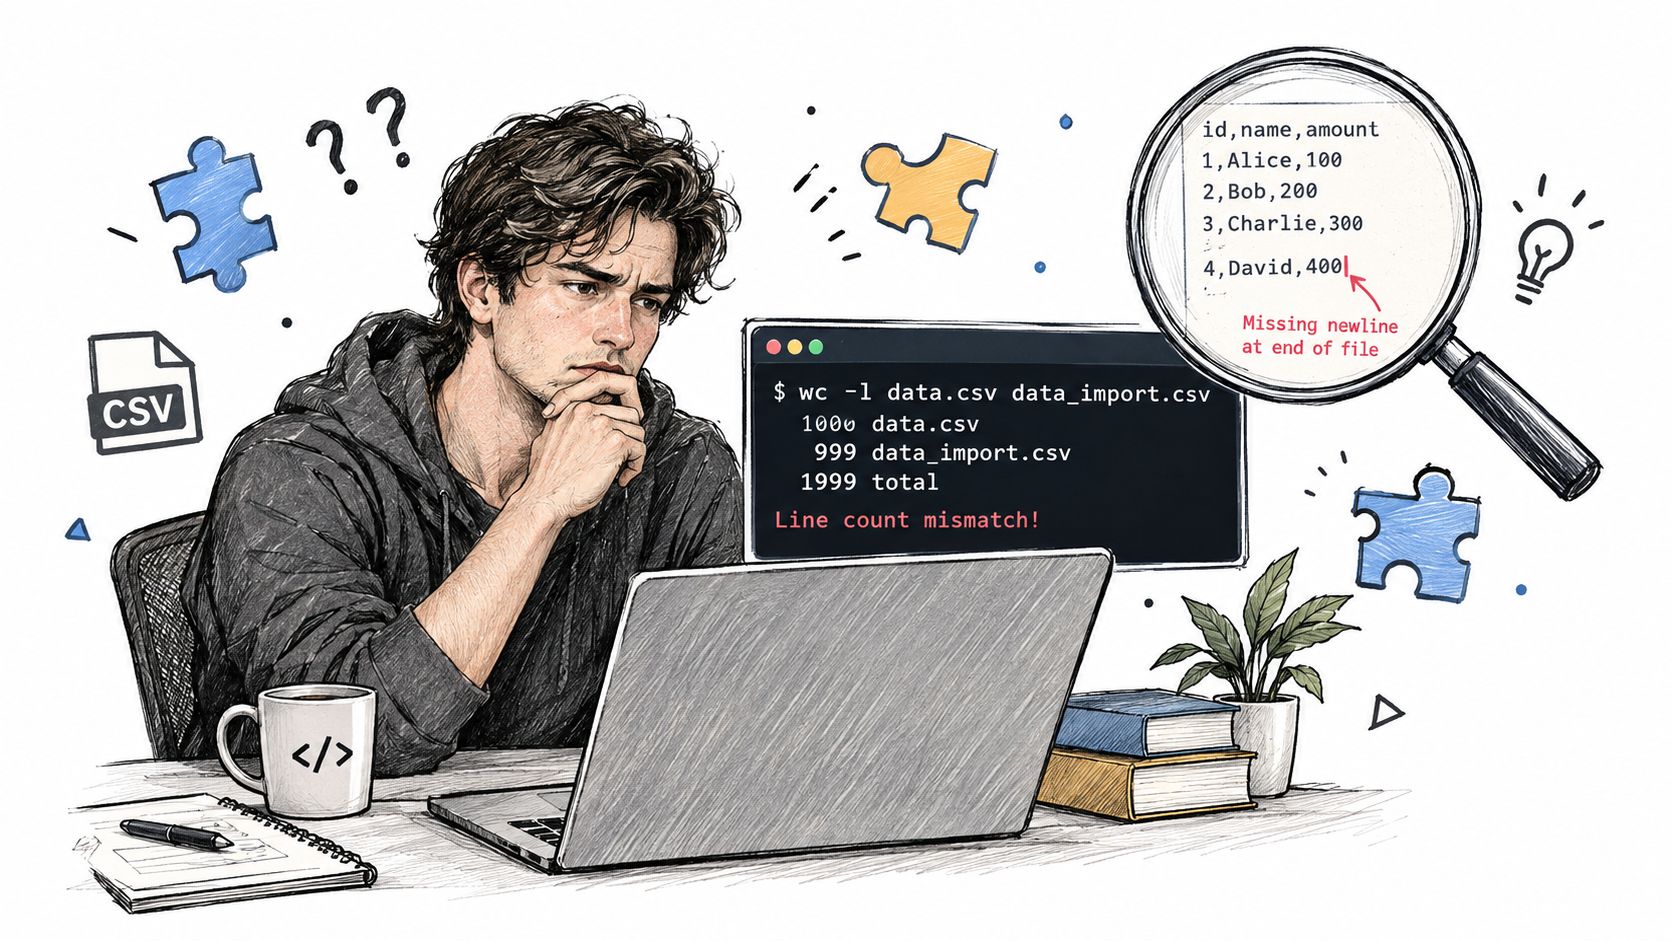
Das Kernproblem: Tools zählen häufig Zeilenumbruchzeichen, nicht das, was Menschen als sichtbare Zeilen wahrnehmen. GNU wc -l verhält sich genau so und zählt eine abschließende unvollständige Zeile nicht mit, wenn die Datei ohne Zeilenumbruch endet – eine einzeilige Datei kann in diesem Sonderfall also 0 Zeilen melden (GNU-wc-Handbuch). Genau diese semantische Unterscheidung ist der Grund, warum die Frage nicht nur lautet „Welcher Befehl ist am schnellsten?“, sondern „Was soll die Zählung bedeuten?“.
Praxisregel: Wenn die Zählung in eine Automatisierung einfließt, legen Sie vorab fest, ob es Ihnen um physische Zeilenumbrüche oder um logische Datensätze geht.
Diese Unterscheidung ist bei generierten Dateien, Logs und Feeds wichtig, die nicht von Hand bearbeitet werden. Ein Parser kann die letzte Zeile als vorhanden behandeln, obwohl ein Zeilenumbruch fehlt, während ein Shell-Zähler das möglicherweise nicht tut. In der Datenqualitätsarbeit gehört diese Abweichung in dieselbe Diskussion wie Validierungsregeln und die Vollständigkeit von Datensätzen – deshalb ist eine strukturierte Prüfung wie der Ansatz von digna für Datenvalidierung und kontinuierliche Qualität ein besseres Denkmodell als „einfach die Zeilen zählen“.
Zeilen unter Linux und macOS zählen
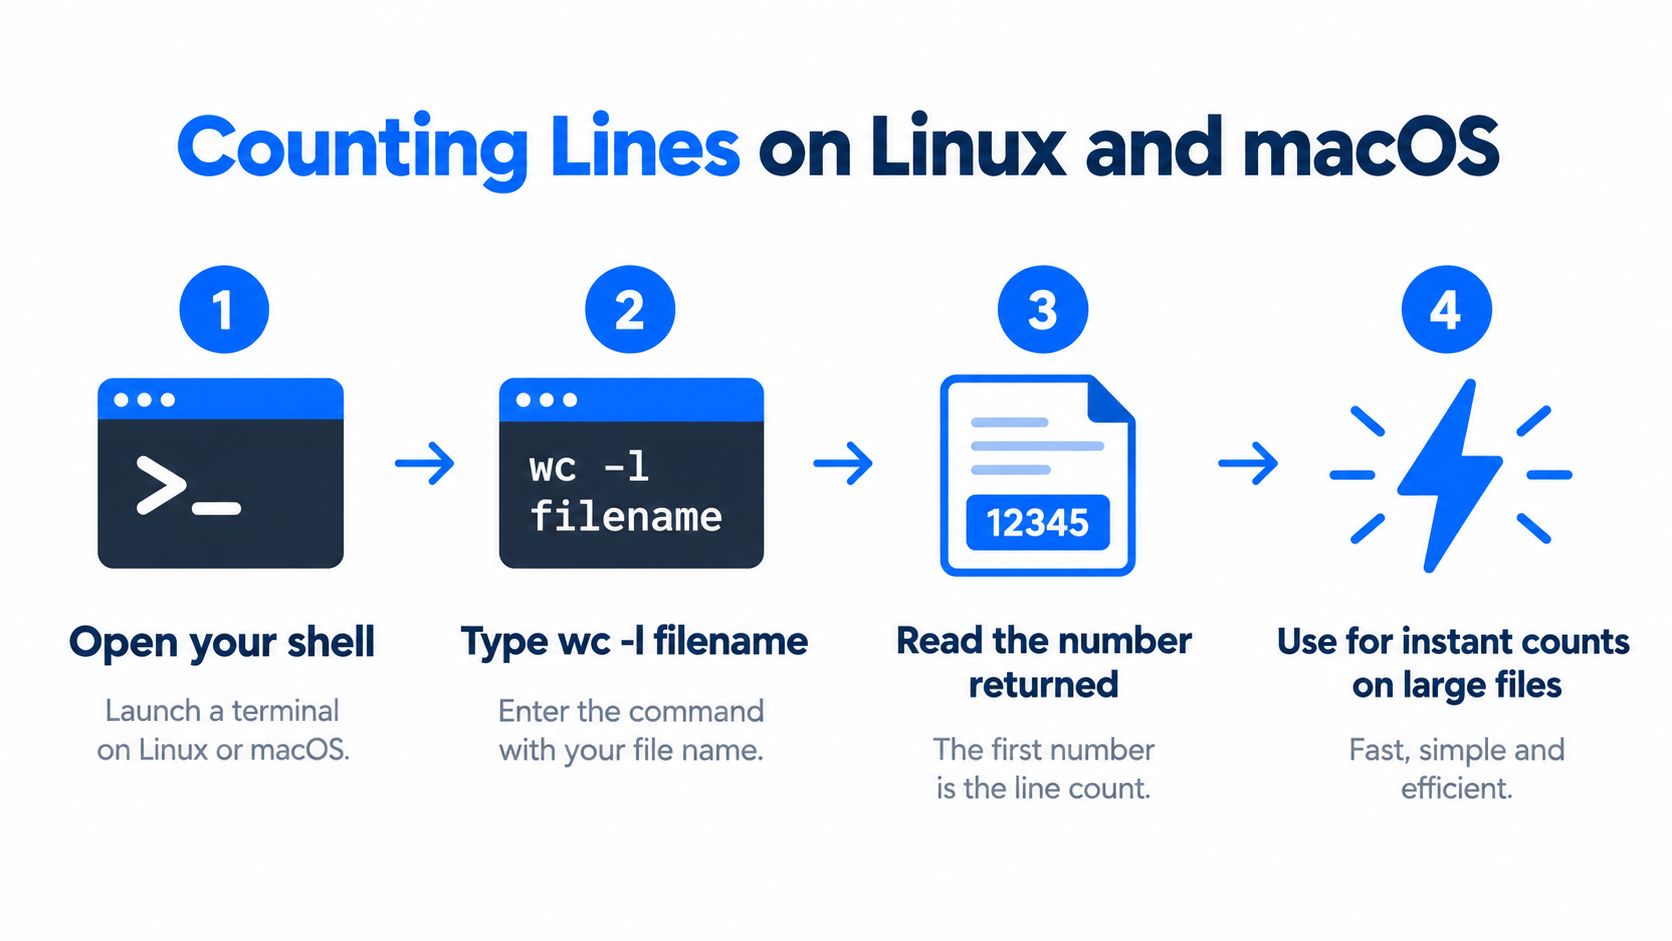
Beginnen Sie unter Linux und macOS mit wc -l. Der Befehl gehört seit Langem zur Textverarbeitung unter Unix und ist nach wie vor die schnellste Wahl für einfache Zeilenzählungen, weil er simpel, nativ in der Shell verfügbar und leicht zu skripten ist.
Die passenden Befehle
Verwenden Sie diese Variante, wenn der Dateiname in der Ausgabe erscheinen soll:
wc -l filename
Verwenden Sie diese Variante, wenn Sie nur die Zahl benötigen:
wc -l < filename
Die zweite Form eignet sich besser für Skripte, weil sie den Dateinamen unterdrückt und nur die Anzahl zurückgibt. Aktuelle Manpages definieren wc als Werkzeug, das Zeilenumbrüche, Wörter, Bytes und Zeichen zählt; bei mehreren Dateien gibt das Tool außerdem Summen aus. Die Textverarbeitungsbeispiele von Red Hat zeigen dieselbe unkomplizierte Art des Zählens in der Shell, darunter grep -c '.' /usr/share/dict/words, das 479.826 passende Zeilen zurückgibt (Textverarbeitungsbeispiele von Red Hat).
Wenn Geschwindigkeit zählt
Für einfache Gesamtzählungen ist wc -l meist die richtige Antwort, weil es Byteströme direkt durchsucht. In einem Benchmark mit einer synthetischen Datei von 110 MB / 10.000.000 Zeilen war wc -l < big.txt nach 0,13 s fertig, gegenüber 0,33 s für awk 'END{print NR}' big.txt – AWK war in diesem Test also rund 2,5× langsamer (Details zum Benchmark). Setzen Sie awk ein, wenn Sie Filter oder dateispezifische Logik benötigen. Bleiben Sie bei wc -l, wenn Sie nur die Anzahl brauchen.
Betriebliche Gewohnheit: Verwenden Sie zuerst
wc -lund wechseln Sie nur dann zu AWK, wenn die Zählung Teil einer umfassenderen Transformation ist.
Halten Sie bei Datei-Ingestion-Jobs die Zählung neben Ihren Landing-Zone-Prüfungen und der Datensatzvalidierung fest, insbesondere wenn die Daten durch die Daten-Ingestion-Pipeline von digna fließen. Ziel ist es, Mehrdeutigkeiten zu beseitigen, bevor die Datei weiter nachgelagert verarbeitet wird.
Zeilen unter Windows und in PowerShell zählen
Windows bietet Ihnen zwei praktikable Wege: PowerShell und CMD. PowerShell ist für Zeilenzählungen die sauberere Option, weil es Dateiinhalte als Objekte behandelt, während CMD weiterhin auf ältere Texttricks angewiesen ist, die zwar funktionieren, sich aber nur umständlich automatisieren lassen.
Zuerst PowerShell
Die einfache Zählung lautet:
(Get-Content "file.txt").Count
Für eine Pipeline-freundliche Ausgabe verwenden Sie:
(Get-Content "file.txt" | Measure-Object -Line).Lines
Laut PowerShell-Dokumentation gibt Get-Content Dateiinhalte standardmäßig als Array zeilenumbruchgetrennter Zeichenfolgen zurück, während -Raw die gesamte Datei als eine einzige Zeichenfolge mit erhaltenen Zeilenumbrüchen liefert; existiert das Trennzeichen nicht, kann Get-Content die gesamte Datei als ein ungetrenntes Objekt zurückgeben (PowerShell-Dokumentation zu Get-Content, Dokumentation zu PowerShell 5.1). Das ist relevant, weil sich die Zählung ändern kann, je nachdem, ob PowerShell die Datei als Sammlung von Zeilen oder als einen Textblock behandelt.
CMD, wenn es keine Alternative gibt
CMD hat kein direktes Äquivalent zu wc -l. Die übliche Behelfslösung lautet:
find /c /v "" file.txt
Die Ausgabe enthält den Dateinamen und zusätzliche Formatierung – für schnelle Prüfungen reicht das, in Skripten ist es jedoch umständlich. Wenn Sie die Anzahl in einer Automatisierung benötigen, betten Sie den Befehl in eine for /f-Schleife ein, auch wenn PowerShell weiterhin die bessere Wahl ist.
Faustregel: Verwenden Sie PowerShell für Skripte und CMD nur dann, wenn der Rechner abgeschottet ist und nichts anderes zur Verfügung steht.
Wenn Sie Windows-Automatisierungen erstellen und vor einer tiefergehenden Validierung eine einfache Qualitätsprüfung benötigen, sind Zeilenzählungen oft der erste kostengünstige Test. Eine Plattform wie digna kann hier als eine Option für Observability auf Datensatzebene dienen, weil sie das Verhalten der Zeilenanzahl über die Zeit verfolgt, statt jede Datei als Einzelfall zu behandeln.
Zeilen in großen Dateien mit Python zählen
Python eignet sich gut, wenn die Datei groß ist, die Plattform variiert oder die Zeilenzählung Teil eines größeren Jobs ist. Die Falle besteht darin, die gesamte Datei in den Arbeitsspeicher zu laden, obwohl Sie nur eine Anzahl benötigen.
Gepuffertes binäres Lesen verwenden
Öffnen Sie die Datei im Binärmodus, lesen Sie sie in Blöcken von beispielsweise 64 KiB oder mehr, zählen Sie die \n-Bytes und addieren Sie nur dann eine zusätzliche Zeile, wenn die Datei nicht leer ist und nicht mit \n endet. So vermeiden Sie zeichenweises I/O, das in jeder Sprache langsam ist. Ein C-Benchmark ergab für fgetc/fputc 5,90 s für einen Durchlauf über 150 MB, während blockweises fread/fwrite mit 65.536 Bytes 0,63 s benötigte (Notizen zum C-Benchmark) – derselbe Engpass, den die Python-Schleife durch das Lesen von 64-KiB-Blöcken vermeidet.
Warum der blockweise Ansatz überlegen ist
Der binäre Scan ist portabel, doch die Semantik bleibt entscheidend. Das Zählen von Zeilenumbrüchen misst physische Zeilenumbrüche. Windows-\r\n, fehlende abschließende Zeilenumbrüche und eingebettete Zeilenumbrüche innerhalb von Datensätzen können das Ergebnis daher verändern, wenn Sie logische Zeilen statt roher Textzeilen erwarten. Der Binärmodus von Python und bytes.count machen dieses Verhalten explizit, und die Zeilenumbruchregel ist dieselbe wie in der File::CountLines-Anleitung.
Für Pipeline-Prüfungen sind strukturierte Zeilenstatistiken oft nützlicher als einmalige Zählungen. Ein Tool, das das Verhalten der Zeilenanzahl über die Zeit überwacht, etwa der anomaliebewusste Observability-Ansatz von digna, ist dann sinnvoll, wenn ein unvollständiger Ladevorgang wichtiger ist als der genaue Befehl, mit dem er erkannt wird.
Sonderfälle und semantische Fallen
Zählen auf Byte-Ebene ist nicht universell anwendbar. Nicht ASCII-kompatible Kodierungen wie UTF-16 oder UTF-32 können naives Zeilenzählen aushebeln, und die Zeilenumbruch-Konventionen unterscheiden sich zwischen Unix und Windows. Eine Datei kann außerdem Datensätze enthalten, die im Editor vollständig aussehen, sich aber anders verhalten, sobald ein Tool die rohen Bytes liest.
GNU grep -c zählt passende Zeilen, und sein zeilenorientiertes Verhalten kann sich ändern, wenn das letzte Byte kein Zeilenumbruch ist (GNU-grep-Handbuch). Das ist in Pipelines relevant, in denen die Zählung Teil der Validierung ist und nicht nur eine schnelle Kontrolle.
Die Kodierung verändert alles
Zeichenweise Ansätze eignen sich schlecht für große Dateien. Das praktische Problem ist nicht nur die Geschwindigkeit, sondern auch die Interpretation. UTF-16 und UTF-32 speichern Text so, dass einfache Byte-Scans unzuverlässig werden – ein Tool, das nur Zeilenumbrüche im ASCII-Stil annimmt, kann daher ein falsches Ergebnis liefern.
Python gibt Ihnen hier mehr Kontrolle, doch der sicherste Ansatz hängt weiterhin vom Dateiformat und von der Art seiner Erzeugung ab. Bei strukturierter Speicherung kann die Zeilenanzahl zum Format selbst statt zur Textebene gehören – deshalb benötigen Parquet-basierte Pipelines andere Prüfungen als reine Textdateien.
Zeilenumbruch-Konventionen sind nicht austauschbar
Unix verwendet \n, Windows üblicherweise \r\n, und dieselbe Datei kann je nach Tool unterschiedlich behandelt werden. Get-Content in PowerShell gibt zeilenumbruchgetrennten Text standardmäßig als Zeichenfolgen zurück, während -Raw die Datei als eine einzige Zeichenfolge belässt – die Form der Ausgabe verändert also die Zählmethode (PowerShell-Dokumentation zu Get-Content).
Wenn Sie generierte Dateien prüfen, ist dieser Unterschied wichtiger als der Name des Befehls. Eine Zählung, die für Rohtext korrekt ist, kann für logische Datensätze falsch sein.
Genau das ist die Falle. Das Zählen in Dateien ist nur dann unkompliziert, wenn Kodierung, Zeilenumbruch-Konvention und Datensatzmodell zusammenpassen.
Die richtige Methode für Ihre Anforderungen wählen
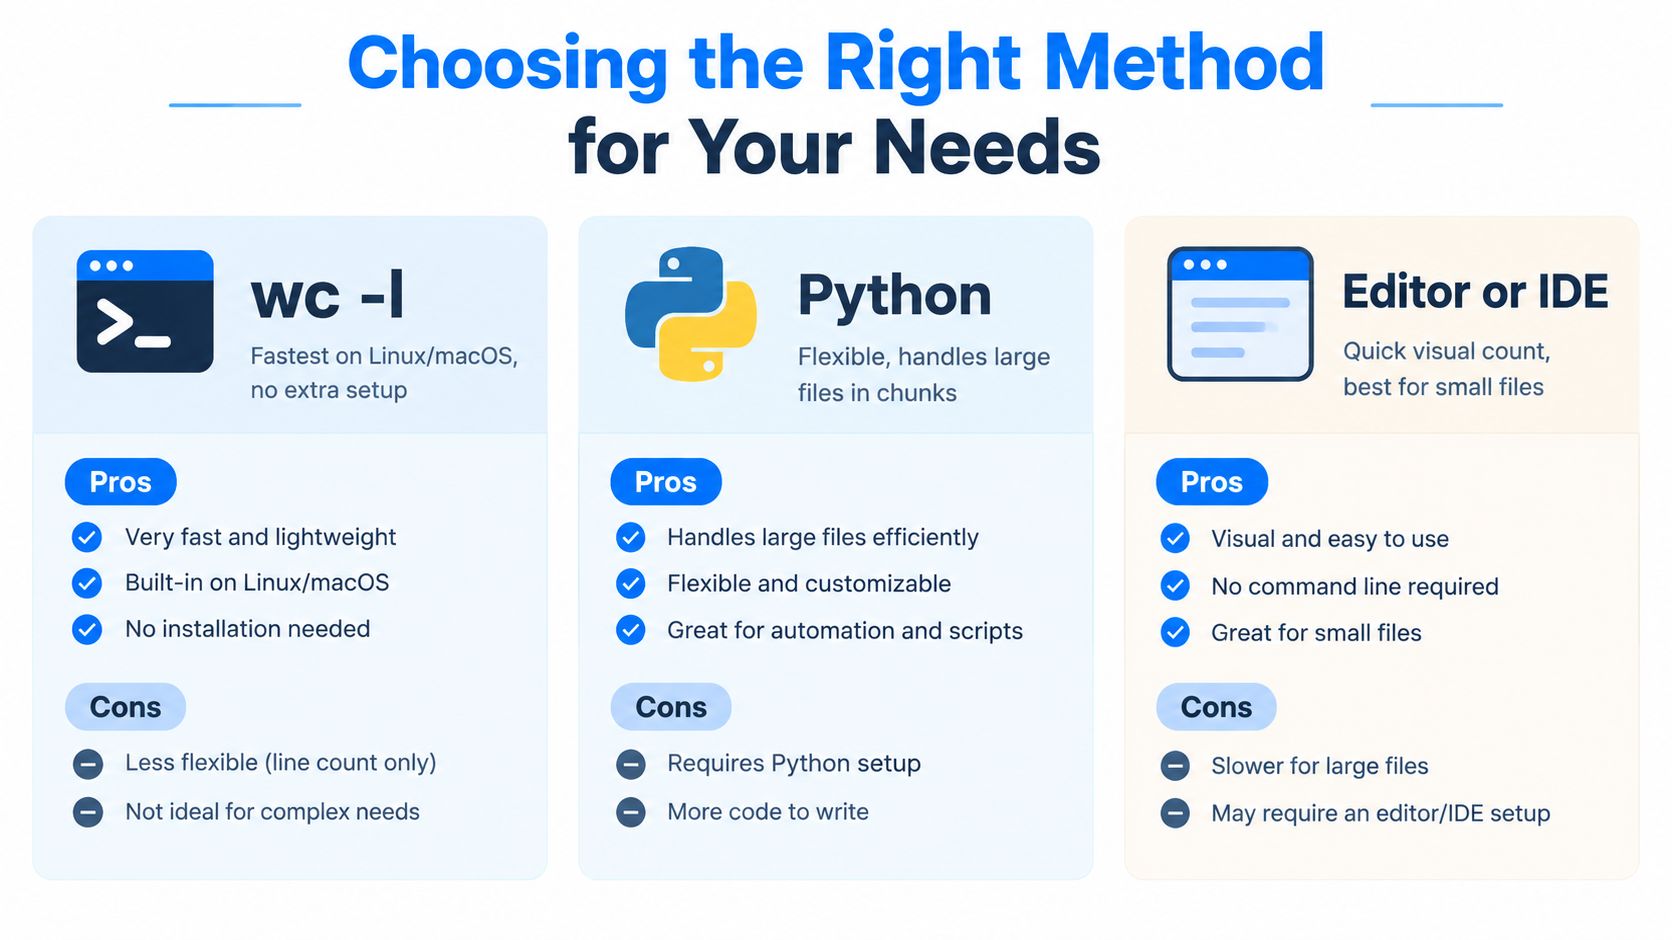
Die beste Methode ist diejenige, die zur Plattform, zur Dateigröße und zur Bedeutung der Zählung passt. Unter Linux und macOS ist wc -l der Standard für eine rohe Gesamtzahl. Unter Windows ist PowerShell die sauberere, Shell-native Wahl, und für programmatische Jobs gibt Ihnen Python Kontrolle über Pufferung und die Behandlung von Sonderfällen.
Schnelle Entscheidungshilfen
Verwenden Sie
wc -l, wenn Sie unter Linux oder macOS arbeiten und die schnellste einfache Zählung ohne zusätzliche Logik benötigen.Verwenden Sie PowerShell, wenn Sie unter Windows arbeiten und ein Ergebnis wünschen, das Sie an den Rest eines Skripts weiterleiten können.
Verwenden Sie Python, wenn die Datei groß ist, die Kodierung unsicher ist oder die Zählung eine individuelle Behandlung erfordert.
Verwenden Sie einen Editor oder eine IDE, wenn die Datei klein ist und Sie nur eine visuelle Kontrolle benötigen.
Der praktische Unterschied ist einfach: wc -l ist der schnellste Zähler für Rohdaten, PowerShell die natürlichste Shell-Option unter Windows und Python der sicherste Ausweg, wenn die Semantik wichtiger ist als Bequemlichkeit. Für Team-Workflows kann eine Data-Observability-Schicht wie die modulare Monitoring-Plattform von digna über diesen Ad-hoc-Prüfungen angesiedelt werden und Zeilenanzahlen, Anomalien und das Eintreffen von Dateien an einem Ort zusammenführen.
Wenn Sie es leid sind, Off-by-one-Problemen in Dateien im Nachhinein hinterherzulaufen, nutzen Sie digna, um die Daten hinter diesen Zählungen zu überwachen und leere oder unvollständige Ladevorgänge zu erkennen, bevor sie nachgelagerte Systeme erreichen. Besuchen Sie digna, um zu sehen, wie sich die Validierungs-, Anomalieerkennungs- und Timeliness-Prüfungen in eine produktive Datenpipeline einfügen.
Wenn eine Zeilenzählung eigentlich ein Stellvertreter dafür ist, wie viele Datensätze angekommen sind, verfolgt digna Data Anomalies das Verhalten der Zeilenanzahl in der Datenbank über die Zeit und meldet leere oder unvollständige Ladevorgänge, die ein einmaliges wc -l niemals mit der Historie vergleichen würde.
Häufig gestellte Fragen
Wie zähle ich die Zeilen in einer Datei unter Linux oder macOS?
Verwenden Sie wc -l filename, um die Anzahl zusammen mit dem Dateinamen auszugeben, oder wc -l < filename, um in Skripten nur die Zahl zurückzugeben. In einem Benchmark mit einer Datei von 10.000.000 Zeilen war wc -l nach 0,13 s fertig, awk nach 0,33 s – setzen Sie awk daher nur für Filterlogik ein.
Warum zeigt wc -l eine Zeile weniger an als mein Editor?
Weil wc -l Zeilenumbruchzeichen zählt, nicht sichtbare Zeilen. Endet eine Datei ohne abschließenden Zeilenumbruch, wird die letzte unvollständige Zeile nicht gezählt, sodass eine einzeilige Datei sogar 0 Zeilen melden kann. Legen Sie vorab fest, ob Ihre Automatisierung physische Zeilenumbrüche oder logische Datensätze benötigt.
Wie zähle ich die Zeilen in einer Datei mit PowerShell?
Führen Sie (Get-Content "file.txt").Count für eine einfache Zählung aus oder (Get-Content "file.txt" | Measure-Object -Line).Lines für eine Pipeline-freundliche Ausgabe. Get-Content gibt standardmäßig zeilenumbruchgetrennte Zeichenfolgen zurück, -Raw dagegen eine einzige Zeichenfolge – die gewählte Form bestimmt also, wie PowerShell die Zeilen der Datei sieht.
Was ist das Äquivalent zu wc -l in Windows CMD?
CMD hat kein direktes Äquivalent zu wc -l; die übliche Behelfslösung ist find /c /v "" file.txt. Die Ausgabe enthält den Dateinamen und zusätzliche Formatierung, sodass sie für schnelle Prüfungen taugt, sich aber nur umständlich automatisieren lässt, sofern sie nicht in eine for /f-Schleife eingebettet wird. Für Skripte ist PowerShell die bessere Wahl.
Wie zähle ich die Zeilen einer großen Datei mit Python am schnellsten?
Öffnen Sie die Datei im Binärmodus, lesen Sie sie in Blöcken von 64 KiB und zählen Sie die Zeilenumbruch-Bytes; addieren Sie nur dann eins, wenn die Datei nicht leer ist und kein abschließender Zeilenumbruch vorhanden ist. Blockweises Lesen vermeidet langsames zeichenweises I/O: Ein C-Benchmark benötigte blockweise 0,63 s gegenüber 5,90 s beim zeichenweisen Lesen.


