Was bedeutet föderiert bei Daten und KI?
|
5
min. Lesezeit

Föderiert bedeutet, dass die Daten an der Quelle bleiben, während gemeinsame Modelle, Richtlinien oder Abfragen über unabhängige Systeme hinweg arbeiten. In der Informatik und der Datenarbeit tauchte diese Idee früh in föderierten Datenbanken auf und später im föderierten Lernen; der rote Faden ist dabei stets derselbe: lokale Kontrolle bei koordiniertem Zugriff.
Viele sind verwirrt, weil „föderiert“ einfach klingt, aber in Verwaltung, Identitätsmanagement, Datenbanken, Governance und KI für verwandte Dinge mit sehr unterschiedlichen Zielkonflikten verwendet wird. Deshalb ist eine praxisnahe Definition wichtiger als ein Schlagwort.
Inhaltsverzeichnis
Die eigentliche Bedeutung föderierter Systeme
Föderiert bedeutet, dass separate Teile zusammenarbeiten, ohne die Zuständigkeit an eine zentrale Stelle abzugeben. In der Technologie heißt das meist, dass ein Unternehmen Daten, Identitäten oder Verarbeitung nah an der Quelle hält und diese Teile über gemeinsame Regeln, Standards oder Koordinationsschichten verbindet. Der Begriff wird bei föderierten Datenbanken seit den späten 1970er- und den 1980er-Jahren verwendet, und Ende der 1980er- bis Anfang der 1990er-Jahre galt er bereits als Weg, autonome Systeme unter Wahrung der lokalen Kontrolle in eine logische Sicht zu integrieren graphapp.ai.
Eine hilfreiche Analogie ist ein Netz lokaler Banken. Jede Bank verwaltet ihre eigenen Konten, doch alle einigen sich auf Clearing-Standards, damit Kunden Geld zwischen Instituten bewegen können, ohne dass alle Banken zu einem riesigen Hauptbuch verschmelzen. Föderation funktioniert bei Daten und KI genauso: zuerst lokale Autonomie, dann gemeinsame Regeln.
Praxisregel: Wenn das Quellsystem weiterhin für die Daten oder die Entscheidung zuständig ist und eine andere Schicht nur den Zugriff oder die Aggregation koordiniert, haben Sie es wahrscheinlich mit einem föderierten Design zu tun.
Vier Bereiche, ein verwirrendes Wort
Das Problem ist, dass sich das Wort über sehr unterschiedliche Kontexte erstreckt. Der Sprachgebrauch im Wörterbuch umfasst politische Föderation, Identitätsföderation sowie föderiertes Rechnen oder föderierte Suche, wobei Identitätsföderation speziell die Verknüpfung der Identität eines Benutzers über getrennte Systeme hinweg mittels vereinbarter Attribute und Anmelderegeln bezeichnet Merriam-Webster. Deshalb kann ein Gespräch über föderale Regierung, föderierte Anmeldung und föderierte Analytik so klingen, als rede man aneinander vorbei.
In der Praxis ist dies der nützliche Anker: Föderierte Systeme koordinieren über unabhängige Teile hinweg, ohne sie vollständig zu zentralisieren. Diese Definition passt auf föderierte Datenbanken, föderiertes Lernen und föderierte Governance, auch wenn jede davon das Muster unterschiedlich anwendet. Sie erklärt auch, warum Implementierungsdetails wichtiger sind als die Bezeichnung.
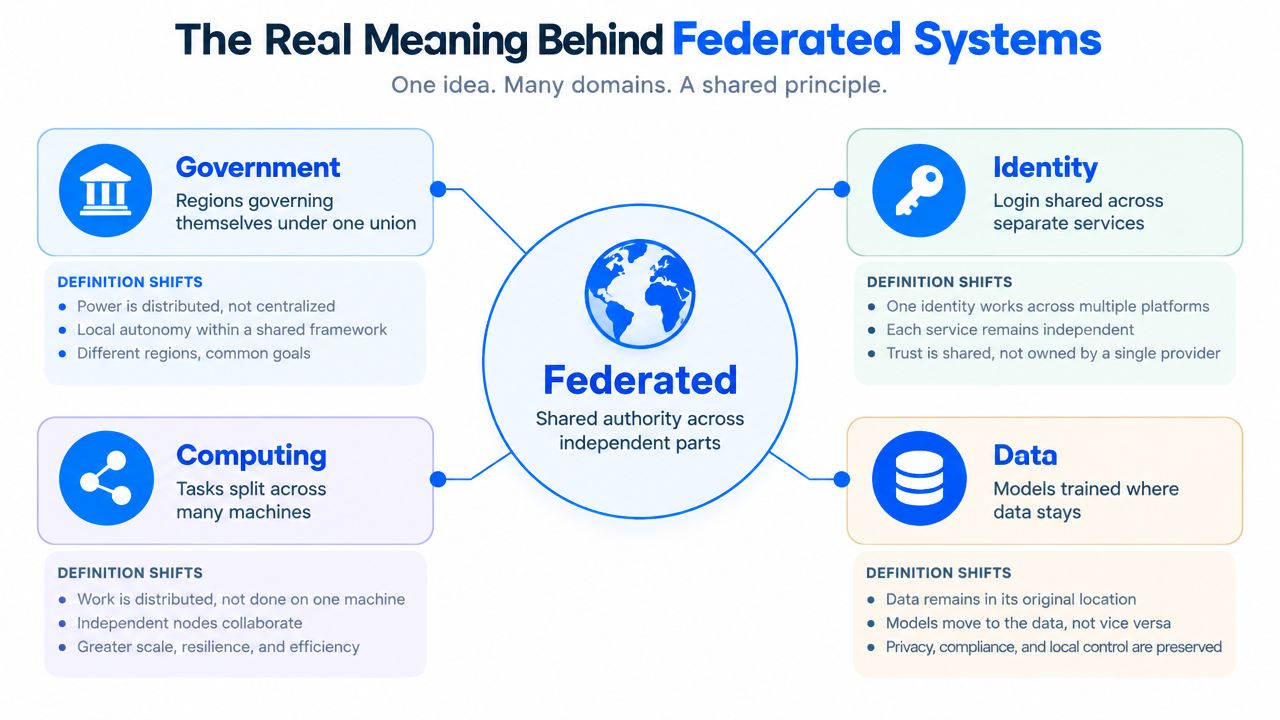
Für Teams, die moderne Datenplattformen aufbauen, wird der Zusammenhang zwischen Föderation und Architekturentscheidung deutlicher, wenn man sie mit anderen Ansätzen vergleicht. Eine fundierte Einführung in verwandte Designabwägungen bietet Data Mesh in modernen Architekturen verstehen, denn bei beiden Mustern geht es um Autonomie, Governance und gemeinsame Standards.
Zentralisierte und föderierte Datenarchitekturen im Vergleich
Eine zentralisierte Datenarchitektur führt Daten in einem gemeinsamen Warehouse oder Lake zusammen und erwartet, dass Pipelines, Modellierung und Governance dort stattfinden. Eine föderierte Architektur belässt die Daten dort, wo sie bereits liegen, und nutzt einen föderierten Server oder eine Zugriffsschicht, um Abfragen und Antworten über die Quellen hinweg zu koordinieren. IBMs Beschreibung föderierter Systeme ist bei der Funktionsweise eindeutig: Ein föderierter Server, eine oder mehrere Datenquellen und Client-Anwendungen arbeiten zusammen, sodass eine einzige SQL-Anweisung auf Daten zugreifen kann, die über mehrere Quellen verteilt sind IBM.
Der Unterschied ist nicht nur technischer Natur, er verändert auch, wer was kontrolliert. In einem zentralisierten Setup wird das Plattformteam oft zum Engpass für Integration, Standards und Zugriff. In einem föderierten Modell behalten die Domänenteams die Zuständigkeit, während das Unternehmen Interoperabilitätsregeln, Metadatenanforderungen und Sicherheitsgrenzen festlegt. Diese Verschiebung ist der Grund, warum föderierte Architekturen in regulierten Umgebungen und solchen mit mehreren Domänen zu finden sind.
Betriebliche Erkenntnis: Zentralisierte Designs optimieren auf Kontrolle und Konsolidierung, föderierte Designs auf Autonomie und kontrollierte Koordination.
Vergleich: föderierte und zentralisierte Architektur
Dimension | Zentralisiert | Föderiert |
|---|---|---|
Speicherort der Daten | In ein gemeinsames Warehouse oder einen Lake verschoben | Verbleiben in den Quellsystemen |
Zuständigkeit | Plattformteam oder zentrales Datenteam | Domänen- oder Quellteam |
Zugriffskoordination | Direkter Zugriff auf den zentralen Speicher | Abfragen werden über eine Koordinationsschicht geleitet |
Integrationsstil | Erst konsolidieren, dann nutzen | Zugriff vor Ort, Aggregation bei Bedarf |
Governance | Zentrale Durchsetzung | Gemeinsame Standards bei lokaler Umsetzung |
Ein föderierter Ansatz entstand, weil große Organisationen mit einem einzigen riesigen Pipeline-Modell an Grenzen stießen. Je mehr Teams, Systeme und Compliance-Vorgaben hinzukommen, desto teurer kann die Pflege einer einzigen Landing Zone werden und desto schwieriger lässt sie sich mit Anforderungen an die Datenresidenz in Einklang bringen. Das heißt nicht, dass Zentralisierung falsch ist – es heißt, dass sich die Abwägung verändert, sobald ein Team realistischerweise nicht mehr für jeden Datensatz und jede Richtlinie zuständig sein kann.
Wenn Sie den Unterschied aus Sicht der Datenqualität bewerten, zeigt er sich auch in den operativen Kontrollen. Dieser Vergleich der Qualitätsabwägungen zwischen föderierten und zentralisierten Datenplattformen ist hilfreich, wenn die Frage weniger lautet „Was klingt sauberer?“, sondern vielmehr „Welche Struktur können wir steuern?“.
Wie föderiertes Lernen ohne Datenbewegung funktioniert
Föderiertes Lernen ist die moderne Verwendung von föderiert, der die meisten Analytics-Teams zuerst begegnen. Dabei werden Modelle über entfernte Geräte oder isolierte Rechenzentren hinweg trainiert, während die Daten lokal bleiben; ein zentraler Server koordiniert wiederholte Trainingsrunden und aggregiert die Modellaktualisierungen der verteilten Teilnehmer arXiv-Übersichtsarbeit. Die Rohdatensätze verbleiben auf dem Smartphone, im Kliniksystem oder am Standort. Übertragen wird das Aktualisierungssignal, nicht der Datensatz.
Dieser Ablauf ist wichtig, weil er die Diskussion über Datenschutz und Compliance verändert. Statt sensible Daten in eine einzige Umgebung für die Modellentwicklung zu kopieren, lernt jeder Teilnehmer lokal und steuert nur das bei, was für die Aggregation erforderlich ist. Deshalb wird föderiertes Lernen häufig für Smartphones, Krankenhäuser und andere Umgebungen diskutiert, in denen Datenbewegungen streng kontrolliert werden.
Der praktische Ablauf
Das lokale Training beginnt auf jedem Client mit den dort bereits vorhandenen Daten.
Gesendet werden Modellaktualisierungen an einen Koordinator, nicht der rohe Datensatz.
Die Aggregation erfolgt zentral und erzeugt ein verfeinertes globales Modell.
Das aktualisierte Modell kehrt zurück für eine weitere lokale Runde.
Dieses Muster reduziert unnötige Datenbewegungen, macht den Prozess aber nicht einfach. Verschiedene Geräte können unterschiedliche Rechenkapazität, Netzwerkzuverlässigkeit oder Datenqualität aufweisen. Der Koordinationsaufwand wird Teil des Designs, und Trainingszeitpläne sind wichtiger als in einer traditionellen zentralisierten ML-Pipeline.
Faustregel: Föderiertes Lernen ist in erster Linie ein Koordinationsmodell und erst in zweiter Linie eine Datenschutzfunktion.
Die operative Seite wird noch wichtiger, wenn Teams Drift oder Modellverhalten über viele Teilnehmer hinweg überwachen möchten. Wenn Sie die Modellstabilität in einem verteilten Setup verfolgen, helfen Verfahren zur Erkennung von Modelldrift dabei, einzuordnen, welche Veränderungen Sie beobachten können, ohne so zu tun, als sei das System statisch.
Föderierte Governance-Modelle für Unternehmensdaten
Föderierte Governance ist die organisatorische Variante derselben Idee. Ein zentrales Gremium legt unternehmensweite Richtlinien, Standards und gemeinsame Kontrollen fest, während die Geschäftsbereiche diese Regeln in ihren eigenen Domänen anwenden Atlan. Diese Aufteilung ist nützlich, wenn das Unternehmen Konsistenz benötigt, die Domänen aber dennoch Spielraum brauchen, um eigene Pipelines zu betreiben, lokale Datenregeln zu definieren und domänenspezifische Ausnahmen zu verwalten.
Der entscheidende Unterschied liegt in der Entscheidungsbefugnis. Föderierte Governance bedeutet weder, dass jede Entscheidung dezentral getroffen wird, noch, dass zentrale Teams jeden Datensatz bis ins Detail steuern. Sie bedeutet, dass die Zentrale die Leitplanken definiert und die Domänen innerhalb dieser Leitplanken agieren. In der Praxis umfasst das in der Regel gemeinsame Metadaten, Sicherheitskontrollen und Qualitätsstandards sowie klare Zuständigkeiten für deren Durchsetzung.
Wo das Modell funktioniert und wo es an Grenzen stößt
Föderierte Governance passt in der Regel zu Organisationen mit mehreren Geschäftsbereichen, regulierten Daten oder komplexen Zuständigkeitslinien. Sie ist außerdem die bessere Wahl, wenn lokale Teams die Daten besser kennen, als es eine zentrale Plattformgruppe je könnte. Der Preis dafür ist Koordinationsaufwand, denn Richtlinien müssen über alle Domänen hinweg einheitlich ausgelegt und nicht nur einmal niedergeschrieben werden.
Das Modell scheitert, wenn die zentrale Richtlinienebene vage bleibt oder die Domänenteams isoliert arbeiten. Dann erhalten Sie das Schlechteste aus beiden Welten: ein zentrales Regelwerk, das niemand nutzt, und lokale Praktiken, die niemand prüfen kann. Deshalb braucht föderierte Governance gemeinsame Verantwortung und nicht nur ein Organigramm mit der Aufschrift „zentral plus lokal“.
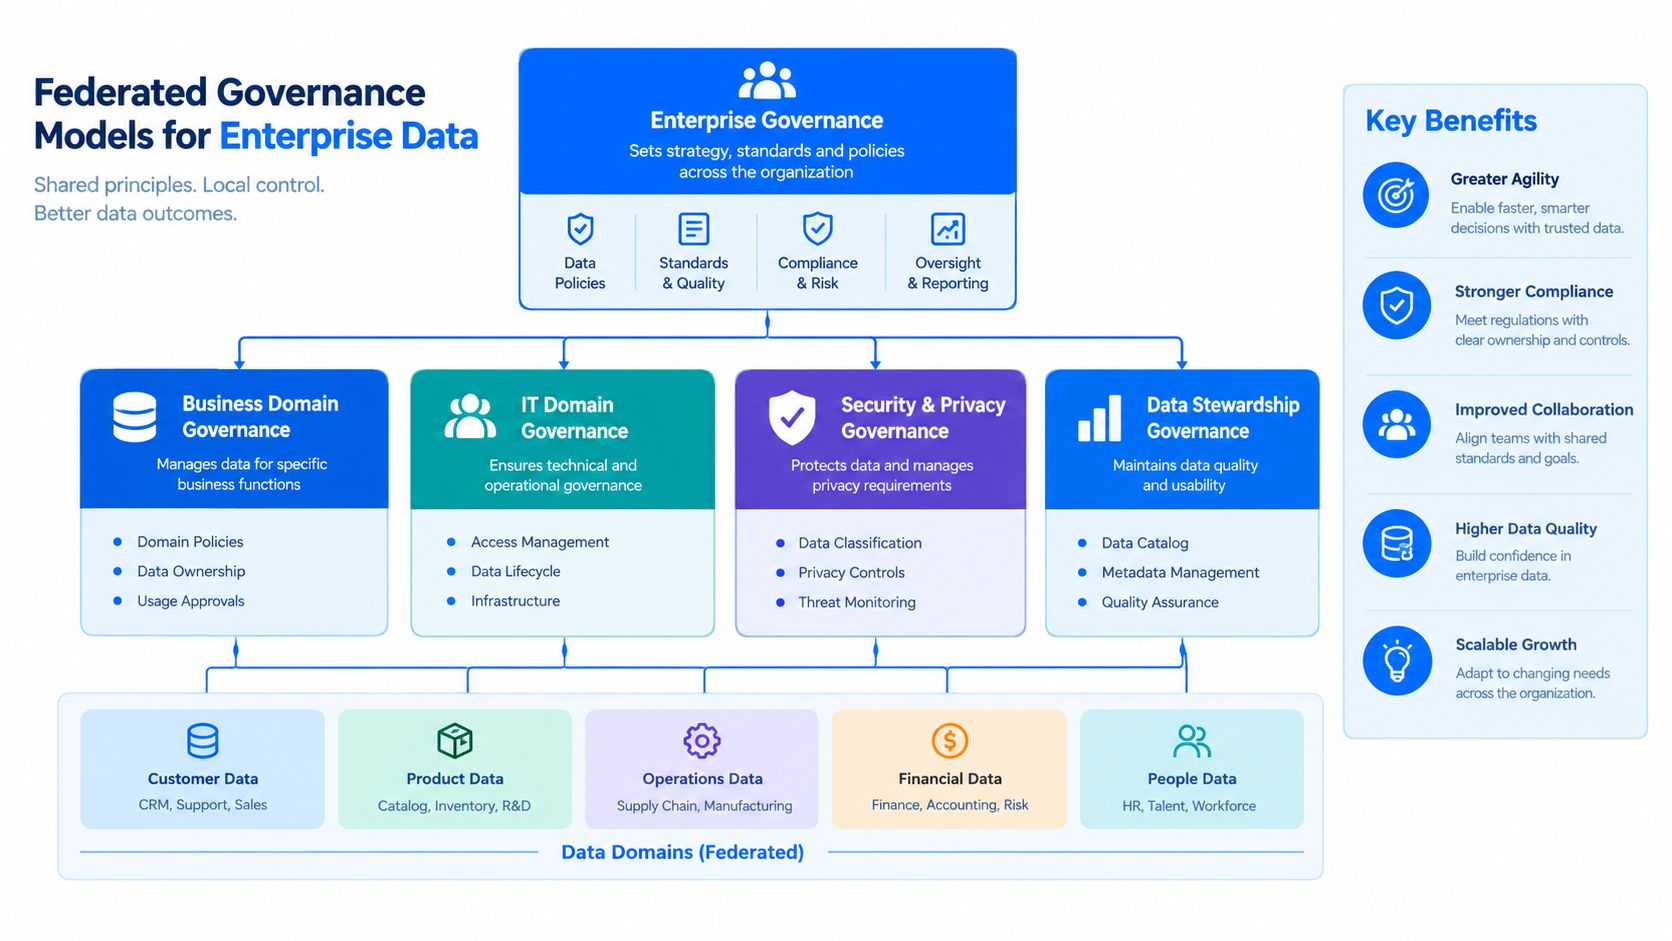
Für Teams, die dieses Betriebsmodell formalisieren, ist ein Leitfaden zur föderierten Data Governance am nützlichsten, wenn er mit konkreten Entscheidungen zu Zuständigkeit, Eskalation und Qualitätsnachweisen verbunden wird. Ohne diese Bausteine wird „föderiert“ zu einem Etikett ohne Durchsetzungsmechanismus.
Warum föderiert nicht automatisch privat bedeutet
Der hartnäckigste Mythos lautet, föderierte Systeme seien standardmäßig privat. Das sind sie nicht. Das NIST weist darauf hin, dass selbst beim föderierten Lernen Informationen aus Modellaktualisierungen oder aus dem trainierten Modell selbst extrahiert werden können – föderiertes Lernen verringert also die Exposition, beseitigt das Datenschutzrisiko aber nicht NIST.
Diesen Teil lassen viele Erklärungen aus. Dass Rohdaten lokal bleiben, ist eine wichtige Kontrolle, aber nicht die ganze Sicherheitsgeschichte. Unabhängige Forschung und regulatorische Leitlinien beschreiben denselben Mechanismus: Clients behalten Rohdaten auf dem Gerät oder vor Ort, führen lokale Berechnungen durch und senden nur gezielte Aktualisierungen zur Aggregation, teils ergänzt um Differential Privacy, um Datenabflüsse zu verringern CACM. Das ist besser, als alle Datensätze an einen zentralen Trainingsdatensatz zu übermitteln, lässt aber weiterhin Risiken wie Datenabfluss über Aktualisierungen, Model Inversion und Koordinationsrisiken bestehen.
Wovon regulierte Teams ausgehen sollten
Eine föderierte Architektur sollte als Strategie zur Reduzierung von Datenbewegungen betrachtet werden, nicht als pauschale Datenschutzgarantie. Wenn Sie im Finanzwesen, im Gesundheitswesen, in der Telekommunikation oder im öffentlichen Sektor tätig sind, benötigen Sie weiterhin Zugriffskontrollen, Prüfbarkeit und kryptografische Schutzmaßnahmen rund um den Aktualisierungspfad. Das Design hilft bei Datenresidenz und Autonomie, ersetzt aber kein Security Engineering.
Für Teams, die sich auf die Compliance-Seite dieser Gleichung konzentrieren, ist der Schutz Ihrer Privatsphäre eine nützliche Erinnerung daran, dass Datenschutz weiterhin mehrschichtige Kontrollen erfordert und kein Wunschdenken. Dieselbe Logik gilt für föderierte Systeme, bei denen die Angriffsfläche ihre Form verändert, statt zu verschwinden.
Föderierte Systeme verlagern das Risiko oft, statt es zu beseitigen. Die robustesten Implementierungen gehen davon aus, dass auch Modellaktualisierungen schützenswerte Assets sind.
Wenn Ihr Unternehmen die Architektur an Anforderungen zur Datenresidenz oder Datensouveränität ausrichten möchte, wird Compliance bei der Datensouveränität Teil der Designdiskussion und nicht zur Nebensache. Die Frage ist nie nur, wo die Rohdaten liegen, sondern auch, wer aus dem umgebenden System welche Schlüsse ziehen kann.
Wann föderierte Architekturen sinnvoll sind
Föderierte Architekturen sind am sinnvollsten, wenn unabhängige Teams die Zuständigkeit für ihre Daten behalten und dennoch an einem gemeinsamen Betriebsmodell teilnehmen müssen. Sie passen gut, wenn Datenschutz, Souveränität oder Domänenautonomie wichtig sind, denn unabhängige Quellen behalten die Kontrolle und bieten gleichzeitig interoperablen Zugriff über gemeinsame Richtlinien, APIs oder Algorithmen MIT. Das ist der Kernnutzen: Koordination ohne vollständige Konsolidierung.
Sie eignen sich auch dann, wenn zentralisierte Pipelines zu Engpässen geworden sind. Muss jede neue Datenquelle vom selben zentralen Team aufgenommen, modelliert, freigegeben und veröffentlicht werden, beginnt die Plattform, das Geschäft auszubremsen. Ein föderiertes Modell kann diesen Druck mindern, allerdings nur, wenn das Unternehmen bereit ist, domänenübergreifend in Standards, Metadaten, Sicherheit und Qualitätsüberwachung zu investieren.
Setzen Sie föderierte Designs ein, wenn
Mehrere Domänen Zuständigkeit benötigen: Jedes Team behält die Kontrolle über seine eigenen Daten und seine Logik.
Datenresidenz wichtig ist: Sie können oder sollten nicht alle Daten auf eine einzige Plattform verschieben.
Zentrale Pipelines überlastet sind: Das Plattformteam verbringt mehr Zeit mit Koordination als damit, andere zu befähigen.
Autonomie und Compliance gleichermaßen zählen: Das Unternehmen braucht lokale Entscheidungsfindung innerhalb globaler Leitplanken.
Ein rein zentralisierter Ansatz ist weiterhin sinnvoll für kleinere Datenbestände, Workloads mit nur einer Domäne oder Organisationen, die noch nicht die Governance-Reife besitzen, um domänenübergreifend zu koordinieren. Gibt es nur ein Team, einen Workload und ein Sicherheitsmodell, kann Föderation mehr Prozessaufwand als Nutzen bringen. Die strukturelle Abwägung ist einfach: Zentralisieren Sie für Einfachheit, föderieren Sie für kontrollierte Unabhängigkeit.
digna bietet Datenqualität und Observability innerhalb der eigenen Umgebung des Kunden und ist damit relevant, wenn föderierte Teams Nachweise aus getrennten Domänen benötigen, ohne alles an einem Ort zusammenzuführen. Wenn Sie eine föderierte Architektur evaluieren und domänenübergreifend Einblick in Anomalien, Schemaänderungen, Aktualität und Validierung benötigen, besuchen Sie digna und sehen Sie, wie die Plattform zu diesem Betriebsmodell passt.
Wenn föderierte Domänen ihre Daten vor Ort behalten, aber dennoch gemeinsame Qualitätsnachweise benötigen, kann Data-Platform-Observability, die in Ihrer eigenen Umgebung läuft, jede Quelle dort überwachen, wo sie liegt, statt sie in einen zentralen Speicher zu kopieren.
Häufig gestellte Fragen
Was bedeutet föderiert bei Daten und KI?
Föderiert bedeutet, dass die Daten an der Quelle bleiben, während gemeinsame Modelle, Richtlinien oder Abfragen über unabhängige Systeme hinweg arbeiten. Jeder Teil behält Zuständigkeit und lokale Kontrolle, und eine Koordinationsschicht übernimmt Zugriff oder Aggregation. Die Idee geht auf föderierte Datenbanken der späten 1970er- und der 1980er-Jahre zurück und bildet heute die Grundlage des föderierten Lernens.
Was ist der Unterschied zwischen föderierter und zentralisierter Datenarchitektur?
Der Kernunterschied liegt darin, wo die Daten liegen und wer für sie zuständig ist. Eine zentralisierte Architektur verschiebt Daten in ein gemeinsames Warehouse oder einen Lake, das bzw. den ein zentrales Team betreibt, während eine föderierte Architektur die Daten in den Quellsystemen belässt und Abfragen über eine Koordinationsschicht wie einen föderierten Server leitet; die Zuständigkeit bleibt bei den Domänenteams.
Wie funktioniert föderiertes Lernen, ohne Daten zu bewegen?
Beim föderierten Lernen wird ein Modell lokal auf jedem Client trainiert, sei es ein Smartphone, ein Kliniksystem oder ein Standort. Nur die Modellaktualisierungen gelangen zu einem Koordinator, der sie zu einem verfeinerten globalen Modell aggregiert und dieses für eine weitere lokale Runde zurücksendet. Die Rohdatensätze verlassen ihren ursprünglichen Speicherort nie.
Ist föderiertes Lernen standardmäßig privat?
Nein. Das NIST weist darauf hin, dass Informationen weiterhin aus Modellaktualisierungen oder aus dem trainierten Modell selbst extrahiert werden können; föderiertes Lernen verringert also die Exposition, ohne das Risiko zu beseitigen. Regulierte Teams im Finanzwesen, im Gesundheitswesen, in der Telekommunikation oder im öffentlichen Sektor benötigen weiterhin Zugriffskontrollen, Prüfbarkeit und kryptografische Schutzmaßnahmen rund um den Aktualisierungspfad.
Wann sollte ein Unternehmen eine föderierte Architektur einsetzen?
Entscheiden Sie sich für Föderation, wenn mehrere Domänen die Zuständigkeit für ihre Daten benötigen, Vorgaben zur Datenresidenz eine Konsolidierung verhindern oder zentrale Pipelines zum Engpass geworden sind. Bei kleineren Datenbeständen, Workloads mit nur einer Domäne oder Teams ohne die Governance-Reife für domänenübergreifende Koordination verursacht ein rein zentralisierter Ansatz meist weniger Prozessaufwand und bleibt die einfachere Option.


