10 häufige Probleme mit Daten und wie Sie sie 2026 erkennen
|
9
min. Lesezeit

Sie blicken auf ein Dashboard, das ruhig aussieht, die Job-Logs sind grün, und im Warehouse ist nichts sichtbar kaputt. Genau dann richten Probleme mit Daten den größten Schaden an. Zahlen können driften, Definitionen sich verschieben, und ein Modell rechnet munter weiter, während das Unternehmen Entscheidungen auf Basis veralteter, unvollständiger oder inkonsistenter Eingaben trifft.
Die meisten Datenfehler kündigen sich nicht an. Sie verstecken sich hinter Erfolgsmeldungen, leeren Spalten, doppelten Zeilen, verspäteten Feeds und Kennzahlenlogik, die niemand ausreichend dokumentiert hat. Das Kernproblem ist selten „die Pipeline ist ausgefallen“. Es ist vielmehr, dass die Pipeline meldet, alles sei in Ordnung, während Report, Modell oder regulatorische Meldung nach und nach an Vertrauenswürdigkeit verlieren.
Die folgende Liste ordnet zehn häufige Datenprobleme danach, wie unauffällig sie scheitern, nicht danach, wie oft darüber gesprochen wird. Zu jedem Punkt erfahren Sie, wie er sich in der Praxis zeigt, wie Sie ihn früh erkennen und welche digna Module zur Erkennung oder Behebung passen.
Inhaltsverzeichnis
6. Ungültige Formate und Werte außerhalb des zulässigen Bereichs
7. Verstöße gegen Geschäftsregeln und Lücken in der referenziellen Integrität
9. Inkonsistente Definitionen, Einheiten und Kennzahlenlogik
10. Unkontrollierte Workloads und Lastspitzen auf der Plattform
Machen Sie aus diesen zehn Prüfungen eine feste Data-Quality-Routine
1. Aktualität, veraltete Daten und fehlerhafte Dashboards
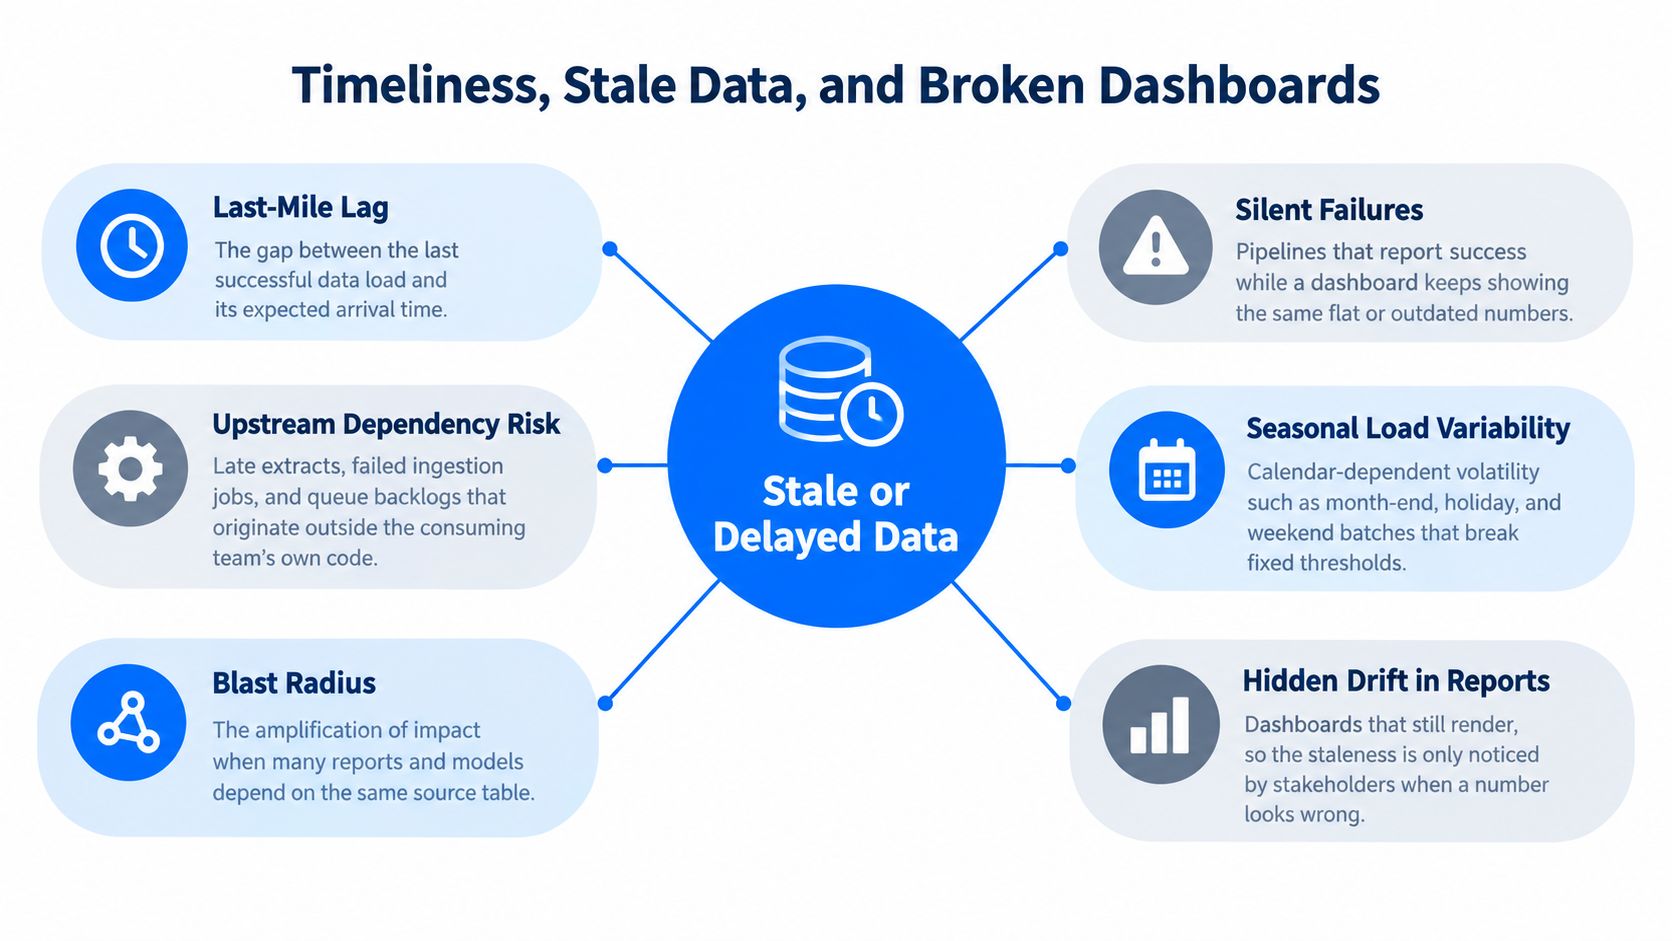
Ein Dashboard kann fehlerfrei laden, während die Zahlen darin längst veraltet sind. Finance sieht einen Report, Sales sieht einen Report, die Geschäftsleitung sieht einen Report, und die veraltete Zahl bleibt verborgen, bis jemand mit Fachkontext die Abweichung bemerkt.
So rutschen Aktualitätsprobleme durch. Ein Quell-Feed kann nach einem verspäteten Extrakt oder einem Rückstau in der Queue stehen bleiben, während eine Dimensionstabelle planmäßig, aber mit falschem Kategorie-Mapping aktualisiert wird. Das Dashboard wird weiter angezeigt, doch die Bedeutung hinter den Zahlen verschiebt sich. Späte Entdeckung ist in der Praxis teuer, und IBMs Studie zu Datenpannen zeigt, wie viel Zeit vergehen kann, bis ein Problem erkannt und eingedämmt ist: Erkennung und Eindämmung dauern im Schnitt 241 Tage, Erkennung und Eskalation kosten durchschnittlich 1,47 Millionen USD (IBM Cost of a Data Breach Studie).
Praxisregel: Ein Report ist nur so aktuell wie die Tabellen, die ihn speisen.
Worauf Sie achten sollten
Erwartete Lieferfenster: Lernen Sie die üblichen Lieferzeiten aus der Historie und alarmieren Sie bei verspäteten, fehlenden und unerwartet frühen Ladevorgängen.
Abhängigkeiten abbilden: Halten Sie fest, welche Dashboards von welchen Tabellen abhängen, damit Fehler im Upstream sichtbar werden, bevor das Meeting beginnt.
Schema und Timing gemeinsam: Ein Feed, der pünktlich ankommt, aber seine Struktur ändert, ist trotzdem ein Fehler.
Nutzen Sie digna Timeliness, um Liefermuster zu lernen und erwartete Ankunftszeiten zu berechnen. Kombinieren Sie es mit digna Data Quality Management für Anomalieerkennung, Validierung und Schema-Tracking auf den Tabellen, die Ihre wichtigsten Dashboards speisen. Mehr zum Betriebsmodell finden Sie im digna Leitfaden zum Monitoring der Datenaktualität.
2. Fehlende oder unvollständige Ladevorgänge
Ein Ladevorgang kann sauber abschließen und trotzdem falsch sein. Die Dateien kommen an, das Schema passt, und die Zeilenanzahl ist nah genug dran, um eine schnelle Prüfung zu bestehen. Was fehlt, ist die Region, das Quellsystem oder der Zeitabschnitt, der es nie durch die Pipeline geschafft hat.
So geraten Summen ins Rutschen, ohne dass ein offensichtlicher Alarm ausgelöst wird. Die COVID-19-Meldepanne von Public Health England ist ein klares Beispiel: Rund 16.000 positive Testergebnisse fehlten mehrere Tage lang, weil ein Tabellenformat das Zeilenlimit des älteren Excel-Formats überschritt, mit dem die Daten zusammengeführt wurden (Wie die COVID-19-Datenerfassung von Public Health England schiefging). Der Fehler sah wie normale Schwankung aus, bis jemand die Quelle prüfte.
Die Erkennung muss auf Segmentebene stattfinden. Gesamtzeilenzahlen reichen nicht aus, denn ein Teilausfall in einer Region oder Produktlinie kann die Gesamtzahl unauffällig aussehen lassen. Zur Messung lesen Sie den digna Leitfaden zur Messung der Datenvollständigkeit. Nutzen Sie digna Anomalies, um normale Volumenmuster pro Tabelle zu lernen und unvollständige Ladevorgänge auch dann zu markieren, wenn der Pipeline-Job Erfolg meldet.
Die Behebung ist repetitive Arbeit, und genau darum geht es. Vergleichen Sie Quell- und Zielzahlen in jeder Stufe, protokollieren Sie erwartete und tatsächliche Zeilen und bewahren Sie den Audit-Trail dort auf, wo ihn später jemand prüfen kann. Wenn ein Feed jeden Tag jede Filiale enthalten soll, muss eine fehlende Filiale an einem Datum auffallen, bevor sie ein Dashboard oder eine Prognose erreicht.
3. Schema Drift
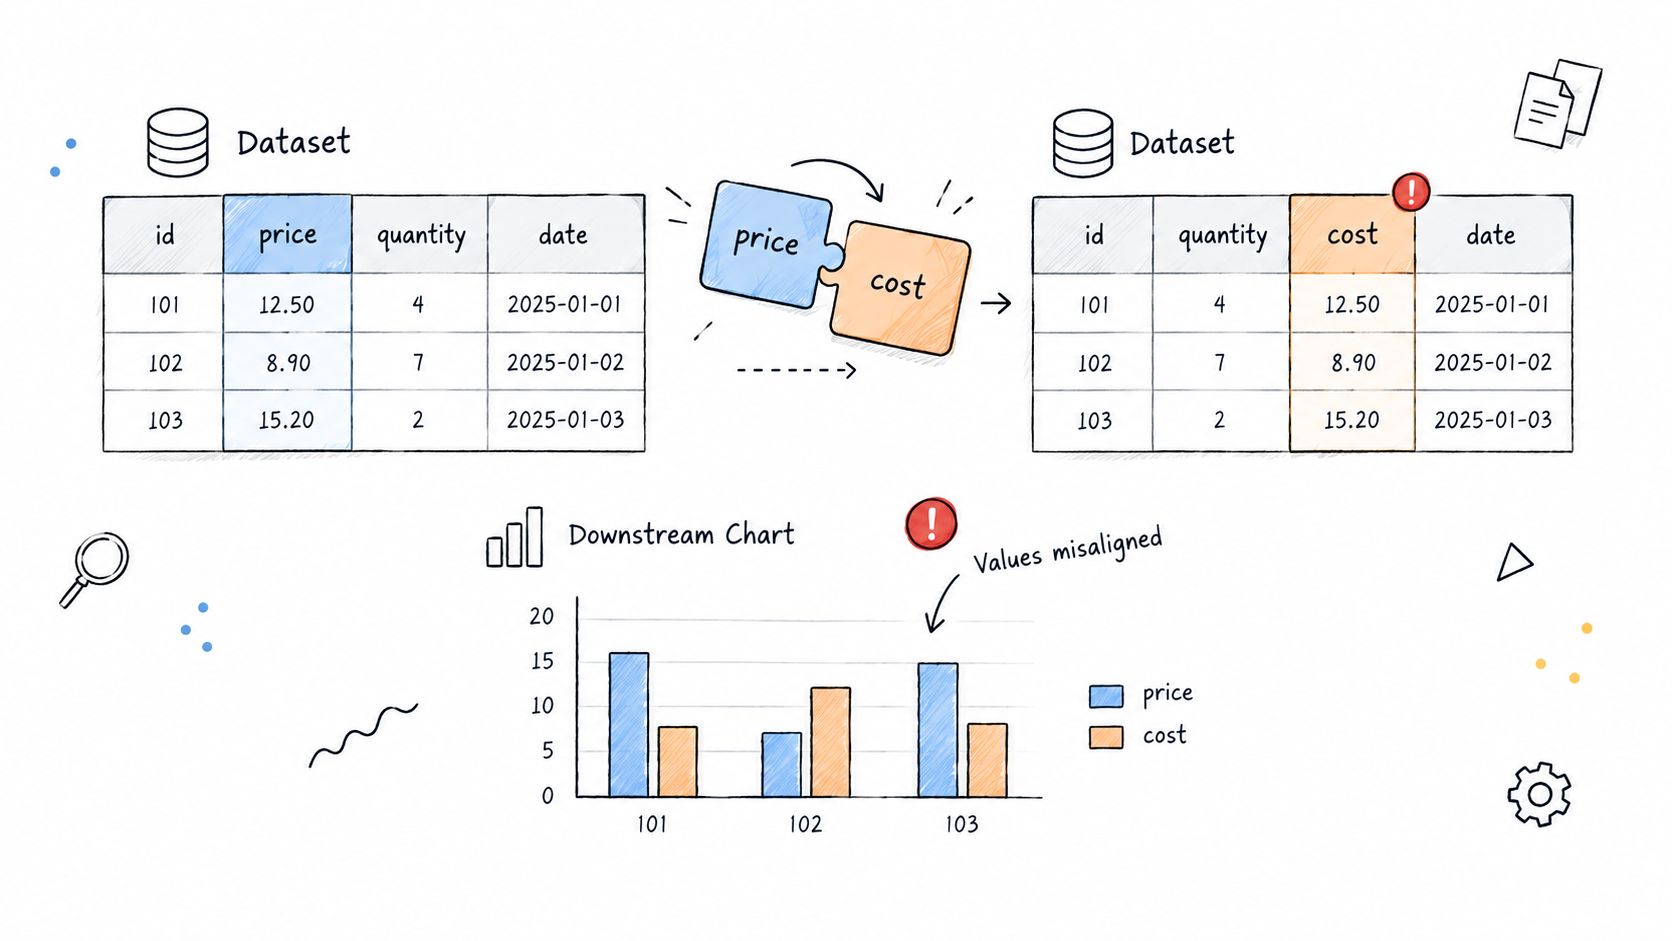
Ein Feld kann seine Struktur ändern, während die Pipeline weiterhin Erfolg meldet. Eine Spalte wird umbenannt, ein Datentyp kippt, oder eine Quelle lässt nach einem Release ein Feld weg, und die nachgelagerte Logik läuft mit falschen Annahmen weiter. Das zeigt sich meist erst später als Nullwerte, verschobene Werte, fehlerhafte Berechnungen oder ein Modell, das mit Eingaben rechnet, die es nicht mehr versteht.
Am schlimmsten sind die leisen Fehler. Ein Geldbetragsfeld, das von Dezimal auf Text wechselt, kann die Aggregation in der BI-Schicht zerstören, während der Upstream-Job weiterhin gesund aussieht. Eine entfernte Spalte kann auch durch einen Standardwert ersetzt werden, der den Feed am Leben hält und die Zahlen weniger wahrheitsgetreu macht, ohne einen offensichtlichen Fehler zu erzeugen.
So erkennen Sie es früh
Überwachen Sie hinzugefügte, entfernte und im Typ geänderte Spalten kontinuierlich, nicht nur beim Deployment.
Klassifizieren Sie Änderungen nach ihrer Auswirkung, damit Breaking Changes nicht in derselben Warteschlange landen wie harmlose Ergänzungen.
Verknüpfen Sie jede Änderung mit der Upstream-Quelle und allen nachgelagerten Assets, die davon abhängen.
Nutzen Sie digna Schema Tracker, um strukturelle Änderungen in dem Moment zu erkennen, in dem sie passieren, und sie den betroffenen Assets zuzuordnen. Der digna Überblick über Schematypen zeigt einen praktischen Weg, diese Änderungen zu gruppieren, bevor sie sich in Reporting- oder Scoring-Logik ausbreiten. Ein Schema-Vertrag verhindert nicht jede Änderung, aber er verhindert die Form von Schema Drift, die erst auffällt, wenn ein Report bereits falsch ist.
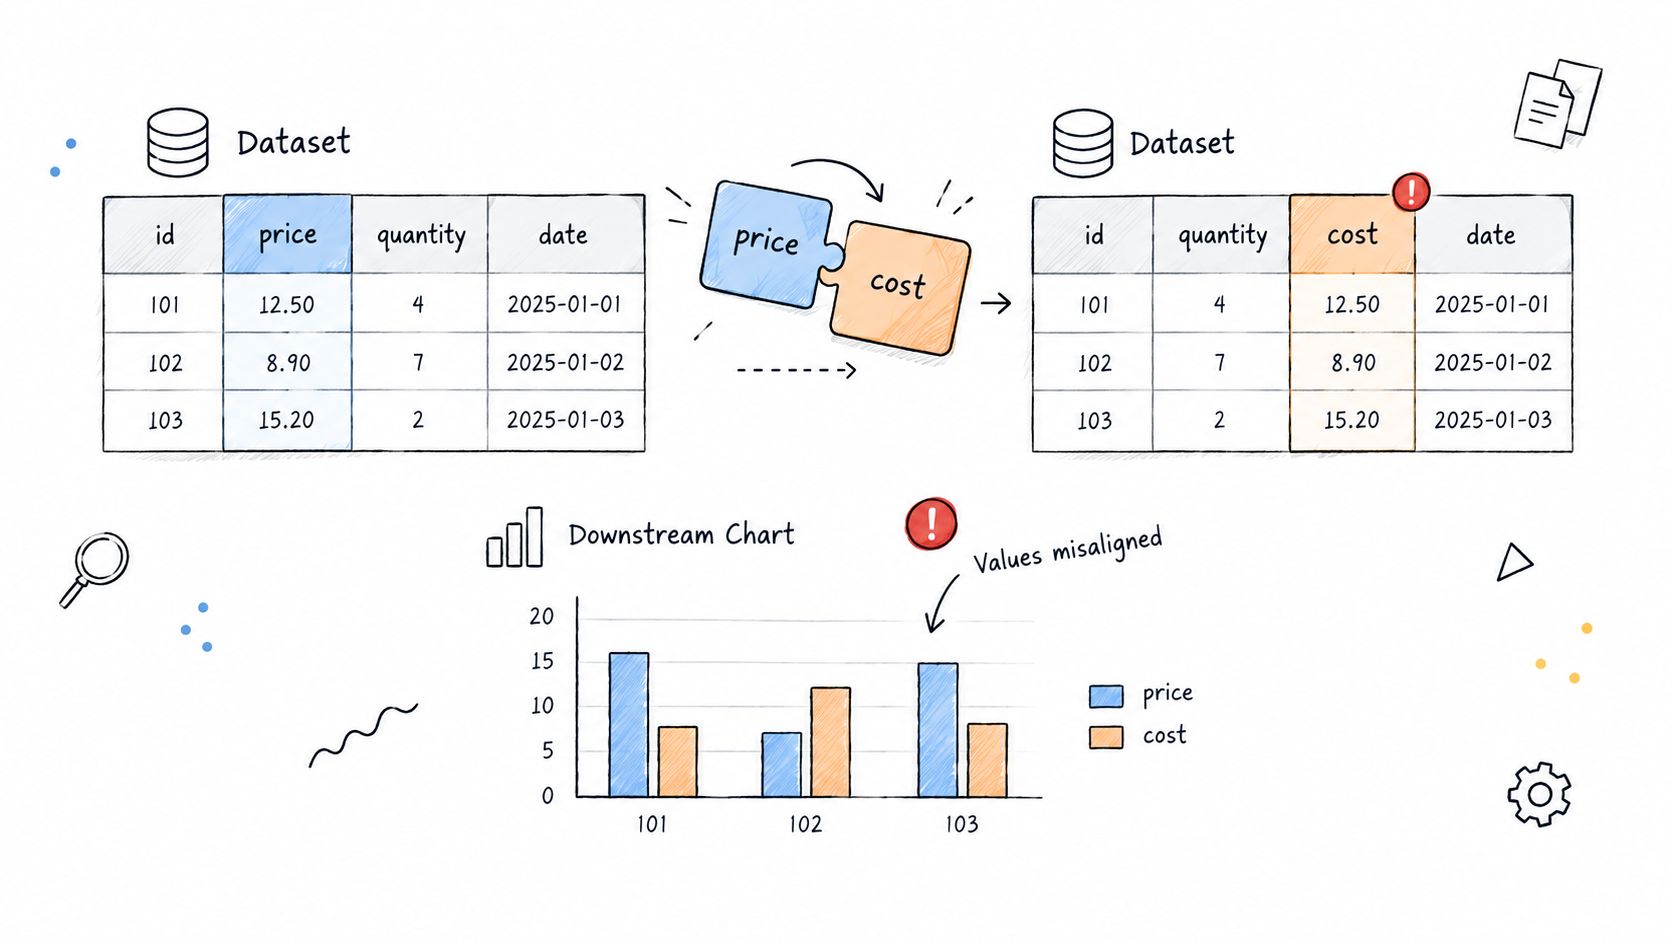
Ein anschauliches Beispiel hilft Teams zu sehen, wie ein Feld unbemerkt umbenannt werden kann. Ein Diagramm zu Datenfehlzuordnungen, bei denen der Preis fälschlich als Kosten bezeichnet wird, was zu falschen nachgelagerten Diagrammen führt.
4. Doppelte Datensätze
Duplikate sind tückisch, weil jede einzelne Zeile legitim aussieht. Derselbe Kunde, dieselbe Transaktion oder dieselbe Police taucht zweimal auf, mal durch Retries, mal durch sich überschneidende Quellsysteme und mal durch Merge-Logik, die einen Schlüsselabgleich verpasst hat. Nichts stürzt ab, aber die Summen stimmen nicht mehr.
Der operative Schaden wird offensichtlich, sobald Sie ihn zurückverfolgen. Abrechnungen werden aufgebläht, Kundenzahlen übertreiben die Realität, und Compliance-Reports beschreiben eine Organisation, die es so nie gab. Bei einer Migration können doppelte Konten das Management-Reporting gesünder oder größer erscheinen lassen, als es ist. In Streaming-Systemen kann Retry-Logik bei einem Netzwerkproblem dieselbe Transaktion mehrfach schreiben, mit dem Ergebnis aufgeblähter Umsätze, Volumina oder Aktivitäten.
Ein gutes Kontrollmuster beginnt mit expliziten Geschäftsschlüsseln. Wenn Sie die Eindeutigkeit einer Entität nicht definieren, überlassen Sie die Deduplizierung dem Zufall. Nutzen Sie digna Data Validation, um eindeutige Schlüssel durchzusetzen und Verstöße auf Datensatzebene zu erfassen, und gestalten Sie die Ingestion idempotent, damit Retries keine zusätzlichen Zeilen erzeugen. Für unscharfe Überschneidungen, bei denen ein exakter Abgleich nicht ausreicht, bietet der digna Leitfaden zu Fuzzy Matching einen praktischen Weg, Datensätze zu finden, die sich so ähnlich sind, dass sie eine Prüfung verdienen.
Die absolute Anzahl an Duplikaten ist weniger wichtig als der Trend. Ein plötzlicher Anstieg sagt meist mehr aus als eine stabile Basislinie.
5. Nullwerte und fehlende Werte
Nullwerte lassen sich leicht abtun, weil nicht jeder fehlende Wert schlecht ist. Problematisch wird es, wenn sich Null-Raten ohne Erklärung ändern oder wenn ein Feld, das befüllt sein sollte, in einem relevanten Teil der Datensätze plötzlich leer ankommt. Das deutet oft auf einen fehlgeschlagenen Join, ein Parsing-Problem oder eine unbemerkte Änderung an der Quelle hin.
Ein Formatunterschied in einem Join-Schlüssel kann dazu führen, dass Datensätze nicht mehr zusammenpassen, und dann verschwindet nachgelagert ein wichtiges Kundenattribut. Ein Release einer mobilen App kann aufhören, ein Feld zu erfassen, wodurch die Null-Raten in die Höhe schnellen, während die Pipeline weiterhin gesund aussieht. Das Risiko ist nicht nur analytischer Natur: Fehlende kritische Felder können Modelle verzerren und operative Entscheidungen verfälschen.
Die richtige Kontrolle ist hier ratenbasiert, nicht absolut. Eine pauschale „keine Nullwerte“-Regel erzeugt Rauschen, während eine gemessene Basislinie relevante Verschiebungen erkennt. Behandeln Sie optionale und Pflichtfelder getrennt und prüfen Sie auf getarnte fehlende Werte wie Platzhalter-Strings oder Dummy-Zahlen. Nutzen Sie digna Anomalies, um das normale Verhalten der Null-Rate pro Spalte zu lernen, und alarmieren Sie bei deutlichen Abweichungen, statt über manuelle Schwellenwerte zu streiten. Die digna Notiz zu Vollständigkeit als Dimension der Datenqualität hilft, wenn Teams echte Vollständigkeit von Annahmen trennen müssen.
6. Ungültige Formate und Werte außerhalb des zulässigen Bereichs
Ungültige Werte bestehen oft die technische Validierung, weil der Datentyp stimmt, der Inhalt aber falsch ist. Ein Datum lässt sich sauber parsen und ist trotzdem unmöglich. Ein Preis ist numerisch, aber in der falschen Einheit. Eine Postleitzahl hat die erwartete Länge und verletzt dennoch jede reale Bedingung, auf die sich das Unternehmen verlässt.
Viele Teams verwechseln erfolgreiche Ingestion mit korrekten Daten. Ein Gesundheitsdatensatz mit einem Geburtsdatum in der Zukunft kann durch vertauschte Tages- und Monatsangaben zwischen Systemen entstehen. Ein Händler kann Preise aus einer Quelle in Cent und aus einer anderen in Währungseinheiten übernehmen, wodurch dasselbe Produkt 100-mal zu teuer oder zu billig erscheint. Nicht die Pipeline ist kaputtgegangen, sondern die Geschäftslogik.
Die Antwort ist eine explizite fachliche Kontrolle. Dokumentieren Sie zulässige Wertebereiche und Codelisten für kritische Felder, validieren Sie diese auf Datensatzebene und bewahren Sie fehlerhafte Zeilen samt Begründung auf. Nutzen Sie digna Data Validation, um diese Regeln auf den wichtigsten Spalten durchzusetzen, und kombinieren Sie Regelprüfungen mit statistischer Erkennung, wenn fehlerhafte Werte nur im Vergleich zur Historie auffallen. Auch die Qualitätsleitlinien des NIST sind hier hilfreich, denn sie definieren Informationsqualität über Nutzen, Integrität und Objektivität, wobei der akzeptable Fehler vom Anwendungsfall abhängt (NIST Information Quality Standards).
7. Verstöße gegen Geschäftsregeln und Lücken in der referenziellen Integrität
Eine Lieferung vor dem Bestelldatum, ein Kredit ohne Genehmigungsdatensatz oder eine Police, die auf einen fehlenden Kunden verweist, bringen die Pipeline selten zum Absturz. Sie zerstören das Vertrauen in die Zahlen. Diese Fehler schlüpfen durch die Basisvalidierung, weil die Felder vorhanden sind, die Geschäftslogik aber falsch ist.
Die leisesten Fehler stecken meist in Beziehungen. Ein geschlossener Kontrahent kann weiterhin im Exposure-Reporting auftauchen, wenn Statusänderungen nicht jede nachgelagerte Tabelle erreichen. Schadensfälle können weiter auf Policennummern verweisen, die im Stammdatensatz nicht mehr existieren. Finance bemerkt es spät, oft nachdem jemand einen Report bereits freigegeben hat.
Ordnen Sie diese Fehler danach, wie sie scheitern. Ein fehlender Fremdschlüssel ist laut. Ein veraltetes Status-Flag ist es nicht.
1. Fehlende Elterndatensätze Ein Kinddatensatz verweist ins Leere, aber die Zeile landet trotzdem im Reporting. Erkennen Sie das, indem Sie jeden Fremdschlüssel gegen die Stammtabelle prüfen, und sichten Sie die Ablehnungen täglich. Mit digna Data Validation bleiben die fehlerhaften Zeilen samt Begründung erhalten, sodass Betrieb und Audit den Bruch nachvollziehen können.
2. Geschäftsdaten in falscher Reihenfolge Ein Ereignis kommt mit Datumsangaben an, deren Abfolge keinen Sinn ergibt. Erkennen Sie das mit expliziten Reihenfolgeregeln, etwa Genehmigung vor Auszahlung oder Policenbeginn vor Schadendatum.
3. Abweichender Status zwischen Systemen Eine Tabelle sagt geschlossen, eine andere noch aktiv. Vergleichen Sie Lebenszyklusfelder über Quellen hinweg und markieren Sie Datensätze, die beim aktuellen Status nicht übereinstimmen.
4. Verwaiste operative Referenzen Eine Rechnung, ein Schadensfall oder ein Exposure bleibt mit einem gelöschten Stammdatensatz verknüpft. Führen Sie referenzielle Prüfungen dort durch, wo die Daten gespeichert sind, nicht erst nach der Aggregation.
5. Regeln, die nur in jemandes Kopf existieren Dokumentieren Sie die Regel, benennen Sie die verantwortliche Person und machen Sie die Prüfbedingung lesbar. Eine Regel, die niemand erklären kann, übersteht kein Review.
Halten Sie die Prüfungen nah an den Daten, sichern Sie Belege und leiten Sie Fehler an die Personen weiter, die die Quelle korrigieren können.
8. Stiller Data Drift und Verteilungsverschiebungen
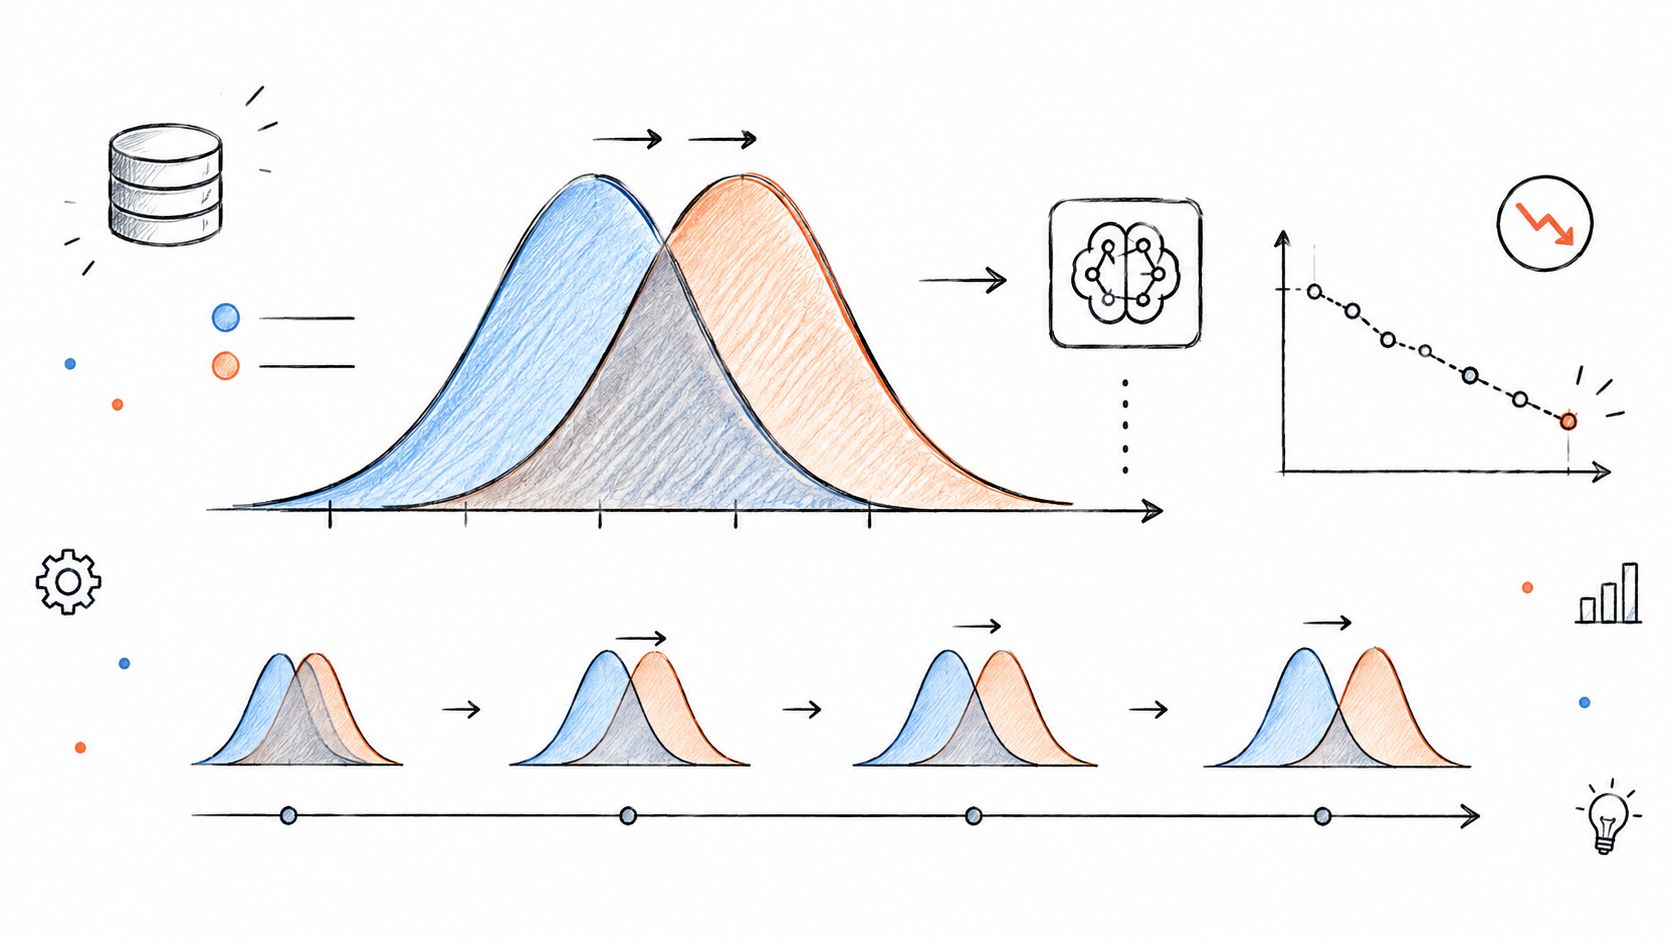
Eine Pipeline kann gesund bleiben, während die Daten langsam ihre Bedeutung verlieren. Durchschnitte verschieben sich, der Mix ändert sich, Korrelationen werden schwächer, und Reports oder Modelle werden unzuverlässiger, ohne dass ein Job fehlschlägt oder ein Schema bricht. Deshalb ist Drift leicht zu übersehen und schwer zu ignorieren.
Ordnen Sie diese Probleme danach, wie leise sie scheitern. Ein lauter Ausfall bekommt Aufmerksamkeit. Eine leise Verhaltensänderung meist nicht.
1. Drift in Feature-Verteilungen Eine Scorecard läuft weiter, aber ein Input stammt jetzt aus einem anderen Kundensegment als zuvor. Prüfen Sie rollierende Verteilungen gegen eine bekannte Basislinie und gleichen Sie sie mit aktuellen Releases der Quelle und Mapping-Änderungen im Upstream ab. Legen Sie mit digna Anomalies erwartete Bereiche pro Datensatz fest und nutzen Sie digna Data Analytics, um zu prüfen, ob die Bewegung isoliert ist oder Teil eines breiteren Trends.
2. Label- oder Outcome-Drift Die Zielgröße selbst ändert sich nach Änderungen an Richtlinien, Produkten oder Routing. Das Modell wirkt schlechter, obwohl die Pipeline intakt ist. Verfolgen Sie Ergebnisraten über die Zeit und gleichen Sie sie mit Geschäftsereignissen ab, bevor Sie die Verschiebung als Modellverfall werten.
3. Stille Änderungen an Einheiten oder Kodierungen Eine Währung, ein Statuscode oder ein Kategorie-Mapping ändert sich im Upstream, aber der Feed besteht die Validierung weiterhin. Das Dashboard bleibt grün, während die Zahlen nicht mehr vergleichbar sind. Gleichen Sie Deployments der Quelle und Transformationslogs ab und bestätigen Sie, dass die Werte noch die Bedeutung haben, die nachgelagerte Nutzer erwarten.
4. Veränderter Segmentmix Ein Report wird von einer neuen Region, einem neuen Kanal oder einer neuen Gerätegruppe dominiert, und der Gesamtdurchschnitt bewegt sich mit. Schlüsseln Sie Kennzahlen nach Segmenten auf, bevor Sie von einem Trend sprechen. Wenn ein Segment den Großteil der Verschiebung erklärt, liegt das Problem in der Zusammensetzung, nicht in der Performance.
5. Schleichender Korrelationsverlust Zwei Felder, die sich früher gemeinsam bewegt haben, tun es nicht mehr. Das zeigt sich oft nach einem Wechsel der Datenquelle, einem verspäteten Feed oder einer neuen Geschäftsregel. Beobachten Sie paarweise Beziehungen und alarmieren Sie bei anhaltender Abweichung, nicht nur bei einzelnen Ausschlägen.
Die nützliche Gewohnheit ist einfach: Überwachen Sie Verteilungen, verknüpfen Sie Alarme mit Ereignissen an der Quelle und halten Sie fehlerhafte Zeilen und Kontext sichtbar, damit Analysten Drift von echter Veränderung unterscheiden können.
9. Inkonsistente Definitionen, Einheiten und Kennzahlenlogik
Zwei Dashboards können beide „richtig“ sein und sich trotzdem widersprechen, weshalb diese Kategorie dem Vertrauen so sehr schadet. Ein Team zählt Konten, ein anderes eindeutige Kunden, ein drittes weist Umsätze in Tausend aus, und ein viertes rechnet Zeitzonen anders um. Die Zahlen sind in sich konsistent, im Vergleich aber nutzlos.
Diese Art von Abweichung bleibt verborgen, bis die Führungsebene fragt, warum dasselbe Quartal in zwei Systemen unterschiedlich aussieht. Der Absturz des Mars Climate Orbiter ist das klassische Beispiel für verwechselte Einheiten, und er ist weiterhin relevant, weil moderne Analytics dieselbe Schwäche hat, nur in höherem Tempo. Wenn Finance, Operations und Produkt jeweils anders definieren, was ein „aktiver Kunde“ ist, wird jedes Meeting zur Abstimmungsübung.
Ein Glossar hilft, aber nur, wenn jeder Kennzahl Verantwortliche, Berechnungslogik und Einheiten zugeordnet sind. Standardisieren Sie Umrechnungen so früh wie möglich, gleichen Sie kritische Kennzahlen regelmäßig ab und untersuchen Sie Abweichungen oberhalb vereinbarter Toleranzen. Nutzen Sie digna Business Monitoring, um KPIs auf den zugrunde liegenden Daten zu überwachen, damit unerwartete Verschiebungen sichtbar werden, noch bevor die Definitionen vollständig harmonisiert sind. Für Teams, die das Verhalten von Kennzahlen gern aus Sicht der Zuverlässigkeit betrachten, ist MTBF, MTTR und OEE erklärt eine nützliche ergänzende Quelle.
Wenn zwei Teams dieselbe Bezeichnung für unterschiedliche Logik verwenden, ist die Bezeichnung das Problem.
10. Unkontrollierte Workloads und Lastspitzen auf der Plattform
Ein Dashboard-Rollout, ein Backfill oder ein neuer Self-Service-Workflow kann eine Plattform über ihre normale Last hinaustreiben, bevor es jemand bemerkt. Das Warehouse antwortet weiterhin, aber die Abfragelatenz steigt, die Kosten klettern, und geplante Jobs verpassen ihre Zeitfenster.
Teams ordnen solche Spitzen oft der Infrastruktur zu, doch Abfragevolumen, Speicherwachstum und längere Laufzeiten sind auch Probleme der Datenzuverlässigkeit. Sie treten meist ohne Vorwarnung auf. Das erste Symptom ist selten ein Ausfall. Es ist ein langsamerer Modell-Refresh, ein verspäteter Report oder eine Rechnung, die niemand eingeplant hat. Studien zur Cloud-Auslastung zeigen immer wieder dasselbe Muster: Ungenutzte oder schlecht verwaltete Kapazität wird zu Verschwendung und bremst den Betrieb. Deshalb gehört Workload-Wachstum genauso in Datenprüfungen wie in Infrastruktur-Reviews.
Plattformverhalten sichtbar halten
Nach Workload-Verantwortlichen verfolgen: Ordnen Sie Spitzen einem Team, einer Pipeline oder einem Dashboard zu, bevor sich das Muster ausbreitet.
Basislinie nach Zeitmuster: Vergleichen Sie das Verhalten an Werktagen, Wochenenden und in Release-Fenstern, bevor Sie alarmieren.
Gemeinsam mit Finance prüfen: Kostenkontrolle funktioniert besser, wenn Engineering und Finance dieselben Trends lesen.
Nutzen Sie digna Data Platform Observability, um Workloads, Verbrauch, Verfügbarkeit und Performance-Kennzahlen an einem Ort zu überwachen. So erkennen Sie leichter den stillen Fehlermodus, bei dem das System läuft, während Kosten und Latenz aus dem Toleranzbereich wandern. Für Plattformteams entscheidet diese Transparenz oft darüber, ob ein Anstieg kontrolliert bleibt oder zur teuren Überraschung wird.
Die 10 häufigsten Datenprobleme im Vergleich
Problem | 🔄 Implementierungsaufwand | 💡 Ressourcenbedarf | ⚡ Erwartete Erkennungsgeschwindigkeit | 📊 Erwartete Ergebnisse / Auswirkungen | ⭐ Ideale Anwendungsfälle / Hauptvorteil |
|---|---|---|---|---|---|
Aktualität, veraltete Daten und fehlerhafte Dashboards | Mittel bis hoch; erfordert SLA-Fenster & Abhängigkeits-Mapping | Mittel: Monitoring, Lineage, Alerting | Langsam, wenn nur Dashboards geprüft werden; ⚡ schnell mit gelernten Lieferfenstern | Hohe Auswirkung auf viele Reports; untergräbt das Vertrauen der Stakeholder | Kritische Dashboards & SLA-Durchsetzung; schnelle Kommunikation an den Upstream |
Fehlende oder unvollständige Ladevorgänge | Mittel; erfordert segmentierte Volumen-Basislinien und Abgleich | Mittel: Zeilenzahl-Logs, Prüfungen pro Partition | Mittel; Teilladungen bleiben unbemerkt, wenn keine segmentierten Prüfungen laufen | Großes Risiko für Aggregate und Trends; Volumina können falsch ausgewiesen werden | Batch-/ETL-Pipelines und aggregierte Kennzahlen; fehlende Segmente erkennen |
Schema Drift | Mittel; erfordert kontinuierliches Tracking von Schema und Verträgen | Gering bis mittel: Schema-Registry oder Tracker | Mittel bis schnell mit automatisiertem Schemavergleich | Bricht Transformationen, erzeugt nachgelagert Nullwerte oder Fehler | Systeme mit vielen Datenlieferanten; Schema-Verträge durchsetzen |
Doppelte Datensätze | Mittel; erfordert Design von Geschäftsschlüsseln und Idempotenz | Gering bis mittel: Deduplizierungslogik, Matching-Tools | Mittel; oft erst nach der Aggregation sichtbar, sofern nicht überwacht | Aufgeblähte Zählungen/Summen und Fehler in Abrechnung oder Kundenanalysen | Ingestion-Pipelines, Auflösung von Kundenidentitäten, Abrechnung |
Nullwerte und fehlende Werte | Gering bis mittel; Monitoring auf Spaltenebene und Basislinien für erwartete Nullwerte | Gering: Prüfungen und Alarme pro Spalte | Schnell mit Monitoring der Null-Rate | Verzerrung in Analytics/ML und fehlende Attribute für Joins | ML-Features und Pflichtfelder; plötzliche Anstiege von Nullwerten erkennen |
Ungültige Formate und Werte außerhalb des zulässigen Bereichs | Gering bis mittel; Regeln für Syntax/Semantik/Wertebereich definieren | Gering: Validierungsregeln und Referenzlisten | Schnell durch deterministische Prüfungen | Unplausible oder nicht konforme Werte, die Kennzahlen verzerren | Felder mit bekannten Wertebereichen (Datumsangaben, Codes, Preise); regulatorische Prüfungen |
Verstöße gegen Geschäftsregeln & referenzielle Lücken | Hoch; tabellenübergreifende Logik und klare Verantwortung erforderlich | Hoch: Integritätsprüfungen, Verantwortliche, Audit-Trails | Mittel; kann aufwendig sein, daher oft nur stichprobenartig | Compliance-Verstöße, Abgleichsprobleme, Audit-Risiko | Regulierte Finanz-, Risiko- und Abgleichsprozesse |
Stiller Data Drift & Verteilungsverschiebungen | Mittel bis hoch; statistische Basislinien und Monitoring von Zusammenhängen | Mittel bis hoch: Drift-Tools, langfristige Basislinien | Von Natur aus langsam; ⚡ schneller mit kontinuierlicher Drift-Erkennung | Schleichende Verschlechterung von Modellen und irreführende Trends | Produktive ML-Modelle und langfristige analytische Basislinien |
Inkonsistente Definitionen, Einheiten & Kennzahlenlogik | Hoch; Governance, Glossar und teamübergreifende Abstimmung | Hoch: Dokumentation, Abgleich, Umrechnungsschichten | Langsam, oft erst in Reviews oder Audits entdeckt | Widersprüchliche Dashboards und Vertrauensverlust in KPIs | Bereichsübergreifende KPIs, Management-Reporting, konsolidierte Kennzahlen |
Unkontrollierte Workloads & Lastspitzen auf der Plattform | Mittel; Basislinien pro Workload und Zuordnung | Hoch: Plattform-Telemetrie, Kostenkontrollen, Playbooks zur Behebung | Mittel bis schnell über Plattformkennzahlen und Alarme | Kostenüberschreitungen, verspätete Jobs, Performance-Einbußen | Gemeinsam genutzte Data Warehouses, FinOps, Produktionsplanung und Backfills |
Machen Sie aus diesen zehn Prüfungen eine feste Data-Quality-Routine
Beginnen Sie mit den Problemen, die Ihre meistgenutzten Dashboards und regulierten Reports betreffen. Weisen Sie jedem eine verantwortliche Person, eine Erkennungsmethode und einen Alarmierungsweg zu, denn „da sollte mal jemand draufschauen“ ist keine Kontrolle. Wenn die Daten Finance, Gesundheitswesen, öffentliches Reporting, Kundenbetrieb oder KI-Pipelines unterstützen, besteht die erste Aufgabe darin, Fehler sichtbar zu machen, bevor sie ein Meeting, eine Meldung oder ein Modell erreichen.
Überprüfen Sie diese Liste jedes Quartal. Neue Quellen kommen hinzu, Schemas ändern sich, Teams bauen neue Dashboards, und die Plattformnutzung wächst auf eine Weise, die Kontrollen erforderlich macht, die Sie vor sechs Monaten noch nicht brauchten. Langfristig bewähren sich die Systeme, in denen Aktualität, Vollständigkeit, Schemaänderungen, Validierung und Anomalieerkennung routinemäßig überwacht werden und nicht erst als Reaktion auf eine Krise.
Am praktischsten beginnen Sie mit den drei Problemen, die Ihre kritischen Reports in diesem Monat am ehesten stören. Legen Sie zuerst für sie Basislinien fest und erweitern Sie dann auf die angrenzenden Fehlermodi, sobald die Alarmierung verlässlich ist. Genau hier passt digna gut, denn seine Module decken Aktualität, Volumenverschiebungen, Nullwerte, Schemaänderungen, Regeln auf Datensatzebene, KPI-Monitoring und Plattform-Observability in einem Betriebsmodell ab.
Am wichtigsten ist Beständigkeit. Wenn Sie veraltete Daten, fehlende Ladevorgänge und strukturelle Änderungen früh erkennen, haben Sie bereits einen großen Teil der stillen Fehler beseitigt, durch die Datenteams das Vertrauen in ihre eigenen Ergebnisse verlieren. Wenn Sie die Geschäftsregel, das Aktualitätsfenster und die Quelle einer Änderung belegen können, wird der Rest beherrschbar.
digna bietet Teams einen praktischen Weg, die Daten zu überwachen, auf denen Reporting, Betrieb und KI beruhen. Wenn Sie mit veralteten Feeds, Drift, fehlenden Datensätzen oder Schemaänderungen kämpfen, besuchen Sie digna und sehen Sie, wie die Module Aktualität, Validierung, Anomalieerkennung, Schema-Tracking und Plattform-Observability in Ihrer eigenen Umgebung unterstützen.
Sobald ein Alarm ausgelöst wird, stellt sich die nächste Frage: Wer übernimmt die Triage, und wie schnell wird das Problem behoben? Der Prozess für das Management von Datenqualitätsproblemen beschreibt diese Schritte von der Erkennung bis zur abgeschlossenen Korrektur.
Häufig gestellte Fragen
Was sind die häufigsten Probleme mit Daten?
Die zehn häufigsten sind veraltete Daten, fehlende oder unvollständige Ladevorgänge, Schema Drift, doppelte Datensätze, Nullwerte, ungültige Formate, Verstöße gegen Geschäftsregeln, stiller Verteilungsdrift, inkonsistente Kennzahlendefinitionen und Lastspitzen auf der Plattform. Die Liste ordnet sie danach, wie unauffällig sie scheitern, nicht danach, wie oft Teams darüber sprechen.
Wie erkennen Sie einen unvollständigen Ladevorgang, wenn der Job Erfolg meldet?
Prüfen Sie das Volumen auf Segmentebene statt als eine Gesamtsumme. Eine fehlende Region oder Produktlinie kann die Gesamtzeilenzahl normal aussehen lassen. Vergleichen Sie daher Quell- und Zielzahlen pro Stufe und Segment und alarmieren Sie, wenn eine einzelne Filiale oder ein Datum fehlt.
Warum ist Schema Drift gefährlich, wenn die Pipeline weiterläuft?
Weil die nachgelagerte Logik mit falschen Annahmen weiterarbeitet. Eine umbenannte Spalte, ein Dezimalfeld, das zu Text wird, oder ein entferntes Feld, das durch einen Standardwert ersetzt wird, erzeugen Nullwerte, fehlerhafte Aggregationen und irreführende Zahlen ohne sichtbaren Fehler. Kontinuierliches Tracking von Spaltenänderungen fängt das ab, bevor Reports falsch werden.
Sollten Datenqualitätsregeln Nullwerte komplett verbieten?
Nein. Eine pauschale Regel gegen Nullwerte erzeugt Rauschen, weil manche Felder berechtigterweise optional sind. Überwachen Sie Null-Raten stattdessen gegen eine gelernte Basislinie pro Spalte, behandeln Sie optionale und Pflichtfelder getrennt und achten Sie auf getarnte fehlende Werte wie Platzhalter-Strings oder Dummy-Zahlen, die befüllt wirken, es aber nicht sind.
Wo sollte ein Team beim Aufbau einer Data-Quality-Routine anfangen?
Beginnen Sie mit den drei Problemen, die Ihre kritischen Reports in diesem Monat am ehesten stören. Geben Sie jedem eine verantwortliche Person, eine Erkennungsmethode und einen Alarmierungsweg, legen Sie Basislinien fest und erweitern Sie, sobald die Alarmierung verlässlich ist. Überprüfen Sie die Liste quartalsweise, wenn sich Quellen, Schemas und Dashboards ändern.