Datenqualitätsprobleme managen und schneller beheben
|
10
min. Lesezeit

Das Dashboard sagt, der Umsatz sei gefallen. Der CFO fragt, ob die Nachfrage einbrach, sich die Preise änderten oder die Finanzabteilung wieder die falsche Tabelle geladen hat. In Slack hat eine Analystin bereits einen Screenshot mit drei verschiedenen Zahlen für dieselbe Kennzahl gepostet. Jemand flickt ein SQL-Modell, lässt eine Pipeline erneut laufen und erklärt es für behoben.
Zwei Tage später kommt dasselbe Problem aus einer anderen vorgelagerten Quelle zurück.
Das ist das Muster, mit dem viele Datenteams leben. Kein einzelnes kaputtes Feld, sondern eine wiederkehrende Schleife aus veralteten Ladevorgängen, stiller Schemadrift, doppelten Alarmen und unklarer Verantwortung. Ad-hoc-Korrekturen fühlen sich im Moment schnell an, doch sie bleiben meist bei der Symptomlinderung. Sie definieren nicht, wer den Mangel verantwortet, welche Reaktionszeit akzeptabel ist oder wie das Team verhindert, dass dieselbe Fehlerklasse wieder aufgeht.
Inhaltsverzeichnis
Warum Datenqualitätsprobleme einen gesteuerten Prozess brauchen
Der Ablauf im Management von Datenqualitätsproblemen, von Erkennung bis Vorbeugung
Wie man unter SLAs triagiert, priorisiert und Verantwortung zuweist
Den Prozess in Werkzeuge, Rollen und den Alltagsbetrieb einbetten
Wiederkehrende Probleme verhindern und belegen, dass der Prozess wirkt
Warum Datenqualitätsprobleme einen gesteuerten Prozess brauchen
Ein fehlerhafter Ladevorgang landet um 6:10 Uhr. Um 8:00 zweifelt die Finanzabteilung am Umsatz, eine Analystin hat drei laute Alarme stummgeschaltet, und ein Engineer lässt einen Job erneut laufen, ohne zu wissen, ob der Mangel in der Quell-Ingestion, einer Transformationsänderung oder einer kaputten Referenztabelle begann. Teams nennen das oft Triage. In der Praxis ist es Warteschlangenarbeit ohne Betriebsmodell.
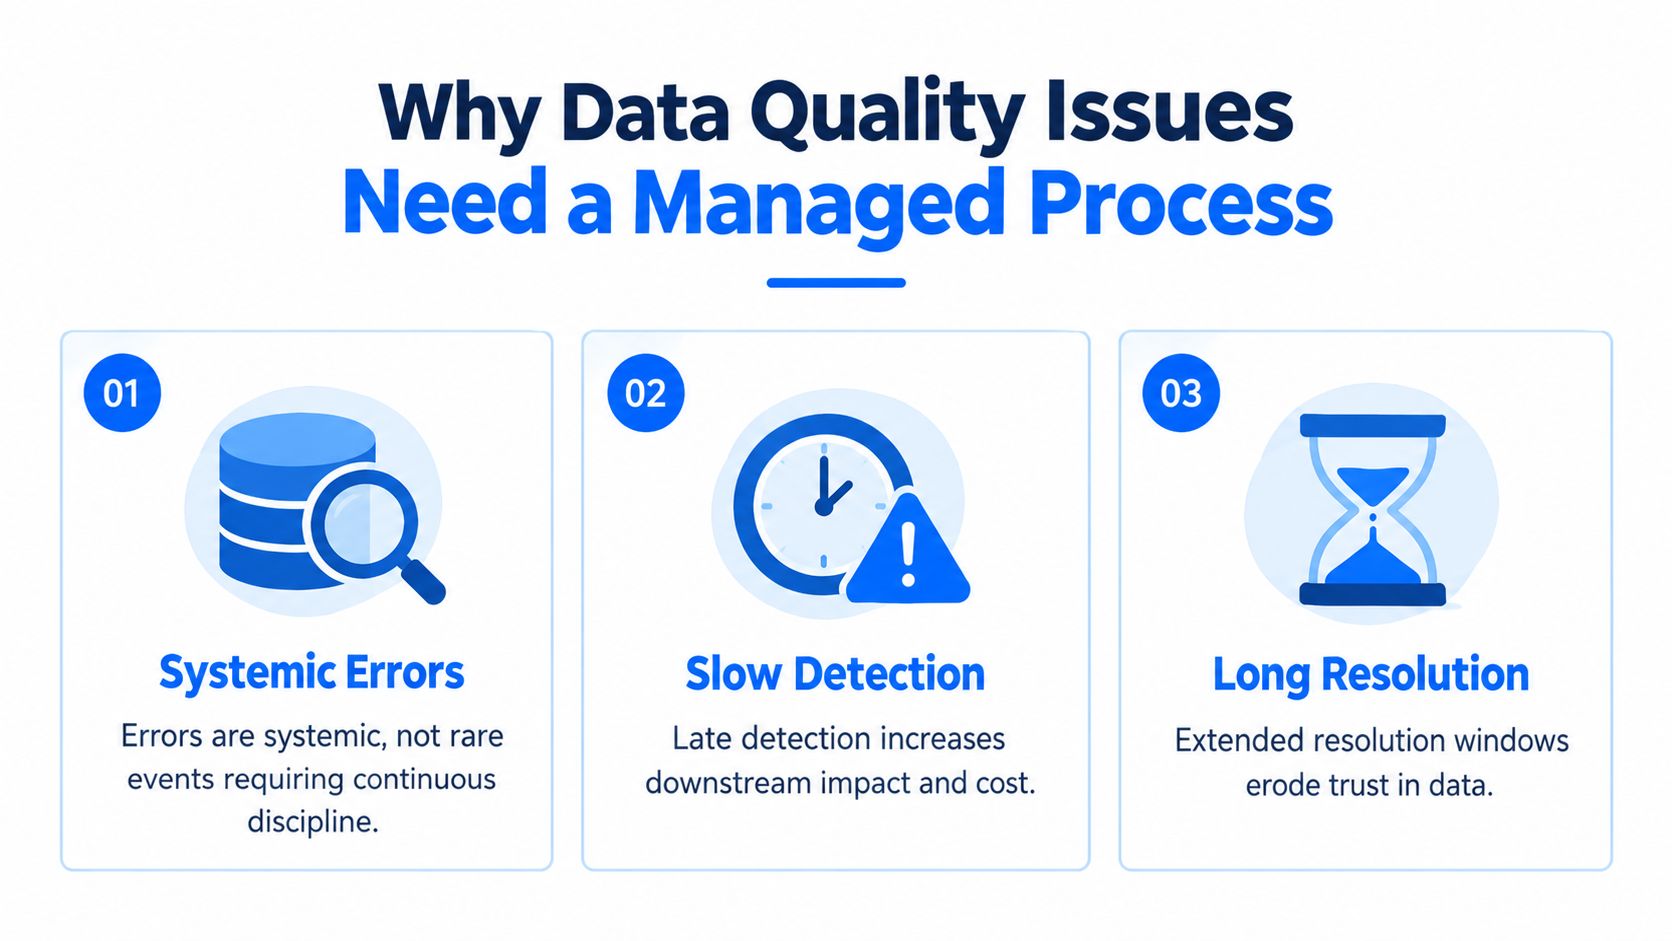
Diese Unterscheidung zählt. Ein gesteuerter Prozess für das Management von Datenqualitätsproblemen ist nicht nur ein Weg, schlechte Datensätze schneller zu fangen. Er setzt Verantwortung, Schweregrade, SLAs, Eskalationswege und Vorbeugearbeit, damit dieselbe Mangelklasse nicht unter neuer Ticketnummer zurückkehrt.
Forschung zur Unternehmenswirkung zeigt, warum Ad-hoc-Behandlung im großen Maßstab scheitert. Schlechte Datenqualität wurde mit durchschnittlichen jährlichen Kosten von 12,9 Millionen US-Dollar je Organisation beziffert, und Forschung der MIT Sloan berichtete in manchen Kontexten von 15 % bis 25 % jährlichem Umsatzrückgang durch schlechte Datenqualität, wie in diesen Statistiken zur Verbesserung der Datenqualität zusammengefasst. Dieselbe Zusammenfassung nennt einen viel zitierten Befund der Harvard Business Review, wonach nur 3 % der Unternehmensdaten grundlegende Qualitätsstandards erfüllten, sowie den Befund von MIT Sloan und Thomas Redman, dass 47 % der neu erstellten Datensätze mindestens einen kritischen Fehler enthielten.
Ad-hoc-Korrekturen scheitern an der Verantwortungsgrenze
Die erste Korrektur ist oft der leichte Teil. Schwer ist zu entscheiden, wer die Ursache verantwortet, wer die Kommunikation nach unten verantwortet, welche Reaktionszeit das Geschäft erwarten darf und welche Änderung die Wiederholung verhindert.
Ohne diese Regeln optimieren Teams auf Schließen statt auf Lösen. Eine Person flickt ein Modell. Eine andere unterdrückt den Alarm. Niemand aktualisiert die Schwelle, ergänzt einen Vertragstest oder benennt eine dauerhafte Verantwortung für das Quellsystem. Der Vorgang verschwindet aus der Warteschlange und bleibt im System.
Praktische Regel: Kann ein Mangel wiederkehren, benennen Sie Verantwortliche, definieren Sie ein Reaktionsziel und entscheiden Sie, welche Kontrolle ihn früher gefangen hätte.
Deshalb sollte das Problemmanagement als Betriebsmodell behandelt werden. Erkennung ist ein Teil davon. Der Rest ist Prozessdisziplin: ein Vorgang je zugrunde liegendem Mangel, klare Schweregradkriterien, SLA-Uhren, Übergaben, die nicht in Slack stecken bleiben, und eine Vorbeugeschleife, die Änderungen an Code, Tests, Metadaten oder Quellsystemverhalten hervorbringt.
Ich habe Teams erlebt, die mehr Zeit mit der Debatte verbracht haben, ob ein Problem „wirklich Datenqualität“ sei, als mit der Entscheidung, wer es beheben muss. Das heißt meist, dass dem Prozess eine gemeinsame Arbeitseinheit und eine Serviceerwartung fehlen. Das Ergebnis ist vertraut. Alarmmüdigkeit steigt, Verantwortung verschwimmt, und Fachnutzerinnen pflegen eigene Tabellen, weil sie ihren manuellen Prüfungen mehr trauen als der Plattform.
Gesteuerter Prozess heißt messbarer Prozess
Ein Team kann nicht verbessern, was es nicht einheitlich zählt. Wird jede fehlgeschlagene Prüfung zum eigenen Vorfall, wirkt die Warteschlange schlimmer, als sie ist. Protokollieren Teams nur vorstandssichtbare Probleme, wirkt sie gesünder als die Wirklichkeit. Beides verzerrt die Priorisierung.
Nützlich ist die operative Sicht. Messen Sie die Vorgangsrate gegen eine definierte Einheit und verfolgen Sie dann die SLA-Leistung nach Schweregrad, Quelldomäne und Klasse wiederkehrender Vorgänge. Das zeigt, ob das Problem bei der Erkennungsabdeckung, der Triage-Disziplin, schwacher Verantwortung oder wiederholten vorgelagerten Mängeln liegt. Es gibt Datenverantwortlichen auch bessere Argumente für Investitionen, als zu sagen, Datenqualität „fühle sich schlecht an“.
Diese Begründung beginnt oft mit einer breiteren Erklärung dazu, warum Datenqualität für eine Organisation wichtig ist, doch der tägliche Gewinn ist einfacher. Weniger doppelte Tickets. Kürzere Zeit bis zur Bestätigung. Schnelleres Weiterleiten an die Verantwortlichen. Mehr Korrekturen, die das Fehlermuster beseitigen, statt seine Symptome aufzuräumen.
Was wirkt, ist selten spektakulär. Klare Schwellen. Benannte Verantwortliche. SLA-gestützte Reaktionsziele. Eskalationsregeln, die greifen, bevor die Geschäftsleitung es bemerkt. Maßnahmen nach dem Vorfall, die das System verändern.
Was als Datenqualitätsproblem gilt und wie man es misst
Teams beginnen zu spät. Sie springen in die Triage, bevor sie sich einig sind, was ein Vorgang ist.
Das ist ein Fehler, denn Ihre Kennzahlen brechen in dem Moment zusammen, in dem verschiedene Teams Verschiedenes zählen. Ein Team behandelt jede fehlgeschlagene Prüfung als Vorgang. Ein anderes protokolliert nur geschäftsseitige Vorfälle. Ein drittes öffnet fünf Tickets für einen vorgelagerten Mangel, weil fünf nachgelagerte Modelle scheiterten. Diese Warteschlange lässt sich schlecht steuern, weil Sie nicht dieselbe Fehlereinheit messen.
Definieren Sie das Problem, bevor Sie den Ablauf definieren
Eine praktische Methodik zählt ein Datenqualitätsproblem als eines von drei Dingen: eine fehlgeschlagene Qualitätsprüfung über der Schwelle, eine Verletzung von Frische oder SLA, oder einen bestätigten Vorfall. Ausgeschlossen bleiben Fehlalarme und Jobfehler ohne Datenqualitätsbezug, gemäß dieser Methodik zur Problemrate.
Der Schwellenteil zählt. Eine nationale Leitlinie zum Datenqualitätsmanagement sagt, jede Kennzahl solle eine Akzeptanzschwelle haben, ausgedrückt entweder als Prozentwert oder als Anzahl von Datensätzen, und fasst Problemmanagement als fortlaufenden Prozess des Erkennens, Verfolgens und Lösens über die Organisation hinweg. In der Praxis heißt das: „es gibt leere E-Mail-Felder“ ist beschreibend, „leere E-Mail-Felder haben die akzeptierte Schwelle überschritten“ ist operativ.
Wählen Sie den Nenner, der zu Ihrer Reife passt
Beim Nenner entscheidet sich, ob Teams eine nützliche Kennzahl oder eine Schaufensterzahl erzeugen. Überwachen Sie viele Prüfungen, kann „fehlgeschlagene Prüfungen je ausgeführte Prüfungen“ funktionieren. Beobachten Sie nur eine Menge kritischer Assets, ist „Vorgänge je überwachtem Datensatz“ oft sauberer. Ist Ihre Umgebung stark batch-orientiert und volumenstark, kann die Vorgangsdichte je verarbeiteter Datensätze sinnvoller sein.
Messgrundlage | Wann Sie sie nutzen | Beispielkennzahl |
|---|---|---|
Prüfungsbasiert | Sie führen viele automatisierte Prüfungen über Pipelines und Tabellen aus | Quote fehlgeschlagener Prüfungen |
Datensatzbasiert | Sie überwachen eine kuratierte Liste kritischer Datensätze | Vorgänge je überwachtem kritischem Datensatz |
Volumenbasiert | Sie verarbeiten große Satzmengen und wollen Dichte verfolgen | Vorgänge je 1 Million verarbeiteter Datensätze |
Es geht nicht darum, den universell besten Nenner zu finden. Es geht darum, einen zu wählen, der abbildet, wie Ihre Plattform arbeitet, und ihn lange genug stabil zu halten, um Trends zu vergleichen.
Bereinigen Sie die Eingaben, bevor Sie den Ergebnissen trauen
Bevor Sie Vorgangskennzahlen berechnen, führen Sie die Betriebsdaten zusammen, die belegen, was geschah. Dazu gehören meist:
Prüfergebnisse: Validierungsfehler, Anomalieausgaben, Frischeverletzungen.
Pipeline-Logs: Ausführungsstatus, Wiederholungen, Fehler vorgelagerter Abhängigkeiten.
Ticketdaten: Eröffnet, bestätigt, abgemildert, gelöst, wiedereröffnet.
Lineage-Metadaten: Was vorgelagert brach und welche Konsumenten es geerbt haben.
Dann die unglamouröse Arbeit:
Verwandte Alarme entdoppeln, damit aus fünf nachgelagerten Fehlern zu einem Quellmangel ein Vorgang wird.
Ursachenkategorien vereinheitlichen, damit „Schemadrift“, „später Quellextrakt“ und „falsche Referenzzuordnung“ jedes Mal dasselbe bedeuten.
Vorgangserzeugung von Vorgangsbestätigung trennen, wenn Ihre Alarmschicht laut ist.
SLA-Ergebnisse erst verfolgen, wenn die Vorgangstaxonomie stabil ist.
Eine Kennzahl, die Sie nicht Monat für Monat vergleichen können, ist keine Steuerungskennzahl. Sie ist eine Momentaufnahme.
Teams, die Dimensionen und Schwellen schärfen, hilft es, Vorgangsdefinitionen an den zentralen Dimensionen der Datenqualität auszurichten und dann klare Abnahmekriterien an jede zu hängen. Das gibt Engineering, Analytik und Fachverantwortlichen dieselbe Sprache, bevor die Vorfallswarteschlange in Bewegung gerät.
Der Ablauf im Management von Datenqualitätsproblemen, von Erkennung bis Vorbeugung
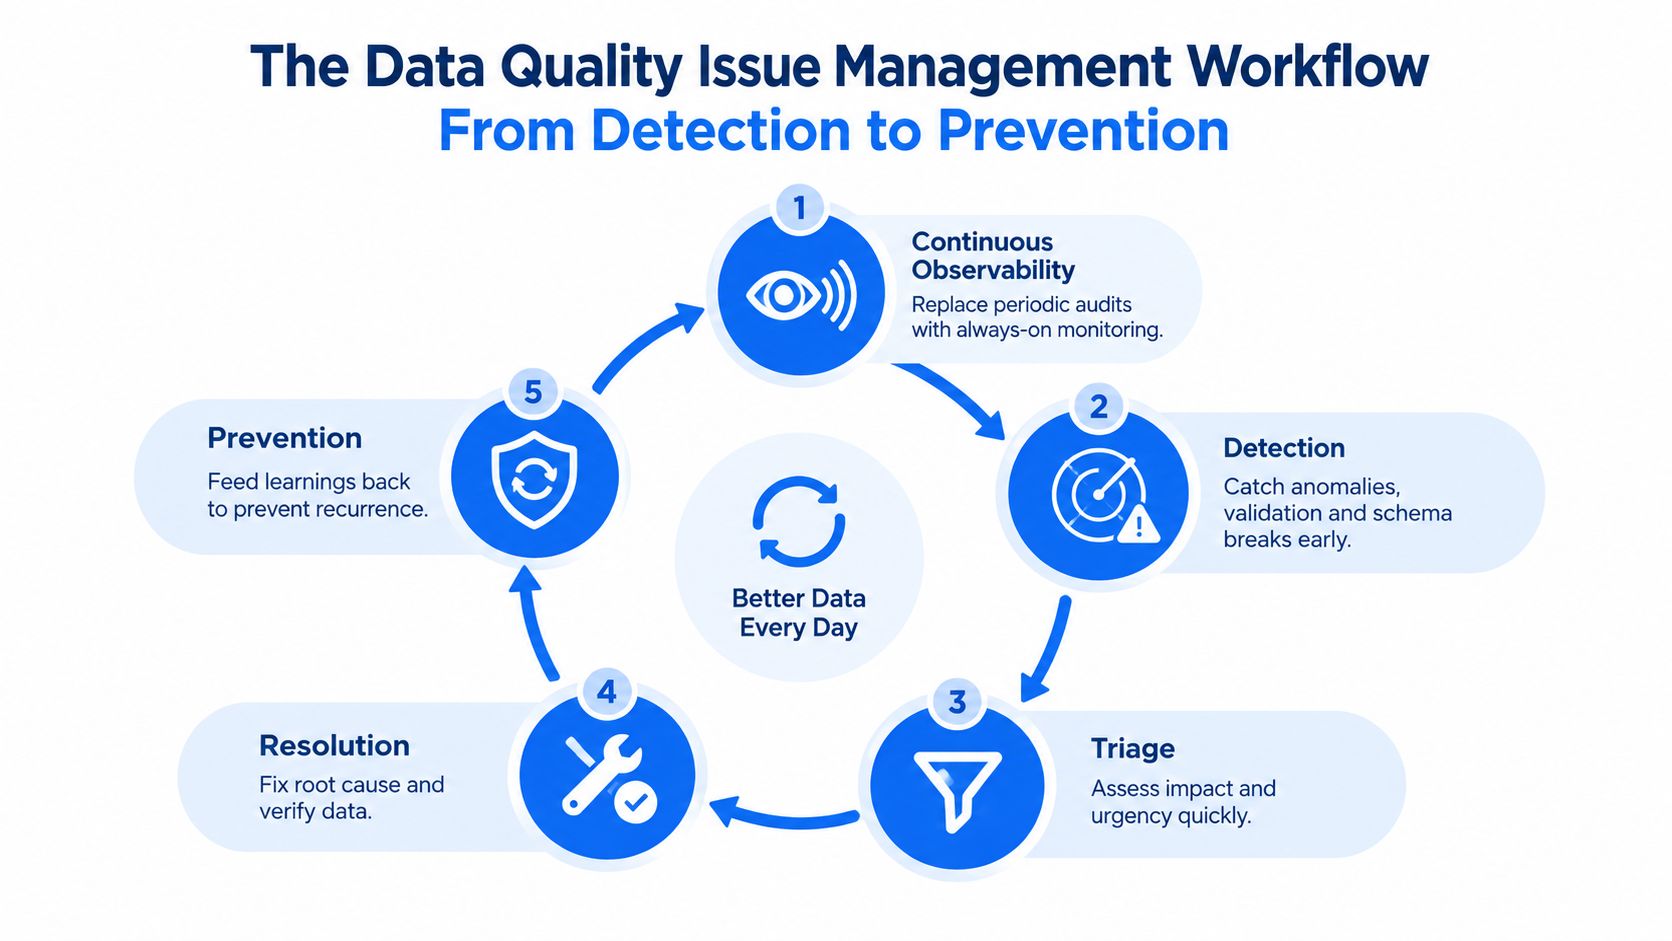
Um 8:15 Uhr öffnet die Finanzabteilung vor dem Monatsabschluss ein Dashboard, und die Zahlen von gestern fehlen. Der Ingestion-Job war technisch erfolgreich. Das Warehouse läuft. Die BI-Schicht liefert veraltete Daten, weil ein vorgelagerter Extrakt drei Stunden zu spät kam und niemand die Frischeprüfung verantwortete. So sieht ein schwacher Problemablauf in der Produktion aus. Der Fehlschlag ist nicht nur die Erkennung. Es ist das fehlende Betriebsmodell, das Überwachung, Verantwortung, Reaktionsziele und Vorbeugung verbindet.
Beginnen Sie mit Observability, die handlungsfähige Vorgänge erzeugt
Problemmanagement beginnt, bevor ein Ticket existiert. Teams brauchen Signale, die sagen, was scheiterte, wann es scheiterte, was sich änderte und wer betroffen ist.
Periodische Durchsichten können das nicht leisten. Produktionsmängel treten zwischen Prüfzyklen auf, und bis jemand es bemerkt, haben nachgelagerte Tabellen, Dashboards oder Modelle die schlechten Daten bereits konsumiert. Gutes Monitoring und Reporting für Datenqualitätsbetrieb verkürzt die Lücke zwischen dem Entstehen eines Mangels und der menschlichen Reaktion.
Die nützlichen Signale fallen meist in vier Gruppen:
Frische und Timeliness: fehlende Ladevorgänge, späte Lieferungen, unvollständige Batch-Ankunft
Validierungsfehler: Pflichtfelder, zulässige Werte, Eindeutigkeit, Abstimmungsregeln
Strukturelle Änderungen: hinzugefügte Spalten, entfernte Spalten, Typänderungen, Vertragsverletzungen
Verhaltensverschiebungen: Volumenspitzen, veränderte Null-Raten, Verteilungsdrift, unerwartete Kennzahlenbewegung
Der Kompromiss ist einfach. Mehr Prüfungen fangen mehr Mängel, erzeugen aber auch mehr Rauschen. Teams, die alles mit derselben Empfindlichkeit überwachen, trainieren Reagierende meist darauf, Alarme zu ignorieren. Ziel ist es, Vorgänge zu erzeugen, die Bearbeitung verdienen, keine Warteschlange voller Fehlalarme.
Trennen Sie Erkennung von Bestätigung
Eine fehlgeschlagene Prüfung ist ein Ereignis. Ein Vorgang ist ein bestätigtes Ereignis mit Umfang, Wirkung und Verantwortlichen.
Diese Unterscheidung zählt, weil Alarmströme laut sind. Eine Schemaänderung in einer Sandbox-Tabelle sollte nicht mit einem kaputten Umsatzfeed konkurrieren. Erzeugt der Prozess für jede Anomalie ohne Bestätigung ein Ticket, verbringt das Team den Tag mit dem Schließen von Rauschen und verpasst den Vorfall, der Berichtsfristen oder kundenseitige Produkte trifft.
GitLab dokumentiert eine praktische Abfolge in seinem Handbuch zum Datenqualitätsprogramm: Erkennung → Triage und Bestätigung → Untersuchung → Behebung → Vorbeugung → Geschlossen. Der Wert dieses Flusses ist das Entscheidungstor. Bevor ein Vorgang in die Hauptwarteschlange kommt, bestätigt jemand, dass er echt ist, prüft, ob Konsumenten betroffen sind, und entscheidet, ob er in den Vorfallspfad oder das Standard-Backlog gehört.
Dieser Schritt verbessert auch die Messung. Das Erkennungsvolumen sagt Ihnen, wie laut das System ist. Das bestätigte Vorgangsvolumen sagt Ihnen, was Betreiberinnen bearbeiten müssen. Beides zu verfolgen ist der Weg, schwache Schwellen und aufgeblähte Vorgangsraten zu erkennen.
Die Untersuchung sollte den Mangel bis zum Kontrollpunkt verfolgen
Die Behebung verlangsamt sich, wenn Teams dem sichtbaren Symptom statt der Quelle nachjagen. Ich sehe das oft bei nachgelagerten Brüchen. Ein Dashboard scheitert, also flickt man BI-Logik, obwohl der eigentliche Fehler in einem vorgelagerten Extrakt, einer Codeänderung im Quellsystem oder einer Scheduler-Abhängigkeit sitzt.
Einige Muster tauchen immer wieder auf:
Späte Daten: Das veraltete Dashboard ist das Symptom. Die Ursache ist meist eine vorgelagerte Verzögerung, ein Retry-Sturm oder ein Abhängigkeitsfehler.
Schemadrift: Das Warehouse-Modell bricht, nachdem eine Quelle einen Typ ändert oder ein Feld entfernt.
Verletzung einer Geschäftsregel: Eine Zuordnungstabelle oder ein Referenzfeed akzeptiert einen neuen Wert, den keine nachgelagerte Regel erwartet.
Das Australian Bureau of Statistics legt in seinem Handbuch zu Qualitätsvorfallsmanagement und Berichterstattung einen gestuften Prozess dar: Qualität überwachen, das Problem erkennen, es bewerten, den passenden Berichtsweg einleiten, dann Korrekturmaßnahmen bewerten und umsetzen. Diese Abfolge hält in der Praxis, weil die Bewertung ausdrücklich ist. Teams, die sie überspringen, neigen dazu, harmlose Anomalien zu übereskalieren oder Mängel zu unterschätzen, die sich über mehrere Konsumenten ausbreiten.
Die Behebung ist erst abgeschlossen, wenn das Vertrauen wiederhergestellt ist
Den technischen Fehler zu schließen ist nur ein Teil der Arbeit. Die Frage ist, ob Konsumenten den Daten wieder trauen können.
Ein tragfähiger Behebungsfluss umfasst meist vier Schritte:
Eindämmung. Einen Konsumenten pausieren, ein kaputtes Dashboard unterdrücken, eine Transformation zurückrollen oder fehlerhafte Datensätze isolieren.
Korrektur. Den Fehler in der Schicht beheben, die den Mangel eingeführt hat.
Verifikation. Prüfungen erneut laufen lassen, Schlüsselergebnisse abstimmen und bestätigen, dass nachgelagerte Daten sich erholt haben.
Kommunikation. Betroffenen sagen, was falsch war, was korrigiert wurde und ab welchem Zeitstempel die Daten sicher nutzbar sind.
GitLabs Handbuch zum Vorfallsmanagement ist hier nützlich, weil es Datenvorfälle als operative Ereignisse behandelt, die strukturierte Zuweisung, Dokumentation und Kommunikation verlangen. Das ist ein besseres Muster, als sich auf einen langen Slack-Thread zu verlassen, den später niemand prüfen kann.
Vorbeugung schließt die Schleife und belegt, dass der Prozess wirkt
Vorbeugung gehört in den Ablauf, nicht dahinter. Kehrt dieselbe Mangelklasse immer wieder, hat das Team kein Erkennungsproblem. Es hat ein Problem im Entwurf der Kontrollen.
Die Lösung kann eine strengere Validierungsregel bei der Ingestion sein, ein Datenvertrag für eine schwankende Quelle, ein Frische-SLO mit ausdrücklicher Verantwortung oder eine Runbook-Aktualisierung, die Mehrdeutigkeit bei der Übergabe beseitigt. Die richtige Wahl hängt davon ab, wo der Vorgang ins System kam und wie teuer es ist, ihn früher zu fangen.
Hier wird Problemmanagement auch zum Betriebsmodell. Messen Sie die Wiederholungsrate nach Ursachenkategorie. Messen Sie, wie viele Vorgänge das SLA für Bestätigung, Abmilderung und Behebung erreichen. Messen Sie die Wiedereröffnungsrate nach Abschluss. Diese Zahlen sagen Ihnen, wo zu investieren ist. Eine Warteschlange mit schnellen Abschlüssen, aber hoher Wiederholung braucht meist stärkere vorbeugende Kontrollen. Eine Warteschlange mit geringer Wiederholung, aber schwacher SLA-Leistung hat meist Probleme bei Verantwortung oder Weiterleitung.
Wie man unter SLAs triagiert, priorisiert und Verantwortung zuweist
Um 9:07 Uhr meldet die Finanzabteilung, dass das Umsatz-Dashboard von gestern um 18 Prozent gefallen ist. Die Dashboard-Verantwortliche sieht das Symptom, doch der Mangel sitzt drei Sprünge vorgelagert in einem verspäteten Quellextrakt, und die Regel zum Ausschluss von Testtransaktionen ist weiterhin undokumentiert. Ohne Triage-Modell beginnen drei Teams zu untersuchen, niemand verantwortet die Uhr, und das Geschäft bekommt Statusmeldungen ohne Wiederherstellungszeit.
Das ist die Aufgabe dieser Stufe. Setzen Sie den Schweregrad schnell, benennen Sie direkt Verantwortliche und hängen Sie Reaktions- und Behebungsziele an den Vorgang, damit er nicht in einer geteilten Warteschlange treibt.
Nutzen Sie Schweregrade, um Abwägungen sichtbar zu machen
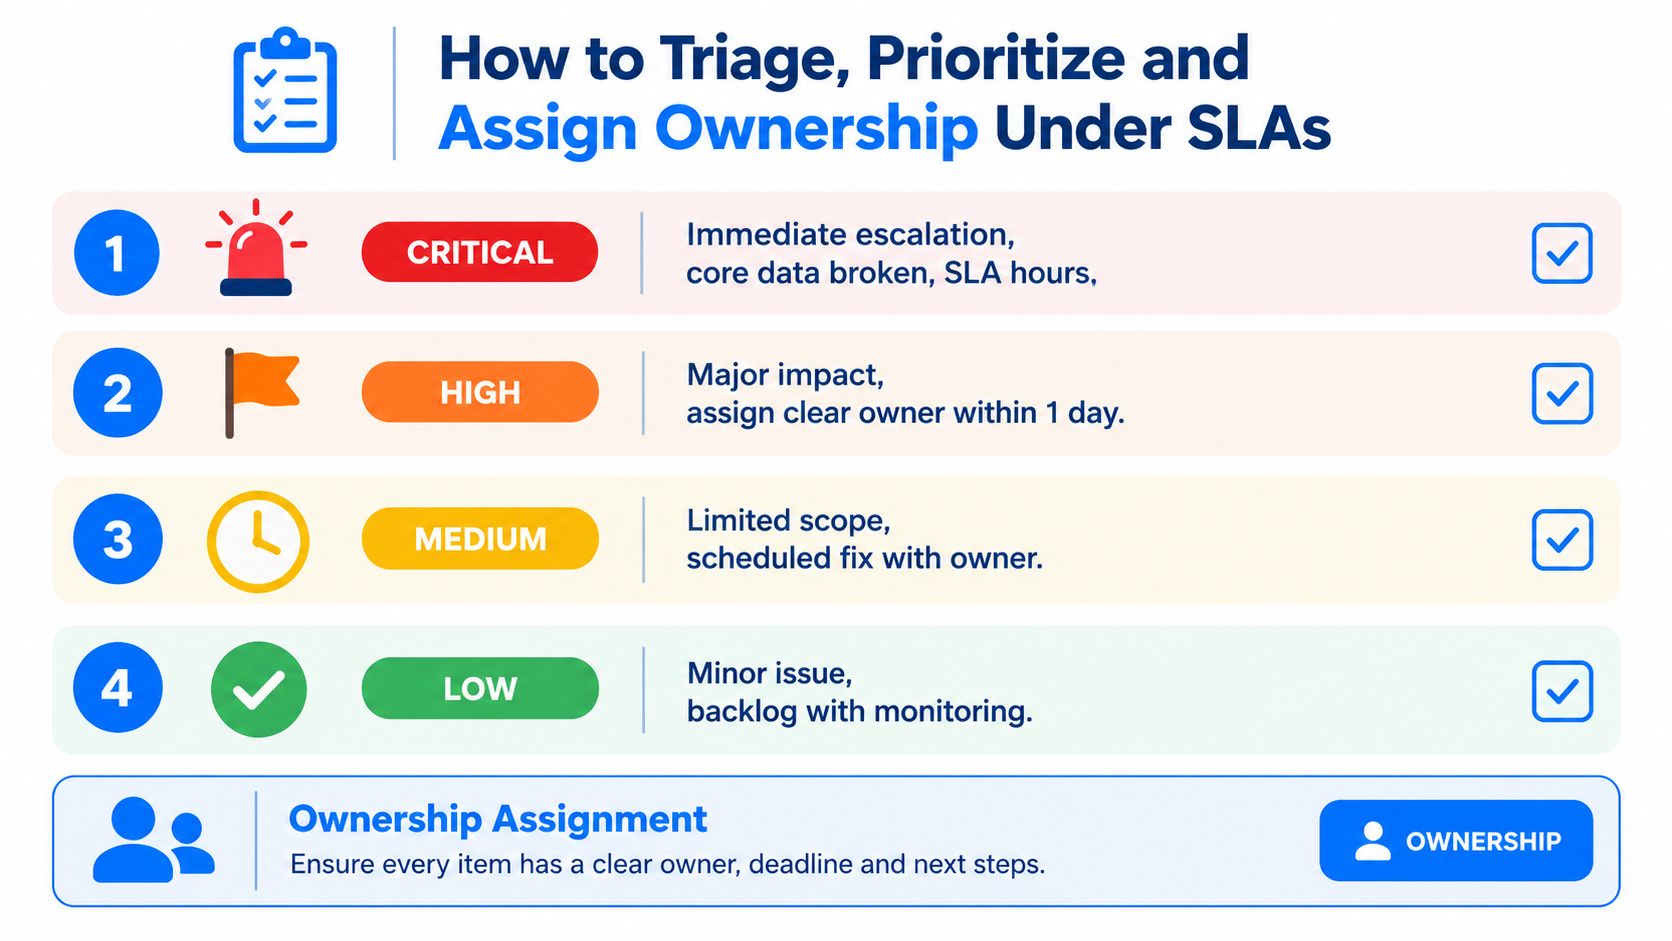
Der Schweregrad sollte eine Frage beantworten: Wie viel Geschäftsrisiko sind wir bereit zu tragen, bis das behoben ist?
Ein praktisches Modell nutzt getrennte Ziele für Bestätigung, Abmilderung und endgültige Behebung. Teams arbeiten oft mit Reaktionsfenstern in Stunden für höhere Schweregrade, Abmilderung in Tagen und vollständiger Behebung auf längerer Uhr, wenn die dauerhafte Lösung Codeänderungen, Abstimmung mit Quellteams oder Nachladungen verlangt. Die genauen Ziele zählen weniger als die Einheitlichkeit. Bedeutet „hohe Priorität“ für ein Team denselben Tag und für ein anderes den nächsten Sprint, ist das SLA Rauschen.
Setzen Sie den Schweregrad aus drei Faktoren:
Geschäftswirkung: Welche Entscheidungen, Berichte, Modelle oder Kundenabläufe sind betroffen?
Ausbreitung: Wie weit hat sich der Vorgang durch nachgelagerte Tabellen und Dashboards fortgepflanzt?
Kontrollrisiko: Berührt er regulierte Ergebnisse, Vorstandsberichte, Abrechnung oder extern sichtbare Kennzahlen?
Halten Sie das Modell klein. Vier Stufen reichen meist. Mehr erzeugt Debatte, ohne die Weiterleitung zu verbessern.
Weisen Sie die Verantwortung der Behebungsdomäne zu
Das Team, das den Vorgang zuerst bemerkt, ist selten das richtige verantwortliche. Richtig ist das Team, das die scheiternde Kontrolle, den Codepfad oder das Quellverhalten ändern kann.
Nutzen Sie ein Weiterleitungsmodell wie dieses:
Schweregrad | Typische Bedingung | Primär verantwortlich | Eskalationsweg |
|---|---|---|---|
Kritisch | Kernprodukt der Daten gebrochen oder sofortige Geschäftswirkung | Datenplattform oder verantwortliche Person im Domain Engineering | Vorfallskanal und Benachrichtigung der Leitung |
Hoch | Große nachgelagerte Wirkung, aber begrenzte Ausbreitung | Datensatzverantwortliche mit Engineering-Unterstützung | Formales Vorfalls-Review, wenn die Abmilderung stockt |
Mittel | Eingegrenzter Vorgang mit verfügbarem Workaround | Analytics Engineering oder Steward | Geplante Behebung mit Nachverfolgung |
Niedrig | Kosmetischer, wirkungsarmer oder isolierter Mangel | Backlog-Verantwortliche | Trend beobachten und bei Wiederholung erneut prüfen |
Das räumt eine verbreitete Verantwortungslücke auf. Plattformteams verantworten Pipelines und Kontrollen. Anwendungsteams verantworten das Verhalten der Quellsysteme. Fachverantwortliche verantworten Regelabsicht und Abnahmekriterien. Alle drei können beteiligt sein, doch eine Person muss die SLA-Uhr, die Statusmeldungen und den nächsten Schritt verantworten.
Hat die Regelabsicht keine Verantwortlichen, erfinden Engineers unter Druck welche.
Priorisieren Sie mit Blick auf die Kapazität
Vorfallswarteschlangen scheitern, wenn jeder rote Alarm gleich dringend behandelt wird. Kapazität ist begrenzt. Manche Mängel verdienen sofortige Unterbrechung. Andere sind günstiger einzudämmen, zu dokumentieren und in geplanter Arbeit zu beheben.
Forschung zur Datenqualitätspraxis hat zersplitterte Verantwortlichkeit und uneinheitliche Steuerung als wiederkehrende Ursachen schlechter Ergebnisse benannt, in dieser Studie zu systemischen Problemen. Forschung im Gesundheitswesen nannte zudem unklare Maßnahmenpläne, begrenzte Ressourcen und schwache Schulung als Hürden in der veröffentlichten Umfragebesprechung. Diese Befunde passen zu dem, was in Produktionswarteschlangen auftaucht. Teams fehlen meist nicht die Alarme. Ihnen fehlt ein einheitlicher Weg zu entscheiden, was die laufende Arbeit unterbricht.
Nutzen Sie vier Triage-Fragen:
Was bricht, wenn das bis morgen oder nächste Woche wartet?
Wer konsumiert die betroffenen Daten als Nächstes, und welche Entscheidung trifft er damit?
Können wir den Vorgang mit Rollback, Quarantäne, Anmerkung oder temporärem Filter eindämmen?
Ist die Wiederholung häufig genug, dass Vorbeugearbeit eine weitere Einzelkorrektur schlagen sollte?
Die letzte Frage zählt. Ein Vorgang mittleren Schweregrads, der sich wöchentlich wiederholt, verdient meist mehr Aufmerksamkeit als ein einzelner gut sichtbarer Mangel, der kaum wiederkehren wird.
Führen Sie die Warteschlange gegen messbare SLAs
Ein einziger Eingangsweg hilft, doch Warteschlangenhygiene ist nur ein Teil des Betriebsmodells. Verfolgen Sie, ob das Team Ziele für Bestätigung, Abmilderung und Behebung nach Schweregrad erreicht. Verfolgen Sie die Wiedereröffnungsrate. Verfolgen Sie die Vorgangsrate nach Datensatz, Domäne und Ursachenkategorie. Diese Kennzahlen zeigen, ob das Problem schlechte Weiterleitung, schwache Kontrollen oder chronische Unterinvestition in einem Quellbereich ist.
Nutzen Sie diese Zahlen, um Prioritäten anzupassen. Eine Warteschlange mit ordentlichen Behebungszeiten, aber schwacher Bestätigung hat meist Probleme bei Alarmierung oder Bereitschaftsabdeckung. Eine Warteschlange, die Reaktions-SLAs erfüllt, aber die endgültige Behebung verfehlt, hat oft Reibung in der teamübergreifenden Verantwortung. Teams, die diese Serviceziele klarer setzen und prüfen wollen, sollten sie zusammen mit Praktiken zur Messung von Zuverlässigkeit definieren, damit Vorgangsrate und SLA-Leistung gemeinsam und nicht in getrennten Dashboards geprüft werden.
Eine Warteschlange. Eine Schweregradentscheidung. Eine verantwortliche Person auf der Uhr. Das macht aus dem Management von Datenqualitätsproblemen ein Betriebsmodell statt reaktiver Triage.
Den Prozess in Werkzeuge, Rollen und den Alltagsbetrieb einbetten
Ein dokumentierter Ablauf überlebt den Kontakt mit der Produktion nur, wenn er in den Werkzeugen steckt, die Menschen ohnehin nutzen.
Das heißt, Ihr Qualitätsprozess muss dort leben, wo die Warehouse-Jobs laufen, wo Analystinnen Ergebnisse prüfen und wo Governance Trend- und Vorfallshistorie sehen kann. Wenn Sie ein separates Qualitätssilo mit eigenen Dashboards, Taxonomien und Nutzerlisten anschrauben, zersplittert die Verantwortung meist binnen eines Quartals.
Bauen Sie um eine operative Sicht herum
Das praktische Muster ist geradlinig. Lassen Sie Anomalieerkennung, Validierung, Timeliness-Überwachung und Schema-Tracking gegen dieselben kritischen Datensätze laufen. Speisen Sie diese Signale in ein gemeinsames Dashboard. Verbinden Sie das Dashboard mit Scheduling-Kontext, Metadaten, Lineage und Ticketing, damit Reagierende vom Alarm zur Handlung kommen, ohne Belege von Hand zusammenzusuchen.
Die zentrale Entwurfsentscheidung ist das Ausführungsmodell. Prüfungen in der Datenbank senken die Datenbewegung und erleichtern die Sicherheitsprüfung, besonders in regulierten Umgebungen. Sie halten die Überwachungslogik zudem näher an den Tabellen und Transformationen, die geprüft werden müssen.
Rollen brauchen gemeinsamen Kontext, keine getrennten Werkzeuge
Verschiedene Rollen interessieren sich für verschiedene Fehlersignale:
Data Engineers wollen Pipeline-Status, Frische, Wiederholungen und Schemabrüche.
Analytics Engineers und BI-Entwicklerinnen kümmern sich um Verletzungen von Geschäftsregeln, Symptome von Modelldrift und kaputte semantische Ergebnisse.
Governance- und Datenqualitätsverantwortliche brauchen Schwellen, Trends, Abnahmestatus und auditfähige Nachweise.
Arbeiten diese Gruppen jeweils aus einem anderen System, verlangsamt sich die Triage, weil jeder Vorgang mit Abgleich beginnt. Besser ist gemeinsame Sicht mit rollenspezifischen Ansichten. Die Plattform kann denselben Vorfall über technische Logs für Engineering und über Zusammenfassungen zur Geschäftswirkung für nichttechnische Verantwortliche zeigen.
Modulare Einführung schlägt Big-Bang-Rollouts
Die meisten Organisationen müssen nicht am ersten Tag jede Überwachungsfähigkeit ausrollen. Sie sollten meist mit dem Fehlermuster beginnen, das den größten Schmerz verursacht, und dann Abdeckung ergänzen.
Dort zählen Werkzeugentscheidungen. Manche Teams beginnen mit Frische- und Schemaüberwachung, weil diese Mängel am leichtesten zu erkennen und weiterzuleiten sind. Andere starten mit deterministischer Validierung, weil Compliance oder Finanzen ausdrückliche Kontrollnachweise brauchen. In gemischten Umgebungen kann eine modulare Option helfen. So funktionieren etwa Muster zur Umsetzung von Datenqualität oft am besten, wenn der Stack von einer überwachten Domäne auf mehrere wachsen kann, ohne ein neues Betriebsmodell zu erzwingen.
Eine Option dieser Art ist digna, das innerhalb der Kundenumgebung läuft und Anomalieerkennung, Validierung, Timeliness-Überwachung, Schema-Tracking, Scheduler-Unterstützung, Katalogfunktionen, Integrationen und ein gemeinsames Dashboard verbindet. Dieser Aufbau ist nützlich, wenn Teams Ausführung in der Datenbank wollen und Produktionsdaten nicht aus der eigenen Infrastruktur bewegen möchten.
Was operativ hält, ist selten der ausgefallenste Detektor. Es ist der Aufbau, der den Prozess sichtbar hält, die Verantwortung angeheftet lässt und zu der Umgebung passt, die Teams bereits haben.
Wiederkehrende Probleme verhindern und belegen, dass der Prozess wirkt
Eine Warteschlange, die Tickets schließt, aber dieselben Fehlermuster immer wieder öffnet, ist nicht reif. Sie ist beschäftigt.
Der Beleg, dass Ihr Prozess wirkt, ist einfach. Die Erkennung wird schneller. Die Behebung wird sauberer. Wiederkehrende Mängel sinken. Stakeholder streiten nicht mehr darüber, ob sie einem Bericht trauen können, weil Vorfallshistorie, Behebungsnachweis und Akzeptanzschwellen sichtbar sind.
Vorbeugung braucht Änderungen nach dem Vorfall
Jeder bedeutsame Vorfall sollte eine dauerhafte Verbesserung hinterlassen. Vielleicht eine neue Schwelle, eine fehlende Validierungsregel, einen Schemavertrag oder eine straffere Übergabe der Verantwortung. Hält der Abschluss nur fest, was brach, hat das System nichts gelernt.
Die nützlichsten Nachbetrachtungen konzentrieren sich darauf, Ursachen zu erkennen mit genug Präzision, um Kontrollen zu ändern, nicht bloß Symptome zu beschreiben. Braucht Ihr Team dafür eine praktische Referenz, lohnt sich diese Sammlung zum Erkennen von Ursachen im Runbook.
Die richtige Frage nach der Behebung lautet nicht „wer hat es repariert?“. Sie lautet „was hat sich geändert, damit uns dieses Problem nächste Woche nicht wieder begegnet?“
Verfolgen Sie die Kennzahlen, die Verhalten ändern
Die Kennzahlen, die es vor Teams zu halten lohnt, sind jene, die die Reaktionsqualität beeinflussen:
Erkennungszeit: wie lange der Mangel bestand, bevor das Team davon wusste.
Behebungszeit: wie lange das Geschäft exponiert blieb.
SLA-Erfüllung: ob Reaktion, Abmilderung und Abschluss das Ziel erreichten.
Wiederholungsrate: ob dieselbe Ursachenkategorie immer wieder zurückkehrt.
Geschäftsexposition: welche kritischen Berichte, Prozesse oder Entscheidungen betroffen waren.
Sie brauchen keine riesige Scorecard. Sie brauchen eine stabile. Wenn Teams sehen, dass eine Domäne wiederholt Frischeziele verfehlt oder eine Klasse von Schemaänderungen oft wieder aufgeht, wird Vorbeugearbeit leichter zu begründen.
Ein kurzer Reifecheck
Nutzen Sie das als groben Selbsttest:
Vorgangsdefinition existiert: Teams sind sich einig, was als Vorgang zählt und was nicht.
Schwellen sind dokumentiert: Kennzahlen werden erst handlungsfähig, wenn sie akzeptierte Grenzen überschreiten.
Schweregrade sind vereinheitlicht: Die Priorität hängt nicht davon ab, wer Bereitschaft hat.
Verantwortung ist ausdrücklich: Jeder Vorgang hat eine verantwortliche Person und einen Eskalationsweg.
Der Abschluss enthält Vorbeugung: Korrekturen aktualisieren Regeln, Basislinien, Verträge oder Runbooks.
Nachweise bleiben erhalten: Sie können zeigen, was geschah, wer reagierte, was sich änderte und ob SLAs erfüllt wurden.
Sind auch nur zwei davon schwach, ist der Prozess noch brüchig. Das ist normal. Teams brauchen keine neue Philosophie. Sie brauchen weniger mehrdeutige Übergaben und bessere operative Disziplin rund um die Mängel, die sie ohnehin kennen.
Wenn Ihr Team verstreute Prüfungen in ein echtes Betriebsmodell verwandeln will, ist digna für diese Art Arbeit gebaut. Es hilft Teams, Anomalien, Timeliness, Validierung und Schemaänderungen innerhalb der eigenen Umgebung zu überwachen, damit Erkennung, Verantwortung und Vorbeugung als ein Prozess statt als vier unverbundene Werkzeuge laufen.
Ein Prozess ist nur so messbar wie die Zahlen dahinter — koppeln Sie diesen Ablauf mit einem tragfähigen Satz an Datenqualitätskennzahlen, damit Abschluss etwas bedeutet.
Häufig gestellte Fragen
Warum scheitern Ad-hoc-Korrekturen?
Sie scheitern an der Verantwortungsgrenze. Jemand flickt ein SQL-Modell, lässt eine Pipeline erneut laufen und erklärt es für behoben, doch niemand verantwortet, ob das Vertrauen wiederhergestellt wurde oder ob derselbe Mangel wiederkehrt. Ein gesteuerter Prozess lässt sich messen; ein Ad-hoc-Prozess nicht.
Was gilt als Datenqualitätsproblem?
Definieren Sie den Vorgang vor dem Ablauf. Nicht jede fehlgeschlagene Prüfung ist ein Vorgang, und nicht jeder Vorgang beginnt als fehlgeschlagene Prüfung — eine unerklärte Kennzahlenbewegung zählt ebenfalls. Wählen Sie einen Nenner, der zu Ihrer Reife passt, und bereinigen Sie die Eingaben, bevor Sie einer daraus berechneten Rate trauen.
Wie sieht der Ablauf von Anfang bis Ende aus?
Erkennung, Bestätigung, Untersuchung, Behebung und Vorbeugung. Erkennung und Bestätigung bleiben bewusst getrennt, denn ein Alarm ist noch kein Vorfall. Die Untersuchung verfolgt den Mangel bis zu seinem Kontrollpunkt, und die Behebung ist unvollständig, solange das Vertrauen nicht wiederhergestellt ist, nicht bloß bis die Daten sich ändern.
Wie sollten Vorgänge triagiert und zugewiesen werden?
Nutzen Sie Schweregrade, um Abwägungen sichtbar zu machen, statt jeden Vorgang als dringend zu behandeln. Weisen Sie die Verantwortung der Behebungsdomäne zu — dem Team, das die Kontrolle tatsächlich ändern kann — nicht dem, der es bemerkt hat. Priorisieren Sie dann mit Blick auf die Kapazität und führen Sie die Warteschlange gegen messbare SLAs.
Wie verhindert man, dass dieselben Probleme wiederkehren?
Vorbeugung verlangt nach dem Vorfall Änderungen an Kontrollen, nicht bloß ein geschlossenes Ticket. Verfolgen Sie Kennzahlen, die Verhalten ändern, etwa die Wiederholungsrate und die Zeit bis zum wiederhergestellten Vertrauen, statt roher Vorgangszahlen, die sinken, sobald Menschen aufhören zu melden.