Data-Warehouse-Monitoring: Der vollständige Leitfaden für 2026
|
7
min. Lesezeit

Der Montagmorgen beginnt hart, wenn das Management-Dashboard veraltete Zahlen zeigt, eine Umsatztabelle verspätet ist und ein Slack-Thread fragt, warum die KPI-Summe nicht mit dem Finance-Team übereinstimmt. Das ist die operative Realität hinter Data-Warehouse-Monitoring, der Arbeit, die verhindert, dass Teams Probleme erst entdecken, nachdem Fachanwender bereits Entscheidungen auf Basis fehlerhafter Daten getroffen haben.
Die Lücke zwischen Anspruch und Wirklichkeit ist nach wie vor groß. Eine gemeinsame Forschungszusammenfassung aus dem Jahr 2023 ergab, dass nur 7 % der Datenteams Probleme lösen, bevor Nutzer die Auswirkungen spüren, 39 % zwischen 20 % und 40 % ihrer Zeit mit der Reparatur von Pipelines verbringen, 51 % einige Stunden für die Lösung eines einzelnen Vorfalls benötigen und 36 % einige Tage oder länger Quellstudie zum Betrieb von Data Observability. Diese Zahlen erklären, warum Monitoring keine nette Zusatzschicht über dem Warehouse mehr ist, sondern Teil dessen, was das Geschäft am Laufen hält.
Der Wandel zeigt sich auch im Markt. Eine Branchenumfrage aus dem Jahr 2026 ergab, dass nur 22 % der Unternehmen Data Observability als kritisch einstufen, weitere 32 % sie als sehr wichtig bezeichnen und nur etwas mehr als ein Drittel sie tatsächlich einsetzt Branchenumfrage zur Observability-Reife. Diese Lücke spricht Bände, denn die meisten Unternehmen brauchen noch mehr Transparenz über Aktualität, Qualität und Fehlermuster, bevor sie Analytics und KI vertrauen können.
Inhaltsverzeichnis
Warum Data-Warehouse-Monitoring jetzt wichtig ist
Ein Warehouse kann von außen gesund wirken und dennoch auf eine Weise versagen, die das Geschäft beeinträchtigt. Finance sieht ein sauberes Dashboard, der Vertrieb eine normale Trendlinie, und dann bemerkt jemand, dass der gestrige Refresh nie angekommen ist oder eine Schemaänderung ein nachgelagertes Modell beschädigt hat. Bis solche Probleme sichtbar werden, verbringen Teams ihren Vormittag bereits damit, Systeme abzugleichen, statt die Daten zu nutzen.
Der Preis des Wartens, bis Nutzer es bemerken
Die schlimmsten Warehouse-Vorfälle scheitern meist nicht lautstark. Eine Tabelle wird verspätet aktualisiert, eine Spalte ändert ihren Datentyp, oder eine Pipeline läuft nur teilweise erfolgreich durch und lässt Fachanwender trotzdem auf veraltete Ergebnisse blicken. Monitoring ist wichtig, weil es solche Zustände erkennt, bevor sie im gesamten Unternehmen zu Vertrauensproblemen werden.
Ältere Betriebsmodelle beruhten auf manuellen Prüfungen und implizitem Teamwissen. Dieser Ansatz bricht zusammen, sobald Dutzende von Domänen, Stakeholdern und Pipelines vom selben Warehouse abhängen.
Praxisregel: Wenn jemand erst ein Dashboard öffnen muss, um zu sehen, ob das Warehouse gesund ist, ist das Warehouse bereits zu schwer zu steuern.
Warum Observability zur operativen Disziplin geworden ist
Die Forschungszusammenfassung von 2023 macht den Zielkonflikt deutlich. Teams reagieren immer noch, nachdem Schaden entstanden ist, statt ihn zu verhindern. Wenn Engineers einen großen Teil ihrer Zeit mit der Reparatur von Pipelines verbringen und trotzdem Stunden oder Tage brauchen, um Vorfälle zu lösen, handelt es sich nicht mehr um einen einmaligen Bug. Es ist das Betriebsmuster.
Deshalb setzen ausgereifte Monitoring-Programme auf frühzeitige Erkennung, klare Verantwortlichkeiten und schnelles Routing. Sie fragen nicht nur, ob ein Job gelaufen ist. Sie fragen, ob die richtigen Daten rechtzeitig angekommen sind, ob sich die Struktur geändert hat, ob die Qualität nachgelassen hat und ob die Business-KPIs noch plausibel sind.
Für Teams, die diesen Kreislauf straffen wollen, sind die Data-Warehouse-Best-Practices von digna ein praktischer Ausgangspunkt. Sie helfen dabei, „wir haben Alerts“ von „wir wissen, was zu tun ist, wenn das Warehouse abdriftet“ zu unterscheiden.
Ein sinnvolles Monitoring-Programm muss außerdem zu realen operativen Zielkonflikten passen. Zu viele Alerts, und die Teams ignorieren sie. Zu wenige Prüfungen, und das erste Anzeichen von Problemen kommt von einem frustrierten Analysten oder einer bereits getroffenen Fehlentscheidung. Die richtige Balance kombiniert klassische Validierung mit Anomalieerkennung, einschließlich In-Database-Ansätzen, die die Prüfungen nah an den Daten halten und die Verzögerung zwischen Fehler und Erkennung verkürzen.
Der Lohn ist Vertrauen. Sobald das Warehouse gezielt überwacht wird, verbringen Data Engineers weniger Zeit mit dem Löschen unerwarteter Brände, Analysten weniger Zeit mit der manuellen Validierung von Extrakten, und Führungskräfte fragen nicht mehr, welche Version der Zahl die richtige ist. Genau das macht das Warehouse im Enterprise-Maßstab nutzbar.
Kernkomponenten des Data-Warehouse-Monitorings
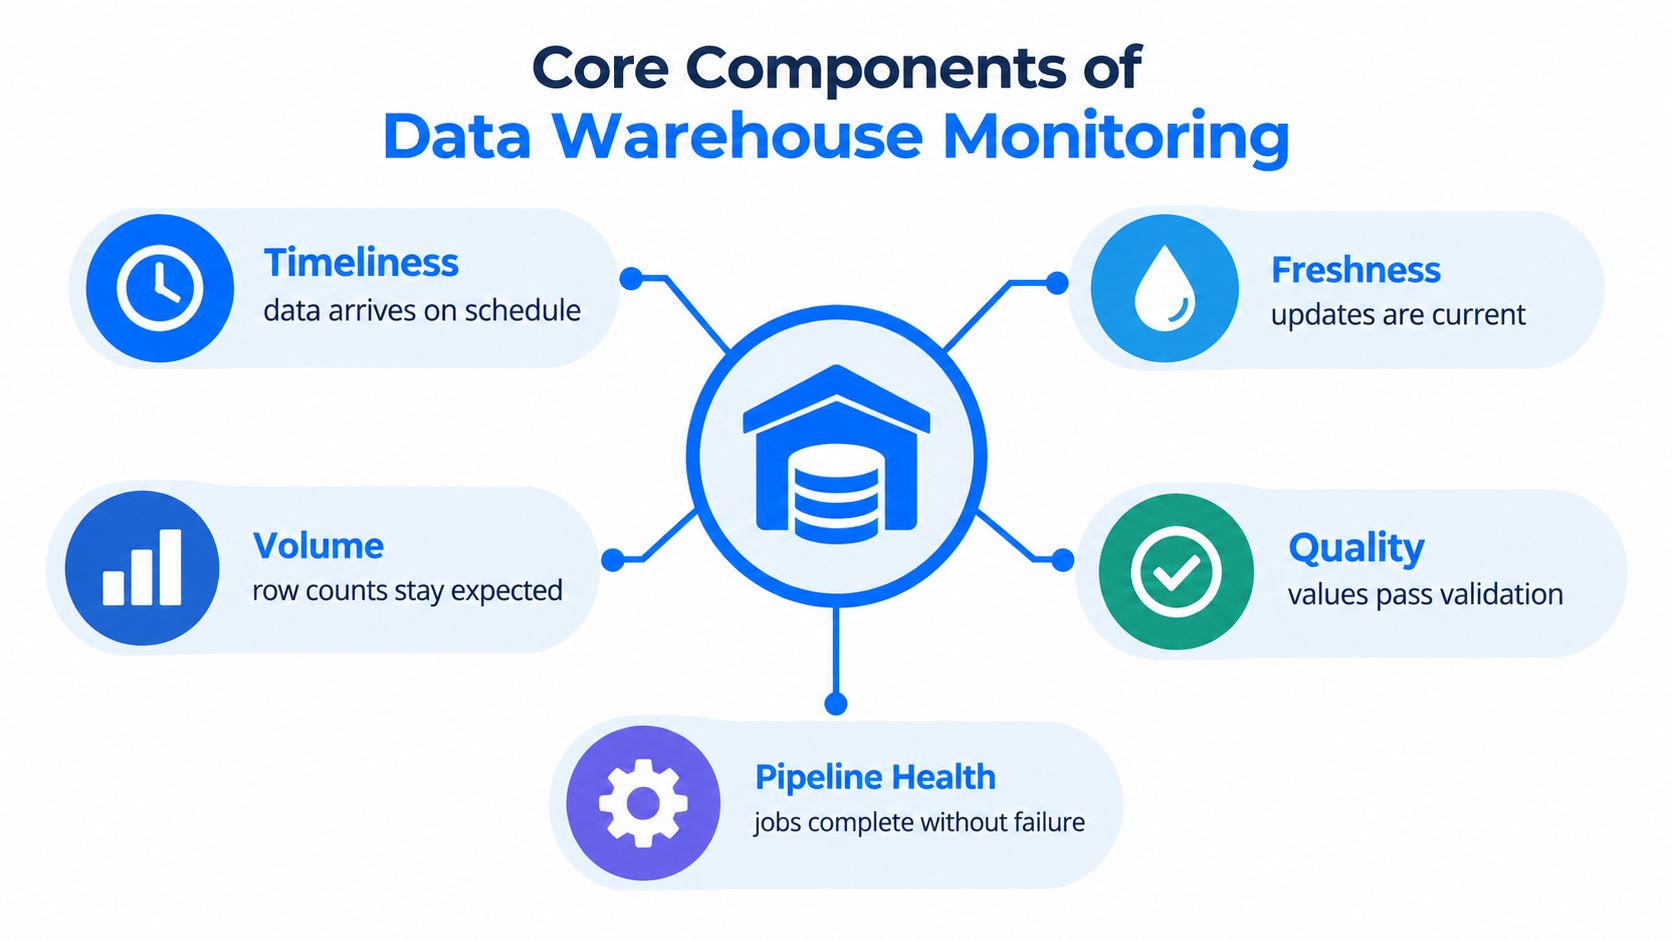
Monitoring funktioniert nur, wenn es die richtigen Risikoebenen abdeckt. Ein Warehouse kann pünktlich laden und trotzdem fehlerhafte Datensätze enthalten. Es kann auch aktuell wirken, während eine Feldänderung unbemerkt nachgelagerte Modelle beschädigt. Starkes Monitoring verbindet diese Fehlerarten, statt sie als getrennte Tools zu behandeln.
Pünktlichkeit und Aktualität hängen zusammen, sind aber nicht dasselbe
Pünktlichkeitsmonitoring prüft, ob Aktualisierungen zum erwarteten Zeitpunkt eintreffen. Der praktische Test ist einfach: den tatsächlichen Aktualisierungszeitpunkt mit einem Zeitplan oder SLA vergleichen und alarmieren, wenn die Abweichung zu groß wird. Ein gängiges Beispiel ist eine stündlich aktualisierte Tabelle, die einen Alert auslöst, wenn ihre Aktualisierungslücke etwa 2 Stunden überschreitet Leitfaden zum Timeliness-Monitoring.
Aktualität (Freshness) ist das Alter des neuesten Datensatzes. Pünktlichkeit fragt, ob der Ladevorgang rechtzeitig stattgefunden hat. Aktualität fragt, wie aktuell die Daten genau jetzt sind. Teams verwischen die beiden oft, und das erzeugt trügerische Sicherheit. Ein Job kann planmäßig laufen und trotzdem alte Datensätze laden. Ein verspäteter Job kann dennoch aktuelle Daten liefern, sobald er abgeschlossen ist.
Schema- und Qualitätsmonitoring erkennen leisere Fehler
Schema Drift ist einer der einfachsten Wege, nachgelagerte Konsumenten ohne offensichtlichen Vorfall zu beschädigen. Strukturelle Änderungen wie hinzugefügte oder entfernte Spalten, Typänderungen, umbenannte Felder und geänderte Constraints können Dashboards, Data Marts und Modelle ohne Vorwarnung beschädigen, wenn sie nicht erfasst und kommuniziert werden. Für Teams, die einen praktischen Bezugspunkt brauchen, sind die Data-Warehouse-Best-Practices von digna ein guter Ausgangspunkt, um über Change Control rund um die Warehouse-Struktur nachzudenken. Ziel ist nicht nur, die Änderung zu erkennen, sondern sicherzustellen, dass die nachgelagerten Verantwortlichen wissen, was sich geändert hat, bevor sie mit fehlerhaften Annahmen live gehen.
Qualitätsmonitoring setzt auf Datensatzebene an. Es sollte Daten gegen Geschäftsregeln validieren und Prüfungen auf Vollständigkeit, Genauigkeit, Konsistenz und Aktualität umfassen Leitfaden zu Datenqualitätsvorfällen. Neutrale Empfehlungen raten außerdem zu messbaren Schwellenwerten wie Nullwerten unter 0,1 % und 0 doppelten Kunden-IDs pro Monat, damit Qualität nicht subjektiv bleibt.
Wenn Monitoring vage ist, streiten Teams über den Schweregrad. Wenn es messbar ist, können sie handeln.
Performance und Pipeline-Health halten das System nutzbar
Performance-Monitoring ist der Teil, den viele Teams aufschieben, bis sich Nutzer beschweren. Es überwacht Ressourcenverbrauch, Abfragelatenz und Durchsatz, damit das Warehouse nicht so langsam wird, dass es faktisch nicht mehr funktioniert. Das ist wichtig, denn ein Warehouse, das technisch läuft, aber zu langsam antwortet, lässt das Geschäft trotzdem im Stich.
Pipeline-Health verbindet alle anderen Signale. Wenn Jobs fehlschlagen, endlos neu starten oder unbemerkt immer länger brauchen, wird jede andere Ebene unruhiger. Teams, die Pipeline-Health zusammen mit Datenqualität und Aktualität überwachen, erhalten frühere Warnungen und erleben weniger gegenseitige Schuldzuweisungen zwischen Plattform- und Analytics-Teams.
Für Teams, die ein praktisches Betriebsmodell statt einer Theorie brauchen, zeigt der Data-Warehouse-Integrationsansatz von digna, wie Monitoring nah am Warehouse angesiedelt sein kann, statt als separates System angeflanscht zu werden.
Klassische Regeln versus KI-gestützte Observability
Statische Regeln sind nach wie vor wichtig, reichen allein aber nicht aus. Fest codierte Schwellenwerte erkennen bekannte Fehlerarten gut, besonders wenn die Geschäftsregel klar und die Toleranz fest definiert ist. Schwierig wird es, wenn Daten ihre Form ändern, Muster abdriften oder Anomalien auf eine Weise auftreten, mit der niemand gerechnet hat.
Was statische Regeln gut können und wo sie versagen
Regelbasiertes Monitoring ist unkompliziert. Wenn ein Job verspätet läuft, Nullwerte einen Schwellenwert überschreiten oder eine kritische Spalte verschwindet, wird der Alert ausgelöst. Das macht es leicht erklärbar, leicht auditierbar und nützlich für Compliance-getriebene Prüfungen.
Der Nachteil ist der Wartungsaufwand. Jeder neue Datensatz, jeder Sonderfall und jede Geschäftsregel fügt einen weiteren Schwellenwert hinzu, der abgestimmt werden muss. In großen Datenlandschaften wird das Alert-Volumen zu einem eigenen Problem, weil Menschen Benachrichtigungen nicht mehr vertrauen, sobald zu viele davon Routine oder von geringem Wert sind.
Wie KI-gestützte Observability den Arbeitsaufwand verändert
KI-gestützte Observability geht einen anderen Weg. Statt von Engineers zu verlangen, jeden Schwellenwert im Voraus zu definieren, lernt sie das Basisverhalten jedes Datensatzes und markiert Abweichungen von diesem erwarteten Muster. Das macht sie nützlich für Drift, subtile Anomalien und Zustände, die in keine saubere Regel passen.
Der Zielkonflikt liegt in der Reife. KI-gestützte Methoden benötigen ausreichend Historie, um daraus zu lernen, und müssen dennoch nachjustiert werden, wenn sich Nutzungsmuster verschieben. Am stärksten sind sie in Kombination mit gezielten Regeln für bekannte Geschäftslogik, während die KI-Ebene die breite Anomalieerkennung und Priorisierung übernimmt.
Eine hilfreiche Betrachtungsweise sieht so aus.
Bereich | Statische Regeln | KI-gestützte Observability |
|---|---|---|
Erkennung | Bekannte Fehlerarten | Unerwartete Drift und Anomalien |
Rauschen | Kann präzise sein, wird aber bei Skalierung unruhig | Kann den Wildwuchs manueller Schwellenwerte reduzieren, muss aber dennoch abgestimmt werden |
Wartung | Laufende Regelpflege | Baseline-Management und Modell-Tuning |
Für einen breiteren operativen Kontext bietet Trends im IT-Performance-Monitoring eine nützliche Parallele dazu, wie Monitoring-Teams Rauschen reduzieren und gleichzeitig die Aufmerksamkeit auf aussagekräftige Signale richten.
Die besten Produktivumgebungen kombinieren in der Regel beides. Nutzen Sie deterministische Regeln für Kontrollen, die niemals mehrdeutig sein dürfen, und legen Sie KI-gestützte Erkennung darüber, wo sich das Warehouse eher wie ein lebendiges System als wie eine feste Checkliste verhält. Für Teams, die Methoden bewerten, ist der Vergleich von digna zwischen KI-gestützten Qualitätsprüfungen und klassischen Methoden ein praktischer Bezugspunkt.
Zentrale Metriken, die jedes Team überwachen sollte
Ein Monitoring-Programm wird dann konkret, wenn es Metriken erfasst, auf die Menschen reagieren können. Es geht nicht darum, alles zu messen. Es geht darum, die Dinge zu messen, die zeigen, ob das Warehouse das Geschäft korrekt mit Daten versorgt.
Beginnen Sie mit Pünktlichkeit, Qualität und Performance
Pünktlichkeitsmetriken vergleichen den tatsächlichen Aktualisierungszeitpunkt mit dem erwarteten Zeitplan oder SLA. Wenn ein Batch-Job täglich laufen soll, brauchen Sie einen klaren Schwellenwert dafür, ab wann eine Verspätung einen Alert rechtfertigt. Der genaue Schwellenwert hängt vom Geschäft ab, wichtig ist aber, dass sich das Team im Voraus darauf einigt und nicht erst nach einem Vorfall.
Qualitätsmetriken übersetzen Geschäftsregeln in Prüfungen. Nutzen Sie sie, um Vollständigkeit, Genauigkeit, Konsistenz und Aktualität auf Zeilenebene zu validieren Leitfaden zum Qualitätsmonitoring. Wenn Schwellenwerte messbar sind, können Teams entscheiden, ob eine Verschlechterung akzeptabel, vorübergehend oder ein echter Vorfall ist, der eine Triage erfordert.
Performance-Metriken sollten Abfrageantwortzeit, Pipeline-Durchsatz und Ressourcenauslastung umfassen. Langsame Abfragen und überlastete Pipelines sind oft das erste Anzeichen dafür, dass das Warehouse unter Druck steht, besonders in reportingintensiven Zeitfenstern oder nach dem Start eines neuen Modells.
Hören Sie nicht bei der technischen Gesundheit auf
Business-Metriken sind wichtig, weil sie Probleme aufdecken, die technische Prüfungen übersehen. Umsatz, Transaktionszahlen, Kundenaktivität und andere operative KPIs können ein Warehouse-Problem schneller sichtbar machen als eine Job-Statusseite. Wenn sich eine zentrale Business-Metrik plötzlich verschiebt, obwohl sich das Geschäft selbst nicht verändert hat, verdient das Warehouse eine genaue Prüfung.
Deshalb sollten Aktualität und Pünktlichkeit auch getrennt betrachtet werden. Eine Tabelle kann planmäßig aktualisiert werden und trotzdem veraltete Quellwerte enthalten, oder sie kann aktuelle Werte nach einer Verzögerung enthalten, die Nutzer nicht hinnehmen können. Beide Zustände sind nützliche Signale, deuten aber auf unterschiedliche Ursachen hin.
Gutes Monitoring fragt nicht nur, ob Daten vorhanden sind. Es fragt, ob das Geschäft ihnen vertrauen kann.
Für Teams, die diese Signale strukturierter definieren wollen, ist der Leitfaden von digna zu Metriken der Datenaktualität ein praktischer Bezugspunkt. Er hilft, zeitplanbasierte Erwartungen mit der operativen Realität der Warehouse-Bereitstellung zu verbinden.
Ein sauberes Metrik-Set sorgt außerdem für ehrliche Incident-Reviews. Wenn das Team Timing, Qualität und geschäftliche Auswirkungen gemeinsam sieht, lässt sich ein Ladeproblem viel leichter von einem Modellierungsproblem oder einer echten Veränderung im Geschäft unterscheiden.
Implementierungsmuster für Enterprise-Monitoring
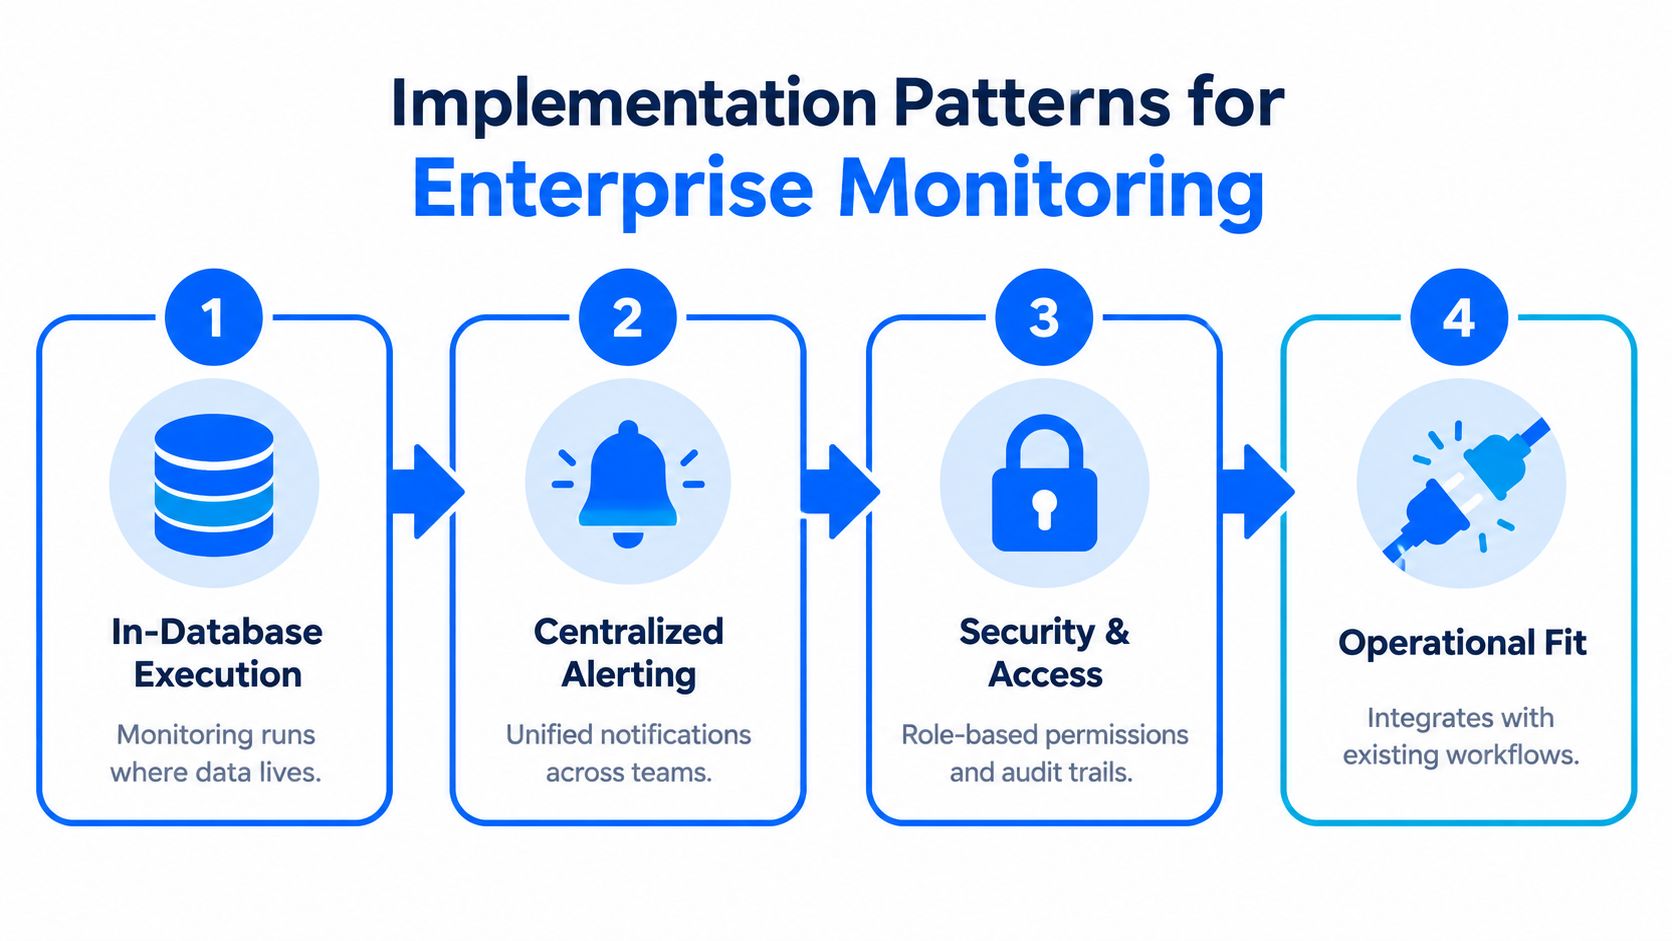
Enterprise-Monitoring scheitert, wenn es mehr zu verwaltende Systeme schafft, als es Probleme verhindert. Das stärkste Bereitstellungsmuster hält die Prüfungen nah an den Daten, belässt sensible Informationen in der Umgebung des Kunden und hält das Alerting für die Teams verständlich, die handeln müssen.
In-Database-Ausführung ist der sicherste operative Standard
Prüfungen direkt in den eigenen Datenbanken des Kunden auszuführen, reduziert Datenbewegungen und erfüllt Sicherheits- und Governance-Anforderungen besser, als alles in externe Systeme zu exportieren. Das ist in regulierten Umgebungen wichtig, aber auch in gewöhnlichen Unternehmen, die sensible Warehouse-Daten nicht für das Monitoring hin- und herschieben wollen.
Hier zählt das Design mehr als die Marke. Ein In-Database-Modell ermöglicht es der Monitoring-Ebene, Daten dort zu prüfen, wo sie liegen, und dennoch Alerts, Trends und Statusmeldungen zu erzeugen, die für die richtigen Personen sichtbar sind. In der Praxis bedeutet das meist weniger Reibung mit Security-Teams und weniger Überraschungen bei Reviews.
Zentrale Alerts brauchen Kontext, nicht nur Geschwindigkeit
Einheitliches Alerting funktioniert nur, wenn Benachrichtigungen mit dem richtigen Verantwortlichen und dem richtigen Reaktionsweg verknüpft sind. Ein unruhiger Strom von Vorfällen hilft nicht, wenn dieselbe Nachricht in fünf Kanälen landet und niemand weiß, wer für die Behebung zuständig ist. Das Monitoring-System muss nach Datensatz, Domäne oder Fehlertyp routen, damit die richtige Person das richtige Signal sieht.
Ein pragmatisches Enterprise-Muster sieht so aus.
In-Database-Prüfungen: Berechnungen direkt beim Warehouse ausführen, um Datenbewegungen zu reduzieren und die Governance zu vereinfachen.
Rollenbasierter Zugriff: einschränken, wer sensible Details zu Vorfällen sehen darf.
Operative Passung: sich in die Orchestrierungs- und Kommunikationstools einfügen, die das Team bereits nutzt.
Gemeinsame Transparenz: Engineers, Analysten und Fachanwendern dasselbe Signal zeigen, ohne sie in unterschiedliche Versionen der Wahrheit zu drängen.
Für Teams, die Tools für dieses Modell evaluieren, ist der Überblick von digna zu Monitoring und Reporting relevant, weil er zeigt, wie Alerting und Reporting auf warehouse-nativen Prüfungen aufsetzen können, ohne zu einem separaten Problem mit Datenkopien zu werden.
Das Ziel ist operative Passung. Wenn die Monitoring-Ebene jeden Workflow unterbricht, übersteht sie den Kontakt mit der Produktion nicht. Wenn sie zur bestehenden Arbeitsweise des Warehouse-Teams passt, wird sie Teil der Control Plane statt eines weiteren Dashboards, das niemand ansieht.
Eine Monitoring-Kultur für langfristigen Erfolg aufbauen
Monitoring-Tools schaffen Zuverlässigkeit nicht von selbst. Das tun Teams. Unternehmen, die es richtig machen, behandeln Observability als Teil des Datenbetriebs und nicht als einmalige Einrichtungsaufgabe, die nach einem Vorfall an das Engineering übergeben wird.
Verantwortlichkeit und Reaktion müssen klar definiert sein
Jede Datendomäne braucht einen klaren Verantwortlichen, und jeder Alert-Typ braucht einen bekannten Reaktionsweg. Wenn eine Schemaänderung eintrifft, sollte der Analytics Engineer wissen, ob er ein Modell anpassen, einen Dashboard-Verantwortlichen informieren oder an ein Plattform-Team eskalieren muss. Wenn eine Qualitätsregel fehlschlägt, muss jemand entscheiden, ob das Problem bei den Upstream-Daten, einer fehlerhaften Transformation oder einer überarbeitungsbedürftigen Geschäftsregel liegt.
Feedbackschleifen sind genauso wichtig. Jeder Vorfall sollte etwas Nützliches hinterlassen: einen besseren Schwellenwert, eine sauberere Regel oder eine genauere Baseline. Ohne diese Schleife wiederholen Teams nur denselben Feuerwehreinsatz mit leicht veränderten Symptomen.
Rauschen überprüfen, Nutzer schulen und das Programm lebendig halten
Regelmäßige Reviews halten gute Monitoring-Programme gesund. Teams sollten prüfen, welche Alerts ausgelöst wurden, welche davon nützlich waren und welche abgeschafft oder verschärft werden sollten. Wenn niemand das Signal-Set je überprüft, untergräbt Alert Fatigue mit der Zeit das Vertrauen.
Schulung ist die andere Hälfte der Aufgabe. Engineers, Analysten und Fachanwender müssen verstehen, was die Alerts bedeuten und welche Maßnahmen sie ergreifen sollten. Eine Monitoring-Plattform funktioniert nur, wenn Menschen sie interpretieren können, ohne bei jeder Änderung ein Meeting einzuberufen.
Ein Warehouse ist zuverlässig, wenn das Team seine Ausfälle schnell erklären und verhindern kann, dass derselbe Fehler wiederkehrt.
Deshalb ist Observability auch zur Voraussetzung für vertrauenswürdige Analytics und KI geworden. Ein Modell ist nur so verlässlich wie die Daten, die es speisen, und ein Dashboard nur so nützlich wie die Pipeline dahinter. Unternehmen, die eine Monitoring-Kultur aufbauen, reduzieren nicht nur Ausfälle, sie treffen auch schneller Entscheidungen, weil weniger dieser Entscheidungen zuerst manuelle Datenprüfungen erfordern.
Für Teams, die Datenqualität, Aktualität, Schema-Tracking und Business-Monitoring in einem Betriebsmodell zusammenführen wollen, bietet digna eine In-Database-Observability-Plattform, die in der eigenen Umgebung des Kunden läuft. Schauen Sie vorbei, wenn Sie das Verhalten Ihres Warehouses praktisch überwachen möchten, ohne sensible Daten aus Ihrem Stack zu exportieren.
Wie die hier beschriebenen Pünktlichkeitsprüfungen ohne manuell festgelegte Zeitpläne für jede Tabelle funktionieren, zeigt das Timeliness-Modul von digna: Es lernt das übliche Ankunftsmuster jeder Tabelle und alarmiert, wenn ein Ladevorgang verspätet ist oder ausbleibt.
Häufig gestellte Fragen
Was ist Data-Warehouse-Monitoring?
Es ist die kontinuierliche Überprüfung eines Warehouses auf verspätete Ladevorgänge, veraltete Daten, Schemaänderungen, Qualitätsverluste und langsame Performance, damit Probleme erkannt werden, bevor Fachanwender auf Basis falscher Zahlen handeln. Ausgereifte Programme überwachen auch Business-KPIs, weil eine plötzliche Verschiebung einer Metrik oft als Erstes ein Pipeline-Problem offenlegt.
Was ist der Unterschied zwischen Pünktlichkeit und Aktualität von Daten?
Pünktlichkeit fragt, ob ein Ladevorgang gemessen an seinem Zeitplan oder SLA zum erwarteten Zeitpunkt eingetroffen ist. Aktualität fragt, wie alt der neueste Datensatz genau jetzt ist. Ein Job kann pünktlich laufen und trotzdem alte Datensätze laden, und ein verspäteter Job kann dennoch aktuelle Daten liefern, daher braucht jede Dimension ihre eigene Prüfung.
Welche Metriken sollte ein Data-Warehouse-Monitoring-Programm erfassen?
Beginnen Sie mit der Pünktlichkeit gegenüber dem erwarteten Zeitplan, der Qualität auf Datensatzebene hinsichtlich Vollständigkeit, Genauigkeit und Konsistenz sowie der Performance, etwa Abfrageantwortzeit, Pipeline-Durchsatz und Ressourcennutzung. Ergänzen Sie Business-Metriken wie Umsatz oder Transaktionszahlen, da sie Probleme aufdecken, die technische Health-Checks übersehen.
Sind KI-gestützte Anomalieprüfungen besser als statische Regeln?
Keines von beiden reicht allein aus. Statische Regeln eignen sich für bekannte Fehlerarten und Compliance-Prüfungen, weil sie leicht zu erklären und zu auditieren sind, werden bei Skalierung aber teuer in der Wartung. KI-gestützte Prüfungen lernen die Baseline jedes Datensatzes und erkennen unerwartete Drift, daher kombinieren Produktivumgebungen in der Regel beides.
Warum sollte Data-Warehouse-Monitoring direkt in der Datenbank laufen?
In-Database-Ausführung hält die Prüfungen direkt bei den Daten, sodass sensible Datensätze nie in ein externes Monitoring-System exportiert werden müssen. Das reduziert Datenbewegungen, erfüllt Sicherheits- und Governance-Anforderungen in regulierten Branchen und bedeutet meist weniger Reibung bei Security-Reviews, während weiterhin Alerts und Trends erzeugt werden.



