8 Data-Observability-Use-Cases für verlässliche Daten
|
9
min. Lesezeit

Der erste Fehler in einer Datenumgebung ist selten eine abgestürzte Pipeline. Es ist ein Dashboard, das mit unvollständigen Daten erfolgreich aktualisiert, ein Modell, das strukturell valide, aber im Verhalten veränderte Eingaben erhält, oder ein KPI, der ohne zugewiesene Untersuchung aus seinem normalen Muster ausbricht. Eine vielzitierte Umfrage ergab, dass monatliche Datenvorfälle von 59 im Jahr 2022 auf 67 im Jahr 2023 stiegen, während 68 % der Befragten angaben, dass die Erkennung von Datenvorfällen 2023 mindestens vier Stunden dauerte, nach 62 % im Jahr 2022. Dieselbe Umfrage berichtete von einem Anstieg der durchschnittlichen Lösungszeit um 166 % auf 15 Stunden je Vorfall (Business-Wire-Berichterstattung zur Monte-Carlo-Umfrage).
Diese Belege verdeutlichen den Zweck von Data Observability. Teams müssen Datenverhalten, Lieferung, Struktur, fachliche Bedeutung und Plattformbetrieb überwachen und jedes Signal mit einer benannten verantwortlichen Person und einem Reaktionsweg verbinden. Die folgenden acht Data-Observability-Use-Cases ordnen Verlässlichkeitsarbeit nach dem Fehler, den ein Team verhindern muss. Jeder benennt die verantwortliche Rolle, das Signal, einen typischen Vorfall, relevante digna-Module und die nächste Handlung. digna läuft innerhalb der Umgebung der Kundin und verbindet Anomalieerkennung, Timeliness, Validierung, Schema-Tracking, Business Monitoring und Platform Observability, ohne Produktionsdaten zu bewegen.
Inhaltsverzeichnis
2. Unentdeckte Datenverschiebung und Vermeidung von Model Drift
4. Erkennung von Schemaänderungen und Vermeidung von Breaking Changes
6. Durchsetzung von Geschäftsregeln und Compliance-Validierung
8. Regulatorische Compliance und auditfähige Data Governance
1. Erkennung veralteter und defekter Dashboards
Ein Dashboard kann verfügbar sein, während seine Entscheidungen bereits unsicher sind. Die visuelle Schicht lädt womöglich, doch eine vorgelagerte Tabelle enthält eine fehlende Partition, eine verspätete Lieferung oder eine Kennzahlenverteilung, die den aktuellen Betrieb nicht mehr abbildet. Damit ist die Erkennung veralteter Dashboards einer der unmittelbarsten Data-Observability-Use-Cases für Analytics- und Fachteams.
Hauptverantwortlich ist meist die Analytics Engineerin oder BI-Entwicklerin, während der Data Engineer für die vorgelagerte Pipeline zuständig ist. Das Signal kombiniert Aktualität, Volumen, Vollständigkeit und Verteilung. Ein Dashboard-Alert sollte benennen, welcher Datensatz verspätet oder unvollständig ist, welche Kennzahl sich verändert hat und welche nachgelagerten Berichte davon abhängen.
Ein Finanzinstitut könnte erkennen, dass ein tägliches Risiko-Dashboard nicht aktualisiert wurde, weil ein vorgelagerter ETL-Prozess verspätet lieferte. Ein Team im Gesundheitsbetrieb könnte fehlende Patientenzahlen identifizieren, bevor Personalentscheidungen auf einer unvollständigen Sicht beruhen. Ein Retail-Analytics-Team könnte unvollständige Verkaufsdaten abfangen, bevor Führungskräfte die Tages-KPIs prüfen.

Erkennung muss zur Diagnose führen
dignas Module Data Anomalies und Timeliness können erwartete Ankunftsmuster und Kennzahlenverhalten lernen und anschließend fehlende Ladevorgänge, verspätete Lieferungen und ungewöhnliche Werte melden. Die In-Database-Ausführung hält die Analyse in den Datenbanken der Kundin, während das gemeinsame Dashboard Engineers und Stakeholdern eine gemeinsame Vorfallsicht gibt. Teams können dignas Leitfaden zu Data Timeliness nutzen, um die wichtigsten Liefersignale zu definieren.
Beginnen Sie mit den Dashboards, die Risiko, Versorgungsbetrieb, Umsatz oder Führungsentscheidungen beeinflussen. Leiten Sie Alerts an die Pipeline-Verantwortlichen, statt jede Benachrichtigung an eine breite Datengruppe zu senden. Prüfen Sie das Baseline-Verhalten während der Einführung, denn ein nützlicher Alert bildet die tatsächliche Taktung des Datensatzes ab und nicht einen willkürlichen Zeitplan.
Praktische Regel: Ein Dashboard-Alert sollte angeben, ob der Fehler eine verspätete Lieferung, ein unvollständiges Volumen oder ein verändertes Kennzahlenverhalten ist. Diese Bedingungen erfordern unterschiedliche Untersuchungen.
2. Unentdeckte Datenverschiebung und Vermeidung von Model Drift
Eine Pipeline kann fehlerfrei laufen und dennoch Daten liefern, die das von einem Modell oder Entscheidungsprozess erwartete Verhalten nicht mehr abbilden. Verteilungsänderungen sind mit Job-Status-Monitoring besonders schwer zu erfassen, weil die Infrastruktur Erfolg meldet, während sich der Inhalt verschoben hat.
Verantwortlich sind Data Scientist, ML Engineer und Data Engineer. Sie sollten Feature-Verteilungen, Kategoriehäufigkeiten, Nullwertverhalten, Transaktionsmuster und weitere Signale überwachen, die die Eingabepopulation beschreiben. Der Vorfall kann eine E-Commerce-Plattform sein, die eine Veränderung im Kaufverhalten sieht, welche die Nachfrageprognose schwächt, oder ein Telekommunikationsanbieter, der eine Verschiebung im Abwanderungsmuster bemerkt, bevor ein Modell unzuverlässig wird.
Teams im Gesundheitswesen sehen womöglich eine unerwartete Veränderung der Aufnahmeraten, die eine operative Untersuchung erfordert. Teams in Finanzdienstleistungen entdecken vielleicht ungewöhnliche Transaktionsmuster, die auf ein Pipeline-Problem, ein echtes Geschäftsereignis oder ein Betrugssignal hindeuten können. Observability entscheidet nicht, welche Erklärung stimmt. Sie verkürzt den Weg von ungewöhnlichem Verhalten zu der Person, die die Erklärung prüfen kann.
Baseline-Learning vor manuellen Schwellenwerten nutzen
dignas Modul Data Anomalies wendet kontinuierliches Baseline-Learning auf das Verhalten von Datensätzen an, während Data Analytics Teams hilft, historische Muster, Volatilität und wiederkehrende Veränderungen zu prüfen. Die digna-Ressource zur Model-Drift-Erkennung ist relevant, wenn Teams Datenänderungen mit Modellmonitoring verbinden wollen, statt beides als getrennte Vorfälle zu behandeln.
Ein praktikabler Alert sollte den betroffenen Datensatz, das konsumierende Modell oder den Entscheidungsprozess, das veränderte Signal und die Eskalationsverantwortung enthalten. Engineers können die Anomalie dann mit Modellleistung, Deployment-Historie, Änderungen im Quellsystem oder saisonalem Verhalten vergleichen. Werden Alerts in eine ML-Monitoring-Plattform gesendet, kann das Team Eingabedrift und Ausgabeverschlechterung über einen Vorfallpfad untersuchen.
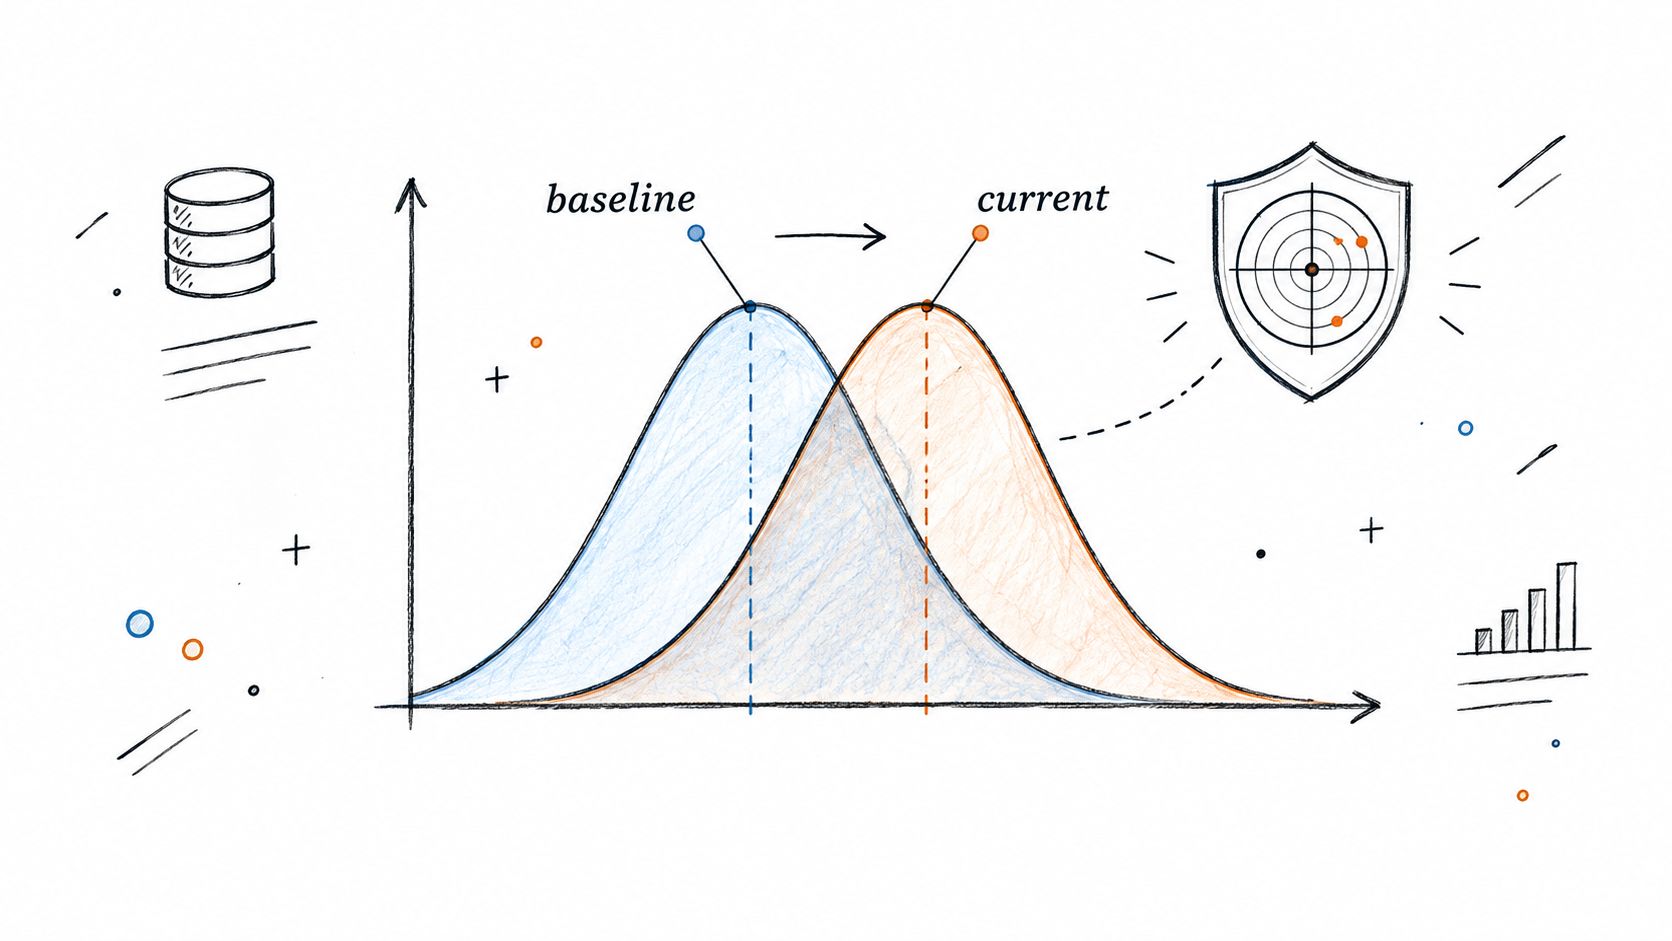
Das strategische Risiko betrifft nicht nur die Modellgenauigkeit. Eine veränderte Eingabe kann Prognosen, Priorisierung, Betrugsprüfung, Versorgungsplanung oder Kundenbehandlung verändern, bevor jemand das Ereignis überhaupt als Modellvorfall bezeichnet.
3. Lieferverzögerungen in Pipelines und SLA-Monitoring
Verspätete Daten erzeugen einen anderen Fehler als fehlerhafte Daten. Eine Transformation kann korrekt sein und die Quelle verfügbar, doch die Tabelle trifft ein, nachdem der Geschäftsprozess sie gebraucht hätte. Damit wird Timeliness zu einer geschäftlichen Kontrolle und nicht nur zu einer Engineering-Kennzahl.
Verantwortlich ist die Data Platform Engineerin oder die Pipeline-Verantwortliche. Das Signal ist die erwartete Lieferzeit im Vergleich zur tatsächlichen Ankunft, gestützt auf vorhandene Ladevorgänge, Ausführungsdauer und historische Taktung. Eine Tabelle, die stündlich aktualisiert werden soll, kann etwa einen Alert auslösen, wenn sie seit mehr als 2 Stunden nicht aktualisiert wurde, und so aus einer vagen Beschwerde über späte Daten eine definierte Vorfallschwelle machen (DataDrivens Erläuterung zu Data Observability).
Eine Bank braucht nächtliche Risikodaten womöglich vor einer Sitzung des Risikoausschusses. Ein Gesundheitsdienstleister ist vielleicht auf tägliche Patientendaten für operative Dashboards angewiesen. Ein Telekommunikationsunternehmen könnte umfangreiche Kundenladevorgänge überwachen, die die Bereitstellung stützen, während ein Händler Verkaufsdaten vor dem morgendlichen Reporting benötigt.
Lieferung als operativen Vertrag behandeln
dignas Modul Timeliness lernt Zeitpläne und erwartete Lieferfenster und meldet dann Verzögerungen, fehlende Ladevorgänge und zu frühe Lieferungen. Teams können dignas Ressource zum AWS-Data-Pipeline-Monitoring nutzen, wenn sie Timeliness-Monitoring auf Cloud-Pipeline-Betrieb ausrichten wollen.
Die nächste Handlung sollte explizit sein. Richten Sie eine Eskalation ein, wenn die erwartete Lieferzeit überschritten wird, senden Sie den Vorfall an die Pipeline-Verantwortliche und integrieren Sie den Alert mit dem Incident Management. Verfolgen Sie den Trend erwarteter Lieferzeiten, nicht nur einzelne Verfehlungen. Eine allmähliche Verschlechterung kann Kapazitäts- oder Abhängigkeitsprobleme offenlegen, bevor ein vollständiger Ausfall eintritt.
Ein Liefer-SLA nützt nur, wenn jemand die Verletzung verantwortet, ihre nachgelagerte Wirkung versteht und weiß, wann zu eskalieren ist.
Die Erkennung identifiziert das verpasste Fenster. Die Diagnose prüft Orchestrator, Quellsystem, Abhängigkeitskette und Ladezustand. Die Reaktion kann darin bestehen, einen Job erneut auszuführen, die Quellverantwortliche zu kontaktieren oder nachgelagerte Ausgaben vorübergehend als nicht vertrauenswürdig zu kennzeichnen.
4. Erkennung von Schemaänderungen und Vermeidung von Breaking Changes
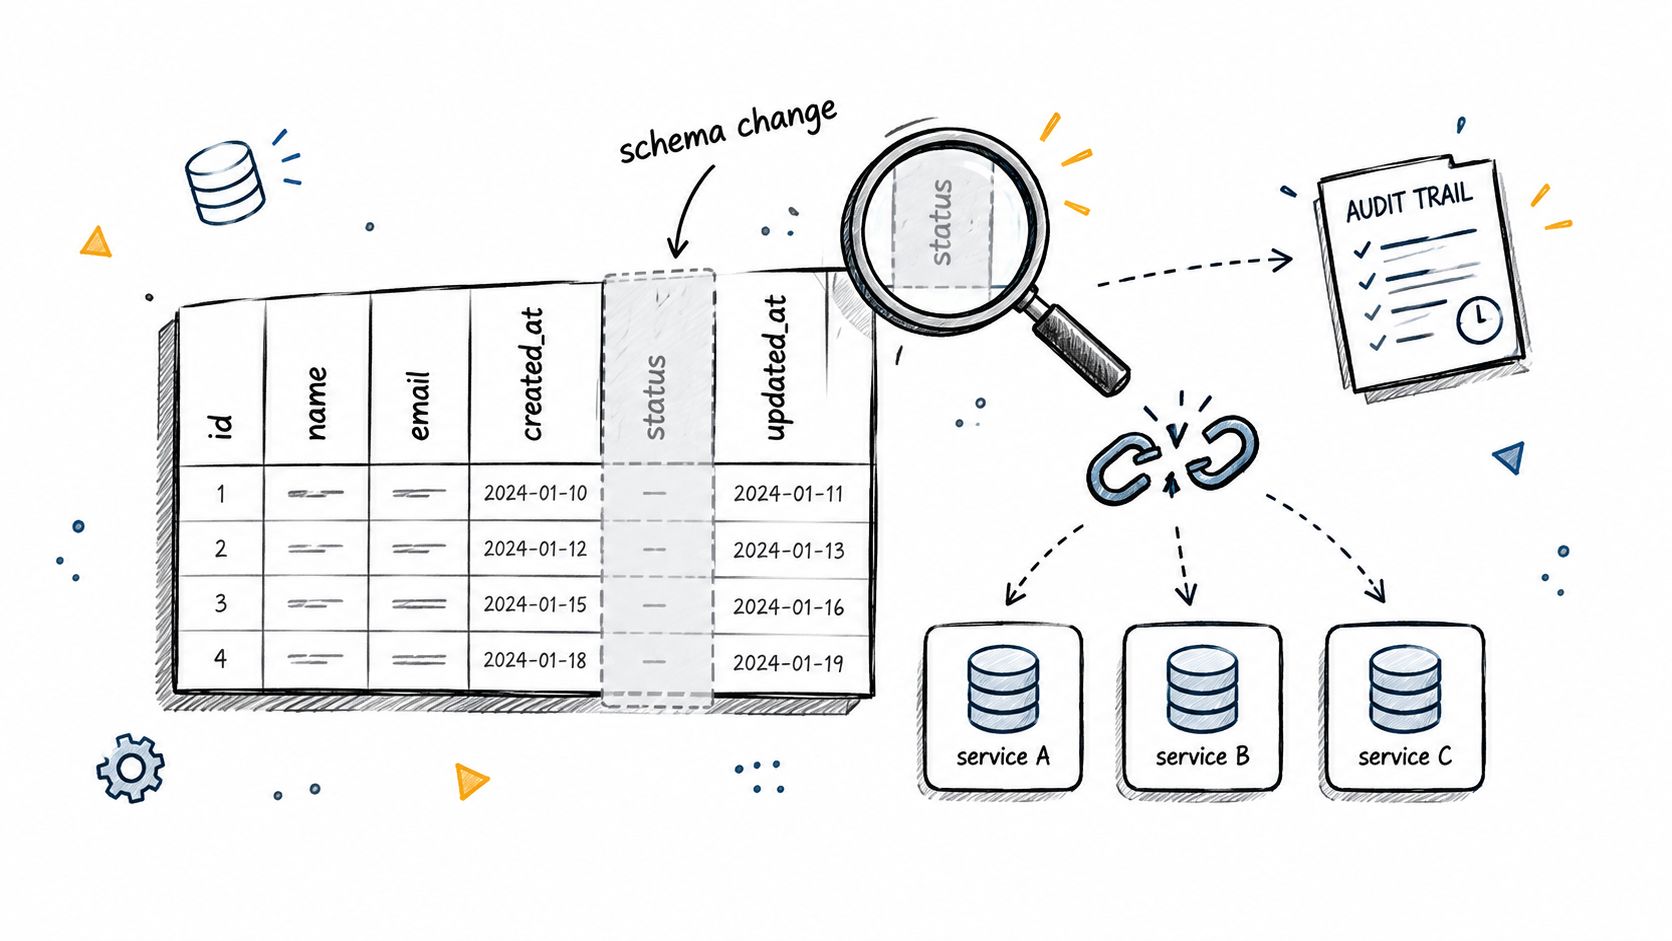
Strukturelle Änderungen sind gefährlich, weil sie Konsumenten brechen können, ohne wie Betriebsstörungen auszusehen. Hinzugefügte Spalten, entfernte Spalten, umbenannte Felder, Typänderungen sowie Wechsel zwischen nullbar und nicht nullbar können fehlende Werte, Typumwandlungen, fehlgeschlagene Transformationen oder falsche Joins verursachen, selbst wenn eine Pipeline erfolgreiche Ausführung meldet (Ataccamas Erläuterung zu Schema und Data Observability).
Die Data Engineerin oder Analytics Engineerin verantwortet die Reaktion, während Verantwortliche der Quellsysteme beabsichtigte Änderungen genehmigen sollten. Das Signal ist ein Vergleich zwischen aktuellem Schema und erwarteter Struktur. Ein typischer Vorfall kann eine Quellanwendung sein, die eine nicht angekündigte Spalte hinzufügt, einen Kundenidentifikator von String auf Integer ändert oder ein in einer Risikoberechnung genutztes Feld entfernt.
IT-Teams im Gesundheitswesen stehen vor einem zusätzlichen Kontrollproblem, wenn sich klinische Datenstrukturen ohne klare Kommunikation weiterentwickeln. Das unmittelbare technische Problem mag eine fehlgeschlagene Transformation sein, das weitergehende Risiko ist jedoch der Verlust der Nachvollziehbarkeit, welche Datenversion einen Bericht gestützt hat.
Änderungen erkennen, bevor Konsumenten sie entdecken
dignas Schema Tracker überwacht strukturelle Eigenschaften fortlaufend und alarmiert Teams, wenn Schemata driften. Das digna-Schema-Tracker-Modul kann einen Workflow unterstützen, in dem Teams erwartete Schemata dokumentieren, Alerts an nachgelagerte Verantwortliche leiten und prüfen, ob eine Änderung beabsichtigt war.
Die Diagnose erfordert mehr als die Bestätigung, dass sich eine Spalte geändert hat. Engineers sollten betroffene Tabellen, Transformationen, Dashboards, Modelle und regulatorische Ausgaben identifizieren. Die nächste Handlung kann darin bestehen, einen Vertrag zu aktualisieren, Kompatibilität wiederherzustellen, eine Transformation zu überarbeiten oder die Änderung formal zu genehmigen. Verknüpfen Sie Schema-Alerts mit Katalog- und Governance-Prozessen, damit strukturelle Entscheidungen nicht in privaten Nachrichten oder undokumentierten Tickets verschwinden.
Ein Schema-Alert ist deshalb ein Signal zur Wirkungskontrolle. Er sagt dem Team nicht nur, dass sich eine Struktur geändert hat, sondern auch, dass eine nachgelagerte Abhängigkeit nun geprüft werden muss.
5. Business-KPI-Monitoring und Anomalie-Alerts
Technische Prüfungen können bestehen, während das Geschäftsergebnis falsch aussieht. Ein Warehouse kann Daten pünktlich erhalten, sein Schema bewahren und jede Transformation abschließen, und dennoch können sich Umsatz, Bestellwert, Kundenvolumen, Abwanderung oder Behandlungsergebnisse außerhalb des erwarteten Verhaltens bewegen.
Verantwortlich ist die Business-Analystin oder die operative Stakeholderin, unterstützt vom Analytics Engineering. Das Signal ist eine Geschäftskennzahl im Vergleich zu ihrem historischen Verhalten, ihrer Saisonalität, ihrer Volatilität und den relevanten Datenbedingungen. Eine Handelsorganisation könnte einen ungewöhnlichen Umsatzrückgang erkennen und mit der Untersuchung beginnen, bevor das Thema in eine formale Leistungsbewertung gelangt. Ein Telekommunikationsteam bemerkt vielleicht auffällige Abwanderung, während eine Finanzdienstleistungsgruppe eine Veränderung des Transaktionsvolumens untersucht, die Betrug oder ein Systemproblem widerspiegeln könnte.
Fachliche Bedeutung neben technischen Kontext stellen
dignas Lösung Business Monitoring wendet Anomalieerkennung auf Kennzahlen an, die im Warehouse oder Lake liegen. Das Modul Data Analytics hilft Teams, historische KPI-Muster, Trends und Volatilität zu verstehen, während das digna Business-Monitoring-System einen fokussierten Weg für die Überwachung geschäftlichen Verhaltens bietet.
Beginnen Sie mit KPIs, die eine klare Entscheidungsverantwortung haben. Legen Sie fest, welche Handlung auf einen Alert folgt, etwa die Vollständigkeit der Quelle prüfen, eine Aktion validieren, Transaktionskontrollen überprüfen oder ein operatives Team kontaktieren. Behandeln Sie nicht jede Bewegung als Vorfall. Die Empfindlichkeit sollte die normale Schwankung der Kennzahl und die Folgen einer übersehenen Anomalie abbilden.
Verantwortungstest: Wenn niemand die Entscheidung benennen kann, die sich nach einem KPI-Alert ändert, ist die Kennzahl wahrscheinlich noch nicht bereit für kontinuierliches Monitoring.
Die Diagnose verbindet die geschäftliche Bewegung mit Datenqualität, Ereignissen im Quellsystem, Produktänderungen oder echtem Marktverhalten. Die Reaktion liegt dann bei dem Team, das die zugrunde liegende Bedingung korrigieren kann, nicht zwingend bei dem Team, das das Dashboard pflegt.
6. Durchsetzung von Geschäftsregeln und Compliance-Validierung
Anomalieerkennung fragt, ob Daten sich anders verhalten als ihre Baseline. Validierung fragt, ob jeder Datensatz eine bekannte fachliche, logische oder Compliance-Regel erfüllt. Beides ist nötig, weil ein Datensatz statistisch normal aussehen und dabei eine geforderte Bedingung verletzen kann.
Verantwortlich sind meist die Leitung Datenqualität, Data Stewards, das Compliance-Team oder Fachexpertinnen der Domäne. Zu den Signalen zählen das Vorhandensein von Pflichtfeldern, gültige Segmente, Wertebereiche, Datumsfolgen, referenzielle Integrität und weitere deterministische Bedingungen. Ein Finanzdienstleistungsteam validiert womöglich, dass Transaktionen Pflichtfelder enthalten und innerhalb von Compliance-Schwellen bleiben. Teams im Gesundheitswesen prüfen vielleicht, ob Datensätze Meldeanforderungen vor der Einreichung erfüllen. Telekommunikationsanbieter können Abrechnungsdatensätze gegen Tarifregeln validieren, während Behörden Audit- und Nachvollziehbarkeitsbedingungen testen.
Validierungsnachweise operativ nutzbar machen
dignas Modul Data Validation führt Prüfungen auf Satzebene gegen dokumentierte Geschäftsregeln aus. Teams sollten mit regulierten oder risikoreichen Domänen beginnen, Fachexpertinnen in die Regelgestaltung einbeziehen und festhalten, welche Datensätze bestanden oder gescheitert sind. Der Datenkatalog kann eine gemeinsame Sicht auf den Validierungsstatus bieten und Analystinnen helfen, nutzbare Daten von prüfbedürftigen zu unterscheiden.
Die Erkennung identifiziert Datensätze, die eine Regel verletzen. Die Diagnose klärt, ob Regel, Quelle, Transformation oder Geschäftsprozess den Fehler verursacht hat. Die Reaktion kann darin bestehen, betroffene Datensätze zu isolieren, die Quelle zu korrigieren, eine Ausnahme zu genehmigen oder die Behebung für die Auditprüfung zu dokumentieren.
Unabhängige Leitfäden zur Pipeline-Observability betonen, dass Monitoring die Ausgabequalität bewerten muss, einschließlich Satzzahlen, Änderungen der Feldverteilung und Schemaänderungen, statt sich allein auf den Joberfolg zu verlassen (Leitfaden zu datenbezogenem Pipeline-Monitoring und Kontrollen). Diese Unterscheidung zählt in compliance-sensiblen Umgebungen, in denen ein abgeschlossener Job kein hinreichender Nachweis dafür ist, dass die Ausgabe verlässlich oder prüfbar ist.
7. Data Platform Observability und Consumption Monitoring
Data-Platform-Teams erben Verlässlichkeitsprobleme mitunter aus dem Ressourcenverhalten statt aus dem Dateninhalt. Eine Lastspitze, eine ineffiziente Abfrage, eine außer Kontrolle geratene Pipeline, eine ungenutzte Tabelle oder ein unerwarteter Speichertrend kann die Verfügbarkeit senken und die nachgelagerte Lieferung weniger vorhersagbar machen.
Verantwortlich ist die Data Platform Engineerin. Zu den Signalen zählen Lastmuster, Abfragevolumen, Verarbeitungskapazität, Pipeline-Ausführungszeit, Verfügbarkeit, Speicherwachstum und Nutzungsveränderungen. Ein Cloud-Warehouse-Team findet womöglich ungenutzte Tabellen, die das Speichermanagement erschweren. Eine Analytics Engineerin könnte Abfragen identifizieren, die übermäßig Ressourcen verbrauchen, und das SQL optimieren. Ein Plattformteam erkennt vielleicht ein auffälliges Nutzungsmuster, das von einer außer Kontrolle geratenen Pipeline verursacht wird.
Die Infrastruktur hinter den Daten überwachen
dignas Lösung Data Platform Observability konzentriert sich auf Plattformgesundheit, Verhalten, Nutzung und betriebliche Veränderungen. Das Modul Data Analytics kann Teams helfen, Plattformkennzahlen im Trend zu betrachten und eine einmalige Spitze von einem sich entwickelnden Kapazitätsproblem zu unterscheiden. Teilen Sie Plattform-Dashboards mit Datenkonsumenten, damit Engineers nicht die Einzigen sind, die die Folgen ineffizienter Nutzung sehen.
Die nächste Handlung hängt vom Signal ab. Eine Abfrageanomalie erfordert womöglich SQL-Optimierung. Ein Speichertrend verlangt vielleicht Lifecycle-Management oder eine Klärung der Verantwortung. Eine veränderte Pipeline-Ausführung kann Kapazitätsanalyse, Abhängigkeitsuntersuchung oder eine Anpassung des Zeitplans erfordern. Etablieren Sie normale Lastbaselines, leiten Sie schwerwiegende Alerts an die Plattformverantwortlichen und nutzen Sie Nutzungstrends für die Infrastrukturplanung.
Dieser Use Case legt auch ein Priorisierungsproblem offen. Eine Observability-Umfrage aus dem Jahr 2025 ergab, dass nur 13 % der erhobenen Telemetrie aktiv für Monitoring, Alerting oder Troubleshooting genutzt wurden, während 84 % der Unternehmen weniger als ein Viertel dessen nutzten, was sie sammelten (Observability-Report von Sawmills AI). Mehr Telemetrie erzeugt nicht automatisch mehr Verlässlichkeit. Teams müssen Signale auswählen, die zu einer Entscheidung führen.
8. Regulatorische Compliance und auditfähige Data Governance
Regulierte Organisationen brauchen mehr als ein sauberes Dashboard an dem Tag, an dem eine Prüferin Nachweise verlangt. Sie brauchen eine fortlaufende Aufsicht über kritische Datenqualität, Validierung, Timeliness, strukturelle Änderungen, Verantwortlichkeiten und Kontrollhistorie.
Verantwortlich sind Governance-Leitung, Compliance Officer, interne Revision und Domänen-Datenverantwortliche. Die Signale kombinieren Validierungsergebnisse, Lieferstatus, Schemahistorie, Datenqualitätsanomalien und Nachweise, dass Kontrollen wie vorgesehen gewirkt haben. Eine Bank muss womöglich zeigen, dass Daten für aufsichtsrechtliches Reporting definierte Anforderungen erfüllten und rechtzeitig eintrafen. Eine Gesundheitsorganisation braucht vielleicht Nachvollziehbarkeit für sensible klinische Daten. Eine Behörde muss unter Umständen nachweisen, dass kritische Daten innerhalb der geforderten Umgebung dokumentierten Kontrollen unterlagen.
Kontrollmonitoring mit Nachweisen verbinden
digna kombiniert dafür Data Validation, Schema Tracker, Timeliness und In-Database-Ausführung. Die Deployment-Optionen für Private Cloud oder On-Premises halten sensible Daten in der Cloud, VPC oder im Rechenzentrum der Kundin. Diese Architektur unterstützt Governance-Anforderungen, bei denen das Verschieben von Produktionsdaten zu einem externen Monitoring-Dienst nicht akzeptabel ist.
Compliance-Teams sollten die Datendomänen identifizieren, die fortlaufende Aufsicht benötigen, Regeln in der Governance-Plattform dokumentieren und wiederkehrende Prüfzyklen etablieren. Die nächste Handlung je Alert sollte festlegen, ob das Thema Behebung, Ausnahmegenehmigung, Aufbewahrung von Nachweisen oder Eskalation erfordert. Der entstehende Nachweis sollte einer Prüferin helfen zu verstehen, was geprüft wurde, wann es geprüft wurde, was gescheitert ist, wer es untersucht hat und wie die Organisation reagiert hat.
Der Marktkontext zeigt, warum dies zu einem Plattformthema geworden ist und nicht zu einer engen Qualitätsaufgabe. Untersuchungen beziffern den Markt für Data Observability 2025 auf 2,94 Milliarden USD und prognostizieren 6,02 Milliarden USD bis 2030, was einer CAGR von 15,4 % entspricht, wobei Nordamerika üblicherweise als größter Markt und Asien-Pazifik als am schnellsten wachsende Region gilt (Marktbericht von The Business Research Company). Die Verbreitung wächst, weil Governance, Verlässlichkeit und operative Rechenschaft zunehmend zusammenfallen.
Für eine zusätzliche Perspektive auf den Aufbau von Datenschutz- und Compliance-Kontrollen siehe Insights von Nexus IT Group.
Data Observability: 8 Use Cases im Vergleich
Merkmal | 🔄 Umsetzungsaufwand | ⚡ Ressourcen & Geschwindigkeit | ⭐ Erwartete Wirksamkeit | 📊 Zentrale Ergebnisse / Wirkung | 💡 Ideale Einsatzfälle |
|---|---|---|---|---|---|
Erkennung veralteter und defekter Dashboards | Mittel, Einlernphase für die KI-Baseline erforderlich | Mittlerer Ressourcenbedarf; In-Database-Ausführung; Alerts in Echtzeit | ⭐⭐⭐⭐ | Weniger Dashboard-Ausfälle; kürzere Lösungszeit bei veralteten Daten | Kritische Dashboards, Führungsberichte, Finanzwesen, Handel, Gesundheitswesen |
Unentdeckte Datenverschiebung und Vermeidung von Model Drift | Hoch, benötigt historische Daten und Feinjustierung der Empfindlichkeit | Mittlerer bis hoher Rechenbedarf für Verteilungsanalyse; kontinuierliches Monitoring | ⭐⭐⭐⭐ | Frühe Drifterkennung; schützt die Leistung von ML-Modellen | Prognosen, Betrugserkennung, Abwanderungsmodelle, ML-Pipelines |
Lieferverzögerungen in Pipelines und SLA-Monitoring | Mittel, lernt Zeitpläne und erwartete Lieferzeiten | Niedriger bis mittlerer Ressourcenbedarf; schnelle Erkennung; senkt MTTD ⚡ | ⭐⭐⭐⭐ | SLAs durchsetzen; Alerts zu rechtzeitiger Lieferung; weniger verpasste Ladevorgänge | Nächtliche Jobs, zeitkritisches Reporting, regulierte Fristen |
Erkennung von Schemaänderungen und Vermeidung von Breaking Changes | Niedrig bis mittel, Baseline-Schema festlegen, dann fortlaufend prüfen | Geringer Ressourcenbedarf; sofortige Erkennung struktureller Änderungen | ⭐⭐⭐⭐⭐ | Stille Fehler verhindern; Debug-Zeit senken; Schema-Audit-Trail | Dynamische Quellen, ETL-Pipelines, Analytics Engineering |
Business-KPI-Monitoring und Anomalie-Alerts | Mittel, erfordert KPI-Definition und Saisonalitäts-Baselines | Mittlerer Ressourcenbedarf; Dashboards für Anwender; zeitnahe Alerts | ⭐⭐⭐⭐ | Geschäftswirksame Anomalien erkennen; Alert-Müdigkeit senken | Umsatzüberwachung, Produktkennzahlen, operative KPIs |
Durchsetzung von Geschäftsregeln und Compliance-Validierung | Hoch, anfängliche Regeldefinition und laufende Pflege | Mittlerer bis hoher Ressourcenbedarf für Prüfungen auf Satzebene; Audit-Logging | ⭐⭐⭐⭐⭐ | Kontinuierliche Regeldurchsetzung; auditfähige Nachweise; weniger nachgelagerte Fehler | Regulierte Domänen (Finanzwesen, Gesundheitswesen), Abrechnung, Compliance-Reporting |
Data Platform Observability und Consumption Monitoring | Hoch, integriert Plattformkennzahlen und Lastbaselines | Mittlerer Ressourcenbedarf; laufende Telemetrie; ermöglicht Kostenoptimierung | ⭐⭐⭐⭐ | Kapazitätsplanung; Kosteneinsparungen; Leistungsengpässe erkennen | Cloud-Warehouses, Plattformteams, Chargeback-Modelle |
Regulatorische Compliance & auditfähige Data Governance | Sehr hoch, modulübergreifende Integration und Governance-Abstimmung | Hoher Ressourcen- und Prozessaufwand; In-Database & private Deployments | ⭐⭐⭐⭐⭐ | Auditfähige Nachweise; geringeres Compliance-Risiko; Datensouveränität | Banken, Gesundheitswesen, öffentlicher Sektor, regulierte Reporting-Workflows |
Aus Alerts ein Verlässlichkeits-Betriebsmodell machen
Die acht Data-Observability-Use-Cases werden nützlich, wenn ein Team sie in einer Reihenfolge einführt, die dem Geschäftsrisiko entspricht. Beginnen Sie mit kritischen Datensätzen und Liefersignalen. Wenn Teams nicht wissen, ob wesentliche Tabellen eingetroffen sind oder ob Dashboards vollständig sind, erzeugen Anomalie- und KPI-Monitoring verwirrende Symptome statt handhabbarer Vorfälle.
Ergänzen Sie danach verhaltensbasierte Anomalieerkennung und Schema-Monitoring. Diese Kontrollen adressieren Fehler, die Job-Status-Prüfungen übersehen, darunter Verteilungsverschiebungen, fehlende Werte und strukturelle Änderungen. Für KI-abhängige Umgebungen wird dieses Fundament immer wichtiger. 2025 stieg die Verbreitung von KI-Monitoring von 42 % auf 54 % der Organisationen, während 73 % weiterhin keine Full-Stack-Observability hatten und die durchschnittliche Zahl der Observability-Werkzeuge von 6 auf 4,4 sank, weil Teams Plattformen konsolidierten (Ergebnisse der Observability-Umfrage von Databahn). Die praktische Konsequenz ist klar. Teams brauchen einen Untersuchungsablauf, der Datensatzgesundheit, Feature-Verhalten, Modellsignale und Geschäftsergebnisse miteinander verbindet.
Weiten Sie die Abdeckung dann auf Validierung, Business-KPIs, Plattformnutzung und regulatorische Nachweise aus. Validierung schützt bekannte Regeln. Business Monitoring schützt Entscheidungen. Platform Observability schützt die Infrastruktur, die Daten liefert und bereitstellt. Governance-Monitoring verwandelt operative Aktivität in Nachweise, die Compliance- und Audit-Teams prüfen können.
Jeder Alert sollte fünf Eigenschaften haben:
Benannte Verantwortung: Bestimmen Sie die Person oder das Team, das die Untersuchung übernimmt.
Schweregrad: Koppeln Sie die Priorität an die geschäftliche Wirkung, nicht nur an die technische Abweichung.
Erkennungssignal: Geben Sie an, ob der Auslöser Aktualität, Volumen, Verteilung, Schema, Validierung, KPI-Verhalten oder Plattformnutzung betrifft.
Untersuchungspfad: Verknüpfen Sie den Alert mit der Quelle, der Pipeline, der Tabelle, der Kennzahl, dem Modell oder dem nachgelagerten Konsumenten, der geprüft werden muss.
Eskalationsweg: Legen Sie fest, wann die verantwortliche Person Plattform-, Fach-, Compliance- oder Incident-Response-Teams einbeziehen muss.
digna unterstützt dieses Betriebsmodell über modulare Lizenzierung, sodass Organisationen mit einem Modul beginnen und über aktive Tabellen und Monitoring-Bedarfe hinweg erweitern können. Die In-Database-Ausführung und die Deployment-Optionen für Private Cloud oder On-Premises halten Produktionsdaten in der Umgebung der Kundin. Die Plattform enthält ab der ersten Modulauswahl einen Scheduler, einen Datenkatalog, Integrationen und Kollaborationsfunktionen und gibt Engineering- und Governance-Teams einen gemeinsamen Ort, um Vorfälle und Trends zu prüfen.
Wählen Sie die ersten Assets, indem Sie praktische Fragen stellen. Welche Tabellen speisen die folgenreichsten Dashboards oder Modelle? Welche Lieferungen haben die stärkste Zeitabhängigkeit? Welche Schemata ändern sich ohne verlässliche Kommunikation? Welche Datensätze tragen regulatorisches oder finanzielles Risiko? Welche KPIs lösen operative Entscheidungen aus? Welche Plattformlasten gefährden Verfügbarkeit oder Ressourcenkontrolle?
Überwachen Sie diese Tabellen und Kennzahlen zuerst. Benennen Sie die Verantwortung, bevor Sie den Alert aktivieren. Definieren Sie die Reaktion, bevor Sie Abdeckung messen. Verlässlichkeit steigt, wenn Observability-Signale zu gesteuerter Arbeit werden und nicht zu einem weiteren Telemetriestrom, für den niemand Zeit hat.
digna bietet Data Observability in der eigenen Umgebung durch Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking, Validierung auf Satzebene, Business Monitoring und Platform Observability. Besuchen Sie digna und prüfen Sie, wie die modulare In-Database-Plattform diese Data-Observability-Use-Cases mit benannten Verantwortlichen und handhabbaren Reaktionswegen verbinden kann.
Die Messschicht unter diesen Use Cases – Aktualität, Vollständigkeit, Schemastabilität, Validität und Verteilungsdrift sowie die Schwellenwerte, die in einen Liefervertrag gehören – finden Sie unter Data Quality Reliability.
Häufig gestellte Fragen
Was sind die wichtigsten Data-Observability-Use-Cases?
Acht decken den Großteil der Verlässlichkeitsarbeit ab: Erkennung veralteter Dashboards, Datenverschiebung und Model Drift, Lieferverzögerungen in Pipelines, Erkennung von Schemaänderungen, Business-KPI-Anomalien, Validierung von Geschäftsregeln, Plattform- und Nutzungsmonitoring sowie auditfähige Governance. Jeder verbindet ein Signal mit einer benannten Verantwortung und einem definierten Reaktionsweg.
Worin unterscheidet sich Data Observability von Pipeline-Monitoring?
Job-Status-Monitoring meldet, dass eine Pipeline gelaufen ist; Observability fragt, was sie geliefert hat. Eine Transformation kann bei drei fehlenden Partitionen gelingen, und eine umbenannte Spalte kann über einen Kompatibilitätspfad durchlaufen, während ihre Nullwertquote steigt. Das Dashboard aktualisiert in beiden Fällen erfolgreich.
Mit welchem Data-Observability-Use-Case sollte ein Team beginnen?
Beginnen Sie mit kritischen Datensätzen und Liefersignalen. Wenn niemand weiß, ob wesentliche Tabellen eingetroffen sind oder ob Dashboards vollständig sind, erzeugen Anomalie- und KPI-Monitoring verwirrende Symptome statt handhabbarer Vorfälle. Verhaltensbasierte Anomalieerkennung und Schema-Monitoring folgen, danach Validierung, KPIs, Plattformnutzung und regulatorische Nachweise.
Warum verursachen Schemaänderungen stille Fehler?
Hinzugefügte, entfernte, umbenannte oder umtypisierte Spalten stoppen selten eine Pipeline. Sie verursachen fehlende Werte, Typumwandlungen und falsche Joins, während die Ausführung weiterhin Erfolg meldet. Ein Schema-Alert ist ein Signal zur Wirkungskontrolle, er sollte deshalb betroffene Tabellen, Transformationen, Dashboards, Modelle und regulatorische Ausgaben benennen, nicht nur die Spalte.
Was macht einen Data-Observability-Alert handhabbar?
Fünf Eigenschaften: eine benannte Verantwortung, ein an die geschäftliche Wirkung gekoppelter Schweregrad, das Erkennungssignal, ein Untersuchungspfad zur Quelle oder zum Konsumenten und ein Eskalationsweg. Menge allein hilft nicht. Eine Umfrage aus dem Jahr 2025 ergab, dass nur 13 % der erhobenen Telemetrie aktiv für Monitoring oder Troubleshooting genutzt wurden.


