CMMI für Datenmanagement: Reife operativ nachweisen
|
7
min. Lesezeit

Der populärste Rat zu CMMI für Datenmanagement lautet, mit dem Dokumentieren von Richtlinien, dem Festlegen von Verantwortlichkeiten und dem Vorbereiten von Nachweisen für ein Assessment zu beginnen. Dieser Rat greift zu kurz. Eine Richtlinie, die „Datenqualität überwachen“ fordert, schützt kein Dashboard, wenn eine Quelle eine Spalte ergänzt, einen Datentyp ändert, eine Datei verspätet liefert oder eine Geschäftsregel verletzt. Reifes Datenmanagement muss belegen, dass Kontrollen über den gesamten Lebenszyklus wirken, nicht bloß, dass jemand sie aufgeschrieben hat.
CMMI wird nützlicher, wenn Teams es als Betriebsmodell für beobachtbare, wiederholbare und verbesserbare Datenprozesse behandeln. Dokumentation bleibt wichtig, besonders in regulierten Umgebungen, doch sie sollte Kontrollen beschreiben, die operative Nachweise erzeugen. Die praktische Frage ist nicht mehr nur, ob ein Governance-Prozess existiert. Sie lautet, ob die Organisation Fehler erkennen, ihre Wirkung erklären, Verantwortung zuweisen und nachweisen kann, dass sich die Leistung verbessert.
Inhaltsverzeichnis
CMMI für Datenmanagement verstehen
Vom Softwareprozess zur Datenfähigkeit
Die fünf Reifegrade und Bewertungskriterien
Was die Stufen operativ bedeuten
Warum die 25 Prozessgebiete zählen
Framework-Praktiken auf modernen Datenbetrieb abbilden
Prozesssprache in Kontrollverhalten übersetzen
Nachweise in den Workflow einbauen
Über statische Governance-Artefakte hinausgehen
Die Lebenszykluslücke
Ihre Roadmap zur Datenreife aufbauen
Ein phasenweises Vorgehen
Reife-KPIs je Umsetzungsphase
Reife mit der digna-Plattform beschleunigen
Module auf Reifenachweise abstimmen
Bereitstellungsoptionen vergleichen
Langfristige Datenverlässlichkeit und Vertrauen sichern
CMMI für Datenmanagement verstehen
Die Geschichte von CMMI erklärt sowohl seinen Wert als auch seinen Ruf. Die breitere Prozessverbesserungs-Chronologie begann 1987 mit der Arbeit am Software CMM, gefolgt von der ersten SW-CMM-Veröffentlichung 1991. Die integrierte CMMI-Produktsuite erschien erstmals 2000 und schuf eine breitere Grundlage zur Bewertung organisationaler Fähigkeit statt der Konzentration auf einzelne technische Aufgaben. Diese Historie dokumentiert die CMMI-Entwicklungsreferenz.
Das Framework gewann zudem Glaubwürdigkeit in Märkten, in denen Wiederholbarkeit und Prüfbarkeit nicht optional waren. Das Gansler Memo von 1999 verlangte DoD-Softwarebewertungen für ACAT-I-Programme und erklärte die vollständige Erfüllung von CMMI Capability Maturity Model Level 3 oder einer gleichwertigen genehmigten Bewertung zum Ziel des Ministeriums. CMMI for Acquisition folgte 2007, CMMI for Services 2009, und die drei Hauptvarianten wurden in Version 1.3 im November 2010 angeglichen, wie das CMMI Acquisition Handbook ausweist.
Vom Softwareprozess zur Datenfähigkeit
Das eigenständige Data Management Maturity- oder DMM-Modell übertrug diese Reifelogik auf Datenpraktiken im Unternehmen. Es erschien im August 2014 nach rund 3,5 Jahren Entwicklung und wurde als strukturierter Weg positioniert, Datenmanagement von Erzeugung oder Beschaffung bis zur Stilllegung zu bewerten. Diese Lebenszyklusperspektive macht das Modell für Organisationen relevant, die Warehouses, Lakes, operative Systeme, Reporting-Plattformen und KI-Pipelines betreiben.
Das DMM-Modell umfasst fünf Reifegrade und 25 Prozessgebiete über Strategie, Qualität, Betrieb, Plattformen und Architektur, Governance sowie unterstützende Prozesse. Sein Wert liegt in der Zerlegung. „Data Governance verbessern“ ist zu breit, um steuerbar zu sein; eine Prozessgebietssicht zeigt einem Team, ob die Schwäche bei Verantwortlichkeit, Qualitätskontrollen, Plattformpraktiken, Lebenszyklusbetrieb oder Messung liegt. Das DMM-Modellmaterial beschreibt das Framework als Weg, Fähigkeit zu bewerten, das Datenmanagementprogramm zu stärken und eine an Geschäftszielen ausgerichtete Verbesserungs-Roadmap zu erstellen.
Praxisregel: Behandeln Sie jede Reifeaussage als unvollständig, bis Sie sie mit wiederholbaren Nachweisen aus den Systemen verbinden können, die die Daten verarbeiten.
Dieses Prinzip verändert, wie Unternehmensteams Datenmanagement-Frameworks nutzen. CMMI ist weder eine veraltete Checkliste aus dem Software Engineering noch als Papierübung nützlich. Es ist ein strukturierter Weg, Datenstrategie, Kontrollen, Betriebsverhalten und Geschäftsergebnisse auszurichten, sofern das Assessment einbezieht, was in der Produktion geschieht.
Die fünf Reifegrade und Bewertungskriterien
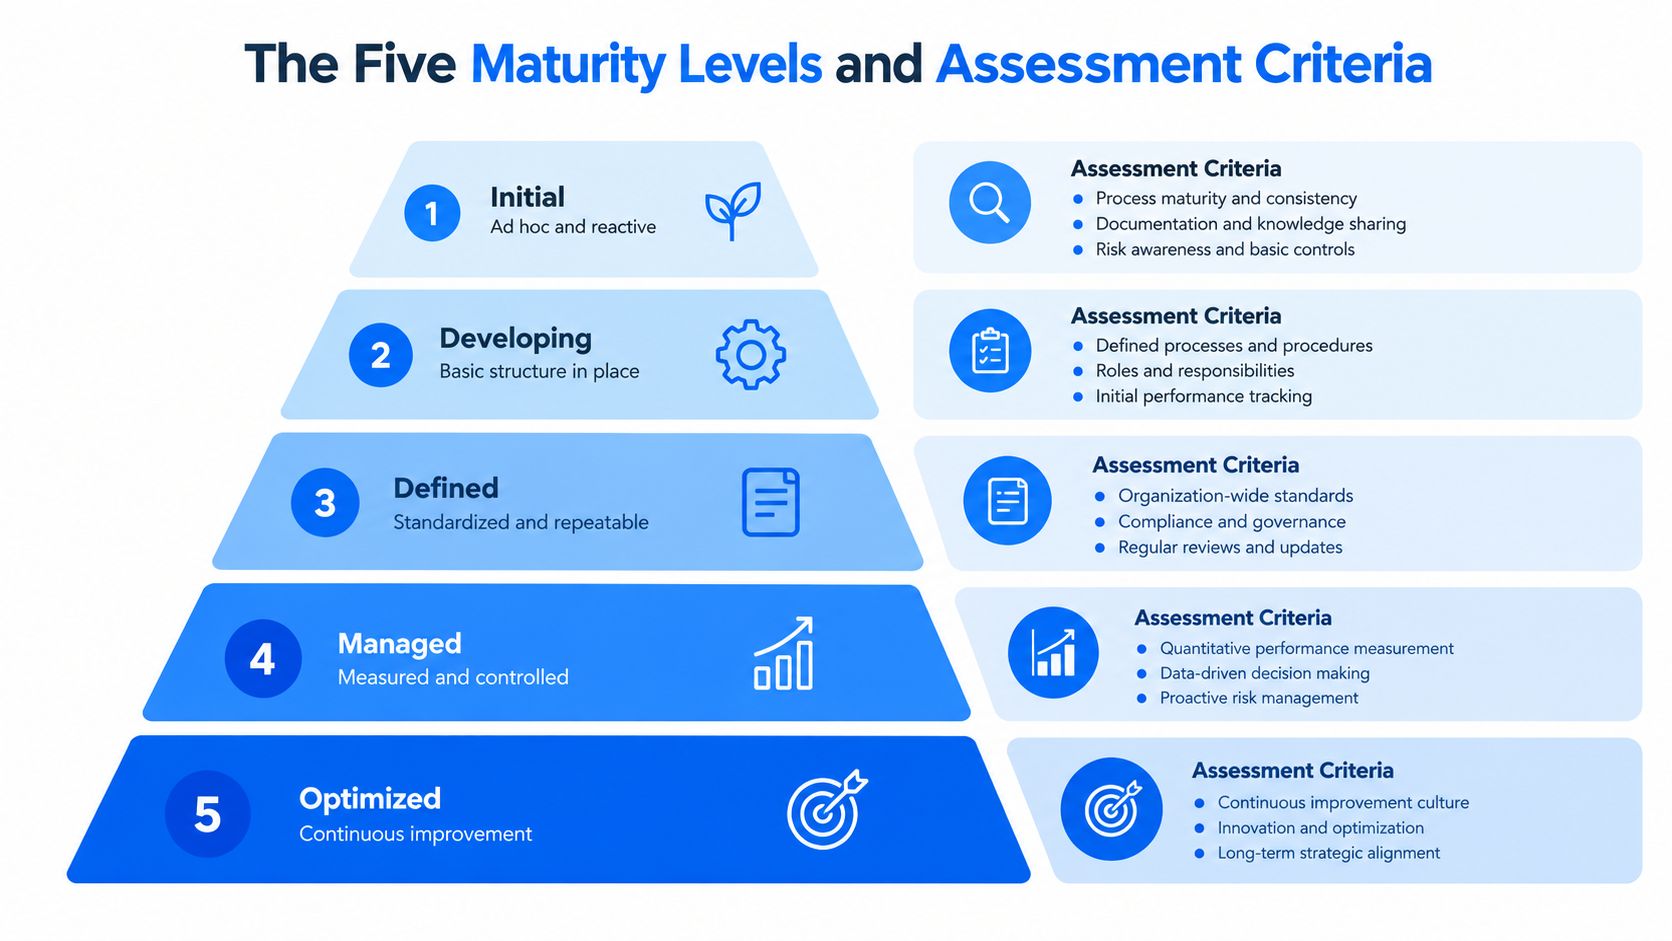
Ein Reifegrad beschreibt, wie konsistent eine Organisation ihre Prozesse ausführt und verbessert. Die fünfstufige Entwicklung führt von reaktivem Vorgehen auf Projektebene zu gemessener und optimierter Unternehmensfähigkeit. Die Stufen sollten nicht als Etiketten für eine Präsentationsfolie behandelt werden. Jede Stufe verlangt Nachweise, dass die Organisation Daten mit größerer Konsistenz, Sichtbarkeit und Kontrolle steuert.
Was die Stufen operativ bedeuten
Stufe 1, Initial, beschreibt unvorhersehbare und reaktive Arbeit. Teams hängen von individuellem Wissen, manuellem Eingreifen und vorfallgetriebenen Reaktionen ab. Daten erreichen womöglich weiterhin die Nutzer, doch die Organisation kann nicht verlässlich erklären, wie Kontrollen über Produkte oder Domänen hinweg wirken.
Stufe 2, Managed, führt Planung und Steuerung auf Projekt- oder Teamebene ein. Ein Pipeline-Team verfolgt vielleicht Qualitätsprobleme und Lieferpläne, doch die Praktiken können zwischen Abteilungen variieren. Nachweise existieren, bleiben aber fragmentiert und hängen oft an lokalen Konventionen.
Stufe 3, Defined, ist der Punkt, an dem unternehmensweite Standardisierung sichtbar wird. Teams nutzen gemeinsame Prozessdefinitionen, geteilte Datenbegriffe, dokumentierte Verantwortlichkeiten und einheitliche Kontrollmuster. Für den Datenbetrieb sollte das gemeinsame Erwartungen an Validierung, Vorfallbehandlung, Schema-Änderungsmanagement und Liefermonitoring einschließen.
Stufe 4, Quantitatively Managed, verlangt mehr als ein Dashboard voller Statusanzeigen. Teams nutzen quantitative Maße, um Prozessverhalten zu verstehen, Baselines zu etablieren, Streuung zu erkennen und Leistung gegen explizite Ziele zu steuern. Ein reifes Team kann einen isolierten Defekt von einer bedeutsamen Verschiebung bei Timeliness, Volumen, Vollständigkeit oder einer anderen überwachten Eigenschaft unterscheiden.
Stufe 5, Optimizing, wendet disziplinierte kontinuierliche Verbesserung an. Teams nutzen operative Nachweise, um Kontrollen zu schärfen, wiederkehrende Fehlerbilder zu beseitigen und die Leistung von Datenprozessen zu verbessern. Optimierung ist nicht dasselbe wie mehr Alerts. Sie bedeutet zu lernen, welche Signale zählen, vermeidbares Rauschen zu senken und Prozesse anhand beobachteten Verhaltens zu ändern.
Warum die 25 Prozessgebiete zählen
Die 25 Prozessgebiete gliedern Datenmanagement in bewertbare Fähigkeiten über Strategie, Datenqualität, Betrieb, Plattformen und Architektur, Governance sowie unterstützende Prozesse. Diese Granularität hilft Führungskräften, einen irreführenden unternehmensweiten Durchschnitt zu vermeiden. Ein Unternehmen kann starke Plattformkontrollen, aber eine schwache Datenstrategie haben, oder klar definierte Richtlinien bei schlechtem Lebenszyklusmonitoring.
Das DMM-Modell kann ein Assessment nach einem Data-Governance-Reifegradmodell stützen, das Fähigkeitslücken auf praktische Behebung abbildet. Ein Assessment sollte fragen, welche Nachweise für jedes relevante Gebiet vorliegen:
Definierte Verantwortung: Kann die Organisation verantwortliche Owner für kritische Daten und Kontrollen benennen?
Wiederholbare Ausführung: Wenden Teams denselben Prozess auf vergleichbare Datensätze an?
Gemessene Leistung: Werden Qualitäts-, Timeliness-, Struktur- und Vorfallmaße konsistent erhoben?
Managementreaktion: Nutzen Teams diese Maße, um Behebung zu priorisieren?
Verbesserungsverhalten: Können Führungskräfte zeigen, dass wiederkehrende Probleme zu Prozessänderungen führen?
Ein Workshop-Update beschrieb eine feinere Struktur aus 6 Kategorien, 15 Komponentenbereichen, 36 Geschäftsprozessgebieten, 18 Richtlinien und Verfahren sowie 200 Fähigkeitsmaßen im NDIA-Workshopmaterial. Dieser Detailgrad unterstreicht einen wichtigen Punkt. Die Qualität eines Assessments hängt von reproduzierbaren Nachweisen ab, nicht davon, wie poliert die Governance-Dokumentation aussieht.
Framework-Praktiken auf modernen Datenbetrieb abbilden
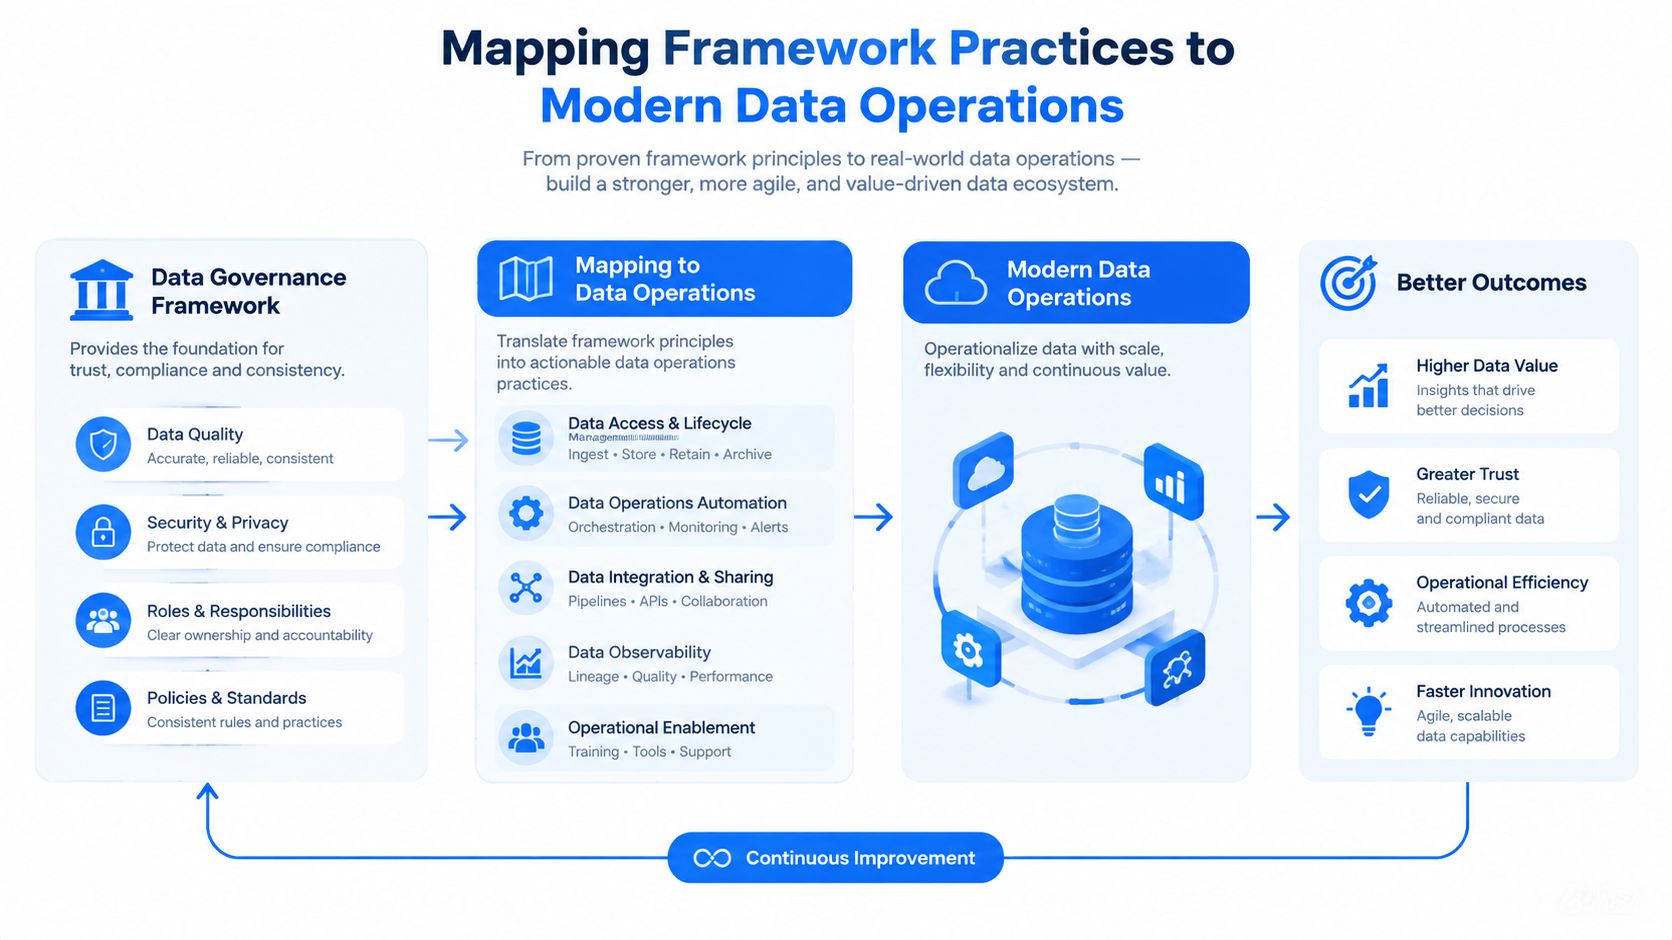
Ein CMMI-Prozessgebiet wird für Engineers nützlich, wenn es sich in ein beobachtbares und steuerbares Verhalten übersetzt. Die Abbildung sollte beim Geschäftsrisiko beginnen und dann das Datensignal identifizieren, das den Fehler offenlegt, die reagierende Kontrolle und den zur Prüfung aufbewahrten Nachweis.
Prozesssprache in Kontrollverhalten übersetzen
Beginnen Sie mit Schema-Management. Hinzugefügte Spalten, entfernte Spalten und Datentypänderungen können nachgelagerte Konsumenten brechen, besonders wenn Pipelines auf implizite Struktur bauen. Eine schriftliche Änderungsrichtlinie erkennt den Fehler nicht von allein. Kontinuierliches Schema-Tracking sollte die frühere Struktur, die beobachtete Änderung, betroffene Assets und den prüfungsverantwortlichen Owner festhalten. Das zugrunde liegende Schema-Drift-Problem beschreibt dieser Vergleich zur Data Observability im Unternehmen.
Instrumentieren Sie als Nächstes Timeliness. Verspätet eintreffende Daten können ebenso schädlich sein wie Daten mit ungültigen Werten. Eine Lieferkontrolle sollte erwartete Zeitpläne lernen oder nutzen, fehlende Ladungen erkennen, Verzögerungen und verfrühte Lieferungen melden und die erwartete Lieferzeit berechnen, wo möglich. Das schafft Nachweise operativer Konsistenz, statt darauf zu bauen, dass ein Teammitglied bemerkt, dass ein Bericht nicht aktualisiert wurde.
Wenden Sie dann Validierung auf Satzebene auf Felder an, bei denen deterministische Logik zählt. Regulierte oder wirkungsstarke Daten verlangen oft versionierte Kataloge von Geschäftsregeln, akzeptable Schwellenwerte und Aktualitäts-SLAs. Eine fehlgeschlagene Validierung sollte Regelversion, betroffene Datensätze oder Umfang, Ausführungszeit, Ergebnis und Behebungsstatus aufbewahren. Der Leitfaden zum Datenqualitätsmanagement beschreibt diesen Ansatz als Weg, konsistente Datentauglichkeit durchzusetzen und Auditierbarkeit zu stützen.
Nachweise in den Workflow einbauen
Eine praktische Umsetzung folgt vier Schritten:
Kritische Assets auswählen: Priorisieren Sie Datensätze, die regulatorisches Reporting, Finanzentscheidungen, klinischen Betrieb, Kundenzusagen oder KI-Workloads tragen.
Beobachtbare Erwartungen definieren: Legen Sie gültige Strukturen, Geschäftsregeln, Lieferverhalten und akzeptable Metrikmuster fest.
Erkennung automatisieren: Führen Sie Prüfungen dort aus, wo die Daten bereits liegen, und erfassen Sie Ergebnisse in einem gemeinsamen Vorfall- und Historienverzeichnis.
Reaktion an Governance koppeln: Weisen Sie Owner zu, dokumentieren Sie Entscheidungen, halten Sie Ausnahmen fest und verfolgen Sie wiederkehrende Fehler im Trend.
Ein Observability-Framework für Daten wird damit mehr als ein Monitoring-Dashboard. Es liefert die operative Schicht, die CMMI-Erwartungen mit Pipeline-Verhalten verbindet. Engineers erhalten handlungsfähige Fehlersignale, Governance-Teams nachvollziehbare Nachweise, und fachliche Owner sehen, ob kritische Daten zwecktauglich bleiben.
Eine reife Kontrolle sagt nicht bloß, dass ein Datensatz gesteuert wird. Sie zeigt, was sich geändert hat, wann die Änderung eintrat, wer sie geprüft hat und ob die Geschäftswirkung eingegrenzt wurde.
Über statische Governance-Artefakte hinausgehen
Schriftliche Richtlinien sind notwendig, aber kein Beleg für Widerstandsfähigkeit. Ein Team kann einen gründlichen Regelkatalog pflegen und dennoch eine schleichende Volumenverschiebung, eine verspätete vorgelagerte Lieferung oder eine strukturelle Änderung übersehen, die nachgelagerte Tabellen technisch verfügbar, semantisch aber falsch lässt.
Die Benchmark-Belege deuten auf ein breiteres organisationales Problem. Das EDM Council berichtet, dass Datenstrategie, Datenmanagementstrategie und Business Case branchenübergreifend zu den am wenigsten ausgereiften strategiebezogenen Fähigkeiten zählen, wobei weniger als ein Drittel der Befragten dort fortgeschrittenen Fortschritt erreicht, wie seine Branchenbenchmarks zeigen. Die Folgerung ist nicht, dass Teams mehr Dokumente brauchen. Sie brauchen dauerhafte Finanzierung, Priorisierung und Akzeptanz über Engineering, Governance, Analytik, Risiko und Fachbereiche hinweg.
Die Lebenszykluslücke
Eine akademische Übersichtsarbeit von 2026 identifizierte 11 wesentliche Defizite in der bestehenden Literatur zur Datenmanagementreife, darunter unzureichende Abdeckung des vollständigen Datenlebenszyklus, fehlende praktische Selbstbewertungsschemata und schwache Behandlung rechtlicher sowie ISO-bezogener Compliance. Diese Befunde stützen eine unbequeme Schlussfolgerung: Reifeprogramme überbetonen oft statische Artefakte und unterschätzen operative Nachweise. Die Arbeit ist über die IEEE Computer Society verfügbar.
Statische Kontrollen scheitern auf vorhersehbare Weise:
Manuelle Regelpflege: Regeln veralten, wenn sich Schemata, Quellen und fachliche Definitionen ändern.
Punktuelle Bewertung: Ein Audit kann bestätigen, dass ein Prozess existierte, ohne zu zeigen, wie er sich zwischen den Prüfungen verhalten hat.
Getrennte Verantwortung: Governance verantwortet womöglich die Richtlinie und Engineering die Ausführung, ohne gemeinsame Sicht auf den Fehler.
Ungemessene Ausnahmen: Teams genehmigen Ausnahmen, ohne zu verfolgen, ob sie zum Dauerzustand werden.
Kontinuierliches Monitoring adressiert diese Schwächen, indem es Verhalten über die Zeit erfasst. In-Database-Observability hält Daten in der Kundenumgebung und berechnet Metriken dort, wo die Daten bereits liegen, und unterstützt Anomalieerkennung, Schema-Tracking, Timeliness-Monitoring und Validierung auf Satzebene. Der Überblick zur In-Database-Observability erklärt, warum dieses Design unnötige Datenbewegung reduziert und zugleich operative Prüfungen trägt.
Ziel ist nicht, Dokumentation abzuschaffen. Ziel ist, dass Dokumentation Kontrollen beschreibt, die laufen, Nachweise erzeugen und verantwortliches Handeln auslösen.
Ihre Roadmap zur Datenreife aufbauen
Eine Reife-Roadmap sollte beim operativen Risiko beginnen, nicht bei der Stufe, die eine Geschäftsführung verkünden möchte. Bewerten Sie die kritischen Datenprodukte, identifizieren Sie die Fehlerbilder mit der größten geschäftlichen Exposition und finanzieren Sie dann zuerst die Prozessgebiete, die diese Exposition senken.
Ein phasenweises Vorgehen
Phase eins schafft eine belastbare Baseline. Erstellen Sie ein praktikables Inventar kritischer Datensätze, Owner, Lineage, fachlicher Definitionen, Richtlinien und bekannter Konsumenten. Versuchen Sie nicht, vor dem Start jedes Asset zu katalogisieren. Das erste Ziel ist zu erkennen, wo ein Fehler Reporting, Compliance, Betrieb oder KI treffen würde.
Phase zwei macht Kontrollen wiederholbar. Standardisieren Sie Validierungsmuster, Vorfallverantwortung, Schemaprüfung und Liefererwartungen. Teams sollten Nachweise automatisch sammeln, statt Engineers während eines Assessments Screenshots und Tabellen zusammentragen zu lassen.
Phase drei führt quantitatives Management ein. Verfolgen Sie das Verhalten kritischer Datensätze im Trend, unterscheiden Sie normale Streuung von bedeutsamen Anomalien und verbinden Sie Vorfälle mit Serviceerwartungen. Maße sollten Managern bei Investitionsentscheidungen helfen, nicht bloß einen Statusbericht schmücken.
Phase vier optimiert das Betriebsmodell. Entfernen Sie rauschende Prüfungen, schärfen Sie Schwellenwerte, verbessern Sie Eskalationswege und nutzen Sie historische Nachweise, um wiederkehrende Fehler zu verhindern. Optimierung sollte manuellen Aufwand senken und zugleich das Vertrauen in die empfangenen Signale erhöhen.
Reife-KPIs je Umsetzungsphase
Umsetzungsphase | Angestrebter Reifegrad | Leistungskennzahlen (KPIs) | Erforderliche operative Nachweise |
|---|---|---|---|
Baseline und Verantwortung | Initial bis Managed | Kritische Assets identifiziert, verantwortliche Owner zugewiesen, bekannte Fehlerbilder erfasst | Katalogeinträge, Verantwortungszuweisungen, Richtlinieninventar, Risikoregister |
Standardisierte Kontrollen | Managed bis Defined | Validierungsabdeckung, Abdeckung der Schemaänderungsprüfung, definierte Liefererwartungen, Nutzung des Vorfall-Workflows | Versionierte Regeln, Schemahistorie, Timeliness-Aufzeichnungen, Vorfallzuweisungen |
Quantitatives Management | Defined bis Quantitatively Managed | Anomaliehäufigkeit, Muster von Validierungsfehlern, Lieferabweichung, Zeit bis zur Erkennung, Zeit bis zur Bestätigung | Historische Metriktrends, Baselines, Alert-Historie, Reaktionszeitstempel |
Kontinuierliche Optimierung | Quantitatively Managed bis Optimizing | Rückgang wiederkehrender Probleme, Nützlichkeit von Alerts, abgeschlossene Behebungen, Verfeinerung der Kontrollen | Verbesserungsentscheidungen, Post-Incident-Analysen, geänderte Schwellenwerte, Trendnachweise |
Teams können eine fokussierte Datenqualitäts-Umsetzung nutzen, um die Roadmap in Arbeit zu überführen, die Engineers und Governance-Verantwortliche teilen können. Halten Sie die Entscheidungsmatrix einfach: Priorisieren Sie Kontrollen dort, wo die Wirkung hoch, die Erkennung derzeit schwach und die Behebung mit vorhandener Verantwortung machbar ist.
Entscheidungsprinzip: Beseitigen Sie die blinden Flecken, die wichtige Entscheidungen stillschweigend entwerten können, bevor Sie Kontrollen für Daten mit geringem Risiko ergänzen.
Eine Roadmap gelingt, wenn jede Phase nutzbare Nachweise und sichtbare Risikominderung erzeugt. Sie scheitert, wenn die Organisation Reife als Zertifizierungsprojekt ohne Bezug zum täglichen Pipeline-Betrieb behandelt.
Reife mit der digna-Plattform beschleunigen
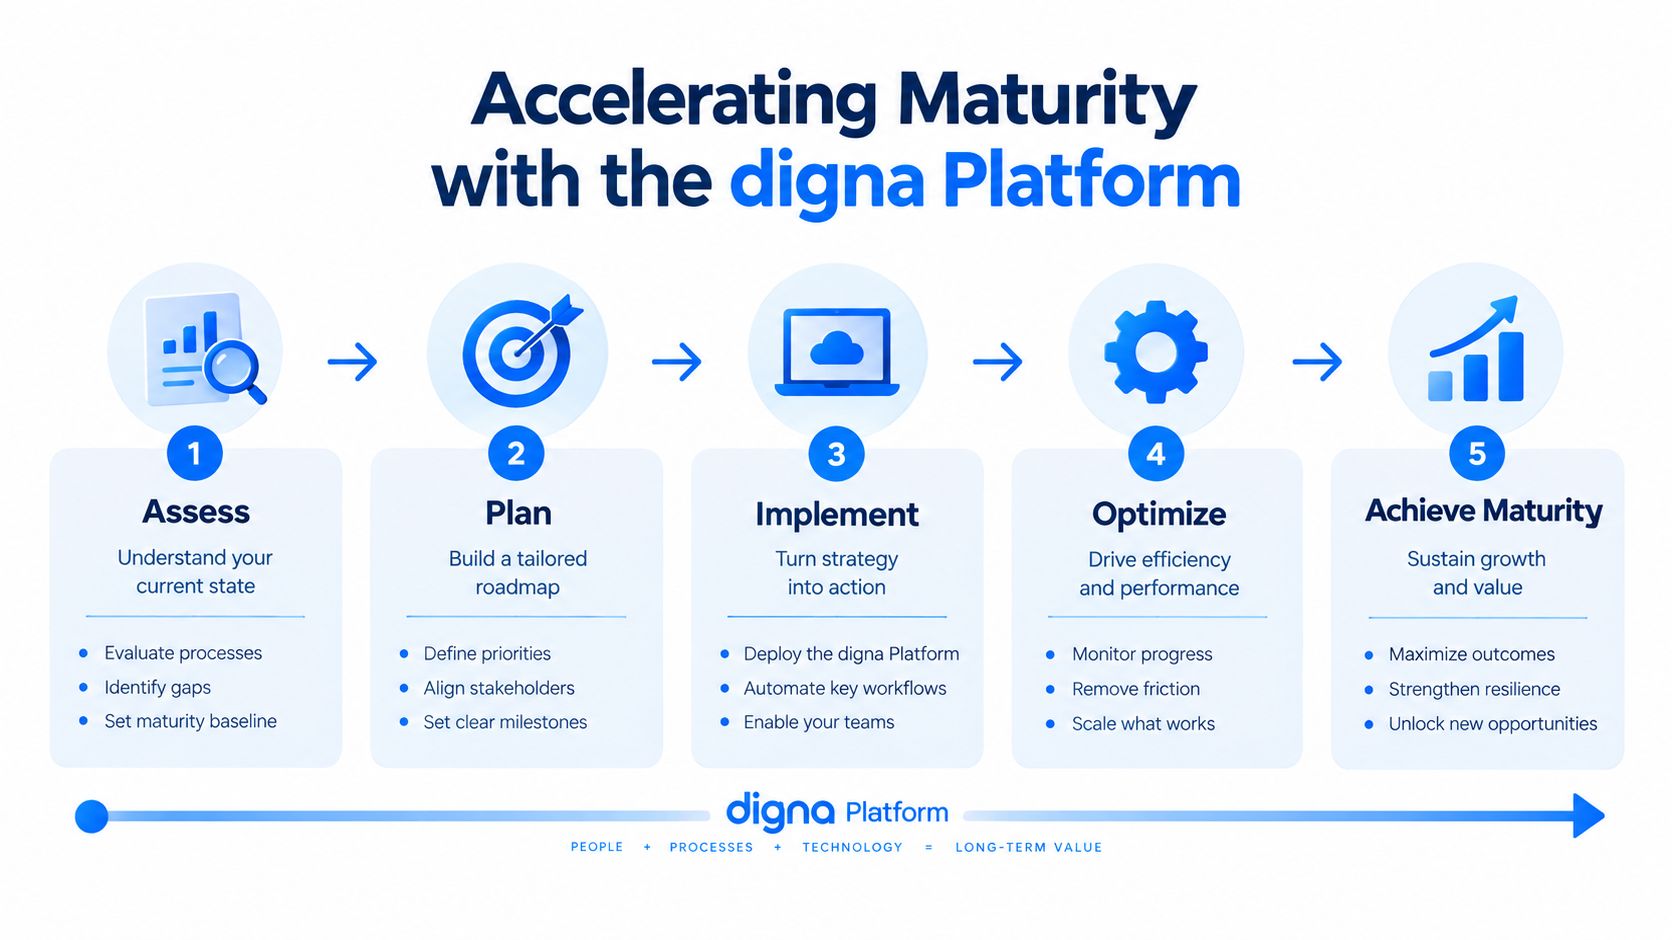
Die Technologiewahl sollte der Nachweisanforderung folgen. Teams können getrennte Monitoring-Werkzeuge kombinieren, interne Prüfungen bauen oder eine modulare Plattform nutzen, die strukturelle, verhaltensbezogene, lieferbezogene und satzbezogene Signale in einer Betriebssicht zusammenführt. Die Abwägung ist klar. Eigenbau-Prüfungen bieten präzise Kontrolle, verlangen aber laufende Engineering-Verantwortung, während unverbundene Werkzeuge fragmentierte Vorfälle und uneinheitliche Nachweise erzeugen können.
Module auf Reifenachweise abstimmen
In einer frühen Reifephase liefert Schema Tracker ein sichtbares Verzeichnis struktureller Änderungen, einschließlich hinzugefügter oder entfernter Spalten und Datentypänderungen. Das stützt einen definierten Prüfprozess, ohne dass Engineers jede Änderung erst über einen nachgelagerten Fehler entdecken müssen.
Für verhaltensbezogene Überwachung nutzt Data Anomalies KI-gestütztes Baseline-Lernen und fortlaufende Anomalieerkennung, ohne dass für jedes erwartete Muster manuelle Regeln nötig sind. Data Analytics ergänzt historische Analyse, sodass Teams Trends, Volatilität und statistisches Verhalten prüfen können, statt nur auf den jüngsten Alert zu reagieren.
Timeliness adressiert Lieferzuverlässigkeit. Es überwacht Ankunftsverhalten, meldet Verzögerungen, fehlende Ladungen und verfrühte Lieferungen und berechnet die erwartete Lieferzeit. Data Validation übernimmt deterministische Prüfungen auf Satzebene gegen Geschäftsregeln und eignet sich damit für regulierte Felder, Auditanforderungen und gezielte Qualitätskontrollen.
Bereitstellungsoptionen vergleichen
Das In-Database-Ausführungsmodell der Plattform berechnet und analysiert Metriken innerhalb der Datenbanken des Kunden, sodass Produktionsdaten an Ort und Stelle bleiben. Private-Cloud- und On-Premises-Optionen erlauben den Betrieb des Systems in der eigenen Cloud, VPC oder im Rechenzentrum, was strengen Sicherheits-, Governance- und Datenresidenzanforderungen entspricht.
Ein gemeinsames Dashboard gibt Data Engineers, Analysten und Stakeholdern einen Ort, um Vorfälle, Trends und Status zu prüfen. Das System enthält zudem Scheduler, Datenkatalog, Integrationen und Kollaborationsfunktionen ab der ersten Modulauswahl. Modulare Lizenzierung erlaubt den Start mit einem Modul und die Erweiterung, mit Preisen aus Grundgebühr plus aktiven Tabellen je Modul.
Das macht die digna-Lösung für Datenqualitätsmanagement zu einer praktikablen Option für Teams, die CMMI-Nachweise mit Produktionsverhalten verbinden wollen, ohne den Werkzeugwildwuchs zu vergrößern. Sie ersetzt weder Verantwortung noch Richtlinienentscheidungen oder Behebungsdisziplin. Sie automatisiert die Beobachtung und Nachweissammlung, die diese Praktiken verlangen.
Langfristige Datenverlässlichkeit und Vertrauen sichern
CMMI für Datenmanagement sollte als kontinuierliche Betriebsdisziplin geführt werden, nicht als periodische Dokumentationsübung. Die reife Organisation verbindet Governance-Anforderungen mit beobachtbarem Verhalten über Struktur, Lieferung, Geschäftsregeln und Datenmuster hinweg. Dieses Vorgehen gibt Führungskräften Belege, dass Kontrollen in der Produktion wirken, und Engineers Signale, auf die sie reagieren können, bevor Fehler die Konsumenten erreichen.
Die ersten drei Maßnahmen sind praktisch:
Executive-Sponsoring sichern: Koppeln Sie das Assessment an konkrete Risiken in Reporting, Compliance, Betrieb und KI.
Kritische Datenprozesse bewerten: Bilden Sie Verantwortung, Qualität, Betrieb, Plattformen, Governance und unterstützende Prozesse auf das Fünf-Stufen-Modell ab.
Automatisiertes Monitoring wählen: Instrumentieren Sie Schemaänderungen, Timeliness, Anomalien und Validierung auf Satzebene innerhalb der Kundenumgebung.
Höhere Reife entsteht nicht durch das Sammeln weiterer Richtliniendokumente. Sie entsteht, indem wichtiges Datenverhalten sichtbar, messbar und Gegenstand disziplinierter Verbesserung wird. Dieses Fundament trägt schnellere Vorfallreaktion, stärkere Compliance-Nachweise und dauerhaftes Vertrauen in die Datenbestände des Unternehmens.
digna bietet eine Plattform für Datenqualität und Observability in der eigenen Umgebung, für Anomalieerkennung, Timeliness-Monitoring, Validierung auf Satzebene und Schema-Tracking. Besuchen Sie digna, um CMMI-Reifeziele mit kontinuierlichen operativen Nachweisen über Ihren kritischen Datenbestand hinweg zu verbinden.
Eine Reifesicht, die speziell auf Datenqualität statt auf Prozessgebiete aufbaut, bietet das Reifegradmodell für Datenqualität.
Häufig gestellte Fragen
Was ist CMMI für Datenmanagement?
CMMI ist ein Prozessverbesserungsmodell, das beschreibt, wie konsistent eine Organisation definierte Praktiken ausführt, hier angewandt auf Datenarbeit. Es bewertet Reife danach, ob Prozesse wiederholbar und verbesserbar sind, nicht danach, welche Werkzeuge Sie besitzen. Deshalb hebt Dokumentation allein nie eine Stufe.
Was bedeuten die CMMI-Reifegrade in der Praxis?
Die Stufen beschreiben Verhalten, nicht Papier. Auf den unteren Stufen gelingt Datenarbeit, weil Einzelne sie gelingen lassen; höhere Stufen bedeuten, dass dasselbe Ergebnis unabhängig davon entsteht, wer Dienst hat, weil der Prozess definiert, gemessen und bewusst verbessert wird.
Warum sind die 25 Prozessgebiete wichtig?
Sie verhindern, dass Reife zu einem einzigen vagen Wert wird. Jedes Gebiet benennt eine eigene Fähigkeit, sodass ein Assessment zeigen kann, dass Ihre Messpraxis stark, Ihr Konfigurationsmanagement aber schwach ist, was weit handlungsleitender ist als eine Gesamtnote.
Wie erzeugt man Nachweise für ein CMMI-Appraisal?
Bauen Sie sie in den Workflow ein, statt sie vorher zusammenzustellen. Laufend ausgeführte Kontrollen — Validierungsergebnisse, Timeliness-Aufzeichnungen, Schemaänderungshistorie — erzeugen Appraisal-Nachweise als Nebenprodukt, was günstiger und schwerer anfechtbar ist als ein eigens fürs Audit geschriebenes Dokument.
Worin unterscheidet sich CMMI von einem Datenqualitäts-Reifegradmodell?
CMMI bewertet Prozessdisziplin über das gesamte Datenmanagement, einschließlich qualitätsferner Gebiete. Ein Datenqualitäts-Reifegradmodell geht allein bei Qualität in die Tiefe. Teams nutzen CMMI oft für die organisationale Bewertung und ein Qualitätsmodell für das operative Detail.


