Warum Datenqualität wichtig ist und wie schlechte Daten den ROI schädigen
|
7
min. Lesezeit

Ein Dashboard kann perfekt formatiert sein, planmäßig aktualisieren und ein Führungsteam trotzdem zu einer falschen Entscheidung führen. Ein doppelter Kundendatensatz kann die Nachfrage aufblähen, ein verspäteter Transaktionsladevorgang kann die Liquiditätsberichterstattung verzerren, und ein geänderter Spaltentyp kann ein Modell unbrauchbar machen. Der technische Defekt mag klein wirken. Die geschäftliche Konsequenz ist es selten.
Gartner schätzt, dass schlechte Daten Unternehmen im Durchschnitt mindestens 12,9 Millionen USD pro Jahr kosten, während von der MIT Sloan Management Review zitierte Untersuchungen den Umsatzverlust durch mangelhafte Datenqualität bei vielen Unternehmen auf 15 % bis 25 % beziffern (Belege zur Verbesserung der Datenqualität). Diese Zahlen erklären, warum Datenqualität eine ökonomische Steuerungsebene ist und nicht bloß eine Pflichtaufgabe des Data Engineering.
Inhaltsverzeichnis
Einleitung: Warum schlechte Daten gute Entscheidungen zerstören
Die Kosten sind größer als der Defekt
Was gute Datenqualität wirklich bedeutet
Genauigkeit eröffnet das Rezept
Die übrigen Dimensionen bestimmen die Nutzbarkeit
Wie mangelhafte Datenqualität Geschäft und Technik schädigt
Wo der Schaden sichtbar wird
Warum Datenqualität für KI und Governance noch wichtiger ist
KI verstärkt Defekte über Workflows hinweg
Reife bedeutet nachweisbare Eignung
Reale Risikobeispiele bei fehlender Datenqualität
Reaktive Reparatur statt früher Kontrolle
Datenqualität mit Validierung, Timeliness und Monitoring steuern
Mit expliziten Erwartungen beginnen
Lieferung und Struktur überwachen
Fazit: Vertrauen in Daten für Analytics und KI aufbauen
Einleitung: Warum schlechte Daten gute Entscheidungen zerstören
Eine Finanzverantwortliche sieht, dass der Umsatz in einer Region nachlässt, verschiebt Einstellungen, kürzt Bestände und stoppt eine Kampagne. Später stellt eine Analystin fest, dass ein Quellsystem seine Transaktionsklassifizierung geändert hat. Das Dashboard zeigte plausible Zahlen, deshalb blieb der Fehler unbemerkt und prägte reale Entscheidungen.
Analytics und KI erzeugen dieselbe Gefährdung in anderer Form. Ein Prognosemodell kann aus unvollständiger Historie eine gut formulierte Empfehlung erzeugen. Ein Workflow zur Kundenrisikobewertung kann veraltete Attribute verwenden. Ein Managementbericht kann technisch stimmig sein und dabei Datensätze verbinden, die auf unterschiedlichen Definitionen beruhen. Das Ergebnis sind Nacharbeit, verzögertes Handeln und schwindendes Vertrauen in die Datenplattform.
Die Kosten sind größer als der Defekt
Mangelhafte Datenqualität wirkt wie ein Fehler in einer gemeinsam genutzten Versorgungsleitung. Engineers prüfen Pipelines, Analystinnen und Analysten gleichen widersprüchliche Zahlen ab, Führungskräfte warten auf Bestätigung, und Fachbereiche verschieben Entscheidungen. Erreicht das Problem mehrere nachgelagerte Systeme, wird jede Kopie zu einer weiteren Stelle, die untersucht und korrigiert werden muss.
Branchenbelege, zusammengefasst in TechTargets Erläuterung zur Datenqualität, zeigen, dass die durchschnittliche Zahl monatlicher Datenqualitätsvorfälle von 59 im Jahr 2022 auf 67 im Jahr 2023 stieg, während der durchschnittlich betroffene Umsatzanteil von 26 % auf 31 % zunahm. Eine separate Finanzumfrage aus dem Jahr 2022 ergab laut derselben Quelle, dass 86 % der Führungskräfte nicht darauf vertrauten, dass ihre Daten Entscheidungen tragen können.
Die ökonomische Steuerungsebene ist damit ebenso die Zeit wie die Korrektheit. Ein vor der Veröffentlichung erkannter Defekt erfordert womöglich eine einzige Korrektur. Derselbe Defekt, entdeckt nachdem Dashboards, operative Workflows und Modelle ihn konsumiert haben, verlangt eine Untersuchung entlang jedes betroffenen Pfads. Prävention und schnelle Erkennung verringern diesen Aufwand, selbst wenn perfekte Daten unerreichbar bleiben.
Auch der Vertrauensverlust verändert die Arbeitsweise. Teams ergänzen manuelle Prüfungen, pflegen Schattentabellen und fordern wiederholte Freigaben. Die Organisation mag moderne Warehouses, Dashboards und Machine-Learning-Systeme besitzen, dennoch verlangsamen sich Entscheidungen, weil niemand die Eingangsdaten schnell verifizieren kann.
Ein sinnvoller Ausgangspunkt ist die Definition von Datenqualität: Daten sind wertvoll, wenn sie für die Entscheidung, den Prozess oder das Modell geeignet sind, das sie nutzt. Der Maßstab ist verlässliche Nutzung, gemessen daran, wie schnell Probleme verhindert oder gefunden werden.
Was gute Datenqualität wirklich bedeutet
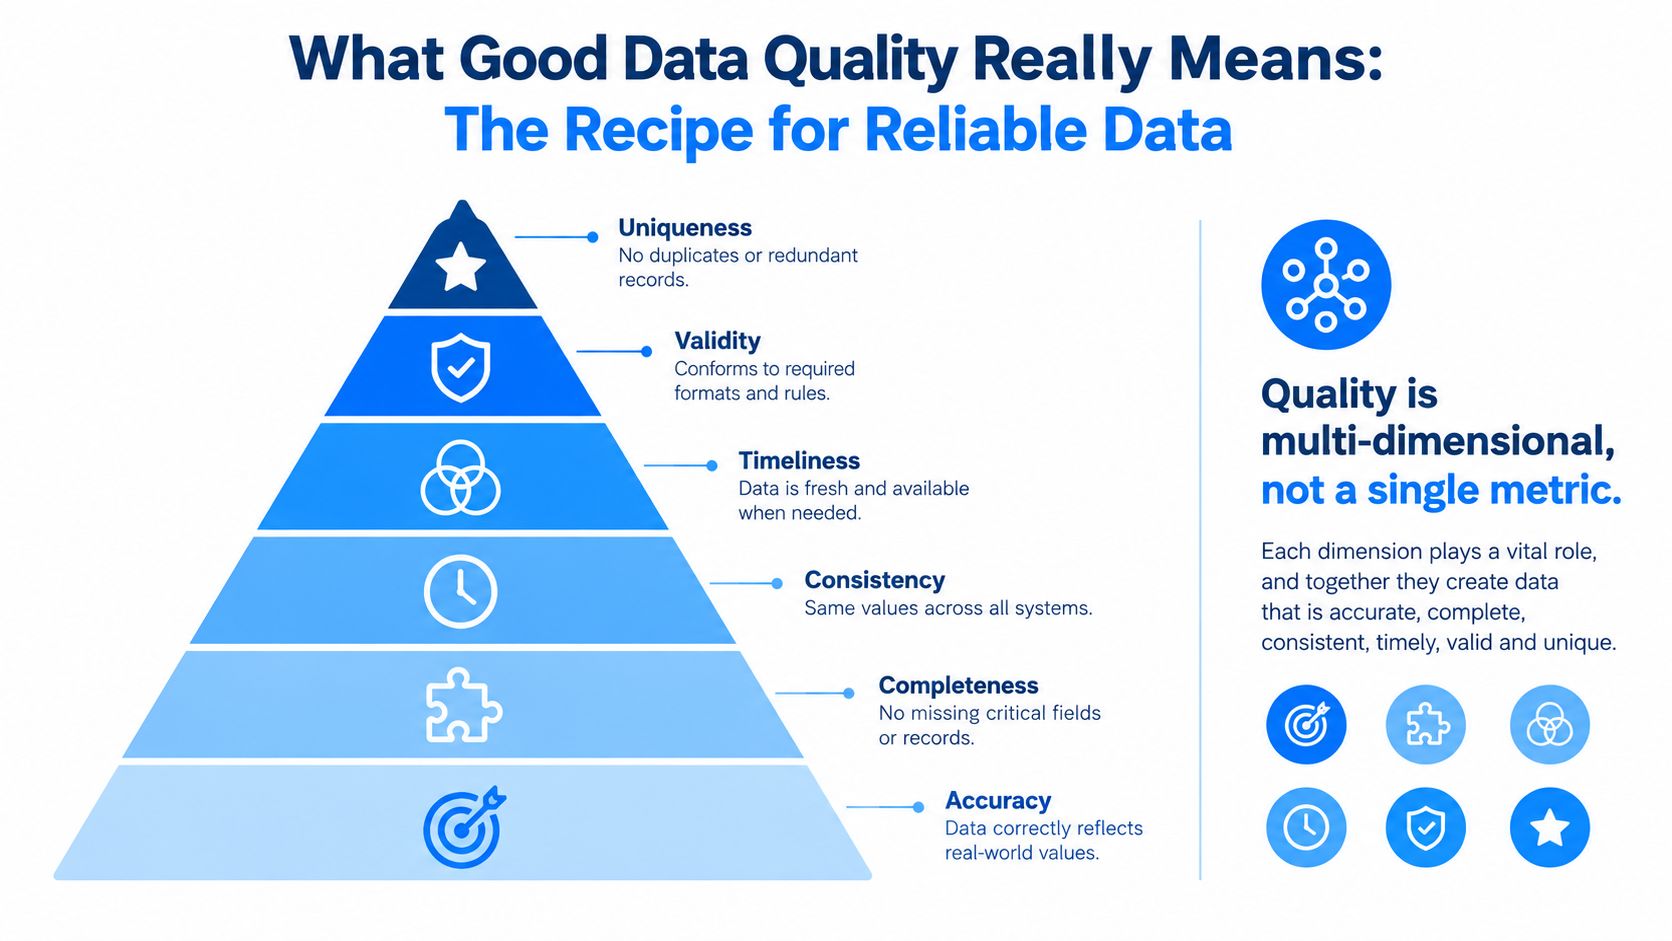
Stellen Sie sich einen Datensatz als die Zutaten für ein Rezept vor. Frische Zutaten genügen nicht, wenn die Mengen falsch sind, ein notwendiger Bestandteil fehlt, zwei Packungen dasselbe Produkt unterschiedlich benennen oder die Zutaten eintreffen, nachdem die Küche geschlossen hat. Ein verlässliches Ergebnis hängt vom Zusammenspiel mehrerer Bedingungen ab.
Datenqualität bedeutet Eignung für den Verwendungszweck. Ein Datensatz kann vorhanden, abfragbar und technisch valide sein und für eine bestimmte fachliche Fragestellung dennoch ungeeignet bleiben.
Genauigkeit eröffnet das Rezept
Genauigkeit fragt, ob ein Wert die Realität abbildet. Eine Kundenadresse, ein Kontostand, ein Produktpreis oder ein medizinischer Code kann im richtigen Feld gespeichert und trotzdem falsch sein. Genauigkeit erfordert in der Regel den Abgleich mit einer vertrauenswürdigen Quelle, einer Transaktionsregel oder einer bekannten fachlichen Bedingung.
Vollständigkeit fragt, ob kritische Datensätze und Felder existieren. Ein fehlender Kundenidentifikator kann Joins verhindern. Ein fehlender Zeitstempel kann die Messung der Aktualität unmöglich machen. Nicht jede Leerstelle ist ein Fehler, aber jede wichtige Leerstelle braucht eine definierte Interpretation.
Konsistenz fragt, ob Systeme übereinstimmen. Wenn eine Anwendung eine Kundin als „aktiv“ führt und eine andere eine abweichende Statusregel verwendet, kann jede Tabelle für sich stimmig wirken, während die unternehmensweite Sicht widersprüchlich ist.
Die übrigen Dimensionen bestimmen die Nutzbarkeit
Timeliness misst, ob Daten früh genug für ihren Zweck eintreffen. Ein tägliches Planungsreporting und ein Echtzeit-Workflow zur Betrugserkennung haben unterschiedliche Erwartungen.
Validität prüft, ob Werte den geforderten Formaten und Regeln folgen. Datumsangaben sollten als Datum interpretierbar sein, Identifikatoren akzeptierten Mustern folgen und Statuswerte zu einer freigegebenen Menge gehören.
Eindeutigkeit verhindert, dass doppelte oder redundante Datensätze Zählungen, Salden oder Kundenhistorien verändern.
Diese Dimensionen sind nicht austauschbar. Ein Datensatz kann genau, aber verspätet sein, vollständig, aber inkonsistent, oder aktuell, aber ungültig. Deshalb verdeckt ein einzelner Qualitätswert oft das eigentliche Problem.
Die praktische Aufgabe besteht darin, Qualität je Anwendungsfall zu definieren. Ein aufsichtsrechtlicher Bericht priorisiert womöglich Vollständigkeit, Validität und Prüfbarkeit. Ein Empfehlungsmodell benötigt neben Genauigkeit vielleicht Repräsentativität, Aktualität und Ausgewogenheit. Die Dimensionen der Datenqualität geben Teams ein Vokabular, um vage Bedenken in prüfbare Erwartungen zu überführen.
Wie mangelhafte Datenqualität Geschäft und Technik schädigt
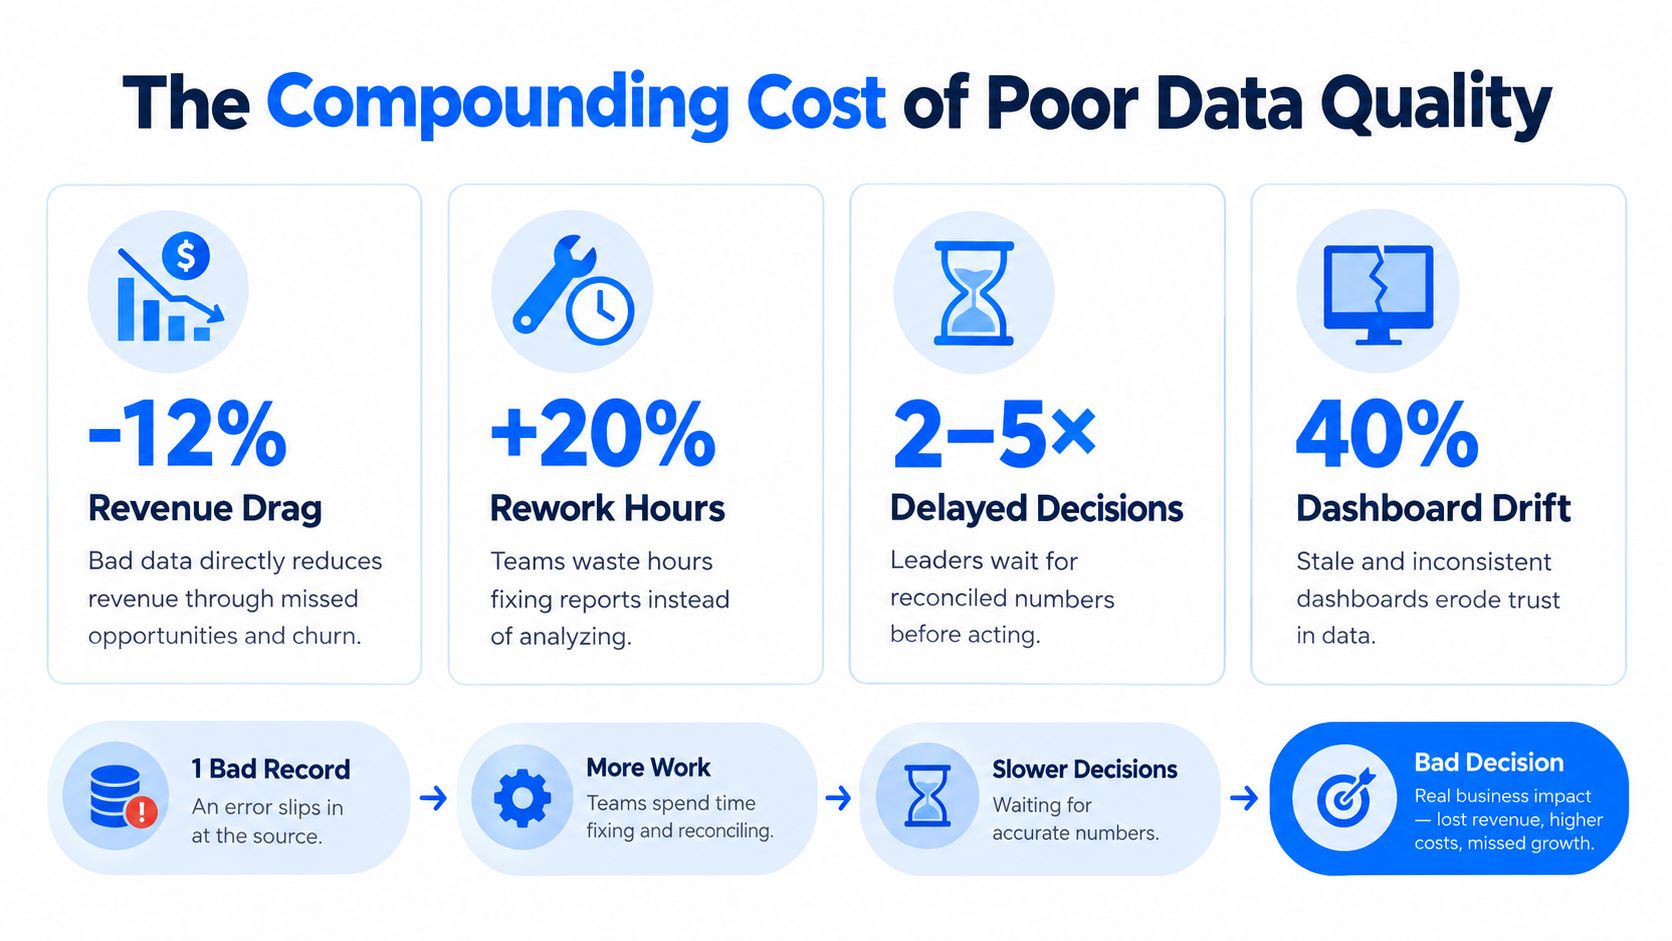
Ein fehlerhafter Datensatz kann eine Organisation schneller durchlaufen, als seine Eigentümerin es bemerkt. Er gelangt in eine Pipeline, verändert eine Aggregation, erscheint in einem Dashboard, beeinflusst eine Entscheidung und wird später womöglich zu Trainingsdaten. Jede Übergabe schafft eine weitere Stelle, an der der ursprüngliche Defekt verdeckt, kopiert oder an jemand anderen zur Behebung weitergereicht werden kann.
Gartners vielzitierte Schätzung beziffert die durchschnittlichen Kosten mangelhafter Datenqualität je Organisation auf 12,9 Millionen USD pro Jahr (ökonomische Auswirkungen mangelhafter Datenqualität). Der Aufwand zeigt sich als manuelle Abstimmung, gescheiterte Prozesse, Ausschuss, Nacharbeit, verzögerte Entscheidungen und entgangener Umsatz. Der geschäftliche Nutzen von Datenqualität wird deutlicher, wenn Qualität als Steuerungsebene für diese Kosten behandelt wird und nicht nur als Aufräumarbeit.
Eine in einem peer-reviewten Artikel zusammengefasste Untersuchung berichtet, dass mangelhafte Datenqualität in einigen proprietären Studien 8 % bis 12 % des Umsatzes aufzehren kann, während andere Schätzungen die Kosten bei vielen Unternehmen auf 15 % bis 25 % des Umsatzes beziffern (peer-reviewte Diskussion der Kosten von Datenqualität). Methoden und Organisationen unterscheiden sich, der Mechanismus bleibt jedoch derselbe. Fehlerhafte Informationen beeinträchtigen Margen und Umsetzung, nicht nur das Erscheinungsbild eines Berichts.
Wo der Schaden sichtbar wird
Teams beobachten die Auswirkungen meist in wiedererkennbarer Form:
Umsatzverluste: Doppelte, fehlende oder falsch klassifizierte Datensätze können Kundenaktivität verzerren und Chancen verbergen.
Operative Nacharbeit: Analystinnen und Engineers gleichen widersprüchliche Ergebnisse ab, statt die zugrunde liegenden Systeme zu verbessern.
Entscheidungsverzögerung: Führungskräfte warten auf geprüfte Zahlen, bevor sie Maßnahmen freigeben.
Dashboard-Drift: Veraltete oder inkonsistente Quellen lassen Berichte voneinander abweichen und schwächen das Vertrauen.
Modellverzerrung: Trainings- und Scoring-Workflows verwenden Eingangsdaten, die die aktuellen Betriebsbedingungen nicht mehr abbilden.
Die Zeit bis zur Erkennung verändert die Ökonomie. Ein bei der Ingestion gefundener Defekt erfordert womöglich eine einzige Korrektur. Derselbe Defekt, gefunden nach Reporting, Auftragsabwicklung oder Modell-Scoring, kann Untersuchungen über mehrere Systeme und Teams hinweg nach sich ziehen.
Der Fachbegriff für diese Unterbrechung lautet häufig Data Downtime. Ein ETSI-Rahmenwerk zur Messung von Datenqualität beschreibt ein handlungsfähiges Modell auf Basis der Vorfallzahl multipliziert mit Erkennungs- und Behebungszeit. Schnellere Erkennung und Behebung senken Aufwand und Störung, selbst wenn perfekte Daten nicht unmittelbar erreichbar sind. Präventionsregeln sind aus demselben Grund wertvoll: Sie stoppen wiederkehrende Defekte, bevor jede nachgelagerte Übergabe weitere Nacharbeit erzeugt.
Eine Befragung von 20.000 Organisationen mit zehn oder mehr Beschäftigten ergab, dass mangelhafte Qualität allein in relationalen Daten in den Niederlanden jährliche Zusatzkosten von rund 400 Millionen Euro verursachte (empirische Forschung zu den geschäftlichen Auswirkungen von Datenqualität). Wiederholte lokale Fehler können damit zu Kosten in Unternehmensgröße werden.
Die praktische Frage lautet, wie schnell ein Team eine Veränderung erkennen, ihre Auswirkungen eingrenzen und jemanden mit der Korrektur beauftragen kann, bevor der Defekt eine Entscheidung erreicht.
Warum Datenqualität für KI und Governance noch wichtiger ist
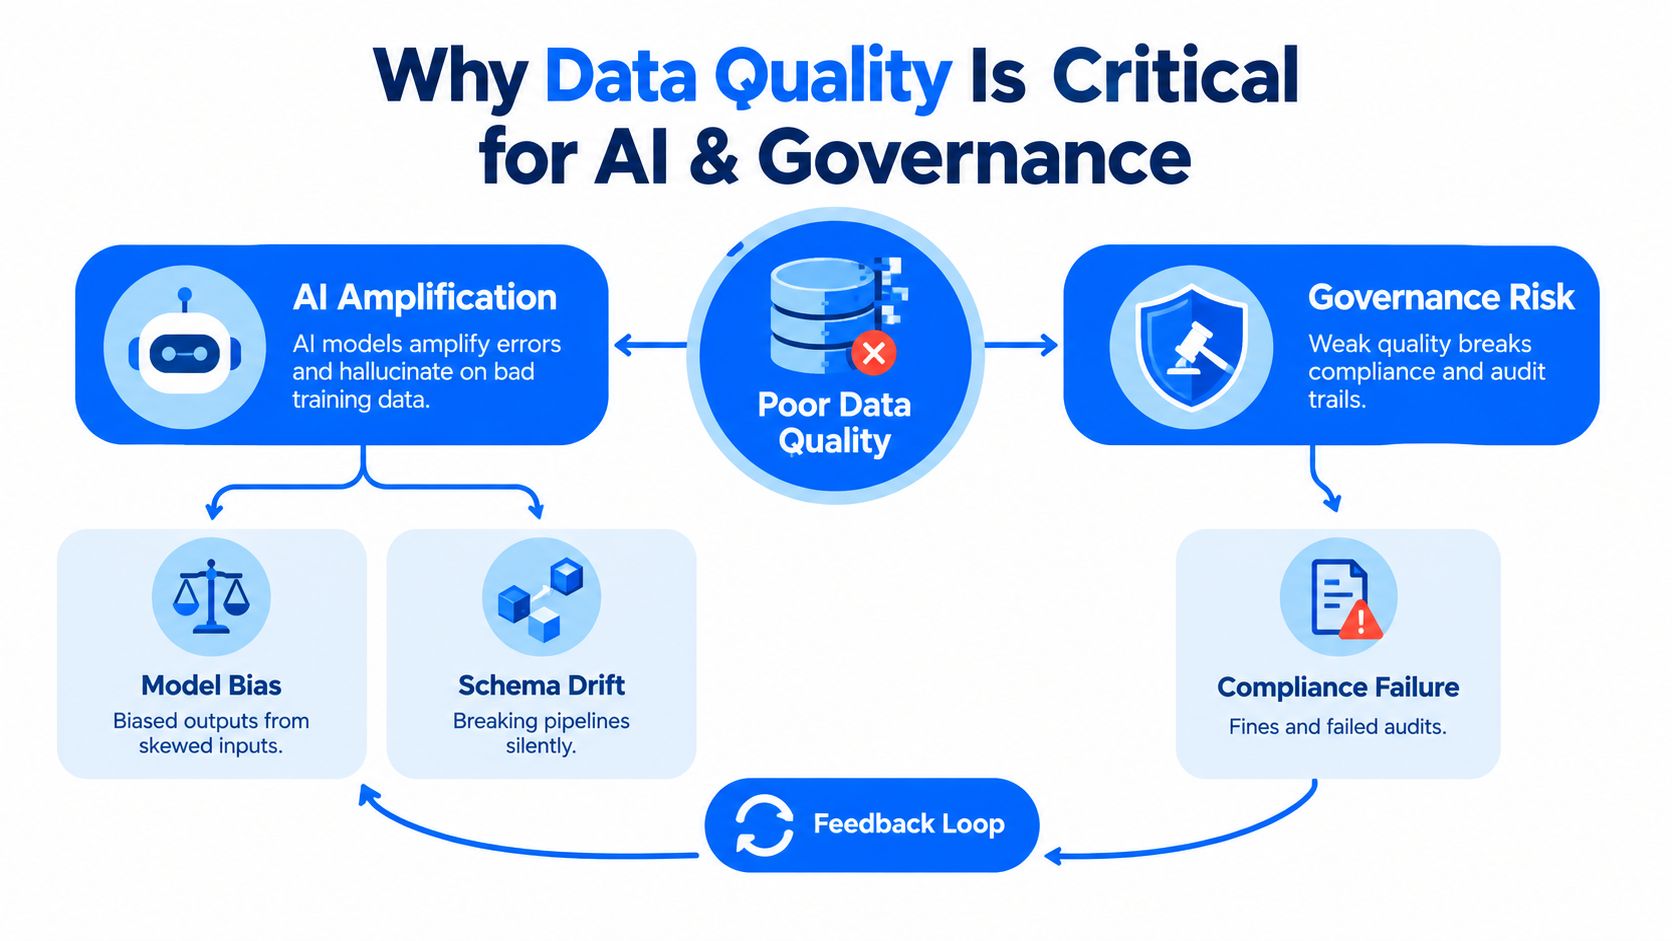
KI kann einen kleinen Datendefekt in eine selbstbewusste geschäftliche Handlung verwandeln. Klassisches Reporting legt einen offensichtlichen Fehler womöglich offen, wenn eine Summe nicht aufgeht oder ein Dashboard veraltet ist. Ein KI-System kann dieselbe fehlerhafte Eingabe stattdessen in eine Klassifizierung, eine Empfehlung, generierten Text oder eine automatisierte Entscheidung überführen, die plausibel wirkt.
KI-Reife hängt von mehr ab als von korrekten Werten. Teams müssen wissen, ob Daten über ihren gesamten Lebenszyklus hinweg aktuell, ausgewogen, repräsentativ, zugänglich, prüfbar und nachverfolgbar sind. Ein Modell kann auf einem engen Testset gut abschneiden und dann versagen, wenn sich Produktionsdaten ändern oder unterrepräsentierte Fälle in den Workflow gelangen. Die Qualität der Daten hinter einem KI-Modell bestimmt, wie viel Vertrauen seine Ausgabe verdient.
KI verstärkt Defekte über Workflows hinweg
Ein fehlendes Feld betrifft womöglich einen einzigen Bericht. In einem Machine-Learning-Workflow kann dieselbe Auslassung Feature-Erzeugung, Training, Evaluation und produktives Scoring beeinflussen. Eine Schemaänderung kann eine Pipeline stoppen oder durchlaufen und dabei die Bedeutung eines Features verändern.
Governance ergänzt eine Anforderung an Nachweise. Teams müssen zeigen, welche Daten ein System verwendet hat, welche Regeln galten, wann die Daten eintrafen und wie ein Vorfall behandelt wurde. Ohne diesen Nachweis wird die Erklärung einer automatisierten Entscheidung schwierig, selbst wenn das Ergebnis plausibel aussieht.
ISO/IEC 5259-5:2025 definiert ein Governance-Rahmenwerk für Datenqualität in Analytics und Machine Learning über den gesamten Datenlebenszyklus. Zu seinen Dimensionen zählen Zugänglichkeit, Prüfbarkeit, Aktualität, Genauigkeit, Rechtzeitigkeit, Ausgewogenheit, Diversität und Repräsentativität (Rahmenwerk ISO/IEC 5259-5:2025).
Reife bedeutet nachweisbare Eignung
Eine mit der Norm zitierte Marktuntersuchung ergab, dass nur 12 % der Organisationen ihre Daten für eine wirksame KI-Umsetzung als ausreichend qualitativ und zugänglich einstuften, während 64 % Datenqualität als ihre größte Herausforderung im Bereich Datenintegrität nannten. Die Zahlen zeigen eine Reifelücke, nicht die Forderung nach überall fehlerfreien Daten.
Das praktische Ziel ist kontrollierte Nutzung. Legen Sie fest, welche Dimensionen für jedes Modell zählen, überwachen Sie sie fortlaufend, bewahren Sie Nachweise auf und stoppen oder isolieren Sie Daten außerhalb vereinbarter Grenzen. Governance wirkt am besten, wenn sie mit den Pipelines verbunden ist, die Daten erzeugen und konsumieren, damit Teams Probleme früh erkennen und wiederkehrende nachgelagerte Kosten verhindern, statt Qualität als Papierarbeit nach dem Deployment zu behandeln.
Reale Risikobeispiele bei fehlender Datenqualität
Ein Datenqualitätsfehler kann unsichtbar bleiben, während Systeme normal weiterlaufen. Die geschäftliche Auswirkung hängt weniger davon ab, ob ein Fehler existiert, als davon, wie lange er nachgelagerten Nutzenden zur Verfügung steht.
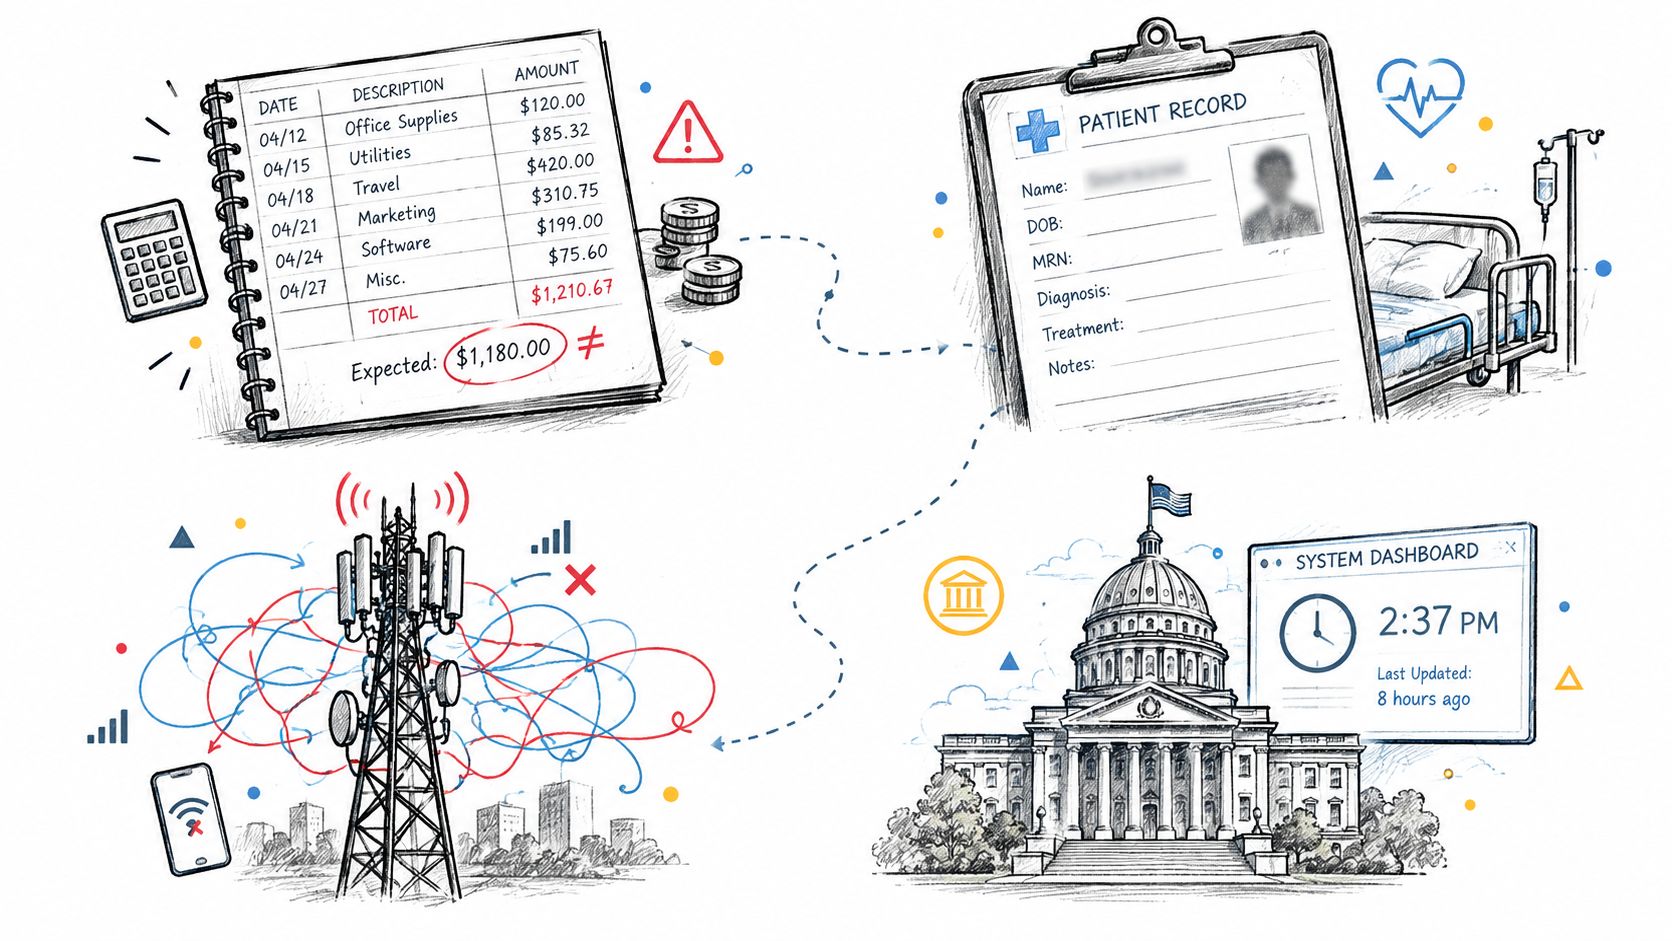
Im Finanzwesen kann ein verspäteter Transaktionsladevorgang ein Risiko-Dashboard ruhiger erscheinen lassen als das zugrunde liegende Portfolio. Im Gesundheitswesen können fehlende oder inkonsistente Patientenattribute klinisches Reporting und aufsichtsrechtliche Meldungen erschweren. In der Telekommunikation kann eine Schemaänderung in Nutzungsdaten die Aggregationslogik verändern und Teams mit unvollständiger Kundenaktivität zurücklassen. Im öffentlichen Sektor können inkonsistente Identifikatoren eine verlässliche Abstimmung zwischen Behörden verhindern.
Diese Fehler erfordern keinen dramatischen Ausfall. Ein Bericht kann erfolgreich aktualisieren und dabei eine Partition auslassen. Eine Pipeline kann einen neuen Datentyp akzeptieren, während nachgelagerte Logik ihn falsch interpretiert. Ein Modell kann weiter scoren, nachdem sich seine Eingabeverteilung verschoben hat, und Ergebnisse liefern, die valide aussehen, dieselbe Entscheidung aber nicht mehr tragen.
Reaktive Reparatur statt früher Kontrolle
Die 1-10-100-Regel zeigt, warum die Erkennungszeit ökonomisch wirkt. Es kostet etwa 1 USD, einen Datenfehler zu verhindern, 10 USD, ihn nach Eintritt ins System zu korrigieren, und 100 USD, ihn zu bewältigen, wenn er unbemerkt bleibt (1-10-100-Kostenmodell für Datenqualität).
Ansatz | Was passiert | Typische Folge |
|---|---|---|
Präventive Kontrolle | Eine Regel oder ein Vertrag blockiert einen ungültigen Wert vor der Veröffentlichung | Das Problem bleibt nahe an seiner Quelle |
Frühe Erkennung | Monitoring erkennt einen ungewöhnlichen Wert, eine Verzögerung oder eine strukturelle Änderung | Ein kleineres Team kann vor der nachgelagerten Nutzung untersuchen |
Reaktive Behebung | Nutzende entdecken das Problem in einem Bericht, Modell oder Geschäftsprozess | Abstimmung, Nacharbeit und Vertrauensaufbau dauern länger |
Perfekte Daten sind nicht die betriebliche Anforderung. Das praktische Ziel ist, Defekte zu erkennen, solange sie lokal sind, bevor Berichte, Modelle und Geschäftsprozesse von ihnen abhängen.
Von TechTarget zusammengefasste Branchenbelege zeigen, dass die durchschnittliche Zahl monatlicher Vorfälle zwischen 2022 und 2023 von 59 auf 67 stieg, während der durchschnittlich betroffene Umsatzanteil von 26 % auf 31 % zunahm (Belege zu Vorfällen und Umsatzwirkung). In diesem Zusammenhang verweisen die Zahlen auf eine Präventionsfrage: Wie schnell kann ein Team einen Defekt erkennen, betroffene Konsumenten identifizieren und die weitere Nutzung stoppen? Schnellere Erkennung begrenzt die Zahl der zu korrigierenden Systeme und hält die Behebung näher an der Quelle.
Datenqualität mit Validierung, Timeliness und Monitoring steuern
Ein praktikables Qualitätsprogramm kombiniert Kontrollen an verschiedenen Punkten des Datenlebenszyklus. Validierung verhindert bekannte Regelverstöße. Anomalieerkennung findet Verhalten, das Regeln nicht beschreiben. Timeliness-Monitoring erkennt Lieferausfälle, während Schema-Tracking strukturelle Änderungen erfasst, die Konsumenten brechen können.
Mit expliziten Erwartungen beginnen
Validierung auf Satzebene ist das richtige Werkzeug für deterministische Bedingungen. Prüfen Sie Pflichtfelder, zulässige Werte, Eindeutigkeit, referenzielle Integrität, Datumsbeziehungen und Geschäftsregeln. Ein Zahlungsdatensatz benötigt womöglich eine gültige Kontoreferenz. Eine Bestellung erfordert vielleicht eine nichtnegative Menge und ein Lieferdatum, das auf das Bestelldatum folgt.
Anomalieerkennung beantwortet eine andere Frage: Weicht das heutige Verhalten vom etablierten Muster ab? Ein statischer Schwellenwert übersieht womöglich eine allmähliche Verschiebung oder meldet eine normale saisonale Änderung. Baseline-Learning hilft, ungewöhnliche Volumina, Verteilungen oder Kennzahlenbewegungen zu erkennen, ohne dass Engineers jede denkbare Regel schreiben müssen.
Lieferung und Struktur überwachen
Timeliness-Monitoring sollte abbilden, wie Konsumenten die Daten nutzen. Verfolgen Sie erwartete Ankunft, fehlende Ladevorgänge, verspätete Partitionen und unerwartet frühe Lieferungen. Ein Datensatz, der nach einer morgendlichen Entscheidung eintrifft, mag technisch vollständig, betrieblich aber nutzlos sein.
Schema-Tracking achtet auf hinzugefügte oder entfernte Spalten, umbenannte Felder und Änderungen von Datentypen. Es gibt Produzenten und Konsumenten die Gelegenheit, sich abzustimmen, bevor eine strukturelle Änderung ein Dashboard oder ein Modell verändert.
Praktische Regel: Erkennen Sie den Fehler möglichst nah an der Stelle, an der er ins System gelangt, und leiten Sie den Alert an die Person weiter, die ihn korrigieren kann.
Ein gemeinsames Dashboard hilft Data Engineers, Analystinnen und Fachverantwortlichen, denselben Vorfall, dieselbe Historie und denselben Status zu sehen. In-Database-Ausführung kann die Kennzahlenberechnung in der Umgebung der Kundin halten, unnötige Datenbewegung reduzieren und Monitoring an Sicherheitsanforderungen ausrichten. Teams können diese Praktiken mit dem Ansatz aus Datenvalidierungsregeln und kontinuierlicher Qualität kombinieren.
Phase | Relative Kosten | Geschäftliche Auswirkung |
|---|---|---|
Verhindern | Etwa 1 USD | Stoppt einen Fehler, bevor er sich ausbreitet |
Früh erkennen und korrigieren | Etwa 10 USD | Begrenzt betroffene Systeme und senkt den Untersuchungsaufwand |
Nach dem Fehler beheben | Etwa 100 USD | Verlängert Nacharbeit, verzögert Entscheidungen und beschädigt Vertrauen |
Die Reihenfolge zählt. Prävention schützt den Prozess, Erkennung schützt die Entscheidung, und Behebung stellt das System wieder her, nachdem sich der Schaden bereits ausgebreitet hat.
Fazit: Vertrauen in Daten für Analytics und KI aufbauen
Ein verlässliches Qualitätsprogramm beginnt mit einer Auswahl, nicht mit einer Checkliste. Wählen Sie die drei Datensätze, deren Ausfall Umsatz, Compliance, Betrieb oder ein KI-System am schwersten treffen würde. Diese Datensätze werden zum ersten Prüffeld für Kontrollen, die konkret genug sind, um Entscheidungen zu tragen.
Notieren Sie für jeden davon die Entscheidung, die er stützt, die akzeptable Ankunftszeit und die Bedingungen, die einen Datensatz nutzbar machen. Benennen Sie eine verantwortliche Person, die handeln kann, wenn diese Bedingungen verletzt werden. Validierung prüft dann, ob die Daten für ihren Zweck geeignet sind, während Timeliness-Kontrollen bestätigen, dass sie verfügbar sind, wenn die Entscheidung sie verlangt.
Verwenden Sie für jeden Datensatz dieselben wenigen Fragen:
Eignung: Welche Felder, Werte und Beziehungen müssen genau, vollständig, gültig, konsistent und eindeutig sein?
Timeliness: Wie spät dürfen die Daten eintreffen, bevor die gestützte Entscheidung beeinträchtigt wird?
Verantwortung: Wer untersucht den Alert, korrigiert die Quelle und bestätigt die Wiederherstellung?
Nachweis: Welcher Eintrag belegt Fehler, Reaktion und Ergebnis?
Dieser Ansatz vermeidet eine verbreitete Falle: gleichen Aufwand für jede Tabelle zu betreiben. Ein explorativer Datensatz mit geringer Wirkung kann warten, während eine Finanzkennzahl, ein aufsichtsrechtlicher Feed oder ein Produktionsmodell zuerst Aufmerksamkeit erhält. Das Ziel sind nicht überall perfekte Daten. Es sind verlässliche Daten dort, wo Fehler Folgen haben, mit Kontrollen, die geprüft und verbessert werden können.
digna unterstützt dieses Betriebsmodell als In-Environment-Plattform für Datenqualität und Observability. Ihre Module bieten Anomalieerkennung, Validierung auf Satzebene, Timeliness-Monitoring, Verfolgung von Schemaänderungen, historische Analyse und geteilte Sichtbarkeit über Warehouses, Lakes und Pipelines hinweg, ohne Produktionsdaten aus der Umgebung der Kundin zu bewegen.
Besuchen Sie digna und sehen Sie, wie die modulare Plattform Ihr Team dabei unterstützt, kritische Datensätze zu validieren, Lieferzeiten zu verfolgen, Anomalien zu erkennen und Schemaänderungen innerhalb Ihrer eigenen Infrastruktur zu identifizieren. Beginnen Sie damit, die wichtigsten drei Datensätze zu dokumentieren, und weiten Sie das Monitoring aus, sobald das Team erkennt, welche Kontrollen die folgenreichsten Fehler verhindern.
Timeliness ist die Dimension, die Teams am häufigsten undefiniert lassen, und sie entscheidet darüber, ob ein korrekter Datensatz im Moment der Entscheidung noch nützlich ist – die Kennzahlen und Monitoring-Muster dahinter finden Sie in dignas Leitfaden zu Data Timeliness.
Häufig gestellte Fragen
Warum ist Datenqualität für den Geschäfts-ROI wichtig?
Weil Defekte wandern. Ein doppelter Kundendatensatz kann die Nachfrage aufblähen, und ein verspäteter Transaktionsladevorgang kann die Liquiditätsberichterstattung verzerren. Gartner beziffert die durchschnittlichen Kosten mangelhafter Datenqualität auf 12,9 Millionen USD pro Jahr, und von MIT Sloan zitierte Untersuchungen sehen den Umsatzverlust bei vielen Unternehmen bei 15 % bis 25 %.
Wie teuer ist die Behebung eines Datenqualitätsproblems, nachdem es sich ausgebreitet hat?
Die 1-10-100-Regel ist der gängige Maßstab: rund 1 USD, um einen Fehler zu verhindern, 10 USD, um ihn nach Eintritt ins System zu korrigieren, und 100 USD, um ihn zu bewältigen, wenn er unbemerkt bleibt. Den größten Teil dieser Kosten treibt die Zeit bis zur Erkennung, nicht die Größe des Defekts.
Welche Dimensionen hat Datenqualität?
Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Validität und Eindeutigkeit. Sie sind nicht austauschbar: Ein Datensatz kann genau, aber verspätet sein, vollständig, aber inkonsistent, oder aktuell, aber ungültig. Deshalb verdeckt ein einzelner Qualitätswert meist genau das Problem, das behoben werden müsste.
Warum ist Datenqualität für KI wichtiger als für Reporting?
Reporting legt einen Fehler oft offen, wenn eine Summe nicht aufgeht oder ein Dashboard veraltet. Ein KI-System verwandelt dieselbe fehlerhafte Eingabe stattdessen in eine selbstbewusste Klassifizierung oder Empfehlung. Nur 12 % der Organisationen halten ihre Daten für eine wirksame KI-Umsetzung für ausreichend qualitativ und zugänglich.
Wie startet man ein Datenqualitätsprogramm?
Wählen Sie die drei Datensätze, deren Ausfall Umsatz, Compliance oder ein Produktionsmodell am stärksten treffen würde. Notieren Sie für jeden die Entscheidung, die er stützt, wie spät er eintreffen darf und welche Bedingungen einen Datensatz nutzbar machen, und benennen Sie dann eine verantwortliche Person, die handelt, wenn diese Bedingungen verletzt werden.


