Data Quality Reliability: Wie Teams sie tatsächlich messen
|
8
min. Lesezeit

Der Montagmorgen beginnt mit einem vertrauten Erfolg. Das Umsatz-Dashboard lädt, die Summen stimmen mit der Finanzabteilung überein, und vor dem Führungsmeeting steht jedes Diagramm auf Grün. Niemand sieht, dass verspätete mobile Transaktionen noch nachgeladen werden, dass ein Sessionization-Job Partitionen verloren hat und dass ein umbenanntes Feld weit mehr Nullwerte erzeugt als seine Baseline. Das Dashboard wirkt vertrauenswürdig, weil die sichtbare Ausgabe gerendert wurde, nicht weil die Lieferkette verlässlich geblieben ist.
Dieser Unterschied zählt, wenn Analytics, Betrieb und KI-Systeme dieselben Pipelines konsumieren. Data Quality Reliability ist keine Checkliste, die nachträglich auf eine Tabelle angewendet wird. Sie ist eine Betriebseigenschaft der gesamten Kette, einschließlich Aktualität, Vollständigkeit, Schemaverhalten, Validität, Lineage und Governance. Dieser Leitfaden behandelt Verlässlichkeit als Produktionsthema und zeigt, wie sie sich messen lässt, ohne jedes Release zu einem manuellen Testengpass zu machen.
Inhaltsverzeichnis
Der verborgene Fehler hinter vertrauenswürdig wirkenden Dashboards
Warum Qualität und Verlässlichkeit nicht dasselbe sind
Der Investitionsfehler
Die Kennzahlen, die Verlässlichkeit wirklich messen
Regelbasierte Prüfungen, statistische Prüfungen und KI-Anomalieerkennung
Nach Sicherheit stapeln
Observability, In-Database-Prüfungen und Validierung im Zusammenspiel
Operative Leitplanken, die Verlässlichkeitsprogramme vor dem Stillstand bewahren
Alerts an das Datenprodukt leiten
Service Level trennen
Kontrollen im Lieferpfad halten
Was KI-taugliche Datenverlässlichkeit wirklich erfordert
Der vollständigen KI-Eingabekette folgen
Alles zusammengeführt und die nächsten Schritte
Der verborgene Fehler hinter vertrauenswürdig wirkenden Dashboards
Das erste Problem tritt im Event-Stream auf. Ein Mobile-Release verändert, wie Transaktionen ausgesendet werden, sodass einige Datensätze verspätet statt im erwarteten Verarbeitungsfenster eintreffen. Der Ingestion-Job gelingt, weil er Daten erhalten hat, doch die Daten sind zu dem Zeitpunkt, an dem nachgelagerte Konsumenten sie lesen, nicht vollständig.
Anschließend verarbeitet die Sessionization die verfügbaren Partitionen. Drei fehlen, dennoch erzeugt die Transformation eine Tabelle. Die täglichen Zeilenzahlen bleiben in einem breiten historischen Bereich, weil der Desktop-Traffic die mobile Lücke verdeckt. Die Dashboard-Aktualisierung läuft durch, und die Summen können weiterhin mit der Finanzabteilung übereinstimmen, wenn diese später eine Nachladung erhält oder einen anderen Stichtag verwendet.
Der dritte Fehler ist struktureller Natur. Ein vorgelagertes Feld wird umbenannt, und die Transformation erhält die Spalte über einen Kompatibilitätspfad. Die Nullwertquote des Felds steigt, doch kein Alert prüft die Änderung gegen eine bekannte Baseline. Attributions-Features enthalten nun weniger nutzbare Information, während das Churn-Modell weiter trainiert, als hätte das Feature seine frühere Bedeutung behalten.
Ein grünes Dashboard belegt, dass eine Abfrage gelaufen ist und ein Ergebnis zurückgegeben hat. Es belegt nicht, dass die richtigen Daten eingetroffen sind, dass jede Transformation korrekt gearbeitet hat oder dass Konsumenten sie innerhalb des geforderten Fensters erhalten haben.
Deshalb können Teams der sichtbaren Oberfläche vertrauen und dennoch unzuverlässige Entscheidungen treffen. Ein Bericht kann rechnerisch zu einem Referenzsystem passen und für einen anderen Anwendungsfall trotzdem unvollständig, veraltet oder semantisch beschädigt sein. Auch ein Modell kann die Verschlechterung aufnehmen, lange bevor jemand einen sichtbaren Reportingfehler bemerkt.
Die praktische Antwort lautet, die Lieferkette zu überwachen, nicht nur die Endtabelle. Ein Dashboard braucht Nachweise zur Aktualität, Partitionsvollständigkeit, Schemahistorie, Lineage-Kontext und klare Verantwortung für jedes kritische vorgelagerte Asset. Teams, die sich nur auf Dashboard-Symptome konzentrieren, finden mehr Hintergrund bei Data-Quality-Dashboards, doch die tiefere Lösung besteht darin, zu identifizieren, welche Kontrolle versagt hat, bevor das Dashboard irreführend wurde.
Warum Qualität und Verlässlichkeit nicht dasselbe sind
Datenqualität beschreibt, ob Daten erwarteten Bedingungen entsprechen. Ein Wert kann valide, nicht null, korrekt typisiert, innerhalb eines zulässigen Bereichs und mit einem vorhandenen Referenzdatensatz verknüpft sein. Diese Prüfungen betrachten Inhalt und Struktur der Datensätze.
Datenverlässlichkeit fragt, ob Konsumenten sich über die Zeit und über den Lieferprozess hinweg auf die Daten verlassen können. Sie schließt Qualität ein, fragt aber zusätzlich, ob die erwarteten Daten eingetroffen sind, ob die Pipeline sie innerhalb ihres Servicefensters bereitgestellt hat, ob ihre Lineage bekannt ist und ob Änderungen kommuniziert und kontrolliert wurden.
Die Ziegel-Analogie macht den Unterschied greifbar. Qualität fragt, ob jeder Ziegel fest und korrekt geformt ist. Verlässlichkeit fragt, ob die Mauer termingerecht ankommt, jede Schicht enthält, eine bekannte Herkunft hat und unter wechselnden Bedingungen stehen bleibt.
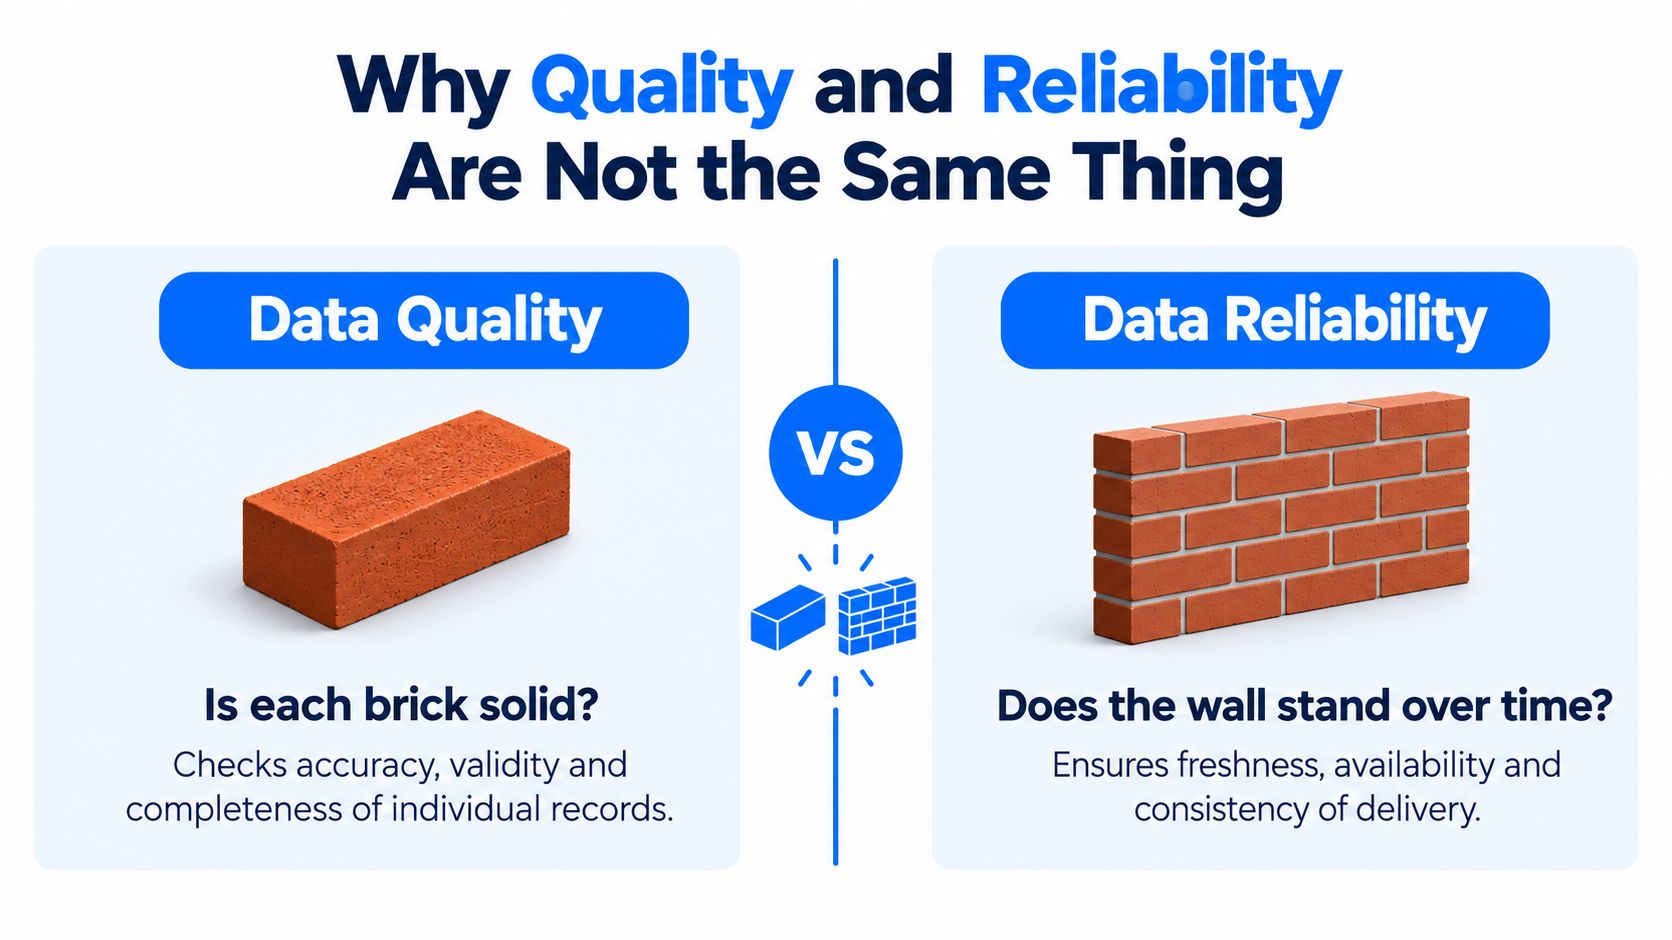
Eine Tabelle kann die Validierung auf Zeilenebene bestehen und als verlässliches Produkt trotzdem scheitern. Jeder eingetroffene Datensatz mag einen gültigen Kundenidentifikator besitzen, während eine ganze Partition fehlt. Ein Schemavalidator kann bestätigen, dass eine Spalte existiert, während die Lineage unterbrochen ist und niemand weiß, welche Quelle sie erzeugt hat. Ein Datensatz kann im Ruhezustand korrekt und für eine operative Entscheidung dennoch zu veraltet sein.
Der Investitionsfehler
Wenn Teams Qualität und Verlässlichkeit als Synonyme behandeln, kaufen oder bauen sie oft die falschen Kontrollen. Sie ergänzen weitere Nullprüfungen, Typzusicherungen und Domänenregeln und lassen Erwartungen an die Aktualität undefiniert. Sie prüfen Werte im Warehouse, überwachen aber keine verspäteten Partitionen, Laufzeiten, vorgelagerten Abhängigkeiten oder nachgelagerten Auswirkungen.
So entsteht ein ungleichmäßiges Kontrollsystem. Deterministische Prüfungen schützen den Ziegel, während niemand prüft, ob die Mauer vollständig ist oder ob sie eintraf, als der Konsument sie brauchte. Das Ergebnis ist eine große Sammlung bestandener Tests an einem unzuverlässigen Produkt.
Verlässlichkeit braucht deshalb durchgängige Servicedefinitionen. Produzent und Konsument sollten sich darauf einigen, was eintreffen muss, bis wann, in welcher Form, unter welchen fachlichen Einschränkungen und mit welchem Lineage-Nachweis. Qualität auf Zeilenebene bleibt wesentlich, wird aber zu einem Teil eines Liefervertrags statt zur gesamten Definition von Vertrauen.
Die Kennzahlen, die Verlässlichkeit wirklich messen
Verlässlichkeit im Produktivbetrieb wird beherrschbar, wenn Teams Erwartungen in beobachtbare Signale übersetzen. Fünf Kennzahlen decken die wesentlichen Fehlermodi ab: Aktualität, Vollständigkeit, Schemastabilität, Validität und Verteilungsdrift. Sie sollten nicht als universelle Bestanden-oder-nicht-Werte behandelt werden. Jeder Schwellenwert gehört in einen Vertrag, der die Toleranz des Konsumenten und die Rolle des Assets abbildet.
Aktualität misst den Abstand zwischen der erwarteten Verfügbarkeit eines Ereignisses und seinem tatsächlichen Eintreffen. Eine sinnvolle Umsetzung vergleicht High-Watermark-Zeitstempel mit einem Service-Level-Fenster und alarmiert, wenn eine Partition verspätet ist oder fehlt. Technische Leitfäden zum Freshness-Monitoring beschreiben diesen SLA-basierten Ansatz, statt einen Zeitstempel als ausreichenden Gesundheitsnachweis zu behandeln.
Vollständigkeit vergleicht, was hätte eintreffen sollen, mit dem, was eingetroffen ist. Die Prüfung sollte auf Partitions- oder Liefereinheitsebene arbeiten, denn ein vollständiger Satz Zeilen innerhalb eines unvollständigen Tages kann dennoch ein irreführendes Ergebnis erzeugen. Ein Alert kann auslösen, wenn eine erwartete Partition fehlt oder die gelieferte Anzahl außerhalb des vereinbarten Bands liegt.
Schemastabilität verfolgt Hinzufügungen, Entfernungen, Umbenennungen und Typänderungen gegen eine Baseline oder einen expliziten Vertrag. Solche Änderungen können Transformationen brechen, Bedeutung verändern oder Nullwertquoten erhöhen, ohne einen sofortigen Pipeline-Fehler auszulösen. Azure Databricks stellt Driftfelder wie count_delta, avg_delta, percent_null_delta, percent_zeros_delta, percent_distinct_delta und non_null_columns_delta bereit und zeigt damit, wie Teams strukturelle und verteilungsbezogene Änderungen in einer Vergleichstabelle quantifizieren können. Die Azure-Databricks-Dokumentation zu Driftkennzahlen erläutert dieses Ausgabemodell.
Validität prüft Werte gegen Einschränkungen und Domänenregeln. Sie umfasst Nullbarkeit, Wertebereiche, zulässige Kategorien, Formate, Eindeutigkeitserwartungen und referenzielle Integrität. Eine praktikable Alert-Bedingung kann jede Verletzung einer Schlüsselbedingung sein, während weichere Regeln alarmieren, sobald die Fehlerquote die mit dem Konsumenten vereinbarte Toleranz übersteigt.
Verteilungsdrift misst Bewegungen im Verhalten numerischer und kategorialer Werte sowie von Nullwerten. Sie erfasst Änderungen, die statische Regeln passieren, etwa eine legitime Kategorie, die ungewöhnlich dominant wird, oder ein normalerweise gefülltes Feld, das ausdünnt. Schema-Drift-Vorfälle oberhalb von 5 % der Felder wurden mit einem Anstieg von 30 % bei durch Endnutzer gemeldeten Datenqualitätsproblemen in Verbindung gebracht, laut Integrate.ios Analyse von Schema-Drift-Vorfällen. Nutzen Sie das als Risikosignal, nicht als universellen Produktionsschwellenwert.
Kennzahl | Was sie misst | Typischer Schwellenwert | Erfasster Fehlermodus |
|---|---|---|---|
Aktualität | Erwartete gegenüber tatsächlicher Ankunftslatenz | Ein definiertes SLA-Fenster, oft mit Warnung vor der harten Verletzung | Verspätete Ladevorgänge, veraltete Dashboards, verzögerte Features |
Vollständigkeit | Erwartete gegenüber gelieferten Datensätzen oder Partitionen | Erforderliche Partitionen vorhanden und Liefermenge innerhalb eines vereinbarten Bands | Fehlende Teilmengen, unvollständige Ladevorgänge, verlorene Events |
Schemastabilität | Strukturelle Abweichung von Baseline oder Vertrag | Keine nicht genehmigte Breaking Change, mit Review für additive Änderungen | Umbenennungen, Entfernungen, Typänderungen, Bruch nachgelagerter Systeme |
Validität | Einhaltung von Einschränkungen und Geschäftsregeln | Kritische Regeln müssen bestehen, mit tolerierten Quoten für unkritische Regeln | Ungültige Schlüssel, unmögliche Werte, falsche Referenzen |
Verteilungsdrift | Statistische Bewegung über die Zeit | Alert, wenn die Bewegung eine kalibrierte Baseline übersteigt | Populationsverschiebungen, Nullwertspitzen, Kategorieänderungen |
Diese Kennzahlen bilden einen Vertrag zwischen Produzenten und Konsumenten. Die nützliche Frage lautet nicht, ob ein Datensatz „gute Qualität“ hat. Sie lautet, ob die Lieferkette die Bedingungen erfüllt hat, die eine bestimmte Entscheidung, ein Modell oder ein Bericht verlangt. Teams können einen praktischen Rahmen zur Messung von Verlässlichkeit nutzen, um diese Bedingungen mit dem Monitoring auf Asset-Ebene zu verbinden.
Regelbasierte Prüfungen, statistische Prüfungen und KI-Anomalieerkennung
Keine einzelne Erkennungsmethode sieht jeden Fehler. Regelbasierte Prüfungen sind am stärksten, wenn das erwartete Verhalten explizit ist. Ein nicht-null Schlüssel, ein zulässiger Statuswert, eine gültige Referenz oder ein gefordertes Muster lässt sich klar ausdrücken und an Ingestion- oder Transformationsgrenzen günstig auswerten.
Statistische Prüfungen lösen ein anderes Problem. Sie etablieren eine Baseline für Verhalten, das sich nicht auf eine deterministische Regel reduzieren lässt, etwa Zeilenvolumen, Durchschnittswert, Varianz, Kardinalität, Nullanteile oder Ankunftszeitpunkt. Eine Regel kann festlegen, dass eine Spalte nicht null sein darf, während eine statistische Prüfung bemerkt, dass Nullwerte plötzlich häufig geworden sind, obwohl die Spalte technisch gefüllt bleibt.
KI-gelernte Anomalieerkennung fügt eine dritte Schicht hinzu. Modelle können mehrere Signale kombinieren und korreliertes Verhalten erkennen, das kein Regelautor vorhergesehen hat. Eine gleichzeitige Verschiebung von Volumen, Aktualität, Verteilung und nachgelagerter Nutzung kann auf ein Release-Problem hindeuten, selbst wenn kein Einzelsignal eine manuell gesetzte Grenze überschreitet.
Ansatz | Am besten geeignet für | Grenzen | Ebene |
|---|---|---|---|
Regelbasierte Validierung | Vertragliche Zusicherungen und fachliche Einschränkungen | Wartungsaufwand bei Logikänderungen, begrenzte Abdeckung unbekannten Verhaltens | Ingestion- und Transformationsgrenzen |
Statistische Prüfungen | Drift, Saisonalität, Volumen, Latenz und Verteilungsänderungen | Erfordert eine brauchbare Baseline und sorgfältige Kalibrierung falsch positiver Befunde | Monitoring von Datensätzen und Pipelines |
KI-Anomalieerkennung | Korreliertes und emergentes Risiko über mehrere Signale hinweg | Weniger unmittelbar erklärbar und abhängig von repräsentativer Historie | Signalübergreifende Observability und Priorisierung |
Nach Sicherheit stapeln
Beginnen Sie mit Regeln für Bedingungen, die niemals verletzt werden dürfen. Diese Prüfungen sollten laut scheitern, wenn ein gebrochener Schlüssel oder eine ungültige Referenz die Ausgabe unsicher machen würde. Legen Sie statistisches Monitoring um Kennzahlen, die natürlich schwanken, und justieren Sie die Empfindlichkeit anhand der Vorfallhistorie statt anhand einer willkürlichen Grenze.
KI-Erkennung verdient ihren Platz, wenn die Umgebung genug Verhaltenskontext zum Lernen bietet. Sie sollte Kandidaten für eine Untersuchung aufzeigen, nicht automatisch jede Pipeline blockieren. Menschliche Prüfung gehört weiterhin dorthin, wo die Anomalie materielle geschäftliche Wirkung hat, die Baseline sich verändert oder das System nicht erklären kann, welcher Konsument betroffen sein wird.
Der passende Ansatz zur Anomalieerkennung für Zeitreihendaten hängt vom Verhalten des Signals und von der Handlung ab, die an einem Alert hängt. Eine verrauschte Warnung ohne Verantwortliche ist keine Observability. Sie ist nur eine weitere Warteschlange, die Engineers ignorieren.
Observability, In-Database-Prüfungen und Validierung im Zusammenspiel
Stellen Sie sich eine Pipeline vor, die Events aus Kafka aufnimmt, sie mit dbt transformiert und kuratierte Tabellen aus Snowflake bereitstellt. Verlässlichkeit steigt, wenn das Team Observability, In-Database-Prüfungen und fachliche Validierung als eine über diese Zeitachse verteilte Kontrollschicht behandelt.
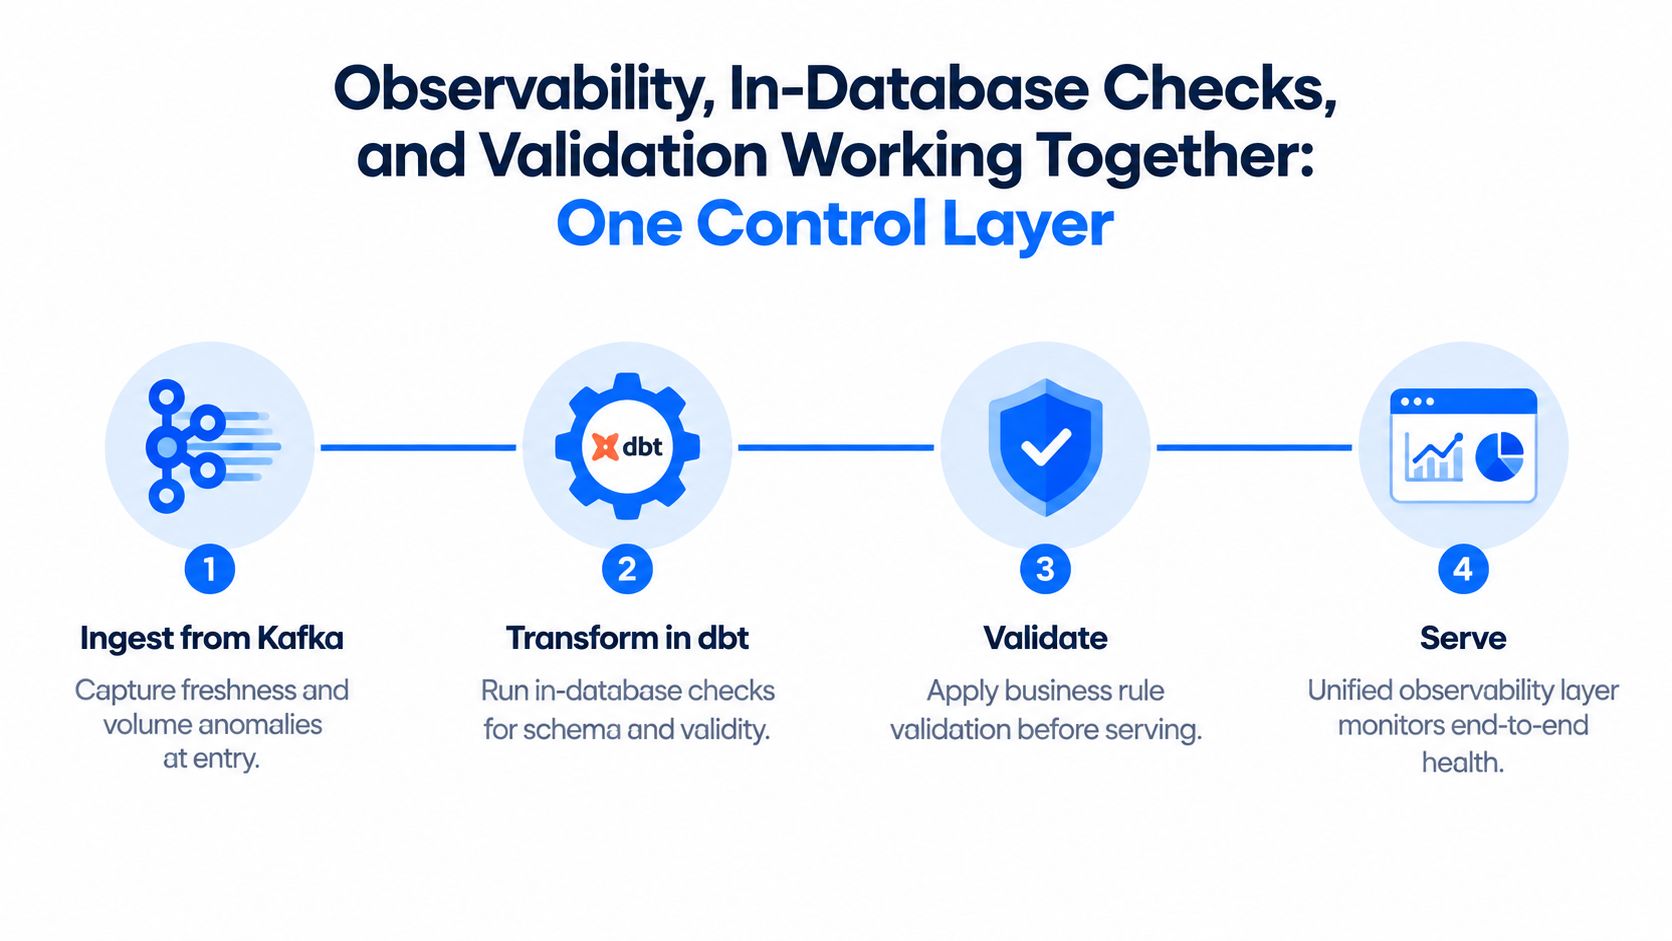
Bei der Ingestion vergleichen leichte Prüfungen Ankunftszeit und Volumen mit dem erwarteten Muster. Warehouse-native Constraints und geplante Abfragen können fehlende Felder, unerwartete Typen oder auffällige Anzahlen nahe am Speicherort der Daten erkennen. Diese Prüfungen erklären nicht jedes nachgelagerte Symptom, können aber verhindern, dass sich ein offensichtliches strukturelles Problem ausbreitet.
Während der Transformation erzwingen dbt-Tests Spaltenverträge und fachliche Annahmen. Parallel beobachtet eine Observability-Schicht Laufzeit, Zeilenzahlen, Partitionsgesundheit, Lineage und Abhängigkeitsverhalten. Wenn ein Modell erfolgreich durchläuft, aber eine unerwartet kleine Relation erzeugt, liefert Pipeline-Telemetrie Kontext, den eine Spaltenzusicherung allein nicht bieten kann.
Nach der Bereitstellung vergleicht das Team die nachgelagerte Nutzung mit den vorgelagerten Erwartungen. Ein Dashboard kann erfolgreich abfragen und dabei eine veraltete Partition erhalten, deshalb muss die Vorfall-Zeitachse die verspätete Kafka-Ankunft, den dbt-Lauf, den Zustand der Snowflake-Tabelle und das betroffene Dashboard verbinden.
In-Database-Prüfungen sehen Verstöße dort, wo die Daten liegen. Validierung sieht, ob die Daten der fachlichen Bedeutung folgen. Observability sieht, wie sich das umgebende System verhalten hat.
Der Integrationspunkt ist ein gemeinsamer Satz von Service-Level-Indikatoren und ein gemeinsamer Vorfall-Datensatz. Jeder Alert sollte Asset, Produzent, Konsument, verletzte Bedingung, Zeitpunkt der ersten Beobachtung und bekannte Lineage benennen. Hinweise zu Datenvalidierungsregeln und kontinuierlicher Datenqualität helfen Teams, die Regelschicht zu definieren, doch der operative Nutzen entsteht, wenn diese Schicht Kontext mit dem Pipeline-Monitoring teilt.
Ohne gemeinsamen Kontext tauschen Teams Screenshots zwischen Werkzeugen aus und diskutieren, ob der Fehler zu Kafka, dbt, Snowflake oder zum Dashboard gehört. Mit einer gemeinsamen Zeitachse können sie Auslöser und Symptom trennen und die Behebung dem Team zuordnen, das den relevanten Vertrag kontrolliert.
Operative Leitplanken, die Verlässlichkeitsprogramme vor dem Stillstand bewahren
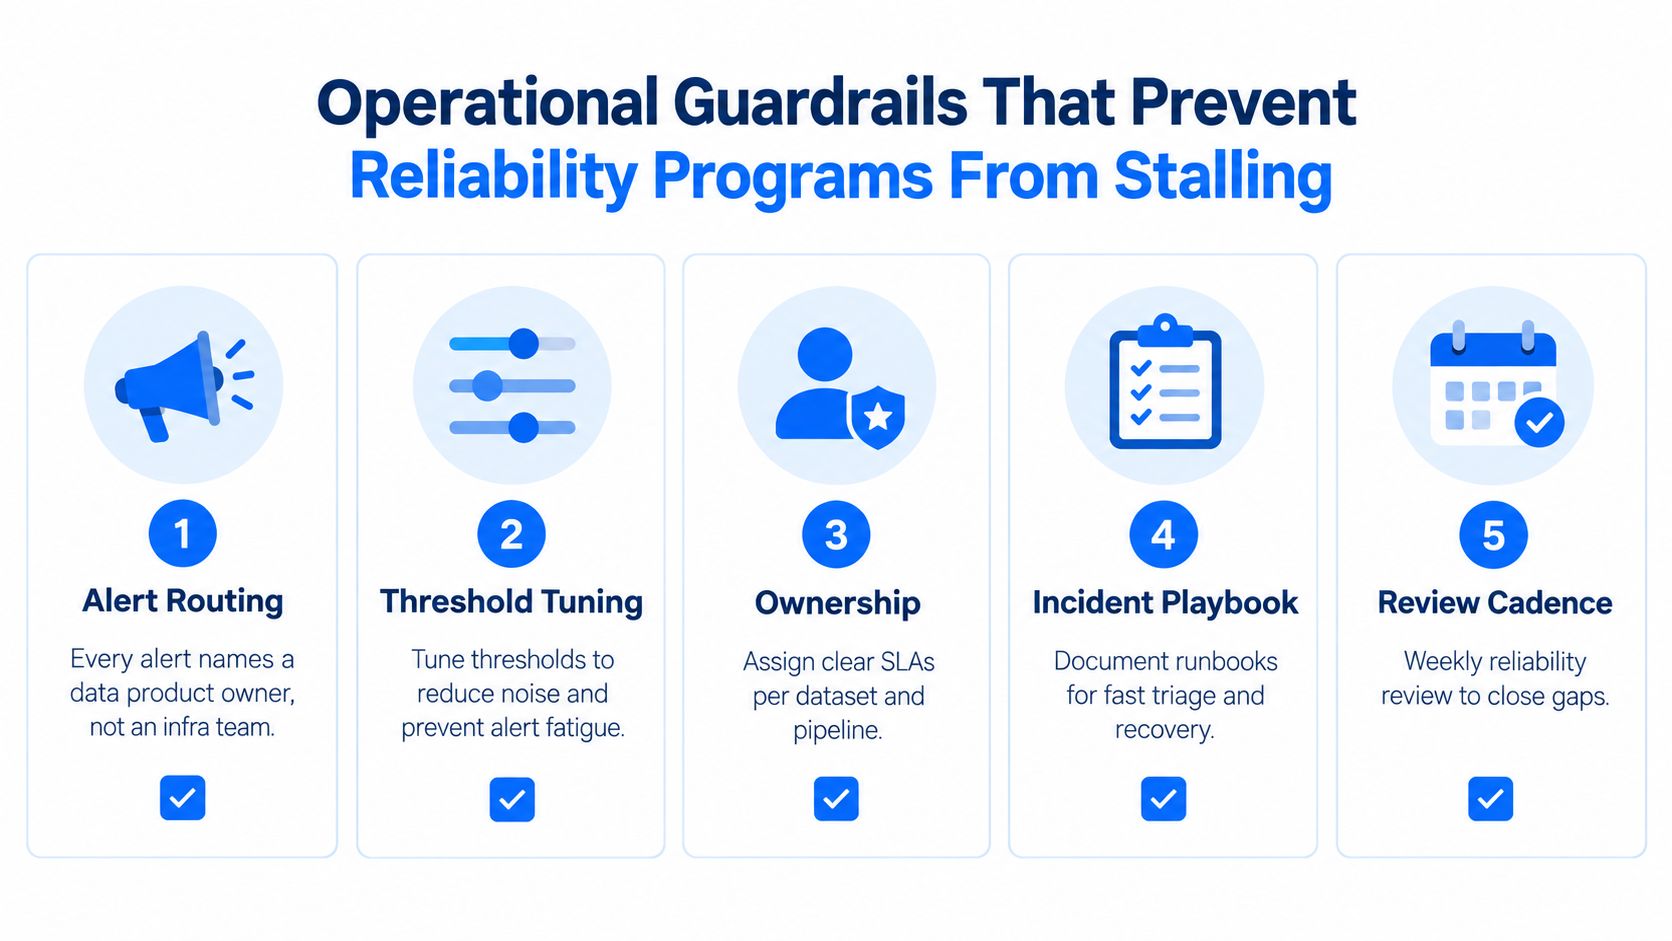
Verlässlichkeitsprogramme geraten meist aus organisatorischen Gründen ins Stocken, bevor sie technisch scheitern. Alerts landen in einer Infrastruktur-Warteschlange, Verantwortliche für Datensätze sind nicht benannt, und jedes Team definiert „gesund“ anders. Leitplanken machen das Betriebsmodell explizit.
Alerts an das Datenprodukt leiten
Ein Alert sollte das betroffene Datenprodukt, seine verantwortliche Person und seinen nachgelagerten Konsumenten benennen. Infrastrukturteams können gemeinsame Ausführungs- und Monitoringfähigkeiten verantworten, während eingebettete Analytics- oder Domänenteams die Datensätze verantworten, deren Bedeutung sie kontrollieren. Geteilte Verantwortung ohne primäre Ansprechperson bedeutet meist, dass niemand schnell handelt.
Service Level trennen
Fassen Sie nicht jede Bedingung in einen Wert oder ein einziges „Data Quality SLA“ zusammen. Definieren Sie getrennte Erwartungen für:
Aktualität: die zulässige Ingestion-Verzögerung, mit einem Warnfenster vor der harten Verletzung.
Korrektheit: der geforderte Anteil an Datensätzen, die kritische Validierungsregeln bestehen.
Verfügbarkeit: der erwartete Abschluss geplanter Pipeline-Läufe.
Auswirkung: die Konsumenten und Geschäftsprozesse, die bei einer Verletzung betroffen sind.
Diese Trennung hilft Teams, die richtige Reaktion zu wählen. Eine verspätete, ansonsten korrekte Tabelle braucht womöglich eine Nachladung, während eine valide wirkende Tabelle mit gebrochener referenzieller Integrität eine Quarantäne braucht.
Kontrollen im Lieferpfad halten
Warehouse-native Prüfungen, dbt-Tests, Gates für Schemaänderungen und Vertragstests verhindern, dass Verlässlichkeit zu einer separaten manuellen QA-Phase wird. Der dokumentierte Monitoring-Workflow von AWS SageMaker trennt Datenerfassung, Baseline-Erstellung und geplante Monitoring-Jobs, und seine Baseline nutzt Deequ, um Schema-Constraints und Statistiken zu berechnen. Die AWS-Dokumentation zum Monitoring der Modell-Datenqualität liefert ein konkretes Beispiel dafür, wie Erwartungen zu geplanten Produktionskontrollen werden.
Achten Sie auf drei Anti-Muster:
Dashboards ohne Verantwortliche: Eine visuelle Statusseite ohne Ansprechperson erzeugt Aufmerksamkeit ohne Handlung.
Schwellenwert-Erosion: Teams weiten Schwellenwerte schrittweise aus, bis keine Alerts mehr auslösen, statt Baseline oder Quelle zu korrigieren.
Verlässlichkeitstheater: Häkchen erfüllen ein Audit, während verspätete Daten, gebrochene Lineage und ungeprüfte Schemaänderungen Konsumenten weiterhin treffen.
Prüfen Sie nach Vorfällen die Qualität der Alerts. Wenn ein Alert nicht zu einer Entscheidung geführt hat, ändern Sie Routing, Kontext, Schwellenwert oder Handlung. Das Ziel ist nicht maximale Monitoring-Abdeckung. Es ist verlässliche Erkennung, die mit der Wiederherstellung verbunden ist.
Was KI-taugliche Datenverlässlichkeit wirklich erfordert
KI-Reife beginnt nicht mit dem Deployment eines Modells. Sie beginnt mit dem Nachweis, dass Eingaben, Features, Retrieval-Kontext und Ausgaben unter Produktionsbedingungen verlässlich bleiben.
Aktuelle Berichte zeichnen die Lücke klar. 71 % der Datenfachleute nennen falsche oder halluzinierte Ausgaben, die Stakeholder erreichen, als eine der größten Sorgen, während PwC feststellte, dass nur 51 % der Befragten eine saubere, strukturierte Datenbasis schaffen, bevor sie digitale Initiativen skalieren, zusammengefasst in diesem Bericht über KI-Beschleunigung und Vertrauen. Diese Zahlen verweisen auf ein operatives Problem, nicht bloß auf ein Problem der Modellbewertung.
Der vollständigen KI-Eingabekette folgen
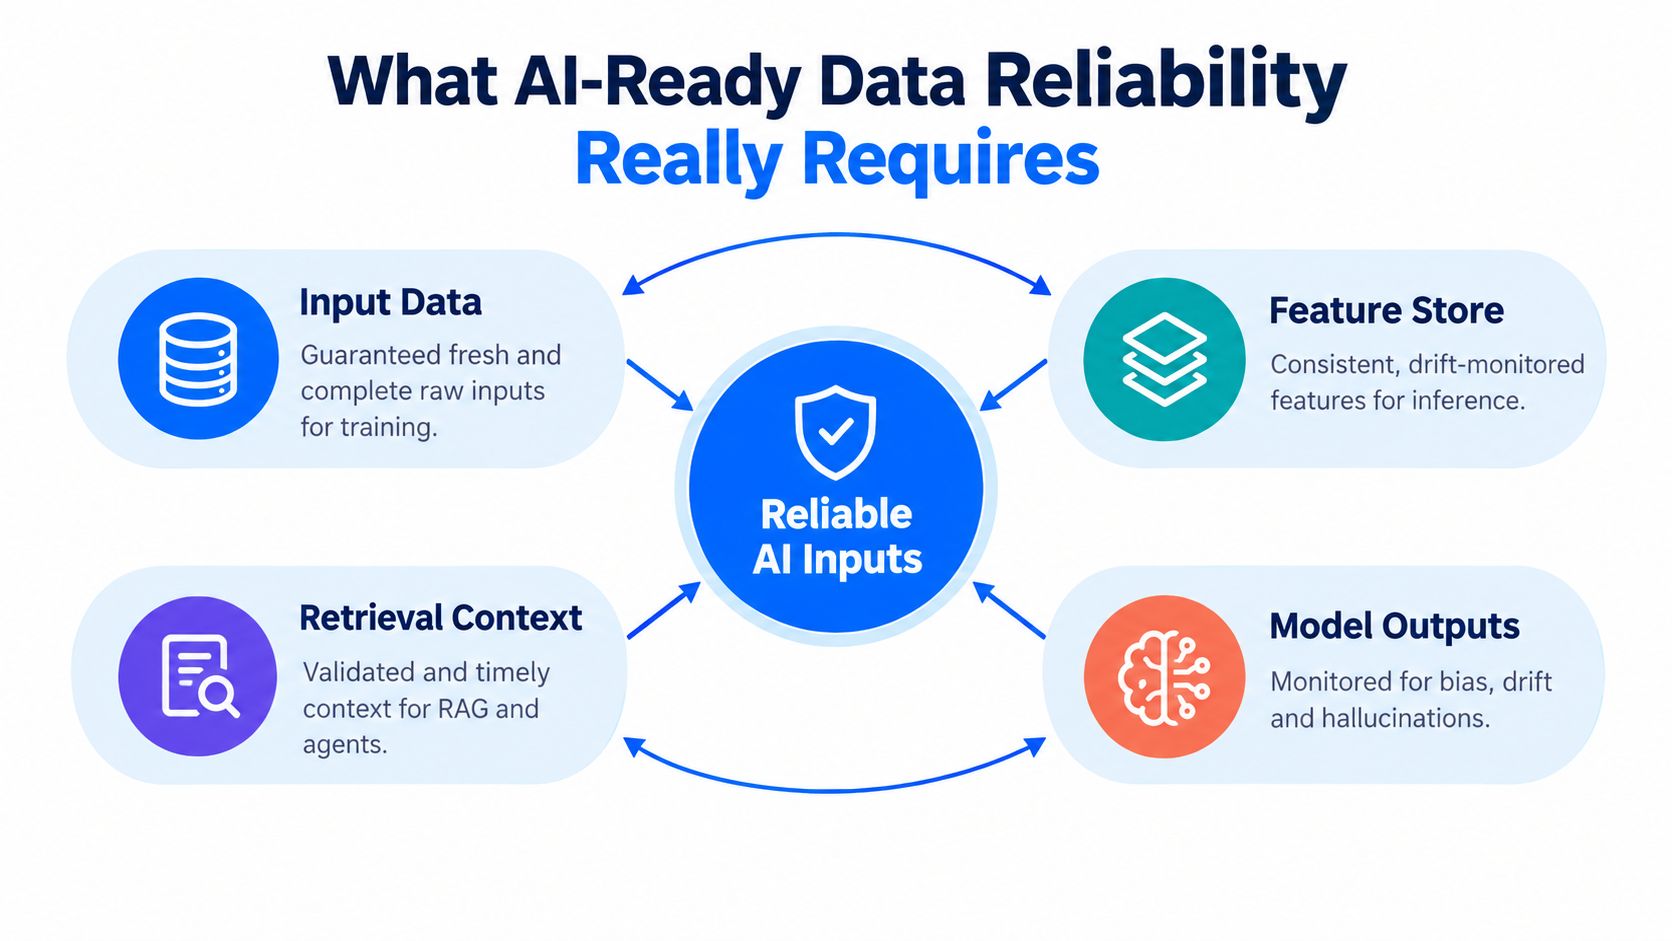
Rohdaten brauchen Zusicherungen zu Aktualität und Vollständigkeit. Feature Stores brauchen konsistente Definitionen und ein Drift-Monitoring, das an den Inferenzfenstern ausgerichtet ist. Retrieval-Augmented-Systeme und Agenten brauchen validierten, rechtzeitigen Kontext, einschließlich des Nachweises, dass Dokumente nicht gelöscht, verändert oder aus einer nicht überwachten Quelle bezogen wurden.
Lineage muss Features und Retrieval-Inhalte auf ihre Quellen und Transformationen zurückführen. Ohne diese Nachvollziehbarkeit kann eine Verschlechterung der Modellqualität zu einer ergebnisoffenen Untersuchung werden. Engineers müssen wissen, ob die Änderung aus Quelldaten, Feature-Logik, Indexierung, Retrieval oder dem Modell selbst stammt.
Modellausgaben brauchen ihre eigene Rückkopplungsschleife. Überwachen Sie Bias-, Drift- und Halluzinationssignale dort, wo sie bewertbar sind, und verbinden Sie Fehler mit vorgelagerten Datenbedingungen. Promotion-Gates sollten ein Release blockieren oder pausieren, wenn kritische Eingabe-SLAs reißen, statt ein Modell nachweislich veraltete Features konsumieren zu lassen.
Das ETSI-Rahmenwerk spiegelt diese breitere Sicht, indem es laut der zitierten Berichterstattung 18 messbare Datenqualitätskennzahlen definiert, darunter Verlässlichkeit, Abdeckung, Lineage, Nachvollziehbarkeit und Rechtzeitigkeit. KI-Reife folgt damit aus dem Verlässlichkeitsprogramm, das Analytics und Betrieb ohnehin schützt. Sie ist keine separate Compliance-Übung und kein abschließendes Genauigkeitshäkchen. Das Prinzip hinter dem Zusammenhang zwischen KI-Modellen und Datenqualität ist operativ: Unzuverlässige Eingaben erzeugen unzuverlässiges nachgelagertes Verhalten, selbst wenn sich das Modell selbst nicht geändert hat.
Alles zusammengeführt und die nächsten Schritte
Ein erster Verlässlichkeits-Sprint sollte eng genug sein, um ihn abzuschließen, und wichtig genug, um zu zählen. Wählen Sie einen umsatzkritischen Datensatz, kartieren Sie seine vor- und nachgelagerten Abhängigkeiten und definieren Sie die Bedingungen, die ihn für seinen primären Konsumenten sicher machen.
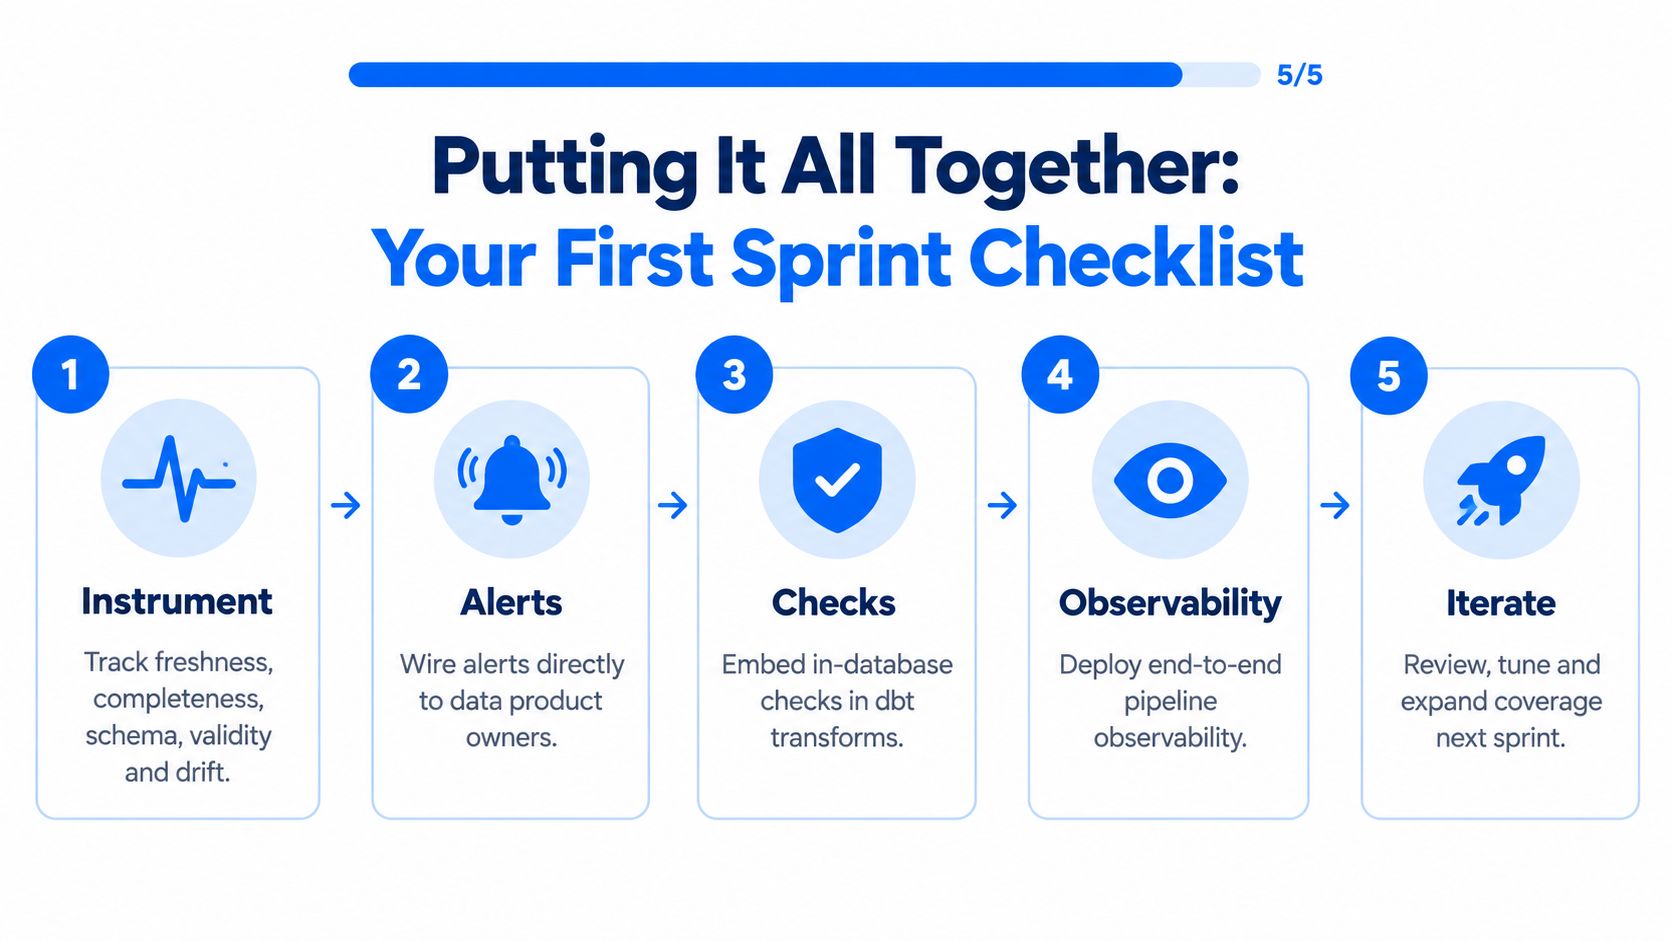
Nutzen Sie diese Reihenfolge:
Die Kette instrumentieren: Verfolgen Sie Aktualität, Vollständigkeit, Schemastabilität, Validität und Verteilungsdrift.
Die Reaktion zuweisen: Leiten Sie jeden Alert an eine benannte verantwortliche Person des Datenprodukts und benennen Sie den betroffenen Konsumenten.
Den Vertrag festschreiben: Dokumentieren Sie Erwartungen an Aktualität, Korrektheit und Verfügbarkeit des Assets.
Prüfungen bewusst platzieren: Nutzen Sie deterministische Regeln für harte Zusicherungen, statistische Prüfungen für Drift und gelernte Erkennung für korrelierte Anomalien.
Den Schutz auf KI-Eingaben ausweiten: Wenden Sie dieselben Kontrollen auf Feature-Daten, Retrieval-Kontext und modellnahe Datensätze an.
Der Markt bewegt sich auf quantifizierte Zusicherung zu statt auf vage Vertrauensrhetorik. Die operative Herausforderung besteht darin, diese Messungen über Teams, Pipelines, Warehouses und Geschäftskennzahlen hinweg nutzbar zu machen. Geteilte Verlässlichkeits-Scorecards und teamübergreifende SLOs sind nützlicher als isolierte Tool-Dashboards, weil sie technische Gesundheit mit den Entscheidungen verbinden, die davon abhängen.
Teams kämpfen weiterhin mit dem Engpass manuellen Testens. Umfragen berichten, dass 61 % auf manuelle Prüfungen oder SQL-basierte Validierung setzen, während nur 27 % eine dedizierte Observability-Plattform nutzen und 14 % SLAs organisationsweit durchsetzen, laut Integrate.ios Trendbericht 2025 zu Datenqualität und Observability. Die praktische Antwort lautet nicht, alles von Hand zu testen. Sie lautet, Nachweise zur Lieferzeit zu automatisieren, jeder Kontrolle eine verantwortliche Person zu geben und eine Verletzung an einem kritischen Asset als Produktionsvorfall zu behandeln.
Wählen Sie diesen Datensatz noch diese Woche. Definieren Sie drei Verlässlichkeitskennzahlen, benennen Sie eine verantwortliche Person und behandeln Sie die erste Verletzung als Vorfall mit Zeitachse und Behebungsplan, nicht als gewöhnliches Datenticket.
digna bietet eine Enterprise-Plattform für Datenqualität und Observability, die innerhalb Ihrer Umgebung läuft und In-Database-Validierung, Timeliness-Monitoring, Schema-Tracking und Anomalieerkennung über Warehouses, Lakes und Pipelines hinweg verbindet. Um diese Kontrollen zu einem praktikablen Verlässlichkeitsprogramm für Analytics und KI zusammenzuführen, besuchen Sie digna und erkunden Sie die Plattform.
Dieselben Kontrollen, geordnet nach dem Fehler, den jede verhindert, statt nach der Kennzahl, die ihn misst, finden Sie in den acht Data-Observability-Use-Cases samt der jeweils zugeordneten Verantwortung und Reaktionswege.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Datenqualität und Datenverlässlichkeit?
Qualität fragt, ob jeder Datensatz den Vorgaben entspricht: valide, nicht null, korrekt typisiert, im zulässigen Bereich. Verlässlichkeit fragt, ob Konsumenten sich über die Zeit auf den Datensatz verlassen können, einschließlich der Frage, ob die erwarteten Partitionen innerhalb des Servicefensters mit bekannter Lineage eintrafen. Der Ziegel kann fest sein, während der Mauer Schichten fehlen.
Welche Kennzahlen messen Datenverlässlichkeit wirklich?
Fünf decken die wesentlichen Fehlermodi ab: Aktualität, Vollständigkeit, Schemastabilität, Validität und Verteilungsdrift. Keine davon sollte ein universeller Bestanden-oder-nicht-Wert sein. Jeder Schwellenwert gehört in einen Vertrag, der die Toleranz des Konsumenten abbildet, und Vollständigkeit gehört insbesondere pro Partition geprüft statt pro Zeile.
Wann sollte man Anomalieerkennung statt regelbasierter Prüfungen einsetzen?
Regeln passen zu Bedingungen, die niemals verletzt werden dürfen, etwa ein nicht-null Schlüssel oder eine gültige Referenz. Statistische Prüfungen behandeln Signale, die natürlich schwanken, darunter Volumen, Kardinalität, Nullanteile und Ankunftszeitpunkt. KI-Erkennung verdient ihren Platz bei korrelierten Verschiebungen über mehrere Signale, die kein Regelautor vorhergesehen hat.
Warum geraten Verlässlichkeitsprogramme ins Stocken?
Meist aus organisatorischen Gründen, bevor technische greifen. Alerts landen ohne benannte Ansprechperson in einer Infrastruktur-Warteschlange, jedes Team definiert „gesund“ anders, und Schwellenwerte weiten sich aus, bis nichts mehr auslöst. Achten Sie auf Dashboards ohne Verantwortliche, Schwellenwert-Erosion und Häkchen, die ein Audit erfüllen, während Konsumenten weiterhin verspätete Daten erhalten.
Was erfordert KI-taugliche Datenverlässlichkeit?
Nachweise entlang der gesamten Eingabekette statt einer abschließenden Genauigkeitsprüfung. Rohdaten brauchen Zusicherungen zu Aktualität und Vollständigkeit, Feature Stores brauchen ein an Inferenzfenstern ausgerichtetes Drift-Monitoring, und Lineage muss Features auf ihre Quellen zurückführen, damit eine Modellverschlechterung nicht zur ergebnisoffenen Untersuchung wird.


