Anomalieerkennung für kategoriale Daten erklärt
|
7
min. Lesezeit

Sie kennen das Fehlerbild bereits. Das Dashboard ist ruhig, die numerischen Prüfungen sind unauffällig, und das Modell, das letzte Woche noch einwandfrei funktionierte, liefert plötzlich Unsinn, weil sich ein kategoriales Feld auf eine Weise verändert hat, die niemand bemerkt hat. Ein neuer Statuscode taucht auf, eine Produktkategorie wird neu zugeordnet oder ein Lieferant sendet plötzlich eine andere Länderbezeichnung, und der Fehler zeigt sich erst, nachdem das nachgelagerte System bereits falsche Entscheidungen getroffen hat.
Deshalb braucht die Anomalieerkennung für kategoriale Daten ein eigenes Vorgehen. In kategorialen Räumen steckt das Signal meist in seltenen Werten, unerwarteten Kombinationen und Verschiebungen gemeinsamer Häufigkeiten, nicht im Abstand zu einem Mittelwert oder in einem großen numerischen Sprung. Die praktische Aufgabe besteht darin, diese Veränderungen früh genug zu erkennen, damit Data Engineers, Analysten und Modellverantwortliche handeln können, bevor das Vertrauen schwindet.
Inhaltsverzeichnis
Die versteckten Risiken von Verschiebungen in kategorialen Daten
Warum Standardalgorithmen bei kategorialen Features versagen
Die versteckten Risiken von Verschiebungen in kategorialen Daten
Die schlimmsten Incidents beginnen selten mit einem lauten Ausfall. Eine Pipeline läuft weiter, die Zeilenzahlen sehen normal aus, und das Einzige, was sich geändert hat, ist ein Label, an dessen Überwachung niemand gedacht hat. Dann beginnt ein Modell, Kunden seltsam zu klassifizieren, weil der erlernte Kategorienmix nicht mehr der Realität in der Produktion entspricht.
Kategoriale Anomalien unterscheiden sich von numerischen Ausreißern. Eine numerische Anomalie kann ein Wert weit entfernt vom Durchschnitt sein, eine kategoriale Anomalie ist dagegen oft eine Ausprägung oder eine Kombination von Ausprägungen über mehrere Felder hinweg, die im Vergleich zur Basispopulation mit ungewöhnlich geringer Häufigkeit auftritt. Deshalb ist die Kategorie selbst weniger wichtig als die Frage, wie oft sie auftritt und wie sie mit anderen Feldern gemeinsam vorkommt. Genau das ist die Kernlogik, die in der Fachliteratur zur kategorialen Anomalieerkennung zu dünnbesetzten Kontingenzmustern und der Seltenheit gemeinsamer Werte beschrieben wird Springer-Kapitel zur kategorialen Anomalieerkennung.
Ein Produktionsfehler beginnt meist mit einer kleinen Label-Änderung
Ein Finanzteam sieht möglicherweise dasselbe Transaktionsvolumen, doch ein Zahlungsstatuscode verändert seine Form, und die nachgelagerten Regeln passen nicht mehr zum zugrunde liegenden Prozess. Ein Team im Gesundheitswesen erhält vielleicht weiterhin plausibel wirkende Abrechnungen, während ein Feld beginnt, einen neuen codierten Wert zu enthalten, den die alte Validierungslogik nie gelernt hat. In beiden Fällen bleiben die Zahlen lange genug stabil, um das Problem zu verbergen.
Deshalb müssen Teams kategoriale Veränderungen als vollwertiges Signal beobachten. Eine Kategorienverteilung kann driften, ohne dass ein einzelnes Feld für sich genommen extrem wirkt, und ein gemeinsames Muster kann anomal sein, selbst wenn jedes einzelne Feld normal aussieht. Das praktische Risiko besteht darin, dass ein einfaches Dashboard eine trügerische Stabilität vermittelt.
Als praktisches Beispiel für das umfassendere Monitoring-Problem passen die Muster der Datendrift aus dignas Überblick zur Erkennung von Datendrift direkt in diese Sicht auf Kategorienverschiebungen. Die betriebliche Lehre ist einfach: Wenn sich der Label-Raum ändert, ändert sich auch die Welt des Modells.
Praxisregel: Wenn ein kategoriales Feld seine geschäftliche Bedeutung ändern kann, ohne dass sich das Zeilenvolumen ändert, gehört es in Ihre Anomalieprüfungen.
Warum Standardalgorithmen bei kategorialen Features versagen
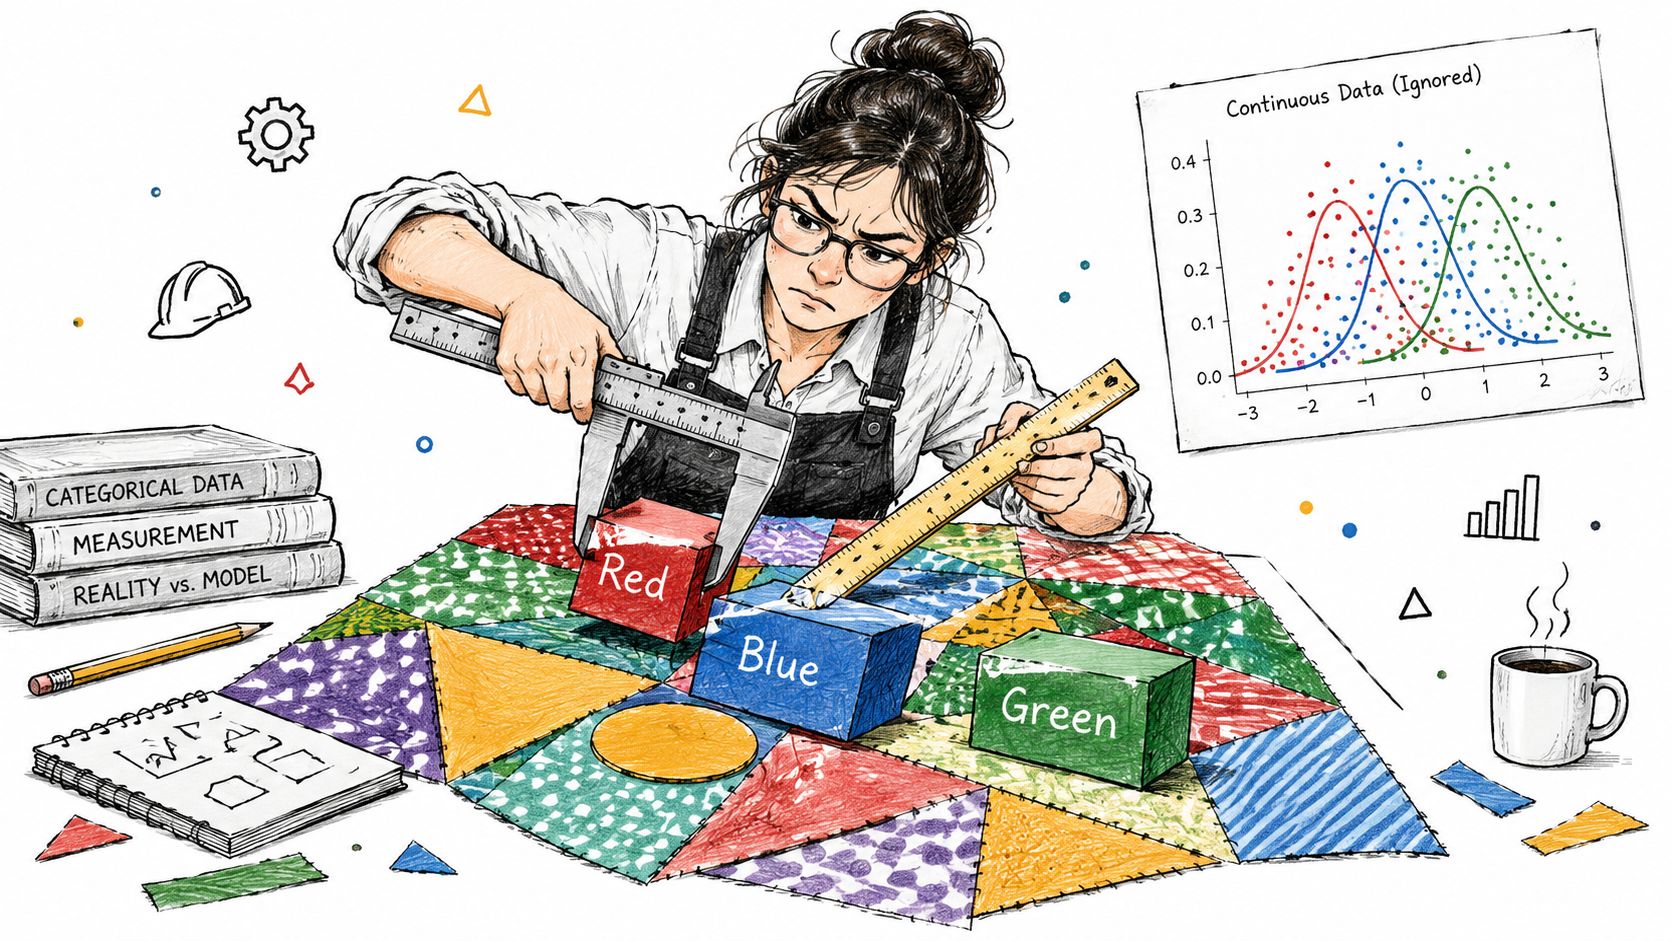
Die meisten numerischen Anomalie-Tools setzen eine Geometrie voraus, die kategoriale Daten nicht haben. Die euklidische Distanz funktioniert für Punkte in einem kontinuierlichen Raum, aber ein Ländercode, ein Transaktionstyp oder ein Abrechnungsstatus ist in keinem sinnvollen ordinalen Sinn „nah“ oder „fern“. Wer Labels wie Koordinaten behandelt, verwandelt ein diskretes Problem in ein vorgetäuschtes numerisches.
Diese Diskrepanz wirkt sich am stärksten bei hoher Kardinalität aus. Je granularer kategoriale Variablen werden, desto dünner besetzt sind die Kontingenztabellen, und das nützliche Signal verlagert sich in seltene Schnittmengen statt in große Ausschläge. Die einschlägige Übersichtsliteratur weist darauf hin, dass klassische Anomalieverfahren oft kontinuierliche Daten voraussetzen. Deshalb werden kategoriale Variablen vor der Erkennung häufig in kontinuierliche Attribute übersetzt, obwohl diese Übersetzung genau die Struktur auslöschen kann, die Sie untersuchen müssen CEUR-Übersicht zu Methoden der Anomalieerkennung.
Dünnbesetzte Kontingenzmuster sind die Stelle, an der Anomalien übersehen werden
Ein Ländercode allein mag gewöhnlich aussehen. Eine Zahlungsart allein mag gewöhnlich aussehen. Eine Geräteklasse allein mag gewöhnlich aussehen. Doch die Kombination dieser drei Felder kann selten genug sein, um Aufmerksamkeit zu verdienen, und distanzbasierte numerische Methoden übersehen das oft, weil sie sich auf Größenordnungen statt auf gemeinsames Auftreten konzentrieren.
Deshalb verursachen hochkardinale kategoriale Variablen Probleme. One-Hot-Encoding kann die Dimensionalität explodieren lassen, Schwellenwerte auf Basis der Standardabweichung werden bedeutungslos, und Z-Scores verraten Ihnen nicht, ob ein neuer Code ungewöhnlich oder einfach nur neu ist. In der Praxis brauchen Teams Methoden, die Seltenheit bewerten, Verteilungen vergleichen und die diskrete Natur der Daten respektieren.
Ein besseres Denkmodell beginnt mit Häufigkeit, nicht mit Distanz
Denken Sie in Kategorien wie Support einer Kategorie, bedingter Häufigkeit sowie beobachteten im Vergleich zu erwarteten Häufigkeiten. Wenn eine Kategorieausprägung in historischen Daten häufig ist, aber plötzlich verschwindet, kann das relevant sein. Wenn eine seltene Ausprägung plötzlich dominiert, kann das ebenfalls relevant sein. Die Methode sollte diese Logik widerspiegeln, statt die Daten in eine geometrische Form zu zwingen, die sie nie hatten.
Statistische Mustererkennung für kategoriale Felder ist hier die richtige Perspektive, weil sie Labels als Labels behandelt und nicht als verkleidete Zahlen. Das ist der Unterschied zwischen einer Pipeline, die echte Kategorienverschiebungen meldet, und einer, die lediglich mathematisches Rauschen erzeugt.
Statistische Baselines und Häufigkeitsbewertung
Beginnen Sie mit einer Baseline, die widerspiegelt, wie der Normalzustand für jedes kategoriale Feld aussieht. Für eine stabile Spalte ist diese Baseline in der Regel die historische Häufigkeitsverteilung jeder Kategorieausprägung sowie die gemeinsamen Häufigkeiten, die für den Geschäftsprozess relevant sind. Wenn die Daten saisonal oder workflowgetrieben sind, vergleichen Sie Gleiches mit Gleichem, statt anzunehmen, dass eine globale Baseline für alles passt.
Beobachtete mit erwarteten Häufigkeiten vergleichen
Der Chi-Quadrat-Test ist ein Standardverfahren, um beobachtete Kategorienhäufigkeiten mit einer Baseline-Verteilung auf kategoriale Drift zu vergleichen, und der Leitfaden zu Datendrift im Streaming beschreibt ihn als geeignet für Verschiebungen in Feldern wie Statuscodes oder Produktkategorien Conduktors Leitfaden zu Datendrift. Auch der PSI ist nützlich, um Verteilungsänderungen in einen operativen Schweregrad zu übersetzen. Derselbe Leitfaden nennt als PSI-Schwellenwerte weniger als 0,1 für minimale Drift, 0,1 bis 0,25 für moderate Drift, die untersucht werden sollte, und mehr als 0,25 für signifikante Drift, die sofortiges Handeln erfordert.
PSI-Wert | Schweregrad der Drift | Empfohlene Maßnahme |
|---|---|---|
Weniger als 0,1 | Minimale Drift | Überwachen und Baseline aktiv halten |
0,1 bis 0,25 | Moderate Drift | Quelle der Kategorie und nachgelagerte Auswirkungen untersuchen |
Mehr als 0,25 | Signifikante Drift | Als dringend behandeln und Pipeline- oder Geschäftsänderungen prüfen |
Entropie nutzen, um schnell ein Gefühl für Unvorhersehbarkeit zu bekommen
Entropie ist nützlich, weil sie Ihnen zeigt, wie breit eine Kategorienverteilung gestreut ist. Niedrige Entropie bedeutet, dass sich die Daten auf wenige Ausprägungen konzentrieren. Höhere Entropie bedeutet, dass die Verteilung gemischter ist, was auf eine neue Quelle, eine umfassendere geschäftliche Veränderung oder eine unsaubere vorgelagerte Integration hindeuten kann.
Das macht Entropie allein noch nicht zu einem vollständigen Detektor. Sie ist ein Profiling-Signal, kein Urteil. Nutzen Sie sie, um zu erkennen, wann ein kategoriales Feld mehr oder weniger vorhersehbar geworden ist, und bestätigen Sie das anschließend mit zählbasierten Prüfungen oder einer Bewertung gemeinsamer Häufigkeiten.
Für Teams, die eine strukturierte Verbindung zwischen Profiling und Erkennung benötigen, liefern Techniken des Data Profiling den passenden Kontext. Und wenn Sie eine klare Erklärung brauchen, wie statistische Signifikanz bei der Entscheidung hilft, ob sich das Handeln bei einer Verschiebung lohnt, ist der Leitfaden zur Signifikanz für Growth-Verantwortliche eine nützliche ergänzende Lektüre.
Den Workflow so einfach halten, dass er betreibbar bleibt
Profilieren Sie zuerst die Spalte. Erstellen Sie Kategorienhäufigkeiten, die Null-Rate und eine Top-k-Ansicht der am häufigsten auftretenden Ausprägungen.
Vergleichen Sie mit einer Baseline. Nutzen Sie Chi-Quadrat oder PSI, wenn es um Verteilungsverschiebungen geht.
Prüfen Sie die gemeinsamen Muster. Wenn die Randverteilung unauffällig aussieht, untersuchen Sie Kombinationen über Felder hinweg.
Eskalieren Sie nach Schweregrad. Eine kleine Verschiebung kann überwacht werden, eine starke Verschiebung erfordert jedoch eine manuelle Prüfung.
Es geht nicht darum, Machine Learning zu ersetzen. Es geht darum, nicht direkt in die Komplexität zu springen, bevor die einfachsten statistischen Tests ihre Arbeit getan haben.
Machine-Learning-Anpassungen für komplexe Verteilungen
Manche kategorialen Probleme sind für einfache Häufigkeitsprüfungen allein zu unübersichtlich. Sie umfassen viele Felder, sich ändernde Geschäftsregeln und Wechselwirkungen, die sich über Kategorienkombinationen hinweg zeigen statt innerhalb einer einzelnen Spalte. In Produktionspipelines bedeutet das in der Regel, dass Sie Modelle benötigen, die Struktur aus dünnbesetzten, hochkardinalen Daten lernen können, ohne die zugrunde liegenden betrieblichen Probleme zu verbergen.
Embeddings helfen, wenn die Kardinalität unhandlich wird
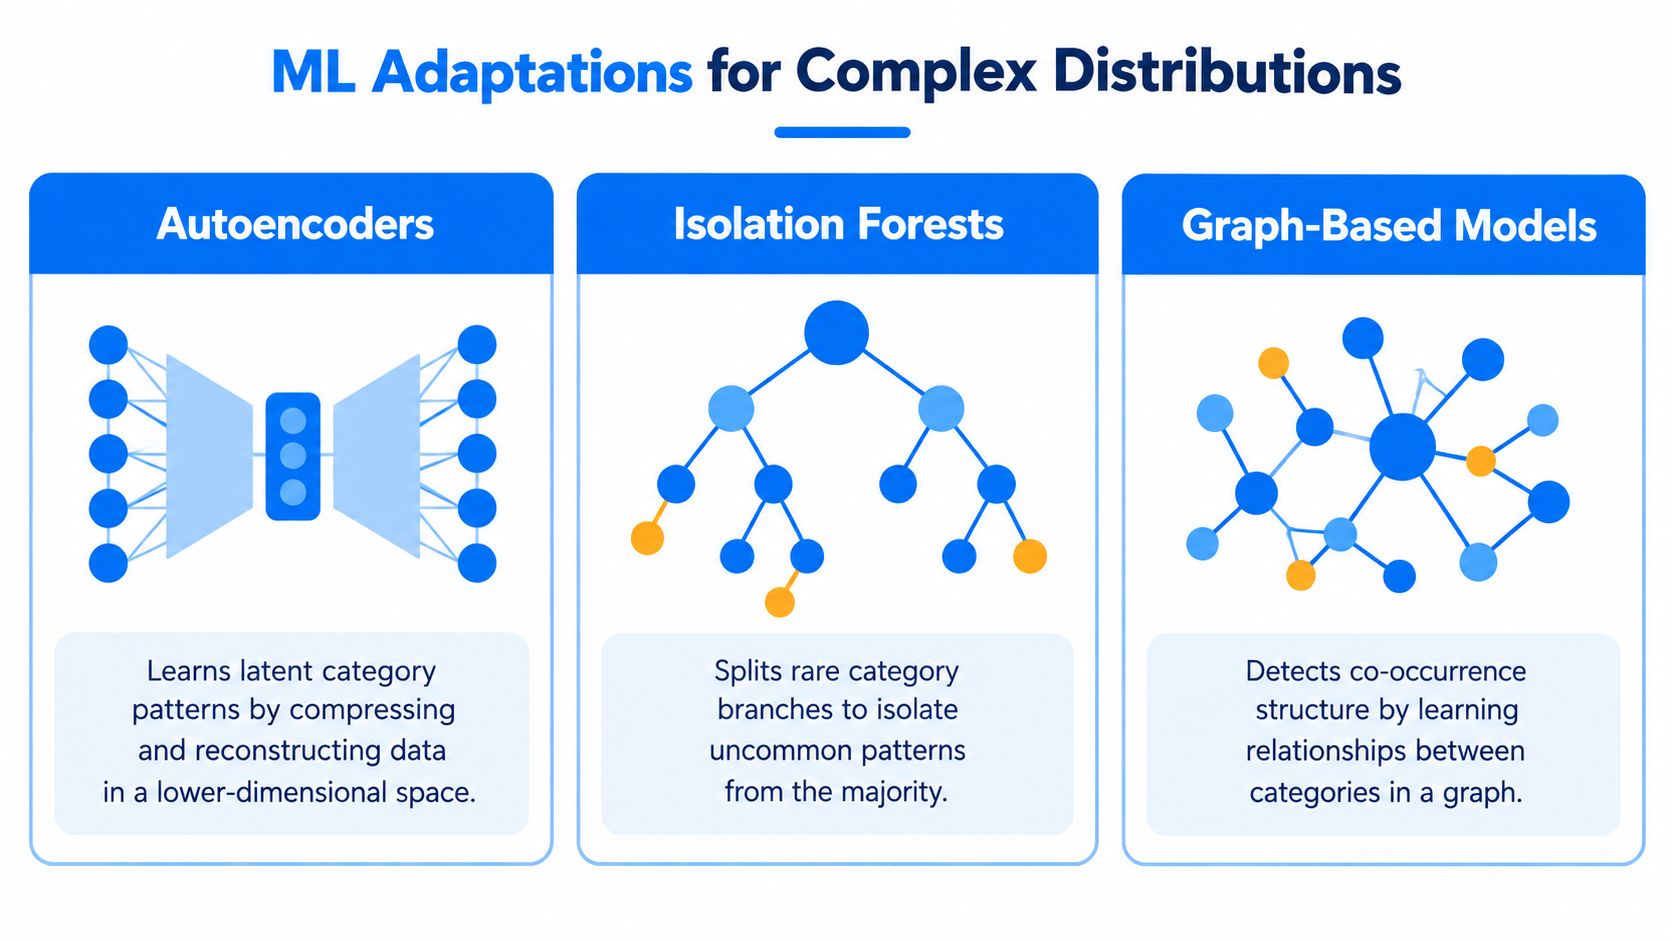
Kategoriale Embeddings bilden hochkardinale Ausprägungen auf dichte Repräsentationen ab, die andere Detektoren nutzen können. So können Teams Kategorienstruktur in Autoencoder, Isolation Forests oder ähnliche Modelle einspeisen, nachdem die rohen Labels in einen gelernten latenten Raum transformiert wurden. Eine in der aktuellen Literatur zitierte Studie aus der Krankenversicherung nutzte ausdrücklich kategoriale Embeddings für hochkardinale Features, unüberwachte Detektoren und SHAP in einem Workflow, der in diesem Kontext zuvor nicht eingesetzt worden war. Das zeigt, wie aktiv dieser Gestaltungsraum noch ist PubMed-Studie zu hochkardinalen kategorialen Features.
Die praktische Frage ist nicht, ob Embeddings elegant aussehen. Sie lautet, ob sie die Kategoriensignale bewahren, die One-Hot-Encoding in dünnbesetzten Feature-Räumen verliert.
Die gängigen Modellfamilien im Vergleich
Autoencoder funktionieren gut, wenn Kategorien stabilen latenten Mustern folgen und Anomalien über den Rekonstruktionsfehler sichtbar werden sollen.
Isolation Forests helfen, sobald Embeddings oder Feature Hashing ihnen eine numerische Oberfläche für die Aufteilung bieten.
Graphbasierte Modelle sind wichtig, wenn die Struktur des gemeinsamen Auftretens mehr Signal trägt als jedes einzelne Feld.
Echte kategoriale Datensätze sind keine Lehrbuchbeispiele. Das Repository ADBenchmarks listet 14 weit verbreitete kategoriale Datensätze auf, darunter Census mit 299.285 Zeilen und CoverType mit 581.012 Zeilen – eine nützliche Erinnerung daran, dass Methoden sowohl hinsichtlich Dimensionalität als auch Stichprobengröße skalieren müssen ADBenchmarks-Repository für kategoriale Datensätze. Der Benchmark zeigt außerdem, dass sich die Performance bei komplexen Datensätzen stark verändern kann.
Das Modell nach dem Fehlerbild auswählen
Wenn das Problem in wenigen offensichtlichen Kategorienverschiebungen besteht, beginnen Sie mit statistischen Tests. Geht es um eine subtile Struktur gemeinsamer Werte, nutzen Sie ein Modell, das Wechselwirkungen lernt. Ist das Feld riesig und dünnbesetzt, können Embeddings die Brücke zwischen rohen Kategorien und brauchbarer Erkennung schlagen. Einen praxisnahen Einstieg bietet dieser Leitfaden zur Datenanomalieerkennung in Python.
Umgang mit hochkardinalen Features und Schema-Drift
Eine Kundentabelle kann monatelang stabil aussehen, bis ein neuer Regionscode, Produktcode oder ein neues Quellsystem dieselbe Spalte mit Werten füllt, die Ihre Baseline noch nie gesehen hat. Genau hier wird das Monitoring hoher Kardinalität unübersichtlich, weil der Kategorienraum dünn besetzt ist und sich das umgebende Schema oft gleichzeitig ändert.
Struktur und Verteilung als getrennte Prüfungen behandeln
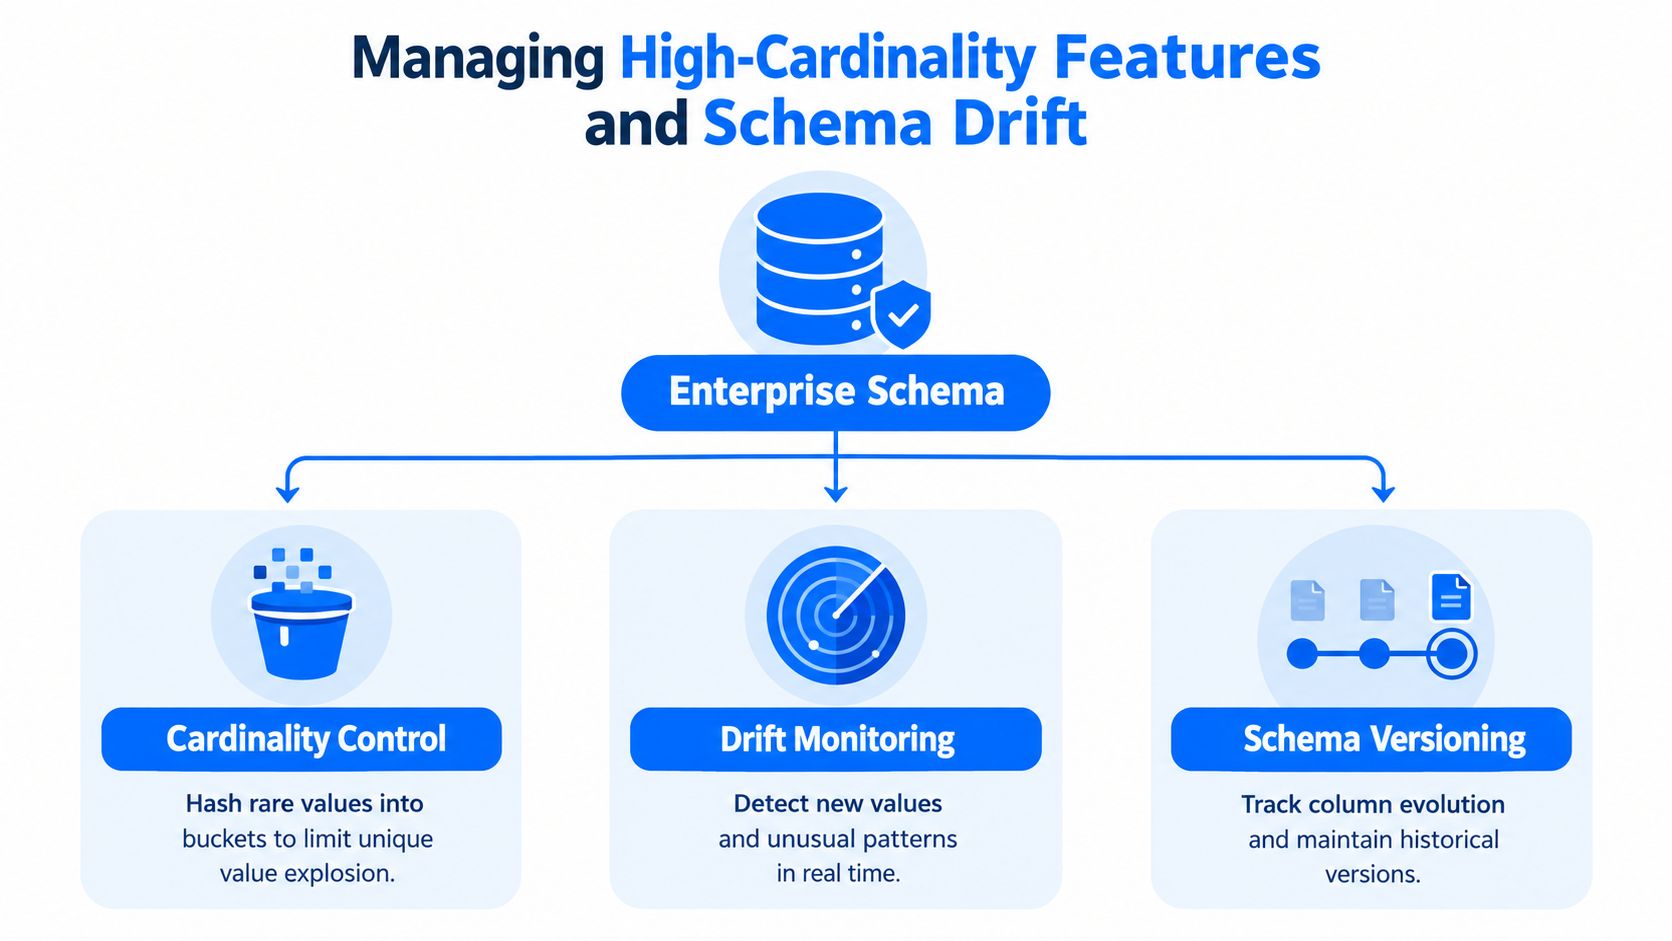
Ein Referenzdesign zur Erkennung von Schema- und Attribut-Drift empfiehlt für jede überwachte Tabelle zwei Baselines: einen strukturellen Fingerabdruck und ein statistisches Profil Design zur Erkennung von Schema- und Attribut-Drift. Der strukturelle Fingerabdruck erkennt hinzugefügte oder entfernte Spalten und Typänderungen. Das statistische Profil erfasst pro Spalte den Null-Anteil, die Anzahl unterschiedlicher Werte, gegebenenfalls numerische Grenzen sowie ein Top-k-Kategorienhistogramm für codierte Felder. Eine ausführlichere Darstellung dessen, was bei Strukturänderungen bricht, finden Sie unter Schema-Drift erklärt.
Diese Trennung ist in der Produktion wichtig. Ein neuer Wert kann eine gültige geschäftliche Änderung sein, während eine umbenannte Spalte oder ein geänderter Typ die Baseline ungültig machen kann, bevor eine Verteilungsprüfung überhaupt sinnvoll ist.
Rauschen reduzieren, ohne seltene Werte zu verbergen
Seltene Kategorien tragen Signal, erzeugen aber auch Alarmrauschen. Hashing, Bucketing und kontrollierte Gruppierung können die Monitoring-Oberfläche stabilisieren, solange Sie unterschiedliche geschäftliche Bedeutungen nicht zu früh zusammenfassen. Wenn ein seltener Produktcode auftaucht, sollte die Pipeline ihn zuerst erfassen und dann entscheiden, ob er zu einer bestehenden Gruppe gehört.
Überwachen Sie zuerst die Schemaänderung und entscheiden Sie dann, ob die Kategorienverschiebung eine echte Anomalie oder ein neuer Normalzustand ist.
Nachvollziehbarkeit ist das Kernthema in regulierten Systemen. Teams müssen zeigen können, was sich geändert hat, warum es gemeldet wurde und welche Baseline zur Entscheidung geführt hat. Verknüpfen Sie Schema-Drift und kategoriale Drift im selben Workflow, damit Analysten nicht mit separaten Tickets für eine einzige zugrunde liegende Störung enden.
Das Betriebsmodell einfach halten
Ein praxistaugliches Setup umfasst in der Regel drei Schritte. Neue oder entfernte Kategorien erkennen. Die aktuelle Verteilung mit der gelernten Baseline vergleichen. Das Schema versionieren, damit die Änderungshistorie später erklärbar bleibt. Das reicht aus, um die meisten kategoriebezogenen Fehler zu erkennen, ohne das Team mit False Positives zu überfluten.
Zielkonflikte bei der Implementierung und Enterprise-Tools
Eine eigene Python-Pipeline für die kategoriale Anomalieerkennung ist absolut machbar. Schwieriger ist es, sie zuverlässig zu halten, wenn die Zahl der Tabellen wächst, sich die Schemas weiterentwickeln und die Alarmierungslogik gleichzeitig Anforderungen an Governance, Sicherheit und Audit erfüllen muss.
Eigener Code bietet Kontrolle, bringt aber auch Wartungsaufwand mit sich
Ein selbst gebauter Stack kann pandas, scikit-learn oder SQL-basiertes Profiling für die statistische Ebene nutzen, und das ist für einen kleinen Umfang in Ordnung. Das Problem ist, was nach den ersten paar Tabellen passiert. Sie müssen Baselines, Schwellenwerte, Scheduling, Historie, Verantwortlichkeiten, Incident-Routing und Erklärbarkeit selbst verwalten, und jedes dieser Elemente kann zu einer eigenen Fehlerquelle werden.
TensorFlow Data Validation ist eine praktische Open-Source-Option, wenn Sie Drift-Prüfungen von Batch zu Batch und kategoriale Distanzmaße benötigen, da es Drift zwischen aufeinanderfolgenden Datenabschnitten erkennt und Drift bei kategorialen Features mit der L-Unendlich-Distanz misst Leitfaden zu TensorFlow Data Validation. Das funktioniert gut, wenn Ihre Pipeline bereits standardisiert ist und Ihr Team es sich leisten kann, die umgebende Orchestrierung selbst zu verantworten.
Die Plattformwahl ist entscheidend, wenn Sicherheit und Governance nicht verhandelbar sind
Die Ausführung in der Datenbank ist wichtig, weil die Daten an Ort und Stelle bleiben und unnötige Bewegungen zwischen Systemen reduziert werden. Das ist besonders in Finanzwesen, Gesundheitswesen, Telekommunikation und öffentlichem Sektor wichtig, wo Datensouveränität und Zugriffskontrollen die Architektur prägen. Die Forschung von IBM zu semantischer KI in Db2 weist in dieselbe Richtung, da sie die Verlagerung der Analyse näher an die Datenbank als Möglichkeit beschreibt, Risiken in Bezug auf Datenschutz, Compliance und Inkonsistenz zu verringern und gleichzeitig strukturierte und unstrukturierte Erkenntnisse zusammenzuhalten IBM Research zu SQL Data Insights Pro.
Hier fügen sich Plattformen wie digna als eine Option unter mehreren in das betriebliche Gesamtbild ein. digna läuft in der eigenen Umgebung des Kunden, führt Prüfungen in der Datenbank aus und kombiniert statistische Methoden mit Machine Learning zur Anomalieerkennung in kategorialen Feldern. Das macht die Plattform relevant, wenn Teams kontinuierliches Monitoring benötigen, ohne jede Komponente von Grund auf selbst zu bauen.
Nach Betriebsaufwand entscheiden, nicht nur nach Detektorqualität
Der beste Detektor ist nutzlos, wenn die Pipeline um ihn herum zusammenbricht. Wenn Ihr Team Hunderte von Tabellen sauber überwachen, eine Schemahistorie führen und das Verschieben sensibler Daten vermeiden muss, ist die Tool-Entscheidung ebenso eine Frage des Ausführungsmodells wie der Algorithmuswahl. Transparente, nutzungsstabile Preise sind ebenfalls wichtig, wenn Sie vorhersagen möchten, wie ein Monitoring-Programm mit der Anzahl der Tabellen und der Nutzung skaliert.
Einen produktionsreifen Monitoring-Workflow aufbauen
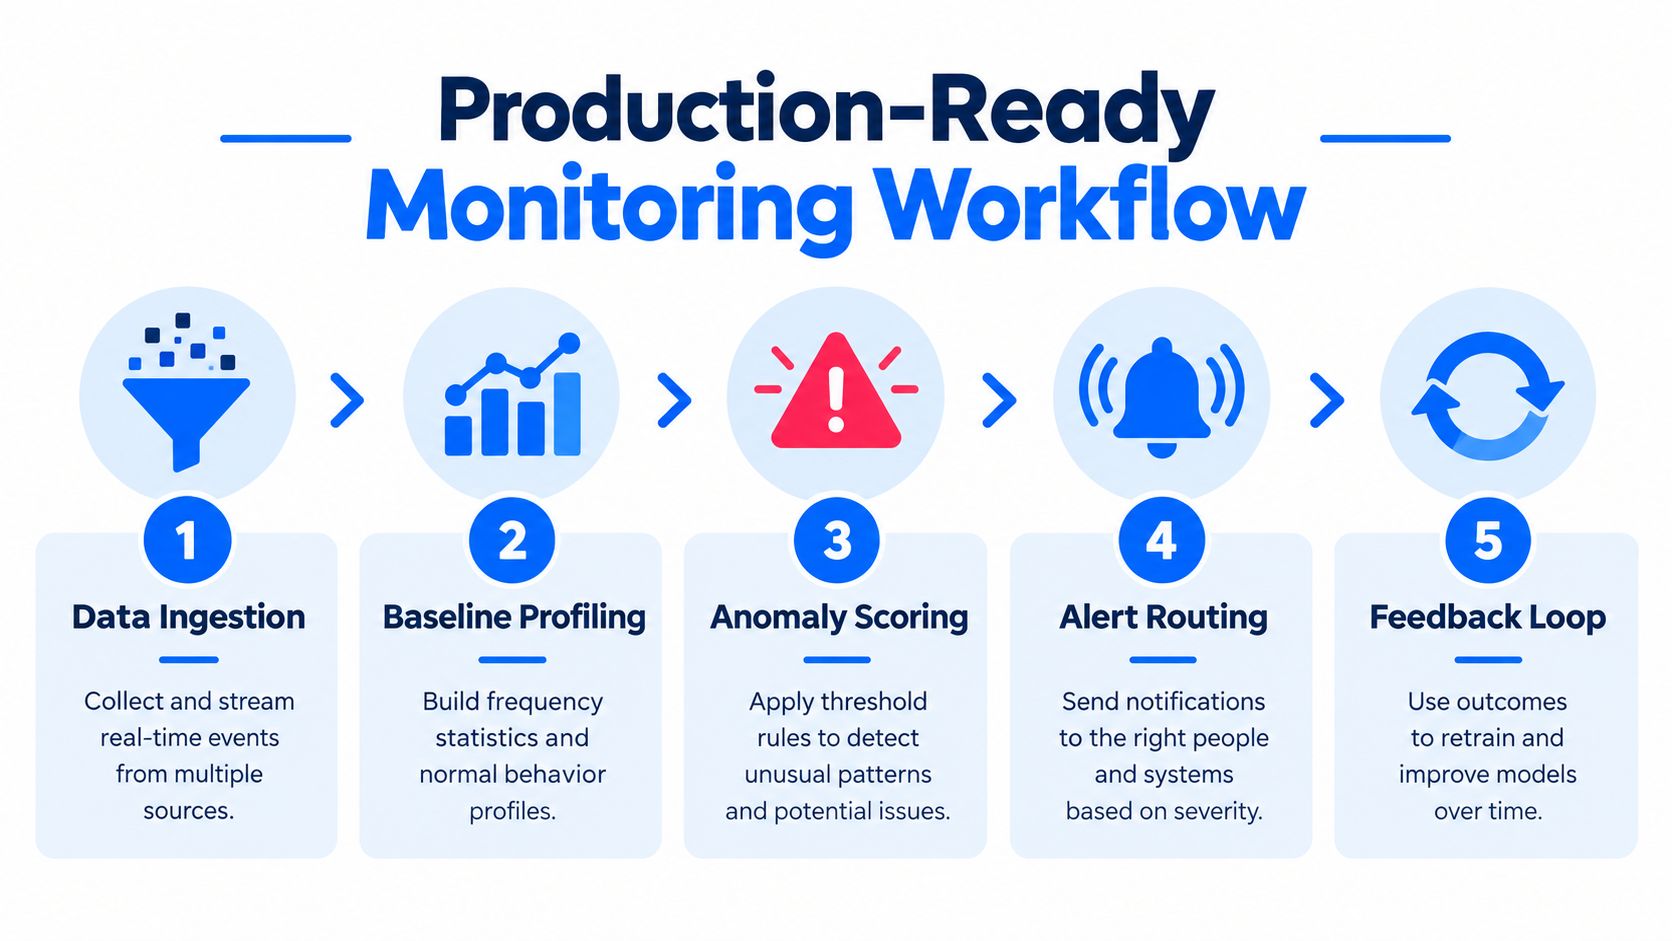
Ein Produktions-Workflow für die kategoriale Anomalieerkennung sollte im besten Sinne langweilig sein. Die Pipeline nimmt Daten auf, profiliert Kategorienverteilungen, bewertet Anomalien, leitet Alarme an den richtigen Verantwortlichen weiter und speist das Ergebnis zurück in die Baseline, damit das System weiterlernt. Fehlt eines dieser Elemente, wird der Detektor zu einem einmaligen Skript statt zu einer operativen Kontrolle.
Den Ablauf um Verantwortlichkeiten herum aufbauen
Legen Sie zunächst fest, welche Tabellen und kategorialen Felder geschäftskritisch sind. Benennen Sie dann Verantwortliche, die eine Meldung im Kontext interpretieren können, denn die richtige Reaktion auf eine neue Kategorie ist nicht immer dieselbe wie die richtige Reaktion auf ein defektes Schema. Ohne klare Verantwortlichkeiten werden Alarme zu Rauschen.
Ein nützlicher Alarm sagt jemandem genau, was sich geändert hat, wo es sich geändert hat und gegen welche Baseline verstoßen wurde.
Halten Sie die Baseline als Nächstes lokal für Tabelle und Feld, nicht global für das gesamte Warehouse. Kategoriales Verhalten ist oft domänenspezifisch, daher kann ein Feld in einem System nicht an denselben Erwartungen gemessen werden wie ein ähnlich benanntes Feld an anderer Stelle. Das gilt besonders, wenn sich Codes, Produkthierarchien und Statuswerte je nach Quellsystem unterscheiden.
Die Feedbackschleife zum Teil des Detektors machen
Jede Prüfung sollte das System in irgendeiner Weise aktualisieren, selbst wenn das Ergebnis „das war zu erwarten“ lautet. Das kann bedeuten, Schwellenwerte anzupassen, eine neue zulässige Kategorie hinzuzufügen oder die Gruppierungslogik für seltene Ausprägungen zu ändern. Wenn die Baseline nie dazulernt, kommt dasselbe False Positive morgen wieder.
Der letzte Schritt ist einfach, wird aber leicht übersprungen. Integrieren Sie die kategorialen Prüfungen in denselben operativen Pfad wie den Rest Ihres Data-Observability-Stacks, damit sie nicht von vorgelagerter Lineage, nachgelagerten Dashboards oder Modelleingaben isoliert sind. So wird die Anomalieerkennung für kategoriale Daten zu einer dauerhaften Kontrolle statt zu einer periodischen Aufräumaufgabe.
Wenn Sie eine kategoriale Anomalieerkennung benötigen, die in echte Enterprise-Pipelines passt: digna ist darauf ausgelegt, Datenverhalten zu überwachen, Schemaänderungen zu erkennen und Prüfungen in Ihrer eigenen Umgebung auszuführen, ohne die Daten nach außen zu verlagern. Besuchen Sie digna, um zu sehen, wie sich dieser Ansatz auf Ihr Warehouse, Ihren Lake oder Ihren Pipeline-Stack übertragen lässt, insbesondere wenn Sie mit dünnbesetzten Kategorien, Drift und Produktionsalarmen zu tun haben, die schnell das richtige Team erreichen müssen.
Wenn Sie die oben beschriebene Schleife aus Baseline, Bewertung und Alarmierung lieber nicht selbst bauen möchten, führt digna Data Anomalies dieses Monitoring in der Datenbank aus, innerhalb Ihrer eigenen Umgebung.
Häufig gestellte Fragen
Was ist eine kategoriale Anomalie?
Eine kategoriale Anomalie ist eine Ausprägung oder eine Kombination von Ausprägungen über mehrere Felder hinweg, die im Vergleich zur Basispopulation mit ungewöhnlich geringer Häufigkeit auftritt. Anders als bei einem numerischen Ausreißer geht es darum, wie oft eine Kategorie auftritt und gemeinsam mit anderen vorkommt. So können Land, Zahlungsart und Geräteklasse in Kombination selten sein, während jedes Feld für sich normal aussieht.
Warum funktioniert die euklidische Distanz bei kategorialen Daten nicht?
Labels wie Ländercodes oder Abrechnungsstatus haben keine sinnvolle Geometrie, daher sagt der Abstand zu einem Mittelwert nichts über sie aus. One-Hot-Encoding hochkardinaler Felder lässt die Dimensionalität explodieren und macht Kontingenztabellen dünnbesetzt, während Z-Scores nicht erkennen können, ob ein neuer Code ungewöhnlich oder einfach nur neu ist.
Wie erkenne ich Drift in einer kategorialen Spalte?
Vergleichen Sie beobachtete Kategorienhäufigkeiten mit einer historischen Baseline mithilfe eines Chi-Quadrat-Tests oder quantifizieren Sie die Verschiebung mit dem Population Stability Index. Ein PSI unter 0,1 deutet auf minimale Drift hin, 0,1 bis 0,25 erfordert eine Untersuchung, und alles über 0,25 ist signifikante Drift, die sofortiges Handeln erfordert.
Wie sollte ich bei der Anomalieerkennung mit hochkardinalen kategorialen Features umgehen?
Kategoriale Embeddings bilden viele Ausprägungen auf dichte Repräsentationen ab, die Autoencoder oder Isolation Forests nutzen können. Für das Monitoring sollten Sie pro Tabelle zwei Baselines führen: einen strukturellen Fingerabdruck für hinzugefügte, entfernte oder im Typ geänderte Spalten und ein statistisches Profil mit Null-Anteil, Anzahl unterschiedlicher Werte und einem Top-k-Kategorienhistogramm.
Was sollte ein produktiver Workflow zum Monitoring kategorialer Anomalien umfassen?
Er muss Daten aufnehmen, Kategorienverteilungen profilieren, Anomalien bewerten, Alarme an benannte Verantwortliche weiterleiten und Prüfergebnisse zurück in die Baseline speisen. Halten Sie Baselines lokal für jede Tabelle und jedes Feld und lassen Sie jede Prüfung Schwellenwerte oder zulässige Kategorien anpassen, damit dasselbe False Positive nicht wiederkehrt.


