7 Stoppwortlisten für Suche und NLP
|
7
min. Lesezeit

Das Entfernen häufiger Wörter ist kein universeller Gewinn. Ein Stoppwort kann in einem Workflow Rauschen und in einem anderen ein entscheidendes Signal sein. Die richtige Konfiguration Ihrer Stoppwortliste hängt daher davon ab, was Sie verbessern möchten: Suchrelevanz, NLP-Features, datenbanknative Verarbeitung oder die Bedeutung von Fachtexten. Historische Retrieval-Systeme behandelten Stopplisten als Abkürzung bei der Indexierung, nicht als pauschale Regel, und moderne Pipelines stehen vor demselben Zielkonflikt: Das Entfernen häufiger Begriffe kann Indizes verkleinern und die Verarbeitung beschleunigen, zugleich aber die Phrasensuche und geschäftskritische Abfragen beeinträchtigen (Geschichte der Stoppwörter und Zielkonflikte beim Retrieval). Die praktische Regel ist einfach: Messen Sie Relevanz, Modellqualität und nachgelagerte Datenqualitätsergebnisse vor und nach dem Filtern, und dokumentieren Sie anschließend jede individuelle Ergänzung oder Ausnahme.
In englischen Texten machen Stoppwörter oft einen großen Teil der gewöhnlichen Sprache aus, und das macht die Entscheidung zu einer operativen, nicht zu einer kosmetischen. Die Leitlinien von NVIDIA fassen Studien zusammen, wonach typischer englischer Text etwa 30 bis 40 % Stoppwörter enthält. Filterentscheidungen können also Indexgröße, Verarbeitungsgeschwindigkeit und Modellverhalten erheblich verändern (NVIDIA-Leitfaden zu Stoppwörtern). Deshalb sollten Sie die sieben folgenden Ressourcen nach Aufgabe lesen, nicht nach Marke. Einige sind für allgemeines NLP gedacht, einige für Suchmaschinen, einige für Machine Learning und einige für die datenbanknative Textverarbeitung, bei der die Daten an Ort und Stelle bleiben sollen.
Inhaltsverzeichnis
1. NLTK English Stop Words
Einsatz, wenn Text einen Monitoring-Workflow unterstützt
2. Native Stoppwörter in Snowflake
Textverarbeitung im Warehouse nah an den Daten halten
3. Apache Lucene Stop Words
Lucene einsetzen, wenn das Suchverhalten wichtiger ist als breites NLP
4. spaCy-Standardstoppwörter
spaCy einsetzen, wenn die Bedeutung von Grammatik und Kontext abhängt
5. Benutzerdefinierte Stoppwort-Wörterbücher in PostgreSQL und BigQuery
Wörterbücher auf Audit und Wiederverwendung ausrichten
6. Branchenspezifische Stoppwortlisten
Fachvokabular als Teil des Kontrolldesigns behandeln
7. Scikit-Learn English Stop Words
Als Ausgangspunkt für Text-Features verwenden
Vergleich von 7 Stoppwortlisten
Wählen Sie die Liste, die Bedeutung bewahrt
1. NLTK English Stop Words
NLTK ist ein solider Ausgangspunkt, wenn es um allgemeines NLP in Python geht. Die englische Stoppwortliste wird in der Vorverarbeitung häufig eingesetzt, weil sie Teams eine schnelle Möglichkeit bietet, Füllwörter vor Tokenisierung, Häufigkeitsanalyse oder Textklassifikation zu entfernen. Für digna-Teams ist sie daher nützlich, wenn natürlichsprachliche Beschreibungen von Geschäftsregeln, Metadaten-Tags oder Incident-Notizen vor einer Validierung oder Anomalieanalyse bereinigt werden müssen. Es geht nicht darum, der Standardliste für immer zu vertrauen, sondern schnell eine lesbare Ausgangsbasis zu erhalten.
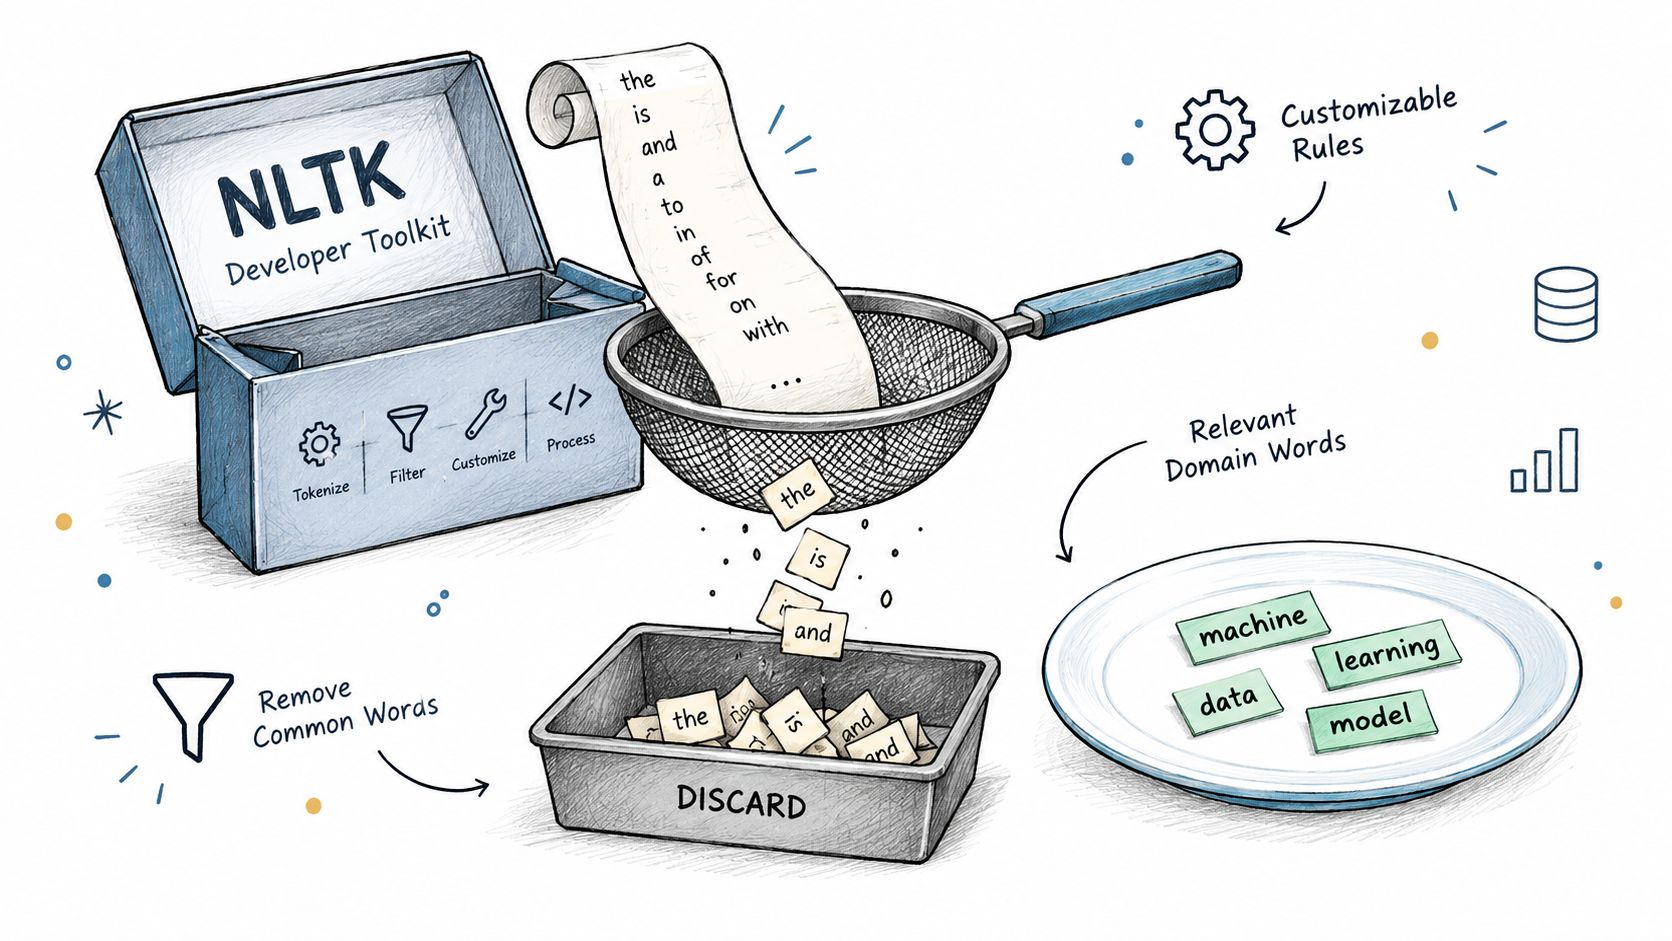
NLTK funktioniert am besten, wenn Sie es als Listenentwurf und nicht als endgültige Richtlinie behandeln. Wenn Ihr Datenqualitätsteam in wiederkehrenden Regeltexten Begriffe wie credit, patient oder subscriber sieht, tragen diese Wörter möglicherweise mehr Bedeutung, als eine generische englische Liste annimmt. In Finanzdienstleistungen, im Gesundheitswesen oder in der Telekommunikation ist eine eigene Liste oft die sicherere Wahl, weil die Fachsprache wichtiger sein kann als grammatikalische Füllwörter.
Einsatz, wenn Text einen Monitoring-Workflow unterstützt
Ein praktischer Anwendungsfall ist das Filtern natürlichsprachlicher Regelbeschreibungen gemäß dignas Leitfaden zur Datenbereinigung, wo das Ziel darin besteht, vor der Analyse Syntax von Signal zu trennen. Dieselbe Liste kann helfen, Lineage-Notizen oder Incident-Zusammenfassungen zu bereinigen, bevor sie geclustert oder gezählt werden. Sie kann auch das Rauschen in Freitextfeldern reduzieren, die Analysten zur Triage von Datenproblemen nutzen.
Praxisregel: Beginnen Sie mit der Standardliste und fügen Sie Begriffe erst hinzu oder entfernen Sie sie, nachdem Sie sie anhand Ihres eigenen Geschäftsregel-Vokabulars getestet haben.
Fachbegriffe bewahren: Behalten Sie Wörter, die in Ihrer Branche die Bedeutung verändern, auch wenn sie im allgemeinen Englisch häufig sind.
Vor dem Rollout testen: Vergleichen Sie gefilterten und ungefilterten Text anhand echter Incident- und Regelbeispiele.
Jede Änderung dokumentieren: Halten Sie jede individuelle Ergänzung schriftlich fest, damit die Validierungslogik teamübergreifend konsistent bleibt.
2. Native Stoppwörter in Snowflake
Snowflake gehört in die Diskussion, wenn die Textverarbeitung im Warehouse bleiben muss. Die native Behandlung von Stoppwörtern passt zur Arbeit mit Cloud-Daten, weil Text nicht in einen externen NLP-Stack verschoben werden muss, nur um häufige Begriffe zu entfernen. Für digna-Deployments in Snowflake passt das zur In-Database-Ausführung, da der Text nah an den Datensätzen, der Lineage und den untersuchten Schema-Metadaten bleibt.
Das ist in Observability-Workflows wichtig. Wenn eine Beschreibung im Datenkatalog oder eine Incident-Notiz dort verarbeitet wird, wo sie bereits liegt, vermeiden Teams zusätzliche Orchestrierung und halten den Audit-Trail einfacher. In der Praxis ist der stärkste Anwendungsfall das Filtern von menschlich verfassten Metadaten, die Schemas begleiten, weil der umgebende Kontext oft genauso wichtig ist wie die reine Token-Liste.
Snowflake erinnert auch daran, dass Stoppwörter nicht nur ein NLP-Thema sind. Sie können Teil derselben Warehouse-Logik sein, die Textsuche, Incident-Triage und die Prüfung von Schemaänderungen unterstützt. Wenn dieselbe Umgebung sowohl Speicherung als auch Analyse abdeckt, wird eine native Stoppwortliste Teil des Betriebsmodells und nicht ein in einem Notebook versteckter Vorverarbeitungsschritt.
Textverarbeitung im Warehouse nah an den Daten halten
Für Teams, die Katalogänderungen überwachen, entspricht dieses Design dignas Snowflake-Leitfaden, insbesondere wenn das Dashboard zeigen soll, was sich geändert hat, ohne sensible Texte zu exportieren. Eine eigene Lookup-Tabelle ist oft die richtige Ergänzung, wenn der Warehouse-Text Fachbegriffe enthält, die Standardlisten entfernen würden. Dieser Ansatz erleichtert auch die Versionierung über Umgebungen hinweg.
Zuerst natives Filtern nutzen: Belassen Sie die Transformation in Snowflake, wenn die Daten bereits dort liegen.
Um Fachbegriffe ergänzen: Fügen Sie eine domänenspezifische Ebene für reguliertes oder technisches Vokabular hinzu.
Release-Änderungen prüfen: Prüfen Sie Aktualisierungen der Stoppwörter, bevor sie bestehende Regeln oder gespeicherte Suchen beeinflussen.
3. Apache Lucene Stop Words
Lucene ist die präzisere Wahl, wenn es um Suchindexierung geht. Die englische Stoppwortliste ist kompakt und auf Information Retrieval abgestimmt, was sie ideal für Katalogsuche, Lineage-Lookups und großflächiges Metadaten-Retrieval macht. Eine solche Liste ist in der Regel besser, wenn das Ziel eine schnelle, fokussierte Suche statt einer breiten linguistischen Analyse ist.
Der Zielkonflikt wird leicht übersehen. Eine kleinere Liste kann sich hervorragend auf die Performance auswirken, doch die Suchrelevanz hängt davon ab, wie Menschen Ihre Daten abfragen. Ein Begriff, der in einem generischen Korpus trivial wirkt, kann in einem Tabellennamen, einer Schemabeschreibung oder einem Incident-Titel wichtig sein. Wenn Ihre Nutzer nach exakten Phrasen suchen, kann das Entfernen der falschen Begriffe das System ungenauer wirken lassen, selbst wenn der Index kleiner wird.
Lucene einsetzen, wenn das Suchverhalten wichtiger ist als breites NLP
Lucene passt zu Situationen, in denen viele Menschen dieselbe Metadatenoberfläche durchsuchen, etwa einen Datenkatalog mit Tausenden von Tabellen. In digna-Deployments ist das besonders für die Erkundung von Schemas und Lineage relevant, wo Suchgeschwindigkeit und Ranking-Qualität beide Teil der Nutzererfahrung sind. Je sauberer der Index, desto leichter lässt sich das richtige Objekt schnell finden.
Lucene ist am stärksten, wenn Sie Stoppwörter als Werkzeug zur Suchoptimierung behandeln, nicht als generischen Bereinigungsschritt.
Deshalb gehört dignas Leitfaden zur Wildcard-Suche in denselben Workflow. Wildcard-Suche und Stoppwortfilterung betreffen unterschiedliche Teile des Retrievals, wirken in der Praxis aber zusammen, wenn Nutzer Teilnamen, gemischte Phrasen oder unsaubere Metadaten-Labels eingeben. Wenn die Suchoberfläche betrieblich wichtig ist, testen Sie sie anhand echter Abfrageprotokolle, bevor Sie die Liste standardisieren.
4. spaCy-Standardstoppwörter
spaCy passt besser, wenn die Pipeline eine breitere Sprachabdeckung und eine genauere linguistische Verarbeitung benötigt. Die standardmäßige englische Stoppwortmenge ist größer als suchorientierte Listen, und spaCy unterstützt zudem Stoppwort-Ressourcen für viele Sprachen. Das ist wichtig, wenn Text geparst, lemmatisiert und analysiert und nicht nur tokenisiert wird.
Für digna-Nutzer lautet der praktische Test, ob Sprache in Datenqualitätsregeln, Incident-Zusammenfassungen und Schemabeschreibungen weiterhin Risikosignale trägt. Eine Regelerläuterung kann an einer Formulierung hängen, etwa daran, ob ein Feld nur unter bestimmten Bedingungen erforderlich ist. In diesem Kontext kann ein zu aggressives Entfernen häufiger Wörter genau die Logik löschen, die Analysten prüfen müssen.
spaCy einsetzen, wenn die Bedeutung von Grammatik und Kontext abhängt
spaCy eignet sich gut, um Schlüsselkonzepte aus Incident-Beschreibungen zu extrahieren und wiederkehrende Muster in Regeltexten zu erkennen. Es passt auch zu Teams, die eine konsistente Behandlung über Sprachen hinweg oder eine zentrale Konfiguration für ein umfassenderes Datenqualitäts-Framework benötigen. In regulierten Umgebungen kann diese Konsistenz genauso wichtig sein wie die reine Modellqualität.
Das beste Vorgehen besteht darin, die Standardliste erst nach Tests mit echtem Text zu erweitern. Im Finanzwesen müssen Begriffe wie credit und debit möglicherweise erhalten bleiben. Im Gesundheitswesen können patient und drug zu wichtig sein, um sie zu entfernen. In der Telekommunikation kann subscriber ein zentrales Signal statt eines Füllworts sein.
Bewährte Praxis: Nutzen Sie die Sprachpipeline und die Stoppwörter von spaCy gemeinsam und entscheiden Sie dann, ob das Fachvokabular eine separate Ausschlussebene benötigt.
Dieser Ansatz entspricht dignas Leitfaden zu historischen Daten, wenn Geschäftsregeltexte für Analysten und Prüfer interpretierbar bleiben müssen.
5. Benutzerdefinierte Stoppwort-Wörterbücher in PostgreSQL und BigQuery
Datenbanknative Wörterbücher sind die richtige Wahl, wenn die Textverarbeitung innerhalb der Plattform bleiben muss. Die Volltextsuche von PostgreSQL und die konfigurierbaren Textfunktionen von BigQuery ermöglichen es Teams, Stoppwortregeln näher an den Daten anzusiedeln. Das reduziert Datenbewegungen und macht die Governance leichter nachvollziehbar. Für Teams, die bereits in diesen Systemen arbeiten, entscheidet diese Platzierung oft über das Design.
Der Zielkonflikt ist einfach: Die Behandlung von Stoppwörtern verlagert sich von allgemeiner Sprachbereinigung hin zur Plattformsteuerung. Ein Team im Gesundheitswesen kann klinische Begriffe in einem Wörterbuch behalten und generisches Englisch in einem anderen entfernen. Ein Team im Finanzdienstleistungssektor dokumentiert möglicherweise jede Änderung aus Compliance-Gründen. Der Nutzen liegt nicht nur im Filtern, sondern darin, die Textrichtlinie an der Umgebung auszurichten, in der der Text abgefragt wird.
Wörterbücher auf Audit und Wiederverwendung ausrichten
Für digna-Deployments passen datenbanknative Listen gut zum Modell der In-Database-Ausführung. Sie unterstützen außerdem wiederholbare Workflows für Beschreibungen von Schemaänderungen, Geschäftsregeltexte und Katalog-Metadaten, die sonst in separate Tools kopiert würden. Dadurch lassen sie sich leichter auditieren und über Umgebungen hinweg konsistent halten. Für BigQuery-spezifische Workflows ist dignas Seite zur Datenqualität in BigQuery ein nützlicher Bezugspunkt, während PostgreSQL-Teams dignas Seite zur Datenqualität in PostgreSQL nutzen können, um Filterung und Validierung im selben operativen Ablauf zu halten.
Nach Domäne trennen: Verwenden Sie separate Wörterbücher für operative, regulierte und analytische Texte.
Änderungen formal nachverfolgen: Versionieren Sie Änderungen an Wörterbüchern, damit Reviews und Rollbacks unkompliziert sind.
Mit repräsentativem Text testen: Validieren Sie anhand echter Beschreibungen, nicht anhand von Spielbeispielen.
Der Hauptvorteil ist Kontrolle. Teams wissen, welche Regeln aktiv sind, wo sie laufen und wie sie die Ergebnisse beeinflussen. Das ist wichtig, weil das Entfernen des falschen Wortes die Suchrelevanz beeinträchtigen oder die geschäftliche Bedeutung verwischen kann, insbesondere wenn derselbe Begriff in Datenbank-, Analyse- und Compliance-Workflows unterschiedlich gewichtet ist.
6. Branchenspezifische Stoppwortlisten
Generische Listen versagen in regulierten Branchen am schnellsten. Ein Wort, das im normalen Englisch unwichtig erscheint, kann für Finanzberichte, Patientensicherheit oder das KPI-Monitoring in der Telekommunikation zentral sein. Deshalb geht es bei branchenspezifischen Stoppwortlisten weniger darum, mehr Wörter zu entfernen, als vielmehr darum, die Begriffe zu bewahren, die geschäftliche Bedeutung tragen.
Finanzdienstleister müssen in der Regel Begriffe wie debit, credit, transaction und settlement sichtbar halten. Teams im Gesundheitswesen brauchen häufig patient, diagnosis, treatment und medication auch nach dem Filtern. Telekommunikationsteams sind für ein genaues Monitoring möglicherweise auf Wörter wie subscriber, churn, revenue und arpu angewiesen. In jedem dieser Fälle kann die falsche Stoppliste das Signal verwischen, das die Verantwortlichen benötigen.
Fachvokabular als Teil des Kontrolldesigns behandeln
Governance ist hier entscheidend. Compliance-Teams sollten die Liste prüfen, weil die Entscheidung, einen Begriff zu behalten oder zu entfernen, Audit-Trails, die KPI-Interpretation und die Anomalieerkennung beeinflussen kann. Wenn eine Geschäftsregel oder ein Monitoring-Schwellenwert von fachlicher Formulierung abhängt, sollte dieses Wort nicht leichtfertig aus der Analyse entfernt werden.
Wenn ein häufiges Wort die Interpretation einer regulierten Kennzahl verändert, ist es für Ihren Anwendungsfall kein Stoppwort.
Dieses Prinzip passt nahtlos zu dignas Leitfaden zur Governance im Finanzwesen, da Finanzteams oft eine strenge Kontrolle über Terminologie, Validierung und Prüfbarkeit benötigen. Dieselbe Logik gilt für Daten im Gesundheitswesen und im öffentlichen Sektor, wo Nachvollziehbarkeit genauso wichtig sein kann wie Bequemlichkeit.
7. Scikit-Learn English Stop Words
Scikit-learn gehört in die Machine-Learning-Ebene, nicht in die Suchebene. Die englischen Stoppwörter sind für die Feature-Extraktion konzipiert und daher eine sinnvolle Ausgangsbasis für Vektorisierung, Klassifikation und anomaliebezogene Text-Features. Wenn die Aufgabe darin besteht, Incident-Notizen oder Schemabeschreibungen in Features umzuwandeln, ist dies die Liste, die zur Pipeline passt.
Der große Vorteil ist die Kompatibilität. Die Stoppwörter von scikit-learn fügen sich nahtlos in Python-ML-Workflows ein, insbesondere wenn Teams TF-IDF-Features oder andere dünnbesetzte Repräsentationen erstellen. Für digna-Nutzer sind sie damit beim Erlernen von Baselines, bei der statistischen Musteranalyse und bei der modellgestützten Triage von Texten nützlich, die Datenqualitätsereignisse begleiten.
Als Ausgangspunkt für Text-Features verwenden
Entscheidend ist, wie ein Modellentwickler zu denken, nicht wie ein Suchingenieur. Eine Machine-Learning-Pipeline profitiert oft davon, hochfrequente Füllwörter zu entfernen, doch der Wert ergibt sich daraus, ob die verbleibenden Begriffe Vorhersage, Clustering oder Drift-Erkennung verbessern. Ist die Liste zu aggressiv, kann das Modell nützliche Unterscheidungen verlieren. Ist sie zu locker, bleiben die Features verrauscht.
Deshalb ist es bewährte Praxis, mit der Basisliste zu beginnen und Fachbegriffe erst hinzuzufügen, nachdem Sie das Modellverhalten anhand echter Beispiele aus Ihrer Umgebung geprüft haben. Eine Notiz zu einer Schemaänderung kann in einem Unternehmen Sprache verwenden, die in einem anderen generisch ist, und die Liste sollte diesen Unterschied widerspiegeln.
Zuerst eine Baseline nutzen: Behalten Sie die Standardliste bei, bevor Sie eigene Begriffe einführen.
Auf die Vektorisierung abstimmen: Kombinieren Sie sie mit TF-IDF oder ähnlichen Methoden der Feature-Extraktion.
Modellausgabe prüfen: Prüfen Sie, ob entfernte Begriffe die Vorhersagen verändert haben, nicht nur die Token-Anzahl.
Vergleich von 7 Stoppwortlisten
Eintrag | Implementierungsaufwand 🔄 | Ressourcenbedarf ⚡ | Erwartete Ergebnisse 📊 & Qualität ⭐ | Ideale Anwendungsfälle 💡 | Wesentliche Vorteile ⭐ |
|---|---|---|---|---|---|
NLTK English Stop Words | Gering, einfache Liste; leicht anpassbar | Gering, schlankes Python-Paket | Mittlere Wirkung; reduziert Rauschen, erfordert aber Feinabstimmung, ⭐⭐⭐ | Allgemeine NLP-Vorverarbeitung, Bereinigung von Metadaten | Open Source, weit verbreitet, leicht anpassbar |
Native Stoppwörter in Snowflake | Gering, natives Setup, minimale Konfiguration | Minimal, In-Database, keine externen Abhängigkeiten, hoher Durchsatz | Hoch für Filterung im Warehouse; schnell & governancefreundlich, ⭐⭐⭐⭐ | digna auf Snowflake; In-Database-Textfilterung und Tokenisierung | Keine Datenbewegung, optimierte Performance, Daten bleiben an Ort und Stelle |
Apache Lucene Stop Words | Gering, lässt sich leicht in Such-Stacks einbinden | Gering, kleine Liste, minimaler Overhead | Hoch für Suchrelevanz und Indexierungseffizienz, ⭐⭐⭐⭐ | Volltextsuche, Optimierung großer Indizes (ES/Solr) | Sehr kompakte Liste, verbessert die Suchgeschwindigkeit und verkleinert den Index |
spaCy-Standardstoppwörter | Mittel, erfordert spaCy-Installation und Modelle | Mittel, Python + NLP-Modelle; mehr Rechenleistung | Hoch für linguistische Aufgaben und entitätsbewusste Filterung, ⭐⭐⭐⭐ | Fortgeschrittenes NLP, Komplexitätsanalyse von Geschäftsregeln, semantisches Parsing | Kuratiert, in die NLP-Pipeline integriert, zur Laufzeit anpassbar |
Benutzerdefinierte Wörterbücher in PostgreSQL & BigQuery | Mittel bis hoch, DB-spezifisches Setup und Administratorrechte | Ressourcen in der Datenbank; erfordert DBA-Kenntnisse | Hoch für konforme, skalierbare Verarbeitung im Warehouse, ⭐⭐⭐⭐ | Regulierte Umgebungen, eigene Wörterbücher pro Tabelle/Schema | Vollständig anpassbar in der DB, keine externen Abhängigkeiten, auditfreundlich |
Branchenspezifische Stoppwortlisten (Finanzwesen, Gesundheitswesen, Telekommunikation) | Hoch, erfordert Fachwissen und laufende Pflege | Mittel, Teams, mögliche Anbieter-/Lizenzkosten | Sehr hohe fachliche Genauigkeit; reduziert False Positives, ⭐⭐⭐⭐⭐ | Anomalieerkennung in regulierten Branchen, Regelvalidierung, KPI-Monitoring | Bewahrt kritische Begriffe, verbessert Erkennungsgenauigkeit und Compliance |
Scikit-learn English Stop Words | Mittel, in ML-Pipelines integriert | Mittel, Python-ML-Stack (TF-IDF, Modelle) | Hoch für ML-Feature-Extraktion und Modellvorbereitung, ⭐⭐⭐⭐ | ML-gestützte Anomalieerkennung, Feature Engineering, TF-IDF-Workflows | Für ML optimiert, reproduzierbar, funktioniert mit scikit-learn-Tools |
Wählen Sie die Liste, die Bedeutung bewahrt
Die beste Wahl der Stoppwortliste hängt von der jeweiligen Aufgabe ab. Nutzen Sie Lucene, wenn fokussierte Suchindexierung Priorität hat. Nutzen Sie NLTK oder spaCy für allgemeines NLP in Python, insbesondere wenn Sie Metadaten, Incident-Texte oder Regelbeschreibungen bereinigen. Nutzen Sie scikit-learn, wenn der Text in ein Modell einfließt und nicht in ein Suchfeld. Nutzen Sie datenbanknative Wörterbücher, wenn die Verarbeitung an Ort und Stelle bleiben muss. Ergänzen Sie branchenspezifische Erweiterungen, wann immer Fachbegriffe ein Signal tragen, das generische Listen löschen würden.
Der Auswahlprozess sollte praxisnah bleiben. Testen Sie Precision, Recall, Suchrelevanz, Modellverhalten und nachgelagerte Datenqualitätsergebnisse, bevor Sie etwas standardisieren. Versionieren Sie anschließend die Liste, prüfen Sie Änderungen und halten Sie fachlich kritische Wörter aus der Stoppwortmenge heraus, sofern Sie nicht nachgewiesen haben, dass sie in Ihren Daten keine Rolle spielen.
Genau diese Disziplin ist der Grund, warum das Management von Stoppwörtern in dieselbe Diskussion gehört wie Observability und Validierung. Wenn ein Wort das Suchranking, die Modellausgabe oder die Interpretation eines Incidents verändert, gehört es in die Governance und nicht in eine Standardliste. Halten Sie die Richtlinie nah bei den Personen, die für die Daten verantwortlich sind, und aktualisieren Sie sie, wenn sich das Geschäftsvokabular ändert.
digna hilft Teams, diese Disziplin in derselben Umgebung beizubehalten, in der die Daten bereits liegen. Die Module für Datenqualität, Schema-Tracking, Timeliness-Monitoring und Anomalieerkennung erleichtern es, Textregeln an echten Betriebsdaten zu testen, statt zu raten. Besuchen Sie digna, wenn Sie Stoppwortentscheidungen mit Monitoring, Validierung und In-Database-Observability auf einer Plattform verbinden möchten.
Wenn Ihre Stoppwortfilterung im Warehouse läuft, wie im Snowflake-Abschnitt oben empfohlen, kann das Datenqualitäts-Monitoring für Snowflake am selben Ort laufen, sodass Textregeln und die von ihnen beschriebenen Tabellen ohne Datenexport geprüft werden.
Häufig gestellte Fragen
Wofür wird eine Stoppwortliste verwendet?
Eine Stoppwortliste legt fest, welche häufigen Wörter eine Suchmaschine oder NLP-Pipeline vor der Indexierung oder Analyse verwirft. Typischer englischer Text besteht zu etwa 30 bis 40 % aus Stoppwörtern, daher kann die gewählte Liste Indexgröße, Verarbeitungsgeschwindigkeit und Modellverhalten erheblich verändern.
Welche Stoppwortliste sollte ich für die Suchindexierung verwenden?
Apache Lucene passt besser, wenn es um Suchindexierung geht. Die englische Liste ist kompakt und auf Information Retrieval abgestimmt, was zu Katalogsuche und Metadaten-Lookups passt. Testen Sie sie zuerst mit echten Abfrageprotokollen, denn das Entfernen der falschen Begriffe kann exakte Phrasensuchen beeinträchtigen.
Was ist der Unterschied zwischen den Stoppwörtern von NLTK, spaCy und scikit-learn?
Jede Bibliothek zielt auf eine andere Aufgabe. NLTK ist eine schnelle Ausgangsbasis für allgemeines NLP in Python, spaCy bietet eine größere Standardmenge und viele Sprachen für grammatikbewusste Pipelines, und die Liste von scikit-learn ist für die Feature-Extraktion wie die TF-IDF-Vektorisierung gedacht, wenn Text in ein Modell statt in ein Suchfeld einfließt.
Sollte ich fachspezifische Wörter wie credit oder patient als Stoppwörter entfernen?
In der Regel nicht. Generische Listen können Begriffe entfernen, die geschäftliche Bedeutung tragen, etwa debit, credit und settlement im Finanzwesen, patient und diagnosis im Gesundheitswesen oder subscriber, churn und ARPU in der Telekommunikation. Wenn ein häufiges Wort die Interpretation einer regulierten Kennzahl verändert, ist es für Sie kein Stoppwort.
Wie passe ich eine Stoppwortliste sicher an?
Beginnen Sie mit einer Standardliste und fügen Sie Begriffe erst hinzu oder entfernen Sie sie, nachdem Sie gefilterten und ungefilterten Text an echten Beispielen getestet haben. Messen Sie Relevanz, Modellqualität und nachgelagerte Ergebnisse, dokumentieren Sie jede individuelle Änderung und versionieren Sie Wörterbücher, etwa in PostgreSQL oder BigQuery, damit Reviews und Rollbacks unkompliziert bleiben.


