Zgodność jakości danych: przewodnik audytowy 2026
|
7
min. czyt.

Niska jakość danych kosztuje organizacje średnio 12,9 mln USD rocznie według benchmarku przywoływanego w badaniach rynku, i to zanim ktokolwiek dojdzie do ustalenia audytowego, zgłoszenia naprawczego czy raportu, któremu nikt nie ufa. W środowiskach regulowanych ten koszt przestaje być problemem efektywności, a staje się problemem kontroli, ponieważ te same słabe rekordy, które spowalniają analityków, osłabiają też dowody regulacyjne, finansowe i audytowe.
Widziałem, jak ten schemat powtarza się w hurtowniach danych i Data Pipelines, które z zewnątrz wyglądały dobrze. Raporty zgadzały się z liczbami z poprzedniego miesiąca, alerty były hałaśliwe, ale znajome, aż przegląd zgodności obnażył sedno problemu: nikt nie potrafił udowodnić, jak dane zostały zwalidowane, prześledzone i obronione. Na tej właśnie luce skupia się ten przewodnik, czyli na zamianie ciągłych kontroli jakości danych w dowody audytowe, które wytrzymają wnikliwą weryfikację.
Spis treści
Dlaczego walidacja oparta na regułach nie wystarcza do nowoczesnej zgodności
Budowanie dowodów gotowych na audyt dzięki ciągłemu monitoringowi
Case study: zastąpienie 9000 ręcznych reguł obserwowalnością opartą na AI
Dlaczego zgodność jakości danych to temat dla zarządu
Słaby system kontroli danych generuje ryzyko na poziomie zarządu na długo przed tym, zanim stanie się ustaleniem audytowym. Szeroko cytowany benchmark szacuje średni koszt niskiej jakości danych na 12,9 mln USD rocznie, a to samo badanie szacuje straty gospodarki USA nawet na 3,1 bln USD rocznie podsumowanie badania rynku. Te liczby mają znaczenie, bo pokazują, jak szybko luki w walidacji zamieniają się w ekspozycję finansową, a nie tylko w porządki dla zespołu danych.
Koszt operacyjny najpierw widać w centrum kontroli. Gdy raporty przychodów opierają się na niespójnych zbiorach danych, gdy zapisy audytowe są niekompletne albo gdy zespoły nie potrafią wyjaśnić, skąd wzięła się dana liczba, problem przestaje dotyczyć narzędzi, a zaczyna dotyczyć odpowiedzialności. To samo źródło wiąże niską jakość danych z negatywnym wpływem na 31% przychodów firmy i podaje, że zespoły danych mogą poświęcać nawet 80% swojego czasu na czyszczenie i przygotowanie danych zamiast na ich analizę podsumowanie badania rynku. To bezpośredni cios zarówno w nadzór, jak i w realizację.
Praktyczna zasada: jeśli zbioru danych nie da się zwalidować, prześledzić i obronić, dashboard jest tylko dekoracją.
Kolejną linią podziału jest pomiar. Jedno z badań branżowych wykazało, że 59% organizacji w ogóle nie mierzy jakości danych podsumowanie badania rynku. W sektorach regulowanych, takich jak usługi finansowe, ochrona zdrowia, telekomunikacja i sektor publiczny, ta luka utrudnia audyty, ponieważ niezmierzonych danych nie da się spójnie obronić, gdy ktoś poprosi o dowody.
Zespołom, które definiują punkt wyjścia, dobrym początkiem będzie tekst o tym, czym w praktyce jest zgodność danych. Właściciele prawni i operacyjni opierają się też na procedurach ładu korporacyjnego i zgodności, ponieważ faktyczną przyczyną porażki rzadko jest jedno błędne pole. Jest nią brak systemu kontroli, który potrafi udowodnić, jak dane zostały sprawdzone, poprawione i zachowane.
Jak niska jakość danych prowadzi do naruszeń zgodności
Naruszenia zgodności rzadko wyglądają jak wyraźna awaria systemu. Zwykle objawiają się niespójnymi raportami, przekroczonym terminem sprawozdawczym albo ścieżką audytu, która nie dowodzi, że liczby zostały sprawdzone. Dlatego tak trudno wychwycić je wcześnie. Zespoły często zauważają problem dopiero wtedy, gdy ktoś zapyta, skąd wzięła się dana liczba, długo po tym, jak pipeline zaczął dryfować.
Presja regulacyjna jest już realna. Przegląd regulacji cyfrowych przypomina, że unijny Data Governance Act obowiązuje od 24 września 2023 r., a firmy, które już 23 czerwca 2022 r. świadczyły usługi pośrednictwa danych, miały czas do 24 września 2025 r. na dostosowanie się do odpowiednich przepisów dotyczących pośredników. Ład danych nie jest już wewnętrzną preferencją. Jest zapisywany w prawie, a słabe kontrole danych stają się ryzykiem prawnym.
Gdzie zwykle zaczynają się problemy
Punkt awarii jest często organizacyjny, a nie techniczny. Kontrola psuje się na styku systemów źródłowych, zespół stosuje niespójne definicje albo ręczną walidację uznaje się za wystarczającą, bo comiesięczny przegląd zwykle przechodzi. W tym samym przeglądzie regulacyjnym jedno z badań wskazuje, że 58% organizacji przyznaje, iż niska jakość danych spowodowała poważne problemy ze zgodnością, a 45% zgłasza słabe lub niespójne ramy ładu danych.
Jakość danych staje się problemem zgodności wtedy, gdy nikt nie potrafi pokazać, że kontrola zadziałała we właściwym czasie, na właściwych danych i z właściwym wynikiem.
Wpływ na biznes przebiega według tego samego schematu. Artykuł o tym, jak niska jakość danych wpływa na biznes, pokazuje, jak słabe dane wychodzą poza analitykę i trafiają do decyzji operacyjnych, gdzie błędy trudniej obronić i trudniej odwrócić. Inne badanie rynku przywołane w tym samym przeglądzie podaje, że 78% dużych przedsiębiorstw doświadczyło poważnych problemów z jakością danych w ciągu ostatnich 12 miesięcy, a 54% twierdzi, że problemy te bezpośrednio wpłynęły na przychody, zgodność regulacyjną lub efektywność operacyjną. Jeśli dane wejściowe są niestabilne, niestabilne są też dowody zgodności.
Od okresowych audytów do ciągłych kontroli zgodności
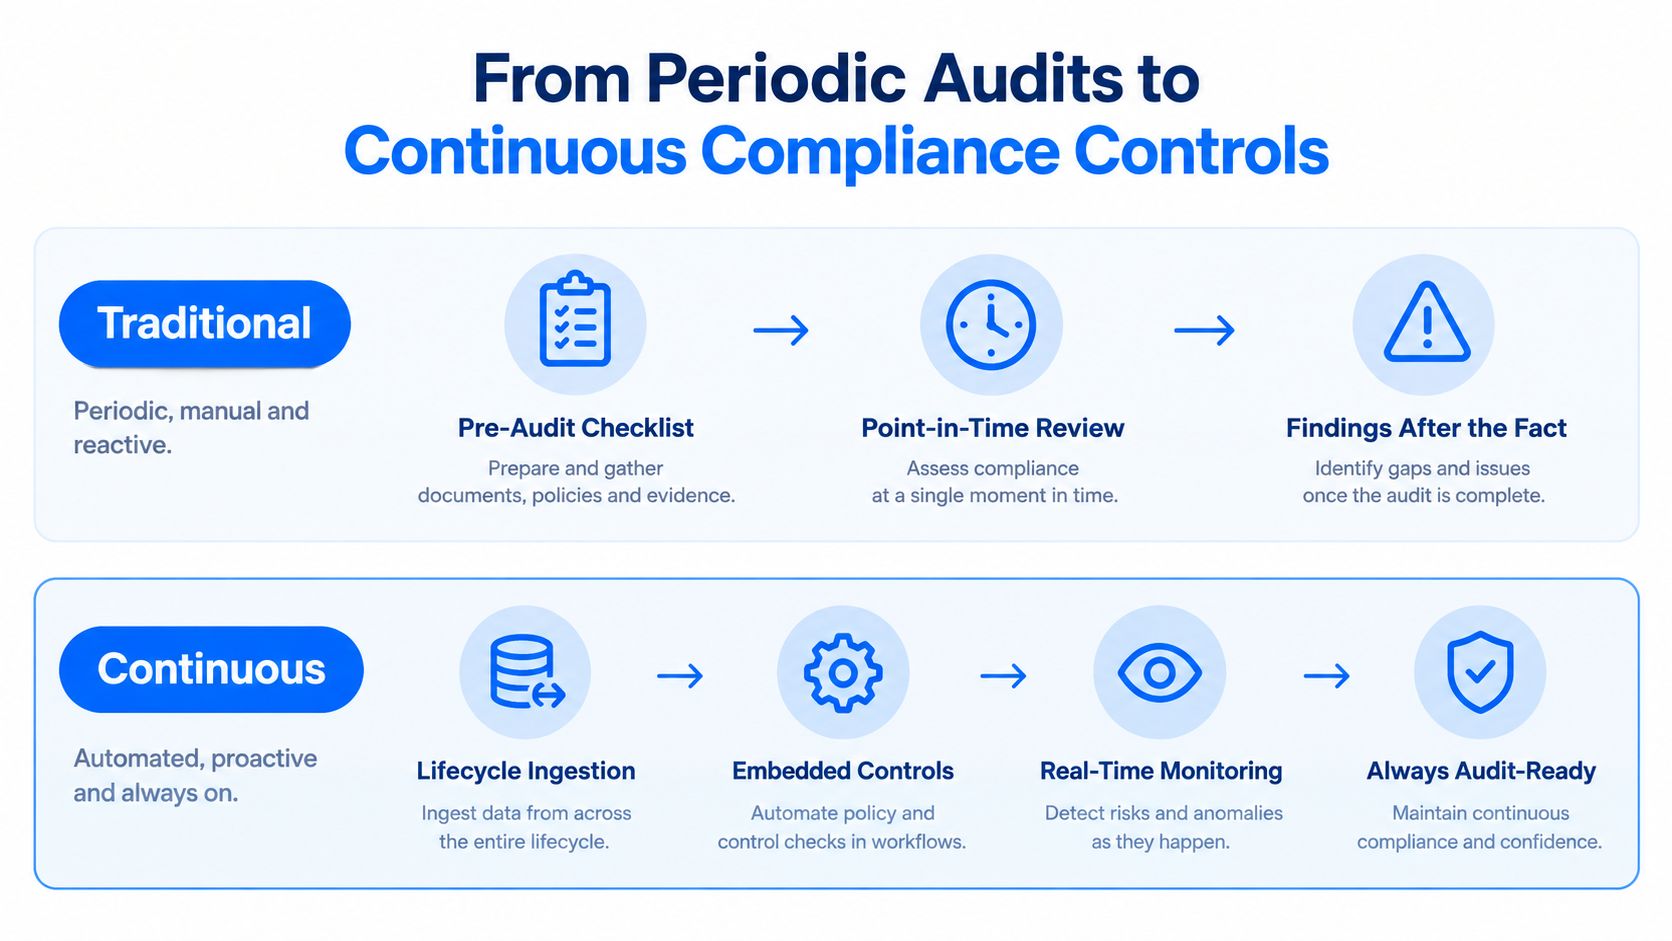
Okresowe audyty wciąż mają znaczenie, ale są zbyt wolne, by stanowić jedyną linię obrony. Zanim audyt wykryje niedziałającą kontrolę, złe dane przejdą już przez ingestion, transformację i raportowanie. Dlatego nowoczesna zgodność jakości danych opiera się na ciągłych kontrolach wbudowanych w cykl życia danych, a nie na przeglądzie raz na kwartał.

Ta zmiana brzmi abstrakcyjnie, dopóki nie odniesiesz jej do pracy, którą Twój zespół już wykonuje. Ciągły monitoring śledzi aktualność, kompletność i zmiany strukturalne w trakcie przepływu danych. Automatyczna walidacja za każdym razem stosuje tę samą logikę, co ma znaczenie, bo audytorów mniej interesuje samo istnienie reguły, a bardziej to, czy była konsekwentnie egzekwowana. Dokumentacja Data Lineage zamyka pętlę, pokazując, skąd dane pochodzą, jak się zmieniały i jakie kontrole je objęły.
Co zmienia się operacyjnie
W modelu okresowym do ładu danych trzeba się przygotowywać. W modelu ciągłym ład danych jest czymś, co platforma wytwarza każdego dnia. Ta różnica zmniejsza lukę między zaprojektowaniem kontroli a jej działaniem, ponieważ dowody powstają w ramach normalnego przetwarzania, a nie są odtwarzane po fakcie.
Praktyczna zasada: jeśli kontrola istnieje tylko podczas przygotowań do audytu, to nie jest kontrola, tylko ściągawka.
Największą zaletą tego modelu jest to, że pasuje do rzeczywistego zachowania regulowanych pipeline'ów. Dane spływają z opóźnieniem, Schematy dryfują, a systemy źródłowe zmieniają się bez większego ostrzeżenia. Gdy kontrole są wbudowane w workflow, zespół widzi te awarie na tyle wcześnie, by je naprawić, zanim staną się błędami w raportach.
Jednym z przydatnych wzorców wdrożeniowych jest automatyczne kierowanie wyników tych kontroli do raportowania zgodności i właśnie tu operacyjnie istotna staje się automatyzacja raportowania zgodności. Eliminuje ona ręczne kompletowanie materiałów, które zwykle spowalnia odpowiedź na audyt.
Mapowanie wymiarów jakości danych na standardy regulacyjne
Ramy zgodności i zespoły data engineering często używają różnych słowników do opisu tego samego problemu. Regulator pyta, czy rekord nadaje się do użycia, a inżynier pyta, czy kolumna przeszła walidację. Ta luka znika, gdy zmapujesz wymiary jakości na uznane standardy, zamiast traktować je jako osobne rozmowy.
Kanadyjskie Data Quality Guidance definiuje dziewięć wymiarów: dostępność, dokładność, spójność, kompletność, zgodność, interpretowalność, adekwatność, wiarygodność i aktualność wytyczne rządu Kanady. Australijskie Archiwa Narodowe wskazują ISO 8000-110:2021 jako globalny standard jakości danych i danych podstawowych przedsiębiorstwa oraz wymieniają typowe wymiary, takie jak dokładność, kompletność, spójność, integralność, aktualność, unikalność/deduplikacja i poprawność wytyczne Australijskich Archiwów Narodowych.
Z czym audytorzy faktycznie mogą pracować
Te ramy mają znaczenie, bo dają zespołom język, który bezpośrednio przekłada się na kontrole. Jeśli polityka wymaga, by dane klientów były dokładne i aktualne, zespół techniczny może przełożyć to na reguły walidacji, kontrole opóźnień i logikę uzgadniania. Jeśli polityka wymaga wiarygodnych danych, dowody powinny pokazywać, jak i kiedy zostały one przetestowane.
Data Governance Primer amerykańskiej Administration for Community Living stwierdza, że dane przedsiębiorstwa powinny być okresowo testowane względem zdefiniowanych standardów jakości, i wymienia dostęp do danych, definicje danych, polityki prywatności, standardy bezpieczeństwa i standardy jakości danych jako obszary ładu danych przewodnik ACL. Rząd Nowej Południowej Walii dodaje przydatny szczegół operacyjny: zarządzanie jakością danych to ciągły proces obejmujący cały cykl życia danych, a instytucje powinny definiować wymagania powiązane z potrzebami biznesowymi, w tym standardy dostępności, metryki i cele moduł jakości danych NSW.
Takie połączenie tworzy praktyczny model. Standardy definiują wymiary, ład danych definiuje odpowiedzialność, a operacje definiują sposób wytwarzania dowodów.
Zespołom, które przekładają te kategorie na działającą mapę kontroli, przyda się tekst o wymiarach jakości danych. Najłatwiej audytować to, co potrafisz jasno nazwać.
Dlaczego walidacja oparta na regułach nie wystarcza do nowoczesnej zgodności
Walidacja oparta na regułach wciąż ma swoje miejsce, ale szybko zawodzi, gdy pipeline'y stają się większe, szybsze i bardziej od siebie zależne. Zakodowane na sztywno kontrole działają, gdy model danych jest stabilny, a wyjątki rzadkie. Nie sprawdzają się, gdy zmienia się Schema, ewoluują systemy źródłowe albo tę samą regułę trzeba utrzymywać w kilku różnych miejscach.
Prawdziwym problemem jest utrzymanie
Reguła może powiedzieć, że coś się nie powiodło. Nie powie jednak, czy błąd ma znaczenie w danym kontekście, czy zmienił się kształt danych ani czy to samo zachowanie jest normalne dla jednego źródła, a podejrzane dla innego. Dlatego zespoły kończą ze zmęczeniem alertami, kruchymi skryptami SQL i kontrolami, które oddalają się od rzeczywistości. Koszt operacyjny to nie tylko narzut w czasie wykonania, ale też utrata wiedzy, gdy odchodzi inżynier, a razem z nim logika reguł.
Luka w zgodności wykracza poza dokładność, kompletność i aktualność. Najnowsze zmiany regulacyjne wymagają dowodów, a nie tylko reguł. Oznacza to wykazywalny Data Lineage, identyfikowalność, udokumentowane źródła danych treningowych i mierzalne metryki jakości. Wymagania unijnego AI Act dla systemów wysokiego ryzyka kładą nacisk na dokumentowanie źródeł, transformacji i wykorzystania danych treningowych, a ramy ETSI z 2026 r. formalizują 18 metryk jakości danych, w tym użyteczność, lineage, identyfikowalność i aktualność przegląd regulacji i standardów.
Statyczny zestaw reguł może udowodnić, że dany warunek został sprawdzony. Nie udowodni jednak, że całe środowisko kontroli pozostało wiarygodne.
Tu właśnie liczy się obserwowalność. Ciągły monitoring wychwytuje dryf, śledzi zmiany kontekstu i zachowuje zapis operacyjny, którego potrzebują audytorzy. Pomaga też zespołom uniknąć częstej pułapki, czyli traktowania zgodności jak checklisty zamiast żywego systemu kontroli.
Dla hurtowni danych, które wciąż opierają się na ręcznie budowanych walidacjach, bezpośrednie porównanie znajdziesz w tekście o ręcznie definiowanych technicznych regułach jakości danych. W praktyce pytanie nie brzmi, czy reguły powinny istnieć. Brzmi ono, czy same wystarczą. Zwykle nie wystarczają.
Budowanie dowodów gotowych na audyt dzięki ciągłemu monitoringowi
Różnica między zdanym a oblanym audytem często sprowadza się do dowodu. Jeśli kontrola walidacyjna się odbyła, ale nie ma trwałego zapisu zbioru danych, ustawień reguły, znacznika czasu i wyniku, kontrolę trudno obronić. Dlatego traktuję dowody gotowe na audyt jako pełnoprawny cel projektowy, a nie efekt uboczny.
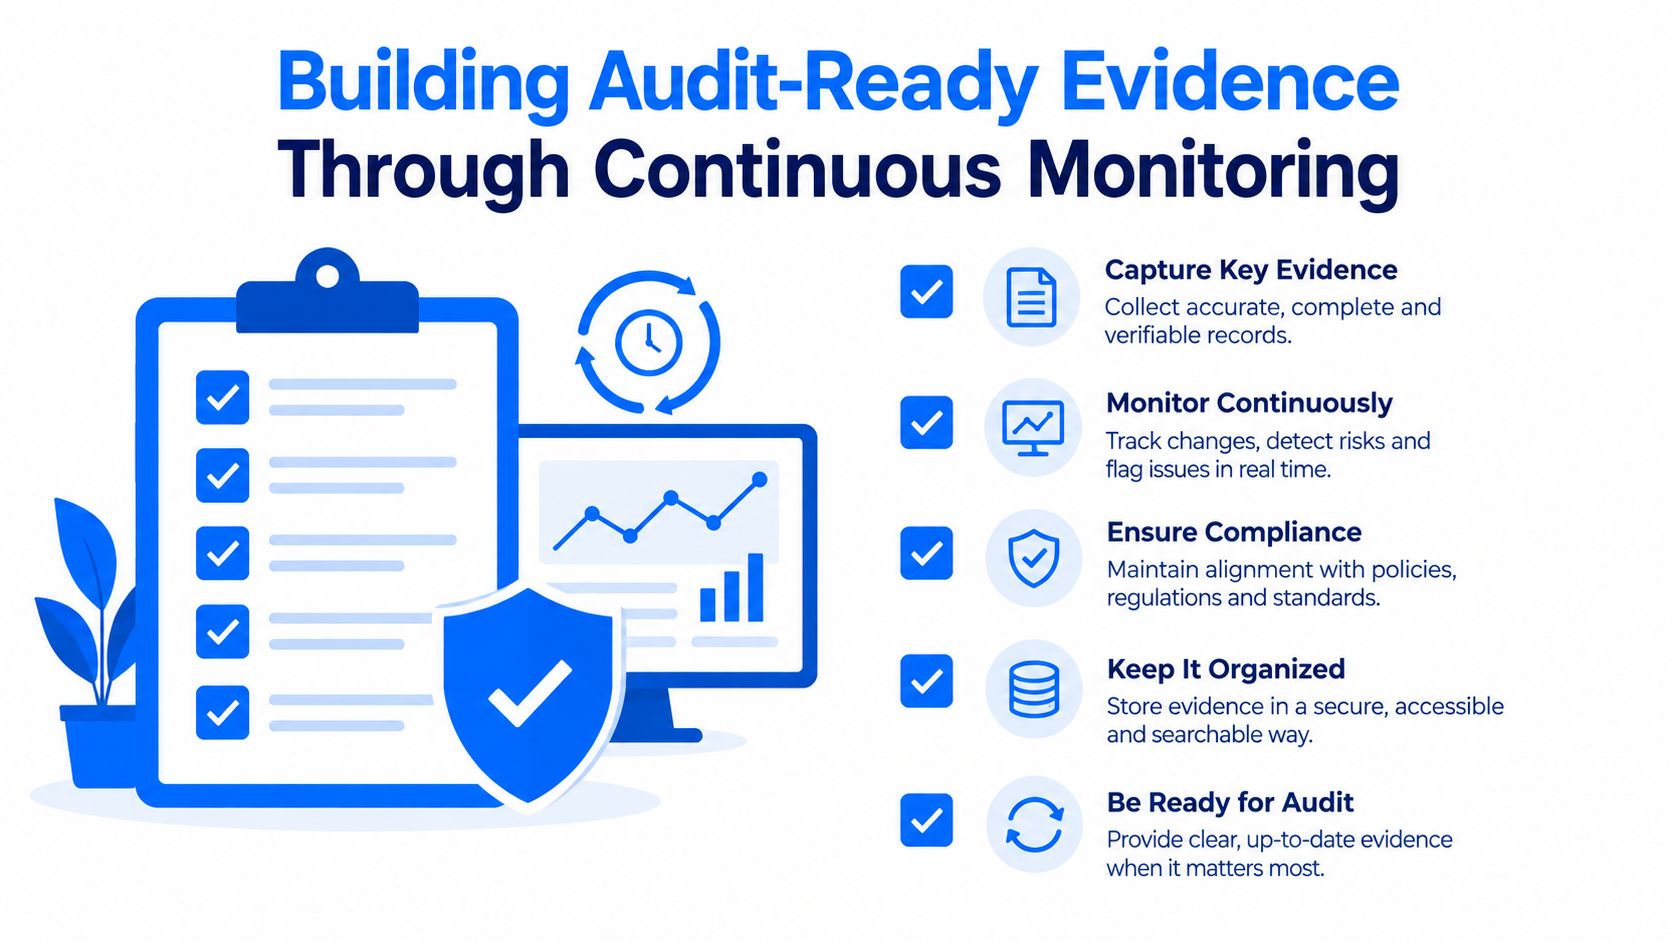
Praktyczny wzorzec jest prosty. Rejestruj każde zdarzenie walidacji w sposób niezmienny, a log rób na tyle szczegółowy, by odpowiadał na pytania, które audytorzy faktycznie zadają. Oznacza to identyfikator zbioru danych, identyfikator kolumny, parametry reguły, znaczniki czasu, wynik pozytywny/negatywny, liczbę błędów i historię rozwiązania wytyczne dotyczące ścieżki audytu. Gdy taki zapis istnieje, zespoły mogą odtworzyć, co zostało sprawdzone, kiedy kontrola się wykonała i jak zachowywała się przed zmianą reguł i po niej.
Co dają takie dowody
Skracają dochodzenia, gdy dryf Schematu lub spóźnione dane wpływają na raportowanie na dalszych etapach. Zachowują też historyczne progi, co ma znaczenie, gdy reguła się zmienia, a zespół audytowy wciąż musi wiedzieć, co działo się przy poprzednim ustawieniu. W regulowanych pipeline'ach to różnica między „wydaje nam się, że było dobrze” a „oto dokładny stan kontroli w tamtym momencie”.
Korzyść techniczna jest równie ważna. Gdy wyniki walidacji są rejestrowane konsekwentnie, zespoły mogą mierzyć jakość w momencie walidacji, a nie dopiero wtedy, gdy dane już się przemieściły. Analiza przyczyn źródłowych staje się dzięki temu znacznie szybsza, bo dowody wskazują na konkretne zdarzenie kontrolne, a nie na mglisty objaw w pipeline.
Towarzyszący temu workflow nie musi spowalniać dostarczania. Dobrze zaprojektowany działa wewnątrz pipeline'u, przechowuje zapis kontroli razem ze zdarzeniem i eksportuje go na żądanie, gdy potrzebuje go dział compliance. Ufam temu modelowi, bo wytrzymuje zarówno presję operacyjną, jak i przegląd audytowy.
Dla zespołów, które chcą zobaczyć, jak to wygląda w praktyce, dostępne jest też wideo z demonstracją.
Case study: zastąpienie 9000 ręcznych reguł obserwowalnością opartą na AI
ITSV, informatyczny filar austriackiego systemu ubezpieczeń społecznych, to dobry przykład, bo skala wymusiła tam prawdziwą decyzję. Zespół zarządzał jakością danych za pomocą 9000 ręcznie napisanych reguł w swojej hurtowni danych, a ten model przestał przystawać do wolumenu i nakładu pracy na utrzymanie. Środowisko przetwarzało 50 GB dziennie z ponad 30 źródeł w ponad 500 strukturach, co sprawiało, że ciągłe strojenie reguł było nie do utrzymania szczegóły case study.
Stary system miał typowe objawy. Wiedza ginęła, gdy ludzie odchodzili, dokumentacja nie nadążała za regułami, a żaden zespół tak naprawdę nie odpowiadał za framework od początku do końca. Ponad 140 alertów dziennie zapełniało skrzynki, większość ignorowano, bo ich znaczenie było niejasne, a pokrytych było tylko 25% istotnych przypadków jakości danych szczegóły case study.
Co się zmieniło po przeniesieniu kontroli
Już we wrześniu 2021 r. ITSV zaczęło zastępować framework oparty na regułach rozwiązaniami digna Data Anomalies i digna Data Timeliness. Analiza pozostała we własnej infrastrukturze ITSV, co odpowiadało wymaganiom dotyczącym prywatności, a zespół nie musiał ręcznie stroić progów ani utrzymywać reguł. Data Timeliness nauczył się wzorców napływu danych i sygnalizował dane spóźnione lub brakujące, a Data Anomalies nauczył się normalnego zachowania całej hurtowni i sygnalizował odchylenia szczegóły case study.
To ważne, bo ten przypadek tak naprawdę nie dotyczy wymiany narzędzia. Chodzi o zastąpienie kruchej pracy utrzymaniowej obserwowalnością, która wytwarza dowody. Kontrole stały się łatwiejsze do obrony, ponieważ były zarówno ciągłe, jak i identyfikowalne, a zespół odzyskał czas, który wcześniej tracił na przesiewanie szumu.
Widziałem, jak podobne migracje się udają z jednego powodu: przenoszą odpowiedzialność z ludzkiej pamięci na zachowanie systemu. Kontrole nie zależą od tego, czy ktoś pamięta, którą regułę trzeba było zaktualizować w poprzednim kwartale. Same się wykonują, logują i eskalują.
Wdrażanie zgodności jakości danych w pracy wielu zespołów
Nawet solidna obserwowalność nie naprawi luki w ładzie danych. Najtrudniejszą częścią zgodności jakości danych jest często kwestia odpowiedzialności, bo awarie zwykle występują między zespołami, a nie wewnątrz jednego systemu. Najnowsze dane z badań pokazują, że 44% respondentów deklaruje odpowiedzialność współdzieloną przez kilka zespołów, 61% wciąż polega na ręcznych kontrolach lub walidacji w SQL, a tylko 14% egzekwuje SLA w całej organizacji, mimo że 39% monitoruje SLA dla kluczowych pipeline'ów raport z badania.
To pokazuje, gdzie leży praca do wykonania. Problemem nie jest to, że zespołom nie zależy na jakości. Chodzi o to, że rozdzieliły odpowiedzialność, nie rozdzielając egzekwowania. Jeśli nikt nie odpowiada za kontrolę od początku do końca, alerty są obsługiwane nieformalnie, incydenty trafiają tam, gdzie zawsze, a dowody audytowe są zbierane za późno.
Praktyczny model operacyjny
Zacznij od wskazania konkretnego właściciela dla każdego krytycznego zbioru danych, a następnie określ, co jest mierzone, jak często jest sprawdzane i dokąd trafiają incydenty, gdy kontrola zawiedzie. Zadbaj o niezmienność logów, utrzymuj lineage powiązany z rekordem i upewnij się, że ścieżka eskalacji jest jednoznaczna. Jeśli awarii kontroli nie da się skierować do konkretnej osoby, kontrola nie jest jeszcze operacyjna.
Drugim wymogiem jest spójność między zespołami. Inżynieria, analityka i ład danych muszą używać tych samych definicji aktualności, kompletności i zmian Schematu. Jeśli jedna grupa raportuje metrykę, a druga waliduje inną interpretację tego samego pola, ścieżka audytu będzie wyglądać spójnie tylko do momentu, gdy ktoś zacznie zadawać pytania.
Praktyczna zasada: zgodność staje się ciągła dopiero wtedy, gdy odpowiedzialność, monitoring i eskalacja są na tyle zautomatyzowane, by przetrwać pracowity tydzień.
Jedną z opcji dla zespołów budujących taki model operacyjny jest digna, która monitoruje zachowanie danych we własnym środowisku klienta i wspiera walidację, monitorowanie terminowości danych, śledzenie Schematów oraz dowody gotowe na audyt. Jeśli Twoim celem jest uczynienie kontroli łatwiejszymi do obrony bez zamieniania zespołu w fabrykę ręcznych reguł, warto sprawdzić, jak platforma wpasowuje się w Twoją hurtownię danych i pipeline'y.
Jeśli chcesz zobaczyć, jak działa podejście oparte na wyuczonej linii bazowej z przypadku ITSV, bez pisania i strojenia progów, digna Data Anomalies pokazuje, jak modeluje ono normalne zachowanie w każdej tabeli i automatycznie sygnalizuje odchylenia.
Najczęściej zadawane pytania
Czym jest zgodność jakości danych?
Zgodność jakości danych oznacza możliwość udowodnienia, że dane regulowane zostały zwalidowane, prześledzone i obronione, a nie tylko sprawdzone. Artykuł dowodzi, że kontrola liczy się tylko wtedy, gdy dowody pokazują, że zadziałała we właściwym czasie, na właściwych danych i z właściwym wynikiem, zamiast być odtwarzana podczas przygotowań do audytu.
Dlaczego kontrole jakości danych oparte na regułach nie wystarczają do zapewnienia zgodności?
Zakodowane na sztywno reguły dowodzą, że dany warunek został sprawdzony, ale nie pokazują, że szersze środowisko kontroli pozostało wiarygodne. Psują się, gdy Schematy dryfują, a źródła się zmieniają, wywołują zmęczenie alertami i tracą wiedzę, gdy odchodzą inżynierowie. Regulacje takie jak unijny AI Act i 18 metryk jakości danych ETSI wymagają dziś także lineage i identyfikowalności.
Co powinna zawierać ścieżka audytu dla walidacji danych?
Każde zdarzenie walidacji powinno być rejestrowane w sposób niezmienny wraz z identyfikatorem zbioru danych, identyfikatorem kolumny, parametrami reguły, znacznikiem czasu, wynikiem pozytywnym lub negatywnym, liczbą błędów i historią rozwiązania. Dzięki takiemu zapisowi zespoły mogą dokładnie odtworzyć, co zostało uruchomione i jak kontrola zachowywała się przed zmianą progu lub reguły i po niej.
Które wymiary jakości danych odpowiadają standardom regulacyjnym?
Kanadyjskie Data Quality Guidance wymienia dziewięć wymiarów, w tym dokładność, kompletność, spójność, wiarygodność i aktualność. Norma ISO 8000-110:2021, przywoływana przez Australijskie Archiwa Narodowe, dodaje integralność, unikalność i poprawność. Zmapowanie ich na reguły walidacji, kontrole opóźnień i logikę uzgadniania daje audytorom i inżynierom wspólny słownik.
Jak ITSV zastąpiło 9000 ręcznych reguł jakości danych?
Od września 2021 r. ITSV zastępowało swój framework ręcznie napisanych reguł rozwiązaniami digna Data Anomalies i Data Timeliness, działającymi we własnej infrastrukturze. Hurtownia przyjmuje 50 GB dziennie z ponad 30 źródeł, a stary system generował ponad 140 alertów dziennie, pokrywając jedynie 25% istotnych przypadków.


