Czym jest baza danych in-memory? Kluczowe kompromisy
|
7
min. czyt.

Baza danych in-memory nie eliminuje dysku. Wykorzystuje RAM jako główną warstwę roboczą, a trwały storage jako podstawę odtwarzania, dlatego pozornie ulotna architektura może obsługiwać trwałe obciążenia produkcyjne. Argument wydajnościowy jest równie prosty: komentatorzy branżowi opisują dostęp do pamięci jako mniej więcej 10 razy szybszy niż dostęp do dysku, a współczesne źródła techniczne wiążą systemy in-memory z opóźnieniem odczytu rzędu mikrosekund i opóźnieniem zapisu rzędu pojedynczych milisekund (Mordor Intelligence opisuje tę historyczną zmianę, AWS przedstawia obecne działanie systemów in-memory).
To odpowiada na pytanie, które kryje się za pytaniem: czym jest baza danych in-memory? To baza danych zaprojektowana tak, by przechowywać aktywne dane w pamięci operacyjnej, przetwarzać je właśnie tam i korzystać z logów, snapshotów, save pointów lub innych mechanizmów persystencji, aby odzyskać sprawność po awarii. Szybkość jest realna, ale realne są też koszty, ograniczenia pojemności, decyzje operacyjne i odpowiedzialność za trwałość danych.
Spis treści
Paradoks szybkości - dane w pamięci, a jednak bezpieczne na dysku
Rozwiązanie zagadki trwałości - persystencja bez kar wydajnościowych
Zastosowania w przedsiębiorstwach, w których szybkość ma największe znaczenie
Paradoks szybkości - dane w pamięci, a jednak bezpieczne na dysku
Powszechny model myślowy jest błędny: „in-memory” nie oznacza „nigdzie indziej nie zapisane”. System produkcyjny trzyma często używane dane w RAM, ponieważ CPU sięga po nie bez czekania na odwołanie do tradycyjnego storage, a trwały storage przechowuje informacje potrzebne po awarii lub zaniku zasilania. SAP opisuje RAM jako główne miejsce przetwarzania w bazie in-memory, jednocześnie wymagając dysku lub SSD do trwałej persystencji (SAP wyjaśnia tę podstawową różnicę).
Dlaczego inżynierowie akceptują wyższy koszt RAM
Weźmy serwis transakcyjny, który musi wielokrotnie sprawdzać aktywne konta, ostatnie zdarzenia lub bieżące stany magazynowe. Architektura zorientowana na dysk nieustannie płaci za I/O storage. Architektura zorientowana na pamięć płaci więcej za RAM i za mechanizmy, które utrzymują tę pamięć wypełnioną danymi, ale skraca drogę między żądaniem a danymi potrzebnymi do odpowiedzi.
Architektura ta stała się opłacalna komercyjnie w latach 80. i na początku lat 90., gdy tańsza pamięć RAM i rozszerzona 64-bitowa przestrzeń adresowa umożliwiły obsługę większych working setów. Wersja in-memory IBM DB2 pojawiła się na początku lat 90., a w 2014 roku ankieta DBTA przytoczona w historii rynku opracowanej przez Mordor Intelligence wykazała wykorzystanie technologii in-memory w około 32% przedsiębiorstw, a 75% respondentów spodziewało się jej rozszerzenia w ciągu kolejnych 3 lat.
Praktyczna zasada: traktuj RAM jako szybką powierzchnię roboczą, a nie trwały zapis.
To rozróżnienie rozwiązuje zagadkę zaniku zasilania. Gdy serwer traci zasilanie, baza danych nie zakłada, że zawartość RAM przetrwa. Odtwarza swój stan z trwałych zapisów, a następnie ponownie wypełnia pamięć. Dokładny mechanizm odtwarzania różni się w zależności od produktu, ale w systemie obsługującym transakcje trwałość nie jest opcjonalną funkcją.
Kompromis pozostaje istotny. RAM kosztuje więcej niż trwały storage, a trzymanie wszystkiego w pamięci bywa marnotrawstwem, gdy natychmiastowego dostępu wymaga tylko część danych. Dlatego nowoczesne systemy łączą wykonywanie w pamięci z warstwami storage: gorące dane zostają w RAM, a chłodniejsze w razie potrzeby trafiają na dyski NVMe SSD (AWS opisuje to podejście warstwowe).
Jak działają bazy danych in-memory od środka
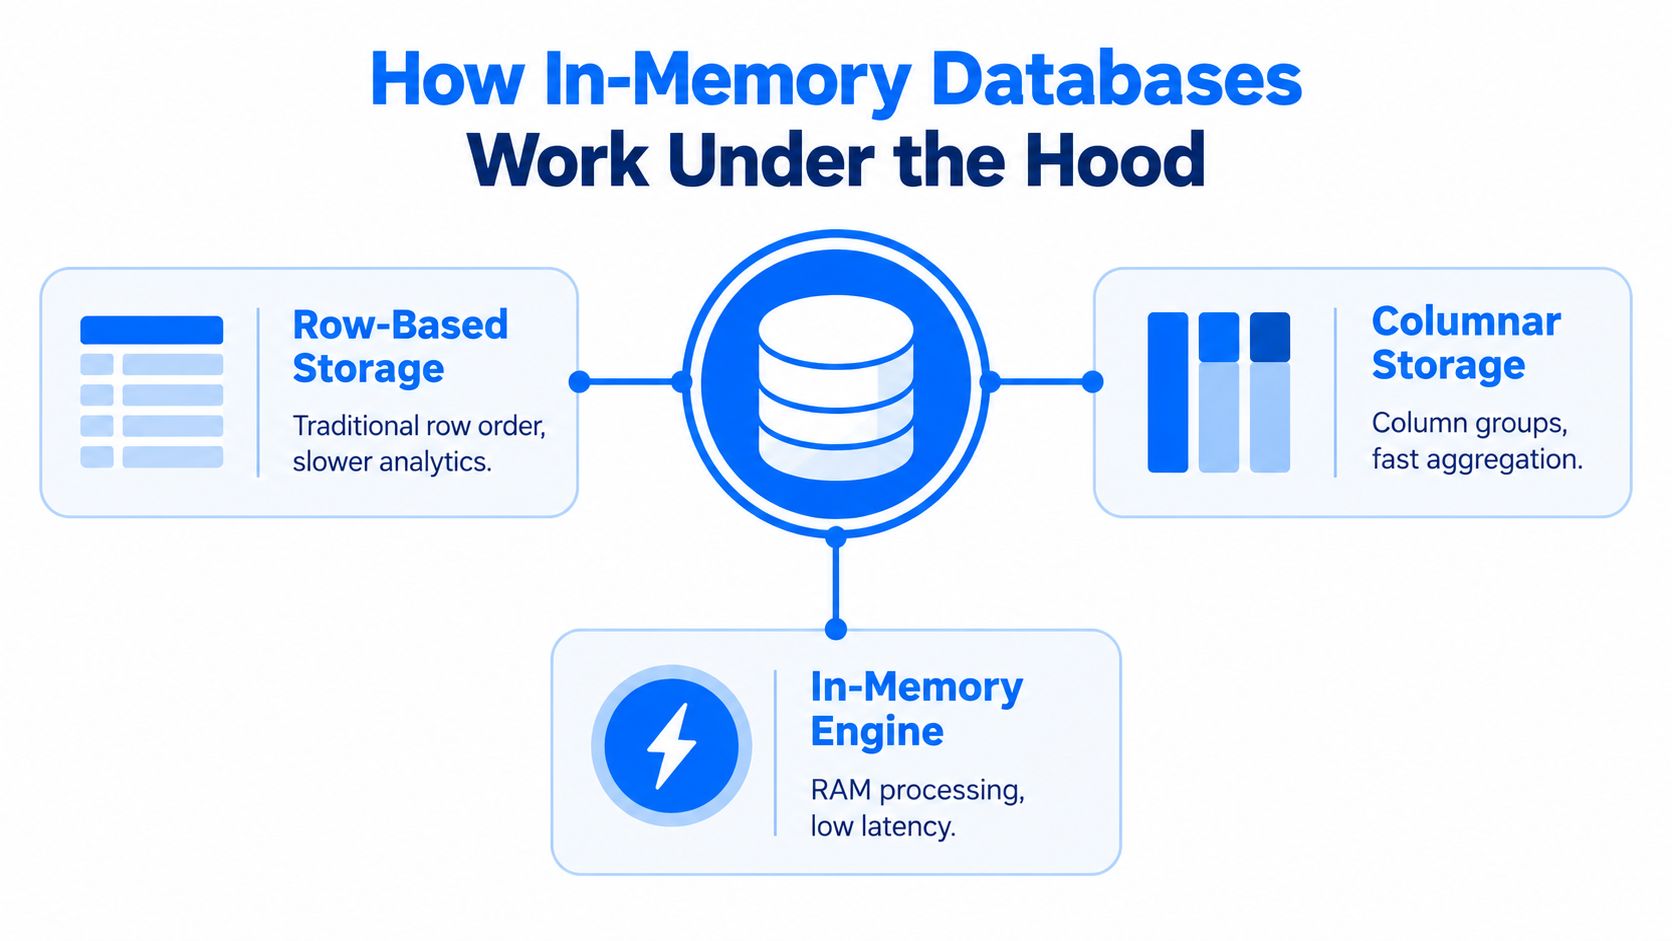
Baza danych in-memory zmienia coś więcej niż tylko miejsce przechowywania danych. Zmienia to, pod kątem czego silnik jest optymalizowany. System dyskowy jest projektowany tak, by minimalizować odczyty ze storage, zarządzać stronami i efektywnie wykorzystywać buffer pool. Silnik in-memory może przeznaczyć większą część swojej konstrukcji na wydajność CPU, przepustowość pamięci, kompresję, równoległe wykonywanie i szybkie ścieżki dostępu.
Pierwszą decyzją architektoniczną jest układ danych. Storage wierszowy trzyma pola rekordu razem, co pasuje do wielu operacji transakcyjnych odczytujących lub aktualizujących całe rekordy. Storage kolumnowy grupuje wartości według kolumn, więc zapytanie analityczne potrzebujące jednej miary i kilku filtrów nie musi przetwarzać każdego pola w każdym wierszu. SAP wskazuje organizację kolumnową i dystrybucję na wiele serwerów jako ważne możliwości systemów in-memory (przegląd HANA od SAP).
Kompresja i dystrybucja
Kompresja ma znaczenie, ponieważ RAM jest cenny. Powtarzające się wartości, uporządkowane kolumny i zwarte kodowania pozwalają silnikowi trzymać w pamięci więcej aktywnych informacji i zmniejszają ilość danych, które CPU musi przenosić. Kompresja nie jest jednak darmowa. Silnik zużywa czas CPU na kodowanie i dekodowanie wartości, więc sensowne pytanie nie brzmi, czy kompresja istnieje, lecz czy jej koszt CPU jest niższy niż koszt pamięci i I/O, którego pozwala uniknąć.
Dystrybucja odpowiada na inne ograniczenie. Pojedynczy serwer ma skończoną pamięć i moc obliczeniową, dlatego systemy mogą partycjonować dane i przetwarzanie na wiele maszyn. To wprowadza koordynację, ruch sieciowy, decyzje dotyczące replikacji i domeny awarii. Skalowanie horyzontalne może poszerzyć working set, ale nie sprawia, że operacje rozproszone są bezkosztowe.
Relacja między pamięcią a dyskiem powinna pozostać w projekcie jawna. RAM obsługuje aktywne przetwarzanie, a trwały storage wspiera odtwarzanie i przechowuje chłodniejsze dane. Niektóre platformy stosują tiering, dzięki czemu aplikacje nie muszą ręcznie zarządzać każdym przeniesieniem danych. Inne trzymają w pamięci mniejszy, świadomie wybrany working set, a źródło prawdy pozostawiają w konwencjonalnej bazie danych.
Zespołom, które zastanawiają się, gdzie powinny odbywać się obliczenia, przydatnym punktem odniesienia architektonicznego jest przetwarzanie in-database. Wykonywanie obliczeń blisko danych może ograniczyć ich przenoszenie, ale baza danych nadal potrzebuje wystarczającego zapasu pamięci, CPU i współbieżności, by obsłużyć zarówno zapytania operacyjne, jak i pracę analityczną.
In-memory a tradycyjny storage - wydajność w praktyce
Bazy danych in-memory są szybsze, ponieważ usuwają I/O storage z najbardziej obciążonej ścieżki, a nie dlatego, że zmieniają sam SQL. Silnik nadal parsuje zapytania, ewaluuje predykaty, utrzymuje indeksy lub inne struktury, koordynuje workery i obsługuje rywalizację o zasoby. Obciążenie ograniczone przez CPU lub słaby model danych mogą zniweczyć korzyść z trzymania danych w RAM.
Źródła techniczne często opisują bazy danych in-memory jako oferujące odczyty rzędu mikrosekund i zapisy rzędu pojedynczych milisekund. Rzeczywiste opóźnienia zależą od silnika, sprzętu, konfiguracji trwałości, kształtu zapytań i współbieżności (AWS dokumentuje te charakterystyki opóźnień). Taki profil pasuje do decyzji, które trzeba podjąć, póki zdarzenie jest jeszcze aktualne.
Wydajność baz in-memory i baz dyskowych
Metryka | Baza danych in-memory | Baza danych dyskowa |
|---|---|---|
Opóźnienie odczytu | Unika większości odwołań do storage, ale cache missy, blokady, serializacja i przeskoki sieciowe nadal wpływają na opóźnienia w ogonie rozkładu | Dostęp do storage, chybienia w buffer cache, indeksy i głębokość kolejki dodają bardziej zmienne opóźnienia |
Opóźnienie zapisu |
| Opóźnienie zależy od sprzętu storage, logowania, checkpointów, indeksów i rywalizacji o zasoby |
Profil przepustowości | Bardzo dobre dopasowanie do częstych odczytów o niskim opóźnieniu i aktywnego przetwarzania transakcji | Bardzo dobre dopasowanie do storage zorientowanego na pojemność, danych archiwalnych i obciążeń batchowych |
Koszt sprzętu | Wyższy koszt pamięci, z możliwymi wymaganiami dotyczącymi replikacji i persystencji | Niższy koszt pojemności na jednostkę przechowywanych danych, przy większej zależności od infrastruktury storage |
Najlepsze zastosowanie operacyjne | Dashboardy na żywo, serwisy decyzyjne, sesje i szybko zmieniające się working sety | Zimne dane, długa retencja, duże repozytoria historyczne i przetwarzanie batchowe bez presji czasu |
Tabela wspiera decyzje architektoniczne, a nie porównywanie produktów po etykietach. Baza dyskowa może przewyższyć system in-memory, gdy zapytanie jest lepiej zaprojektowane, a system in-memory może rozczarować, jeśli jego working set wylewa się na wolniejsze warstwy. Mierz wzorzec dostępu i zachowanie trwałości łącznie.
Szybkość ma znaczenie tylko wtedy, gdy aplikacja potrafi wykorzystać krótszy czas odpowiedzi.
Oceń opóźnienia p95 i p99, wymagania dotyczące trwałości zapisów, wykorzystanie pamięci, zachowanie eviction lub tieringu, opóźnienie replikacji oraz czas odtwarzania. Tuning wydajności bazy danych ma tu znaczenie, ponieważ kształt zapytań i zachowanie obciążenia mogą zniweczyć korzyść z szybszego storage, gdy wzorce wykonania nie są mierzone.
Rozwiązanie zagadki trwałości - persystencja bez kar wydajnościowych
In-memory nie oznacza braku storage. RAM zapewnia stan roboczy o niskim opóźnieniu, ale produkcyjna baza danych nadal potrzebuje trwałych zapisów do restartu, failoveru i odtwarzania po katastrofie. Przegląd Springer omawia trwałość i benchmarking IMDB, traktując persystencję jako część projektu bazy in-memory, a nie opcjonalne zabezpieczenie.
Logi, snapshoty i save pointy
Log transakcji zapisuje zmiany w trwałej sekwencji. Po restarcie silnik wczytuje zapisany stan bazowy i odtwarza odpowiednie wpisy logu. Zatwierdzona praca przetrwa, a aktywne przetwarzanie kontynuuje na danych rezydujących w pamięci.
Save pointy i snapshoty wyznaczają granice odtwarzania. W określonych odstępach silnik zapisuje spójną reprezentację stanu roboczego w trwałym storage. Po awarii baza danych musi przywrócić tę reprezentację i zastosować późniejsze wpisy logu. Częstsza persystencja może skrócić okno narażenia przy odtwarzaniu, ale zużywa przepustowość storage i może konkurować z bieżącymi zapytaniami i zapisami.
Projekt zwykle łączy cztery mechanizmy:
Logowanie transakcji: zapisuje zmiany na potrzeby odtwarzania i trwale zachowuje zatwierdzone transakcje.
Save pointy: utrwalają stan możliwy do odtworzenia bez przepisywania całego zbioru danych przy każdej operacji.
Snapshoty: tworzą trwałą reprezentację z określonego momentu, która może przyspieszyć restart i odtwarzanie.
Asynchroniczne kopie zapasowe: wykonują backup w tle, zgodnie z gwarancjami odtwarzania danej bazy danych.
SAP podkreśla, że dysk lub SSD pozostaje niezbędny do trwałej persystencji po zaniku zasilania lub katastrofie, nawet gdy dane są dostępne w pamięci (wytyczne SAP dotyczące persystencji). SAP HANA ilustruje ten sam projekt: przetwarzanie zgodne z ACID, skompresowane dane kolumnowe w pamięci oraz zatwierdzone transakcje utrwalane przez logowanie i save pointy, dzięki czemu system może się odtworzyć po restarcie (materiały SAP o administracji HANA).
Test odtwarzania: nie poprzestawaj na stwierdzeniu „baza danych ma persystencję”. Przywróć uszkodzony węzeł, odtwórz logi i zweryfikuj zatwierdzone transakcje, jak opisujemy w naszym przewodniku po database reliability engineering, a następnie zmierz zachowanie aplikacji podczas odtwarzania.
Ustawienia trwałości odsłaniają bezpośredni kompromis. Agresywna persystencja chroni więcej niedawnych zapisów, ale zwiększa obciążenie storage i pracę koordynacyjną. Łagodniejsze ustawienia mogą poprawić przepustowość zapisu, pozostawiając więcej pracy przy odtwarzaniu. Dobierz konfigurację do biznesowych skutków utraty ostatnich danych, celu odtwarzania i pojemności storage dostępnej dla danego obciążenia.
Zastosowania w przedsiębiorstwach, w których szybkość ma największe znaczenie
Baza danych in-memory zwraca swój koszt wtedy, gdy opóźniona odpowiedź zmienia wynik. Najlepsi kandydaci generują dane w sposób ciągły, oceniają je natychmiast i nie mogą czekać na załadowanie do hurtowni danych ani na długi cykl batchowy. Właściwe pytanie dotyczy nie tylko szybkości zapytania, ale też tego, co aplikacja musi zrobić, gdy węzeł się zrestartuje.
Dobrym przykładem są usługi finansowe. Przychodzi transakcja, a serwis antyfraudowy potrzebuje bieżącego zachowania konta, kontekstu transakcji i sygnałów ryzyka, zanim ją zatwierdzi lub zakwestionuje. Trzymanie tych aktywnych sygnałów w RAM skraca drogę od przyjęcia zdarzenia do decyzji. Obciążenie nadal potrzebuje zdefiniowanej polityki trwałości: zatwierdzone decyzje muszą być możliwe do odtworzenia, a tymczasowe cechy lub sygnały pochodne można odbudować. Z tego samego powodu korzysta analityka ryzyka, zwłaszcza gdy analitycy lub zautomatyzowane kontrole potrzebują zmieniających się pozycji, a nie wczorajszych ekstraktów.

Dopasuj silnik do decyzji
Zespoły produkcyjne i logistyczne mierzą się z podobnym problemem. Czujniki, zamówienia, ruchy magazynowe i zdarzenia dostaw nieustannie zmieniają obraz sytuacji operacyjnej. Warstwa zorientowana na pamięć może zasilać dashboardy na żywo, wykrywanie wyjątków, decyzje dyspozytorskie i widoki przepustowości bez przepuszczania każdego żądania przez ciężką od storage ścieżkę analityczną. Sprawdza się tam, gdzie nieaktualna informacja może spowodować niezrealizowaną wysyłkę, zbędną zmianę w produkcji lub złą decyzję alokacyjną.
Zdefiniuj aktywny working set, zanim wybierzesz platformę:
Określ okno decyzyjne. Ustal, które zdarzenia, encje i miary muszą być dostępne natychmiast.
Oddziel dane aktywne od historycznych. Trzymaj bieżący kontekst operacyjny w szybkiej warstwie, a starsze rekordy w odpowiednich systemach trwałych.
Zdefiniuj zachowanie w razie awarii. Zdecyduj, co musi przetrwać restart, co można odbudować i jak szybko usługa musi wrócić do działania.
Mierz całą ścieżkę. Uwzględnij ingestion, transformację, wykonanie zapytań, persystencję, replikację i czas odpowiedzi aplikacji.
SAP HANA to znany przykład platformy łączącej przetwarzanie transakcyjne i analityczne, co może wyeliminować etap przenoszenia danych między aktualizacjami operacyjnymi a analizą. Szersza lekcja zależy od obciążenia: konsolidacja pomaga, gdy osobne systemy wprowadzałyby niedopuszczalne opóźnienia, ale skupia też kwestie wydajności, odtwarzania i pojemności na jednej platformie.
Monitorowanie danych w czasie rzeczywistym wymaga czegoś więcej niż szybkiego silnika zapytań. Zespoły muszą wiedzieć, czy dane dotarły, czy zmienił się ich kształt i czy wartości pozostają wiarygodne. Podejście do monitorowania danych w czasie rzeczywistym może uzupełnić warstwę bazy danych, sprawdzając zachowanie i dostępność danych, od których zależą szybkie aplikacje. Te informacje powinny być częścią modelu operacyjnego, obok pomiarów opóźnień, odtwarzania i pojemności.
Najczęstsze mity o technologii in-memory
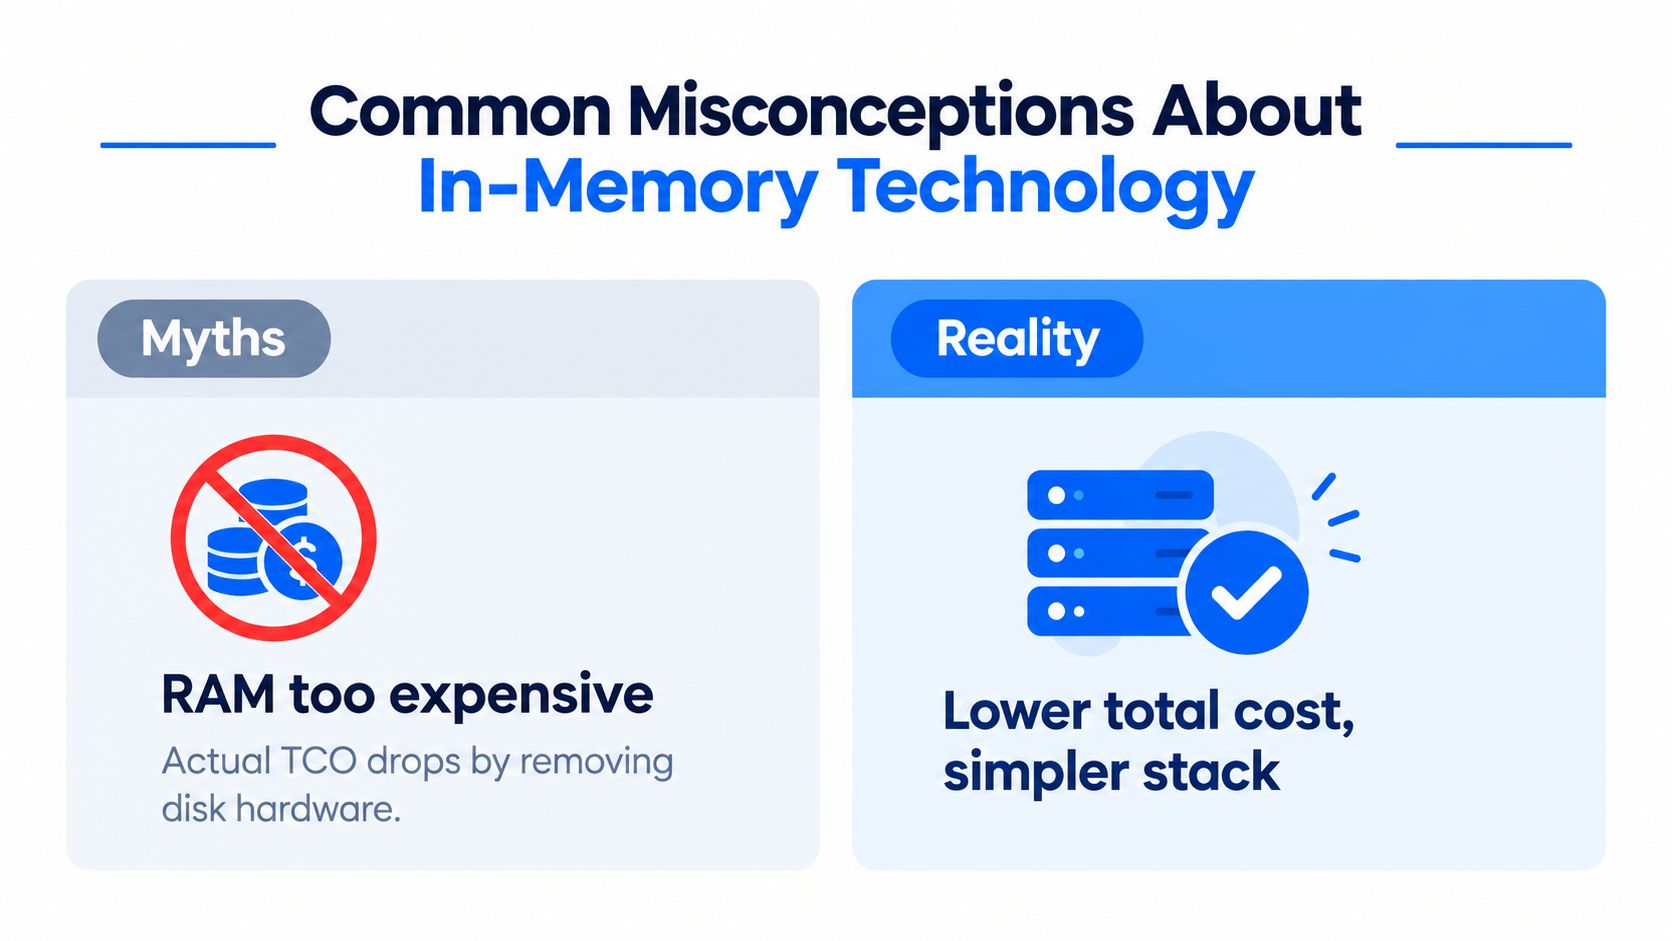
Pierwszy mit głosi, że koszt RAM automatycznie czyni bazę danych in-memory nieopłacalną. RAM jest droższy niż pojemność dyskowa, więc obawa jest zasadna. Porównanie nie powinno jednak kończyć się na rachunku za pamięć. Architektura zorientowana na pamięć może ograniczyć powtarzane I/O, uprościć niektóre ścieżki przetwarzania i usunąć części rozdrobnionej architektury. To, czy całkowity koszt spadnie, zależy od charakteru obciążenia, licencji, replikacji, utrzymania i ilości danych wymagających szybkiego dostępu.
Trzy założenia, które warto podważyć
„Cały zbiór danych musi zmieścić się w RAM.” Niekoniecznie. Nowoczesne architektury mogą trzymać gorące dane w RAM, a chłodniejsze na dyskach NVMe SSD, zaś architektury rozproszone mogą dzielić aktywne przetwarzanie między serwery (AWS opisuje tiering między pamięcią a SSD). Kluczowe pytanie przy wymiarowaniu dotyczy aktywnego working setu i wzorca dostępu do niego, a nie tylko całkowitego historycznego rozmiaru danych.
„In-memory oznacza, że dane znikają podczas awarii.” Prototyp działający wyłącznie w pamięci może się tak zachowywać. Produkcyjna baza danych in-memory korzysta z mechanizmów persystencji, takich jak logi, snapshoty czy pliki odtwarzania, a konfiguracja trwałości określa, co system jest w stanie odtworzyć. Zespoły powinny testować te gwarancje, zamiast wnioskować o nich z nazwy produktu.
„Szybszy storage rozwiązuje każdy problem z bazą danych.” Nie rozwiązuje. Źle zaprojektowane joiny, nadmierna serializacja, rywalizacja o blokady, nieefektywne modelowanie danych i nieograniczona kardynalność mogą sprawić, że szybki silnik pozostanie wolny. Technologia in-memory usuwa jedną klasę wąskich gardeł, czyli opóźnienia storage, ale reszta systemu pozostaje widoczna.
Właściwe pytanie nie brzmi „Czy możemy umieścić tę bazę danych w pamięci?”, tylko „Które dane i decyzje uzasadniają wykonywanie w pamięci?”
Kolejny mit zakłada, że jedna architektura musi obsługiwać każde obciążenie. Archiwa historyczne, duże repozytoria o długiej retencji i transformacje batchowe często lepiej sprawdzają się na trwałym storage zorientowanym na pojemność. Warstwa in-memory może działać obok tych systemów, przyspieszając aktywną ścieżkę, nie stając się jedynym miejscem przechowywania danych.
Czy baza danych in-memory pasuje do Twojego stacku?
Najpierw wybierz obciążenie, potem produkt. Baza danych in-memory sprawdza się, gdy użytkownicy lub serwisy wymagają stale niskich opóźnień, transakcje napływają nieprzerwanie, aktywne rekordy są często ponownie wykorzystywane, a opóźnione decyzje generują koszty operacyjne. Mniej nadaje się do dostępu archiwalnego, zaplanowanych zapytań batchowych lub working setu zbyt zimnego, by uzasadnić zajmowaną pamięć RAM.
Skorzystaj z tego filtra decyzyjnego:
Wybierz wykonywanie w pamięci dla sygnałów fraudowych, operacyjnych widoków na żywo, stanu sesji, decyzji podejmowanych z dużą częstotliwością oraz obciążeń, w których I/O storage dominuje w czasie odpowiedzi.
Pozostaw tradycyjny storage w centrum dla zimnych archiwów, zbiorów danych o długiej retencji, rzadkiego raportowania i zadań batchowych z elastycznym oknem realizacji.
Zastosuj architekturę hybrydową, gdy natychmiastowego dostępu wymaga tylko część zbioru danych, a reszta pozostaje na trwałych warstwach.
Rynek wyszedł już poza niszowe eksperymenty. Szacunki określają globalny rynek baz danych in-memory na około 7,20 mld USD w 2024, 8,14 mld USD w 2025 i 9,05 mld USD w 2026 roku, z prognozą osiągnięcia 15,31 mld USD do 2031 roku, według szacunków rynkowych Fortune Business Insights. Wzrost rynku sprzyja dalszej adopcji, ale nie zastępuje testów obciążenia ani weryfikacji odtwarzania po awarii.
Zanim podejmiesz decyzję, przetestuj reprezentatywne zapytania, sprawdź persystencję przy zaniku zasilania i restarcie, zmierz presję na pamięć i zweryfikuj zachowanie tieringu. Dostrój ścieżkę SQL dzięki optymalizacji zapytań SQL, a następnie porównaj zmierzone zyski w opóźnieniach z kosztami pamięci, licencji, replikacji i utrzymania. Wynikiem powinien być wybór infrastruktury oparty na systemie, który faktycznie eksploatujesz.
digna pomaga zespołom danych monitorować anomalie, terminowość danych, zmiany schematu i kontrole jakości na poziomie rekordów bezpośrednio w ich własnych bazach danych. Jeśli architektura in-memory zależy od aktualnych i wiarygodnych danych wejściowych, odwiedź digna, aby ocenić podejście do observability in-database.
Szybki silnik pomaga tylko wtedy, gdy zasilające go dane są aktualne, dlatego warto sprawdzać, czy każda tabela źródłowa rzeczywiście dotarła zgodnie z harmonogramem. Zobacz, jak digna Timeliness uczy się oczekiwanych wzorców dostarczania danych i sygnalizuje opóźnione lub brakujące ładowania.
Najczęściej zadawane pytania
Czy baza danych in-memory traci dane po zaniku zasilania?
Nie w systemie produkcyjnym. RAM pełni rolę szybkiej przestrzeni roboczej, a nie trwałego zapisu, więc po zaniku zasilania silnik odtwarza zapisany stan z dysku lub SSD i odtwarza swój log transakcji. SAP HANA na przykład utrwala zatwierdzone transakcje za pomocą logowania i save pointów.
O ile szybsza jest baza danych in-memory od bazy dyskowej?
Dostęp do pamięci określa się jako mniej więcej 10 razy szybszy niż dostęp do dysku, a źródła techniczne podają odczyty rzędu mikrosekund i zapisy rzędu pojedynczych milisekund. Rzeczywiste opóźnienia zależą jednak od sprzętu, ustawień trwałości, kształtu zapytań i współbieżności, dlatego zespoły powinny mierzyć opóźnienia p95 i p99 zamiast ufać deklarowanym wartościom.
Czy wszystkie moje dane muszą zmieścić się w RAM?
Nie. Nowoczesne architektury trzymają gorące dane w RAM, a chłodniejsze przenoszą na dyski NVMe SSD, natomiast konfiguracje rozproszone dzielą working set między kilka serwerów. Przy wymiarowaniu liczy się aktywny working set i sposób dostępu do niego, a nie cały historyczny rozmiar bazy.
Kiedy warto wybrać bazę danych in-memory zamiast tradycyjnej?
Wtedy, gdy opóźniona odpowiedź zmienia wynik, na przykład przy sygnałach fraudowych, operacyjnych dashboardach na żywo, stanie sesji czy decyzjach dyspozytorskich. Zimne archiwa, dane o długiej retencji i zadania batchowe z elastycznym oknem zwykle lepiej umieścić w dyskowym storage zorientowanym na pojemność, a architektura hybrydowa sprawdza się tam, gdzie gorąca jest tylko część danych.
Czym różni się fsync-per-commit od group commit?
Oba mechanizmy decydują, kiedy zapisy trafiają do trwałego storage. Fsync-per-commit zrzuca każdą transakcję natychmiast, co daje najsilniejszą trwałość przy wyższym koszcie każdego zapisu. Group commit łączy kilka zrzutów w jedną partię, zwiększając przepustowość kosztem dodatkowej koordynacji commitów, więc właściwy wybór zależy od tego, jak kosztowna byłaby utrata ostatnich zapisów.


