10 skutecznych metod kontroli jakości danych
|
9
min. czyt.

Jeden zestaw reguł nie ochroni nowoczesnego środowiska danych. Kontrole deterministyczne wychwytują nieprawidłowe rekordy, ale niekoniecznie wykryją spadek wolumenu, który wygląda na całkowicie uzasadniony. Statyczny próg może uznać sezonowy szczyt za incydent, a monitor dostaw może wykryć brakujące ładowanie, nie mówiąc nic o tym, czy dostarczone rekordy są poprawne. Kontrole strukturalne, sygnały behawioralne, wskaźniki biznesowe, telemetria platformy i współpraca ludzi ujawniają różne rodzaje awarii.
Praktyczna odpowiedź nie polega na wyborze między testowaniem a obserwowalnością. Zespoły potrzebują uzupełniających się warstw kontroli, które działają razem na etapie pozyskiwania, transformacji, przechowywania i konsumpcji danych. Ta zasada wpisuje się w szerszą ewolucję kontroli jakości: od kart kontrolnych Waltera A. Shewharta z 1924 roku, oddzielających zmienność naturalną od zmienności wynikającej z przyczyn specjalnych, po współczesne metody mierzące takie wymiary jak kompletność, aktualność i spójność. Historia statystycznej kontroli jakości pokazuje, dlaczego nietypowe zachowanie wymaga analizy, a wymiary jakości danych dają język do opisania, co oznacza „dobre”.
Poniższe 10 metod kontroli jakości danych ułożyliśmy jako stos kontroli. Zacznij od jawnych reguł, dodaj sygnały wyuczone i statystyczne, monitoruj dostawy i strukturę, chroń dane wrażliwe odpowiednią architekturą, a następnie powiąż incydenty techniczne z wpływem na biznes i pracą zespołów. Praktyczny przykład znajdziesz w tym przewodniku po walidacji danych z pipeline'ów mediów społecznościowych.
Spis treści
1. Wykrywanie anomalii z użyciem AI i uczenia się punktu odniesienia
2. Walidacja danych na poziomie rekordów względem reguł biznesowych
3. Monitorowanie terminowości i dostarczania danych z wyliczaniem oczekiwanego czasu dostawy
9. Kompleksowe dashboardy obserwowalności danych i wspólny monitoring
10. Modułowa architektura kontroli jakości z szybkim wdrożeniem
1. Wykrywanie anomalii z użyciem AI i uczenia się punktu odniesienia
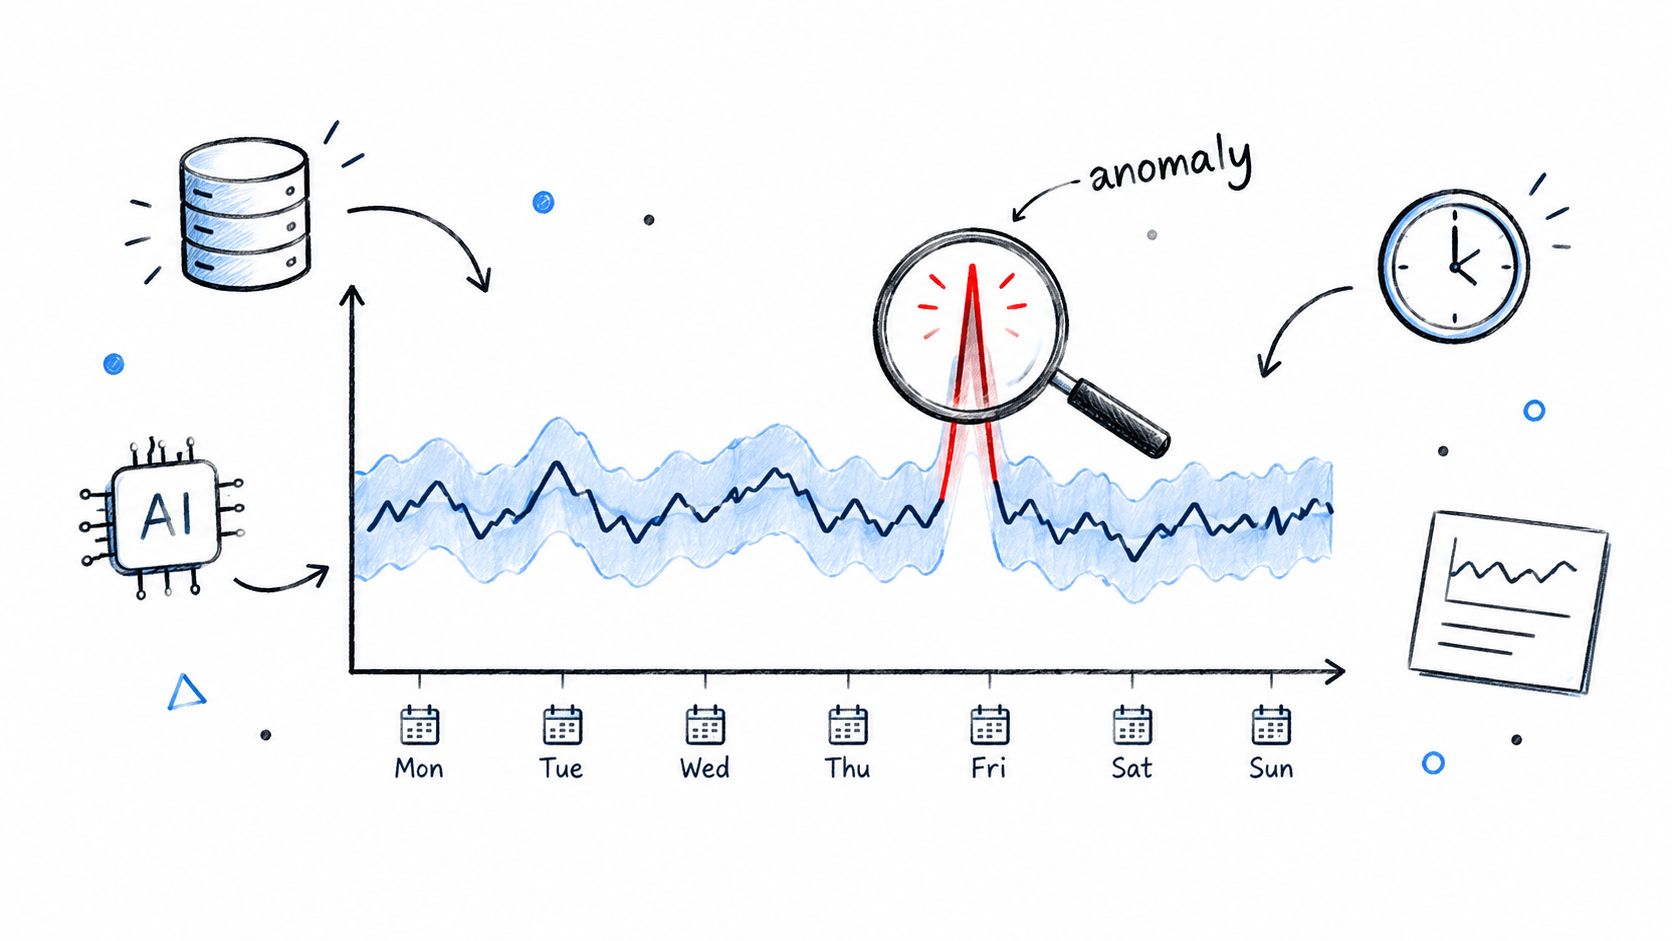
Wykrywanie anomalii z użyciem AI szuka zachowań odbiegających od normalnego wzorca zbioru danych. Zamiast zmuszać inżynierów do definiowania progu dla każdej tabeli, system uczy się punktu odniesienia na podstawie historycznych wolumenów, rozkładów, kategorii lub innych metryk obserwowalności. Sprawdza się więc przy zbiorach danych z sezonowością, wzrostem, nieregularnym popytem lub zależnościami zbyt złożonymi dla stałej reguły.
Moduł Data Anomalies w digna powstał z myślą o takim monitoringu. W środowisku finansowym nieoczekiwany spadek wolumenu transakcji może pojawić się przed błędem uzgodnienia. W ochronie zdrowia nietypowy wzorzec przyjęć pacjentów lub rozkład wyników badań laboratoryjnych może wymagać analizy. W telekomunikacji zmiana ruchu sieciowego może wskazywać na pogorszenie jakości usług lub nietypowe użycie. To sygnały wykrywania, a nie automatyczny dowód problemu biznesowego, więc właściciel danych nadal musi zweryfikować przyczynę.
Spraw, by punkt odniesienia był zrozumiały
Zbierz wystarczająco dużo reprezentatywnej historii, zanim zaczniesz traktować alerty jako podstawę do działania. Nowy zbiór danych, przejęcie, wprowadzenie produktu lub migracja źródła mogą sprawić, że stary punkt odniesienia stanie się mylący. Dodaj kontekst biznesowy, taki jak wydarzenia kalendarzowe, planowane kampanie i właściciele źródeł, a pierwsze alerty przejrzyj z ekspertami dziedzinowymi, aby dostroić czułość.
Praktyczna zasada: używaj wykrywania anomalii, aby znaleźć to, czego reguły nie przewidziały, a deterministycznej walidacji, aby udowodnić, co zawiodło.
Wykrywanie anomalii w danych kategorycznych w digna jest szczególnie przydatne tam, gdzie zmiana struktury kategorii ma większe znaczenie niż sama liczba wierszy. Zespoły mogą łączyć to podejście z rozwiązaniami AI firmy Wisely, gdy potrzebują szerszego wsparcia we wdrażaniu AI.
2. Walidacja danych na poziomie rekordów względem reguł biznesowych
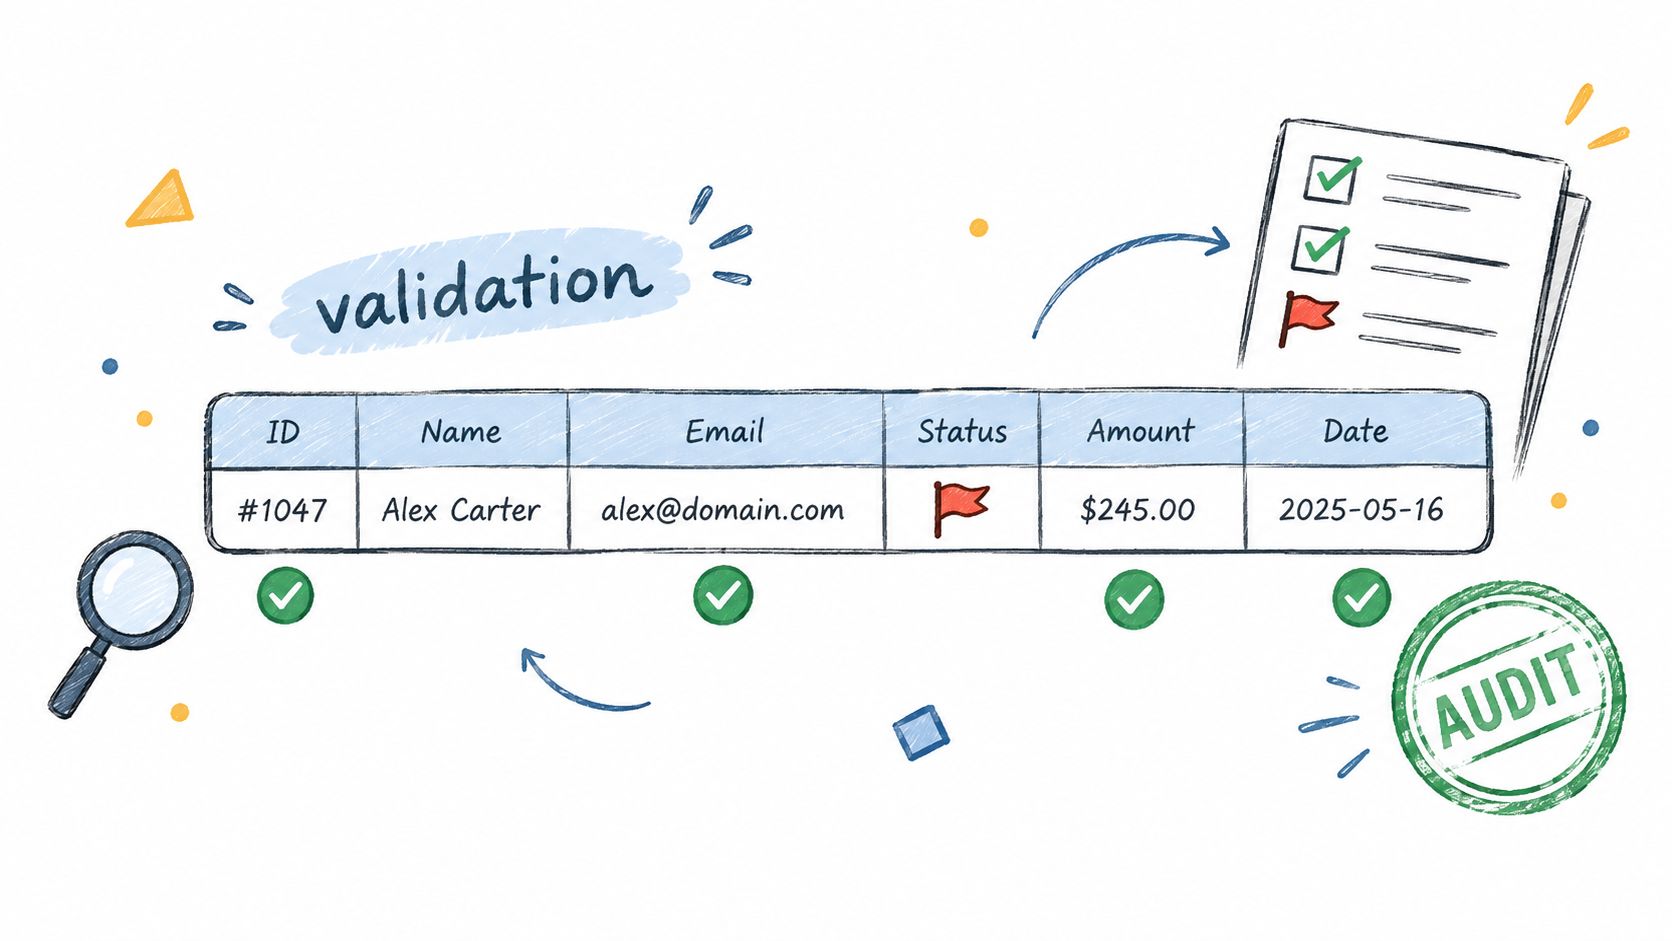
Walidacja na poziomie rekordów odpowiada na precyzyjne pytanie: czy ten wiersz spełnia reguły, które czynią go użytecznym? Sprawdza pojedyncze rekordy pod kątem pól wymaganych, dozwolonych wartości, zakresów, formatów, relacji i logiki biznesowej. W przeciwieństwie do zagregowanego sygnału anomalii potrafi wskazać dokładny rekord, regułę i wynik, które wymagają naprawy.
Typowe rodzaje reguł to kontrole wartości niepustych, unikalności, typu danych, zakresu, formatu, integralności referencyjnej i logiki biznesowej. Wytyczne dotyczące walidacji danych opisują, jak zespoły egzekwują te kontrole za pomocą ograniczeń bazy danych, walidacji schematu i testów automatycznych. Instytucja finansowa może walidować limity transakcji i wymagania dotyczące kontrahentów. System ochrony zdrowia może sprawdzać identyfikatory pacjentów i kody diagnoz. Urząd może weryfikować dane licencyjne lub pola dotyczące uprawnień do świadczeń.
Spraw, by błędy dało się prześledzić
Nie zaczynaj od walidowania wszystkich pól w jednakowym stopniu. Priorytetowo traktuj rekordy, które wpływają na raportowanie regulacyjne, płatności, decyzje kliniczne, tożsamość klientów lub KPI zarządu. To właściciele biznesowi powinni zdefiniować, co znaczy „poprawny”, bo wartość akceptowalna technicznie może nadal naruszać zasady operacyjne.
Wersjonuj reguły i przechowuj dowody wyników pozytywnych i negatywnych. Dzięki temu inżynierowie odróżnią błąd źródła od świadomej zmiany zasad, a zespoły ds. governance otrzymają ścieżkę audytu.
Reguły walidacji danych i ciągła kontrola jakości danych w digna obsługują własną logikę walidacji wykonywaną w bazie danych, z identyfikowalnymi wynikami reguł. Ceną jest utrzymanie. Reguły są niezawodne dla znanych warunków, ale nie wykryją nieznanej zmiany, dopóki ktoś nie zapisze jej jako reguły albo nie połączy walidacji z wykrywaniem anomalii.
3. Monitorowanie terminowości i dostarczania danych z wyliczaniem oczekiwanego czasu dostawy
Zbiór danych może być kompletny i poprawny, a mimo to bezużyteczny, bo dotarł za późno. Monitorowanie terminowości porównuje rzeczywiste dostawy z oczekiwanym zachowaniem i wykrywa opóźnione ładowania, brakujące pliki, zbyt wczesne dostawy oraz stopniowe pogarszanie się wydajności źródeł. Chroni dashboardy, modele downstream, uzgodnienia i procesy operacyjne, które zależą od dostępności danych w określonym czasie.
Zespół bankowy może użyć monitora terminowości, aby wykryć brakujący nocny batch przed porannym raportowaniem. Placówka medyczna może wyjaśnić opóźnione dane pacjentów, zanim zakłócą koordynację opieki. Operator telekomunikacyjny może sprawdzać, czy dane o użyciu lub rozliczeniach docierają do celu w oczekiwanym oknie czasowym. Moduł Timeliness w digna wylicza oczekiwany czas dostawy na podstawie zaobserwowanych wzorców, zamiast traktować każde źródło tak, jakby działało według tego samego harmonogramu.
Odróżnij opóźnienie od braku
Jeden monitor nie powinien obsługiwać źródeł o różnym rytmie dostaw. Zdefiniuj oczekiwania dla każdego źródła, tabeli lub workloadu i połącz alerty z procesem zarządzania incydentami oraz dyżurami. Alert, który wisi na dashboardzie bez właściciela, to tylko mechanizm opóźnionego odkrywania problemów.
Łącz monitorowanie dostaw z monitorowaniem wolumenu. Plik, który przychodzi na czas bez żadnych rekordów, to inna awaria niż plik z oczekiwanym wolumenem, który przychodzi z opóźnieniem. Śledź też wzorzec dostaw w czasie, bo pipeline, który stopniowo się opóźnia, może wymagać uwagi, zanim przekroczy formalny termin.
Definicja terminowości danych i wskazówki dotyczące jej monitorowania dają użyteczne ramy do rozróżnienia świeżości, oczekiwań co do dostaw i reakcji operacyjnej. Głównym kompromisem jest rygor alertów. Stałe okna łatwo wyjaśnić, natomiast wyuczone oczekiwania lepiej dopasowują się do rzeczywistej pracy systemów, ale wymagają przeglądu przy zmianie harmonogramów.
4. Wykrywanie zmian schematu i monitorowanie struktury
Dryf schematu powoduje awarie, których kontrole na poziomie wierszy mogą nigdy nie zauważyć. Dostawca może dodać pole, usunąć kolumnę, zmienić typ danych lub ograniczenie, a jednocześnie wysyłać rekordy, które pojedynczo wyglądają wiarygodnie. Transformacje, raporty i modele downstream mogą wtedy głośno się wywrócić albo, co gorsza, działać dalej ze zmienioną interpretacją danych.
Monitorowanie schematu porównuje strukturę przychodzących danych z zatwierdzonym, umownym punktem odniesienia. Może ilościowo opisać zmianę za pomocą miar takich jak wskaźnik niezgodności kolumn lub złożony wskaźnik podobieństwa schematu, dzięki czemu zmiany strukturalne nadają się do automatycznego alertowania. Metryki dryfu schematu opisują to podejście do mierzenia odchyleń strukturalnych zamiast traktowania każdej zmiany jako równie poważnej.
Pokaż wpływ stojący za alertem
Dodana opcjonalna kolumna może oznaczać niskie ryzyko. Usunięty identyfikator lub zmiana typu w strumieniu danych regulacyjnych może wymagać natychmiastowego zatrzymania. Dokumentuj zależności między tabelami, aby alert wskazywał dotknięte zadania ETL, modele semantyczne, dashboardy i data products, zamiast wysyłać inżynierów na poszukiwania po omacku.
Wyjaśnienie dryfu schematu od digna opisuje ryzyko operacyjne niezapowiedzianych zmian strukturalnych. Schema Tracker wykrywa dodane lub usunięte kolumny oraz zmiany typów danych. Połącz wykrywanie z procesem zatwierdzania zmian i automatycznymi testami zgodności. Sam monitoring mówi, że struktura się zmieniła. Governance decyduje, czy zmiana jest dozwolona, poddana kwarantannie czy eskalowana.
5. Analiza statystyczna i analiza trendów metryk danych
Analiza statystyczna bada, jak metryki jakości i wskaźniki biznesowe zachowują się w czasie. Może ujawnić stopniowy dryf, zmienną zmienność, nietypowe rozkłady i wzorce, których nie wychwyci pojedyncza reguła typu zaliczone/niezaliczone. Średnie kroczące, analiza odchylenia standardowego i dekompozycja trendu to przydatne narzędzia, ale metoda musi pasować do metryki. Miara ciągła, rozkład kategoryczny i liczba zdarzeń nie zachowują się statystycznie tak samo.
Zespół finansowy może analizować zmienność przychodów, a placówka medyczna badać wskaźniki przyjęć, wolumen leczenia lub miary wyników. Zespół telekomunikacyjny może obserwować stopniowy wzrost liczby porzuconych połączeń lub zmieniający się wzorzec churnu. Moduł Data Analytics w digna służy do historycznej analizy metryk obserwowalności i zachowań biznesowych, pomagając zespołom ustalić, czy zmiana jest odosobniona, czy stanowi część trendu.
Korzystaj z reprezentatywnej historii
Punkt odniesienia zbudowany na nietypowym okresie może prowadzić do błędnych wniosków. Wykluczaj znane awarie, migracje i wyjątkowe zdarzenia, jeśli nie odzwierciedlają normalnej pracy, albo oznaczaj je, aby analitycy mogli poprawnie zinterpretować wynik. Wiedza dziedzinowa pozostaje niezbędna, bo statystyczna nietypowość to nie to samo co błąd z punktu widzenia biznesu.
W przypadku alertów o anomaliach przedziały ufności i reguły odchylenia kroczącego dają lepiej uzasadnione granice niż arbitralne stałe limity. Jedno z udokumentowanych podejść generuje alert, gdy metryka wychodzi poza 99% przedział ufności dla tego samego dnia w poprzednim roku lub gdy odchyla się o więcej niż 3 odchylenia standardowe od średniej kroczącej. Przykłady statystycznego wykrywania anomalii ilustrują te techniki.
Kompromisem jest interpretowalność. Metody statystyczne skutecznie wykrywają wzorce, ale zanim zespoły zablokują pipeline lub eskalują sprawę do zarządu, potrzebują jasnych wyjaśnień i kontekstu zdarzeń. Pokrewne podejście analityczne opisuje analiza trendów w danych od digna.
6. Obliczanie i analiza metryk bezpośrednio w bazie danych
Monitorowanie jakości nie wymaga eksportowania danych produkcyjnych do zewnętrznej usługi. Wykonywanie w bazie danych oblicza metryki, uruchamia kontrole i przeprowadza analizy wewnątrz hurtowni, data lake'a lub bazy danych klienta. Taka architektura ogranicza przenoszenie danych i wspiera wymagania governance tam, gdzie wrażliwe rekordy muszą pozostać w infrastrukturze organizacji.
Instytucja finansowa może przeprowadzać walidację zgodności na danych regulowanych bez kopiowania ich gdziekolwiek indziej. Placówka medyczna może oceniać jakość danych pacjentów, zachowując chronione informacje we własnym, kontrolowanym środowisku. digna wykonuje kontrole anomalii, walidacji, terminowości i pokrewne bezpośrednio w bazach danych klienta, więc warstwa monitoringu może badać dane bez przejmowania samych rekordów.
Chroń wydajność, nie tylko prywatność
Wykonywanie w bazie danych przenosi odpowiedzialność na środowisko bazy. Zapytania monitorujące potrzebują odpowiednich uprawnień, najlepiej tylko do odczytu, i muszą być zaprojektowane tak, by kontrole jakości nie konkurowały z workloadami produkcyjnymi. Kosztowne profilowanie lub analizy historyczne planuj na okresy mniejszego obciążenia, a czas wykonania zapytań i zużycie zasobów mierz jako część projektu monitoringu.
Pozostawienie danych na miejscu ogranicza ich ekspozycję, ale nie zwalnia z kontroli dostępu, governance zapytań ani testów wydajności.
Kompromisem są przenośność i złożoność operacyjna. Kontrola, która dobrze działa w jednej hurtowni, może wymagać optymalizacji w innej, zwłaszcza gdy różnią się rozmiary tabel, partycjonowanie lub wzorce obciążenia. Zespoły powinny testować plany zapytań, stosować obliczenia przyrostowe tam, gdzie ma to sens, i monitorować obciążenie generowane przez sam monitoring.
7. Monitorowanie biznesowych KPI i metryk operacyjnych
Techniczne sygnały jakości mają znaczenie, bo wpływają na decyzje i operacje. Monitoring biznesowy łączy dane źródłowe z takimi wskaźnikami jak przychody, wolumen transakcji, aktywność klientów, konwersja, wyniki leczenia, churn czy dostępność sieci. Nieoczekiwana zmiana KPI może ujawnić problem z danymi, zanim właściciel techniczny zauważy nieudany test, a technicznie zdrowy pipeline może mimo to dać wynik biznesowy, który wymaga wyjaśnienia.
Zespół finansowy może zauważyć nieoczekiwaną zmianę przychodów lub wolumenu transakcji. Podmiot medyczny może monitorować liczbę przyjęć i wyniki operacyjne. Operator telekomunikacyjny może śledzić churn, średni przychód na użytkownika lub dostępność sieci. Nie są to automatycznie błędy danych. Rzeczywiste wydarzenie rynkowe może wywołać rzeczywisty ruch KPI, dlatego monitoring biznesowy powinien inicjować analizę, a nie przesądzać o przyczynie.
Uzgodnij eskalację, zanim pojawi się alert
Wybierz wskaźniki najważniejsze dla decyzji i zdefiniuj ich oczekiwane zachowanie razem z właścicielami. Zapisz, kto otrzymuje alert, jakich dowodów potrzebuje i kiedy problem staje się incydentem biznesowym. Jeśli KPI się zmienia, prześledź to wstecz przez sygnały świeżości, wolumenu, schematu, walidacji, źródła i platformy.
Wskaźniki biznesowe pomagają też ustalać priorytety. Nieudana kontrola na nieużywanej tabeli deweloperskiej nie powinna konkurować z mniejszym błędem, który wpływa na raport regulacyjny. Najlepsza konfiguracja łączy anomalie KPI z lineage i kontekstem technicznym, dzięki czemu analitycy i inżynierowie mogą badać ten sam incydent z różnych perspektyw.
Moduł Business Monitoring w digna łączy analizę wskaźników biznesowych i operacyjnych z szerszymi sygnałami jakości potrzebnymi do analizy przyczyn źródłowych. Praktycznym kompromisem jest odpowiedzialność. Zespoły biznesowe muszą pomóc zdefiniować znaczenie i istotność wskaźników, w przeciwnym razie inżynierowie będą zgadywać, które zmiany mają znaczenie.
8. Obserwowalność platformy danych i workloadów
Kontrole zbiorów danych mogą pokazać, że dane są błędne. Obserwowalność platformy pomaga wyjaśnić dlaczego. Monitoruje zachowanie workloadów, zużycie zasobów, dostępność, wydajność zapytań, czas trwania zadań i zmiany w infrastrukturze, która przenosi i przechowuje dane. Ten widok na poziomie systemu wychwytuje awarie niewidoczne w pojedynczej tabeli.
Zadanie ETL może trwać dłużej, bo hurtownia jest przeciążona. Nagły skok obciążenia może ujawnić zduplikowane pipeline'y lub nieefektywną transformację. Zmiana platformy może wpłynąć na wiele zbiorów danych jednocześnie, nawet gdy ostatnia walidacja każdej tabeli zakończyła się sukcesem. Te sygnały pomagają zespołom odróżnić błąd źródła od problemu z pojemnością, zmiany konfiguracji lub nierównowagi obciążenia.
Koreluj sygnały, ale ich nie scalaj
Ustal normalne zachowanie platformy, a następnie koreluj odchylenia z incydentami jakości danych. Jeśli kilka alertów o świeżości pojawia się po wzroście zużycia zasobów, telemetria platformy może skierować analizę na infrastrukturę. Jeśli zmienia się jedno źródło, a kondycja platformy pozostaje stabilna, bliższej uwagi wymaga źródło lub transformacja.
Oddzielaj incydenty platformy od błędów danych. Wolne zapytanie nie oznacza automatycznie złych danych, a poprawna tabela nie dowodzi, że platforma jest zdrowa. Rozdzielona odpowiedzialność może usprawnić reakcję, pod warunkiem że system obsługi incydentów zachowuje powiązania między workloadem, pipeline'em, zbiorem danych i wpływem na biznes.
Moduł Data Platform Observability w digna monitoruje kondycję platformy, zachowanie workloadów, zużycie, dostępność i sygnały związane z wydajnością. Kompromisem jest zakres. Więcej telemetrii może oznaczać więcej szumu, dlatego zespoły powinny określić, które zmiany platformy wymagają natychmiastowego działania, a które należą do planowania pojemności lub przeglądu inżynierskiego.
9. Kompleksowe dashboardy obserwowalności danych i wspólny monitoring
Kontrola, którą potrafi zinterpretować tylko jeden specjalista, nie będzie się skalować w całej organizacji danych. Wspólny monitoring łączy wyniki walidacji, sygnały anomalii, terminowość, zmiany schematu, KPI, kondycję platformy, odpowiedzialności i historię incydentów we wspólnych widokach operacyjnych. Data engineerowie potrzebują szczegółów technicznych, analitycy kontekstu wskaźników, zespoły governance dowodów, a kadra kierownicza zwięzłego obrazu niezawodności i wpływu.
Dashboard powinien dopasowywać się do tych decyzji, a nie domyślnie wyświetlać każdą dostępną metrykę. Inżynier może potrzebować nieudanej reguły, partycji źródłowej, zapytania i lineage. Analityk może potrzebować dotkniętego KPI, stanu świeżości i definicji biznesowej. Lider ds. governance może potrzebować właściciela, historii rozwiązania i dowodu, że kontrola wykonała się zgodnie z oczekiwaniami.
Świadomie ograniczaj zmęczenie alertami
Grupuj powiązane alerty w incydenty, eliminuj duplikaty i pokazuj najpierw najcenniejszy sygnał. Dodaj widoki szczegółowe do analizy, ale domyślny ekran skup na tym, co wymaga działania. Informacja zwrotna od użytkowników sama w sobie jest kontrolą operacyjną. Jeśli zespoły regularnie odrzucają określoną kategorię alertów, zmień próg, routing lub projekt kontroli.
Zintegruj dashboard z narzędziami komunikacji zespołów i zarządzania incydentami. Przypisz właścicieli do zbiorów danych i reguł, zapisuj kroki naprawcze i zachowuj ślad decyzji. Wtedy warstwa wizualizacji staje się systemem współpracy.
digna oferuje dashboard zorientowany na użytkownika dla inżynierów, analityków i interesariuszy, ze wspólnym wglądem w incydenty, trendy i statusy. Kompromisem jest governance samego dashboardu. Bez jasnych definicji i odpowiedzialności scentralizowany widok może zamienić się w zatłoczony katalog nierozwiązanych sygnałów zamiast narzędzia do podejmowania decyzji.
10. Modułowa architektura kontroli jakości z szybkim wdrożeniem
Najskuteczniejszy program jakości danych zwykle rośnie warstwami, a nie powstaje jako jedno duże wdrożenie. Architektura modułowa pozwala zespołowi zacząć od rodzaju awarii, który wyrządza najwięcej szkód, udowodnić skuteczność kontroli i dodawać kolejne obszary bez zmiany modelu operacyjnego. Organizacja finansowa może zacząć od walidacji i wykrywania anomalii, a potem dodać monitorowanie terminowości i schematu. Zespół w ochronie zdrowia może zacząć od zarządzania jakością, a później podłączyć wskaźniki wyników klinicznych. Operator telekomunikacyjny może najpierw wdrożyć obserwowalność platformy, a dopiero potem rozszerzyć działania o kontrole na poziomie rekordów.
Ustal kolejność kontroli według ryzyka
Zacznij od oceny jakości danych, która wskaże krytyczne zbiory danych, ich odbiorców, właścicieli i znane incydenty. Pierwszy moduł wybierz na podstawie faktów, a nie tego, którą funkcję najłatwiej zademonstrować. Problem z brakującymi ładowaniami wymaga monitorowania terminowości. Wadliwy strumień od dostawcy wymaga śledzenia schematu. Błędne pole uprawnień wymaga walidacji rekordów.
Zaplanuj mapę rozbudowy na 6 do 12 miesięcy, z kamieniami milowymi powiązanymi z pokryciem i naprawami, a nie samą instalacją. Zapewnij sobie wsparcie sponsora ds. data governance, zarezerwuj wewnętrzne zasoby na integrację i traktuj szablony branżowe wyłącznie jako punkt wyjścia. Pierwsze sukcesy powinny finansować szerszą adopcję, a nie pozostawać odosobnionymi demonstracjami.
Buduj z myślą o pokryciu: dodawaj kontrole, które ujawniają różne rodzaje awarii, a nie trzy wersje tego samego testu.
Modułowa platforma digna już od wyboru pierwszego modułu obejmuje harmonogram, katalog danych, integracje i funkcje współpracy. Opcje wdrożenia obejmują chmurę prywatną oraz instalację on-premises w chmurze, VPC lub centrum danych klienta. Kompromisem jest dyscyplina. Modułowe licencjonowanie i wdrażanie mogą obniżyć próg wejścia, ale zespoły nadal potrzebują wspólnego modelu kontroli, spójnej odpowiedzialności i jasnej zasady, kiedy alert staje się zadaniem naprawczym.
Porównanie w 10 punktach: metody kontroli jakości danych
Metoda | Złożoność wdrożenia 🔄 | Wymagane zasoby ⚡ | Oczekiwane rezultaty 📊 | Idealne zastosowania 💡 | Kluczowe zalety ⭐ |
|---|---|---|---|---|---|
Wykrywanie anomalii z użyciem AI i uczenia się punktu odniesienia | Średnia do wysokiej; wymaga pipeline'ów ML i model ops | Średnie do wysokich; potrzebne dane historyczne i moc obliczeniowa | Wysokie ⭐⭐⭐; wczesne wykrywanie nowych & subtelnych odchyleń | Złożone szeregi czasowe, sezonowe wskaźniki biznesowe | Adaptacyjny punkt odniesienia; mniej fałszywych alarmów |
Walidacja danych na poziomie rekordów względem reguł biznesowych | Niska do średniej; tworzenie i utrzymanie reguł | Niskie do średnich; silnik reguł i wkład biznesu | Wysokie ⭐⭐⭐; deterministyczny wynik pozytywny/negatywny ze ścieżką audytu | Zgodność regulacyjna, integralność transakcji | Identyfikowalne naruszenia; precyzyjne cele naprawy |
Monitorowanie terminowości i dostarczania danych z wyliczaniem oczekiwanego czasu dostawy | Niska do średniej; harmonogramy + uczenie się wzorców | Średnie; historyczne logi dostaw i integracja | Wysokie ⭐⭐⭐; szybkie wykrywanie opóźnionych/brakujących ładowań | Pipeline'y ETL, dostawy danych krytyczne dla SLA | Predykcyjne alerty o awariach pipeline'ów |
Wykrywanie zmian schematu i monitorowanie struktury | Niska; ciągłe śledzenie schematu & mapowanie | Niskie do średnich; katalog metadanych i zależności | Wysokie ⭐⭐⭐; zapobiega awariom downstream | Strumienie od dostawców, zadania ETL, systemy wrażliwe na schemat | Alerty strukturalne w czasie rzeczywistym i historia wersji |
Analiza statystyczna i analiza trendów metryk danych | Średnia; modele statystyczne i interpretacja | Średnie; historyczne metryki i czas analityków | Wysokie ⭐⭐⭐; wgląd w trendy i wczesne sygnały ostrzegawcze | Zagregowane wskaźniki biznesowe, wykrywanie zmienności | Statystyka w kontekście; wykrywa stopniowe zmiany |
Obliczanie i analiza metryk bezpośrednio w bazie danych | Średnia; zapytania i optymalizacje specyficzne dla bazy | Niskie do średnich; wykorzystuje istniejące zasoby bazy | Wysokie ⭐⭐⭐; bezpieczne kontrole w czasie rzeczywistym przy minimalnym przenoszeniu danych | Środowiska z danymi wrażliwymi, organizacje skupione na zgodności | Zachowana rezydencja danych; mniej przenoszenia danych |
Monitorowanie biznesowych KPI i metryk operacyjnych | Średnia; definiowanie KPI, mapowanie i dashboardy | Średnie; wkład interesariuszy i narzędzia BI | Wysokie ⭐⭐⭐; łączy problemy z danymi z wpływem na biznes | Dashboardy zarządcze, śledzenie OKR, monitoring operacyjny | Łączy jakość danych z wynikami biznesowymi |
Obserwowalność platformy danych i workloadów | Wysoka; integruje telemetrię wielu komponentów | Wysokie; telemetria platformy, logi i narzędzia | Wysokie ⭐⭐⭐; całościowy obraz kondycji platformy i kosztów | Utrzymanie platformy, planowanie pojemności, optymalizacja kosztów | Wykrywa problemy infrastruktury wpływające na wiele zbiorów danych |
Kompleksowe dashboardy obserwowalności danych i wspólny monitoring | Średnia do wysokiej; UX, widoki według ról i integracje | Średnie; adopcja w wielu zespołach i narzędzia | Wysokie ⭐⭐⭐; szybsza reakcja na incydenty i lepsza koordynacja | Zespoły międzydziałowe potrzebujące wspólnego kontekstu | Scentralizowany widok; mniej silosów; wgląd według ról |
Modułowa architektura kontroli jakości z szybkim wdrożeniem | Na start niska do średniej; rozbudowa modułowa wymaga planu | Na start niskie; rosną wraz z modułami (opłata za tabelę) | Wysokie ⭐⭐⭐; szybki zwrot wartości i iteracyjne wdrażanie | Wdrażanie etapami, szablony branżowe, szybkie pilotaże | Szybkie wdrożenie; stopniowa rozbudowa; mniejsze ryzyko na starcie |
Buduj stos kontroli, a nie checklistę
Właściwe metody kontroli jakości danych zależą od awarii, którą musisz wychwycić. Walidacja rekordów to najlepsza pierwsza odpowiedź, gdy wymaganie jest jawne: niepusty identyfikator, dozwolona wartość, poprawny zakres, zgodne odwołanie lub reguła biznesowa, którą musi spełniać każdy rekord. Daje konkretne dowody i umożliwia celowaną naprawę, ale nie rozpozna każdego nieznanego wzorca.
Wykrywanie anomalii i analiza statystyczna obejmują zmiany zachowania. Uczenie się punktu odniesienia jest przydatne, gdy normalne zachowanie zmienia się wraz z sezonowością, wzrostem lub strukturą kategorii. Analiza statystyczna pomaga zespołom zrozumieć trendy, zmienność i zmiany rozkładów w czasie. Żadne z tych podejść nie powinno automatycznie blokować danych bez kontekstu. Uzasadniona kampania, przejęcie, migracja lub zdarzenie operacyjne mogą wyglądać nietypowo, więc właściciele potrzebują sposobu na wyjaśnienie i zatwierdzenie oczekiwanych zmian.
Monitorowanie terminowości dotyczy niezawodności dostaw. Informuje zespoły, że źródło dotarło z opóźnieniem, za wcześnie albo nie dotarło w oczekiwanym czasie. Połącz je z kontrolami wolumenu, aby odróżnić brakujące ładowanie od pustego lub częściowego. Śledzenie schematu obsługuje dryf strukturalny, w tym dodane lub usunięte kolumny i zmiany typów danych. Waga problemu powinna zależeć od zależności downstream. Nieszkodliwe rozszerzenie i zmiana identyfikatora, która coś psuje, nie powinny wywoływać tej samej reakcji.
Architektura ma znaczenie, gdy wymagania governance, prywatności lub rezydencji danych ograniczają ich przenoszenie. Wykonywanie w bazie danych pozwala zespołom obliczać metryki i uruchamiać kontrole tam, gdzie dane już się znajdują, choć nadal wymaga kontroli dostępu, optymalizacji zapytań i monitorowania obciążenia. Stos kontroli potrzebuje też kontekstu. Monitoring biznesowy pokazuje, czy zmiana techniczna wpływa na przychody, transakcje, operacje, wyniki kliniczne lub inny wskaźnik decyzyjny. Obserwowalność platformy pomaga zidentyfikować warunki dotyczące zasobów, obciążenia, dostępności i wydajności, które mogą wyjaśniać incydent.
Warstwa operacyjna decyduje, czy wykrycie prowadzi do poprawy. Przypisz właścicieli do krytycznych zbiorów danych, udokumentuj definicje biznesowe, połącz alerty z zarządzaniem incydentami i przechowuj dowody wyników pozytywnych i negatywnych razem z wersją reguły, która je wygenerowała. Stosuj kontrole blokujące dla naruszeń, które czynią dalsze użycie danych niebezpiecznym, a łagodne alerty o anomaliach tam, gdzie przed działaniem potrzebna jest analiza. Ustal progi zgodności dla jawnych kontroli, a tam, gdzie zachowanie zmienia się w czasie, używaj przedziałów ufności lub wyuczonych punktów odniesienia.
Rozsądne wdrożenie zaczyna się od krytycznych zbiorów danych, a nie od całego środowiska. Zmapuj ich odbiorców i historię awarii, wybierz pierwszą kontrolę dla luki o najwyższym ryzyku i uzgodnij właściciela oraz ścieżkę reakcji, zanim włączysz alerty. Następnie dodawaj uzupełniające się metody, na przykład walidację z monitorowaniem terminowości, wykrywanie anomalii z monitorowaniem schematu oraz wskaźniki biznesowe z telemetrią platformy. digna wspiera takie modułowe podejście modułami Data Anomalies, Data Validation, Timeliness, Schema Tracker, Business Monitoring i Data Platform Observability, wykonywanymi bezpośrednio w bazie danych.
Program powinien się rozrastać, gdy zespoły potrafią wykazać, że kontrole działają regularnie, incydenty trafiają do właściwych właścicieli, a naprawy usprawniają procesy upstream. Tak jakość danych staje się infrastrukturą operacyjną, a nie okresowym audytem czy długą checklistą, do której nikt nie wraca.
digna to platforma jakości i obserwowalności danych dla przedsiębiorstw, działająca w środowisku klienta i łącząca walidację, wykrywanie anomalii, terminowość, schemat oraz monitoring biznesowy i monitoring platformy. Wykorzystaj ją do budowy uzupełniających się warstw kontroli wokół krytycznych zbiorów danych, poznaj modułową platformę na stronie digna i zaplanuj pierwsze wdrożenie wokół rodzaju awarii, który ma dla Ciebie największe znaczenie.
Jeśli zastanawiasz się, którą warstwę wdrożyć jako pierwszą, rozwiązanie digna do zarządzania jakością danych pokazuje, jak Data Validation, Data Anomalies, Timeliness i Schema Tracker działają jako oddzielne moduły w Twojej własnej bazie danych. Możesz zacząć od jednej kontroli i dodawać kolejne w miarę rozszerzania pokrycia.
Najczęściej zadawane pytania
Jakie są główne metody kontroli jakości danych?
Główne metody to wykrywanie anomalii, walidacja na poziomie rekordów, monitorowanie terminowości, wykrywanie zmian schematu, statystyczna analiza trendów, obliczenia w bazie danych, monitorowanie KPI, obserwowalność platformy, wspólne dashboardy i modułowe wdrażanie. Każda z nich wychwytuje inny rodzaj awarii, dlatego artykuł zaleca łączenie ich w uzupełniające się warstwy zamiast polegania na jednym zestawie reguł.
Czym różni się walidacja danych od wykrywania anomalii?
Walidacja dowodzi, że konkretny wiersz naruszył znaną regułę, a wykrywanie anomalii sygnalizuje zachowanie odbiegające od wyuczonego punktu odniesienia. Reguły wskazują dokładny rekord i dają ścieżkę audytu, ale przeoczają nieznane zmiany, takie jak spadek wolumenu, który wygląda na uzasadniony. W praktyce najpierw znajduje się nieoczekiwane zjawiska dzięki anomaliom, a potem dowodzi błędów walidacją.
Jak ustalać progi dla statystycznych alertów jakości danych?
Stosuj przedziały ufności lub reguły odchylenia kroczącego zamiast arbitralnych stałych limitów. Jedno z udokumentowanych podejść generuje alert, gdy metryka wychodzi poza 99% przedział ufności dla tego samego dnia w poprzednim roku lub odchyla się o więcej niż 3 odchylenia standardowe od średniej kroczącej. Najpierw wyklucz awarie i migracje z historii, na której opiera się punkt odniesienia.
Po co monitorować terminowość danych, skoro dane są już zwalidowane?
Ponieważ zbiór danych może być kompletny i poprawny, a mimo to bezużyteczny, jeśli dotrze po uruchomieniu porannego raportu. Monitorowanie terminowości porównuje rzeczywiste dostawy z oczekiwanym czasem dostawy dla każdego źródła, a połączenie go z kontrolami wolumenu pozwala odróżnić spóźniony plik od takiego, który dotarł na czas, ale pusty.
Od czego zespół powinien zacząć wdrażanie kontroli jakości danych?
Zacznij od oceny jakości krytycznych zbiorów danych, a następnie wybierz pierwszą kontrolę dla luki o najwyższym ryzyku: terminowość dla brakujących ładowań, śledzenie schematu dla wadliwych strumieni od dostawców, walidację dla błędnych pól. Artykuł sugeruje zaplanowanie rozbudowy na 6 do 12 miesięcy, z kamieniami milowymi powiązanymi z pokryciem i naprawami.


