Wzorzec projektowy danych: przewodnik dla nowoczesnych zespołów
|
8
min. czyt.

Zespół ma hurtownię danych, pipeline strumieniowy i dashboardy, które podają różne wartości tej samej metryki klienta. Jeden analityk ufa tabeli finansowej, drugi - martowi działowemu, a trzeci dodał filtr, żeby wczorajszy raport się uzgadniał. Problem niekoniecznie leży w technologii bazodanowej. Chodzi o to, że nikt nie uzgodnił wzorca projektowego danych, czyli zasad określających, jak informacje są kształtowane, zarządzane i sprawdzane po uruchomieniu na produkcji.
Użyteczny wzorzec to coś więcej niż atrakcyjny diagram architektury. Daje inżynierom powtarzalny sposób na pozyskiwanie danych, łączenie powiązanych faktów, obsługę różnych obciążeń i ujawnianie awarii, zanim użytkownicy podejmą decyzje na podstawie błędnych informacji. Najlepsze wzorce jasno określają też odpowiedzialność, definiują dopuszczalne zmiany i zachowują dowody na to, co system wiedział w danym momencie.
Spis treści
Czym właściwie jest wzorzec projektowy danych
Zespoły zwykle sięgają po wzorzec po pierwszym bolesnym sporze. Pipeline działa dla jednego działu, potem inny zespół potrzebuje tych samych danych z inną definicją, harmonogramem dostaw lub historią. Inżynierowie zaczynają dodawać wyjątki. Analitycy tworzą zduplikowane transformacje. W końcu organizacja ma kilka odpowiedzi na pytanie, które powinno mieć jedną odpowiedź.
Warto traktować wzorzec projektowy danych jak przepis kulinarny. Przepis nie narzuca marki piekarnika ani koloru talerzy. Określa składniki, kolejność przygotowania, relacje między elementami i kontrole, które mówią kucharzowi, czy danie można bezpiecznie podać. Wzorzec danych robi to samo dla systemów informacyjnych.

Struktura to dopiero pierwsza warstwa
Wzorzec to wielokrotnego użytku odpowiedź na powtarzający się problem projektowy. Może porządkować analityczne fakty i wymiary, zachowywać każde zdarzenie biznesowe, centralizować wspólne definicje albo pozwalać domenom publikować produkty danych według wspólnych standardów. Wzorzec daje zespołowi słownictwo do podejmowania decyzji, zanim górę wezmą szczegóły implementacji.
Diagram architektury pokazuje komponenty i połączenia. Wzorzec idzie dalej, wyjaśniając, dlaczego te komponenty istnieją i jak zachowują się przy zmianach. Dwa diagramy mogą wyglądać podobnie, a dawać zupełnie różne rezultaty, jeśli jeden definiuje własność, historię i walidację, a drugi pozostawia te kwestie bez odpowiedzi.
Praktyczny wzorzec odpowiada na trzy pytania:
Jak dane są ukształtowane? Należy określić encje, zdarzenia, relacje, ziarnistość, klucze, historię i modele udostępniania.
Jak dane są zarządzane? Należy zdefiniować własność, nazewnictwo, znaczenie biznesowe, dostęp, lineage i zasady kompatybilności.
Jak awaria staje się widoczna? Należy określić oczekiwania co do świeżości, kontrole walidacyjne, monitorowanie schematu, progi anomalii i ścieżkę eskalacji.
Praktyczna zasada: Jeśli wzorzec nie wyjaśnia, co się dzieje, gdy ładowanie się opóźnia lub pole zmienia typ, jest to szkic struktury, a nie projekt operacyjny.
To rozróżnienie ma znaczenie, zanim wybierze się hurtownię danych, lakehouse, brokera wiadomości czy narzędzie do orkiestracji. Technologia może zaimplementować wzorzec, ale nie rozstrzygnie, czy historia adresów klienta należy do niemutowalnego strumienia zdarzeń, tabeli bieżącego stanu, czy do obu. Zespół musi najpierw podjąć tę decyzję, a następnie konsekwentnie ją zakodować.
Jak korporacyjne hurtownie danych dały nam pierwsze wzorce
Pod koniec lat 80. przedsiębiorstwa próbowały przekształcić informacje rozproszone w systemach operacyjnych w coś, z czego kadra zarządzająca mogłaby korzystać przy analizach. Artykuł w IBM Systems Journal opublikowany w 1988 roku użył określenia „business data warehouse”, co było ważnym krokiem w sformalizowaniu idei integrowania informacji z wielu systemów operacyjnych na potrzeby analizy biznesowej. William Inmon rozwinął później korporacyjny wzorzec hurtowni i w 1992 roku wydał książkę Building the Data Warehouse.
Weźmy organizację z sektora ochrony zdrowia, która chce odpowiedzieć na proste pytanie: ile każdy oddział wydał na dany epizod leczenia pacjenta? Systemy źródłowe mogą osobno rejestrować wizyty, roszczenia, płatności i informacje o świadczeniodawcach. W podejściu Inmona organizacja najpierw przenosi szczegółowe, historyczne, zintegrowane dane do centralnej hurtowni korporacyjnej. Warstwa integracyjna ogranicza niespójne definicje, zanim zespoły downstream otrzymają podzbiory tematyczne. Wzorzec Inmona wykorzystuje zazwyczaj znormalizowane struktury relacyjne, które wspierają identyfikowalność i ograniczają redundancję we wspólnej warstwie.
Takie podejście traktuje hurtownię jako starannie zarządzaną księgę znaczeń organizacji. Zespół finansowy i zespół operacji klinicznych mogą nadal otrzymywać różne widoki, ale oba dziedziczą te same, zarządzane fundamenty.
Wymiarowe podejście Ralpha Kimballa zaczyna się od innego pytania: jaki proces biznesowy użytkownicy muszą analizować? Jego metoda, sformalizowana w książce The Data Warehouse Toolkit, wydanej po raz pierwszy w 1996 roku, spopularyzowała tabele faktów, tabele wymiarów, schematy gwiazdy i wymiary uzgodnione. Zespół z sektora ochrony zdrowia mógłby zbudować tabelę faktów roszczeń połączoną z wymiarami pacjenta, świadczeniodawcy, oddziału, płatnika i czasu. Analitycy mogą bezpośrednio odpytywać proces biznesowy bez poruszania się po silnie znormalizowanym modelu korporacyjnym.
Większość organizacji łączy obie filozofie. Utrzymują warstwę kanoniczną lub zintegrowaną dla wspólnych znaczeń, lineage i governance, a następnie publikują marty wymiarowe do raportowania i analizy KPI. Ta hybryda jest nadal widoczna w nowoczesnych architekturach korporacyjnych hurtowni danych, nawet gdy infrastrukturą bazową jest chmurowa hurtownia danych lub lakehouse.
Trwała lekcja jest prosta. To, gdzie mieszka prawda, i to, jak jest konsumowana, to powiązane decyzje, ale nie ta sama decyzja.
Modelowanie wymiarowe w praktyce
Zespół sprzedaży rzadko pyta: „Czy mogę przejrzeć wasz znormalizowany model relacyjny?”. Pyta raczej: „Ile sprzedaliśmy, komu, w którym sklepie i w jakim okresie?”. Modelowanie wymiarowe sprawdza się, ponieważ organizuje dane wokół takich pytań biznesowych.
Punktem wyjścia jest mierzalne zdarzenie, na przykład pozycja zamówienia. Tabela faktów przechowuje liczbowe i operacyjne szczegóły zdarzenia, w tym ilość, przychód, rabat, znacznik czasu zamówienia, klucz produktu, klucz klienta i klucz sklepu. Tabele wymiarów dostarczają kontekstu opisowego, który czyni każdy wiersz użytecznym. Produkt opisuje towar, klient opisuje nabywcę, sklep opisuje lokalizację, a czas dostarcza atrybutów kalendarzowych i sprawozdawczych.
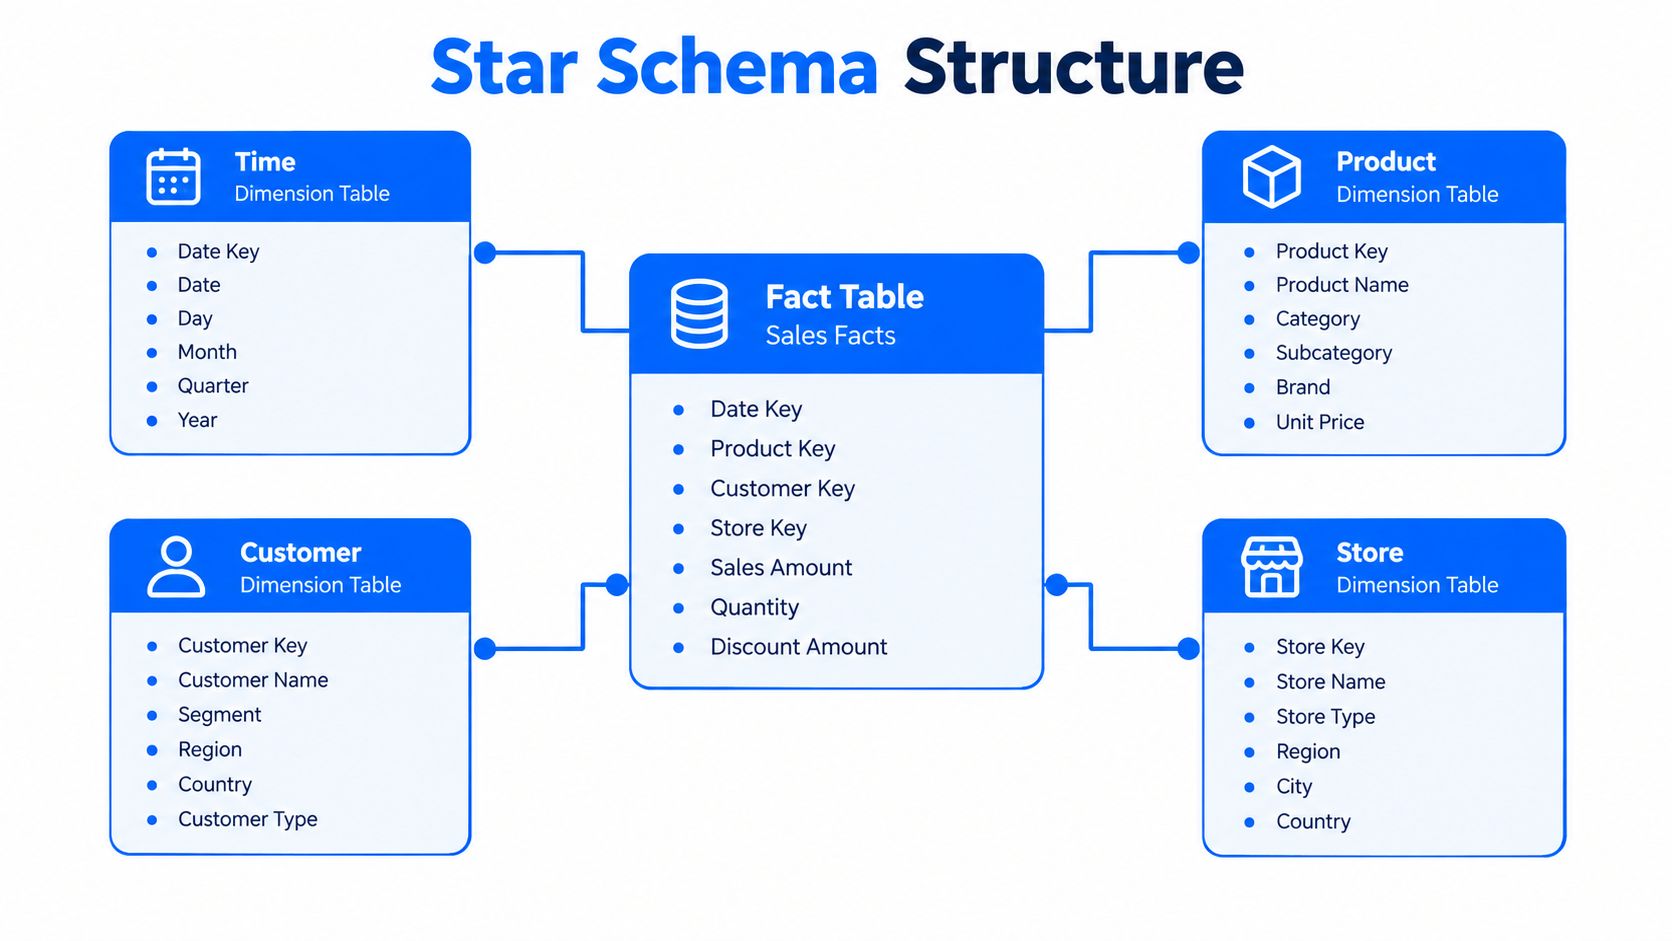
Ziarnistość przed kolumnami
Przed dodaniem pól należy określić ziarnistość w jednym zdaniu: „Jeden wiersz reprezentuje jeden produkt w jednym zamówieniu”. To zdanie zapobiega częstemu błędowi - mieszaniu wartości na poziomie zamówienia i na poziomie pozycji w tej samej tabeli faktów. Jeśli przychód powtarza się w kilku wierszach produktów, zwykła suma może zawyżyć sprzedaż.
Wymiar uzgodniony używa tej samej definicji biznesowej we wszystkich martach. Jeśli wymiar klienta oznacza w finansach „klienta, któremu wystawiono fakturę”, a w analityce produktowej „użytkownika końcowego”, wspólna nazwa tworzy fałszywą spójność. Zespoły muszą zdefiniować znaczenie, klucze, historię i dopuszczalne relacje, a następnie udostępnić te zasady każdemu konsumentowi. Wskazówki dotyczące tabel faktów i wymiarów mogą pomóc zespołom ustalić to słownictwo, zanim zaczną budować raporty.
Dokładność historyczna wymaga kolejnej decyzji projektowej. Załóżmy, że klient zmienia segment z małej firmy na przedsiębiorstwo. Wymiar bieżącego stanu pokaże najnowszy segment, ale historyczny raport sprzedaży może potrzebować segmentu obowiązującego w chwili złożenia każdego zamówienia. Techniki wolno zmieniających się wymiarów zachowują odpowiednią historię, w zależności od tego, czy biznes chce zachować poprzednie wartości, nadpisać je, czy rejestrować okresy obowiązywania.
Gdzie ten wzorzec się sprawdza
Modelowanie wymiarowe się opłaca, gdy dominujące pytania dotyczą tego, ile, jak często, gdzie, kiedy lub przez kogo. Schematy gwiazdy są przystępne dla analityków, zapewniają przewidywalne złączenia i ułatwiają współdzielenie logiki KPI. Stabilny kontrakt fakt-wymiar daje też zespołom ds. jakości jasne miejsca do sprawdzania integralności referencyjnej, odsetka wartości null, zduplikowanych kluczy i nieoczekiwanych miar.
Wzorzec napotyka ograniczenia, gdy obciążenie opiera się na nieregularnych dokumentach, dużych wolumenach nieustrukturyzowanych zdarzeń lub rekonstrukcji każdej zmiany stanu na poziomie wymaganym przez audyt. Może reprezentować takie dane wejściowe, ale wciskanie każdego problemu w schemat gwiazdy często ukrywa pierwotną historię zdarzeń. Dlatego wiele dojrzałych platform zachowuje surowe lub kanoniczne rekordy i udostępnia marty wymiarowe jako warstwę serwującą.
Event sourcing i myślenie w kategoriach append-only
Saldo bankowe wygląda jak wartość bieżącego stanu, ale uzgodnienie zależy od stojącej za nim historii. Jeśli saldo zostanie błędnie zmienione, a system przechowuje tylko najnowszą liczbę, osoby wyjaśniające sprawę nie mają wiarygodnego sposobu na odtworzenie, jak powstało.
Event sourcing przyjmuje odwrotne podejście. Zamiast aktualizować wiersz salda w miejscu, system rejestruje zdarzenia, takie jak wpłata, wypłata, przelew czy korekta. Bieżące saldo staje się projekcją obliczaną z tej uporządkowanej historii.

Od zdarzeń do użytecznego stanu
Wzorzec składa się z trzech praktycznych elementów:
Magazyn zdarzeń append-only: Każda zmiana biznesowa jest rejestrowana jako nowe zdarzenie. Istniejące zdarzenia nie są nadpisywane.
Projekcja: Konsument odczytuje zdarzenia i buduje reprezentację, którą można odpytywać, na przykład bieżące saldo rachunku.
Odtwarzanie i korekta: Jeśli logika projekcji się zmieni lub stan zostanie uszkodzony, zespół może go odbudować z historii zdarzeń.
Korekta nie usuwa pierwotnej transakcji. Dodaje zdarzenie kompensujące, które zachowuje chronologię. Dzięki temu system jest przydatny do audytu, debugowania, analizy historycznej i odtwarzania incydentów.
Model odczytu może nie aktualizować się dokładnie w tym samym momencie co log zdarzeń. Zespoły muszą więc akceptować i komunikować spójność ostateczną (eventual consistency) tam, gdzie pasuje ona do procesu biznesowego. Potrzebują też wersjonowania zdarzeń, idempotentnych konsumentów, reguł kolejności, decyzji dotyczących retencji oraz strategii snapshotów na wypadek, gdy odtwarzanie długiej historii staje się kosztowne.
Wybierać dla identyfikowalności, nie dla mody
Event sourcing to solidny fundament, gdy biznes musi odpowiedzieć na pytanie: „Co się stało, w jakiej kolejności i dlaczego bieżący stan wygląda tak, a nie inaczej?”. Naturalnymi kandydatami są księgi finansowe, historie przepływów pracy, ruchy magazynowe i rozproszone zdarzenia domenowe.
Nie jest to dobry domyślny wybór dla każdej aplikacji CRUD. Odczyty stają się bardziej złożone, ponieważ użytkownicy często potrzebują projekcji, a nie logu źródłowego. Zespoły muszą utrzymywać kod projekcji i radzić sobie z opóźnioną zbieżnością. Zwykła tabela bieżącego stanu może być czytelniejsza, gdy biznes potrzebuje tylko najnowszej wartości i nie wymaga historii, którą da się odtworzyć.
Zespoły lakehouse mogą łączyć ingestię zorientowaną na zdarzenia z otwartym formatem tabel i zmaterializowanymi modelami serwującymi. Przegląd otwartych formatów tabel zapewnia przydatny kontekst do oddzielenia trwałej historii danych od modeli odpytywanych przez konsumentów.
Log zdarzeń jest dowodem. Projekcja jest wygodną interpretacją.
Modele kanoniczne a własność domenowa
Model kanoniczny zakłada, że organizacja powinna uzgodnić wspólne definicje w warstwie integracyjnej. Model należący do domen zakłada, że zespół najbliższy danej zdolności biznesowej powinien publikować użyteczny produkt danych i brać odpowiedzialność za jego jakość.
Żadne z tych stanowisk nie rozwiązuje wszystkich problemów. Model centralny może zapobiegać sprzecznym definicjom, ale centralny zespół może stać się kolejką dla każdej zmiany. Model domenowy może przybliżyć decyzje do źródła, ale oddzielne zespoły mogą publikować niekompatybilne znaczenia pojęć „klient”, „aktywne konto” czy „zrealizowane zamówienie”.
Wymiar | Model kanoniczny | Data Mesh |
|---|---|---|
Własność | Centralny zespół danych lub integracji zarządza wspólnymi definicjami | Zespoły domenowe są właścicielami produktów danych tworzonych z ich zdolności biznesowych |
Governance | Spójne reguły korporacyjne łatwiej egzekwować centralnie | Sfederowane standardy koordynują zespoły, nie odbierając domenom odpowiedzialności |
Szybkość dostarczania | Zmiany międzydomenowe mogą wymagać centralnego przeglądu i uzgodnień | Domeny mogą iterować szybciej w ramach wspólnych reguł interoperacyjności |
Ryzyko | Zespół centralny może stać się wąskim gardłem lub oddalić się od kontekstu źródłowego | Definicje, jakość i interfejsy mogą się rozjechać bez silnych kontraktów |
Argumenty za modelem kanonicznym
Modele kanoniczne sprawdzają się w organizacjach, które potrzebują wspólnego słownika regulacyjnego, wspólnych kontroli finansowych lub identyfikowalności między działami. Warstwa integracyjna działa jak słownik. Rozwiązuje różnice między systemami źródłowymi, zanim analitycy i aplikacje zaczną korzystać z danych.
Ceną jest koordynacja. Centralny zespół musi rozumieć wiele domen, zarządzać wnioskami o zmiany i utrzymywać aktualność modelu w miarę rozwoju biznesu. Jeśli stanie się jedyną grupą uprawnioną do publikowania użytecznych danych, dostarczanie zwalnia, a eksperci domenowi tracą poczucie własności.
Argumenty za podejściem domenowym
Data mesh przypisuje własność domenom, takim jak rozliczenia, logistyka czy obsługa klienta. Każda domena publikuje dane jako produkt, z dokumentacją, oczekiwaniami co do jakości, kontrolą dostępu i zobowiązaniem dotyczącym poziomu usług. Sfederowana warstwa governance nadal definiuje wspólne zasady interoperacyjności, bezpieczeństwa i wyszukiwania danych.
Działa to tylko wtedy, gdy zespoły domenowe mają umiejętności i zasoby do obsługi produktów danych. Organizacja musi zapewnić wspólne narzędzia i egzekwować kontrakty, w przeciwnym razie decentralizacja zamienia się w zduplikowane pipeline'y oparte na różnych założeniach. Zespołom pracującym na granicach domen może się też przydać ten przewodnik po modelowaniu agregatów dla SaaS, zwłaszcza gdy trzeba dopasować własność biznesową do granic systemów.
Praktyczny kompromis polega na utrzymaniu warstwy kanonicznej dla wspólnych pojęć wysokiego ryzyka i pozwoleniu domenom publikować wokół niej wyspecjalizowane produkty. Sfederowane data governance może wspierać tę równowagę, określając, co musi być spójne wszędzie, a co domeny mogą dostosowywać lokalnie.
Porównanie trzech podstawowych wzorców
Trzy wzorce rozwiązują różne podstawowe problemy. Modelowanie wymiarowe optymalizuje nawigację analityczną. Event sourcing zachowuje sekwencję zmian. Modelowanie kanoniczne ustanawia wspólne znaczenia w różnych systemach i zespołach.
Różnice między nimi stają się wyraźniejsze, gdy ocenia się je pod kątem obciążenia, a nie osobistych preferencji.
Kryterium | Modelowanie wymiarowe | Event sourcing | Model kanoniczny |
|---|---|---|---|
Wydajność zapytań | Mocna strona przy powtarzalnych zapytaniach BI i agregacjach | Często wymaga projekcji lub snapshotów dla wygodnych odczytów | Zależy od warstwy serwującej, struktury znormalizowane mogą wymagać modeli downstream |
Dopasowanie do governance | Jasne kontrakty metryk i wymiarów | Mocna historia i identyfikowalność, przy większej dyscyplinie w zarządzaniu zdarzeniami | Najlepszy dla centralnych definicji, lineage i regulowanych danych współdzielonych |
Gotowość na AI | Przydatny dla wyselekcjonowanych cech i oznaczonych metryk biznesowych | Cenny przy odtwarzaniu, cechach czasowych i historiach zachowań | Przydatny dla spójnych cech i wspólnej semantyki między domenami |
Koszt operacyjny | Umiarkowany, obejmuje modelowanie i utrzymanie wymiarów historycznych | Wyższy, bo trzeba obsługiwać logi, projekcje, wersjonowanie i odtwarzanie | Wyższy koszt koordynacji, zwłaszcza gdy wiele domen zależy od zmian centralnych |
Najlepsze pytanie na start | „Co użytkownicy powinni agregować i porównywać?” | „Jaka sekwencja doprowadziła do tego stanu?” | „Którą definicję musi współdzielić każdy system?” |
Tabela nie wskazuje uniwersalnego zwycięzcy, ponieważ realna platforma często potrzebuje wszystkich trzech wzorców. Warstwa kanoniczna może ustanowić wspólne definicje klienta, produktu i finansów. Marty wymiarowe mogą przekształcić te definicje w przystępne modele raportowe. Logi zdarzeń mogą zachować dowody potrzebne do odtworzenia lub audytu ważnych zmian.
Zdiagnozować dominujące obciążenie
Warto zapytać zespół, która awaria byłaby najbardziej dotkliwa:
Wolny lub niejasny raport: Zacząć od modelowania wymiarowego i zdefiniować ziarnistość każdego faktu.
Zmiana stanu, której nie da się prześledzić: Zachowywać zdarzenia i budować projekcje z historii append-only.
Sprzeczne definicje korporacyjne: Ustanowić pojęcia kanoniczne, własność i kontrolę zmian.
Dane wejściowe AI, które dryfują bez ostrzeżenia: Dodać monitorowanie zachowania i przypisać własność do dowolnie wybranego wzorca strukturalnego.
Gotowość na AI to nie tylko kwestia przechowywania danych. Embeddingi, rozkłady cech, wyniki wyszukiwania i aktualność danych wejściowych modelu mogą się zmieniać, podczas gdy schemat tabeli pozostaje poprawny. Wzorzec, który zarządza wyłącznie kolumnami, może przeoczyć awarię semantyczną.
Dlaczego przejrzysty diagram nie wystarczy
Tablica może pokazać dopracowany przepływ od systemów źródłowych do hurtowni danych, martu, dashboardu i modelu. Nie pokaże jednak, kto otrzyma alert, gdy wczorajszy plik dotrze z opóźnieniem, która reguła waliduje kwotę roszczenia ani jak audytor udowodni, że raport wykorzystał poprawne dane w określonym momencie historycznym.
Ta luka zamienia architekturę w ryzyko operacyjne. Niezawodny wzorzec definiuje oczekiwane zachowanie dostaw, miejsce walidacji, własność, politykę kompatybilności i dowody przechowywane po każdym ważnym ładowaniu.
Kontrole zaufania tuż przy przepływie danych
Zespół wybierający wzorzec powinien określić kontrole w trzech punktach:
Ingestia: Sprawdzanie dotarcia danych, wolumenu, podstawowej struktury, duplikatów i pól wymaganych.
Transformacja: Walidacja reguł biznesowych, relacji, dopuszczalnych wartości i logiki uzgadniania.
Konsumpcja: Monitorowanie zachowania KPI, świeżości widocznej dla użytkowników, awarii downstream i przydatności danych wejściowych modelu.
Ewolucja schematu wymaga takiego samego podejścia. Dodawane pola dopuszczające wartość null mogą być kompatybilne z istniejącymi konsumentami, podczas gdy zawężenie typu lub zmiana nazwy o znaczeniu semantycznym mogą je zepsuć. Układ partycji powinien w miarę możliwości pozostać kwestią implementacyjną, tak aby konsumenci odpytywali tabele logiczne, a nie zakodowane na sztywno ścieżki katalogów. Ewolucja sterowana metadanymi, opisana w wytycznych projektowych Apache Iceberg, pozwala zmieniać układ fizyczny, a jednocześnie pliki historyczne zachowują swoje pierwotne specyfikacje.
Dowody zmieniają standard
Ponad 56% respondentów badania wśród inżynierów analityki wskazało jakość danych jako najczęściej zgłaszane wyzwanie, a 38% planowało zwiększyć inwestycje w jakość danych lub observability w kolejnym roku, według raportu dbt State of Analytics Engineering 2025. Te liczby prowadzą do praktycznego wniosku: governance i observability należą do wzorca, a nie do późniejszego backlogu operacyjnego.
Wiarygodny projekt sprawia, że błędne dane łatwiej znaleźć, wyjaśnić, odizolować i poprawić.
Dla każdego krytycznego zbioru danych należy rejestrować właściciela, oczekiwane zachowanie dostaw, wersję schematu, wyniki walidacji, lineage i historię incydentów. Następnie trzeba zdefiniować, co się dzieje, gdy kontrola zakończy się niepowodzeniem. Czy pipeline się zatrzymuje, poddaje rekordy kwarantannie, publikuje ostrzeżenie, czy kontynuuje z jawnym statusem ograniczonej jakości? Właściwa odpowiedź zależy od wpływu na biznes, ale pozostawienie jej nieokreślonej gwarantuje niespójne reakcje.
Wybór i wdrożenie operacyjne wzorca
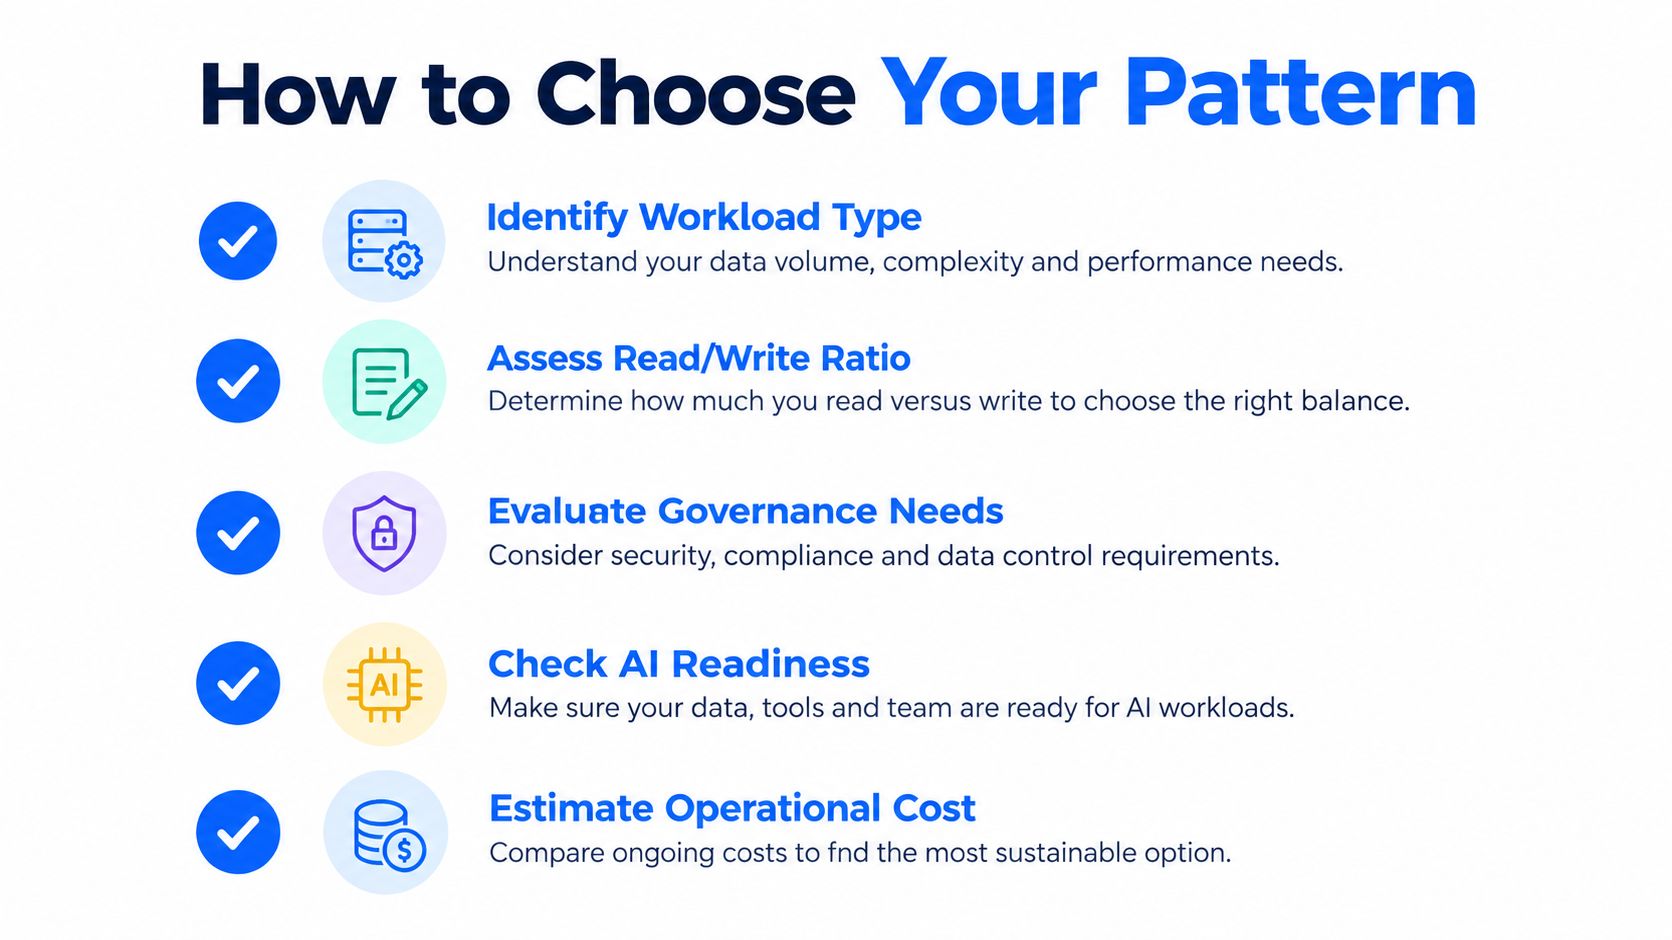
Warto przeprowadzić krótki przegląd projektu i zapisać pięć decyzji:
Określić dominujące obciążenie. Raportowanie, audyt, serwowanie operacyjne, reagowanie w czasie rzeczywistym i generowanie cech dla AI wymagają różnych struktur.
Wybrać wzorzec główny. Wybrać model, który rozwiązuje najważniejszy problem, a następnie świadomie dodawać warstwy pomocnicze.
Zdefiniować kontrakty. Określić ziarnistość, klucze, znaczenia, oczekiwania co do świeżości, kompatybilność schematu i własność.
Dołączyć kontrole. Dodać monitorowanie dotarcia danych, walidację rekordów, wykrywanie anomalii, alerty o dryfie schematu, lineage i dowody historyczne.
Przetestować zachowanie w razie awarii. Zasymulować opóźnione dane, nieoczekiwane wartości, zmiany strukturalne, zduplikowane zdarzenia i odbudowę projekcji.
W przypadku obciążeń AI listę kontrolną należy rozszerzyć poza kolumny. Trzeba zdecydować, jak zespół będzie wykrywał dryf embeddingów, zmiany rozkładu cech, pogorszenie wyników wyszukiwania i nieaktualne dane wejściowe modelu. Technicznie poprawna tabela wciąż może prowadzić do zawodnego modelu, jeśli jej zachowanie zmienia się bez odpowiedzialnego właściciela.
Platforma taka jak podejście digna do zarządzania produktami danych może wpisać się w tę warstwę operacyjną, łącząc walidację w bazie danych, monitorowanie terminowości, wykrywanie anomalii i śledzenie zmian schematu w środowisku klienta. Najważniejszą decyzją nie jest samo narzędzie. Chodzi o to, czy wzorzec daje wskazanym osobom wystarczające dowody, by mogły działać, gdy dane przestają zachowywać się zgodnie z oczekiwaniami.
digna pomaga zespołom monitorować zachowanie danych w ich własnym środowisku dzięki walidacji w bazie danych, monitorowaniu terminowości, wykrywaniu anomalii i śledzeniu zmian schematu. Jeśli statyczny diagram architektury ma stać się operacyjnym kontraktem zaufania, warto odwiedzić digna i sprawdzić, jak platforma może wesprzeć tę pracę.
Ponieważ zawężenie typu lub zmiana nazwy o znaczeniu semantycznym mogą zepsuć działanie konsumentów, mimo że każdy pipeline nadal działa, Schema Tracker w digna rejestruje zmiany strukturalne w monitorowanych tabelach, dzięki czemu za polityką kompatybilności we wzorcu stoi realny alert.
Najczęściej zadawane pytania
Czym jest wzorzec projektowy danych?
Wzorzec projektowy danych to wielokrotnego użytku odpowiedź na powtarzający się problem z danymi, obejmująca trzy kwestie: jak dane są ukształtowane, jak są zarządzane i jak awaria staje się widoczna. Podobnie jak przepis określa składniki, kolejność i kontrole, a nie markę piekarnika, dlatego kieruje decyzjami, zanim wybierze się jakąkolwiek hurtownię danych lub narzędzie.
Czym różnią się podejścia Inmona i Kimballa?
Inmon zaczyna od centralnej, znormalizowanej hurtowni korporacyjnej, która integruje szczegółową historię, zanim zespoły otrzymają podzbiory tematyczne. Kimball zaczyna od procesu biznesowego, budując tabele faktów, tabele wymiarów i schematy gwiazdy do bezpośredniej analizy. Większość organizacji łączy oba podejścia, utrzymując warstwę zintegrowaną dla wspólnych znaczeń i publikując marty wymiarowe do raportowania.
Dlaczego najpierw należy zdefiniować ziarnistość tabeli faktów?
Określenie ziarnistości, na przykład jeden wiersz na jeden produkt w jednym zamówieniu, zapobiega mieszaniu wartości na poziomie zamówienia i na poziomie pozycji w tej samej tabeli. Bez niej przychód powtórzony w kilku wierszach produktów jest sumowany wielokrotnie i zawyża sprzedaż. Zdanie opisujące ziarnistość należy zapisać przed dodaniem jakichkolwiek kolumn.
Kiedy stosować event sourcing zamiast tabeli bieżącego stanu?
Event sourcing warto stosować, gdy biznes musi wyjaśnić, co się stało, w jakiej kolejności i dlaczego bieżący stan wygląda tak, a nie inaczej. Dobrze pasuje do ksiąg finansowych, historii przepływów pracy i ruchów magazynowych. W aplikacjach CRUD, które potrzebują tylko najnowszej wartości, zwykła tabela jest czytelniejsza, ponieważ projekcje i spójność ostateczna generują realne koszty operacyjne.
Czy platforma danych powinna korzystać z modelu kanonicznego, czy z data mesh?
Często z obu. Praktyczny kompromis polega na utrzymaniu warstwy kanonicznej dla wspólnych pojęć wysokiego ryzyka, takich jak definicje klienta, produktu i finansów, podczas gdy zespoły domenowe publikują wokół niej wyspecjalizowane produkty danych. Sfederowane governance decyduje następnie, co musi być spójne wszędzie, a co domeny mogą dostosowywać lokalnie, unikając zarówno centralnego wąskiego gardła, jak i rozbieżnych definicji.


