Analiza zagrożeń operacyjnych dla zespołów danych
|
6
min. czyt.

Wiele zespołów wciąż traktuje analizę zagrożeń operacyjnych jak formalność do odhaczenia. Spisują listę kontrolną, zatwierdzają wydanie i zakładają, że obraz ryzyka pozostanie stabilny aż do następnego przeglądu. Ten nawyk zawodzi w nowoczesnych operacjach na danych i AI, gdzie najistotniejsze awarie pojawiają się zwykle po wdrożeniu, a nie przed nim.
Statyczne przeglądy pomijają sygnały, które zmieniają wyniki: dryf schematu, opóźnione ładowania, uszkodzone ścieżki walidacji, zmieniające się uprawnienia automatyzacji oraz ludzkie obejścia, które nigdy nie trafiają do dokumentu sporządzanego przed uruchomieniem. Bezpieczniejszym wzorcem jest ciągła, oparta na danych analiza zagrożeń, w której metryki observability pełnią rolę bieżących dowodów, a każda zmiana w środowisku operacyjnym może ponownie otworzyć kwestię ryzyka.
Spis treści
Nowe spojrzenie na analizę zagrożeń operacyjnych w operacjach na danych
Analiza zagrożeń operacyjnych działa tylko wtedy, gdy podąża za systemem, a nie za kalendarzem. Jednorazowy przegląd może wychwycić oczywiste wady projektowe, ale nie nadąży za pipeline'em, którego dane źródłowe, logika orkiestracji lub sposób wykorzystania na dalszych etapach zmieniają się z tygodnia na tydzień. Ta luka ma znaczenie, ponieważ zagrożenie rzadko sprowadza się do jednego objawu. Zwykle ujawnia się jako łańcuch drobnych awarii, które zbiegają się w niewłaściwym momencie.
Dlaczego jednorazowe przeglądy zawodzą
Pipeline może przejść listę kontrolną przed uruchomieniem, a mimo to później stać się ryzykowny. Zespół w systemie źródłowym zmienia schemat, transformacja nadal działa, tabela raportowa wypełnia się wartościami null, a biznes wciąż działa na podstawie nieaktualnych danych, ponieważ nikt nie powiązał tych zdarzeń ze sobą. Właśnie tutaj liczy się myślenie w kategoriach cyklu życia, bo zagrożeniem nie jest sama zmiana schematu, lecz ścieżka przyczynowa od zmiany do błędnej decyzji.
Praktyczna zasada: Jeśli środowisko może się zmienić bez formalnego wydania, analiza zagrożeń musi się zmieniać bez czekania na kwartalny przegląd.
Data observability staje się w tym kontekście czymś więcej niż udogodnieniem inżynieryjnym. Gdy opóźnienia, nieudane walidacje, nieciągłości liczby wierszy lub dryf schematu są rejestrowane jako dowody operacyjne, stają się materiałem wyjściowym dla analizy zagrożeń, a nie tylko szumem na dashboardzie. Zespół, który traktuje te sygnały jako dane wejściowe dla bezpieczeństwa, może zareagować, zanim problem przerodzi się w utratę raportów, degradację modelu lub awarię kontroli.
Data observability sprawdza się najlepiej, gdy jest wpięta w ten sam sposób myślenia o kontroli, który stosują programy bezpieczeństwa w branżach regulowanych. Właściwym pytaniem nie jest to, czy pipeline „przeszedł”. Chodzi o to, czy system nadal zachowuje się tak, jak zakładała analiza zagrożeń.
Od jakościowych list kontrolnych do modeli ilościowych

Współczesna dyscyplina nie zaczęła się od dashboardów. Zaczęła się wtedy, gdy inżynierowie bezpieczeństwa przestali uważać ogólne listy kontrolne za wystarczające i zaczęli modelować, w jaki sposób awarie się łączą. Analiza drzewa błędów (Fault Tree Analysis) pojawiła się na początku lat 60. XX wieku jako metoda dedukcyjna, która zaczyna od niepożądanego zdarzenia na poziomie systemu i cofa się do awarii komponentów, działań ludzi i warunków zewnętrznych, które mogłyby je wywołać. Bell Laboratories opracowało ją około 1961–1962 roku dla systemu kontroli startu pocisków Minuteman, a Boeing przyjął ją w 1963 roku do analizy bezpieczeństwa samolotów komercyjnych, co skierowało analizę zagrożeń w stronę jawnych modeli logicznych i obliczeń prawdopodobieństwa. Przegląd FTA przygotowany przez NASA śledzi ten rozwój w sektorach krytycznych dla bezpieczeństwa, takich jak energetyka jądrowa, przetwórstwo chemiczne i farmacja. Przegląd FTA opracowany przez NASA
Dlaczego dawna logika wciąż ma znaczenie
Główna lekcja z FTA ma charakter strukturalny: zagrożenia lepiej rozumieć jako kombinacje obserwowalnych warunków niż jako odosobnione incydenty. W operacjach na danych opóźniony plik źródłowy, nieudana walidacja i niezauważona zmiana schematu tworzą bardziej użyteczny model ryzyka niż stwierdzenie „pipeline zawiódł”. Pierwsza wersja wspiera dochodzenie i zapobieganie. Druga służy głównie szukaniu winnych.
Dobry model zagrożeń nazywa warunki, które można zmierzyć, a nie tylko skutek, który wszyscy zauważają, gdy szkoda już nastąpiła.
Ta logika pomaga też zespołom identyfikować pojedyncze punkty awarii i minimalne zbiory przekrojów, co ma znaczenie, gdy jedna krucha zależność może przerwać cały łańcuch raportowania. Celem nie jest przekształcenie platform danych w systemy lotnicze. Celem jest zastosowanie tej samej dyscypliny, która w ogóle uczyniła inżynierię wysokiego ryzyka bardziej niezawodną.
Dla zespołów, które chcą przełożyć te idee na współczesną praktykę analityczną, symulacja Monte Carlo jest użytecznym uzupełnieniem, gdy przestrzeń danych wejściowych jest niepewna. Nie zastępuje analizy przyczynowej, ale pozwala przetestować pod obciążeniem, jak zachowują się kombinacje błędów czasowych, wolumenowych i transformacyjnych.
Mapowanie granic systemu i łańcuchów przyczynowych

Analiza zagrożeń jest słaba, jeśli granica systemu jest niejasna. Wytyczne FAA dotyczące zarządzania bezpieczeństwem wymagają od analityków zdefiniowania systemu i kontekstu operacyjnego, zidentyfikowania zagrożeń na tyle szczegółowo, by określić ryzyko, przeanalizowania dotkliwości i prawdopodobieństwa, porównania ryzyka z docelowymi wskaźnikami wydajności oraz ponownej oceny kontroli na podstawie danych operacyjnych. To ujęcie cyklu życia dobrze pasuje do platform danych, ponieważ system obejmuje zwykle pozyskiwanie, transformację, przechowywanie, orkiestrację, przegląd przez człowieka i odbiorców końcowych. Wytyczne FAA dotyczące zarządzania bezpieczeństwem
Praktyczna mapa granic
Należy zacząć od pełnej ścieżki danych, a nie tylko od tabeli w hurtowni, którą wszyscy odpytują każdego ranka. Warto uwzględnić zasilania źródłowe, okna wsadowe, procesory strumieniowe, modele dbt, etapy zatwierdzania, ręczne nadpisania oraz zespoły, które wykorzystują dane do raportowania lub automatyzacji. Jeśli ryzyko może wejść przez system źródłowy i ujawnić się trzy warstwy dalej, należy do tej samej analizy.
Następnie zagrożenia należy zapisywać jako łańcuchy przyczynowe. Modyfikacja schematu może uszkodzić transformację, co może skutkować niekompletnym raportowaniem regulacyjnym, a to z kolei może spowodować awarię kontroli w procesie przeglądu biznesowego. Taki zapis jest mocniejszy niż „dryf schematu”, ponieważ identyfikuje warunek inicjujący, konsekwencję i kontekst operacyjny, w którym strata staje się widoczna.
Architektura systemów danych ma tu znaczenie, ponieważ to architektura określa, gdzie dostępne są dowody i gdzie można umieścić kontrole. Jeśli zespół nie potrafi wskazać dokładnego etapu, na którym wykrywane są opóźnienia, skoki wartości null lub nieprawidłowe rekordy, analiza pozostaje abstrakcyjna.
Bezpieczeństwo agentów AI w finansach to użyteczne źródło, jeśli chcą Państwo zobaczyć, jak zmienia się analiza ryzyka, gdy w pętli pojawia się zautomatyzowane podejmowanie decyzji. Wspólny mianownik jest prosty: gdy oprogramowanie może działać, granica musi obejmować zarówno samo działanie, jak i warunki, które czynią je niebezpiecznym.
Co powinien zawierać każdy rejestr zagrożenia
Użyteczny rejestr obejmuje tryb działania, warunek inicjujący, konsekwencję, dotkliwość, prawdopodobieństwo, istniejące zabezpieczenia, właściciela kontroli, sygnał wykrycia oraz organ akceptujący. Dzięki temu zagrożenie przestaje być wspomnieniem i staje się zarządzanym obiektem. Ułatwia to również ponowną ocenę przy zmianie systemu, ponieważ zespół wie dokładnie, które założenie zostało naruszone.
Ocena ryzyka za pomocą obserwowalnych metryk danych
Najmocniejsze oceny ryzyka powstają z połączenia konsekwencji i prawdopodobieństwa, a nie z sumowania objawów. Polityka FAA definiuje ryzyko bezpieczeństwa jako kombinację dotkliwości i prawdopodobieństwa, a praktyka oparta na MIL-STD-882 ocenia zagrożenia w obszarze sprzętu, oprogramowania, interfejsów człowieka i środowisk operacyjnych. Ma to znaczenie w operacjach na danych, ponieważ ta sama usterka techniczna może być niskiego ryzyka w jednym procesie biznesowym, a poważna w innym. Rozporządzenie FAA 8040.4B
Jak zamienić observability w sygnał ryzyka
Opóźnione ładowanie to nie tylko inżynieryjna niedogodność. Jeśli przypadek użycia na dalszym etapie zależy od aktualnych danych, opóźnienie zwiększa ekspozycję, odwlekając decyzję lub zasilając model nieaktualnym wynikiem. Skok odsetka wartości null może wskazywać na niekompletne pozyskanie danych ze źródła, nieudane złączenie lub uszkodzoną transformację, a każda z tych przyczyn w inny sposób wpływa na wiarygodność wyniku.
Składnik ryzyka | Definicja abstrakcyjna | Obserwowalna metryka danych |
|---|---|---|
Prawdopodobieństwo | Jak często zagrożenie może wystąpić | Opóźnienia ładowania, odsetek nieudanych walidacji |
Dotkliwość | Jak poważny może być skutek | Wpływ na KPI biznesowe, kompletność raportowania regulacyjnego |
Wykrywalność | Jak szybko zespół może dostrzec problem | Opóźnienie alertów, nieciągłości liczby wierszy |
Siła kontroli | Jak dobrze zabezpieczenia blokują lub ujawniają problem | Wykrywanie zmian schematu, pokrycie walidacjami |
Tabela jest najbardziej użyteczna, gdy zespoły przestają traktować ją jak artefakt raportowy i zaczynają używać jej do ustalania priorytetów pracy. Powtarzające się opóźnione zasilanie przy słabej wykrywalności wymaga innego planu kontroli niż odosobniony problem z formatowaniem wychwycony przed publikacją. Na tym polega różnica między uporządkowanym dziennikiem a prawdziwym modelem ryzyka.
Zasada operacyjna: Należy oceniać wiarygodną konsekwencję scenariusza przyczynowego, a następnie korygować ocenę po zastosowaniu kontroli.
Co sprawia, że ocena jest możliwa do obrony
Ocena możliwa do obrony jest identyfikowalna. Jeśli zbiór danych o roszczeniach dociera z opóźnieniem, zespół powinien móc wskazać częstotliwość opóźnień, ścieżkę wykrycia, ekspozycję biznesową oraz kontrolę, która ograniczyła ryzyko rezydualne. Tylko w ten sposób akceptacja ryzyka rezydualnego przestaje być machnięciem ręką i staje się udokumentowaną decyzją.
Aby lepiej poznać warstwę metryk, warto sięgnąć po metryki data observability, które stanowią praktyczny pomost między zachowaniem platformy a oceną ryzyka. Dają analizie mierzalną powierzchnię zamiast ogólnego zapewnienia, że wszystko jest w porządku.
Projektowanie testowalnych kontroli dla nadzoru ludzkiego
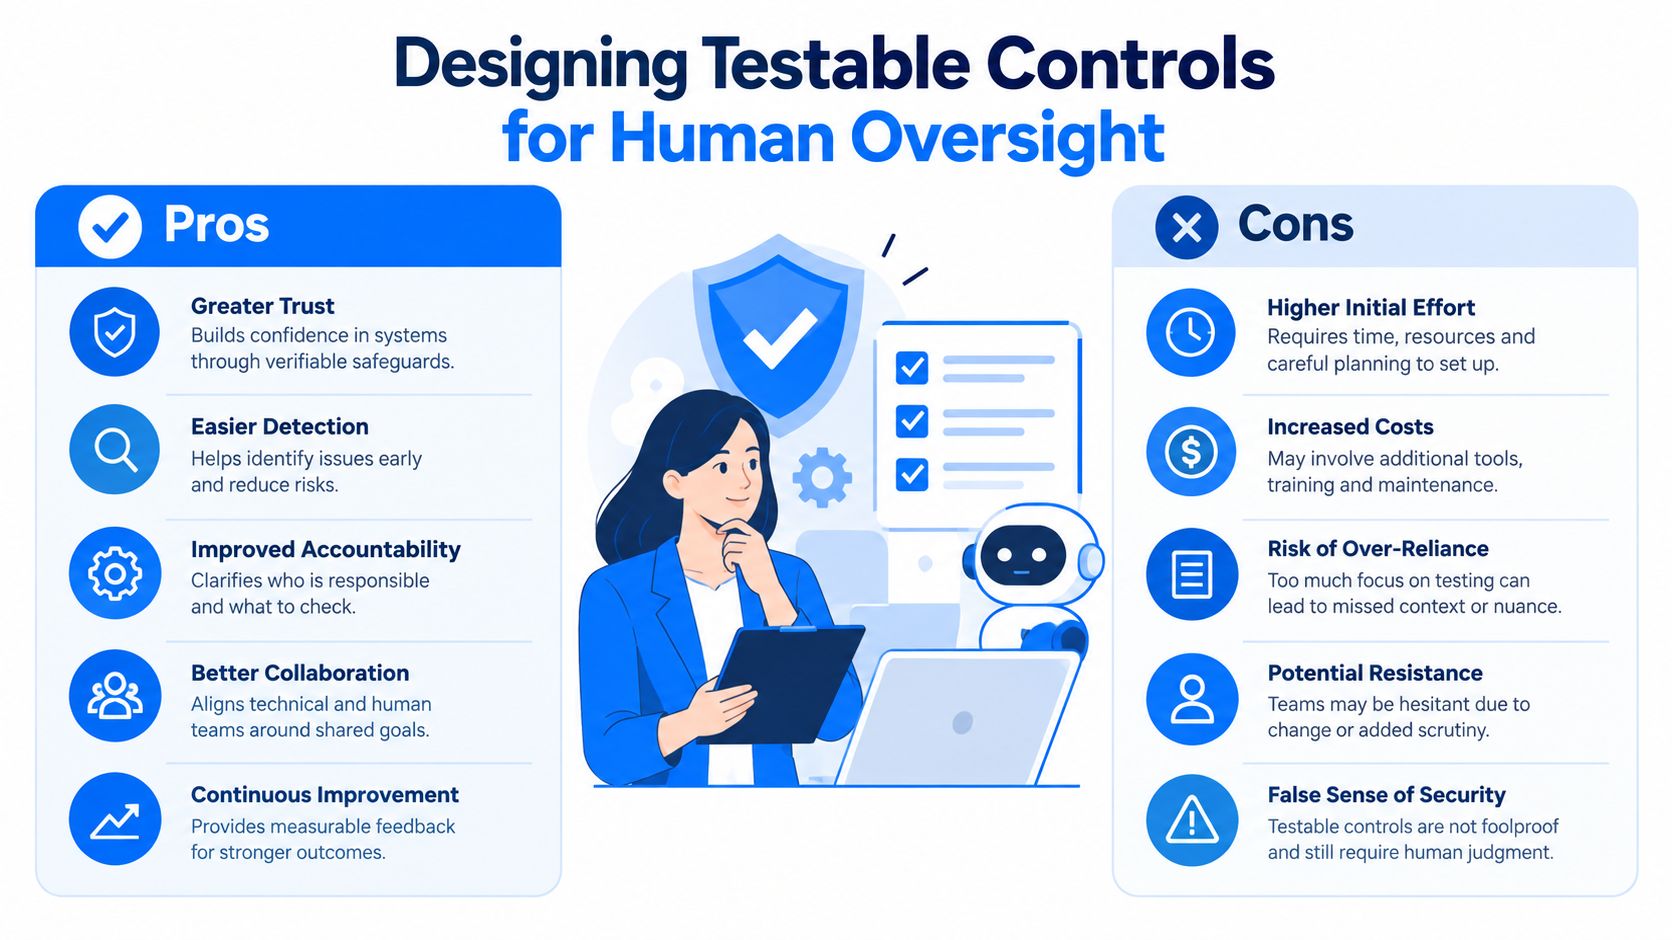
Przegląd przez człowieka trafia do wielu planów kontroli, ponieważ brzmi bezpiecznie. W praktyce może jednak zawodzić w subtelny sposób. Regulatorzy i organizacje zajmujące się bezpieczeństwem wciąż podkreślają, że odpowiedzialność człowieka nie znika, gdy w grę wchodzi AI, i zalecają testowanie obciążenia pracą, uwagi, podejmowania decyzji, jasności ról, zachowań eskalacyjnych oraz reakcji na błędne lub wstrzymane rekomendacje. Wytyczne dotyczące czynników ludzkich
Human-in-the-loop sam w sobie nie jest kontrolą
Recenzent, który otrzymuje zbyt wiele alertów, zacznie je segregować, zamiast je weryfikować. Recenzent, który widzi niejasne wyjaśnienia, zaakceptuje wynik systemu, bo zakwestionowanie go trwa zbyt długo. Recenzent, który nie wie, kto odpowiada za eskalację, może zauważyć problem, a mimo to go przepuścić.
Dlatego nadzór ludzki musi być testowalny. Należy symulować zdegradowane dane, opóźnione dane wejściowe, zmiany schematu, sprzeczne sygnały, awarie automatyzacji i duże obciążenie pracą, a następnie mierzyć czas wykrycia, jakość nadpisań, kompletność eskalacji, czas przywrócenia i nawroty. Te wyniki pokazują, czy człowiek ma czas, informacje, uprawnienia i kompetencje, by interweniować.
Dodanie recenzenta może zwiększyć ryzyko, jeśli jest on zasypany alertami, niedostatecznie przeszkolony lub nie ma możliwości działania.
To element, który wiele zespołów pomija. Warstwa ludzka nie jest automatycznie kontrolą prewencyjną. W niektórych środowiskach staje się wąskim gardłem, które dodaje opóźnienie bez zwiększania bezpieczeństwa, zwłaszcza gdy strumień alertów jest zaszumiony lub wyjaśnienia systemu są słabe.
Jak uczynić nadzór mierzalnym
Należy rejestrować, kiedy operator dostrzegł problem, czy go zakwestionował, jakie działanie podjął i czy system wrócił do prawidłowego stanu. Te dowody warto przechowywać obok telemetrii technicznej, ponieważ nominalnie udany przepływ pracy może nadal ukrywać niebezpieczne zachowania ludzi. Jeśli operator musi zgadywać, odkładać decyzję lub obchodzić proces, kontrola nie jest jeszcze dojrzała.
Ciągły monitoring w branżach regulowanych
Zespół w sektorze usług finansowych może zrobić wszystko poprawnie na papierze, a mimo to w praktyce przeoczyć zagrożenie. Zasilanie transakcyjne, które zwykle dociera na czas, zaczyna spływać później niż zwykle, ale zmiana wolumenu jest na tyle mała, że statyczny próg nigdy się nie uruchamia. Raport nadal się generuje, dashboard nadal się aktualizuje, a nieaktualne dane niezauważenie trafiają do procesu decyzyjnego, który zakłada ich świeżość.
Ciągły monitoring zmienia ten scenariusz awarii. W środowisku regulowanym KPI biznesowe, dryf schematu, terminowość, walidacja i stan platformy muszą być obserwowane łącznie. Przypadek użycia digna dotyczący jakości danych i compliance pasuje do tego modelu, ponieważ platforma pozostaje we własnym środowisku klienta i monitoruje zachowanie danych tam, gdzie się znajdują, dzięki czemu dowody operacyjne pozostają blisko systemu, który chronią.
Dlaczego sztywne progi zawodzą w środowiskach regulowanych
Sztywna reguła widzi tylko to, do czego wykrywania została napisana. Pomija ładowanie, które jest obecne, ale opóźnione, lub zmianę schematu, która wciąż przechodzi kontrole składni, a jednocześnie łamie założenie na dalszym etapie. Nie nadąża też, gdy kontekst biznesowy zmienia się szybciej niż zestaw reguł.
Ciągły monitoring sprawdza się lepiej, ponieważ potrafi wychwycić nietypowe kombinacje zachowań, a nie tylko odosobnione przekroczenia progów. Ma to znaczenie w ochronie zdrowia, finansach, telekomunikacji i sektorze publicznym, gdzie subtelna zmiana wolumenu lub struktury może przerodzić się w problem z raportowaniem lub usługą, zanim ktokolwiek otworzy zgłoszenie incydentu.
Najlepsze alerty są wczesne, konkretne i powiązane z konsekwencją biznesową, którą właściciel już rozumie.
Tutaj platforma danych i system kontroli nakładają się na siebie. Jeśli warstwa observability potrafi walidować krytyczne reguły biznesowe, śledzić zmiany strukturalne i ujawniać anomalie bez przenoszenia danych produkcyjnych poza środowisko, dowody ryzyka pozostają użyteczne zarówno dla operacji, jak i dla audytu. W regulowanych operacjach na danych te same dowody wspierają także przejrzystą ścieżkę compliance, co pokazuje przypadek użycia digna dotyczący jakości danych i compliance.
Czego potrzebuje dobry monitoring operacyjny
Dobry monitoring robi trzy rzeczy jednocześnie. Wykrywa zachowanie pipeline'u, weryfikuje znaczenie biznesowe i zachowuje dowody na to, że kontrola zadziałała. Gdy brakuje któregokolwiek z tych elementów, zespół otrzymuje szum zamiast pewności.
Uruchamianie ponownej oceny przy zmianach systemu

Analiza zagrożeń operacyjnych dla operacji wykorzystujących AI wciąż zbyt często jest traktowana jako jednorazowe ćwiczenie przed wdrożeniem, mimo że największe ryzyka ujawniają się zwykle po wdrożeniu. Najnowsze wytyczne bezpieczeństwa kładą nacisk na stopniowe wdrażanie, ciągły monitoring, kontrolę zmian, lokalną walidację i jasno określoną odpowiedzialność, zamiast zakładać, że model lub zautomatyzowany system pozostaje bezpieczny po zatwierdzeniu. Wytyczne FAA dotyczące bezpieczeństwa operacji wykorzystujących AI
Co powinno uruchamiać nowy przegląd
Ponowna ocena powinna się rozpocząć, gdy system zmienia się w sposób, który może wpłynąć na ryzyko. Obejmuje to zmiany wersji modelu lub oprogramowania, zmienione rozkłady danych wejściowych, nowe uprawnienia automatyzacji, nietypowe wzorce nadpisań, zmiany kadrowe, incydenty i zdarzenia potencjalnie niebezpieczne. Obejmuje to również zmiany procesów, które wpływają na to, kto widzi alert, kto może zatwierdzić decyzję lub jak szybko może nastąpić przywrócenie działania.
Dla zespołów pracujących z danymi regulowanymi lub treściami generowanymi automatycznie użytecznym materiałem pokrewnym są przepisy dotyczące filmów generowanych przez AI. Powód jest prosty: jeśli zautomatyzowany system zmienia to, co ludzie widzą, czemu ufają lub co zatwierdzają, analiza ryzyka musi obejmować zarówno wynik, jak i reakcję człowieka.
Jak zachować użyteczność ścieżki dowodowej
Należy rejestrować niepewność, reakcję użytkownika, działanie na dalszym etapie, dotkliwość, dotkniętą podgrupę, działanie naprawcze i nawroty. Daje to kolejnemu przeglądowi wystarczający kontekst, by ocenić, czy zagrożenie zostało w pełni usunięte, czy jedynie wyciszone. Zapobiega to również częstej awarii, w której model wygląda na dokładny w ujęciu zagregowanym, a mimo to wyrządza szkody operacyjne, ponieważ ludzie nadmiernie mu ufają, ignorują go lub nie są w stanie wystarczająco szybko zareagować na jego wynik.
Najmocniejszy proces opiera się na wyzwalaczach, a nie na kalendarzu. Gdy zmieniają się dane, przepływ pracy lub model uprawnień, analiza zagrożeń powinna automatycznie się ponownie otwierać, a dowody kontroli powinny być wraz z nią aktualizowane.
digna pomaga zespołom przekształcać metryki pipeline'ów, dryf schematu, wyniki walidacji i sygnały terminowości w ciągłe wskaźniki zagrożeń we własnym środowisku. Jeśli zastępują Państwo statyczne listy kontrolne bieżącymi dowodami operacyjnymi, zapraszamy na stronę digna, by zobaczyć, jak data observability może wspierać bezpieczniejsze i bardziej rozliczalne operacje na danych.
Opóźnione ładowania należą do najczęstszych warunków inicjujących w tych łańcuchach przyczynowych, dlatego ocena prawdopodobieństwa zależy od ich wczesnego wychwycenia. Moduł Timeliness w digna uczy się normalnego wzorca dostarczania danych dla każdej tabeli i sygnalizuje dane, które docierają z opóźnieniem lub wcale, zapewniając rejestrowi zagrożenia mierzalny sygnał wykrycia.
Najczęściej zadawane pytania
Czym jest analiza zagrożeń operacyjnych w operacjach na danych?
Analiza zagrożeń operacyjnych to praktyka identyfikowania, w jaki sposób awarie w działającym systemie mogą łączyć się w szkodę, a następnie kontrolowania ich. W operacjach na danych obejmuje ona całą ścieżkę danych, od zasilań źródłowych i modeli dbt po ręczne nadpisania i odbiorców końcowych, i jest otwierana ponownie przy każdej zmianie systemu.
Dlaczego jednorazowe przeglądy zagrożeń zawodzą w przypadku pipeline'ów danych?
Ponieważ większość szkodliwych awarii pojawia się po wdrożeniu. Pipeline może przejść listę kontrolną przed uruchomieniem, a następnie zmiana schematu w systemie źródłowym wypełnia tabelę raportową wartościami null, podczas gdy transformacja nadal działa, a biznes podejmuje działania na podstawie nieaktualnych danych. Kwartalny przegląd nie wychwyci łańcucha przyczynowego, który tworzy się między przeglądami.
Jak wykorzystać metryki observability do oceny ryzyka zagrożeń?
Należy przypisać każdemu składnikowi ryzyka mierzalny sygnał. Prawdopodobieństwo można wyznaczać na podstawie opóźnień ładowania i odsetka nieudanych walidacji, dotkliwość na podstawie wpływu na KPI biznesowe lub kompletności raportowania regulacyjnego, wykrywalność na podstawie opóźnienia alertów i nieciągłości liczby wierszy, a siłę kontroli na podstawie wykrywania zmian schematu i pokrycia walidacjami. Po wdrożeniu kontroli ocenę należy przeliczyć.
Co powinien zawierać rejestr zagrożenia?
Użyteczny rejestr zagrożenia zawiera tryb działania, warunek inicjujący, konsekwencję, dotkliwość, prawdopodobieństwo, istniejące zabezpieczenia, właściciela kontroli, sygnał wykrycia oraz organ akceptujący. Zapisywanie zagrożeń jako łańcuchów przyczynowych, na przykład od zmiany schematu przez uszkodzoną transformację do niekompletnego raportowania regulacyjnego, pokazuje dokładnie, które założenie zostało naruszone, gdy system się zmienia.
Kiedy należy ponownie ocenić analizę zagrożeń operacyjnych?
Ponownej oceny należy dokonywać zawsze, gdy zmiana może wpłynąć na ryzyko, a nie według stałego kalendarza. Wyzwalaczami są m.in. zmiany wersji modelu lub oprogramowania, przesunięte rozkłady danych wejściowych, nowe uprawnienia automatyzacji, nietypowe wzorce nadpisań, zmiany kadrowe, incydenty i zdarzenia potencjalnie niebezpieczne, a także zmiany procesów wpływające na to, kto widzi alert lub kto może zatwierdzić decyzję.


