7 przykładów katalogów danych dla lepszego ładu danych
|
7
min. czyt.

Katalog jest użyteczny tylko wtedy, gdy ludzie mu ufają. Popularna rada mówi, by traktować przykład katalogu danych jako przeszukiwalny inwentarz, ale pomija ona test, który naprawdę się liczy. Najlepszy katalog zależy od tego, jakie metadane gromadzi, jak egzekwuje własność i pochodzenie danych (lineage), jak organizuje zasoby oraz czy każdy rekord niesie wystarczająco dużo sygnałów niezawodności, by zespoły mogły na jego podstawie działać z pewnością. Dlatego najlepsze przykłady wyglądają różnie w zależności od modelu operacyjnego – od platform nastawionych na ład danych po systemy aktywnych metadanych, od elastyczności open source po obserwowalność stawiającą prywatność na pierwszym miejscu we własnym środowisku.
Ta perspektywa ma znaczenie, ponieważ nowoczesne katalogi wyewoluowały z wąskich list schematów w systemy ładu danych. Początki katalogów sięgają słowników danych i ręcznie prowadzonych repozytoriów metadanych, podczas gdy nowsze platformy obsługują lineage, procesy przeglądu i budowanie zaufania w dużych środowiskach danych, co podsumowują opracowania o historii katalogów i wzorcach ich wdrażania w korporacyjnym ładzie danych: historia katalogu danych według DataGalaxy oraz podsumowanie adopcji StatPit za 2026 r. Dla zespołów szukających przykładu katalogu danych kluczowe pytanie nie brzmi, czy narzędzie potrafi wylistować tabele. Chodzi o to, czy katalog pomaga ludziom odkrywać, weryfikować, klasyfikować i wykorzystywać dane z mniejszym tarciem.
Właśnie dlatego w porównaniu należy uwzględnić obserwowalność w stylu digna – digna łączy odkrywanie danych w stylu katalogu z wykrywaniem anomalii, kontrolą terminowości, walidacją i śledzeniem schematów w środowisku klienta. Siedem poniższych wzorców pokazuje, jak działają różne projekty katalogów, gdzie się sprawdzają i jakich kompromisów zespoły powinny się spodziewać.
Spis treści
1. digna
digna wpisuje się we wzorzec przykładu katalogu danych stawiającego prywatność na pierwszym miejscu, ponieważ traktuje metadane jako element niezawodności operacyjnej, a nie tylko odkrywania danych. Platforma działa w Twojej własnej chmurze, VPC lub centrum danych, więc dane produkcyjne pozostają w Twoim środowisku, a kontrole wykonywane są w bazie danych, co ogranicza przenoszenie danych i jest zgodne z mechanizmami bezpieczeństwa. To praktyczna opcja dla zespołów, które potrzebują wglądu katalogowego oraz wiarygodnych dowodów z obserwowalności w środowiskach regulowanych.

Kontekst niezawodności liczy się bardziej niż statyczny inwentarz
Siła digna polega na połączeniu w jednym interfejsie wykrywania anomalii, śledzenia terminowości, walidacji na poziomie rekordów i monitorowania zmian schematów. AWS rozdziela zarządzanie metadanymi, katalog i ład danych – katalog wspiera odkrywanie danych, a ład danych określa zasady ich wykorzystania (wytyczne AWS dotyczące zarządzania metadanymi). digna działa bliżej operacyjnej krawędzi, tam gdzie zespoły muszą widzieć, czy dane dotarły na czas, czy zmienił się schemat lub czy reguła biznesowa zawiodła, zanim zepsuje się dashboard albo model.
Platforma odpowiada zespołom z sektorów finansowego, ochrony zdrowia, telekomunikacji i publicznego, które potrzebują identyfikowalności i dowodów gotowych na potrzeby zgodności z przepisami. Od początku zawiera też harmonogram zadań, katalog, integracje i funkcje współpracy, dzięki czemu rekord katalogu i proces monitorowania pozostają połączone, zamiast rozjeżdżać się w osobnych narzędziach. Dla zespołów porównujących modele katalogów to połączenie ma znaczenie, ponieważ wiąże ład danych z codziennymi kontrolami niezawodności, zamiast pozostawiać sygnały jakości w innym systemie. Jej podejście do obserwowalności danych wyraźnie pokazuje ten wzorzec.
Praktyczna zasada: Jeśli Twój zespół poświęca więcej czasu na wyjaśnianie, dlaczego dane są błędne, niż na ich znalezienie, metadane powiązane z obserwowalnością zwykle sprawdzą się lepiej niż sam inwentarz.
digna pomaga też zróżnicowanym zespołom technicznym pracować w jednym systemie – inżynierom, analitykom, liderom ładu danych i użytkownikom biznesowym. Kompromisem jest odpowiedzialność za wdrożenie, ponieważ organizacja musi samodzielnie zarządzać środowiskiem. Dla zespołów, które mogą obsłużyć taki model, efektem jest wzorzec katalogu zbudowany wokół zaufania i dowodów operacyjnych.
Strona internetowa: digna.ai
2. Alation Data Catalog
Katalog oparty na wyszukiwaniu działa tylko wtedy, gdy użytkownicy ufają wynikom wyszukiwania. Alation jest najwyraźniejszym przykładem tego wzorca. Służy dużym przedsiębiorstwom, które potrzebują odkrywania danych, lineage i szerokiego pokrycia konektorami, ale prawdziwym testem jest to, czy użytkownicy biznesowi mogą zacząć od pytania i mimo to trafić na treści objęte ładem danych.
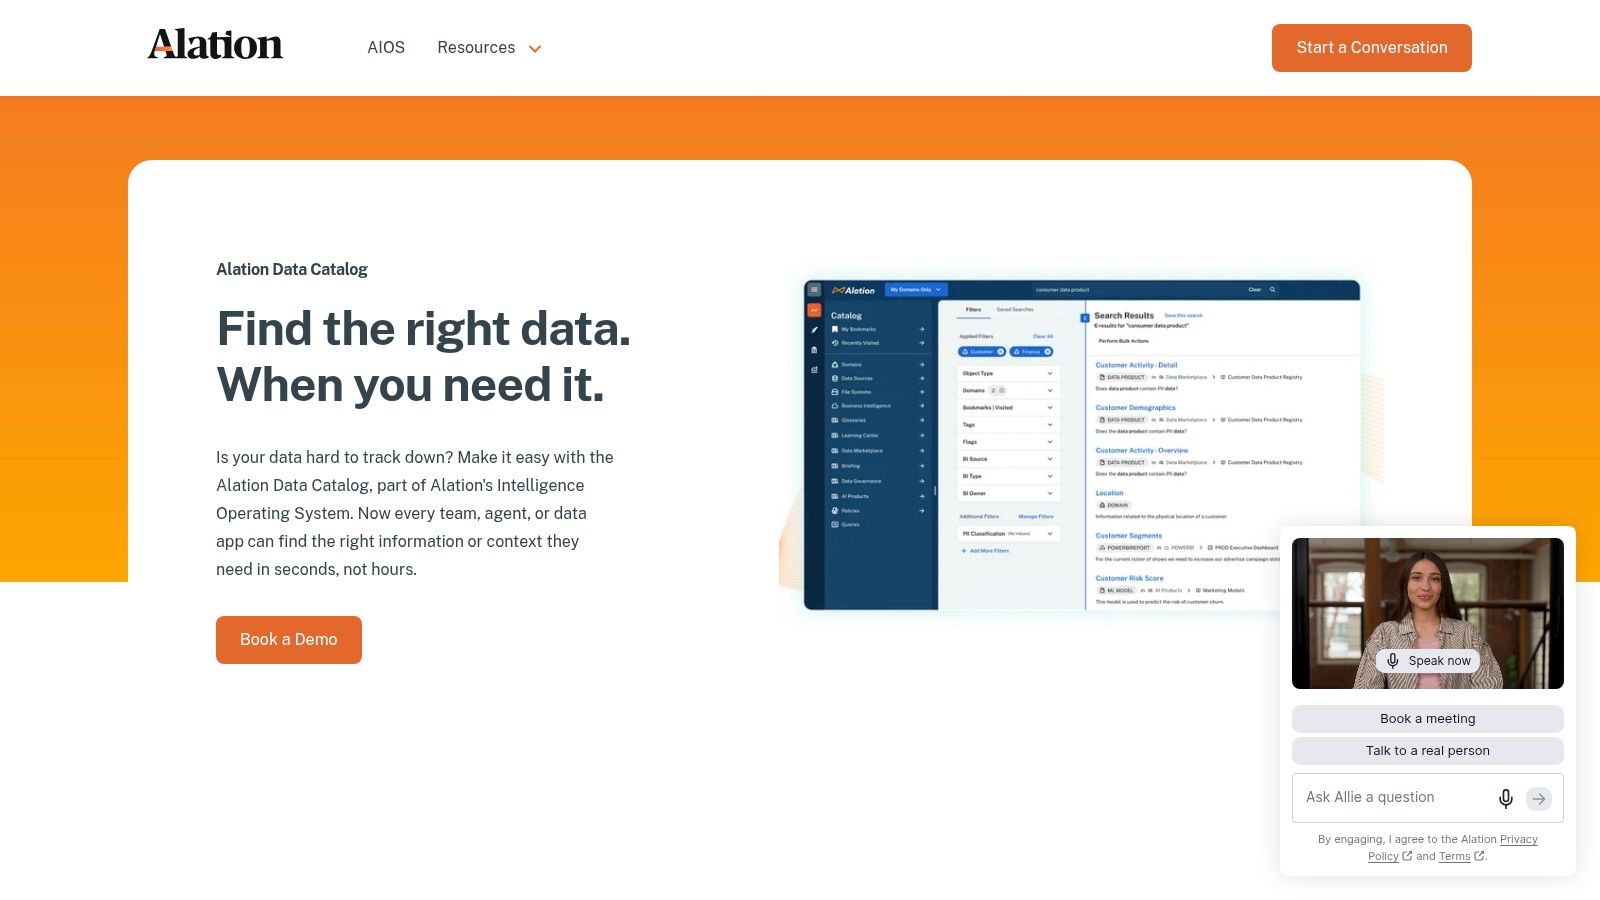
Skuteczne wyszukiwanie zależy od dyscypliny stewardów danych
Wartość wynika z czegoś więcej niż indeksowania. Terminy słownika, kontekst zasad, lineage i sygnały użycia muszą być utrzymywane na tyle dobrze, by wyniki wyszukiwania nie stały się stosem atrakcyjnych, lecz niewiarygodnych zasobów. Strona produktu Alation podkreśla wyszukiwanie w języku naturalnym, pełny lineage, ponad 120 gotowych konektorów oraz otwarty framework konektorów. Takie połączenie ma sens tam, gdzie nadzór nad danymi jest rozproszony między wiele systemów, a własność słownika jest jasno określona.
Ten warunek ma znaczenie. Jeśli organizacja ma wiele źródeł, ale brak jej reguł certyfikacji, wyszukiwanie rankingowane według popularności może szybciej wyświetlać treści, nie zwiększając zaufania. Wówczas odkrywanie danych wyprzedza ład danych, a użytkownicy nadal muszą weryfikować dane ręcznie.
Wzorzec sprawdza się najlepiej, gdy wąskim gardłem jest adopcja, a dyscyplina w zakresie metadanych już istnieje. Użytkownicy biznesowi otrzymują znajome doświadczenie wyszukiwania, a zespoły danych utrzymują uporządkowaną strukturę w rozproszonym środowisku danych. Kompromisem jest nakład pracy operacyjnej. Szerokie pokrycie zwykle oznacza więcej pracy nad wdrożeniem użytkowników, zwłaszcza gdy własność i definicje biznesowe są wciąż niespójne.
Jako przykład katalogu danych Alation pokazuje, jak odkrywanie danych objęte ładem może być naturalne, nie stając się przy tym powierzchowne. Katalog jest najmocniejszy, gdy wyszukiwanie, nadzór nad danymi i certyfikacja są już ze sobą połączone. Słabszy jest wtedy, gdy organizacja wciąż musi ustalić, kto jest właścicielem zasobów, którym z nich można ufać i jak należy używać terminów. Powiązana lektura: Jak digna definiuje katalog danych w praktyce
Strona internetowa: Alation Data Catalog
3. Collibra Data Catalog
Collibra wpisuje się we wzorzec korporacyjnego ładu danych. Została zbudowana dla organizacji, które potrzebują odkrywania danych, lineage, klasyfikacji danych wrażliwych i procesów opartych na zasadach działających w ramach szerszego modelu data intelligence. Ma to znaczenie, gdy dział prawny, dział ryzyka, compliance i biuro ds. danych muszą przeglądać ten sam rekord zasobu.
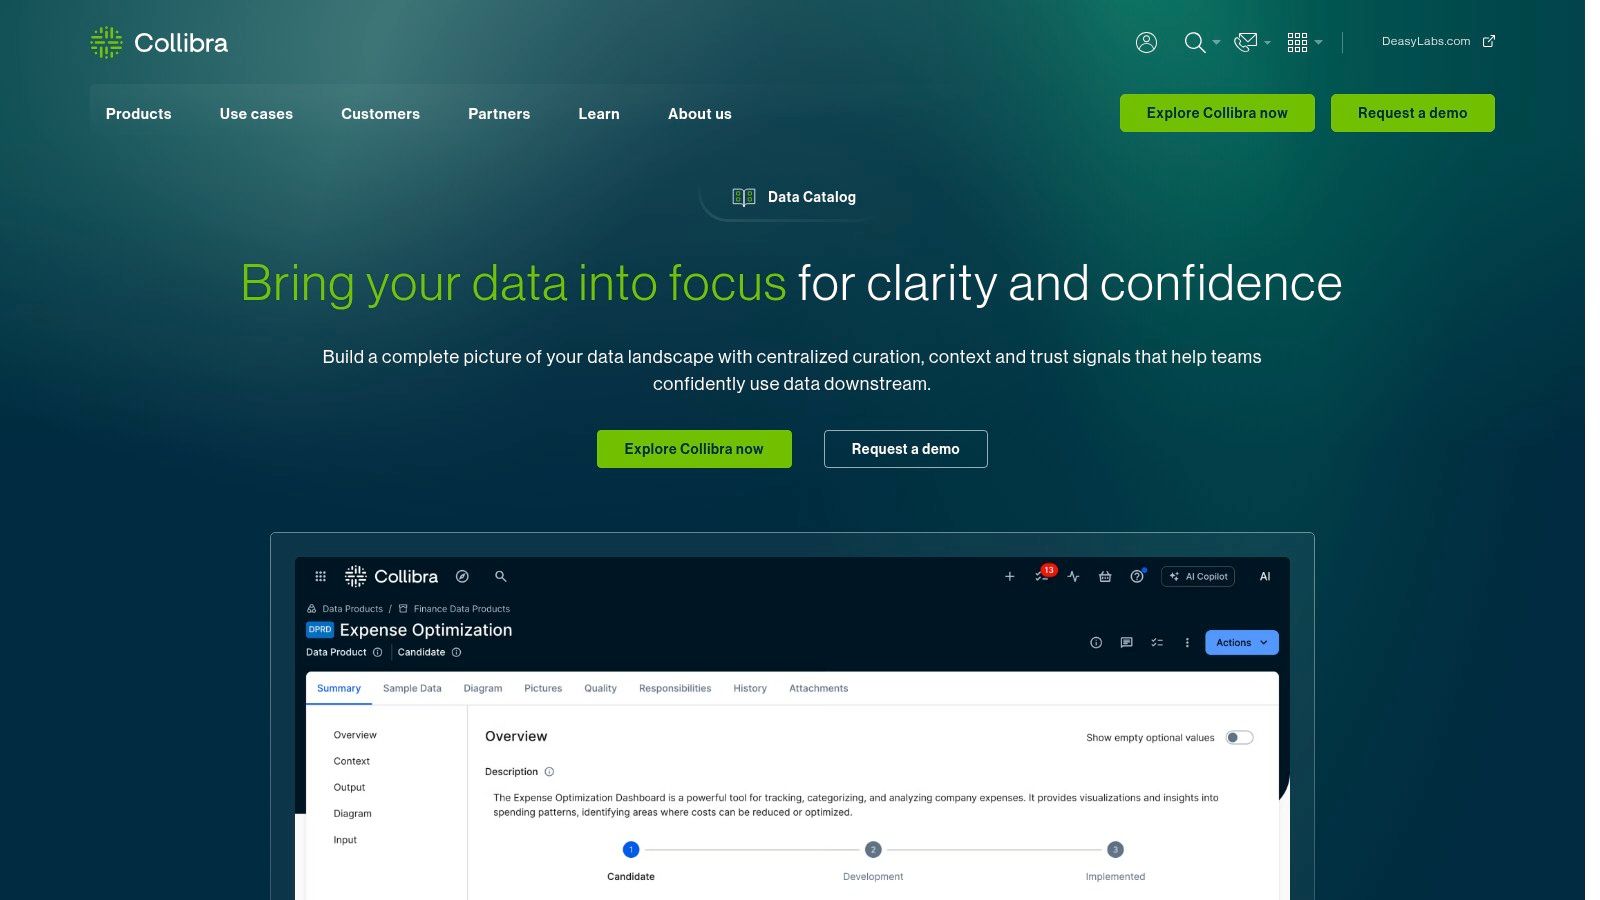
Głęboki ład danych opłaca się w złożonych modelach operacyjnych
Praktyczną zaletą jest kontrola. Strona produktu Collibra wskazuje na scentralizowany inwentarz, ponad 100 natywnych integracji, automatyczną kurację, oznaczanie danych wrażliwych, interaktywny lineage oraz proces dostępu w stylu marketplace. To połączenie sprawdza się, gdy katalog musi pokazywać, czym jest zasób, kto go zatwierdził, jakie zasady go obejmują i jak zarządzany jest dostęp.
Wzorzec jest praktyczny, gdy dział prawny, dział ryzyka i compliance muszą wspólnie zatwierdzać zasoby oraz gdy oznaczanie danych wrażliwych jest obowiązkowe. Pasuje też do organizacji z wieloma warstwami nadzoru nad danymi i formalnymi ścieżkami przeglądu. Jest mniej praktyczny, gdy organizacja ma mniej niż 3 warstwy nadzoru nad danymi i potrzebuje lekkiego odkrywania danych. W takim przypadku koszty operacyjne mogą przewyższyć wartość dodatkowej kontroli.
Collibra pasuje także do zespołów, które przekształcają produkty danych w zasoby do ponownego wykorzystania objęte ładem danych. Dostęp w stylu marketplace i kontekst słownika pomagają udostępniać zaufane dane, ale tylko wtedy, gdy odpowiedzialność za własność i przeglądy jest już jasna. Kompromis jest oczywisty. Im bogatszy model kontroli, tym więcej dyscypliny potrzebują zespoły w zakresie ról, administracji i obsługi wyjątków.
Katalog stawiający ład danych na pierwszym miejscu powinien pokazywać zasady już na etapie odkrywania, aby użytkownicy widzieli regułę, zanim poproszą o dostęp do zasobu.
Jak digna definiuje strategię ładu danych – to przydatny punkt odniesienia. Collibra przekłada tę strategię na działanie poprzez warstwę katalogu. Dla organizacji, które potrzebują identyfikowalności, obsługi danych wrażliwych i wspólnej odpowiedzialności, na tym polega wartość tego wzorca.
Strona internetowa: Collibra Data Catalog
4. Atlan Active Metadata Catalog
Atlan wpisuje się we wzorzec aktywnych metadanych. Katalog jest przeznaczony dla zespołów, które chcą, aby metadane zmieniały się wraz z danymi, tak by aktualność, lineage, certyfikacja i kontekst domeny pozostawały widoczne w codziennej pracy. Dzięki temu jest przydatny dla zespołów analitycznych i programów data mesh, w których własność szybko się zmienia, a ręczne utrzymanie nie nadąża.
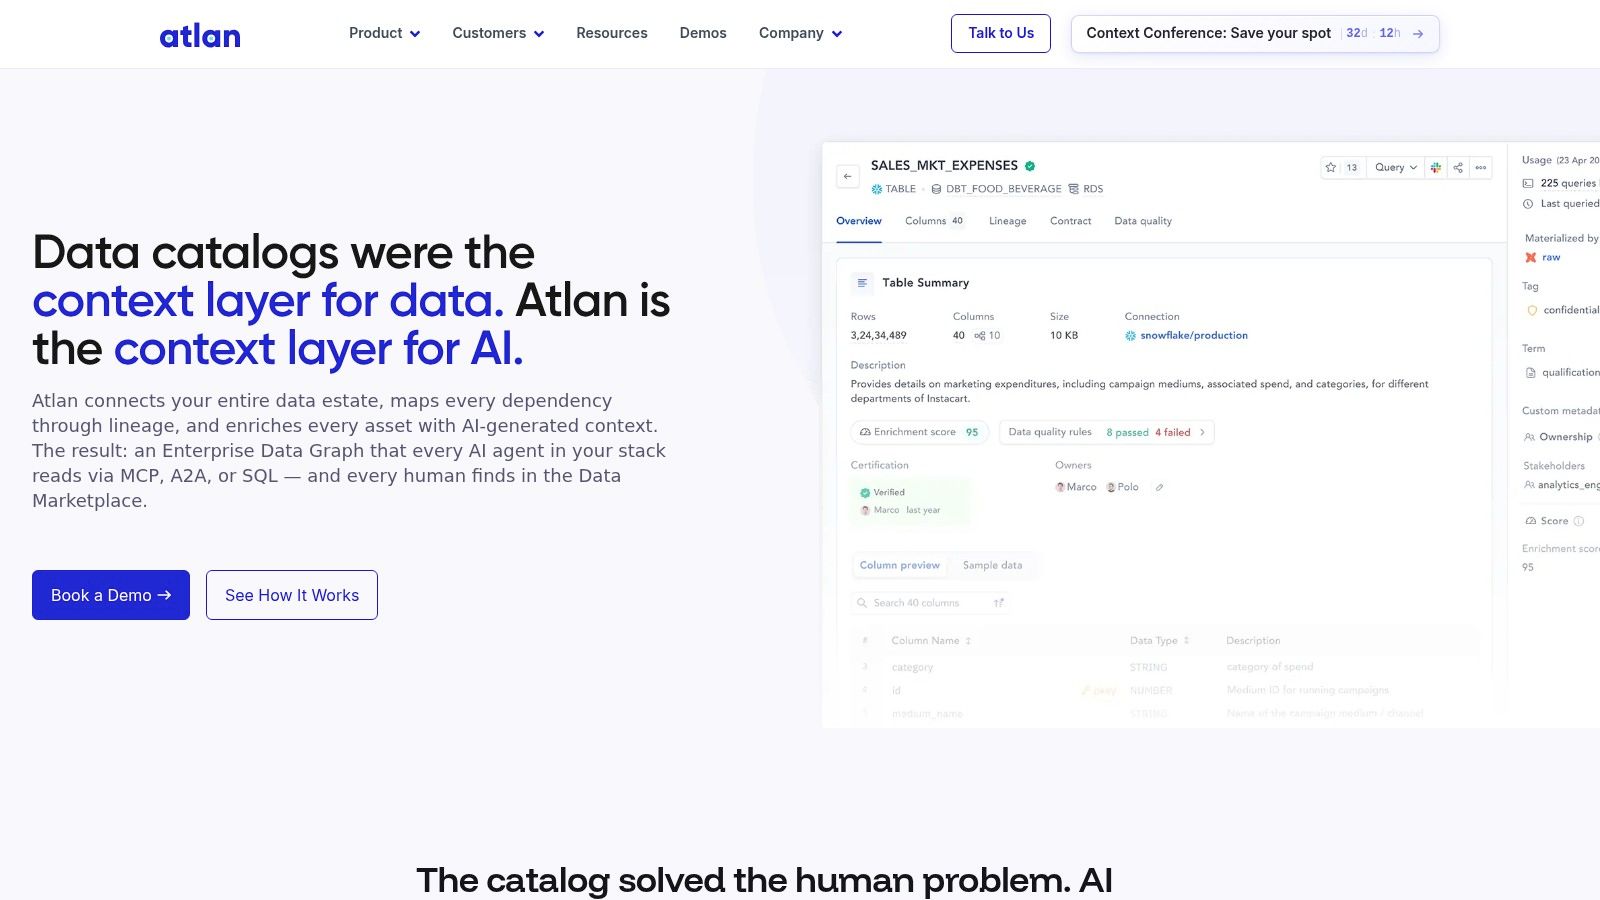
Aktywne metadane działają, gdy model operacyjny jest już jasno określony
Strona katalogu odkrywania danych Atlan wskazuje na wyszukiwanie w języku naturalnym, automatyczny lineage, automatyzacje aktywnych metadanych i dokumentację wspieraną przez AI. Funkcje te mają największe znaczenie, gdy katalog musi odzwierciedlać bieżący kontekst operacyjny, a nie jednorazowe udokumentowanie. Jeśli własność, aktualność i certyfikacja często się zmieniają, statyczny katalog szybko się dezaktualizuje.
Wzorzec działa, gdy granice domen są zdefiniowane, kontrakty własności istnieją w kodzie, a potoki metadanych są sterowane zdarzeniami. W takich warunkach katalog może aktualizować kontekst na bieżąco i utrzymywać rozproszony nadzór nad danymi. Bez tych warunków automatyzacja może równie łatwo skalować chaos, jak dokumentację.
Kiedy działa: zespoły domenowe są już właścicielami produktów danych, zdarzenia metadanych są niezawodne, a katalog może publikować aktualizacje bez ręcznej interwencji. Kiedy zawodzi: granice są niejasne, informacje o własności są w arkuszach kalkulacyjnych, a nieaktualne sygnały nadpisują lokalny kontekst.
Pasuje tu uwaga analityczna z artykułu digna o odkrywaniu danych. Odkrywanie danych staje się użyteczne dopiero wtedy, gdy katalog odzwierciedla sposób, w jaki zespoły już pracują. Atlan jest najmocniejszy tam, gdzie liczy się szybkość współpracy, a organizacja chce nowoczesnego interfejsu zachęcającego do udziału, ale kompromis jest jasny: wymaga zdyscyplinowanego projektu domen, zanim automatyzacja zacznie pomagać.
Strona internetowa: Atlan Data Discovery Catalog
5. Microsoft Purview Unified Catalog
Microsoft Purview wpisuje się we wzorzec chmurowego nadzoru nad danymi, ale tylko w odpowiednich warunkach operacyjnych. Jest najbardziej praktyczny, gdy środowisko oparte głównie na technologiach Microsoft obejmuje już Azure, Fabric i OneLake, a zespół potrzebuje rozwijać ład danych etapami, a nie poprzez pełną zmianę platformy. W takim układzie katalog podąża za platformą, z której organizacja już korzysta.
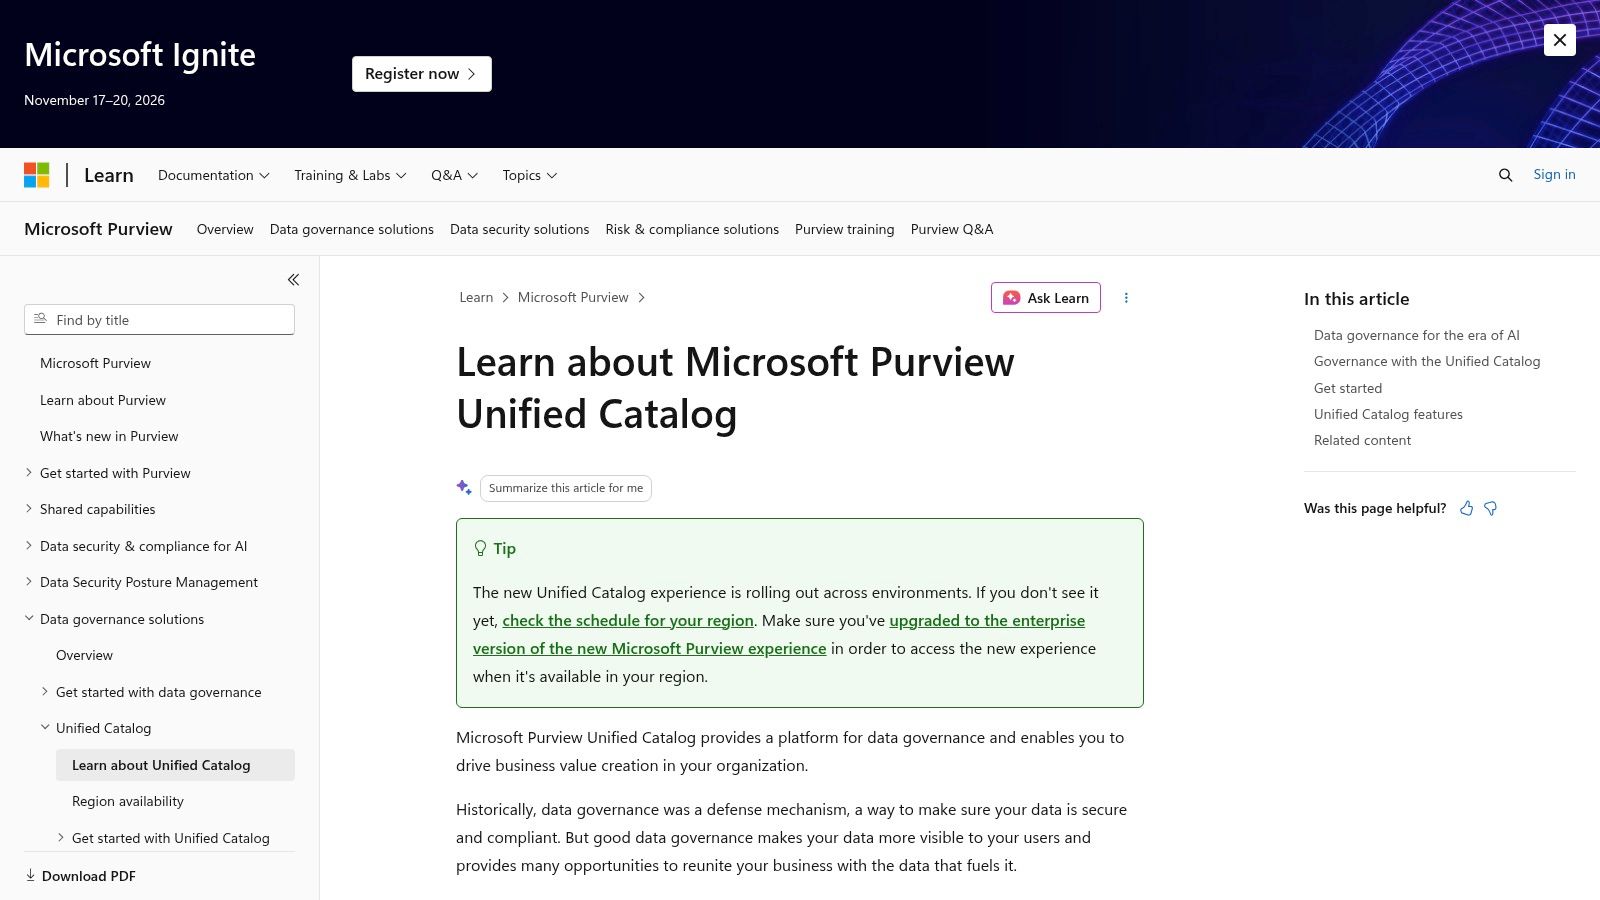
Ład danych rozliczany według użycia pasuje do stopniowych wdrożeń
Dokumentacja Unified Catalog usługi Purview przedstawia model zbudowany wokół skanowania wielochmurowego, centralnych map danych, lineage, klasyfikacji i przetwarzania ładu danych rozliczanego w jednostkach DGPU. Praktyczna wartość nie polega na ogólnej teorii katalogów. Chodzi o możliwość rozpoczęcia od ograniczonego zakresu, zweryfikowania konektorów i rozszerzania ładu danych tam, gdzie użycie uzasadnia wydatki.
Wybierz ten wzorzec, gdy potrzebujesz ładu danych w modelu pay-as-you-go i integracji z Fabric bez zmiany platformy. Zaplanuj 2–3 sprinty na weryfikację konektorów dla źródeł spoza ekosystemu Microsoft, ponieważ pokrycie różni się w zależności od konektora, co wpływa na adopcję. Model jest praktyczny, gdy około 70% lub więcej zasobów znajduje się w Azure, Fabric lub OneLake, a mniej praktyczny, gdy środowisko jest wielochmurowe, a obecność Microsoftu niewielka.
To jasno pokazuje kompromis. Zespoły skupione na technologiach Microsoft zyskują lepsze dopasowanie, mniejsze tarcie integracyjne i warstwę ładu danych blisko stosu bezpieczeństwa, z którego już korzystają. Zespoły z mieszanymi źródłami nadal mogą używać Purview, ale różnice między konektorami mogą sprawić, że ważne zasoby znajdą się poza najbardziej niezawodnym pokryciem katalogu.
Jako przykład katalogu danych w środowisku opartym głównie na technologiach Microsoft jest to wzorzec wielokrotnego użytku, a nie ogólny katalog. Sprawdza się najlepiej, gdy dojrzałość ładu danych może rosnąć etapami, a organizacja chce, by katalog podążał za jej modelem operacyjnym opartym na Microsoft.
Strona internetowa: dokumentacja Microsoft Purview
Powiązana lektura: digna o zarządzaniu metadanymi
6. DataHub Open Source i DataHub Cloud
DataHub to wzorzec elastyczności prowadzonej przez inżynierów. Pasuje do zespołów, które chcą lineage, wyszukiwania, procesów ładu danych i sygnałów obserwowalności bez wiązania się z zamkniętym stosem katalogowym. Edycja open source daje zespołom technicznym kontrolę. DataHub Cloud zachowuje ten sam model, ale zdejmuje znaczną część ciężaru utrzymania infrastruktury.
Kontrola inżynierska a obciążenie operacyjne: ile naprawdę kosztuje model open source
Siłą DataHub nie jest ogólna szerokość funkcji katalogowych. Jest nią możliwość kształtowania metadanych jako części platformy, a nie tylko korzystania z nich jak z narzędzia front-endowego. Dzięki temu wzorzec jest praktyczny dla zespołów, które już prowadzą wewnętrzne platformy, niestandardowe konektory i potoki metadanych, które potrafią utrzymywać w miarę zmian stosu technologicznego.
DataHub Cloud zmniejsza obciążenie operacyjne, ale kompromis nie znika. Kontrola w modelu open source nadal wymaga zarządzania aktualizacjami, utrzymania konektorów i kogoś, kto zadba o sprawność pozyskiwania danych, gdy zmieniają się systemy źródłowe. Pasuje, gdy zespół platformowy może przejąć tę pracę, a trudniej go uzasadnić, gdy organizacji brakuje dedykowanych zasobów SRE lub zespołu do obsługi katalogu.
Sygnał dopasowania | Praktyczny, jeśli | Mniej praktyczny, jeśli |
|---|---|---|
Model operacyjny | inżynierowie są właścicielami procesów związanych z metadanymi | katalog ma działać przy niewielkim bezpośrednim wsparciu |
Wybór wdrożenia | liczą się niestandardowe rozszerzenia i samodzielny hosting | zespół chce minimalnej odpowiedzialności za infrastrukturę |
Nacisk na niezawodność | potoki pozyskiwania danych są monitorowane i utrzymywane | aktualizacje i konektory pozostawia się doraźnym działaniom |
Dla kupujących porównujących przykłady katalogów danych w różnych modelach wdrożenia DataHub jest najwyraźniejszym przypadkiem kontroli w modelu self-hosted obok opcji zarządzanej. Sprawdza się najlepiej, gdy infrastruktura metadanych jest traktowana jak oprogramowanie – z jasną własnością, dyscypliną wydań i odpowiedzialnością operacyjną.
Strona internetowa: DataHub
7. Informatica Cloud Data Governance and Catalog
W hybrydowych środowiskach danych, w których zasięg skanerów decyduje o kompletności katalogu, Informatica stawia pokrycie ponad lżejsze doświadczenie odkrywania danych. Pasuje do organizacji, które już korzystają z narzędzi Informatica i potrzebują katalogowania powiązanego z pracą nad integracją, jakością i ładem danych.
Zasięg ma znaczenie, gdy środowisko danych jest nieuporządkowane
Strona produktu katalogu podkreśla automatyczne skanowanie, profilowanie, lineage, słownik, zarządzanie zasadami oraz powiązane usługi jakości i integracji danych. Taki profil ma znaczenie tam, gdzie trzeba objąć zarówno systemy chmurowe, jak i lokalne, a artefakty ładu danych muszą pozostawać spójne z metadanymi technicznymi. Wartość tkwi w pełnym pokryciu metadanych, a nie w lekkim odkrywaniu danych.
Ten wzorzec pasuje do przedsiębiorstw, które potrzebują szerokiego wsparcia skanerów i ściślejszego powiązania z istniejącym stosem zarządzania danymi. Kompromisem jest ciężar operacyjny. Zakres, administracja i wdrażanie użytkowników mogą stać się znaczące, zwłaszcza gdy zarówno zespoły techniczne, jak i użytkownicy odpowiedzialni za ład danych polegają na tym samym katalogu. Adopcja jest zwykle silniejsza, gdy praca z katalogiem stanowi część szerszego modelu operacyjnego, a nie samodzielne narzędzie wyszukiwania.
Wybierz Informatica, gdy środowisko danych wymaga szerokiego pokrycia skanerami oraz usług jakości lub integracji powiązanych z IDMC. Wybierz Collibra, gdy ład danych w stylu marketplace i procesy dla użytkowników biznesowych są ważniejsze niż głębokość skanowania. Dla czytelników porównujących przykład katalogu danych o maksymalnej szerokości platformy Informatica jest najlepszym wyborem dla organizacji, które chcą, aby katalogowanie działało jako część większego programu zarządzania danymi.
Strona internetowa: Informatica Cloud Data Governance and Catalog
Porównanie 7 najlepszych katalogów danych
Produkt | Złożoność wdrożenia (🔄) | Zasoby i operacje (⚡) | Oczekiwane rezultaty (⭐📊) | Idealne zastosowania | Kluczowe zalety (💡) |
|---|---|---|---|---|---|
digna | Średnia (🔄🔄), instalacja w środowisku klienta i konfiguracja modułów | Umiarkowane–wysokie ⚡, klient zarządza infrastrukturą; obliczenia w bazie danych ograniczają przenoszenie danych | Wysokie ⭐⭐⭐⭐, obserwowalność klasy korporacyjnej, szybki czas do uzyskania wartości (wnioski w <2 godz.) | Regulowane przedsiębiorstwa potrzebujące kontroli na miejscu, z priorytetem prywatności | Wykonywanie w środowisku klienta, kontrole w bazie danych, modułowe licencjonowanie, anomalie wykrywane przez AI + deterministyczna walidacja |
Alation Data Catalog | Średnia–wysoka (🔄🔄🔄), praca nad ładem danych i adopcją | Umiarkowane ⚡, konektory + wdrażanie użytkowników w rozległych środowiskach | Wysokie ⭐⭐⭐⭐, silne odkrywanie danych, wyszukiwanie i adopcja ładu danych | Duże przedsiębiorstwa szukające odkrywania i wyszukiwania danych objętego ładem | Wyszukiwanie w języku naturalnym, lineage, ponad 120 konektorów, procesy ładu danych |
Collibra Data Catalog | Wysoka (🔄🔄🔄), wymagana konfiguracja ról i modelu na poziomie organizacji | Wysokie ⚡, znaczny nakład na wdrażanie użytkowników i model operacyjny | Wysokie ⭐⭐⭐⭐, kompleksowy ład danych, kontrola danych wrażliwych | Złożone organizacje z potrzebami w zakresie zgodności i produktów danych | Scentralizowany ład danych, oznaczanie danych wrażliwych, AI Copilot, marketplace/procesy |
Atlan, Active Metadata Catalog | Średnia (🔄🔄), szybszy UX, ale wymaga projektu domen | Umiarkowane ⚡, nowoczesny UX zmniejsza tarcie; pewna konfiguracja domen | Dobre ⭐⭐⭐, szybsza adopcja i wspólne zarządzanie metadanymi | Zespoły data mesh/domenowe, zespoły analityczne nastawione na współpracę | Automatyzacje aktywnych metadanych, dokumentacja wspierana przez AI, procesy domen/produktów |
Microsoft Purview, Unified Catalog | Niska–średnia (🔄🔄), natywnie chmurowy, stopniowe wdrażanie | Umiarkowane ⚡, rozliczanie pay-as-you-go (DGPU); zróżnicowanie konektorów | Dobre ⭐⭐⭐, ujednolicony katalog dla ekosystemów Microsoft | Organizacje skoncentrowane na Microsoft/Azure/Fabric | Skanowanie wielochmurowe, integracja z Fabric/OneLake, przejrzyste ceny według użycia |
DataHub (open source) / DataHub Cloud | Średnia (🔄🔄), OSS wymaga pracy inżynierskiej; Cloud ułatwia operacje | Zmienne ⚡, wysokie przy self-hostingu; DataHub Cloud zmniejsza obciążenie operacyjne | Dobre ⭐⭐⭐, metadane przyjazne programistom, silny lineage/wyszukiwanie | Zespoły chcące elastyczności OSS lub ścieżki zarządzanego SaaS | Społeczność open source, elastyczne wdrażanie, przejrzyste ceny pakietu startowego (Cloud) |
Informatica, Cloud Data Governance & Catalog (IDMC) | Wysoka (🔄🔄🔄), wdrożenie i ład danych w skali przedsiębiorstwa | Wysokie ⚡, szerokie skanery i bieżąca administracja | Wysokie ⭐⭐⭐⭐, głębokie skanowanie, profilowanie i integracje korporacyjne | Bardzo duże, hybrydowe środowiska danych wymagające szerokiego pokrycia źródeł | Szeroki zakres skanerów klasy korporacyjnej, szczegółowy lineage, integracja z ekosystemem IDMC |
Wybierz wzorzec, który Twój model operacyjny jest w stanie utrzymać
Właściwy katalog zależy nie tyle od liczby funkcji, ile od tego, czy Twój model operacyjny jest w stanie utrzymać zachowania, których oczekuje narzędzie. Jeśli potrzebujesz korporacyjnego ładu danych i dowodów zgodności, sensownym wyborem są Collibra lub Informatica. Jeśli adopcja zależy od szybkiego, intuicyjnego wyszukiwania, lepiej pasuje Alation. Jeśli Twoje zespoły pracują w domenach i produktach, Atlan daje aktywnym metadanym praktyczne zastosowanie. Jeśli Twoje środowisko danych jest skoncentrowane na Microsoft, Purview pasuje naturalnie. Jeśli inżynierowie chcą kontroli i elastyczności, DataHub jest otwartą ścieżką. Jeśli najważniejsze są niezawodność, prywatność i wykonywanie w środowisku klienta, digna jest wzorcem najsilniej osadzonym w praktyce operacyjnej.
Przydatnym sposobem ich porównania jest zadanie sześciu pytań. Czy ludzie mogą szybko znaleźć zasób. Czy widzą lineage, któremu ufają. Czy słownik lub taksonomia zapewniają spójność terminów. Czy sygnały obserwowalności lub aktualności ostrzegą ich, zanim użyją nieaktualnych danych. Czy model wdrożenia odpowiada Twojej polityce bezpieczeństwa. I czy Twój zespół udźwignie obciążenie operacyjne, jakie niesie wybrany projekt?
Odkrywanie danych: Alation i Atlan przodują w odkrywaniu opartym na wyszukiwaniu, a Collibra, Purview, DataHub, Informatica i digna łączą odkrywanie z różnymi warstwami ładu danych lub niezawodności.
Lineage: Collibra, Purview, DataHub, Informatica i Alation kładą nacisk na widoczność lineage, podczas gdy digna wiąże kontrole niezawodności z sygnałami dotyczącymi schematów i terminowości.
Obsługa taksonomii lub słownika: Collibra, Alation, DataHub i Informatica oferują najsilniejszy kontekst słownika i zasad, a Atlan i Purview skłaniają się ku kontekstowi operacyjnemu.
Kontekst obserwowalności: digna pasuje tu najwyraźniej, a DataHub i Collibra wnoszą sygnały wspierające do warstwy katalogu.
Model wdrożenia: Purview i dostawcy chmurowi preferują ścieżki zarządzane lub natywnie chmurowe, DataHub oferuje self-hosting lub chmurę, a digna działa w infrastrukturze klienta.
Obciążenie operacyjne: Zarówno elastyczność open source, jak i głębia korporacyjnego ładu danych wymagają przejęcia odpowiedzialności. Różnica polega na tym, gdzie leży ciężar – po stronie inżynierii, administracji czy obu.
Praktyczna kolejność jest prosta. Najpierw zdefiniuj rekord metadanych, następnie ustal zasady własności i taksonomii, potem przeprowadź pilotaż na jednym zbiorze danych o wysokiej wartości, w kolejnym kroku dołącz sygnały zaufania, takie jak lineage, aktualność czy walidacja, a na koniec zmierz, czy użytkownicy potrafią znaleźć zasób i z pewnością go wykorzystać. Katalog zyskuje adopcję, gdy pomaga ludziom podejmować decyzje szybciej i z mniejszą liczbą sporów o to, co oznaczają dane.
digna daje zespołom inny rodzaj doświadczenia z katalogiem – taki, w którym odkrywanie danych i obserwowalność pozostają połączone w tym samym środowisku. Jeśli potrzebujesz platformy, która wiąże metadane z anomaliami, terminowością, walidacją i zmianami schematów bez wyprowadzania danych produkcyjnych spod Twojej kontroli, odwiedź digna i oceń, czy ten model operacyjny pasuje do Twojego przykładu katalogu danych lepiej, niż kiedykolwiek mógłby statyczny inwentarz.
Jeśli rekord katalogu ma przenosić sygnały aktualności, zmian schematów i walidacji zamiast statycznego inwentarza, zobacz, jak digna realizuje obserwowalność platformy danych we własnym środowisku klienta.
Najczęściej zadawane pytania
Jaki jest dobry przykład katalogu danych?
Nie ma jednego najlepszego przykładu; artykuł porównuje siedem wzorców. Alation reprezentuje odkrywanie oparte na wyszukiwaniu, Collibra korporacyjny ład danych, Atlan aktywne metadane, Microsoft Purview chmurowy nadzór nad danymi, DataHub elastyczność open source, Informatica szeroki zasięg skanerów, a digna wzorzec stawiający prywatność na pierwszym miejscu, który łączy rekordy katalogu z kontrolami obserwowalności we własnym środowisku.
Czy Microsoft Purview to dobry katalog danych dla mieszanego środowiska chmurowego?
Purview sprawdza się najlepiej, gdy około 70% lub więcej zasobów znajduje się w Azure, Fabric lub OneLake. W przypadku źródeł spoza ekosystemu Microsoft artykuł zaleca zaplanowanie 2–3 sprintów na weryfikację konektorów, ponieważ pokrycie różni się w zależności od konektora, a ważne zasoby mogą znaleźć się poza najbardziej niezawodnym pokryciem katalogu.
Czym różnią się katalogi danych Collibra i Informatica?
Wybierz Informatica, gdy środowisko danych wymaga szerokiego pokrycia skanerami i powiązań z usługami jakości lub integracji IDMC. Collibra lepiej pasuje, gdy ład danych w stylu marketplace, oznaczanie danych wrażliwych i procesy dla użytkowników biznesowych są ważniejsze niż głębokość skanowania, choć jest mniej praktyczna dla organizacji z mniej niż 3 warstwami nadzoru nad danymi.
Kiedy sprawdza się katalog aktywnych metadanych, taki jak Atlan?
Aktywne metadane działają, gdy granice domen są zdefiniowane, kontrakty własności istnieją w kodzie, a potoki metadanych są sterowane zdarzeniami. Zawodzą, gdy granice są niejasne, a informacje o własności są w arkuszach kalkulacyjnych, ponieważ automatyzacja skaluje wtedy chaos równie łatwo jak dokumentację. Wyszukiwanie w języku naturalnym i automatyczny lineage w Atlan pomagają dopiero po przygotowaniu tych podstaw.
Jak wdrożyć katalog danych?
Postępuj zgodnie z pięcioetapową sekwencją: najpierw zdefiniuj rekord metadanych, następnie ustal zasady własności i taksonomii, a potem przeprowadź pilotaż na jednym zbiorze danych o wysokiej wartości. Później dołącz sygnały zaufania, takie jak lineage, aktualność czy walidacja, a na koniec zmierz, czy użytkownicy potrafią znaleźć zasób i z pewnością go wykorzystać, zanim dalej rozbudujesz katalog.



