Monitorowanie integralności danych: praktyczny przewodnik na 2026 rok
|
7
min. czyt.

Pulpity rzadko zawodzą w spektakularny sposób. Znacznie częściej ktoś z działu finansów otwiera w poniedziałek widok przychodów, widzi wczorajsze liczby i zakłada, że w firmie wszystko w porządku. Tymczasem tabela źródłowa przestała się odświeżać, weekendowe zadanie pominęło ładowanie, a model AI wytrenowany na danych z zeszłego tygodnia podejmuje teraz pewne siebie decyzje na podstawie nieaktualnych danych wejściowych.
Dlatego właśnie monitorowanie integralności danych ma dziś znaczenie. Nie jest to zadanie porządkowe na zapleczu ani to samo co sporadyczne testowanie. To ciągła warstwa kontrolna, która wychwytuje zakłócenia w obszarach aktualności, wolumenu, rozkładu, schematu i pochodzenia danych, dzięki czemu zespoły dostrzegają ciche awarie, zanim zrobią to interesariusze. Przegląd akademicki przedstawia te pięć filarów jako podstawowe ramy oceny, czy dane docierają na czas, zachowują oczekiwane właściwości statystyczne, pozostają kompletne, zachowują strukturę i mają identyfikowalne pochodzenie – a to dokładnie ten rodzaj widoczności, jakiego potrzebują nowoczesne potoki danych przegląd akademicki.
Przydatnym modelem myślowym jest traktowanie monitorowania integralności jako siatki bezpieczeństwa między testami. Testy mówią, czy znana reguła nadal jest spełniona. Monitorowanie mówi, czy system nie przeszedł w stan, który później zepsuje raportowanie, modele lub dalszą automatyzację. Jeśli zajmujesz się już wykrywaniem anomalii, praktycznym uzupełnieniem jest przewodnik ELECTE, który pomaga znaleźć ukryte wzorce w danych, ponieważ te same instynkty sprawdzają się, gdy interesującym Cię wzorcem jest cicha degradacja potoku.
Jeśli odnosisz to do własnego stosu technologicznego, znaczenie ma także warstwa pulpitów. Wspólny widok incydentów, trendów i statusu staje się znacznie bardziej użyteczny, gdy opiera się na ciągłych kontrolach, a nie tylko na wyrywkowych audytach. Jedną z referencyjnych implementacji takiej widoczności są pulpity jakości danych digna, które odzwierciedlają tę samą ideę operacyjną z innej perspektywy.
Spis treści
Moment, w którym pulpit przestaje działać, a nikt tego nie zauważa
Dlaczego monitorowanie integralności stało się warstwą strategiczną
Porównanie podejść do monitorowania, które naprawdę działają
Moment, w którym pulpit przestaje działać, a nikt tego nie zauważa
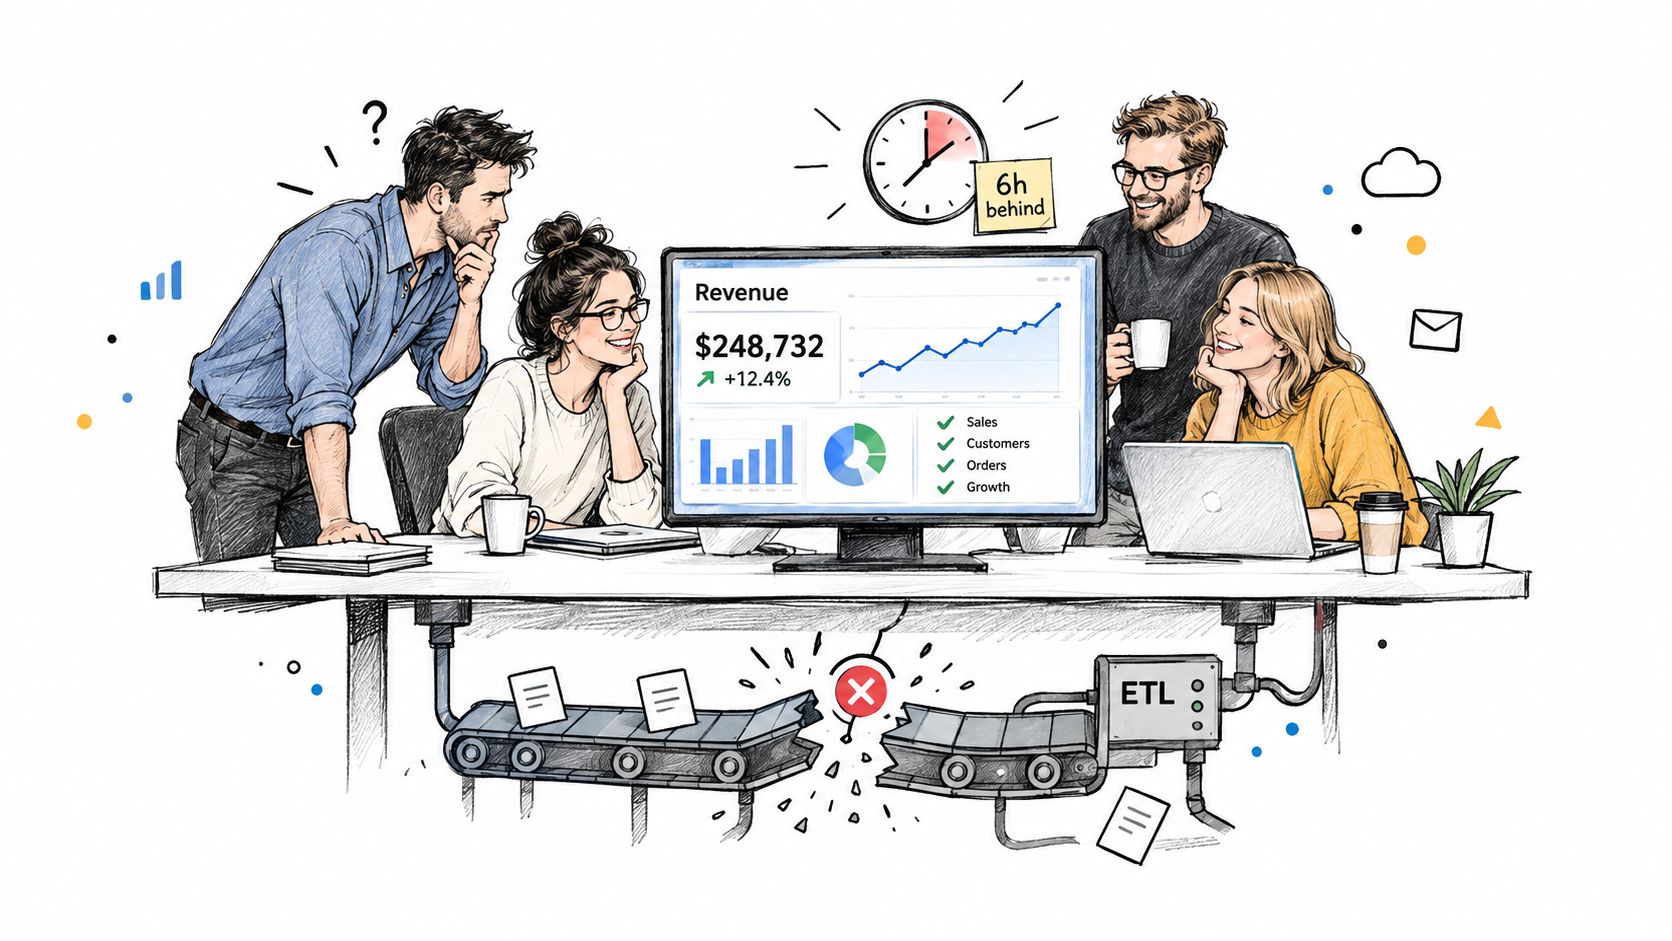
Poniedziałek zaczyna się od wiadomości, której nikt nie lubi. Ładowanie hurtowni, które miało zakończyć się w nocy, nie przebiegło poprawnie, tabela źródłowa jest nieaktualna od sześciu godzin, a pulpit zarządu nadal pokazuje wczorajsze przychody bez żadnego komunikatu o błędzie. Zespół produktowy również tego nie zauważa, ponieważ model rekomendacyjny wdrożony w zeszłym tygodniu nadal działa na starej kohorcie.
To właśnie ten tryb awarii, z myślą o którym powstało monitorowanie integralności danych. Chodzi o to, by w sposób ciągły obserwować same dane, tak aby nieaktualne ładowania, brakujące rekordy, zmiany schematu i zerwane łańcuchy zależności wychodziły na jaw, gdy wciąż jest czas na reakcję.
Głośną awarię łatwo zauważyć. Potok przestaje działać, uruchamia się alert i ktoś zostaje wezwany. Cicha awaria jest trudniejsza, ponieważ liczby wciąż wyglądają wiarygodnie, choć dane bazowe odbiegły już na tyle, by zniekształcić decyzję.
Praktyczna zasada: jeśli kontrola uruchamia się dopiero po skardze interesariusza, na nazywanie jej monitorowaniem jest już za późno.
Dlatego też ta warstwa różni się od jednorazowego testowania. Testy przeprowadza się zwykle przy wdrożeniu lub w punktach walidacji. Monitorowanie integralności danych działa w samym środku cyklu życia, obserwując bieżący stan potoku w miarę jego zmian – jak sterownia, która stale sprawdza wskaźniki, podczas gdy maszyna już pracuje.
To rozróżnienie ma znaczenie dla zespołów, które prowadzą zarówno analitykę, jak i ML. Model może nadal generować predykcje, gdy tabela wejściowa jest nieaktualna, schemat się zmienił lub źródło przestało przesyłać wiersze. Nic się nie zawiesza, ale logika biznesowa i tak ulega degradacji. Dlatego warstwa monitorowania musi śledzić zarówno to, czy zadanie zostało wykonane, jak i to, czy dane nadal są wiarygodne.
Najlepsze konfiguracje korelują ponadto kilka sygnałów jednocześnie. Sama aktualność może przeoczyć duplikację. Sam wolumen może przeoczyć zmianę schematu, która usuwa kolumnę bez zmiany liczby wierszy. Same kontrole schematu mogą przeoczyć spóźniony plik, który dociera w całości, ale zbyt późno, by wesprzeć raportowanie. Jedną z referencyjnych implementacji takiej widoczności są pulpity jakości danych digna, które pokazują, jak widoki incydentów mogą funkcjonować obok ciągłych kontroli. Aby dokładniej przyjrzeć się temu, jak łączą się obserwowalność i widoki incydentów, warto sięgnąć po wspólny pulpit incydentów, ponieważ odzwierciedla on rodzaj widoczności operacyjnej, jakiej zespoły potrzebują po wyjściu poza ręczne kontrole wyrywkowe.
Pięć perspektyw monitorowania integralności danych
Pomyśl o izbie przyjęć w szpitalu. Lekarz nie stawia diagnozy na podstawie jednego sygnału. Sprawdza puls, zadaje pytania, analizuje wyniki badań krwi, ogląda obrazowanie i porównuje obecny stan z historią choroby i wywiadem rodzinnym. Potoki danych zasługują na tę samą dyscyplinę.

Aktualność, wolumen, rozkład, schemat i pochodzenie danych
Aktualność odpowiada na pytanie, czy dane dotarły na czas. Jeśli strumień danych sprzedażowych zwykle trafia do systemu przed 6:00, a o 8:00 jeszcze go nie ma, to nie jest problem teoretyczny, lecz nieaktualne raportowanie. To samo dotyczy opóźnionych zadań wsadowych, pominiętych ładowań przyrostowych i opóźnionych dostaw danych od partnerów. Przewodnik po obserwowalności danych zalicza aktualność, obok dostępności, wolumenu i zmian schematu, do podstawowych kontroli w monitorowaniu zbiorów danych przewodnik dasca.
Wolumen dotyczy liczby wierszy, rozmiarów plików i innych sygnałów opartych na liczebności. Nagły spadek może oznaczać awarię ekstraktora w systemie źródłowym. Nagły skok może oznaczać duplikaty lub przypadkowe ponowne przetworzenie. Sama liczba nie wyjaśnia przyczyny, ale mówi, że coś się zmieniło.
Rozkład obejmuje zakresy, odsetek wartości null, kardynalność i wzorce wartości. To tutaj ujawniają się nagłe skoki wartości null, zaburzone proporcje kategorii i wartości odstające od typowych. To różnica między stwierdzeniem „tabela się załadowała” a „dane nadal wyglądają jak ten sam rodzaj danych”.
Schemat wychwytuje dodane, usunięte, przemianowane kolumny oraz kolumny o zmienionym typie. Takie zmiany są często przyczyną, dla której zapytania SQL w dalszych etapach przestają działać lub modele dbt zaczynają zwracać niekompletne wyniki. Zmianę strukturalną łatwo przeoczyć, jeśli sprawdza się jedynie, czy zadanie zakończyło się sukcesem.
Pochodzenie danych pozwala prześledzić, skąd dane pochodzą i co od nich zależy. Ma to znaczenie, gdy trzeba ustalić, czy defekt powstał w ekstrakcie źródłowym, w transformacji, czy u odbiorcy końcowego. Właśnie to pomaga też zespołom zrozumieć, dlaczego jedno uszkodzone pole może wpłynąć jednocześnie na kilka pulpitów.
Pojedyncze sygnały mogą wskazywać na objaw. Skorelowane sygnały wskazują na przyczynę.
To najważniejsza lekcja. Dojrzałe monitorowanie nie reaguje po prostu na jedną anomalię. Koreluje wiele perspektyw, dzięki czemu zespoły potrafią odróżnić nieaktualną tabelę od sezonowego wahania biznesowego i od rzeczywistej awarii potoku. Jeśli chcesz zobaczyć praktyczny przykład tego, jak te sygnały łączą się w widoku monitorowania, strona obserwowalność danych digna ściśle odpowiada temu modelowi pięciu perspektyw.
Dlaczego monitorowanie integralności stało się warstwą strategiczną
Jeszcze kilka lat temu wiele zespołów traktowało jakość danych jako pracę porządkową. Naprawić błędne wiersze, załatać pulpit i iść dalej. Takie podejście przestaje się sprawdzać, gdy analityka i AI zaczynają kierować decyzjami na dużą skalę.
Zmiana w branży jest widoczna w danych dotyczących wdrożeń. Badanie z 2026 roku wykazało, że tylko około 35–36 procent organizacji aktywnie monitoruje lub optymalizuje swoje programy integralności danych, podczas gdy mniej więcej 15–16 procent wciąż znajduje się na etapie przedplanowania badanie. Oznacza to, że praktyka ta weszła już do głównego nurtu działań operacyjnych, ale wciąż daleko jej do powszechności.
Dlaczego AI podnosi stawkę
Systemy AI nie tylko konsumują dane, ale także je wzmacniają. Jeśli dane wejściowe są nieaktualne, niekompletne lub zmienione strukturalnie, model nadal może generować wynik, który wygląda poprawnie. Ten wynik może być błędny, ale często będzie sprawiał wrażenie pewnego, i właśnie to czyni problem niebezpiecznym.
Dlatego monitorowanie integralności nie jest już tylko kwestią higieny technicznej. Pełni funkcję płaszczyzny kontroli dla gotowości na AI, ponieważ zespoły potrzebują dowodów, że dane zasilające analitykę i modele są aktualne, kompletne i identyfikowalne. Pomaga również w zakresie ładu danych i audytowalności, ponieważ pochodzenie danych i zmiany strukturalne stają się widoczne, zamiast ginąć w doraźnych logach.
Kogo to dotyczy i dlaczego
Czynnik | Interesariusz | Co psuje się bez monitorowania |
|---|---|---|
Gotowość na AI | Zespoły danych i ML | Modele są trenowane lub oceniają na danych nieaktualnych, niekompletnych lub zmienionych strukturalnie |
Ład danych | Zespoły ds. ryzyka i zgodności | Zespoły nie potrafią wykazać, co się zmieniło, kiedy się zmieniło ani na co to wpłynęło |
Niezawodność operacyjna | Zespoły platformowe i analityczne | Pulpity, transformacje i odbiorcy końcowi dryfują, zanim ktokolwiek to zauważy |
Strategiczny wniosek jest prosty. Jeśli brakuje monitorowania integralności danych, kosztem nie jest tylko błędny pulpit. To łańcuch błędnych decyzji, podejmowanych szybciej dzięki automatyzacji. Dla zespołów oceniających mechanizmy kontroli operacyjnej przydatne jest ujęcie przedstawione na stronie monitorowanie jakości danych digna, ponieważ traktuje ono integralność jako stały mechanizm kontroli, a nie jednorazowe porządki.
Porównanie podejść do monitorowania, które naprawdę działają
Nie każde podejście do monitorowania sprawdza się wszędzie. Właściwy projekt zależy od tego, gdzie znajdują się dane, jak szybko się zmieniają i ile szumu zespół jest w stanie przyjąć. Najlepsze programy zwykle łączą różne metody, zamiast stawiać na jedną.
Mocne i słabe strony poszczególnych podejść
Wykonywanie w bazie danych utrzymuje kontrole blisko danych. Ogranicza to przenoszenie danych, co ma znaczenie w środowiskach o wysokich wymaganiach bezpieczeństwa lub dużych wolumenach, i odpowiada zespołom, które chcą, by logika walidacji działała tam, gdzie już znajduje się hurtownia lub jezioro danych. Kompromis jest jednak oczywisty. Dziedziczy się ograniczenia platformy, na której się działa, więc przenośność może być mniejsza niż w przypadku narzędzi zewnętrznych.
Zewnętrzne skanery są bardziej elastyczne w różnych systemach. Mogą badać pliki, API, hurtownie i aplikacje końcowe spoza granicy bazy danych. Ta elastyczność wiąże się z narzutem, zwłaszcza gdy środowiska się rozrastają lub gdy zależy nam na niskich opóźnieniach.
Progi oparte na regułach są łatwe do zrozumienia. Wychwytują oczywiste awarie, takie jak tabela, której liczba wierszy nigdy nie powinna spaść poniżej minimum, lub strumień danych, który powinien dotrzeć o ustalonej godzinie. Mają trudności, gdy działalność jest sezonowa, ponieważ stały limit może oznaczać normalną zmianę jako problem.
Linie bazowe wyuczone przez AI lepiej dostosowują się do tego rodzaju zmienności. Są przydatne, gdy zbiór danych ma cykle tygodniowe, stopniowy dryf lub nieuporządkowaną historię. Wymagają jednak czasu na rozruch, a zespół musi zaakceptować, że początkowa pewność będzie niższa niż w przypadku stałej reguły.
Stosuj statyczne reguły dla znanych niezmienników, wyuczone linie bazowe dla zmieniających się zachowań, a korelację wielu sygnałów wtedy, gdy jeden objaw nie wystarcza.
Ten ostatni punkt jest najważniejszy. Pojedynczy alert dotyczący aktualności może być szumem. Aktualność w połączeniu z wolumenem i dryfem schematu daje bardziej wiarygodny obraz. Zespół, który chce utrzymać kontrole blisko hurtowni, a jednocześnie zapewnić szerokie pokrycie, może przyjrzeć się narzędziu do sprawdzania integralności danych digna jako przykładowi tego, jak można łączyć te elementy, nie traktując każdego sygnału w ten sam sposób.
Podejście | Zaleta | Ograniczenie | Najlepsze zastosowanie |
|---|---|---|---|
Wykonywanie w bazie danych | Niewielkie przenoszenie danych, dobre dopasowanie do środowisk objętych ładem danych | Mniejsza przenośność między platformami | Kontrole hurtowni o dużych wolumenach |
Zewnętrzne skanery | Szerokie pokrycie wielu systemów | Większy narzut przy dużej skali | Środowiska wielosystemowe i wielonarzędziowe |
Progi oparte na regułach | Przejrzyste, łatwe do wyjaśnienia | Zawodne przy wahaniach sezonowych | Stałe reguły biznesowe i twarde limity |
Linie bazowe wyuczone przez AI | Dostosowują się do normalnej zmienności | Wymagają rozruchu i dostrajania | Zmienne lub ewoluujące zbiory danych |
Korelacja wielu sygnałów | Ogranicza fałszywe alarmy i usprawnia diagnozę | Więcej pracy projektowej na starcie | Dojrzałe programy monitorowania |
Wzorce wdrożeniowe i dobre praktyki
Większość programów monitorowania zawodzi, ponieważ próbuje zrobić zbyt wiele zbyt wcześnie. Lepsze wdrożenie zaczyna się od poznania normalnego kształtu potoku, a alerty dodaje się warstwowo dopiero wtedy, gdy zespół rozumie, jak naprawdę wygląda „normalność”.
Punktem odniesienia, o którym warto pamiętać, jest skala. Jeden z cytowanych zbiorów danych monitorujących wykazał średnio 42 odrębne metryki na potok, w tym aktualność, zmienność wolumenu, dryf schematu i opóźnienie przetwarzania querysurge. Nie oznacza to, że każdy zespół powinien od razu ustawiać alerty na wszystkie 42. Oznacza to, że dojrzałe programy obserwują wiele sygnałów i wykorzystują je łącznie.

Wdrożenie, które nie przytłoczy zespołu
Najpierw poznaj linię bazową. Uruchamiaj kontrole w trybie obserwacji, zanim kogokolwiek zaalarmujesz. Zespoły muszą wyczuć zwykły dzienny rytm, zanim będą w stanie ocenić, czy zmiana jest rzeczywista.
Ustal priorytety według wpływu na biznes. Zacznij od aktualności, wolumenu, schematu i kontroli rozkładu, które chronią najbardziej widoczne zbiory danych. Nie rozpraszaj zespołu na każdą tabelę tylko dlatego, że narzędzia to ułatwiają.
Stosuj dynamiczne progi. Ustalaj limity dla każdego zasobu osobno, a nie jeden globalny próg. Strumień danych sprzedażowych, kliniczny i dotyczący wykorzystania usług telekomunikacyjnych nie będą miały tego samego normalnego wzorca.
Doskonal na podstawie informacji zwrotnych. Każdy rozwiązany incydent powinien usprawniać kolejny alert. Jeśli powiadomienie generowało szum, dostrój je. Jeśli wcześnie wychwyciło rzeczywistą awarię, zachowaj ten wzorzec i być może go rozszerz.
Odpowiedzialność jest równie ważna jak logika alertów. Każdy monitorowany zasób powinien mieć wskazanego opiekuna, ponieważ alerty bez właściciela stają się porzuconymi zgłoszeniami. Pomaga także kwartalny przegląd pokrycia, ponieważ potoki zmieniają się szybciej niż statyczne mapy monitorowania.
Operacyjne odzwierciedlenie tego sposobu myślenia wyraźnie widać na stronie wdrażanie jakości danych z digna, gdzie dyscyplina wdrożenia jest równie ważna jak same kontrole.
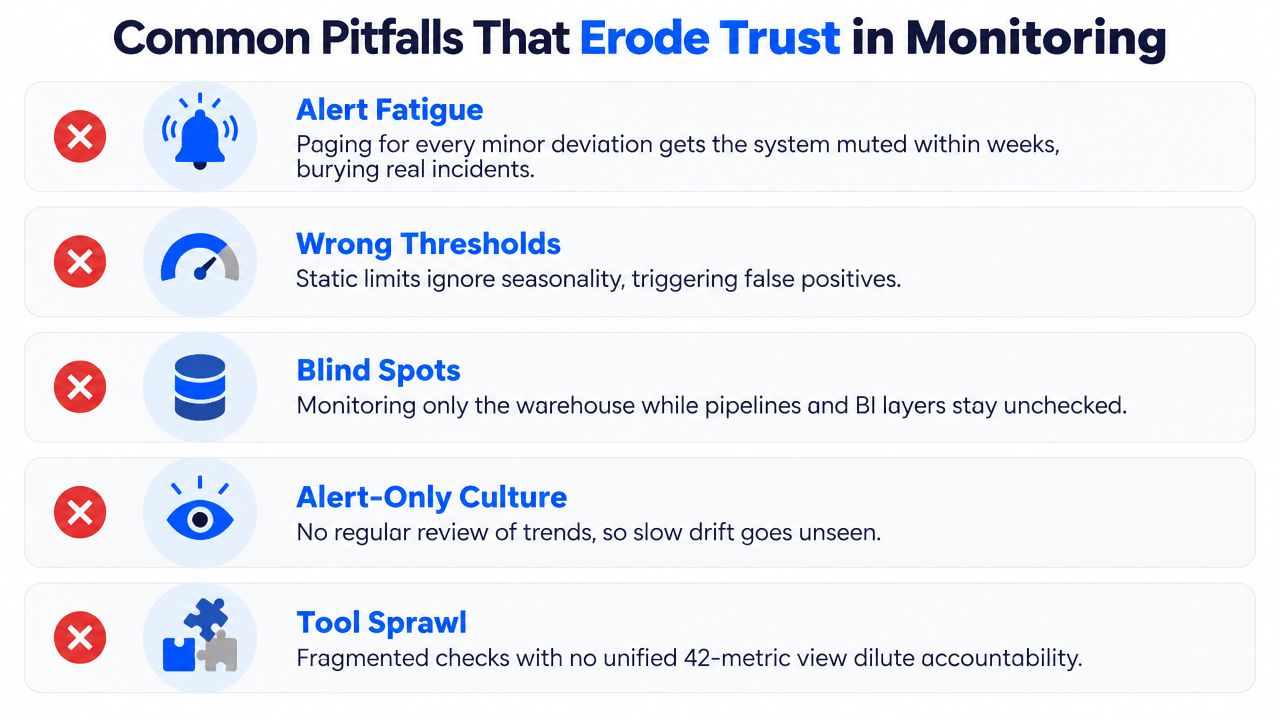
Typowe pułapki podważające zaufanie do monitorowania
Monitorowanie szybko traci wiarygodność, gdy zachowuje się jak hałaśliwy system alarmowy. Zespoły nie przestają mu ufać dlatego, że sama idea jest błędna, ale dlatego, że implementacja jest uciążliwa, zawodna lub ślepa na rzeczywiste tryby awarii.
Błędy, które pojawiają się w rzeczywistych programach
Zmęczenie alertami to najszybszy sposób na utratę zaufania zespołu. Jeśli system alarmuje przy każdym drobnym odchyleniu, ludzie go wyciszają, a wtedy prawdziwa awaria przechodzi niezauważona.
Niewłaściwe progi rodzą inny rodzaj nieufności. Statyczne limity ignorują sezonowość, promocje, szczyty na koniec miesiąca i inne rytmy biznesowe, przez co zupełnie normalne zmiany wyglądają jak incydenty.
Martwe pola powstają, gdy zespoły obserwują tylko hurtownię i ignorują etapy potoku oraz warstwę BI, która z niej korzysta. Efektem jest fałszywe poczucie pełnego pokrycia.
Kultura opierająca się wyłącznie na alertach to kolejna cicha awaria. Jeśli nikt nie analizuje trendów, system przeoczy powolny dryf, który nie przekracza twardego progu, dopóki nie stanie się widoczny dla użytkowników.
Rozrost narzędzi zaciera odpowiedzialność. Rozproszone kontrole w wielu systemach rzadko składają się na jeden obraz operacyjny, dlatego tak ważny jest ujednolicony widok.
Zaufanie bierze się z mniejszej liczby lepszych alertów, a nie z większego szumu.
Środki zaradcze są proste, ale nie opcjonalne. Stosuj poziomy ważności, wiąż progi z zachowaniem linii bazowej, dodaj subskrypcje zmian schematu i wpisz regularne przeglądy do kalendarza. Przede wszystkim traktuj monitorowanie jako żywy mechanizm kontroli, a nie projekt, który ogłasza się jako zakończony po uruchomieniu.
Stawka w poszczególnych branżach regulowanych
Ta sama logika monitorowania sprawdza się inaczej w zależności od branży. Zespół finansowy, szpitalna grupa analityczna, operator telekomunikacyjny i instytucja publiczna – wszystkim zależy na integralności, ale każdy obawia się innych punktów awarii.
Cztery przykłady, cztery różne wzorce awarii
W usługach finansowych najniebezpieczniejszą awarią jest często nieaktualny lub przesunięty strumień danych o ryzyku. Model może nadal oceniać transakcje, podczas gdy bazowy sygnał nadużyć jest przestarzały, co może zniekształcić zarówno decyzje, jak i ścieżki audytu.
W opiece zdrowotnej najostrzejszym problemem są zmiany strukturalne. Przemianowana kolumna diagnozy może po cichu przenieść przypadki o wysokim stopniu ciężkości do niewłaściwej kategorii, co oznacza, że problem ujawnia się w raportowaniu klinicznym na długo przed tym, zanim ktokolwiek zauważy kwestię schematu.
W telekomunikacji kłopotem są zazwyczaj skala i zmienność. Pulpit odpływu klientów może przeoczyć regionalną awarię, jeśli tabele przychodów lub wykorzystania ładują się normalnie, podczas gdy inny strumień danych się opóźnia.
W sektorze publicznym zerwane zależności często ujawniają się w procesach dotyczących uprawnień lub świadczeń. Zmiana schematu u dostawcy może sprawić, że złączenie przestanie poprawnie dopasowywać rekordy, co powoduje problemy z usługami na dalszych etapach, trudne do rozwikłania po fakcie.
Branża | Główne ryzyko dla integralności | Najcenniejszy sygnał | Stawka regulacyjna |
|---|---|---|---|
Usługi finansowe | Nieaktualne lub przesunięte dane o ryzyku | Aktualność i pochodzenie danych | Audytowalność i kontrole sprawozdawcze |
Opieka zdrowotna | Cicha zmiana strukturalna | Schemat i rozkład | Niezawodność kliniczna i identyfikowalność |
Telekomunikacja | Dryf potoków o dużych wolumenach | Wolumen i aktualność | Ciągłość operacyjna i dokładność usług |
Sektor publiczny | Zerwane złączenia po zmianach u dostawcy | Schemat i pochodzenie danych | Uprawnienia do usług, rozliczalność i integralność rejestrów |
Błędem jest zakładanie, że jedna konfiguracja pasuje do wszystkich. Ramy są te same, ale zmienia się waga poszczególnych elementów. Środowisko regulowane potrzebuje sygnałów dostrojonych do awarii, której najmniej może sobie pozwolić przeoczyć, a nie ogólnej listy kontrolnej skopiowanej ze stosu technologicznego innego zespołu.
Wszystko razem z digna
Awaria pulpitu z początku artykułu, ramy pięciu perspektyw, punkt odniesienia 42 metryk i przykłady branżowe prowadzą do tego samego wniosku. Monitorowanie integralności danych działa, gdy staje się ciągłą warstwą kontrolną, a nie okazjonalną inspekcją.

Praktyczny punkt odniesienia
digna to jeden ze sposobów wdrożenia tego modelu we własnym środowisku klienta – z kontrolami, które działają w bazie danych i obejmują aktualność, wolumen, rozkład, schemat i pochodzenie danych w modułowej konfiguracji. Odpowiada to również opisanemu wyżej wzorcowi wdrożenia, w którym najpierw ustala się linie bazowe, a alerty zaostrza się dopiero wtedy, gdy system rozumie normalne zachowanie.
Najważniejszych jest tu kilka punktów:
Zastosowanie pięciu perspektyw. Ten sam zestaw może jednocześnie obserwować terminowość, zmiany strukturalne, kontekst zależności i odchylenia od linii bazowej.
Myślenie w kategoriach 42 metryk. Dojrzałe monitorowanie to nie jedna kontrola na tabelę, lecz zestaw sygnałów dopasowany do zbioru danych i ryzyka.
Etapowe wdrożenie. Obserwacja poprzedza alarmowanie, dzięki czemu program pozostaje użyteczny, a nie hałaśliwy.
Zachowanie zaufania. Dostrojone progi pomagają zapewnić, że zespół jest budzony tylko wtedy, gdy coś naprawdę wymaga działania.
Praktyczny następny krok jest prosty. Wybierz jeden krytyczny potok, skonfiguruj pięć perspektyw, poznaj linię bazową i pozwól, by anomalie ujawniły się, zanim zauważą je użytkownicy. Jeśli potrzebujesz konkretnego punktu odniesienia dla takiej konfiguracji, odwiedź digna i oceń, jak jej podejście do monitorowania pasuje do tego jednego potoku, w którym nie możesz sobie pozwolić na błąd.
Jeśli chodzi o opisane wyżej linie bazowe wyuczone przez AI, które dostosowują się do cykli tygodniowych i stopniowego dryfu zamiast polegać na statycznych progach, zobacz, jak digna Data Anomalies uczy się normalnego zachowania dla każdego zbioru danych.
Najczęściej zadawane pytania
Czym jest monitorowanie integralności danych?
Monitorowanie integralności danych to ciągła warstwa kontrolna, która obserwuje bieżące dane pod kątem zakłóceń aktualności, wolumenu, rozkładu, schematu i pochodzenia danych. W przeciwieństwie do jednorazowych testów przeprowadzanych przy wdrożeniu działa w środku cyklu życia potoku, dzięki czemu nieaktualne ładowania, brakujące rekordy i zmiany schematu wychodzą na jaw, zanim zauważą je interesariusze.
Jakie jest pięć filarów monitorowania integralności danych?
Pięć perspektyw to aktualność, wolumen, rozkład, schemat i pochodzenie danych. Aktualność określa, czy dane dotarły na czas, wolumen śledzi liczbę wierszy i rozmiary plików, rozkład obejmuje odsetek wartości null i wzorce wartości, schemat wychwytuje dodane lub przemianowane kolumny, a pochodzenie danych pokazuje, gdzie powstał defekt i co od niego zależy.
Czym monitorowanie integralności danych różni się od testowania danych?
Testowanie sprawdza, czy znana reguła nadal jest spełniona, zwykle przy wdrożeniu lub w punktach walidacji. Monitorowanie obserwuje bieżący stan potoku i wychwytuje dryf, który później zepsuje raporty lub modele. Praktyczna zasada z artykułu: jeśli kontrola uruchamia się dopiero po skardze interesariusza, nie jest to monitorowanie.
Ile metryk należy monitorować w jednym potoku danych?
Jeden z cytowanych zbiorów danych monitorujących wykazał średnio 42 odrębne metryki na potok, obejmujące aktualność, zmienność wolumenu, dryf schematu i opóźnienie przetwarzania. Nie oznacza to ustawiania alertów na wszystkie 42 naraz; dojrzałe programy obserwują wiele sygnałów i je korelują, zaczynając od zbiorów danych o największym wpływie na biznes.
Jak wdrożyć monitorowanie integralności danych bez zmęczenia alertami?
Zacznij w trybie obserwacji, aby poznać linię bazową, zanim kogokolwiek zaalarmujesz, a następnie nadaj priorytet najbardziej widocznym zbiorom danych. Ustalaj dynamiczne progi dla każdego zasobu zamiast jednego globalnego, dostrajaj każdy hałaśliwy alert po incydencie, przypisz każdemu monitorowanemu zasobowi opiekuna i co kwartał przeglądaj pokrycie.


