Jak utworzyć plik konfiguracyjny, który działa
|
5
min. czyt.

Aby nauczyć się, jak utworzyć plik konfiguracyjny, określ ustawienia potrzebne aplikacji, wybierz czytelny format, zapisz plik z właściwym rozszerzeniem i zweryfikuj go, zanim cokolwiek trafi na produkcję. Celem jest oddzielenie zachowania w czasie działania od kodu aplikacji, tak aby zespoły mogły dostosowywać środowiska bez zmieniania bazy kodu.
Spis treści
Pliki konfiguracyjne i szybka konfiguracja
Plik konfiguracyjny wypełnia lukę między kodem a środowiskiem uruchomieniowym. Zamiast zapisywać na sztywno w kodzie źródłowym parametry połączenia z bazą danych, punkty końcowe API, poziomy logowania czy flagi funkcji, przechowujesz je na zewnątrz, dzięki czemu upoważnieni członkowie zespołu mogą je aktualizować niezależnie.
Takie rozdzielenie ma znaczenie w systemach finansowych, medycznych i sektora publicznego, w których zmiany muszą być kontrolowane, objęte ograniczonym dostępem i audytowalne. Ogranicza też liczbę błędów wdrożeniowych, ponieważ środowiska deweloperskie, testowe i produkcyjne mogą używać różnych wartości przy wspólnym kodzie aplikacji.
Zacznij od wypisania ustawień, bez których aplikacja nie może działać:
Dane połączenia, takie jak nazwy baz danych i odwołania do usług
Flagi funkcji, które włączają lub wyłączają opcjonalne zachowania
Ustawienia logowania, w tym poziom szczegółowości i miejsce zapisu logów
Etykiety środowisk, aby aplikacja wczytywała właściwy profil przy starcie
Wybierz format pasujący do Twojego zestawu narzędzi. YAML jest czytelny i dobrze radzi sobie z hierarchią. JSON jest rygorystyczny i bezproblemowo współpracuje z API. INI sprawdza się w przypadku prostych par klucz-wartość. TOML zapewnia jednoznaczną strukturę bez zbędnych formalności.
Poniższy wykres porównuje te cztery formaty pod względem czytelności, hierarchii, obsługi komentarzy i typowych zastosowań.
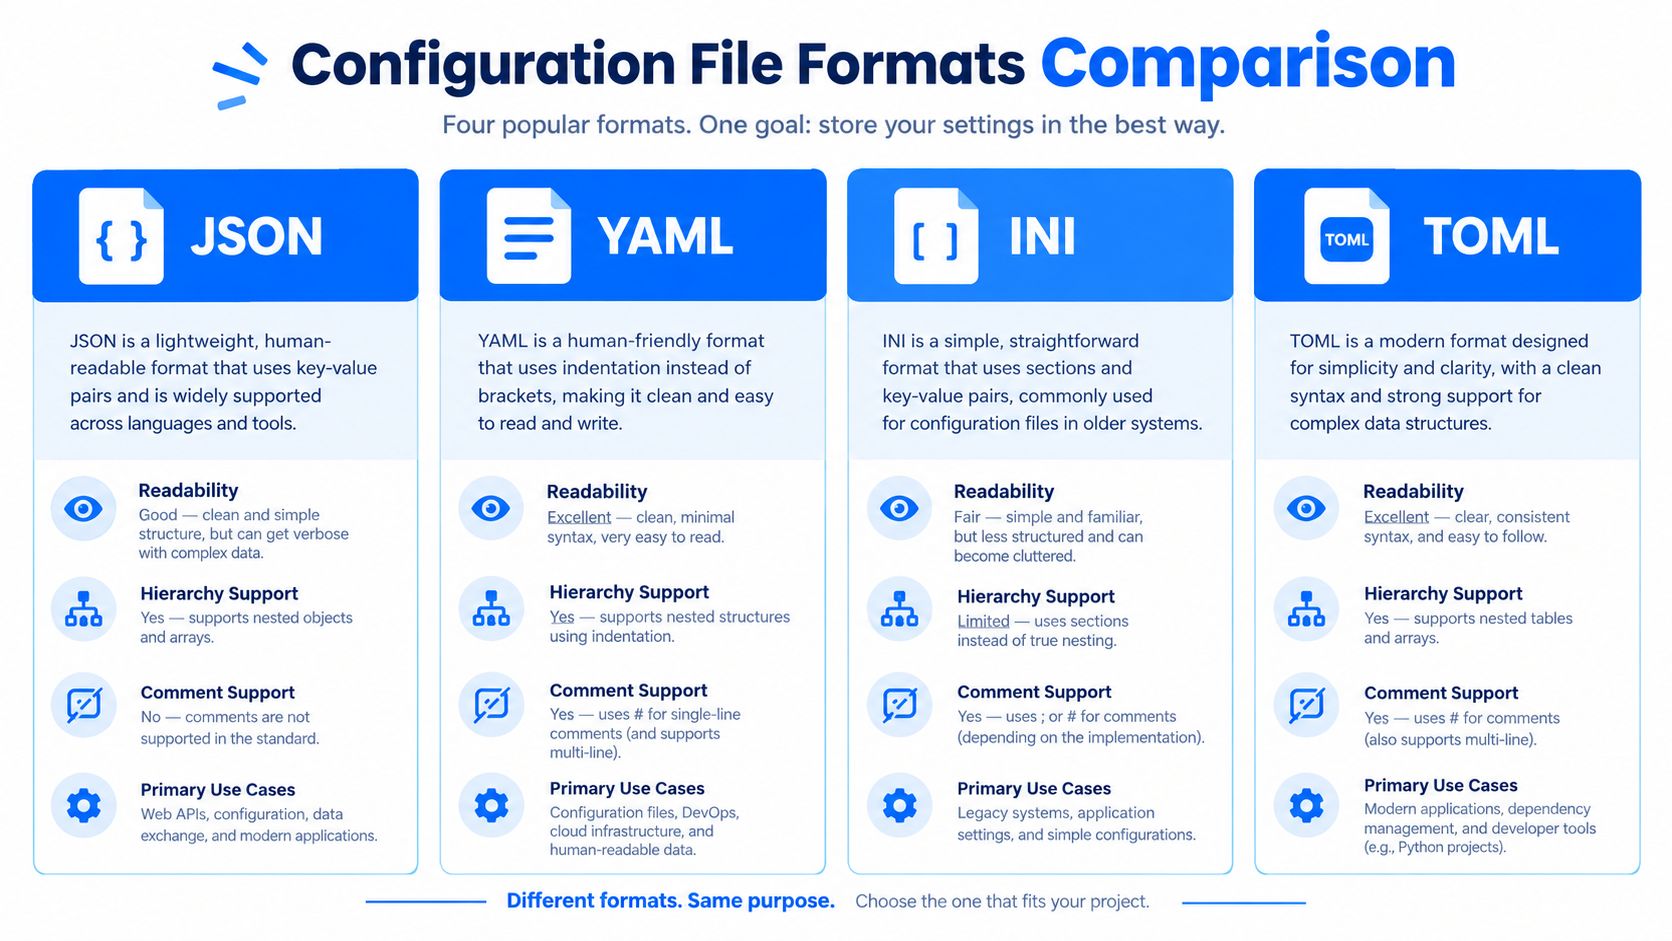
Zauważysz, że YAML i TOML sprzyjają edycji przez człowieka, podczas gdy JSON został zaprojektowany do ścisłego parsowania maszynowego, a INI pozostaje przydatny przy płaskich, prostszych ustawieniach.
Wskazówka: Traktuj każdy plik konfiguracyjny jako dane wejściowe, które mogą zawieść. Zawsze parsuj go i weryfikuj przed uruchomieniem aplikacji – nigdy nie zakładaj, że wczyta się poprawnie.
Jeśli pracujesz w Pythonie i chcesz połączyć procesy monitorowania z kodem aplikacji, zajrzyj do dokumentacji Python SDK digna, aby zobaczyć praktyczny przykład tego, jak konfiguracja wspiera obserwowalność w rzeczywistych warunkach.
Wybór właściwego formatu konfiguracji sprowadza się do trzech czynników: czego oczekuje aplikacja, co już obsługuje Twój potok wdrożeniowy i kto będzie utrzymywał plik za pół roku. Nie wybieraj wyłącznie na podstawie osobistych preferencji. Wybierz format, który Twój zestaw narzędzi niezawodnie obsługuje.

Dopasuj format do sposobu pracy
YAML jest popularny nie bez powodu. Pojawia się w manifestach Kubernetes, konfiguracjach Docker Compose i definicjach potoków CI/CD, ponieważ jego struktura oparta na wcięciach jest łatwa do odczytania. Jedna źle postawiona spacja może jednak zepsuć cały plik. Jeden dodatkowy tabulator może uniemożliwić uruchomienie kontenera. Spójność ustawień edytora i lintowanie są niezbędne.
JSON sprawdza się, gdy plik generują maszyny. Kontrakty API, serializowane ładunki danych i automatycznie generowane ustawienia korzystają z jego ścisłej składni. Wadą jest to, że ręczna edycja dużego pliku JSON staje się żmudna, a brakujący przecinek może wywołać niejasny błąd parsera.
INI znajduje się na drugim końcu spektrum. Używa płaskich sekcji z prostymi parami klucz-wartość. W przypadku małego narzędzia desktopowego lub lekkiego narzędzia deweloperskiego ta prostota jest zaletą, a nie ograniczeniem.
TOML zapewnia czytelność bez polegania na wcięciach. Nagłówki sekcji, typowane wartości i przewidywalna struktura czynią go atrakcyjnym dla nowoczesnych narzędzi. Kompromisem jest stopień przyjęcia: nie każdy język czy platforma oferuje pełnoprawną obsługę TOML.
Format | Najlepsze zastosowanie | Główna kwestia |
|---|---|---|
YAML | Infrastruktura i potoki | Błędy wcięć |
JSON | API i dane generowane | Rozwlekła edycja |
INI | Płaskie ustawienia aplikacji | Ograniczone zagnieżdżanie |
TOML | Jednoznaczne, nowoczesne narzędzia | Mniej powszechna obsługa |
Praktyczna zasada: Wybierz format, który znają już Twój parser, platforma wdrożeniowa i zespół utrzymaniowy.
W korporacyjnych środowiskach analitycznych YAML i JSON są częstym wyborem. Równoważą czytelność dla człowieka z niezawodną automatyzacją. Oba formaty to cenne umiejętności dla inżynierów danych i inżynierów platform. Jeśli Twoje potoki korzystają również z kolumnowych formatów przechowywania, dowiedz się więcej o plikach Parquet i ich strukturze, zanim podłączysz te zbiory danych do swojego stosu monitorowania lub przetwarzania.
Zawsze weryfikuj konfigurację za pomocą faktycznie używanego parsera, zanim wyślesz ją do rzeczywistego środowiska. Plik, który wygląda dla Ciebie poprawnie, może nadal zawieść, gdy aplikacja natrafi na nieobsługiwany przypadek brzegowy.
Każdy niezawodny plik konfiguracyjny zaczyna się od rzetelnej inwentaryzacji. Uwzględnij tylko to, czego aplikacja naprawdę potrzebuje do działania – odwołania do baz danych, punkty końcowe usług, poziomy logowania, flagi funkcji i podobne ustawienia. Następnie pogrupuj powiązane wartości w sensownych przestrzeniach nazw, zamiast rozpraszać je po całym pliku.

Porządkuj ustawienia według obszarów aplikacji
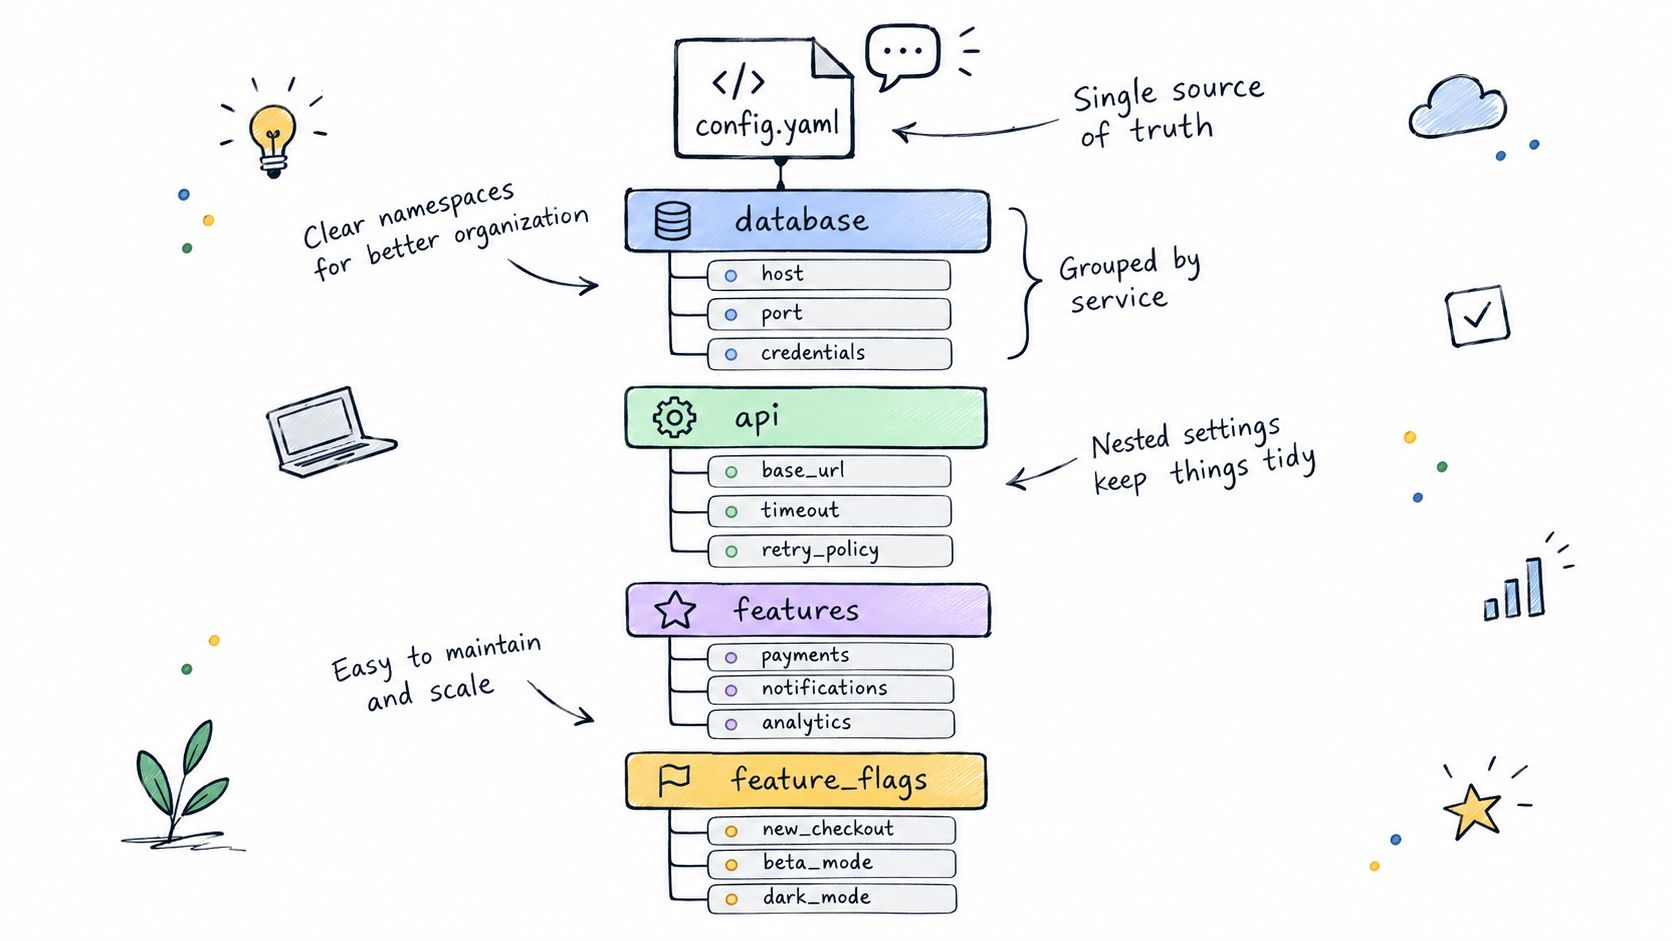
Załóżmy, że konfigurujesz usługę raportowania w YAML. Plik mógłby wyglądać tak:
Gdy o 2 w nocy dochodzi do incydentu, taka struktura się zwraca. Każda osoba pełniąca dyżur szybko znajdzie właściwe ustawienie, zamiast przeszukiwać ścianę kluczy. JSON działa podobnie: zagnieżdżaj odpowiadające sobie obiekty i stosuj spójne wcięcia o szerokości dwóch spacji. INI działa inaczej, więc zachowaj płaską strukturę i opieraj się na jasno nazwanych sekcjach, takich jak [database] i [logging].
Używaj komentarzy wybiórczo. Dodawaj je, aby wyjaśnić nietypowy limit czasu, tymczasowy przełącznik funkcji lub wartość, która musi pozostać zsynchronizowana z innym systemem. Komentarz, który jedynie powtarza nazwę parametru, wprowadza szum. Czytelnicy potrzebują uzasadnienia decyzji, a nie jej echa.
Najważniejsze: Plik konfiguracyjny powinien wyjaśniać decyzje dotyczące działania aplikacji, a nie zmuszać czytelników do ich odtwarzania metodą inżynierii wstecznej.
Przed zapisaniem pliku przeprowadź trzy szybkie kontrole:
Użyj oczekiwanego rozszerzenia – takiego jak
.yaml,.jsonlub.ini– aby narzędzia rozpoznały plik.Zachowaj spójne nazewnictwo, wybierając jedną konwencję, np.
timeout_seconds, i stosując ją wszędzie.Rozdziel środowiska, aby środowisko deweloperskie i produkcyjne mogły używać różnych wartości bez zmiany logiki aplikacji.
Jeśli Twoje ustawienia opisują zbiory danych lub metadane, dowiedz się więcej o opisach schematów baz danych, aby terminologia konfiguracji była spójna z danymi, którymi steruje.
Od razu przetestuj plik za pomocą rzeczywistego parsera aplikacji. Plik może wyglądać poprawnie, a mimo to zawierać nieobsługiwany klucz, niepoprawny typ lub brakującą wymaganą wartość. Wykrycie tych problemów przed wdrożeniem sprawia, że zmiany konfiguracji są przewidywalne, i ogranicza pracę związaną z przywracaniem działania.
Zarządzanie konfiguracją na dużą skalę wykracza poza wybór właściwego formatu. Każdy plik konfiguracyjny niezawierający sekretów powinien znajdować się w Git. Kontrola wersji daje zespołom wgląd w zmiany, prostą ścieżkę wycofania i ślad audytowy na potrzeby zgodności z przepisami.
Dyscyplina commitów ma znaczenie. Małe, skoncentrowane commity z komunikatami takimi jak Increase reporting timeout są bardziej przydatne niż jeden duży commit miscellaneous fixes. W przypadku zmian produkcyjnych przegląd w ramach pull requestu powinien być obowiązkowy. Gdy wdrażasz aktualizację konfiguracji w wielu usługach, oznacz wydanie tagiem, aby móc je później odnaleźć.
Chroń sekrety i weryfikuj zmiany
Hasła, tokeny, klucze prywatne i parametry połączeń nie powinny trafiać do commitowanych plików. Zamiast tego odwołuj się do zmiennych środowiskowych lub pobieraj sekrety z dedykowanego systemu zarządzania, który zapewnia kontrolę dostępu i rotację bez konieczności zmian w kodzie aplikacji.
Przed scaleniem jakiejkolwiek zmiany konfiguracji połącz kontrole automatyczne z przeglądem przez człowieka:
Sparsuj plik tą samą biblioteką, której używa aplikacja, aby wcześnie wychwycić problemy z parsowaniem w czasie działania.
Zweryfikuj schemat, aby wykryć brakujące klucze, niepoprawne typy lub nieoczekiwane wartości.
Uruchom linter, aby wykryć niespójności formatowania i błędy składni.
Skanuj commity pod kątem sekretów, zanim trafią do współdzielonego repozytorium; usuwanie wycieków z historii jest znacznie trudniejsze niż zapobieganie im.
Testuj nadpisania środowiskowe, aby środowisko testowe i produkcyjne przyjmowały oczekiwane wartości, a nie zapomniane wartości domyślne.
Najważniejsze: Traktuj konfigurację jak kod produkcyjny, a sekrety jako odrębną granicę bezpieczeństwa.
Konwencje nazewnictwa sprawiają problemy większej liczbie zespołów, niż można by się spodziewać. Wybierz jeden styl – np. timeout_seconds lub TIMEOUT_SECONDS – i stosuj go konsekwentnie we wszystkich usługach. Dokumentuj wymagane zmienne i dbaj o przewidywalność nadpisań środowiskowych. Dobrze sprawdza się plik bazowy z rozsądnymi wartościami domyślnymi, w którym pliki środowiska testowego i produkcyjnego nadpisują tylko wartości, które faktycznie się różnią.
Zbuduj niezawodne mechanizmy kontroli wdrożeń
Skonfiguruj bramkę w potoku, która blokuje przedostanie się nieprawidłowej konfiguracji do wdrożenia. W przypadku usług krytycznych wprowadzaj zmiany stopniowo, uważnie monitoruj metryki uruchamiania i stanu oraz utrzymuj przetestowaną ścieżkę wycofania.
Jeśli potrzebujesz przypomnienia, dlaczego to ważne, warto przeczytać analizę poawaryjną Cloudflare dotyczącą awarii z listopada 2025 r. Pokazuje ona, dlaczego generowana konfiguracja wymaga własnej walidacji, limitów rozmiaru, kontrolowanej propagacji i znanej, sprawdzonej wersji do przywrócenia.
Zespołom przetwarzającym dane klientów digna oferuje wskazówki dotyczące ochrony danych klientów w środowiskach korporacyjnych. Zasada jest prosta: dbaj, aby konfiguracje pozostawały możliwe do przeglądu, audytowalne i odtwarzalne w miarę rozwoju usług i zespołu.
Nawet dobrze zorganizowana konfiguracja może zawieść podczas parsowania, wczytywania lub działania. Kluczowe jest ustalenie, czy masz do czynienia z problemem składni, czy z rzeczywistym błędem w czasie działania, a następnie przetestowanie w pierwszej kolejności właściwej warstwy.
Najpierw wykryj problemy z parsowaniem
YAML często psuje się z powodu niespójnych wcięć, zwłaszcza gdy w jednym pliku występują tabulatory i spacje. JSON zwykle zawodzi z powodu brakujących cudzysłowów, zbędnego przecinka przed nawiasem zamykającym lub niezamkniętego nawiasu.
Przepuść konfigurację przez dokładnie ten parser, którego używa aplikacja. Następnie dodaj do procesu deweloperskiego linter lub walidator schematu, aby te kontrole odbywały się automatycznie. Nieprawidłowa struktura powinna zostać wykryta na długo przed dotarciem na produkcję.
Sprawdź wcięcia i zagnieżdżenia w plikach YAML.
Sprawdź cudzysłowy, przecinki i nawiasy w JSON.
Upewnij się, że występują wymagane klucze i oczekiwane typy wartości.
Upewnij się, że rozszerzenie nazwy pliku odpowiada temu, czego oczekuje mechanizm wczytujący.
Najważniejsze: Plik, który wygląda idealnie w edytorze, nadal wymaga automatycznego parsowania i walidacji schematu, aby można było mu zaufać.
Zbadaj błędy w czasie działania
Czasami konfiguracja parsuje się bez problemów, ale zawodzi, gdy aplikacja korzysta z jej wartości. Nieprawidłowy numer portu, nieobsługiwana opcja, brakująca zmienna środowiskowa lub nieosiągalny punkt końcowy mogą zablokować uruchomienie albo spowodować błędy, które pojawią się dopiero po kilku godzinach.
Zacznij od porównania problematycznego pliku ze znaną, działającą konfiguracją, zmieniając po jednej wartości, aż problem się pojawi. Następnie przejrzyj logi aplikacji; komunikat o błędzie często wskazuje klucz lub wartość, która spowodowała awarię.
Przed wypchnięciem na produkcję sprawdź następujące kwestie:
Usługi, do których się odwołujesz, są dostępne w środowisku docelowym.
Nadpisania zmiennymi środowiskowymi dają oczekiwane wartości.
Żadne dane uwierzytelniające ani tokeny nie są zapisane na sztywno jawnym tekstem.
Limity zasobów akceptują skonfigurowane wartości bez ich obcinania.
Dostępna jest przetestowana wcześniejsza wersja do wycofania zmian.
Raport Cloudflare dotyczący awarii z 18 listopada 2025 r. potwierdza, że generowana konfiguracja wymaga limitów rozmiaru, kontrolowanej propagacji i znanej, sprawdzonej wersji do przywrócenia. Zadbanie o te szczegóły przed wdrożeniem sprawia, że wdrożenia są bardziej przewidywalne, i pomaga chronić dostępność, gdy pojawią się problemy.
Pliki konfiguracyjne dają narzędziom do zapewniania jakości danych jasny, spójny plan działania. Podczas konfigurowania digna zdefiniuj odwołania do połączeń z bazami danych, harmonogramy monitorowania, reguły walidacji i progi alertów w dedykowanej warstwie konfiguracji, zamiast rozpraszać je po wielu skryptach.
Na przykład zespół finansowy może sprawdzać tabele transakcji w miarę napływu nowych ładunków danych, oznaczać nietypowe zmiany wolumenu i weryfikować, czy regulacyjne zbiory danych są dostarczane zgodnie z harmonogramem. W ochronie zdrowia ta sama struktura może wspierać walidację rekordów, wykrywanie zmian schematu i alerty, gdy dostarczanie danych klinicznych się opóźnia.
Praktyczna konfiguracja sprawia, że każdą decyzję dotyczącą monitorowania łatwo znaleźć:
Ustawienia połączenia wskazują zatwierdzone źródło danych bez ujawniania danych uwierzytelniających.
Harmonogramy określają, kiedy mają być uruchamiane kontrole terminowości i inne zadania monitorowania.
Progi definiują, kiedy dryf, opóźnienia lub błędy walidacji wymagają uwagi.
Ustawienia modułów włączają lub wyłączają wykrywanie anomalii, walidację, kontrolę terminowości lub śledzenie schematów.
Najważniejsze: Konfiguracja powinna opisywać, co digna monitoruje i jak reaguje. Przechowuj sekrety w zmiennych środowiskowych lub w zatwierdzonym menedżerze sekretów, a nie w plikach konfiguracyjnych.
Dbaj o bezpieczeństwo i testowalność ustawień monitorowania
digna działa w Twojej własnej chmurze, VPC lub centrum danych i oblicza metryki bezpośrednio w Twoich bazach danych. Takie podejście pozwala zespołom pozostawić dane na miejscu, a jednocześnie stosować spójne mechanizmy kontroli w hurtowniach, jeziorach danych i potokach.
Rozdziel pliki konfiguracyjne według środowisk – deweloperskiego, testowego i produkcyjnego. Przed wprowadzeniem nowego harmonogramu lub progu alertu przetestuj go na reprezentatywnych danych i przejrzyj wynikające z tego incydenty. Każdą zmianę obejmij kontrolą wersji, aby inżynierowie danych mogli ustalić, kto zmodyfikował regułę, i bez nerwowego pośpiechu wrócić do znanej, sprawdzonej wersji.
Aby dokładniej zobaczyć, jak wspiera to szerszą strategię monitorowania, poznaj możliwości integracji jakości danych w digna. Takie podejście pomaga zespołom z sektorów finansowego, ochrony zdrowia i telekomunikacji utrzymać wiarygodność systemów analitycznych i AI bez kompromisów w zakresie bezpieczeństwa czy wymogów audytowych.
Odpowiedzi na pytania o format i bezpieczeństwo
Decydując, jak utworzyć plik konfiguracyjny, używaj JSON do rygorystycznych, generowanych maszynowo ustawień, a YAML do czytelnych plików infrastruktury. W praktyce najlepszym wyborem jest zwykle format, który już obsługują Twój parser i narzędzia wdrożeniowe.
Aby rotować sekrety bez przestojów, przechowuj je w menedżerze sekretów, opublikuj nową wersję i pozwól aplikacjom ponownie wczytać dane uwierzytelniające, zanim unieważnisz stare.
Najważniejsze: Nigdy nie commituj danych uwierzytelniających. Jeśli dojdzie do ich ujawnienia, natychmiast unieważnij sekret, usuń go z aktywnych plików i przyjmij, że Twoja historia Git została naruszona.
Zachowaj przewidywalność walidacji i środowisk
Uruchamiaj parsery formatów, kontrole schematów i lintery w CI/CD. Narzędzia takie jak yamllint, walidatory JSON Schema i natywne kontrole platform mogą blokować nieprawidłowe zmiany, zanim trafią na produkcję.
Jasno dokumentuj kolejność pierwszeństwa: wartości z wiersza poleceń zazwyczaj nadpisują zmienne środowiskowe, a te z kolei nadpisują wartości domyślne z plików. W przypadku mikrousług wykrywaj dryf, porównując wynikowe konfiguracje z wersjonowaną konfiguracją bazową.
Zawsze przechowuj znaną, sprawdzoną konfigurację na potrzeby wycofania zmian. digna pomaga zespołom monitorować zachowanie danych i zmiany schematów bezpośrednio we własnym środowisku.
Poznaj digna na digna.ai, aby wspierać niezawodne operacje na danych.
Najczęściej zadawane pytania
Do czego służy plik konfiguracyjny?
Plik konfiguracyjny przechowuje ustawienia czasu działania poza kodem źródłowym, dzięki czemu upoważnieni członkowie zespołu mogą je zmieniać bez ingerencji w bazę kodu. Typowo zawiera dane połączenia z bazą danych, flagi funkcji, poziom szczegółowości i miejsce zapisu logów oraz etykiety środowisk, które wskazują aplikacji, jaki profil wczytać przy starcie.
Czy w pliku konfiguracyjnym używać YAML, JSON, INI czy TOML?
Wybierz format, który znają już Twój parser, platforma wdrożeniowa i zespół utrzymaniowy. YAML pasuje do manifestów Kubernetes i potoków CI/CD, ale psuje się przez jedną źle postawioną spację, JSON sprawdza się w API i danych generowanych, INI obsługuje płaskie ustawienia klucz-wartość, a TOML oferuje jednoznaczną strukturę przy mniej powszechnej obsłudze w językach programowania.
Jak zweryfikować plik konfiguracyjny przed wdrożeniem?
Przepuść go przez dokładnie ten parser, którego używa aplikacja, a następnie dodaj w CI/CD walidację schematu i linter, taki jak yamllint lub walidator JSON Schema. Artykuł zaleca także skanowanie commitów pod kątem sekretów i testowanie nadpisań środowiskowych, aby środowisko testowe i produkcyjne przyjmowały oczekiwane wartości, a nie zapomniane wartości domyślne.
Czy hasła i klucze API powinny trafiać do pliku konfiguracyjnego?
Nie. Hasła, tokeny, klucze prywatne i parametry połączeń należą do zmiennych środowiskowych lub dedykowanego menedżera sekretów, nigdy do commitowanych plików. Aby rotować sekret bez przestojów, opublikuj nową wersję, pozwól aplikacjom ją wczytać, a następnie unieważnij starą. Jeśli sekret wycieknie, natychmiast go unieważnij i traktuj historię Git jako naruszoną.
Dlaczego plik konfiguracyjny parsuje się poprawnie, a aplikacja mimo to nie działa?
Błędy w czasie działania wynikają z wartości, a nie ze składni: nieprawidłowego numeru portu, nieobsługiwanej opcji, brakującej zmiennej środowiskowej lub nieosiągalnego punktu końcowego. Porównaj problematyczny plik ze znaną, działającą konfiguracją, zmieniaj po jednej wartości, aż pojawi się błąd, i sprawdź logi aplikacji, które często wskazują winny klucz.


