Model operacyjny jakości danych: praktyczny przewodnik dla firm
|
7
min. czyt.

Regionalny zespół prognoz otworzył na koniec kwartału pulpit przychodów i zobaczył wiarygodnie wyglądającą liczbę, choć populacja klientów w danych źródłowych podwoiła się. Migracja systemu źródłowego połączyła konta aktywne i nieaktywne, nikt nie odpowiadał za logikę scalania, a żaden alert nie pokazał zmiany liczby wierszy na tyle wcześnie, by wstrzymać decyzję. Decyzję cenową wycofano, audyt wskazał brak lineage, a inżynierowie trzy razy odbudowywali ten sam pipeline, zanim data steward w końcu zablokował źródło.
Takie incydenty opisuje się zwykle jako problem z narzędziami. Rzadko nim są. Organizacja miała pipeline'y, pulpity, inżynierów i zapewne sporo kodu walidacyjnego. Brakowało jasnej odpowiedzi na cztery pytania operacyjne: kto definiuje akceptowalną jakość, kto odpowiada za awarię, kto może zablokować dane i kto decyduje o zamknięciu sprawy.
Model operacyjny jakości danych dostarcza dokładnie tej brakującej struktury decyzyjnej. Łączy walidację, observability, terminowość, odpowiedzialność i eskalację, dzięki czemu jakość staje się powtarzalną zdolnością operacyjną, a nie zbiorem niepowiązanych reguł. Tę potrzebę coraz trudniej ignorować. Szacunek rynkowy z 2026 roku wyceniał globalny rynek zarządzania jakością danych na 2,66 mld USD w 2025 roku, z prognozą 4,95 mld USD do 2030 roku przy CAGR 13,2 % (raport o globalnym rynku jakości danych). Wzrost rynku ma znaczenie, ale ważniejsze jest pytanie operacyjne: czy Wasza organizacja potrafi zareagować na sygnał jakości, zanim zmieni on decyzję biznesową?
Spis treści
Dlaczego jakość danych zawodzi nawet w dojrzałych zespołach
Czym naprawdę jest model operacyjny jakości danych
Pięć komponentów, które czynią go operacyjnym
Cztery wzorce modelu i jak wybrać
Przewodnik decyzyjny dla wzorca startowego
Poziomy dojrzałości i mierzalne KPI
Połączenie observability, walidacji i terminowości
Walidacja wykrywa jawne naruszenia
Observability wykrywa to, co reguły pomijają
Terminowość zasługuje na własną kontrolę
Mapa wdrożenia od pilota do skali korporacyjnej
Fundament
Domena pilotażowa
Rozszerzenie
Skala korporacyjna
Uwarunkowania branżowe w sektorach regulowanych
Częste nieporozumienia i lista zadań na przyszły tydzień
Pięć działań na przyszły tydzień
Dlaczego jakość danych zawodzi nawet w dojrzałych zespołach
Incydent prognostyczny miał wszystkie zewnętrzne oznaki dojrzałego środowiska danych. Migracja była zatwierdzona, pipeline wykonał się poprawnie, a pulpit odświeżył się zgodnie z harmonogramem. Mimo to żadna kontrola nie pytała, czy populacja kont wciąż odpowiada zamierzonej populacji biznesowej.
Awaria zaczęła się w górę strumienia, ale stała się problemem całej firmy. Zespół prognoz zaufał zawyżonemu widokowi przychodów i wycofał decyzję cenową na koniec kwartału. Podczas audytu zauważono, że lineage kończy się na zmigrowanym źródle i nie wyjaśnia, jak połączono konta aktywne i nieaktywne. Inżynierowie odbudowali potem pipeline trzy razy, za każdym razem adresując objaw po stronie odbiorczej zamiast nierozstrzygniętej odpowiedzialności.
Data steward ostatecznie zablokował źródło. To usunęło bezpośrednie ryzyko, ale też obnażyło brakującą mechanikę operacyjną. Nikt nie odpowiadał za logikę scalania, nie było ścieżki eskalacji dla nietypowej zmiany liczby wierszy i żadna uzgodniona miara nie klasyfikowała dryfu populacji jako zdarzenia blokującego publikację.
Zasada praktyczna: udane wykonanie pipeline'u dowodzi, że oprogramowanie zadziałało. Nie dowodzi, że powstałe dane wciąż pasują do decyzji biznesowej.
Ten schemat pojawia się także w organizacjach z kompetentnymi inżynierami. Po incydencie wiele zespołów dodaje kolejne testy, ale nowe reguły stają się następnym obciążeniem utrzymaniowym, jeśli nikt nie odpowiada za ich definicje, progi i wyjątki. Analiza strukturalnych przyczyn niepowodzeń projektów jakości danych stawia to samo rozróżnienie operacyjne: praca nad jakością zawodzi, gdy organizacje traktują ją jak projekt lub wdrożenie narzędzia zamiast zmiany sposobu podejmowania decyzji.
Niezależne badania nad governance tłumaczą, dlaczego luka się utrzymuje. W badaniu 825 uczestników aż 75 % wskazało jakość danych jako priorytetowy cel, podczas gdy inne badanie wykazało, że tylko 10 % ocenia swoje dane jako doskonałe, a 30 % jako dobre — łącznie 40 % ocen pozytywnych (badanie governance Precisely). Zespoły często nie wiedzą też, skąd pochodzą dane, jak bardzo są wiarygodne ani kto naprawia błędy.
Model operacyjny istnieje po to, by zapobiec dokładnie tej niejednoznaczności. Rozdziela prawa decyzyjne przed kolejną migracją, definiuje sygnał uruchamiający interwencję i daje wskazanej osobie uprawnienie do wstrzymania niepewnych danych.
Czym naprawdę jest model operacyjny jakości danych
Model operacyjny jakości danych to skodyfikowany system praw decyzyjnych, ról, procesów, kontroli i miar, który określa, jak problemy jakości są wykrywane, przejmowane, eskalowane i rozwiązywane w całym cyklu życia danych. Opisuje pracę, którą ludzie wykonują powtarzalnie, a nie tylko standardy, które publikują.
Polityka governance wyraża intencję. Biblioteka reguł przechowuje testy. Platforma observability wykrywa zmiany zachowania systemów lub zbiorów danych. Żaden z tych komponentów sam nie odpowiada, kto zatwierdza próg, kto akceptuje wyjątek i kto ma prawo zablokować wadliwy feed. Model operacyjny łączy te komponenty z odpowiedzialnymi ludźmi.
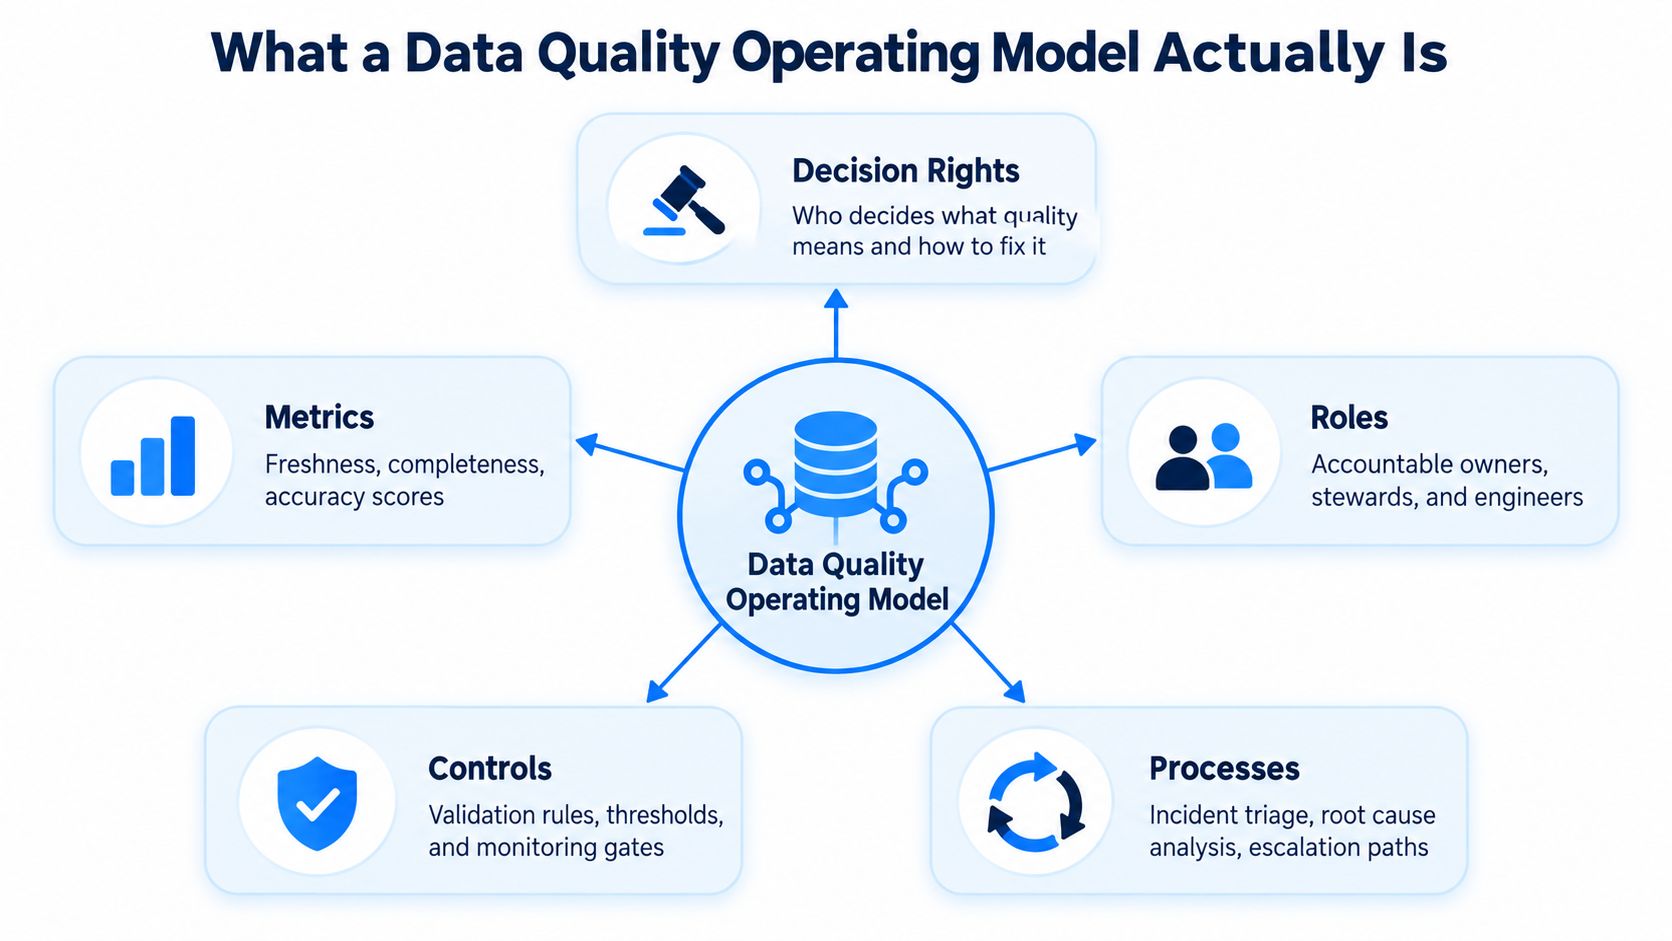
Pięć komponentów, które czynią go operacyjnym
Odpowiedzialność i własność wskazują właściciela biznesowego, data stewarda, producenta, zespół platformy i osobę reagującą na incydenty dla każdego krytycznego produktu lub elementu danych. Właściciel zatwierdza, co znaczy „przydatne do użycia”. Steward utrzymuje definicje i wyjątki. Inżynierowie wdrażają i utrzymują kontrole.
Standardy i reguły przekładają oczekiwania biznesowe na mierzalne wymagania. Mogą obejmować kompletność, poprawność, unikalność, integralność referencyjną, dokładność, terminowość i stabilność strukturalną. Każda reguła potrzebuje właściciela i udokumentowanej reakcji na niepowodzenie.
Wykrywanie i kontrole łączą walidację z observability. Walidacja sprawdza, czy wartości spełniają jawne kryteria biznesowe lub strukturalne. Observability obserwuje nieoczekiwane zachowania, takie jak zmiany wolumenu, luki świeżości, zmiany rozkładów i ewolucję schematu.
Przepływ obsługi incydentów definiuje triage, poziom istotności, kwarantannę, analizę przyczyn źródłowych, eskalację, naprawę i zamknięcie. Wykryta anomalia to jeszcze nie zakończona kontrola. Przepływ musi zapisać, kto ją ocenił i dlaczego.
Pomiar i informacja zwrotna pokazują, czy kontrole zapobiegają szkodzie biznesowej. Przydatne miary to skuteczność reguł, czasy reakcji, pokrycie właścicielami, powtarzalne awarie i praca poprawkowa. Te miary powinny zasilać planowanie i przeglądy produktowe, a nie zalegać na nieużywanym pulpicie.
Praktyczne spojrzenie na zarządzanie jakością danych pomaga zespołom uzgodnić słownictwo, ale terminologia nie jest rezultatem. Rezultatem jest działające porozumienie, co się dzieje, gdy dane zawiodą.
Cztery wzorce modelu i jak wybrać
W praktyce korporacyjnej zwykle wygrywa jeden z czterech wzorców. Właściwy wybór zależy mniej od mód organizacyjnych, a bardziej od ryzyka, złożoności domen, zdolności inżynierskich i istniejącej bazy governance.
Wzorzec | Prawa decyzyjne | Gdzie leży odpowiedzialność | Typowa porażka |
|---|---|---|---|
Zespół centralny | Centralna funkcja jakości danych lub CDO definiuje standardy i priorytetyzuje naprawy | Centralny zespół jakości, a producenci odpowiadają za poprawki | Centrum staje się wąskim gardłem, a zespoły biznesowe czekają na zatwierdzenie |
Domeny federacyjne | Zespoły domenowe definiują kryteria przydatności dla danych, które wytwarzają, w ramach wspólnych standardów | Właściciele i stewardzi domen | Definicje i progi rozjeżdżają się między domenami |
Inżynierowie osadzeni w zespołach | Zespoły produktowe lub platformowe przejmują kontrole jako część wytwarzania i utrzymania | Zespoły inżynierskie i produktowe | Znaczenie biznesowe jest niedoreprezentowane w testach technicznych |
Hybrydowy hub-and-spoke | Centrum kompetencji dostarcza standardy, narzędzia i wsparcie, a domeny odpowiadają za rezultaty | Współdzielona odpowiedzialność zespołu centralnego i domen | Hub publikuje wytyczne, ale nikt nie egzekwuje ich stosowania |
Model centralny działa, gdy interpretacja regulacyjna musi być spójna lub gdy zdolności inżynierskie domen są ograniczone. Wyczerpuje się, gdy oczekujemy, że jeden zespół zrozumie każdy kontekst biznesowy. Model federacyjny przybliża decyzje do danych, ale wymaga silnego wspólnego słownika, kontroli zmian i mechanizmu eskalacji. Własność osadzona w zespołach czyni jakość częścią dostarczania, choć inżynierowie nie powinni zgadywać biznesowej definicji dokładności.
Wzorzec hybrydowy jest zwykle najbardziej wykonalnym punktem startu dla dużych organizacji. Zespół centralny odpowiada za ramy kontroli, wspólne narzędzia i raportowanie. Właściciele domen decydują o przydatności, producenci naprawiają przyczyny w górę strumienia, a zespoły platformowe utrzymują wspólną infrastrukturę. To logika operacyjna stojąca za federacyjnym data governance, gdzie standardy pozostają spójne bez wpychania każdej decyzji do centralnej kolejki.
Przewodnik decyzyjny dla wzorca startowego
Domeny regulowane: wiele domen regulowanych przemawia za modelem centralnym lub hybrydowym, bo zatwierdzenia, dowody i eskalacja muszą być traktowane jednolicie.
Dojrzałość inżynierska: silne zespoły produktowe udźwigną własność osadzoną lub federacyjną. Zespoły bez wiarygodnych praktyk dostarczania potrzebują więcej wsparcia centralnego.
Inwestycja w governance: istniejące komitety, katalogi i rutyny stewardship ułatwiają wdrożenie hybrydy. Przy niskiej inwestycji lepiej zacząć od wąskiego pilota centralnego przed federalizacją.
Nie kopiujcie modelu większej firmy. Wybierzcie najmniejszą strukturę, która daje każdej krytycznej awarii właściciela, ścieżkę reakcji i osobę z prawem decyzji.
Poziomy dojrzałości i mierzalne KPI
Etykieta dojrzałości ma wartość tylko wtedy, gdy zmienia codzienne decyzje. „Zaawansowane governance” niewiele znaczy, jeśli odbiorcy nadal pierwsi znajdują błędy, odpowiedzialność jest niejasna, a inżynierowie wciąż naprawiają to samo zakłócenie w górę strumienia. Wykorzystajcie model dojrzałości jakości danych, aby powiązać zachowania operacyjne z mierzalnymi rezultatami.
Poziom dojrzałości | Obserwowalne sygnały | Kluczowe KPI |
|---|---|---|
Ad hoc | Kontrole różnią się między zespołami, własność jest nieformalna, użytkownicy znajdują błędy w raportach | Wskazani właściciele krytycznych aktywów, liczba aktywnych kontroli |
Reaktywny | Incydenty rejestruje się po awarii, priorytety są nieformalne, gaszenie pożarów się powtarza | MTTD, MTTR, zaległości otwartych incydentów |
Zdefiniowany | Krytyczne zbiory danych mają udokumentowane reguły, właścicieli, poziomy istotności i ścieżki eskalacji | Wskaźnik walidacji za pierwszym razem, krytyczne aktywa z właścicielem |
Mierzony | Miary jakości pojawiają się w przeglądach operacyjnych, a zespoły analizują powtarzające się przyczyny | Trend MTTD i MTTR, wskaźnik nawrotów, godziny pracy poprawkowej |
Optymalizowany | Kontrole wpływają na wydania, umowy, budżety i priorytety usprawnień | Koszt złej jakości, wiek otwartych wyjątków, pokrycie kontrolami, wpływ na KPI biznesowe |
Na poziomie ad hoc nie budujcie wskaźnika złożonego. Zacznijcie od inwentaryzacji i oznaczcie aktywa wspierające przychód, zarządzanie ryzykiem, raportowanie regulacyjne lub decyzje operacyjne. Pierwszy użyteczny KPI może być prosty: gdy zawiedzie krytyczna kontrola, czy jest ktoś z prawem decyzji?
Zespoły reaktywne potrzebują dyscypliny reagowania. Średni czas wykrycia i średni czas naprawy — MTTD i MTTR — pokazują, czy monitoring i odpowiedzialność się poprawiają. Uzupełnijcie je wskaźnikiem nawrotów: szybka obejściowa poprawka nie dowodzi usunięcia przyczyny źródłowej.
Na poziomie zdefiniowanym mierzcie, czy udokumentowane kontrole działają spójnie i czy krytyczne aktywa mają właścicieli. Wskaźnik walidacji za pierwszym razem pokazuje, jak często dane przechodzą bez interwencji. Na poziomie mierzonym wskaźnik nawrotów i godziny pracy poprawkowej ujawniają koszt słabej analizy przyczyn. Koszt złej jakości łączy te awarie z rozmowami o zasobach i budżecie.
KPI mają wspierać decyzje, a nie zdobić pulpit. Kontrola z wysokim wskaźnikiem zaliczeń może chronić mało istotne pole, podczas gdy niższy wskaźnik na zbiorze krytycznym dla decyzji wymaga natychmiastowej inwestycji.
Dojrzały program mierzy, czy kontrole chronią decyzje biznesowe i czy zespoły uczą się na awariach. Badanie trendów FP&A EY z 2025 roku pokazało, że tylko 16 % organizacji dysponowało wysokiej jakości, łatwymi w analizie danymi, a 25 % opisało swoje dane jako słabe lub złe (badanie trendów FP&A EY). W praktyce oznacza to wiązanie miar jakości z wykorzystaniem analitycznym i reakcją właścicieli, zamiast optymalizowania samych technicznych wskaźników zaliczeń.
Połączenie observability, walidacji i terminowości
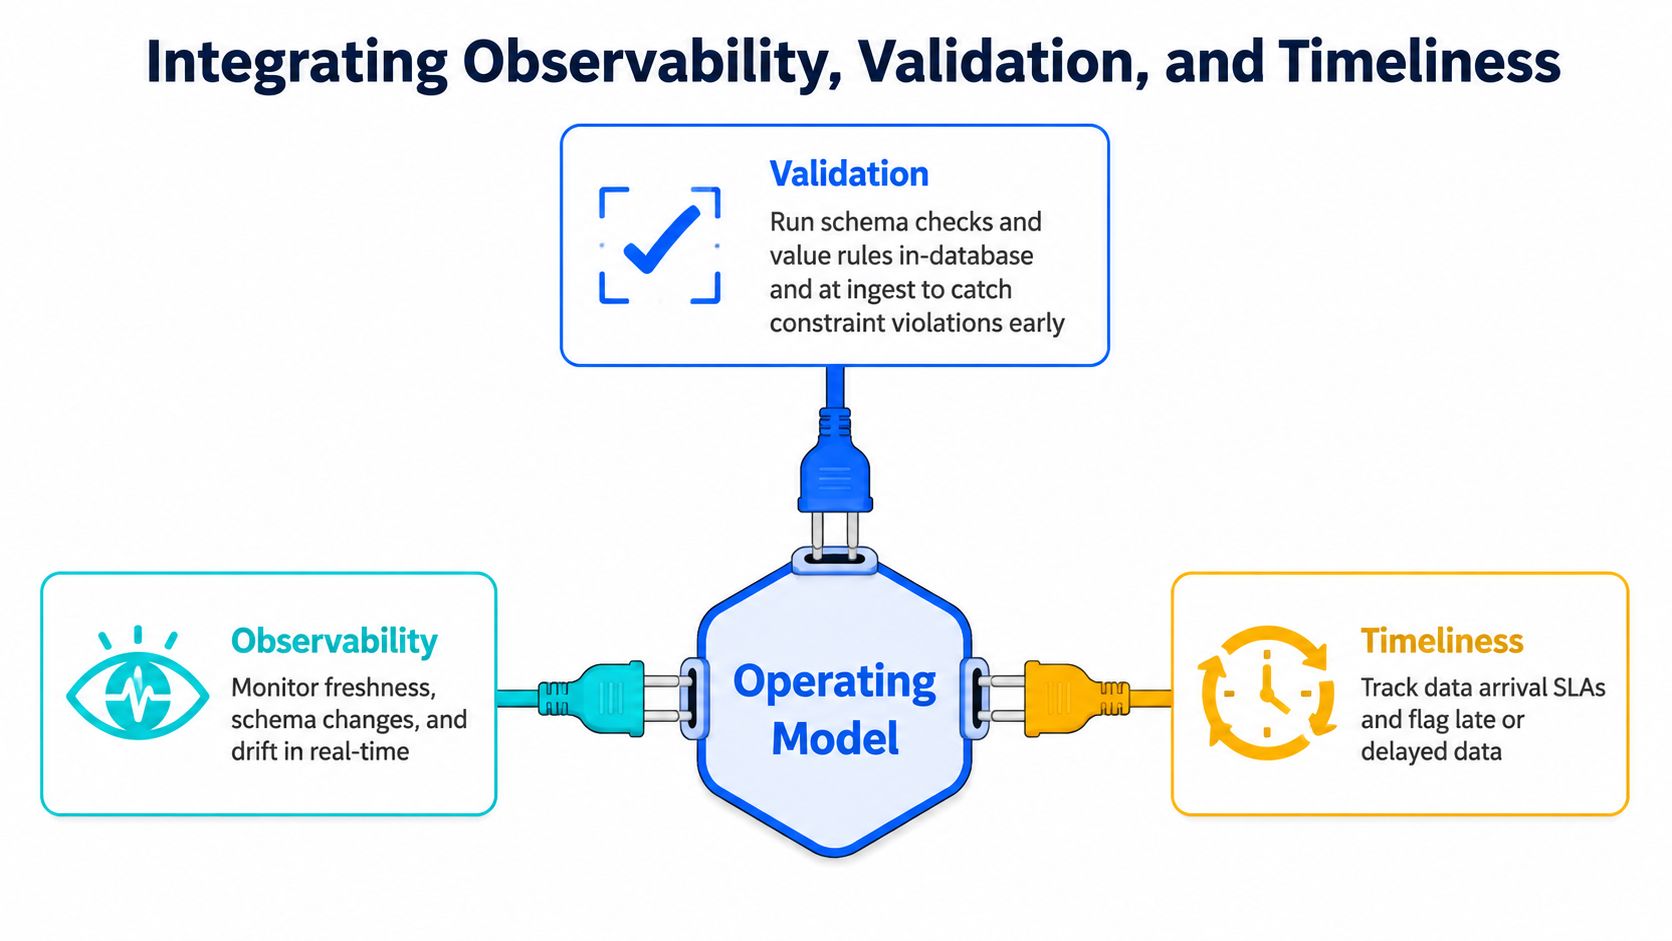
Te kontrole nie powinny stać się trzema równoległymi łańcuchami narzędzi z trzema kolejkami alertów. To komplementarne warstwy jednego modelu operacyjnego, a każda warstwa potrzebuje jasnego właściciela, poziomu istotności i przekazania.
Walidacja wykrywa jawne naruszenia
Walidacja sprawdza, czy rekord spełnia zdefiniowany wymóg. Na poziomie hurtowni ograniczenie NOT NULL na identyfikatorach klientów oraz kontrola referencyjna wobec wymiaru klienta mogą wychwycić nieprawidłowe rekordy przy zapisie. Producent odpowiada za poprawkę u źródła, steward za znaczenie reguły, a inżynier platformy za jej niezawodne wykonanie.
Stosujcie twarde bramki dla awarii, które czynią dalsze wykorzystanie niebezpiecznym. Stosujcie bramki miękkie lub ścieżki kwarantanny, gdy biznes toleruje kontrolowane wyjątki. Decyzja należy do odpowiedzialnego właściciela danych, a nie do inżyniera, który akurat dostał alert.
Observability wykrywa to, co reguły pomijają
Observability obserwuje, jak systemy i zbiory danych zachowują się w czasie. Wykrywa nieoczekiwane wolumeny, rozkłady, świeżość, obciążenia i zmiany schematu, nawet gdy każdy wiersz spełnia regułę statyczną. Nagła anomalia wolumenu transakcji może wskazywać na brakującą partycję źródłową, zduplikowane ładowanie lub zdarzenie biznesowe warte zbadania.
Reakcja musi łączyć sygnał z kontekstem. Metadane powinny wskazywać dotknięte produkty danych, raporty odbiorcze i producenta odpowiedzialnego za proces w górę strumienia. Bez tego kontekstu platforma observability generuje alerty, nie poprawiając decyzji. Centralny zespół wsparcia może utrzymywać wzorzec monitoringu, podczas gdy właściciel domeny ocenia, czy zmiana jest incydentem.
Terminowość zasługuje na własną kontrolę
Terminowość pyta, czy wartości nadal odzwierciedlają bieżący stan realnych obiektów, które reprezentują. Zespoły operacyjne zwykle mierzą ją jako opóźnienie od powstania do dostępności, więc instrumentujcie event_time, processed_time i available_time, aby rozróżnić opóźnienia pozyskania, przetwarzania i udostępnienia (badania nad terminowością w jakości danych).
Próg świeżości powinien stać się egzekwowalnym celem poziomu usług produktu danych. Automatyczne kontrole wieku mogą oznaczać rekordy przekraczające akceptowany wiek, zamieniając przeterminowane dane w incydent zamiast biernej adnotacji na pulpicie (przewodnik po monitoringu terminowości). Właściciel decyduje wtedy, czy zablokować użycie, opublikować ostrzeżenie, czy uruchomić rozwiązanie zastępcze.
Walidacja pyta: „czy ta wartość jest akceptowalna?”. Observability pyta: „czy to zachowanie jest nietypowe?”. Terminowość pyta: „czy dane dotarły na czas, by były użyteczne?”. Model operacyjny przypisuje każdą odpowiedź osobie i ścieżce reakcji. Dlatego zespoły oceniające data observability powinny badać przepływ pracy i odpowiedzialność równie uważnie jak zdolność wykrywania.
Mapa wdrożenia od pilota do skali korporacyjnej
Wiarygodne wdrożenie zaczyna się od wąsko określonego ryzyka biznesowego i rozszerza się dopiero, gdy pętla odpowiedzialności działa. Szerokie inwentaryzacje i duże biblioteki reguł wyglądają produktywnie, ale często tworzą ustalenia bez właściciela, które podkopują zaufanie do programu.
Fundament
Zinwentaryzujcie krytyczne aktywa danych i zmapujcie odbiorców, producentów, właścicieli i znane tryby awarii. Wyznaczcie tymczasowych właścicieli biznesowych i stewardów, zdefiniujcie taksonomię istotności i opublikujcie przepływ incydentów obejmujący wykrycie, triage, kwarantannę, eskalację, naprawę i zamknięcie.
Lider governance odpowiada za projekt operacyjny. Lider platformy odpowiada za ścieżkę wykonania, a liderzy domen potwierdzają, które aktywa się liczą. Warunek zakończenia jest praktyczny: każde wybrane aktywo krytyczne ma tymczasowego właściciela, a każdy incydent ma udokumentowaną ścieżkę.
Domena pilotażowa
Wybierzcie domenę o wysokiej wartości, na przykład przychody lub Customer 360. Zdefiniujcie pierwsze kontrakty danych, wdróżcie ukierunkowane kontrole walidacji i terminowości oraz połączcie sygnał observability z dyżurem. Właściciel domeny ocenia awarie, producent poprawia logikę źródłową, a zespół platformy utrzymuje środowisko wykonawcze kontroli.
Pilot kończy się, gdy zespół potrafi pokazać wykrycie, przypisanie, analizę przyczyn, naprawę i zamknięcie w tej samej ścieżce operacyjnej. Nie oceniajcie go liczbą dostarczonych reguł, lecz tym, czy odpowiedzialność wytrzyma prawdziwą awarię.
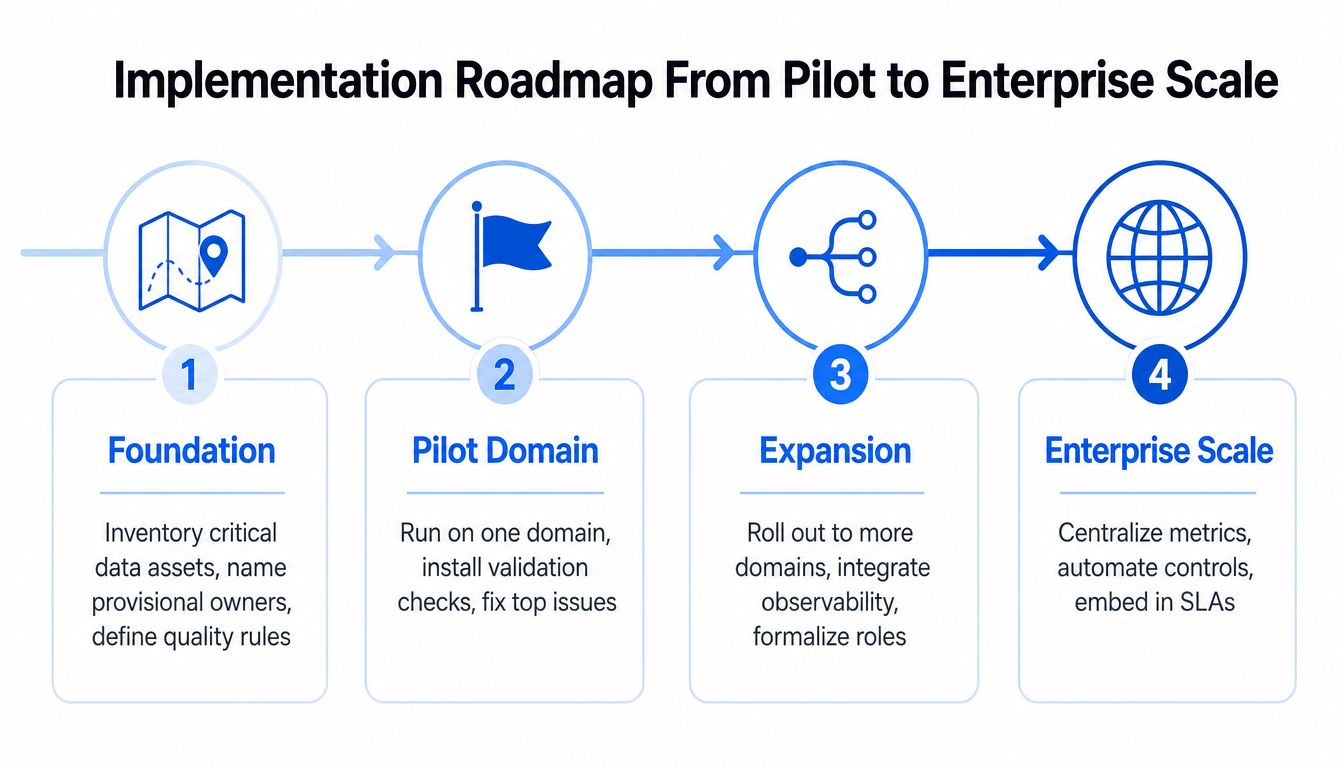
Rozszerzenie
Powielcie wzorzec w kilku domenach, powołajcie radę jakości danych i ustandaryzujcie minimalne wymagania wobec kontroli i metadanych. Rada powinna rozstrzygać konflikty międzydomenowe, zatwierdzać wspólne definicje i analizować powtarzające się awarie. Domeny zachowują odpowiedzialność za swoje rezultaty danych.
Użytecznymi kryteriami wyjścia są MTTD poniżej 24 godzin i 80 % krytycznych aktywów z udokumentowanymi właścicielami. To lokalne cele operacyjne, a nie uniwersalne benchmarki. Jeśli nie są osiągane, sprawdźcie przekazania i uprawnienia eskalacyjne, zanim dodacie więcej automatyzacji.
Skala korporacyjna
Osadźcie miary jakości w kartach wyników produktów danych, przeglądach wydań, umowach SLA i rozmowach budżetowych. Śledźcie koszt złej jakości przez godziny pracy poprawkowej, powtarzane naprawy i opóźnione decyzje. Funkcja centralna staje się warstwą wsparcia i zapewnienia, a domeny zachowują odpowiedzialność za swoje dane.
Ciągłe doskonalenie oznacza wycofywanie nieskutecznych reguł, korygowanie progów przy zmianie przypadków użycia i sprawdzanie, czy kontrole zapobiegają szkodzie biznesowej. Skala korporacyjna to nie większy pulpit. To powtarzalny system, który czyni decyzje jakościowe widocznymi w codziennej pracy.
Uwarunkowania branżowe w sektorach regulowanych
Szkielet modelu operacyjnego pozostaje stabilny w sektorach regulowanych, ale zmieniają się prawa decyzyjne i obowiązki dowodowe. Finanse potrzebują dowodów lineage dla BCBS 239 i raportowania objętego SOX, z odpowiedzialnością blisko księgi głównej, a nie tylko ogólnego zbioru danych. Ochrona zdrowia potrzebuje stewardów bezpieczeństwa klinicznego, którzy mogą zatrzymać pipeline przy zmianie danych referencyjnych, a kontrole kompletności i dokładności wiążą się z ryzykiem HIPAA.
Zespoły telekomunikacyjne powinny wiązać jakość CDR z revenue assurance. Operacje sieciowe powinny zasiadać w radzie jakości, bo utracone lub uszkodzone rekordy mogą wpływać na rozliczenia i analizę usług. Sektor publiczny potrzebuje kontroli nad danymi obywateli, gdzie świeżość i dostępność wspierają obowiązki dotyczące jawności i równego traktowania.
Dla organizacji działających w badaniach klinicznych, regulacjach i funkcjach komercyjnych katalogi liderów sektora biotechnologicznego mogą dawać użyteczny kontekst, jacy interesariusze powinni być reprezentowani w decyzjach jakościowych. Celem nie jest tworzenie czterech osobnych programów governance, lecz utrzymanie jednego mechanizmu odpowiedzialności i dopasowanie dowodów, właścicieli i progów eskalacji do środowiska ryzyka.
Branża | Punkt ciężkości odpowiedzialności | Główny motor KPI | Szczególna warstwa kontroli |
|---|---|---|---|
Finanse | Właściciele księgi głównej i raportowania | Kompletność lineage i przydatność raportowania | Dowody dla BCBS 239 i SOX |
Ochrona zdrowia | Bezpieczeństwo kliniczne i data stewardzi | Kompletność, dokładność i wiarygodność dla opieki nad pacjentem | Interwencja w pipeline'y nastawiona na bezpieczeństwo |
Telekomunikacja | Operacje sieciowe i revenue assurance | Integralność rekordów i pewność rozliczeń | Walidacja i uzgadnianie CDR |
Sektor publiczny | Właściciele programów, dostępności i rejestrów | Świeżość, dostępność i wiarygodność usług publicznych | Kontrole jawności i równego traktowania |
Jedna polityka może objąć wszystkie cztery sektory, ale lokalni właściciele muszą zachować władzę nad tym, co stanowi nieakceptowalną awarię. Ta równowaga czyni model modularnym, nie czyniąc go rozmytym.
Częste nieporozumienia i lista zadań na przyszły tydzień
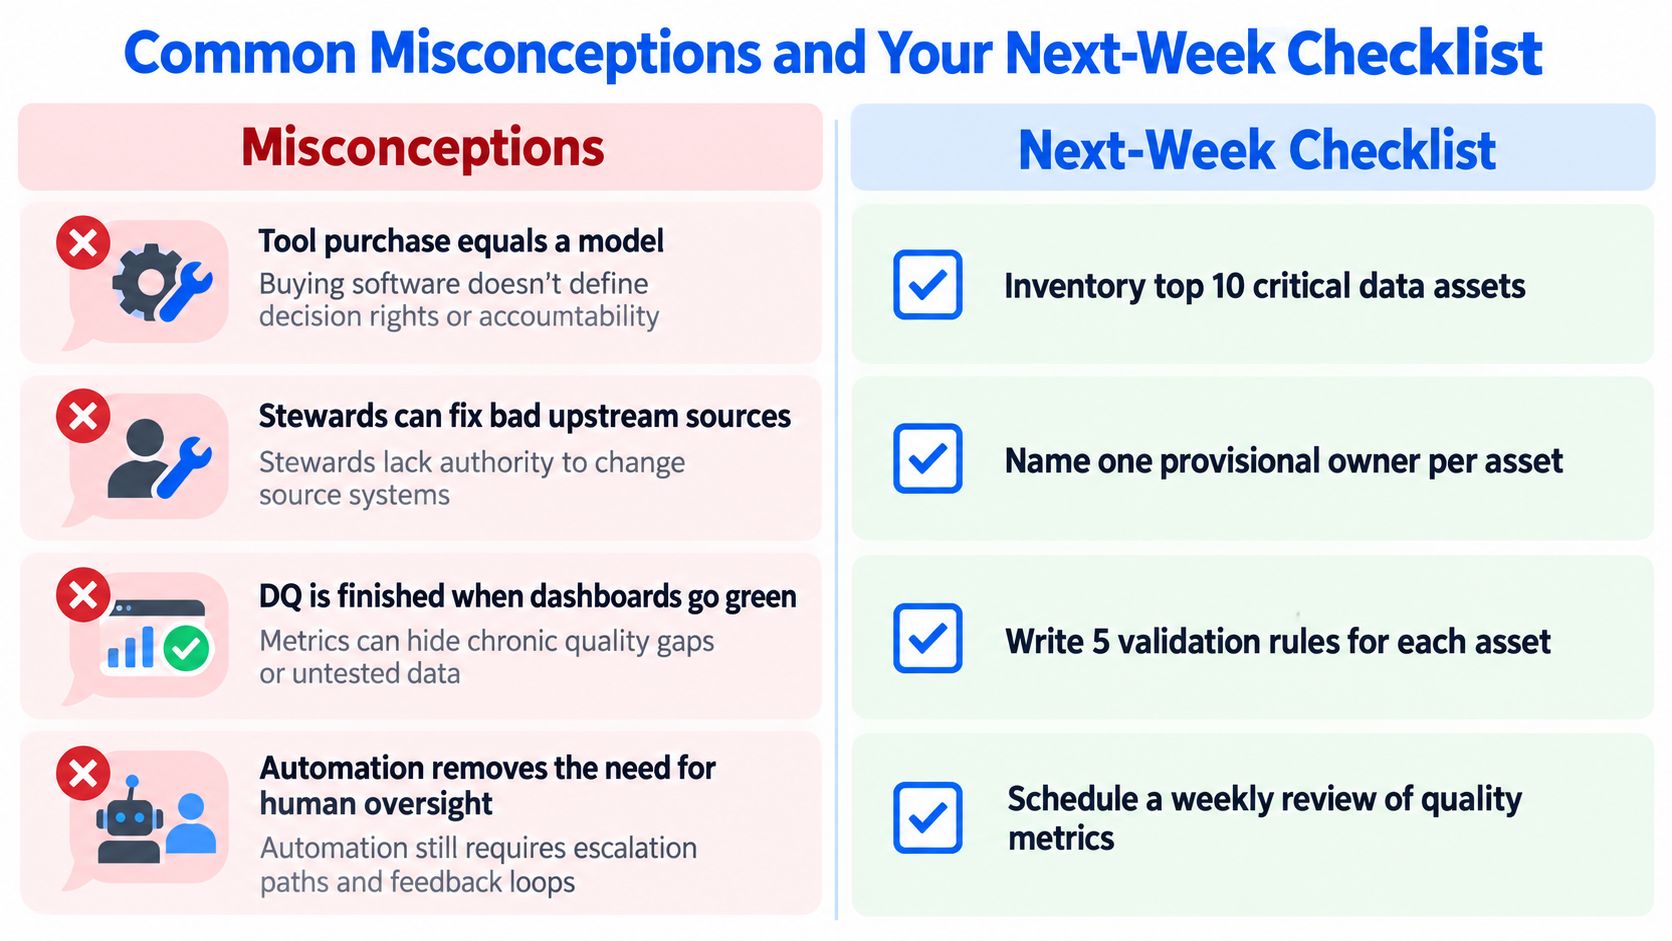
Zakup oprogramowania nie tworzy modelu operacyjnego. Platforma może wykrywać anomalie lub wykonywać walidacje, ale ludzie wciąż muszą ustalić odpowiedzialność, zatwierdzić progi, zdecydować o wyjątkach i eskalować awarie.
Data stewardzi też nie naprawią każdej wady w górę strumienia. Jeśli steward nie ma uprawnień do zmiany systemu źródłowego, przypisanie mu incydentu jedynie maskuje lukę w odpowiedzialności. Producent musi odpowiadać za poprawkę, steward utrzymuje znaczenie, a organ governance rozstrzyga spór.
Zielone pulpity nie dowodzą, że jakość jest załatwiona. Zbiór danych może przechodzić testujące go reguły, podczas gdy niemonitorowane źródło się zmienia, zobowiązanie świeżości zostaje złamane albo miara biznesowa odchodzi od oczekiwanego zachowania. Dokładanie reguł może to pogorszyć, jeśli tworzą szum, dublują logikę lub skłaniają zespoły do optymalizowania wskaźników zaliczeń zamiast pewności decyzji.
Pięć działań na przyszły tydzień
Wskażcie właścicieli: potwierdźcie odpowiedzialnego właściciela jakości dla każdego krytycznego elementu lub aktywa danych.
Udokumentujcie prawa do kwarantanny: zapiszcie, kto może zablokować, poddać kwarantannie lub zwolnić dane, gdy zawiedzie krytyczna kontrola.
Podłączcie jeden sygnał do dyżuru: połączcie alert observability z istniejącą rotacją inżynierską lub operacyjną.
Wycofajcie nieużywaną regułę: usuńcie kontrolę, której nikt nie przegląda ani nie potrafi wyjaśnić, i udokumentujcie decyzję.
Opublikujcie KPI świeżości: wnieście miarę terminowości na forum kierownicze, gdzie ktoś może zareagować.
Praktyczny model operacyjny data governance wymaga praw decyzyjnych, ról, organów, rutyn, przekazań, oceny efektywności, kontroli zmian i mapy wdrożenia. Trzymajcie tę poprzeczkę, przeglądając swoją listę: jeśli zadanie nie mówi, kto decyduje i co dzieje się dalej, to jeszcze nie jest kontrola operacyjna.
digna pomaga zespołom danych łączyć walidację w bazie, wykrywanie anomalii, monitoring terminowości i śledzenie zmian schematu we wspólnym widoku incydentów, w ich własnym środowisku. Odwiedźcie digna, aby zobaczyć, jak platforma wspiera model operacyjny jakości danych z odpowiedzialnymi właścicielami, mierzalnymi kontrolami i wykonalną eskalacją.
Zobacz, jak digna robi to w praktyce: monitoring jakości danych na wszystkich Waszych platformach.
Najczęściej zadawane pytania
Czym jest model operacyjny jakości danych?
Model operacyjny jakości danych to struktura, która przenosi jakość z serii projektów do codziennej pracy operacyjnej. Określa, kto odpowiada za jakie dane, jakie kontrole działają, jak mierzy się rezultaty i co się dzieje, gdy coś zawiedzie.
Jakie komponenty ma model operacyjny jakości danych?
Pięć czyni go operacyjnym: własność i odpowiedzialność, zdefiniowane kontrole obejmujące walidację, observability i terminowość, KPI pokazujące, czy jakość rośnie, narzędzia wykonujące kontrole oraz rutyny — triage, eskalacja, przegląd — które utrzymują model przy życiu.
Czy jakość danych powinna być scentralizowana czy federacyjna?
To zależy od tego, gdzie odpowiedzialność już leży. Zespół centralny sprawdza się, dopóki krajobraz jest niewielki; model federacyjny pasuje do organizacji z silną własnością domenową; większość dużych firm kończy na hybrydzie: centralne standardy i narzędzia, wykonanie w domenach.
Jakie KPI mierzą operacyjną jakość danych?
Przydatne są pokrycie krytycznych zbiorów danych, średni czas wykrycia i rozwiązania, częstotliwość i nawroty incydentów oraz udział problemów wykrytych przez monitoring zamiast zgłoszonych przez użytkownika biznesowego.
Ile trwa wdrożenie modelu operacyjnego jakości danych?
Praktyczna kolejność to fundament, domena pilotażowa, rozszerzenie, skala korporacyjna. Wąski pilot zwykle pokazuje mierzalną poprawę wykrywania w ciągu kwartału, a właśnie ten dowód pozwala sfinansować rozszerzenie.