Automatyczna kontrola jakości dla wiarygodnych danych
|
7
min. czyt.

Poranny dashboard świeci na zielono, a mimo to trend przychodów wygląda źle. Zaplanowane zasilanie dotarło z opóźnieniem, kolumna zmieniła typ albo system źródłowy zmienił rozkład pola. Pipeline zakończył się powodzeniem, więc standardowa kontrola statusu przeszła. Zanim ktoś zauważy skutki biznesowe, analitycy zdążyli już udostępnić niewiarygodne liczby, a inżynierowie cofają się w poszukiwaniu przyczyny.
Ręczny przegląd nie nadąża za skalą i różnorodnością współczesnych pipeline'ów. Automatyczna kontrola jakości zmienia model działania: obserwuje dane w sposób ciągły, wykrywa istotne odchylenia, egzekwuje kluczowe reguły i dostarcza właściwym osobom materiał, na podstawie którego mogą działać. Skutki niewykrytych awarii opisuje ten przegląd konsekwencji złej jakości danych.
Spis treści
Wprowadzenie: dlaczego jakość danych pęka bez automatyzacji
Od inspekcji do ciągłej operacji
Kluczowa decyzja projektowa
Czym naprawdę jest automatyczna kontrola jakości
Podstawa statystyczna
Co obserwuje system
Jak działają zautomatyzowane kontrole — od reguł po wykrywanie AI
Walidacja regułowa
Progi statystyczne
Wykrywanie oparte na AI i uczeniu maszynowym
Dobór właściwego rodzaju kontroli do sygnału
Wdrożenie automatyzacji w ciągłą operację
Trzymaj obliczenia blisko danych
Połącz czas, strukturę i znaczenie
Korzyści, które zmierzysz i odczujesz na co dzień
Co zmienia się dla zespołu
Gdzie automatyczna kontrola jakości daje wartość w praktyce
Finanse
Ochrona zdrowia
Telekomunikacja
Sektor publiczny
Kiedy automatyzować i jak zacząć z digna
Lista kontrolna wdrożenia
Wprowadzenie: dlaczego jakość danych pęka bez automatyzacji
Zespół danych może po wdrożeniu sprawdzić kilka krytycznych tabel, potwierdzić, że transformacja się wykonała, i przejść do kolejnego zadania. Taki proces wychwyci oczywiste awarie, jak pusta tabela czy przerwane zadanie. Nie wychwyci natomiast stopniowej zmiany aktywności klientów, spóźnionego źródła ani poprawnie wyglądającej wartości, która przestała mieć sens biznesowy.
Problemem nie jest brak testów. Nowoczesne środowiska łączą hurtownie, jeziora danych, systemy strumieniowe, zasilania od dostawców, narzędzia transformacji i dashboardy. Każda warstwa może wyglądać zdrowo, podczas gdy wynik staje się mniej wiarygodny. Udany przebieg pipeline'u dowodzi, że kod się wykonał. Nie dowodzi, że dane wciąż odzwierciedlają biznes.
Od inspekcji do ciągłej operacji
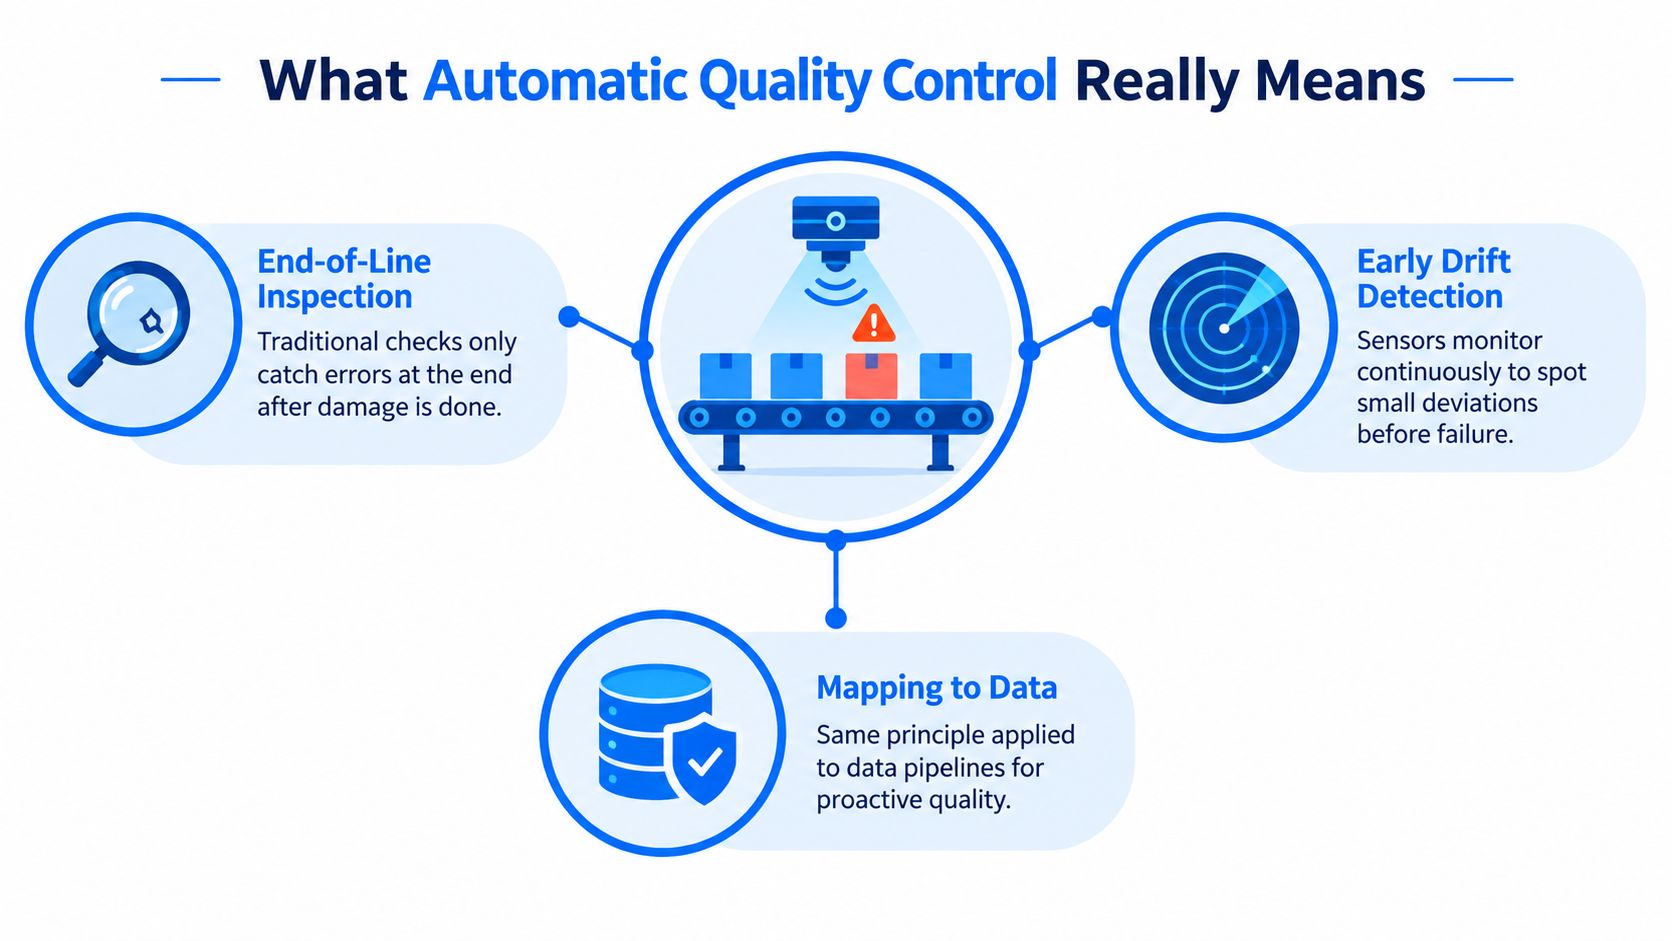
Produkcja przemysłowa daje dobrą analogię. Kontrola końcowa usunie wadliwe wyroby, ale czujniki rozstawione wzdłuż linii wykryją dryf procesu, zanim wady się skumulują. Zespoły danych potrzebują tej samej pętli sprzężenia zwrotnego. Zamiast traktować jakość jako bramkę na końcu pipeline'u, mogą monitorować rekordy, zachowanie dostaw, strukturę, metryki biznesowe i aktywność platformy jako część codziennej pracy.
Ta zmiana porządkuje też odpowiedzialność. Inżynier danych może musieć zbadać zmianę schematu, analityk wyjaśnić nietypowy ruch KPI, a osoba odpowiedzialna za governance wykazać, że kontrola się wykonała. Automatyczna kontrola jakości powinna łączyć te zadania, a nie tworzyć kolejny odizolowany raport.
Kluczowa decyzja projektowa
Automatyzacja nie oznacza zastąpienia każdej reguły modelem. Część sygnałów warto wyuczyć z zachowań historycznych — jak normalny wolumen czy oczekiwany czas dostarczenia. Inne muszą pozostać deterministyczne: pole obowiązkowe, dopuszczalny status, wymóg regulacyjny.
Praktyczne pytanie brzmi więc precyzyjnie: które warunki system ma wyuczyć statystycznie, a które musi egzekwować dokładnie? Odpowiedź decyduje, czy automatyzacja ogranicza szum, czy generuje więcej alertów.
Czym naprawdę jest automatyczna kontrola jakości
Wyobraź sobie taśmę z identycznymi elementami. Czujnik śledzi temperaturę, wagę i położenie, a kamera sprawdza powierzchnię. System nie czeka na zapakowanie ostatniego kartonu, żeby wykryć problem. Porównuje bieżące odczyty z oczekiwanym zachowaniem, sygnalizuje odchylenia i potrafi zatrzymać lub przekierować proces, zanim przejdzie więcej wadliwych sztuk.
Jakość danych działa tak samo. System monitoringu obserwuje tabele i pipeline'y, ustala, jak wygląda normalne zachowanie, i porównuje z nim napływające dane. Może też stosować jawne walidacje tam, gdzie organizacja ma regułę, która zawsze musi obowiązywać.
Automatyczna kontrola jakości to ciągłe wykorzystanie oprogramowania do obserwowania zachowania danych, egzekwowania zdefiniowanych wymagań jakościowych, wykrywania istotnych odchyleń i przekazywania dowodów osobom lub systemom odpowiedzialnym za działanie.
Podstawa statystyczna
Statystyczne sterowanie procesem (SPC) daje użyteczny fundament. Za pomocą kart kontrolnych i danych pomiarowych odróżnia zmienność normalną od zmienności o przyczynie specjalnej, czyli zmiany sugerującej, że do procesu weszło coś nietypowego. W procesie o rozkładzie normalnym często przywoływana granica 3 sigma daje prawdopodobieństwo wypadnięcia dobrej sztuki poza pasmo na poziomie około 1 na 1000, a granica 6 sigma obniża je do mniej więcej 1 na 1 000 000 (badania SPC nad automatycznym wykrywaniem).
Wniosek nie brzmi, że każda tabela potrzebuje reguły sześć sigma. Wniosek jest taki, że systemy jakości powinny wykrywać dryf wcześnie, zamiast polegać wyłącznie na kontroli końcowej. Linia bazowa daje systemowi kontekst. Bez kontekstu próg zgłosi zwykłą sezonowość albo przeoczy istotną zmianę.
Co obserwuje system
Automatyczna kontrola jakości obejmuje kilka warstw zachowania:
Jakość rekordów: wartości wymagane, poprawne formaty, zakresy, wartości słownikowe, duplikaty i zależności biznesowe.
Terminowość pipeline'ów: czy dane docierają wtedy, gdy oczekują ich użytkownicy i zadania w dole strumienia.
Stabilność schematu: czy kolumny są dodawane, usuwane, zmieniają nazwę lub typ.
Zachowanie biznesowe: czy przychody, transakcje, aktywność klientów lub inne KPI wychodzą poza oczekiwane wzorce.
Zachowanie platformy: czy obciążenia, dostępność, zużycie lub metryki wydajności zmieniają się nieoczekiwanie.
Pojedynczy test nie obejmie tego wszystkiego. System operacyjny łączy pomiary, reguły, historię, odpowiedzialność, alerty i kontekst naprawy. To właśnie ta kombinacja zamienia testowanie w ciągłą kontrolę.
Jak działają zautomatyzowane kontrole — od reguł po wykrywanie AI
Trzy rodziny kontroli pokrywają większość wdrożeń automatycznej kontroli jakości. Nie zawsze ze sobą konkurują: każda odpowiada na inne pytanie, a najlepsze wdrożenia przypisują każdy sygnał metodzie dopasowanej do jego ryzyka.
Walidacja regułowa
Kontrole deterministyczne są jawne i powtarzalne. Reguła może wymagać identyfikatora klienta, odrzucać ujemną ilość, ograniczać status do zatwierdzonej listy słownikowej albo sprawdzać, czy timestamp ma wymagany format. Gdy warunek nie zostanie spełniony, wynik jest jednoznaczny: rekord lub zbiór danych łamie określone wymaganie.
Reguły są szczególnie cenne dla logiki biznesowej, kontroli audytowych i zobowiązań umownych. Stanowią też dobry materiał dowodowy, bo osoba odpowiedzialna może dokładnie wyjaśnić, co przeszło, co nie i dlaczego. Ich ograniczeniem jest utrzymanie: reguła nie wywnioskuje zmieniającej się linii bazowej, dopóki ktoś jej nie zaktualizuje, a zbyt szeroka reguła generuje zbędną pracę operacyjną.
Progi statystyczne
Kontrole statystyczne pytają, czy pomiar oddalił się nietypowo od swojego ustalonego zachowania. Pomiarem może być liczba wierszy, udział wartości pustych, rozkład wartości albo czas dostarczenia. Pasma kontrolne dostosowują się do wzorców, które sztywny próg potraktowałby błędnie.
System wciąż wymaga przemyślanej konfiguracji. Metryka biznesowa może się zmieniać zależnie od dnia tygodnia, cyklu wdrożeń czy okresu raportowego. Linia bazowa ignorująca te wzorce będzie alarmować zbyt często; zbyt pobłażliwa przeoczy realny problem.
Wykrywanie oparte na AI i uczeniu maszynowym
Wykrywanie oparte na AI przydaje się, gdy dane mają złożone zależności albo ręczne pisanie reguł byłoby niepraktyczne. Model potrafi nauczyć się wzorców zbioru danych i zgłaszać odchylenia w wolumenie, rozkładzie lub wartościach. To nie czyni wyniku automatycznie poprawnym: model potrzebuje wystarczającej historii, odpowiedniego nadzoru i procesu przeglądu fałszywych alarmów.
Badanie porównawcze na profilach oceanicznych pokazuje, dlaczego dobór testów ma znaczenie. Naukowcy ocenili 60 różnych zautomatyzowanych kontroli i stwierdzili, że konieczny jest wybór optymalnego podzbioru, ponieważ różne reguły jakości wymieniają czułość na nadmiar zgłoszeń (benchmark automatycznych kontroli jakości). Więcej testów nie oznacza automatycznie lepszej jakości. Może oznaczać zmęczenie alertami, jeśli zespół nie odróżnia istotnego sygnału od zwykłej zmienności.
Dobór właściwego rodzaju kontroli do sygnału
Rodzina kontroli | Najlepsza do | Mocne strony | Na co uważać |
|---|---|---|---|
Walidacja regułowa | Pola obowiązkowe, formaty, zakresy, listy słownikowe i ograniczenia biznesowe | Jednoznaczny wynik, wytłumaczalna logika, mocny materiał audytowy | Wymaga utrzymania, gdy zmieniają się wymagania biznesowe |
Progi statystyczne | Wolumen, rozkłady, wartości puste i wzorce dostarczania | Dostosowuje się do obserwowanego zachowania i uwypukla dryf | Może nadmiernie alarmować, gdy sezonowość lub linia bazowa są słabo rozpoznane |
Wykrywanie AI | Subtelne, wielowymiarowe lub zmieniające się wzorce w zbiorach danych | Znajduje zachowania trudne do zapisania jako pojedyncze reguły | Wymaga nadzoru, przeglądu i zabezpieczeń przed nieprzejrzystymi decyzjami |
Właściwa strategia to nie pisanie mniejszej liczby reguł, lecz rozstrzygnięcie, które sygnały zasługują na dokładne egzekwowanie, które potrzebują progów adaptacyjnych, a które zyskają na wykrywaniu wyuczonym. Praktyczne omówienie wykrywania anomalii w pipeline'ach znajdziesz w tekście jak AI wykrywa anomalie danych.
Wdrożenie automatyzacji w ciągłą operację
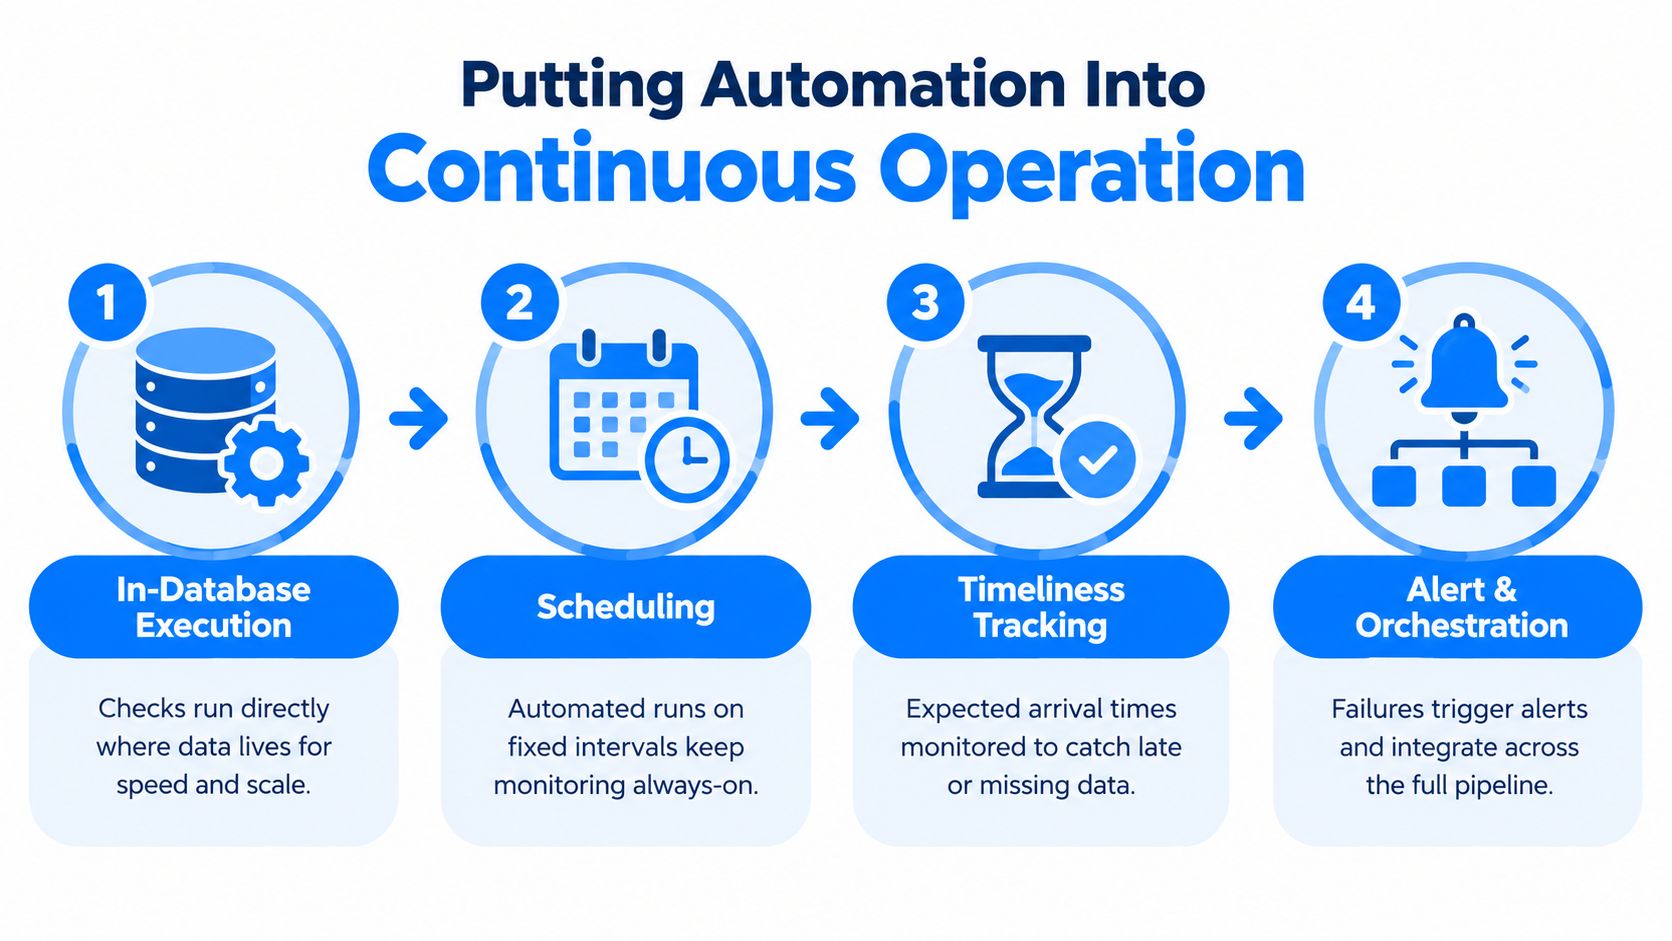
Zbiór kontroli staje się użyteczny dopiero wtedy, gdy działa jako pętla operacyjna. Pętla powinna obserwować dane tam, gdzie już się znajdują, uruchamiać się według niezawodnego harmonogramu, porównywać zachowanie rzeczywiste z oczekiwanym i kierować awarie do właściciela z kontekstem wystarczającym do reakcji.
Trzymaj obliczenia blisko danych
Wykonanie in-database pozwala liczyć metryki i prowadzić analizy wewnątrz bazy klienta. Dane pozostają na miejscu, co ogranicza zbędny ruch i wspiera wymogi prywatności oraz governance. To podejście jest szczególnie istotne, gdy danych produkcyjnych nie wolno kopiować do zewnętrznej usługi monitoringu.
Projekt wciąż wymaga kontroli dostępu, logowania i wyraźnego rozdzielenia metadanych monitoringu od danych wrażliwych. Lokalne wykonanie nie zastępuje governance — daje mu mocniejszą podstawę, bo organizacja określa, gdzie odbywa się obliczenie i jakie dowody opuszczają środowisko.
Połącz czas, strukturę i znaczenie
Niezawodna pętla monitoringu łączy różne rodzaje dowodów:
Zaplanuj obserwację. Stałe interwały lub zdarzenia pipeline'u sprawiają, że kontrole działają bez polegania na czyjejś pamięci.
Śledź oczekiwane dostarczenie. Monitoring terminowości uczy się spodziewanego czasu napływu i zgłasza dane spóźnione, brakujące lub zbyt wczesne.
Wykrywaj zmiany strukturalne. Śledzenie schematu wskazuje dodane i usunięte kolumny oraz zmiany typów, zanim zawiodą systemy w dole strumienia.
Obserwuj metryki biznesowe. Monitoring KPI łączy techniczne zachowanie danych z wynikami, które rozpoznają właściciele biznesowi.
Kieruj incydent. Alert powinien zawierać dotknięty zasób, niespełniony warunek, zaobserwowaną zmianę oraz osobę lub zespół odpowiedzialny.
Dane ankietowe wskazują na lukę strategiczną. SYNQ ustaliło, że największym wyzwaniem jakości danych jest „niewystarczająca wiedza o tym, jak dobrze testować”, przy czym zdecydowana większość zespołów opierała się głównie na wbudowanych testach narzędzia transformacji, a tylko około 10% często korzystało z AI w procesach jakościowych (badanie benchmarkowe SYNQ). To sugeruje, że zespoły potrzebują wskazówek operacyjnych, a nie kolejnej biblioteki testów.
Wspólny dashboard, katalog danych, scheduler i proces współpracy zamieniają alert w zarządzany incydent. Inżynierowie analizują dowody techniczne, analitycy widzą wpływ biznesowy, a interesariusze śledzą status bez wynoszenia danych produkcyjnych poza środowisko klienta. Więcej praktycznych wskazówek o walidacji i bieżących kontrolach znajdziesz w tekście reguły walidacji i ciągła jakość danych.
Korzyści, które zmierzysz i odczujesz na co dzień
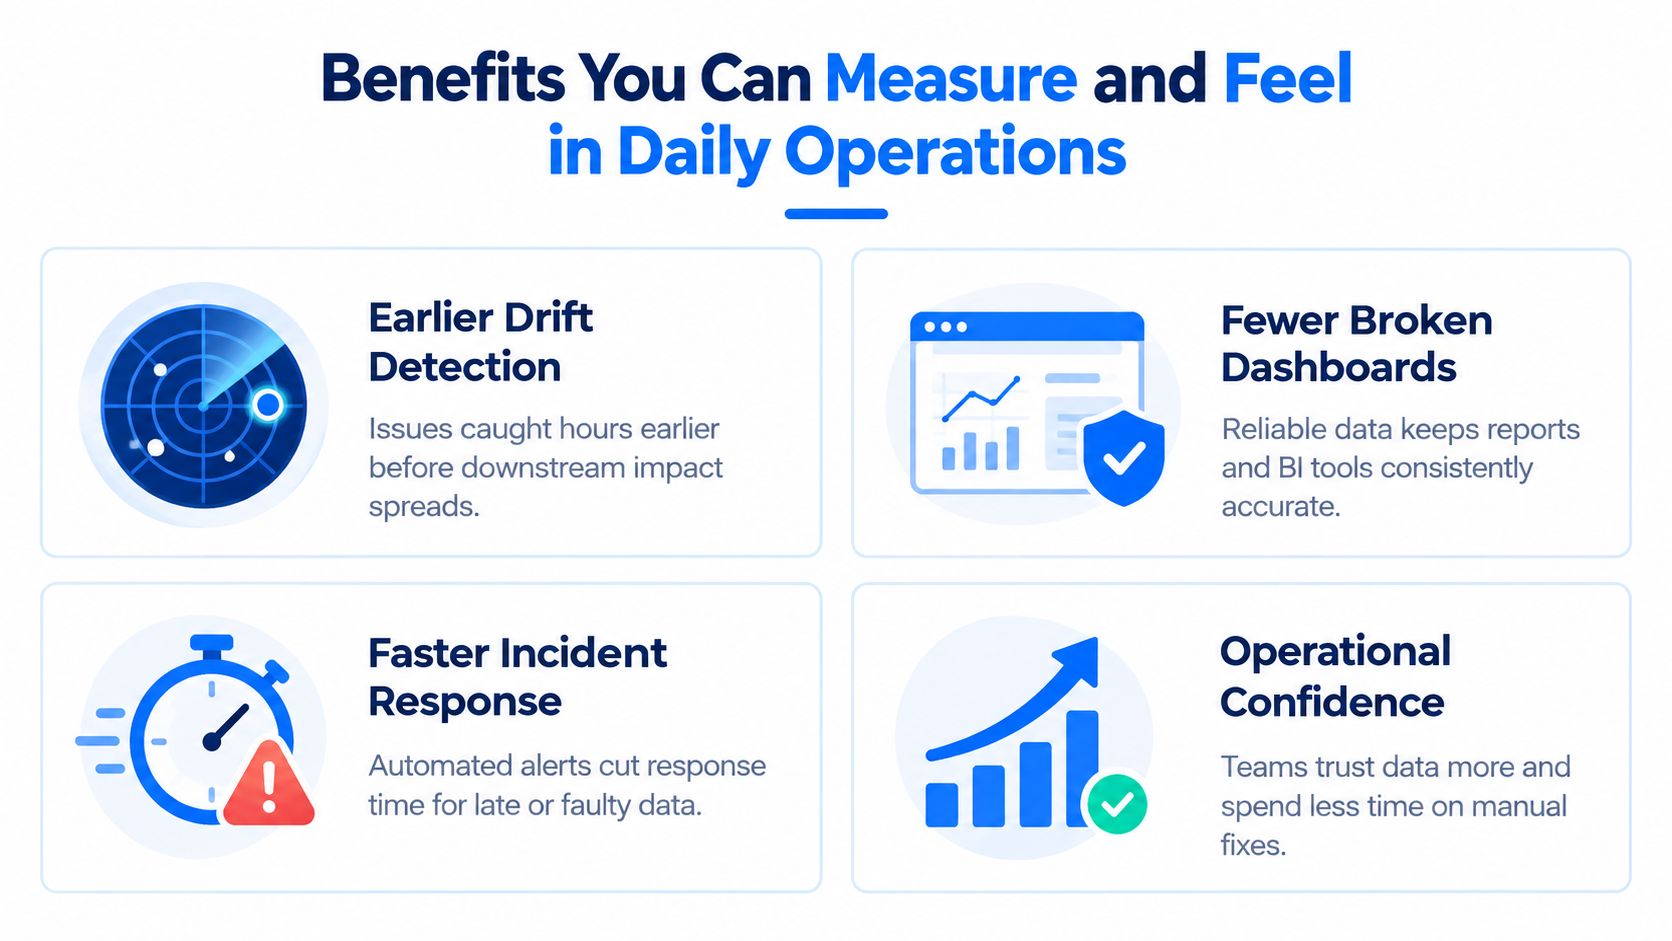
Najcenniejszą korzyścią automatycznej kontroli jakości nie jest liczba skonfigurowanych kontroli, lecz mniejsza niepewność w codziennej pracy. Zespoły wykrywają dryf, zanim ujawni go odświeżenie dashboardu, widzą, czy spóźnione zasilanie spowodowało lukę w raporcie, i odróżniają zepsuty pipeline od prawdziwej zmiany w biznesie.
Przemysłowe systemy wizyjne pokazują wartość kontroli ciągłej wobec wyrywkowej kontroli końcowej. Przeglądy rozwiązań wizyjnych zintegrowanych ze sterownikami PLC opisują systemy rejestrujące obraz każdego produktu, klasyfikujące wady w czasie rzeczywistym i umożliwiające 100% inspekcji przy prędkości linii. Jedno z opisywanych wdrożeń osiągnęło około 96,2% dokładności, przy 95,4% precyzji, 96,8% czułości i wyniku F1 na poziomie 96,1% (przegląd przemysłowej kontroli jakości opartej na wizji).
Co zmienia się dla zespołu
Wcześniejsze wykrycie dryfu daje inżynierom czas na zbadanie źródła lub transformacji, zanim odbiorcy w dole strumienia zwielokrotnią skutki. Niewielkie odchylenie staje się widocznym zdarzeniem zamiast ukrytego założenia.
Mniej zepsutych dashboardów wynika z monitorowania zarówno danych, jak i struktury. Dashboard może być technicznie dostępny i jednocześnie pokazywać nieaktualne lub zniekształcone informacje; sygnały jakości pomagają to rozróżnić.
Szybsza reakcja na brakujące ładowania bierze się ze śledzenia oczekiwanych dostaw. Zamiast czekać, aż analityk zauważy pusty raport, system stwierdza, że zbiór danych nie dotarł w swoim normalnym rytmie.
Mocniejsze dowody zgodności powstają z kontroli deterministycznych, historii wykonań, przypisanej odpowiedzialności i udokumentowanych wyników. Audytorzy i właściciele biznesowi potrzebują czegoś więcej niż zielonego statusu — muszą wiedzieć, co się wykonało i co się wydarzyło.
Dla osób badających rolę danych predykcyjnych w QA zasada jest podobna: historyczne zachowanie pomaga przewidywać ryzyka jakościowe, ale sygnały predykcyjne potrzebują jasnych ścieżek działania. Automatyzacja wspiera kontrolę kosztów, niezawodność modeli i zaufanie do analityki tylko wtedy, gdy alerty są zrozumiałe i ktoś odpowiada za reakcję.
Praktycznym efektem jest zaufanie. Zespoły spędzają mniej czasu na sprawdzaniu, czy dane istnieją, a więcej na rozstrzyganiu, co te dane znaczą. Korzyść znika, gdy każdy alert jest hałaśliwy, zduplikowany lub oderwany od odpowiedzialnego zespołu — dlatego strojenie i własność pozostają częścią systemu jakości. Szerszy kontekst tych efektów opisuje tekst korzyści z jakości danych.
Gdzie automatyczna kontrola jakości daje wartość w praktyce
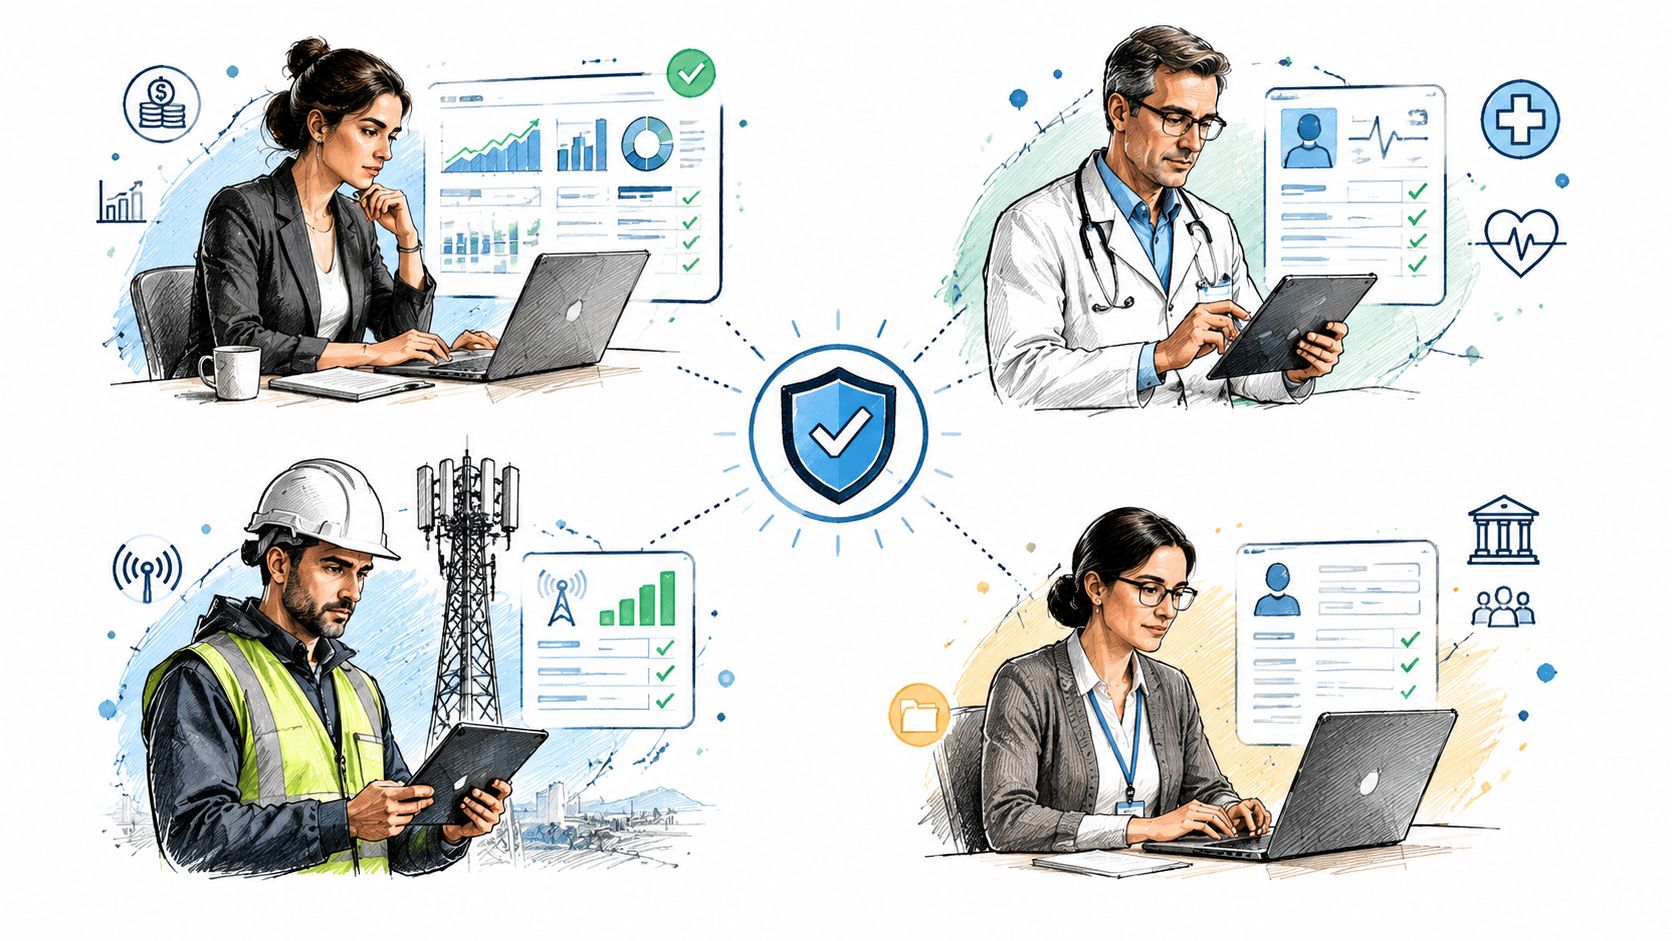
Ta sama architektura kontroli zachowuje się inaczej w różnych branżach, bo różne są ryzyka. Zespół finansowy zadba o raportowanie regulacyjne i kompletność transakcji. Organizacja ochrony zdrowia postawi na wiarygodność danych klinicznych i prywatność. Operator telekomunikacyjny będzie obserwował zdarzenia klienckie o dużym wolumenie, a instytucja publiczna potrzebuje spójnych, możliwych do prześledzenia rekordów na potrzeby audytu.
Finanse
Zasilanie danymi ryzyka przychodzi każdego ranka i zasila raporty używane przez finanse i compliance. Zakończone zadanie nie gwarantuje, że zasilanie zawiera oczekiwane rekordy ani że zmiana po stronie źródła nie zmodyfikowała krytycznego pola. Monitoring terminowości wykryje spóźnioną dostawę, walidacja deterministyczna wymusi reguły transakcyjne, a śledzenie schematu ujawni zmianę strukturalną, zanim raportowanie się posypie.
Praktyczny wniosek: zacznij od zbiorów wspierających decyzje regulacyjne, ryzyka lub finansowe i przypisz każdej kontroli jawnych właścicieli.
Ochrona zdrowia
Zespół operacji klinicznych łączy informacje z kilku systemów. Brakujące pole może wpłynąć na interpretację, a zmiana strukturalna zaburzyć aplikację w dole strumienia bez wyraźnego błędu pipeline'u. Ciągła walidacja i monitoring schematu pozwalają wykryć takie sytuacje, utrzymując obliczenia w kontrolowanym środowisku organizacji.
Praktyczny wniosek: oddziel przetwarzanie danych wrażliwych od dowodów monitoringu i określ, które kontrole wymagają dowodu deterministycznego.
Telekomunikacja
Platforma telekomunikacyjna przetwarza zdarzenia klienckie i operacyjne o dużym wolumenie. Właściciele biznesowi muszą wiedzieć, czy nieoczekiwany ruch odzwierciedla rzeczywiste zachowanie klientów, czy problem w pipeline. Monitorowanie metryk biznesowych obok dostępności danych i obciążenia platformy pomaga badać właściwą warstwę.
Praktyczny wniosek: połącz monitoring KPI z obserwowalnością platformy, aby nietypowy ruch biznesowy dało się skonfrontować z dowodami operacyjnymi.
Sektor publiczny
Dane publiczne często przechodzą między resortami i systemami o różnych modelach własności. Program kontroli musi zapewniać spójność, identyfikowalność i dowody gotowe na audyt, a nie opierać się na nieformalnych sprawdzeniach w pojedynczych zespołach.
Praktyczny wniosek: udokumentuj regułę, wykonanie, wynik i osobę odpowiedzialną dla każdego krytycznego zbioru danych.
W środowiskach regulowanych architektura wdrożenia liczy się tak samo jak wykrywanie. digna może działać w chmurze prywatnej, VPC lub centrum danych klienta, a obliczenia wykonywane są in-database — organizacje ograniczają ruch danych, zachowując wspólny obraz incydentów, trendów i statusów.
Kiedy automatyzować i jak zacząć z digna
Zacznij od ryzyka, a nie od najszerszego katalogu funkcji. Krytyczny zbiór danych z częstymi oczekiwaniami dostaw i wieloma odbiorcami zasługuje na uwagę wcześniej niż mało istotna tabela, z której prawie nikt nie korzysta.
Cztery pytania pomagają wyznaczyć pierwszy zakres:
Wpływ na decyzje: jaka decyzja biznesowa, kliniczna, finansowa lub publiczna zależy od tych danych?
Widoczność awarii: czy użytkownicy zauważyliby błąd od razu, czy mógłby pozostać ukryty?
Złożoność operacyjna: czy dane przechodzą przez wiele pipeline'ów, właścicieli lub platform?
Presja governance: czy prywatność, zgodność lub audyt wymagają dowodów?
Rozsądny pierwszy projekt obejmuje jeden problem o dużym wpływie, na przykład wykrywanie anomalii lub terminowość. Rozszerzaj zakres, gdy zespół zrozumie jakość alertów, własność i sposób naprawy. Prowadź wdrożenie modułowo, dokładając walidację deterministyczną, śledzenie schematu, monitoring biznesowy lub obserwowalność platformy tam, gdzie uzasadnia to ryzyko.
Lista kontrolna wdrożenia
Uruchamiaj lokalnie: trzymaj obliczenia w chmurze, VPC lub centrum danych organizacji, gdy przenoszenie danych tworzy ryzyko.
Korzystaj z bazy: preferuj liczenie metryk in-database tam, gdzie wymagają tego bezpieczeństwo i skala.
Oddzielaj sygnały wyuczone od stałych: pozwól liniom bazowym wskazywać nietypowe zachowania, a regułom deterministycznym egzekwować zobowiązania.
Zapisuj dowody: przechowuj kontrolę, kontekst uruchomienia, wynik, właściciela i historię rozwiązania.
Połącz przepływ pracy: zintegruj alerty ze schedulerem, katalogiem, dashboardami i procesem współpracy.
Przeglądaj fałszywe alarmy: traktuj strojenie alertów jako stałe zadanie inżynierskie.
Skoncentrowane podejście do wdrożenia jakości danych pomaga przełożyć te decyzje na model operacyjny. Celem nie jest automatyzowanie testów dla samej automatyzacji, lecz uczynienie z jakości procesu ciągłego i przejrzystego, któremu zaufają inżynierowie i właściciele biznesowi.
digna zapewnia modułowy monitoring anomalii, walidacji, terminowości, zmian schematu, metryk biznesowych i zachowania platformy danych wewnątrz środowiska klienta. Odwiedź digna, aby ocenić skoncentrowany punkt startowy i zobaczyć, jak ciągła automatyczna kontrola jakości wpisuje się w Twoje środowisko danych.
Zobacz, jak robi to digna w praktyce: zautomatyzowany monitoring jakości danych tam, gdzie leżą Twoje dane.
Najczęściej zadawane pytania
Czym jest automatyczna kontrola jakości danych?
Automatyczna kontrola jakości to ciągłe sprawdzanie zbiorów danych bez udziału człowieka uruchamiającego proces. Łączy walidację regułową dla wymagań, które da się precyzyjnie zapisać, progi statystyczne dla mierzalnych tolerancji oraz uczenie maszynowe sygnalizujące odchylenia od wyuczonego zachowania każdego zbioru.
Czym zautomatyzowana kontrola jakości różni się od kontroli ręcznych?
Kontrola ręczna bada dane wyrywkowo i zależy od tego, kto akurat ma czas spojrzeć. Automatyzacja obserwuje każde ładowanie względem linii bazowej, więc pokrycie nie zmienia się wraz ze zmianą dyżuru, a czas wykrycia spada z dni do minut — i to właśnie on decyduje, ile szkody wyrządzi problem w dole strumienia.
Kiedy stosować reguły, a kiedy wykrywanie AI?
Stosuj reguły tam, gdzie wymaganie da się zapisać: kolumna nie może być NULL, wartość musi mieć określony format, tabela musi dotrzeć przed terminem. Stosuj wykrywanie statystyczne i AI dla wszystkiego, czego nie da się wyliczyć z góry — spadku wolumenu, przesunięcia rozkładu czy ładowania, które każdej nocy kończy się później.
Czy automatyczna kontrola jakości wymaga kopiowania danych na inną platformę?
Nie powinna. Trzymanie obliczeń blisko danych oznacza, że środowisko opuszczają wyłącznie metryki i metadane — co ma znaczenie wszędzie tam, gdzie rezydencja danych, prywatność lub regulacje branżowe ograniczają miejsce przetwarzania danych produkcyjnych.
Jak zacząć automatyzować kontrolę jakości danych?
Zacznij od zbiorów, których awaria ma realne skutki, pozwól systemowi nauczyć się ich normalnego zachowania i zautomatyzuj kontrole, które zespół i tak wykonuje ręcznie. Rozszerzaj pokrycie, gdy alerty zyskają zaufanie — wdrożenia częściej rozbijają się o szum alertów niż o brak funkcji.


