Analityka zaufania do danych (Data Trust Analytics) wyjaśniona dla nowoczesnych zespołów ds. danych
|
8
min. czyt.

Badanie 2024 planning-insights wykazało, że 67% organizacji nie ufało całkowicie danym używanym do podejmowania decyzji, co stanowi wzrost z poziomu 55% rok wcześniej i oznacza 12-punktowy spadek zaufania w jednym rocznym cyklu. Analiza tego badania przeprowadzona przez firmę Precisely jasno opisuje problem: od zespołów analitycznych wymaga się szybszego działania, podczas gdy ich baza dowodowa pozostaje trudna do zweryfikowania.
Ta luka to praktyczny obszar działania analityki zaufania do danych (data trust analytics). Łączy ona jakość danych, Observability, wykrywanie anomalii, pochodzenie danych (lineage) oraz kontekst biznesowy, dzięki czemu zespoły mogą odpowiedzieć na znacznie bardziej użyteczne pytanie niż „Czy rurociąg danych został uruchomiony?”. Mogą zapytać: „Czy ten zestaw danych jest obecnie wystarczająco wiarygodny, aby wesprzeć decyzję lub wynik działania AI?”
Spis treści
Dlaczego zaufanie do danych jest nowym wąskim gardłem dla analityki i AI
Dlaczego pewność co do kodu to nie to samo co pewność co do danych
Co naprawdę oznacza analityka zaufania do danych
Zaufanie to sygnał złożony
Pięć filarów generujących sygnały zaufania
Aktualność pokazuje, czy dane są świeże
Jakość testuje wartości i reguły biznesowe
Wolumen wychwytuje ciche błędy kompletności
Schemat chroni kompatybilność strukturalną
Pochodzenie danych (lineage) identyfikuje, na kogo i na co ma to wpływ
Jak warstwy wykrywania łączą statystykę, ML i weryfikację ludzką
Gdzie uczenie maszynowe wnosi wartość dodaną
Dlaczego ludzie pozostają częścią systemu
Metryki, które zmieniają zaufanie w coś, co można zmierzyć
Wspólna interpretacja metryk
Dodawanie kontekstu decyzyjnego
Od Observability do gotowości decyzyjnej dla AI
Budowanie kart wyników wokół danych wyjściowych
Zarządzanie zaufaniem w obliczu ograniczeń korporacyjnych
Utrzymywanie proporcjonalności płaszczyzny kontrolnej
Przypisywanie własności przed dodaniem alertów
Budowanie trwałego modelu operacyjnego zaufania
Przekształcanie incydentów w wiedzę instytucjonalną
Przegląd zaufania jako praktyka międzyfunkcyjna
Dlaczego zaufanie do danych jest nowym wąskim gardłem dla analityki i AI
Lider finansowy otwiera pulpit nawigacyjny przychodów przed spotkaniem zarządu. Wykres pokazuje gwałtowny spadek sprzedaży regionalnej, więc zespół opóźnia plan rekrutacyjny i koryguje prognozę. Później inżynier odkrywa, że zmiana na wcześniejszym etapie procesu (upstream) spowodowała opóźnienie części danych o klientach. Pulpit nawigacyjny nie wyświetlał złośliwego fałszerstwa. Wyświetlał dane, które stały się niekompletne, choć błąd ten nie był oczywisty.
Ten scenariusz jest powszechny, ponieważ pulpity nawigacyjne, modele uczenia maszynowego i asystenci AI dziedziczą stan swoich danych źródłowych. Brakujące wiersze mogą obniżyć wartość metryki. Przestarzała partycja może sprawić, że trend będzie wyglądał na aktualny, choć taki nie jest. Uszkodzone złączenie (join) może usunąć klientów z segmentu. Zmiana nazwy kolumny może zmienić transformację. Bez użytecznego pochodzenia danych (lineage) nikt nie jest w stanie szybko ustalić, na które raporty, funkcje lub decyzje ma to wpływ.
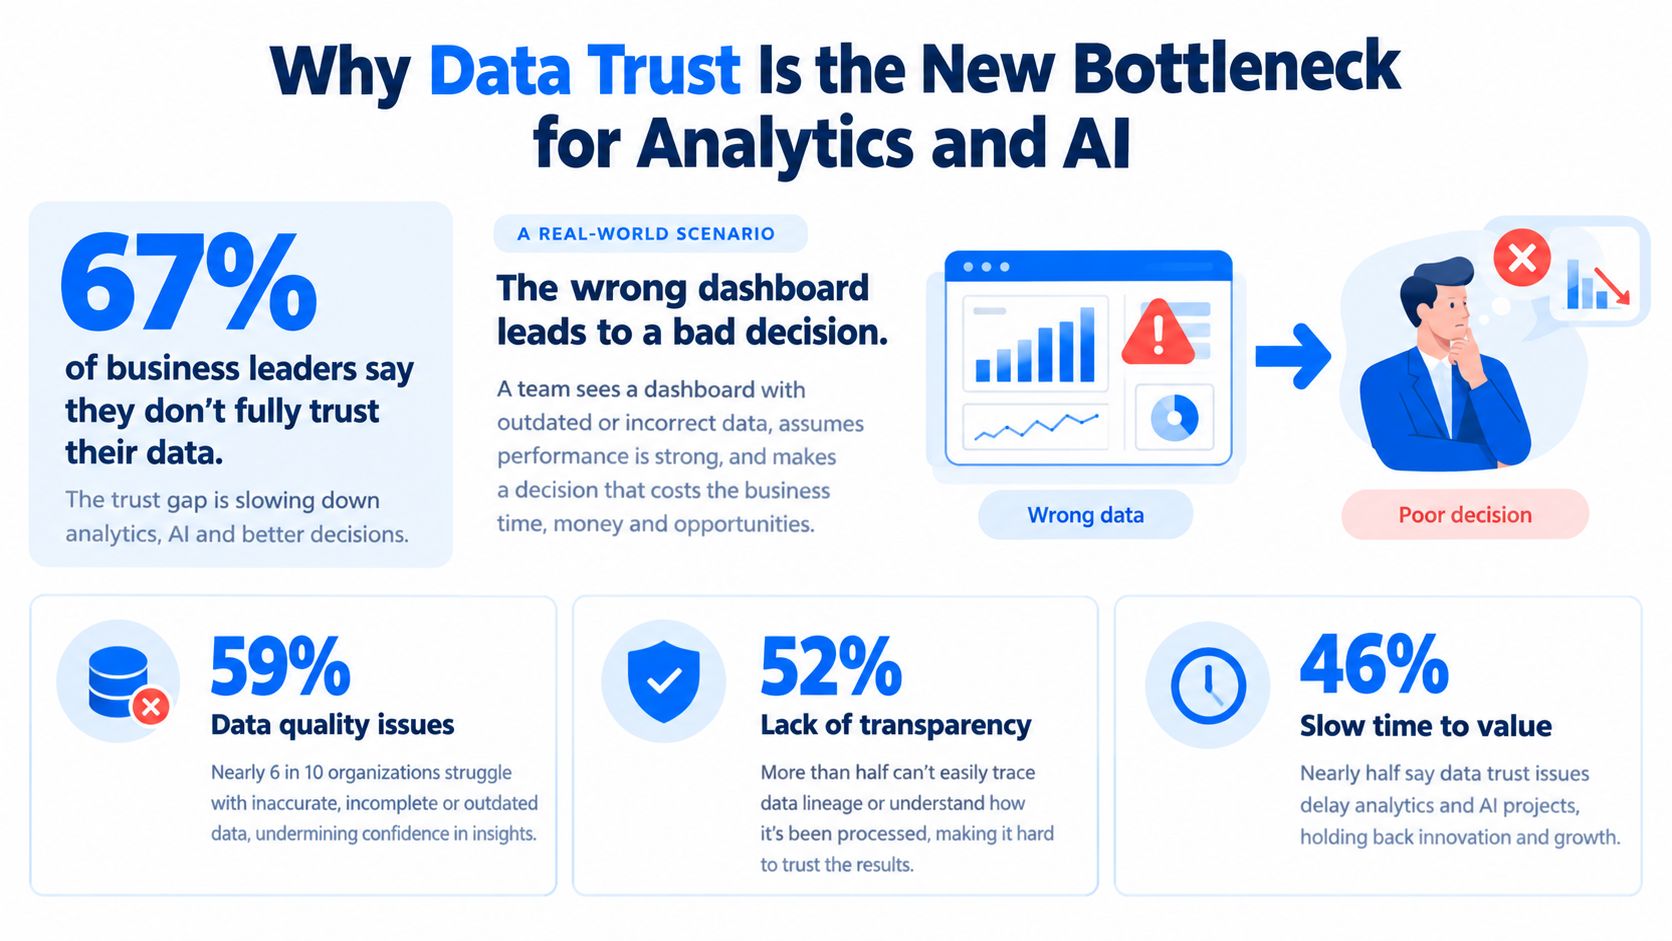
Koszt dla przedsiębiorstwa wykracza poza jeden błędny wykres. W powiązanym raporcie branżowym 77% decydentów IT stwierdziło, że nie ufa w pełni danym swojej organizacji przy podejmowaniu dokładnych, terminowych i krytycznych dla biznesu decyzji, podczas gdy 82% stwierdziło, że pracownicy musieli ponownie przetwarzać ukończone projekty analityczne z powodu słabej jakości danych. Ten sam raport Precisely łączy słabe zaufanie z tarciami operacyjnymi, wskazując jakość danych jako główną barierę dla 70% respondentów w organizacjach o niskim poziomie zaufania do danych decyzyjnych.
Why code confidence isn't data confidence
Model może pomyślnie przejść testy wdrożeniowe, a mimo to generować niewiarygodne rekomendacje, jeśli jego tabele cech (features) uległy dryfowi. Zapytanie SQL może się pomyślnie skompilować, zwracając jednocześnie mniej wierszy, ponieważ proces upstream przestał ładować jedno ze źródeł. Poprawność oprogramowania mówi jedynie, że kod wykonał się zgodnie z projektem. Nie dowodzi jednak, że dane wejściowe były kompletne, terminowe, stabilne lub odpowiednie do podjęcia decyzji.
Analityka zaufania do danych dostarcza tych brakujących dowodów. Traktuje sygnały operacyjne jako część poprawności analitycznej, a następnie łączy awarie z dotkniętymi zasobami i odpowiedzialnymi właścicielami. Zespoły analizujące wpływ słabej jakości danych na decyzje biznesowe mogą wykorzystać to rozróżnienie, aby przejść od korygowania widocznych błędów na pulpitach nawigacyjnych do zapobiegania sytuacji, w której niewiarygodne wyniki trafiają do decydentów.
Co naprawdę oznacza analityka zaufania do danych
Zacznijmy od wąskiej definicji. Jakość danych sprawdza, czy wartości i rekordy spełniają określone warunki, takie jak wypełnienie wymaganego pola, mieszczenie się daty w dozwolonym zakresie czy unikalność identyfikatora klienta. Te kontrole są niezbędne, ale obejmują tylko to, co zespół zdołał wcześniej przewidzieć i określić.
Analityka zaufania do danych rozszerza to pytanie. Łączy dowody jakości z Timeliness, wolumenem, stabilnością schematu, pochodzeniem danych (lineage), własnością i udokumentowanym znaczeniem. Odbiorca danych musi wiedzieć nie tylko, czy dana wartość wygląda na poprawną, ale także czy zestaw danych jest aktualny, zrozumiały, mierzalny i bezpieczny do użycia w konkretnym celu.
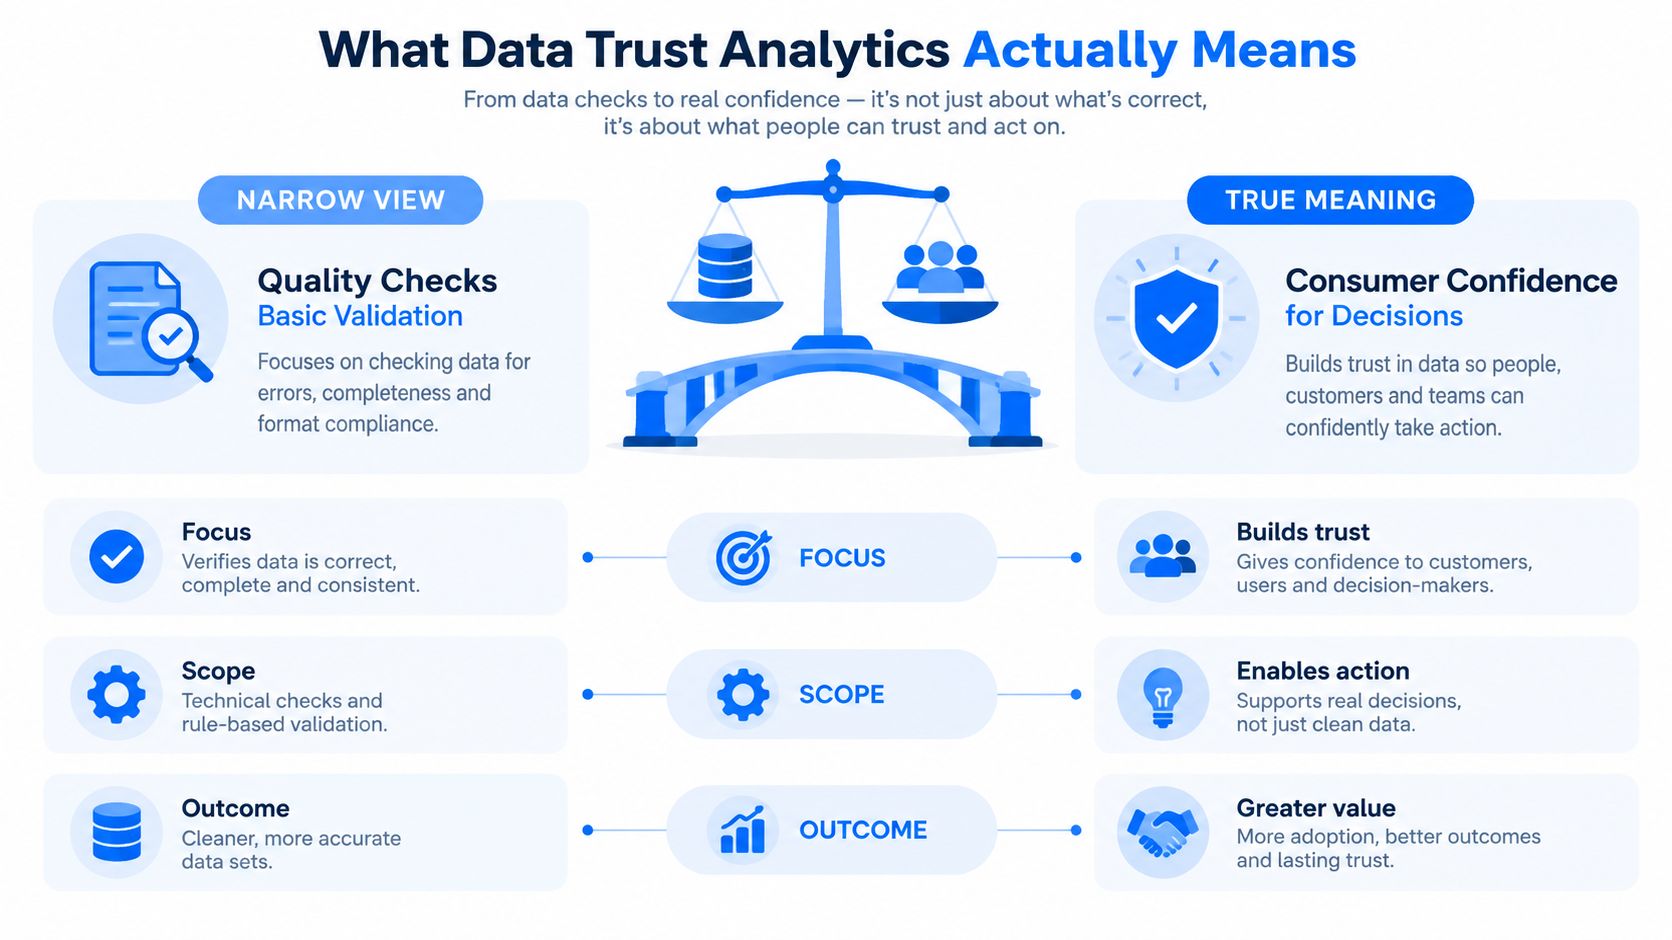
Pomocne jest następujące rozróżnienie:
Jakość danych pyta: „Czy ta wartość spełnia regułę?”
Analityka zaufania do danych pyta: „Czy decydent oparłby rekomendację na tym zbiorze danych w tym momencie?”
To drugie pytanie zależy od kontekstu. Niewielkie opóźnienie może być akceptowalne w przypadku miesięcznego raportu planistycznego, ale niedopuszczalne w przypadku alertu operacyjnego. Kolumna może być poprawna technicznie, ale niejednoznaczna semantycznie. Cecha modelu może pomyślnie przechodzić kontrole wartości pustych (null), tracąc jednocześnie połączenie z systemem źródłowym, który wyjaśnia jej znaczenie.
Zaufanie to sygnał złożony
Pomyśl o zaufaniu jak o wniosku wyciągniętym z kilku rodzajów dowodów:
Dowody operacyjne: Czy dane dotarły na czas i czy rurociąg danych zakończył działanie?
Dowody statystyczne: Czy liczby, rozkłady, średnie i wzorce brakujących wartości przypominają ich dotychczasowe zachowanie?
Dowody strukturalne: Czy kolumny, typy danych i relacje pozostały kompatybilne?
Dowody kontekstowe: Czy cel, właściciel, pochodzenie (lineage) i definicja biznesowa zbioru danych są udokumentowane?
Ramy Data Observability sprawiają, że te sygnały stają się widoczne, ale sama widoczność nie jest celem ostatecznym. Kluczowym krokiem jest przełożenie tych obserwacji na ocenę wiarygodności konkretnego pulpitu nawigacyjnego, modelu, metryki czy przepływu pracy AI.
Pięć filarów generujących sygnały zaufania
Cicha awaria rurociągu danych rzadko sygnalizowana jest czerwonym błędem. Załóżmy, że proces przechwytywania zmian danych (CDC) na wcześniejszym etapie gubi wiersze przez dwa dni, ale zadanie nadal raportuje sukces. Pulpity nawigacyjne przychodów zaczynają zaniżać wyniki, a model prognostyczny otrzymuje niekompletną historię klientów. Każdy filar Observability ujawnia inną część tego incydentu.
Standardowe pięć filarów to Timeliness, jakość, wolumen, schemat i pochodzenie danych (lineage). Współpracują one ze sobą, a nie jako wymienne etykiety. Wymiary jakości danych zapewniają użyteczny sposób na połączenie poszczególnych kontroli z szerszym pytaniem, czy dane końcowe nadal nadają się do użytku.
Aktualność pokazuje, czy dane są świeże
Aktualność odpowiada na pytanie, czy zbiór danych dotarł zgodnie z oczekiwanym harmonogramem. Dane, które pojawiają się co rano, ale omijają swoje normalne okno dostarczenia, powinny obniżać zaufanie, nawet jeśli rekordy, które już są obecne, pomyślnie przechodzą walidację. Monitorowanie terminowości pozwala odróżnić opóźnione dostarczenie od jego całkowitego braku, a także zidentyfikować nieoczekiwanie wczesne dostarczenie, co może wskazywać na problem z harmonogramem lub partycjonowaniem.
Jakość testuje wartości i reguły biznesowe
Kontrole jakości badają wskaźniki wartości pustych (null), duplikaty, nieprawidłowe formaty, relacje referencyjne i ograniczenia biznesowe. W przykładzie z utraconymi wierszami pozostałe rekordy mogą nadal mieć poprawne identyfikatory klientów, więc sama walidacja na poziomie rekordów może przeoczyć incydent. Jakość staje się bardziej informacyjna, gdy jest interpretowana wraz z wolumenem i zachowaniem historycznym.
Wolumen wychwytuje ciche błędy kompletności
Monitorowanie wolumenu porównuje liczbę wierszy lub inne wskaźniki rozmiaru z oczekiwanymi wzorcami. Nagły spadek może ujawnić częściowy eksport, nawet gdy rurociąg danych nie zgłasza żadnego błędu technicznego. Wolumen nie wyjaśnia przyczyny, ale daje zespołowi wczesny sygnał, że kompletność zbioru danych wymaga zbadania.
Schemat chroni kompatybilność strukturalną
Śledzenie schematu wykrywa dodania, usunięcia, zmiany nazw kolumn i zmiany typów danych. Zmiana nazwy kolumny może natychmiast zepsuć transformację na dalszym etapie (downstream) lub zostać błędnie zmapowana i dać prawdopodobne, ale błędne wyniki. Kompatybilność strukturalna jest elementem zaufania, ponieważ odbiorcy zależą zarówno od wartości, jak i od kształtu danych.
Pochodzenie danych (lineage) identyfikuje, na kogo i na co ma to wpływ
Pochodzenie (lineage) łączy tabelę źródłową z transformacjami, pulpitami nawigacyjnymi, cechami, modelami i metrykami biznesowymi. Po wykryciu spadku liczby wierszy lineage pomaga zespołowi zidentyfikować, które raporty przychodów i prognozy wymagają weryfikacji. Własność (ownership) przekształca tę mapę w działanie, kierując incydent do osób odpowiedzialnych za źródło i powiązane produkty.
Żaden pojedynczy filar nie może zaświadczyć o gotowości do podjęcia decyzji. Zaufanie pojawia się wtedy, gdy sygnały są skorelowane, interpretowane w kontekście i przekazywane odpowiedzialnym właścicielom.
Jak warstwy wykrywania łączą statystykę, ML i weryfikację ludzką
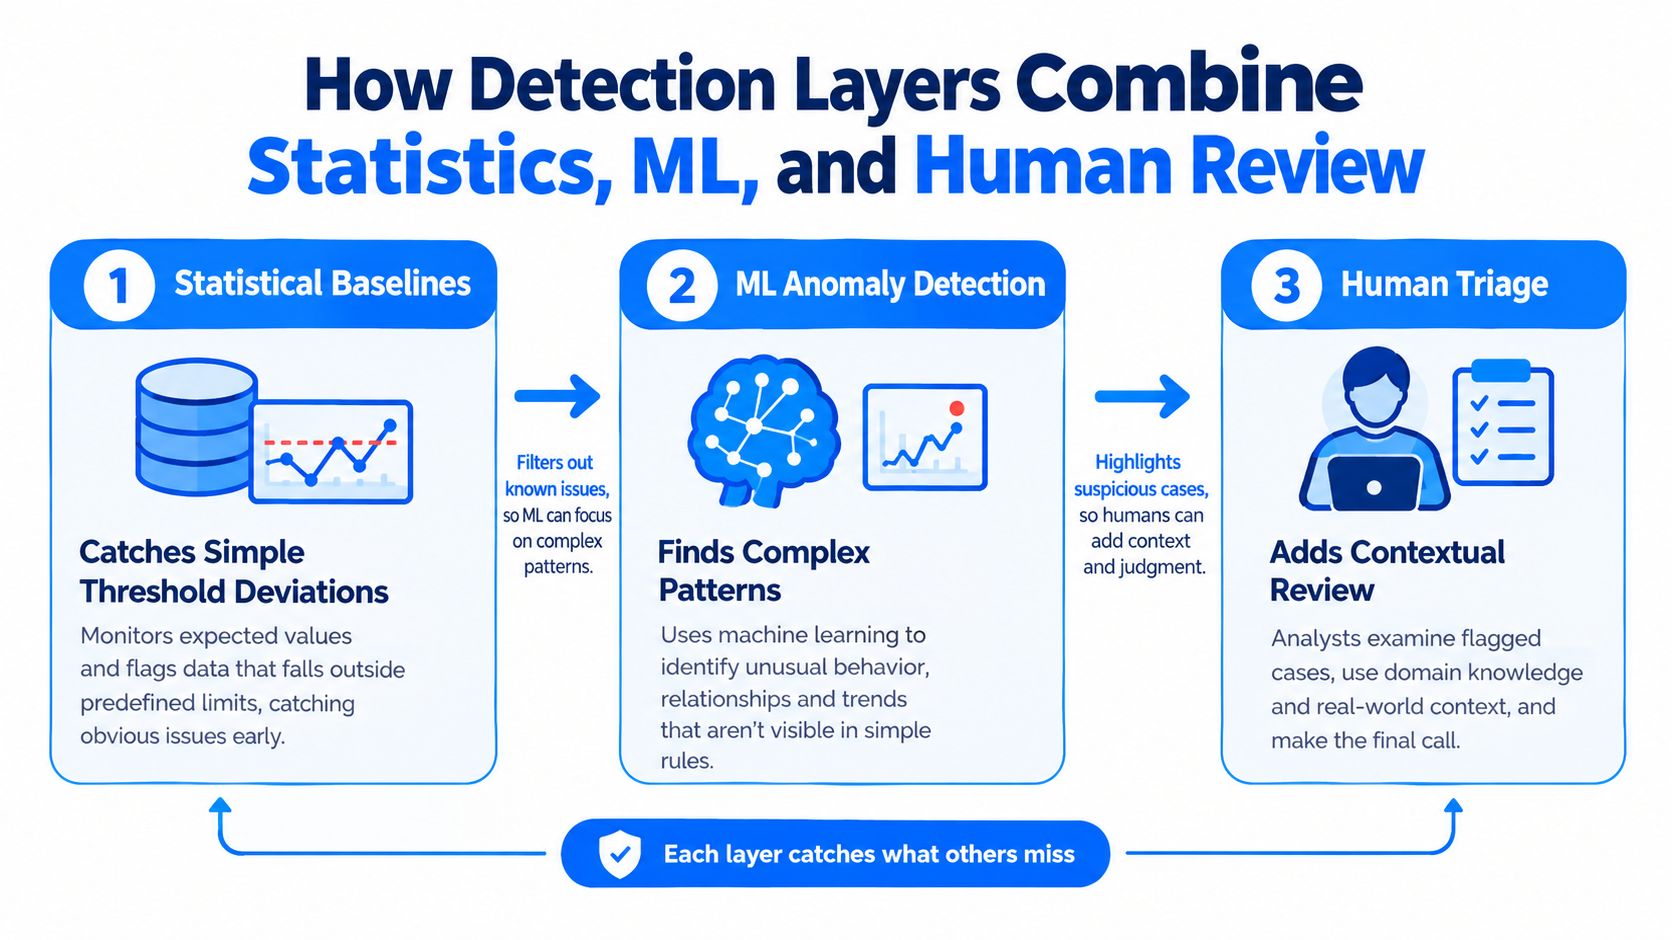
Wykrywanie działa najlepiej jako system wielowarstwowy, ponieważ każda warstwa odpowiada na inne pytanie. Statystyczne punkty odniesienia (baselines) pozwalają tanio i w zrozumiały sposób wyłapać wyraźne błędy. Uczenie maszynowe identyfikuje zachowania, które mogą umknąć sztywnym regułom. Weryfikacja ludzka dostarcza kontekstu biznesowego niezbędnego do podjęcia decyzji, czy alert reprezentuje rzeczywisty incydent, planowaną zmianę czy niegroźną zmienność.
Zacznij od punktów odniesienia dla aktualności, wolumenu, wskaźnika wartości pustych, średnich i innych kluczowych miar. Próg może oznaczyć brakujące dostarczenie, podczas gdy statystyka krocząca może wykazać znaczące odejście od niedawnego zachowania. Kontrole te są łatwe do wyjaśnienia podczas przeglądu incydentów, dzięki czemu pozostają użyteczne nawet po dodaniu przez zespół bardziej zaawansowanego wykrywania.
Gdzie uczenie maszynowe wnosi wartość dodaną
Statyczne reguły stają się mniej niezawodne, gdy dane podlegają wzorcom sezonowym, dniom tygodnia, cyklom wydań (Release) lub segmentom klientów. Wyuczony rozkład lub model sezonowy może zidentyfikować nietypowy wzorzec, który mieści się w szerokim, stałym progu – to podejście oparte na statystycznym rozpoznawaniu wzorców. Rurociąg danych może przejść regułę minimalnej liczby wierszy, generując jednocześnie rozkład, który ostro odbiega od jego ustalonego profilu.
W przypadku danych operacyjnych o dużym wolumenie badania Uniwersytetu Amsterdamskiego opisują oparte na konsensusie podejście bez nadzoru (unsupervised), które łączy wiele modeli, reguły praktyczne, iteracyjne dostrajanie hiperparametrów oraz obecność eksperta dziedzinowego w pętli decyzyjnej. Metoda opisana w badaniu wspiera praktyczną zasadę projektową: żaden pojedynczy detektor nie powinien odpowiadać za każdy typ anomalii.
Dlaczego ludzie pozostają częścią systemu
Rurociąg danych może przejść stałe kontrole aktualności i wolumenu, a mimo to uruchomić wyuczony model, ponieważ kluczowa metryka spada w nietypowy sposób. Analityk sprawdza kalendarz wdrożeń i potwierdza, że zmiana była spowodowana planowaną promocją. Oznaczenie zdarzenia jako oczekiwanego zapobiega przekształceniu się podobnych alertów w powtarzający się szum i zapewnia lepszy kontekst dla procesu wykrywania.
Inna koncepcja dotycząca jakości danych zaleca profilowanie każdej przychodzącej partii, zachowywanie profili historycznych i wprowadzanie wynikowych szeregów czasowych do modeli anomalii. Cytowane podejście do profilowania traktuje dryf jako mierzalną sekwencję, a nie jednorazową inspekcję.
Zasada praktyczna: Używaj reguł dla znanych trybów awarii, modeli dla zmieniających się zachowań, a ludzi do określania kontekstu biznesowego.
Metryki, które zmieniają zaufanie w coś, co można zmierzyć
Zarządzanie zaufaniem staje się możliwe, gdy zespoły wyrażają je za pomocą metryk, które mogą raportować, na które mogą ustawiać alerty i które mogą ulepszać. Pulpit nawigacyjny z komunikatem „dane wyglądają na zdrowe” jest trudny do obrony. Karta wyników pokazująca wydajność aktualności, nierozwiązane anomalie, czas przywracania schematu i pokrycie lineage daje inżynierom i interesariuszom wspólny język operacyjny.
Poniższe metryki stanowią punkty wyjścia, a nie uniwersalne cele. Krytyczny zbiór danych dotyczących płatności powinien mieć surowsze wymagania niż tabela o charakterze eksploracyjnym. Zdefiniuj punkt odniesienia wraz z właścicielami i odbiorcami, którzy rozumieją konsekwencje awarii.
Metryka | Definicja | Docelowy punkt odniesienia | Filar źródłowy |
|---|---|---|---|
SLO aktualności | Udział oczekiwanych aktualizacji dostarczonych w uzgodnionym cyklu | Określany przez cel decyzyjny i oczekiwania dotyczące dostarczenia zbioru danych | Aktualność |
Wskaźnik anomalii | Wykryte zdarzenia anomalne w stosunku do monitorowanej populacji tabeli i okresu obserwacji | Na tyle niski, by utrzymać uwagę, z potwierdzonymi incydentami śledzonymi oddzielnie od zaakceptowanych zdarzeń | Jakość, wolumen, aktualność |
MTTR zmiany schematu | Średni czas od nieautoryzowanej lub niekompatybilnej zmiany schematu do jej rozwiązania | Na tyle krótki, aby chronić publikację danych i użycie modeli na dalszych etapach | Schemat |
Pokrycie lineage | Udział zasobów downstream połączonych z posiadanym i monitorowanym źródłem upstream | Pełne pokrycie dla krytycznych raportów, funkcji i modeli | Pochodzenie danych (lineage) |
Wspólna interpretacja metryk
Świetny wynik aktualności nie zrekompensuje słabego lineage. Niski wskaźnik anomalii może oznaczać stabilne dane, ale może też oznaczać, że detektor jest zbyt konserwatywny. MTTR zmiany schematu może wyglądać dobrze, podczas gdy zespoły nadal nie są w stanie zidentyfikować wszystkich pulpitów nawigacyjnych, na które ma to wpływ.
Z tego powodu publikuj kontekst metryk wraz z samą wartością liczbową. Rejestruj zestaw monitorowanych zasobów, cel decyzyjny, wykluczenia, zaakceptowane anomalie oraz status własności. Przewodnik po mierzeniu niezawodności może pomóc zespołom przekształcić obserwacje operacyjne w rozmowę o niezawodności, którą zrozumieją interesariusze biznesowi.
Dodawanie kontekstu decyzyjnego
Każda karta wyników powinna odpowiadać na trzy pytania:
Co było mierzone? Nazwij tabelę, zestaw cech, metrykę lub dane wejściowe modelu.
Co się zmieniło? Pokaż bieżący sygnał na tle jego historycznego punktu odniesienia i uzgodnionych oczekiwań.
Jakie działanie po tym następuje? Zidentyfikuj właściciela, ścieżkę eskalacji oraz decyzję o publikacji lub wnioskowaniu (inference).
Taka struktura zapobiega traktowaniu zaufania przez zespoły jako ozdobnej etykiety na pulpicie nawigacyjnym. Sprawia, że stopień wiarygodności staje się mierzalny i możliwy do zweryfikowania.
Od Observability do gotowości decyzyjnej dla AI
Observability dostarcza dowodów, ale nie informuje automatycznie właściciela modelu, czy system AI powinien dziś działać. Platforma może pokazywać prawidłowe wykonanie rurociągu danych, podczas gdy dane cech (features) pozostają trudne do prześledzenia, mają nietypowy rozkład lub są dotknięte nierozwiązanymi anomaliami.
Ta luka jest wyraźnie widoczna w nastrojach przedsiębiorstw. 58% organizacji stwierdziło, że wdrożyło lub zoptymalizowało programy Data Observability, a mimo to 42% nadal nie ufało wynikom swoich modeli AI lub uczenia maszynowego, jak wynika z niedawnych raportów na temat zaufania do sztucznej inteligencji w przedsiębiorstwach. Observability może zatem współistnieć z brakiem zaufania, jeśli zespoły monitorują infrastrukturę bez udowadniania, że dane wejściowe na dalszych etapach są gotowe do podjęcia decyzji.
Budowanie kart wyników wokół danych wyjściowych
Karta zaufania powinna wiązać dowody z konkretnym odbiorcą. Na przykład tabela cech może wykazywać akceptowalną aktualność, ale tylko 60% pokrycia lineage i trzy nierozwiązane anomalie. Te liczby to wartości scenariuszowe, a nie ogólne punkty odniesienia, ale pokazują, dlaczego ogólny, zielony status rurociągu danych może wprowadzać w błąd.
Proces wdrażania modelu może stosować wyraźne warunki wejściowe (gates):
Warunek aktualności: Wymagane dane wejściowe dotarły w oczekiwanych oknach czasowych.
Warunek jakości: Krytyczne reguły walidacji zostały spełnione, a wyjątki udokumentowano.
Warunek schematu: Brak nierozwiązanych, niekompatybilnych zmian strukturalnych.
Warunek lineage: Właściciel modelu może prześledzić krytyczne cechy wstecz aż do monitorowanych źródeł.
Warunek incydentów: Otwarte anomalie mają przypisanego właściciela i udokumentowaną decyzję.
Karta wyników nie powinna ukrywać niepewności pod jedną zbiorczą oceną. Powinna pokazywać dowody stojące za decyzją, zatwierdzenie właściciela ryzyka oraz warunki, w których wynik musi zostać wstrzymany lub zweryfikowany.
Te dowody mogą również pojawić się w dokumentacji modelu. Kadra zarządzająca, regulatorzy, analitycy i inżynierowie potrzebują czegoś więcej niż tylko metryki modelu. Potrzebują wiarygodnego wyjaśnienia, czy dane wspierające wynik były aktualne, stabilne, zweryfikowane i możliwe do prześledzenia w momencie ich użycia.
Zarządzanie zaufaniem w obliczu ograniczeń korporacyjnych
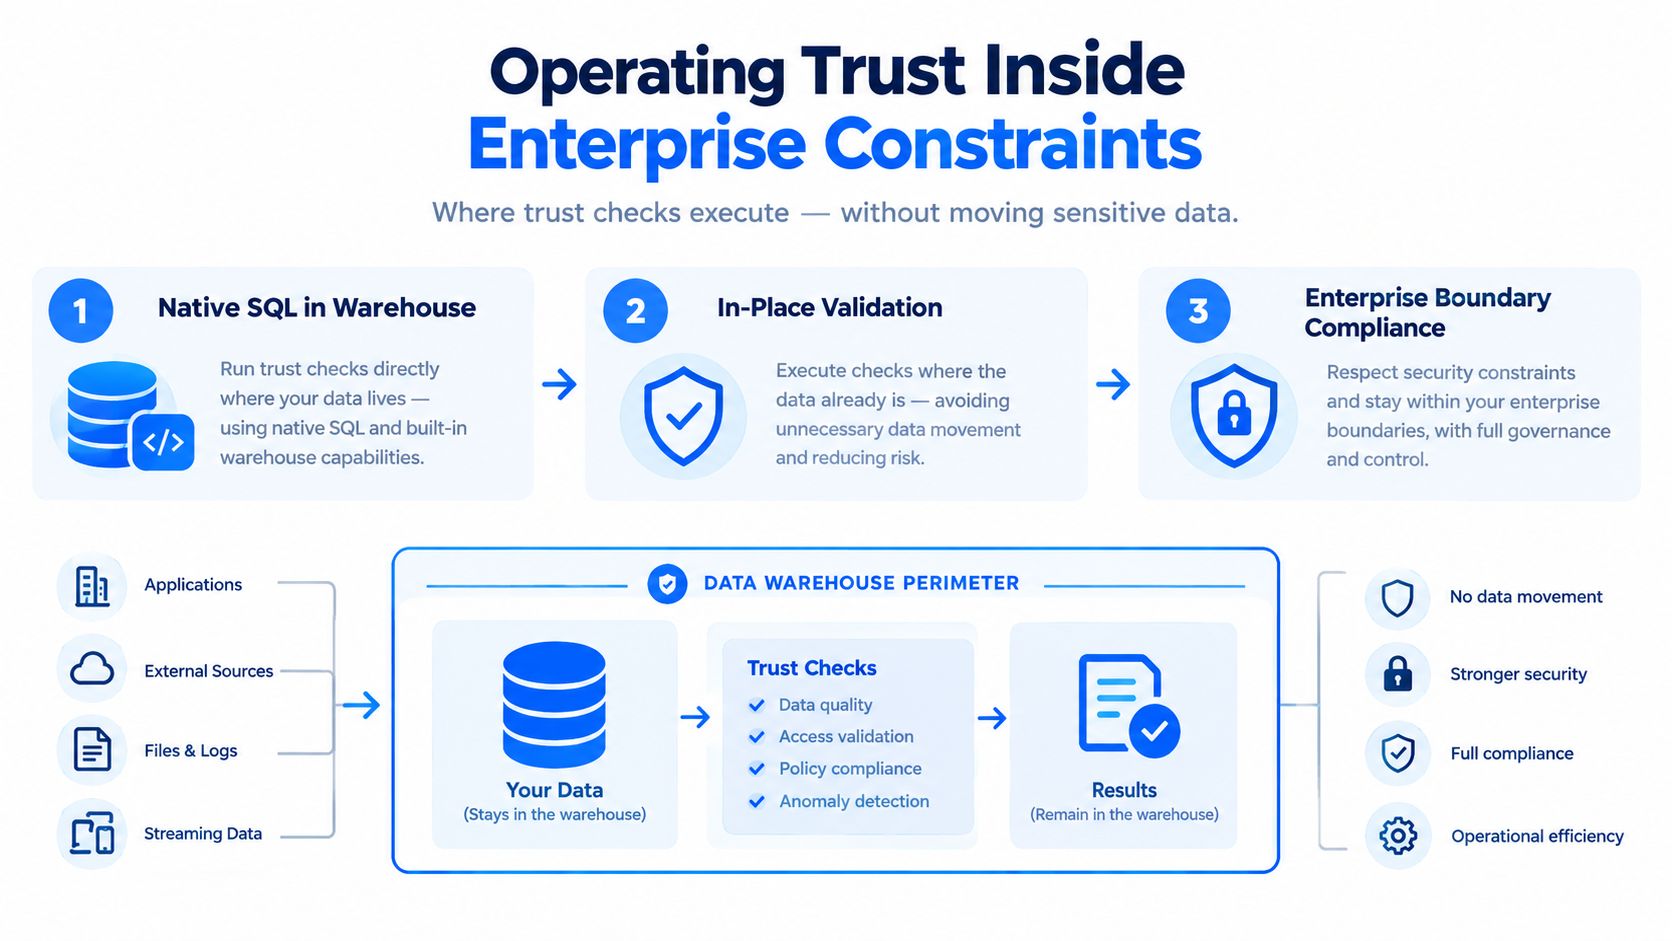
Kontrola zaufania musi być dostosowana do środowiska, w którym już znajdują się wrażliwe dane. Przenoszenie rekordów produkcyjnych do osobnej usługi monitorującej może rodzić obawy związane z prywatnością, lokalizacją danych (residency), kontrolą dostępu, szyfrowaniem i siecią. Może również skomplikować model własności poprzez oddzielenie dowodów od systemu, który przechowuje te dane.
Praktyczna architektura często oddziela wykonanie od koordynacji. Natywne kontrole SQL lub bazy danych mogą obliczać liczbę wierszy, ograniczenia, wskaźniki aktualności i wyniki walidacji bezpośrednio tam, gdzie znajdują się dane. Scentralizowana usługa może następnie zarządzać zasadami, alertami, kierowaniem incydentów i kartami wyników, korzystając z niezbędnych metadanych, a nie z kopii bazowych rekordów.
Utrzymywanie proporcjonalności płaszczyzny kontrolnej
Właściwy model wdrożenia zależy od granic organizacji. Chmura prywatna lub instalacja lokalna (on-premises) może odpowiadać zespołom, które nie mogą przenosić danych produkcyjnych poza swoje środowisko. digna informuje, że jej platforma działa w chmurze prywatnej klienta lub w jego infrastrukturze lokalnej, a kontrole jakości danych i logika wykrywania anomalii są wykonywane wewnątrz silnika bazy danych klienta. Jej dokumentacja opisuje ten model działania na miejscu (in-place).
Projekt operacyjny powinien również uwzględniać opór przed wdrożeniem. Niedawne badanie wykazało, że 61% zespołów nadal polegało na ręcznych kontrolach lub walidacji opartej na SQL, 27% korzystało z dedykowanej platformy Observability, a tylko 14% wdrażało umowy SLA w całej organizacji, podczas gdy 39% je śledziło. Raport Integrate.io pokazuje, dlaczego wdrożenie musi szanować istniejące przepływy pracy, zamiast zakładać, że każdy zespół może natychmiast zastąpić swoje dotychczasowe praktyki walidacji.
Przypisywanie własności przed dodaniem alertów
Ten sam raport wykazał, że własność jakości danych była dzielona między wiele zespołów w przypadku 44% respondentów, a ograniczona widoczność stanu rurociągu danych była głównym wyzwaniem dla 31%. Wspólna odpowiedzialność może działać, ale tylko wtedy, gdy konkretna osoba jest właścicielem decyzji o zbadaniu, opublikowaniu, zablokowaniu lub przywróceniu danych wyjściowych.
Ustalaj priorytety kontroli według:
Wpływu na decyzje: W pierwszej kolejności monitoruj zasoby, które wpływają na decyzje finansowe, regulacyjne, kliniczne, operacyjne lub klienckie.
Wrażliwości danych: Minimalizuj ilość przechowywanych metadanych i dopasuj uprawnienia dostępu do już istniejących.
Kosztu awarii: Kieruj alerty o poważnych konsekwencjach przez ustalone kanały zarządzania incydentami.
Dopasowania operacyjnego: Testuj kontrole podczas opóźnionego pobierania danych, pogorszonych zależności i zmian schematu.
Nie kupuj obietnicy obejmującej całą platformę przed sprawdzeniem przepływu pracy w krytycznym obszarze. Modułowe wdrażanie pozwala zespołom zweryfikować jakość sygnału, własność alertów i koszty operacyjne przed rozszerzeniem zakresu monitorowania.
Budowanie trwałego modelu operacyjnego zaufania
Trwały program zaufania to system operacyjny o zamkniętej pętli, a nie zbiór losowych alertów monitorowania. Zespoły definiują cele poziomu usług (SLO) dla aktualności, kompletności, poprawności, kompatybilności schematu i pokrycia lineage, a następnie łączą te cele ze wskazanymi właścicielami, ścieżkami eskalacji i progami wpływu na biznes.
Polityka reagowania ma takie samo znaczenie jak samo wykrywanie. Nieudana kontrola może zablokować publikację na dalszych etapach lub wnioskowanie AI, ale tylko wtedy, gdy udokumentowane procedury uzasadniają takie zakłócenie. W innych przypadkach organizacja może zachować ostatni znany wiarygodny wynik, oznaczyć dane wyjściowe jako nieaktualne i dać właścicielowi określony czas na rozwiązanie problemu.
Przekształcanie incydentów w wiedzę instytucjonalną
Dla każdego istotnego incydentu zarejestruj:
Przyczynę: Co zmieniło się w źródle, transformacji, harmonogramie, schemacie lub ścieżce dostępu?
Wpływ: Na które tabele, metryki, pulpity nawigacyjne, cechy, modele i decyzje miało to wpływ?
Reakcję: Kto prowadził dochodzenie, jakie działania podjęto i jak szybko przywrócono działanie usługi?
Dowody: Które wyniki walidacji i monitorowania potwierdziły, że dane są ponownie bezpieczne do użycia?
Po usunięciu awarii wprowadź te wnioski z powrotem do reguł walidacji, konfiguracji bazowej, map własności, polityk dostępu i backlogów inżynieryjnych. Powtarzające się problemy z terminowością mogą wymagać przeprojektowania harmonogramu. Powracający problem ze schematem może wymagać kontraktów kompatybilności. Powtarzająca się niejednoznaczność wokół metryki może wymagać silniejszej definicji semantycznej.
Przegląd zaufania jako praktyka międzyfunkcyjna
Inżynieria danych, analityka, governance, bezpieczeństwo oraz interesariusze biznesowi powinni wspólnie przeglądać karty wyników. Każda grupa dostrzega inne rodzaje błędów. Inżynierowie rozumieją zachowanie rurociągów, analitycy rozumieją interpretację, bezpieczeństwo rozumie ekspozycję danych, governance rozumie odpowiedzialność, a właściciele biznesowi rozumieją konsekwencje decyzji.
Ta dyscyplina wspiera szersze wysiłki mające na celu odblokowanie wartości biznesowej dzięki danym, ponieważ wiarygodne dane stają się zdolnością operacyjną, a nie niezbadanym produktem ubocznym. Celem nie jest wyeliminowanie każdej anomalii. Jest nim wypracowanie powtarzalnych dowodów na to, że organizacja zna swoje dane, wie, kto jest ich właścicielem, wie, jakie decyzje od nich zależą i potrafi sprawnie reagować, gdy zmieniają się warunki.
Na zaufanie pracuje się wtedy, gdy te same dowody wspierają tę samą decyzję zarówno w zwykłe dni, jak i w dniach wystąpienia incydentów.
digna zapewnia działające w środowisku lokalnym funkcje jakości danych i Observability do monitorowania anomalii, terminowości, walidacji, zmian schematu i historycznego zachowania danych bez przenoszenia danych produkcyjnych poza środowisko klienta. Odwiedź digna, aby zobaczyć, jak jej modułowe podejście może połączyć sygnały operacyjne z gotowością decyzyjną dla analityki i AI.
✦ Generated with Artifical Intelligence



Poznaj zespół tworzący platformę
Zespół z Wiednia, składający się z ekspertów od AI, danych i oprogramowania, wspierany rygorem akademickim i doświadczeniem korporacyjnym.