Klasa danych: praktyczny przewodnik dla nowoczesnych zespołów
|
7
min. czyt.

Popularna rada brzmi: sklasyfikuj dane raz, nadaj im etykiety, takie jak publiczne czy poufne, i uznaj problem governance za rozwiązany. Takie podejście myli opis z kontrolą. Etykieta, która nie zmienia dostępu, walidacji, retencji, monitorowania ani reagowania na incydenty, jest dokumentacją, a nie governance.
Użyteczny model klas danych musi opisywać, co zawiera dany zasób, jak się zachowuje i co organizacja musi zrobić, gdy zmienia się jego ryzyko. Oznacza to połączenie typu analitycznego, znaczenia statystycznego, sposobu reprezentacji, kontekstu biznesowego i wpływu na bezpieczeństwo. Najtrudniejsza praca zaczyna się po opublikowaniu taksonomii, ponieważ zespoły muszą powiązać każdą klasę z mechanizmami kontroli działającymi w rzeczywistych bazach danych, pipeline'ach, hurtowniach, data lake'ach i repozytoriach dokumentów.
Spis treści
Ukryte ryzyko statycznych etykiet danych
Wiele programów klasyfikacji zawodzi bez żadnego alarmu: zespół governance tworzy politykę, właściciele oznaczają ważne zbiory danych, a audytorzy dostają eksport z katalogu, podczas gdy uprawnienia pozostają bez zmian. Monitorowanie nadal traktuje każdą tabelę tak samo, a zespoły reagujące na incydenty nie dostają wiarygodnego sygnału, gdy zwykły operacyjny zbiór danych staje się zasobem wyższego ryzyka.
Kategorie takie jak publiczne, wewnętrzne, poufne i regulowane nadal zapewniają przydatny wspólny język. Problem zaczyna się wtedy, gdy zespoły zakładają, że ten język sam w sobie cokolwiek egzekwuje. Statyczna etykieta nie zamaskuje pola, nie skróci okresu retencji, nie zwiększy częstotliwości walidacji ani nie eskaluje alertu.
Luka między klasyfikacją a egzekwowaniem
Dane wskazują na mierzalną lukę operacyjną. 55% badanych organizacji nie wdrożyło automatycznej klasyfikacji we wszystkich głównych systemach, a tylko 47% miało klasyfikację, która egzekwowała mechanizmy kontroli na dalszych etapach, zamiast jedynie nadawać etykiety, wynika z raportu Kiteworks 2026 Data Security and Compliance Risk Report.
Te liczby rozdzielają dwa efekty, które zespoły często łączą. Trafność klasyfikacji odpowiada na pytanie, czy przypisana klasa jest poprawna. Skuteczność klasyfikacji odpowiada na pytanie, czy ta klasa zmienia zachowanie systemów, które przechowują, przetwarzają, monitorują i chronią dane.
Zespół może poprawnie uznać tabelę klientów za poufną, a jednocześnie pozostawić szeroki dostęp dla analityków. Może oznaczyć raport regulacyjny jako wymagający wysokiej integralności, a potem dopuścić niezweryfikowaną zmianę schematu, która modyfikuje jego dane wejściowe. Może sklasyfikować pipeline jako wymagający wysokiej dostępności, a monitorować jedynie, czy zadanie się zakończyło, a nie czy oczekiwane dane dotarły na czas.
Praktyczna zasada: Traktuj każdą klasę jako wyzwalacz decyzji o mechanizmie kontroli. Jeśli żaden mechanizm się nie zmienia, zastanów się, czy klasa ma wartość operacyjną.
Dlaczego dodawanie kategorii rzadko rozwiązuje problem
Słabe egzekwowanie często skłania zespoły do rozbudowy taksonomii. Dodają etykiety dla danych osobowych, finansowych, krytycznych, zastrzeżonych, zatwierdzonych do użycia w AI, archiwalnych oraz lokalnych wyjątków. Efekt wygląda precyzyjnie, ale właściciele i narzędzia mają jeszcze więcej wątpliwości, która etykieta jest nadrzędna i jakie działanie z niej wynika.
Mniejszy zestaw wiarygodnych klas powiązanych z jawnymi działaniami zwykle sprawdza się lepiej. Każda klasa powinna odpowiadać na praktyczne pytania:
Kto może uzyskać dostęp do zasobu? Zdefiniuj zasady dostępu i dopuszczalne wyjątki.
Co trzeba walidować? Określ kontrole na poziomie pól, rekordów, uzgodnień lub reguł biznesowych.
Jak szybko awarie muszą wychodzić na jaw? Ustal ważność alertów i oczekiwania co do reakcji.
Jak dokumentować zmiany? Zachowuj lineage, zdarzenia audytowe i informacje o właścicielach.
Co się dzieje, gdy zmienia się kontekst? Uruchamiaj przegląd, zamiast pozwalać, by stara etykieta obowiązywała w nieskończoność.
Klasa danych zyskuje wartość, gdy zautomatyzowany proces potrafi wykryć niezgodność między etykietą a bieżącym zachowaniem. Zmiana schematu, nieoczekiwany wzorzec dostaw, nowe zastosowanie na dalszych etapach lub zmienione znaczenie biznesowe mogą wymagać ponownej klasyfikacji.
Bez takiej pętli zwrotnej taksonomia się dezaktualizuje, a interesariusze nadal jej ufają. Governance produkuje wtedy katalog opisujący wczorajsze ryzyko, mimo że uprawnienia, pipeline'y i zastosowania biznesowe już się zmieniły. Klasyfikacja musi więc być powiązana z monitorowaniem i reagowaniem, w przeciwnym razie jej etykiety stają się obciążeniem, a nie zabezpieczeniem.
Trzy wymiary klas danych
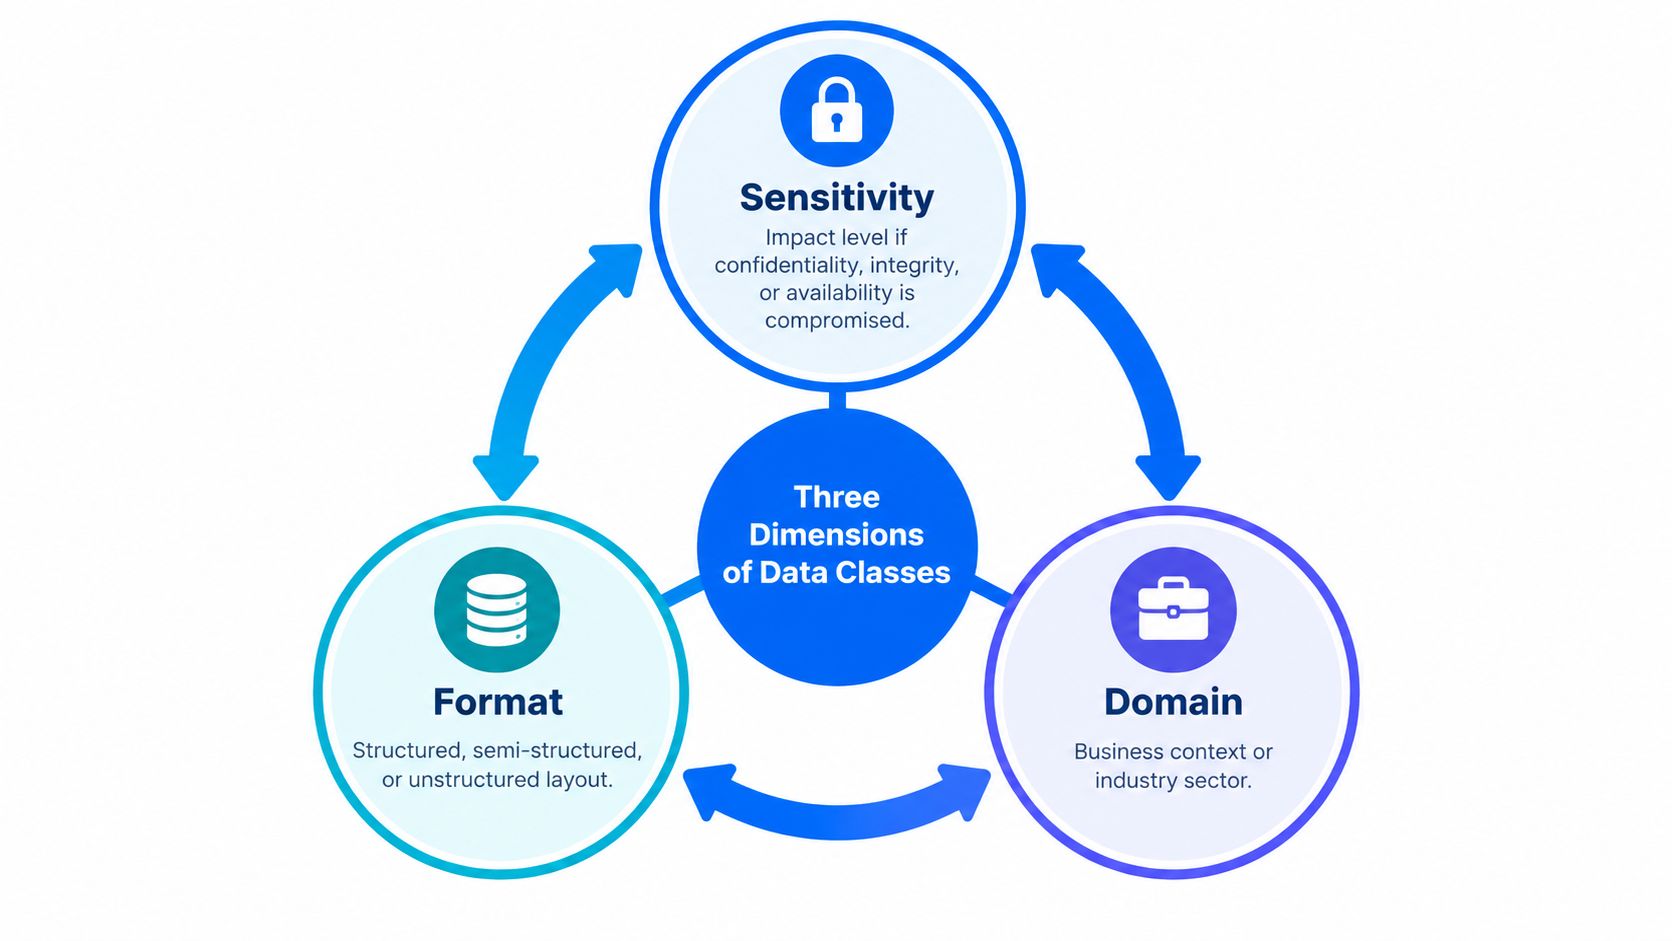
Wiarygodny system klasyfikacji potrzebuje czegoś więcej niż skali wrażliwości. Powinien oceniać łącznie wrażliwość, format i domenę, ponieważ każdy z tych wymiarów zmienia znaczenie pozostałych.
Wrażliwość opisuje skutki naruszenia. Format opisuje, jak zasób jest reprezentowany i co można przetestować. Domena dostarcza kontekstu biznesowego, informacji o właścicielach i oczekiwań regulacyjnych. Klasa zbioru danych powinna wynikać z interakcji tych wymiarów, a nie z jednej etykiety wybranej w oderwaniu od reszty.
Wrażliwość zmienia konsekwencje
Klasyfikacja bezpieczeństwa ocenia każdy typ informacji niezależnie pod kątem poufności, integralności i dostępności. Klasa może mieć niski poziom w jednym wymiarze i wysoki w innym. Publiczny strumień danych KPI może nie zawierać żadnych poufnych informacji, a mimo to błędne wartości mogą wpływać na decyzje regulacyjne lub operacyjne, co nadaje integralności wysoką wagę.
To rozróżnienie zapobiega częstemu błędowi, czyli traktowaniu „publicznego” jako synonimu „niskiego ryzyka”. Dane publiczne mogą nadal wymagać ścisłej kontroli zmian, uzgadniania, lineage lub monitorowania aktualności. Z kolei dane prywatne nie muszą wymagać identycznych mechanizmów kontroli we wszystkich wymiarach.
Format zmienia test
Tabela relacyjna pozwala na kontrole kolumn, typów danych, unikalności, relacji i reguł na poziomie rekordów. Strumień zdarzeń JSON wymaga uwagi poświęconej zagnieżdżonym ścieżkom, atrybutom opcjonalnym, wariantom payloadu i błędom parsera. Repozytorium dokumentów może wymagać kontroli statusu ekstrakcji, metadanych oraz potwierdzenia, że przechowywane pliki nadal nadają się do użytku.
Sposób reprezentacji decyduje o tym, które awarie są widoczne. Ogólny test brakujących wartości może przejść pomyślnie nawet wtedy, gdy zniknął zagnieżdżony atrybut JSON lub zadanie pobierania dokumentów zapisuje pliki bez możliwej do wyodrębnienia treści.
Domena zmienia decyzję
To samo pole może wymagać różnych mechanizmów kontroli w różnych kontekstach. Znacznik czasu w procesie medycznym może decydować o terminowości działań klinicznych. Ten sam typ pola w publicznym strumieniu raportowym może wspierać harmonogramy publikacji i rozliczalność. Zespoły z sektora finansowego, telekomunikacyjnego, ochrony zdrowia i publicznego przypisują różne konsekwencje opóźnieniom, modyfikacjom i niekompletnym rekordom.
Praktyczny model rejestruje więc właściciela biznesowego zasobu, przypadek użycia, krytyczność, format i wpływ w ujęciu CIA. Zespoły, które chcą dokładniej zrozumieć, jak wymiary jakości wpływają na te decyzje, mogą skorzystać z tego przewodnika, aby poznać wymiary jakości danych.
W efekcie klasa mówi inżynierom nie tylko, czym są dane, ale też jak należy je monitorować.
Zastosowanie triady CIA w klasyfikacji danych
Klasyfikacja zorientowana na bezpieczeństwo powinna oceniać każdy typ informacji niezależnie pod kątem poufności, integralności i dostępności, przypisując poziom wpływu na podstawie szkody wynikającej z utraty każdego z tych celów. Zasadę tę opisują wytyczne Organizacji Państw Amerykańskich dotyczące klasyfikacji danych w przedsiębiorstwach.
Praktycznym błędem jest sprowadzanie trzech wymiarów do jednego wskaźnika wrażliwości. Pojedynczy wynik ukrywa powód, dla którego zbiór danych jest ważny, i utrudnia dobór właściwego mechanizmu kontroli. Ten problem rozwiązuje zasada najwyższego poziomu (high-watermark): o ogólnym wymaganiu ochrony decyduje najbardziej krytyczny wymiar CIA.
Poufność wymaga kontroli ekspozycji
Dane poufne wyrządzają szkodę, gdy nieuprawnione osoby mogą je zobaczyć, skopiować lub wywnioskować. Rekordy klientów, informacje o zdrowiu, dane pracowników i materiały wrażliwe handlowo wymagają mechanizmów kontroli, takich jak ograniczony dostęp, maskowanie, szyfrowanie i monitorowanie ekspozycji.
Klasyfikacja powinna określać typ informacji i dozwolony sposób użycia, a nie tylko nazwę tabeli. Tabela o nazwie customer_summary może w jednym środowisku zawierać wartości zagregowane, a w innym rekordy bezpośrednio identyfikujące osoby. Mechanizm kontroli musi podążać za rzeczywistą treścią i kontekstem.
Integralność wymaga dowodów poprawności
Integralność dotyczy nieautoryzowanych lub błędnych modyfikacji. Dokumentacja finansowa, dane regulacyjne i metryki decyzyjne mogą być publicznie widoczne, a mimo to wymagać rygorystycznej ochrony przed niezauważonymi zmianami.
Prowadzi to do innego zestawu mechanizmów kontroli:
Walidacja rekordów: Sprawdzaj wartości pod kątem reguł biznesowych i dozwolonych relacji.
Uzgadnianie: Porównuj powiązane sumy lub wyniki w źródle i miejscu docelowym.
Lineage: Zachowuj ścieżkę od rekordów źródłowych do publikowanych metryk.
Wykrywanie manipulacji: Rejestruj zmiany i ujawniaj modyfikacje, których nie da się wyjaśnić.
Publiczny strumień danych może więc mieć wysoki wpływ w wymiarze integralności, a jednocześnie niski w wymiarze poufności. Klasa powinna przekazywać to rozróżnienie inżynierom danych i zespołom reagującym na incydenty.
Dostępność wymaga świadomości dostaw
Dostępność oznacza dostęp do danych w momencie, gdy użytkownicy i systemy ich potrzebują. Operacyjne zbiory danych, strumienie i zależności platformowe mogą zawieść przez opóźnione dostawy, brakujące ładowania lub przestoje, nawet jeśli ich treść pozostaje poprawna i chroniona.
Monitorowanie powinno więc śledzić aktualność, opóźnienia dostaw, oczekiwane wzorce dotarcia danych i brakujące ładowania. Zakończone zadanie pipeline'u nie dowodzi, że dotarły użyteczne dane. Mechanizm kontroli musi obserwować zdarzenie w danych, od którego faktycznie zależą odbiorcy na dalszych etapach.
Klasa oparta na CIA powinna przekładać się bezpośrednio na ważność alertów, częstotliwość walidacji, retencję i docelowe czasy reakcji na incydenty. Powinna też podlegać przeglądom. Zastosowania biznesowe się zmieniają, zależności się rozrastają, a schematy ewoluują. Klasyfikacja, która nie uwzględnia tych zmian, staje się nieaktualnym założeniem, a nie wiarygodnym sygnałem bezpieczeństwa.
Klasyfikacja według formatu danych
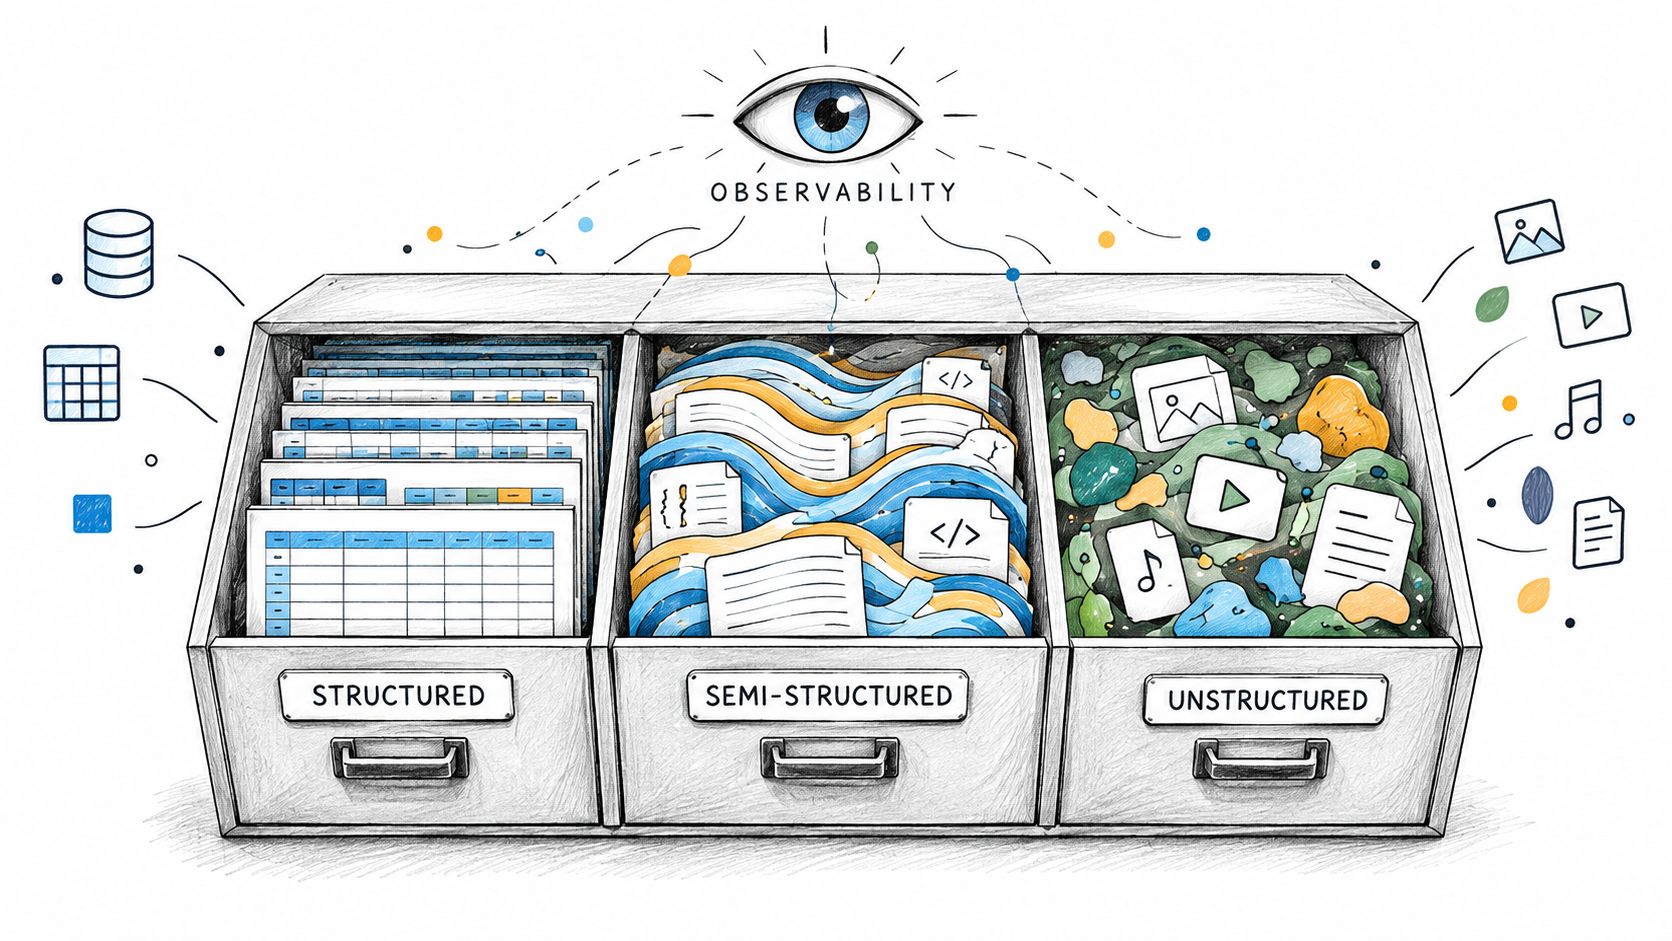
Pierwsze pytanie strukturalne nie dotyczy tego, czy zbiór danych jest wrażliwy. Dotyczy tego, jak dane są reprezentowane. Zasoby ustrukturyzowane, półustrukturyzowane i nieustrukturyzowane mają różne tryby awarii, więc wymagają różnych mechanizmów obserwowalności. Komisja Europejska wskazuje jakość, strukturę, interoperacyjność, autentyczność i integralność jako ważne warunki czerpania wartości z danych, zwłaszcza w kontekście AI, co podsumowuje jej dokument dotyczący data governance i polityk w zakresie danych.
Zasoby ustrukturyzowane
Tabele ustrukturyzowane opierają się na zdefiniowanym modelu. Dzięki temu nadają się do ukierunkowanych kontroli:
Zgodność ze schematem: Wykrywaj brakujące, dodane lub przemianowane kolumny.
Walidacja typów: Potwierdzaj, że wartości odpowiadają oczekiwaniom analitycznym.
Unikalność: Identyfikuj zduplikowane klucze lub nieoczekiwane powtórzenia.
Integralność referencyjna: Weryfikuj relacje między tabelami.
Reguły biznesowe: Sprawdzaj warunki na poziomie rekordów i dozwolone kombinacje.
Typ przechowywania to wciąż nie to samo co znaczenie analityczne. Pole liczbowe może kodować kategorię, na przykład kod statusu, zamiast reprezentować mierzalną wielkość. Dane statystyczne dzieli się zwykle na klasy kategoryczne i ilościowe, a to rozróżnienie decyduje, czy zespoły powinny stosować zliczanie częstości i wykrywanie nieoczekiwanych wartości, czy rozkłady, średnie, percentyle, wariancję i analizę wartości odstających. Tę różnicę dokumentuje słownik terminów statystycznych OECD.
Dane półustrukturyzowane
Zdarzenia JSON i podobne payloady mogą mieć rozpoznawalny kształt bez konsekwentnie egzekwowanego schematu. Monitorowanie powinno sprawdzać obecność zagnieżdżonych pól, warianty struktur, błędy parsera, zmiany w tablicach i dryf semantyczny.
Kontrola odsetka wartości null może przeoczyć awarię, w której producent danych przenosi wartość pod inną ścieżkę lub zmienia jej znaczenie, pozostawiając pole wypełnione. Zespoły pracujące z kolumnowym przechowywaniem danych powinny też rozumieć format plików Parquet, w tym to, jak jego struktura wpływa na walidację i śledzenie schematów na dalszych etapach.
Nieustrukturyzowane dokumenty i multimedia
Dokumenty, obrazy i inne multimedia wymagają innego modelu kontroli. Udane przesłanie pliku nie dowodzi, że ekstrakcja zadziałała, metadane są kompletne, a dalsze przetwarzanie potrafi zinterpretować treść.
Śledź status pobierania, kompletność ekstrakcji, poprawność metadanych i wyniki przetwarzania treści. Sklasyfikowanie zasobu jako nieustrukturyzowanego powinno automatycznie wybierać te kontrole, zamiast stosować założenia właściwe dla danych relacyjnych.
Najskuteczniejsze katalogi rejestrują sposób reprezentacji, rygor schematu, właścicieli, oczekiwany sposób odświeżania i krytyczność dla dalszych etapów. Format nie jest opisowym przypisem. Decyduje o tym, które sygnały mogą dowieść, że zasób nadal nadaje się do użytku.
Powiązanie klasyfikacji z wykonywalnymi mechanizmami kontroli
Gdy klasy są już przypisane, pytanie brzmi: co każda z nich każe zrobić systemowi? Tabela przypisuje czterem typowym klasom główny mechanizm kontroli oraz dowody potwierdzające, że ten mechanizm zadziałał.
Porównaj opcje operacyjne
Klasa danych | Główny mechanizm kontroli | Metryka monitorowania |
|---|---|---|
Poufne dane klientów | Ograniczenie dostępu, maskowanie i przegląd ekspozycji | Nieautoryzowany dostęp, status maskowania i ekspozycja pól wrażliwych |
Dane finansowe wymagające wysokiej integralności | Walidacja rekordów, uzgadnianie, lineage i wykrywanie manipulacji | Naruszenia reguł, różnice w uzgodnieniach i zmiany strukturalne |
Dane operacyjne wymagające wysokiej dostępności | Wykrywanie problemów z aktualnością, dostawami i przestojami | Czas dotarcia, brakujące ładowania, opóźnienia i dostępność |
Publiczne, ale krytyczne dla decyzji metryki | Governance publikacji i walidacja integralności | Dryf wartości, uzgodnienie ze źródłem i niewyjaśnione zmiany |
Każdy wiersz łączy etykietę z reakcją operacyjną. Właściciele nie muszą interpretować pojęcia „krytyczny” różnie w różnych systemach. Mogą wskazać wymagany mechanizm kontroli, przypisać odpowiedzialność i sprawdzić dowody powstające, gdy mechanizm zadziała lub zawiedzie.
Klasa ma wartość tylko wtedy, gdy jej polityka dociera do systemów, które ją egzekwują. Metadane katalogu mogą sterować ograniczeniami dostępu, maskowaniem, retencją, monitorowaniem, kierowaniem incydentów lub przeglądem publikacji. Jeśli te miejsca docelowe nie są połączone, etykieta pozostaje opisowa i może dawać fałszywe poczucie bezpieczeństwa.
Odwzoruj klasy w całym środowisku
Zacznij od zasobów o dużym wpływie, a nie od każdego obiektu w organizacji. Przypisz wielowymiarową klasę, wskaż właściciela, określ, gdzie mechanizm kontroli ma działać, i sprawdź, czy klasyfikacja trafia do każdego właściwego systemu. Upewnij się, że każdy system rejestruje dowody, takie jak wynik walidacji, zdarzenie dostępu, wynik uzgodnienia lub alert, gdy mechanizm kontroli zostaje uruchomiony.
Wytyczne dotyczące reguł walidacji danych i ciągłej jakości danych pomagają przełożyć klasy na kontrole na poziomie rekordów, reguły biznesowe i cykliczne mechanizmy kontroli jakości. Praktyczny wybór polega na definiowaniu kontroli odpowiadających ryzyku, a nie na przypisywaniu ogólnego wskaźnika jakości każdemu zasobowi.
Odpowiedzialność właściciela musi obejmować ponowną klasyfikację. Zbiór danych może zyskać nowego odbiorcę, zmienić schemat, przejść do innej domeny lub trafić do procesu podlegającego regulacjom. Każde takie zdarzenie powinno uruchamiać przegląd klasy i aktualizację polityk na dalszych etapach.
Regularnie testuj cały łańcuch. Klasyfikacja, która aktualizuje katalog, ale nie zmienia monitorowania, dostępu ani działania procesów, nie jest governance. Jest niezweryfikowaną intencją.
Osadzanie obserwowalności w infrastrukturze
Klasyfikację można egzekwować, gdy monitorowanie działa blisko danych i może korzystać z tego samego kontekstu, który zdefiniował klasę. Przenoszenie rekordów produkcyjnych do zewnętrznej usługi analitycznej może tworzyć niepotrzebną ekspozycję, komplikować wymogi rezydencji danych i oddzielać decyzje governance od dowodów operacyjnych.
Architektura osadzona utrzymuje analizę w infrastrukturze kontrolowanej przez klienta. Ma to znaczenie dla organizacji z rygorystycznymi wymaganiami dotyczącymi bezpieczeństwa, zgodności lub rezydencji danych, w tym dla zespołów działających on-premises lub w chmurze prywatnej.

Utrzymuj kontrole blisko źródła
Wykonywanie w bazie danych pozwala zespołom obliczać metryki i prowadzić walidację bez wyodrębniania danych produkcyjnych do osobnego środowiska hostowanego przez dostawcę. Ułatwia też powiązanie klasy z sygnałami, które mają znaczenie:
Zachowanie schematu: Wykrywaj dodane, usunięte lub zmienione pola.
Zachowanie rekordów: Stosuj kontrole reguł biznesowych do poszczególnych rekordów.
Terminowość: Identyfikuj opóźnienia, brakujące ładowania i nieoczekiwane wzorce dotarcia danych.
Metryki biznesowe: Monitoruj zachowanie krytycznych miar.
Kondycja platformy: Obserwuj obciążenie, dostępność i zmiany operacyjne.
Taką rolę architektoniczną pełni platforma obserwowalności danych digna, zaprojektowana do działania we własnym środowisku organizacji. Dokumentacja digna opisuje opartą na AI platformę jakości i obserwowalności danych, która obsługuje wdrożenia on-premises i w chmurze prywatnej, utrzymuje monitorowanie w infrastrukturze kontrolowanej przez klienta i ogranicza potrzebę wyodrębniania danych produkcyjnych do zewnętrznej usługi.
Korzystaj z wyuczonych zachowań tam, gdzie progi zawodzą
Ręcznie ustawiane progi przydają się przy twardych limitach biznesowych, ale stają się trudne w utrzymaniu, gdy każdy zbiór danych ma inną zmienność, sezonowość, harmonogram dostaw czy zachowanie operacyjne. Punkt odniesienia oparty na AI może nauczyć się normalnego zachowania każdego zbioru danych i wykrywać nieoczekiwane zmiany bez konieczności konfigurowania progu dla każdej metryki.
Analiza historyczna dostarcza brakującego kontekstu. Inżynierowie mogą badać trendy, zmienność i wzorce statystyczne, aby odróżnić jednorazowe odchylenie od narastającego problemu. To rozróżnienie wspiera lepszy triage incydentów i sprawia, że zespoły nie traktują każdego alertu jako odizolowanej awarii.
Ważnym wyborem projektowym nie jest „AI kontra reguły”. Wiarygodne governance wykorzystuje deterministyczną walidację dla jawnych wymagań i wykrywanie zachowań dla wzorców, które trudno zakodować ręcznie. Klasa decyduje, jakie połączenie jest właściwe, a infrastruktura decyduje, czy dowody pozostaną bezpieczne, aktualne i użyteczne.
Budowa operacyjnego modelu klasyfikacji
Praktyczny model zaczyna się od ograniczonego spisu krytycznych zasobów. Wybierz zbiory danych, które wspierają ważne raportowanie, obowiązki regulacyjne, obsługę klientów, procesy kliniczne, usługi telekomunikacyjne lub decyzje w sektorze publicznym. Nie zaczynaj od próby sklasyfikowania każdego pliku i każdej tabeli z jednakową dokładnością.
Każdemu wybranemu zasobowi przypisz wielowymiarowy opis:
Opisz wrażliwość: Zapisz osobno wpływ w zakresie poufności, integralności i dostępności.
Opisz format: Określ, czy reprezentacja jest ustrukturyzowana, półustrukturyzowana czy nieustrukturyzowana, oraz jak zachowuje się schemat.
Opisz domenę: Uwzględnij właściciela biznesowego, cel, kontekst regulacyjny i zależności na dalszych etapach.
Przypisz mechanizmy kontroli: Powiąż klasę z wymaganiami dotyczącymi dostępu, walidacji, aktualności, schematu, retencji i reagowania.
Zweryfikuj wykonanie: Potwierdź, że systemy monitorowania i polityk zastosowały oczekiwane mechanizmy kontroli.
Przeglądaj zmiany: Oceniaj klasę ponownie, gdy zmienia się zachowanie, schemat, właściciel lub zastosowanie biznesowe.
Opis klasyfikacji powinien być przydatny zarówno dla zespołów governance, jak i inżynierskich. Właściciel bezpieczeństwa musi znać skutki ekspozycji. Inżynier danych musi wiedzieć, które testy mają być uruchamiane. Zespół reagujący na incydenty musi wiedzieć, jak szybko problem powinien zostać eskalowany i jakie dowody należy zebrać.
Klasa jest aktualna tylko wtedy, gdy jej mechanizmy kontroli nadal odpowiadają temu, jak ludzie korzystają z danych.
Ten model operacyjny wspiera też decyzje dotyczące suwerenności danych. Zespoły oceniające wymagania w zakresie rezydencji i governance mogą uznać za przydatny artykuł o spełnianiu wymogów regulacyjnych dotyczących danych ze Stoa, gdy analizują, jak obowiązki prawne, lokalizacja infrastruktury i praktyki obsługi danych wpływają na siebie nawzajem.
Weryfikuj klasyfikację na podstawie obserwowanego zachowania, zamiast polegać na corocznej dokumentacji. Zbiór danych może pozostać poufny, a jego wymagania dotyczące integralności mogą wzrosnąć, gdy stanie się źródłem danych regulacyjnych. Tabela ustrukturyzowana może zacząć otrzymywać dane półustrukturyzowane przez nową ścieżkę pobierania. Strumień o niskich wymaganiach dostępności może stać się krytyczny operacyjnie, gdy zacznie od niego zależeć proces biznesowy.
Wytyczne digna dotyczące wdrażania data governance mogą pomóc zespołom połączyć odpowiedzialność właścicieli, mechanizmy kontroli jakości, monitorowanie i procesy governance. Celem nie jest jak największa taksonomia. Celem jest zestaw klas, który konsekwentnie zmienia to, co systemy mierzą, chronią, przechowują i eskalują.
digna pomaga zespołom zamienić klasę danych w wykonywalne mechanizmy kontroli dzięki walidacji w bazie danych, śledzeniu schematów, monitorowaniu terminowości, monitorowaniu biznesowemu i wykrywaniu anomalii opartemu na AI, w środowiskach chmury prywatnej lub on-premises. Odwiedź digna i zobacz, jak Twój zespół może monitorować krytyczne dane bez przenoszenia rekordów produkcyjnych do zewnętrznej usługi.
Klasyfikacja decyduje też o tym, gdzie dane mogą być przechowywane i przetwarzane. Nasz przewodnik po wymogach dotyczących rezydencji danych wyjaśnia, jak zasady lokalizacji łączą się z przypisanymi klasami i mechanizmami kontroli, które one uruchamiają.
Najczęściej zadawane pytania
Czym jest klasa danych?
Klasa danych to kategoria, do której należy zasób, określana na podstawie jego wrażliwości, formatu i domeny biznesowej. Użyteczna klasa robi więcej niż opisuje dane: decyduje, które mechanizmy kontroli dostępu, walidacji, retencji i monitorowania mają zastosowanie, więc etykieta, która niczego nie zmienia na dalszych etapach, jest dokumentacją, a nie governance.
Jakie są trzy wymiary klasyfikacji danych?
Wrażliwość, format i domena. Wrażliwość opisuje skutki naruszenia danych, format opisuje sposób ich reprezentacji, a tym samym to, co można przetestować, a domena dostarcza kontekstu biznesowego, informacji o właścicielach i oczekiwań regulacyjnych. Łączna ocena wszystkich trzech daje bardziej wiarygodną klasę niż pojedyncza skala wrażliwości.
Jak triada CIA odnosi się do klasyfikacji danych?
Każdy typ informacji ocenia się osobno pod kątem poufności, integralności i dostępności, na podstawie szkody wynikającej z utraty każdej z nich. Publiczny strumień danych KPI może nie wymagać żadnych kontroli poufności, a mimo to potrzebować silnych kontroli integralności, ponieważ błędne wartości mogą wpływać na decyzje regulacyjne lub operacyjne. Sprowadzenie trzech wymiarów do jednego wskaźnika to ukrywa.
Dlaczego programy klasyfikacji danych zawodzą?
Większość zawodzi po cichu, ponieważ etykiety nigdy nie zmieniają mechanizmów kontroli. Właściciele oznaczają zbiory danych, audytorzy dostają eksport z katalogu, ale uprawnienia i monitorowanie pozostają bez zmian. Według przywołanego raportu z 2026 roku tylko 47% organizacji miało klasyfikację egzekwującą mechanizmy kontroli na dalszych etapach, a dodawanie kolejnych kategorii zwykle zwiększa niejednoznaczność, zamiast naprawiać egzekwowanie.
Czym powinno różnić się monitorowanie danych ustrukturyzowanych i nieustrukturyzowanych?
Tabele ustrukturyzowane nadają się do kontroli schematu, typów, unikalności, integralności referencyjnej i reguł biznesowych. Półustrukturyzowane dane JSON wymagają monitorowania zagnieżdżonych ścieżek, wariantów i błędów parsera, ponieważ wartości mogą się przemieszczać, nie stając się null. Nieustrukturyzowane dokumenty i multimedia wymagają kontroli pobierania, kompletności ekstrakcji i metadanych, ponieważ udane przesłanie pliku nie dowodzi, że treść nadaje się do użytku.


