Proces monitorowania KPI: kompletny przewodnik krok po kroku
|
6
min. czyt.

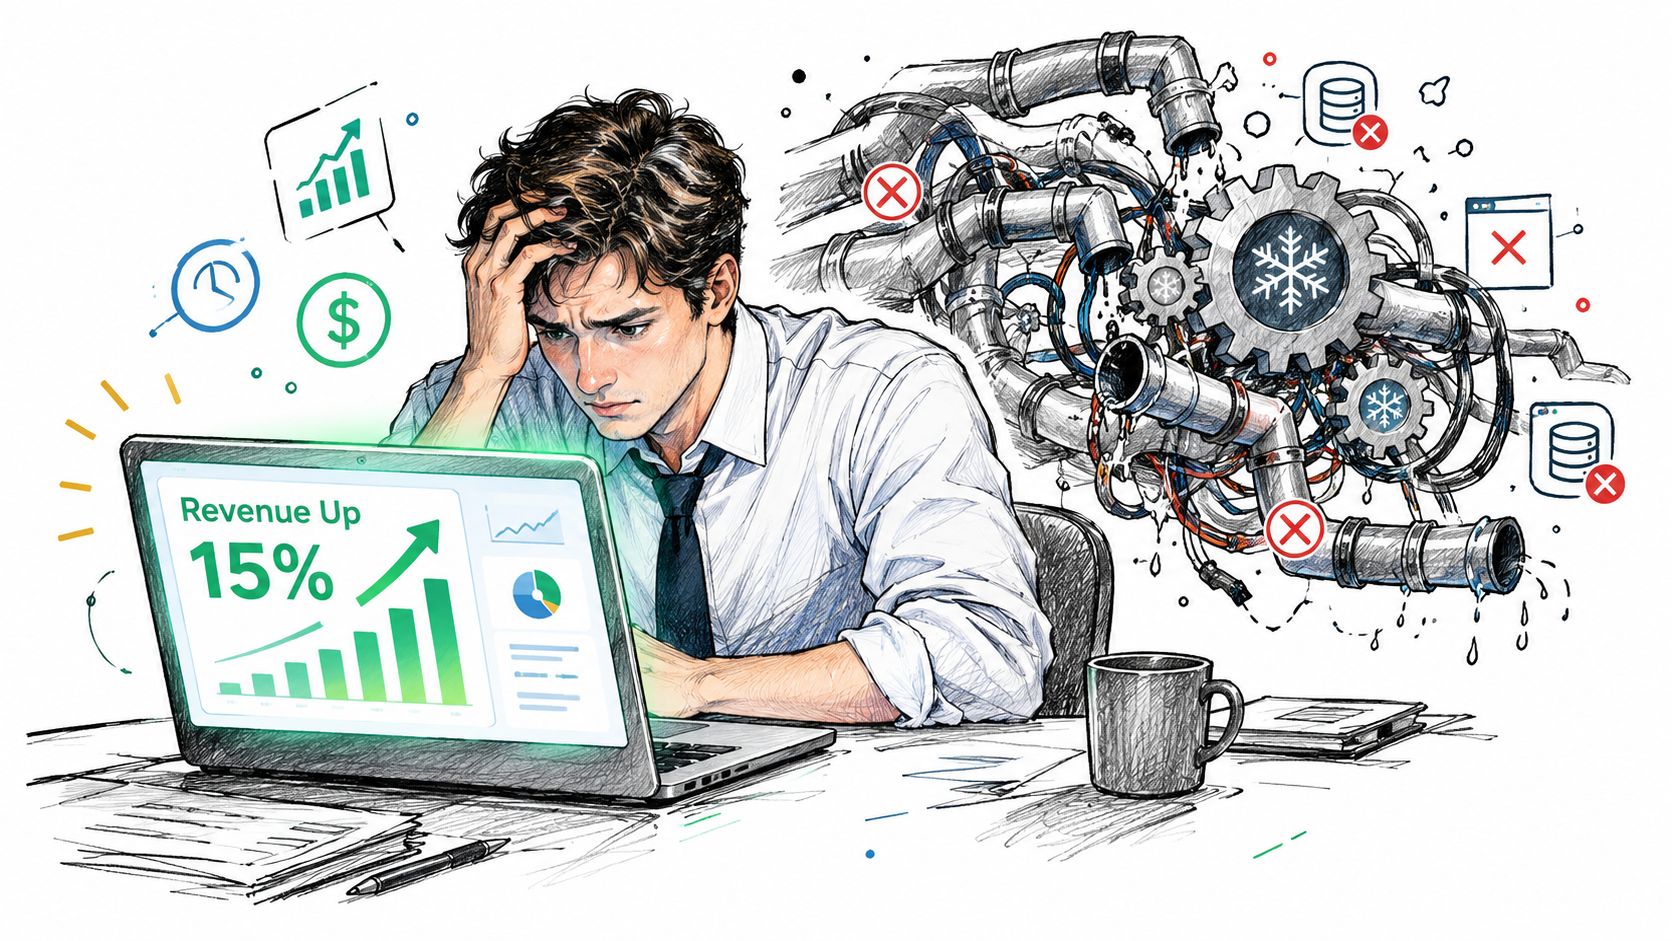
Jest 9 rano. Dzwoni interesariusz, bo dashboard przychodów pokazuje wzrost o 15%. Zespół przez chwilę świętuje, aż ktoś sprawdza strumień transakcji i odkrywa, że pipeline załadował dane z opóźnieniem i pominął ostatnie dwa dni. KPI nie pokazał lepszych wyników. Odzwierciedlał niekompletne dane.
Dlatego niezawodny proces monitorowania KPI musi obejmować coś więcej niż wartości metryk. Musi ustalić, czy dane są aktualne, kompletne, poprawne strukturalnie i nadają się do interpretacji. Dashboard może być dopracowany wizualnie, a mimo to dawać decydentom fałszywe poczucie pewności.
Spis treści
Dlaczego Twój dashboard KPI wprowadza Cię w błąd
Sześć etapów procesu monitorowania KPI
Zdefiniuj decyzję i właściciela
Ustal reprezentatywny punkt odniesienia
Zweryfikuj lineage przed interpretacją zmian
Obliczaj w autorytatywnym źródle
Wykrywaj przekroczenia limitów i nietypowe zachowania
Kieruj, rozwiązuj i ulepszaj alerty
Oddzielanie wyników biznesowych od przydatności danych
Stosuj dwie ścieżki alertów
Zadbaj o audytowalność wyniku
Tradycyjne reguły a wykrywanie anomalii oparte na AI
Gdzie sprawdzają się reguły deterministyczne
Gdzie pomaga wykrywanie adaptacyjne
Role, obowiązki i praktyki operacyjne
Jasno przypisz obowiązki
Dopasuj częstotliwość do możliwości działania
Typowe błędy i jak ich unikać
Typowe wzorce porażek
Budowanie strategii monitorowania KPI z digna
Dlaczego Twój dashboard KPI wprowadza Cię w błąd
Problem zwykle zaczyna się od rozsądnego projektu. Analytics engineer definiuje przychód, łączy obliczenia z tabelą w hurtowni, dodaje linię celu i publikuje wynik w Power BI lub innej platformie BI. Z perspektywy narzędzia raportowego odświeżenie dashboardu kończy się sukcesem, ale ładowanie transakcji w źródle dotarło z opóźnieniem albo zawierało tylko część oczekiwanych danych.
Interesariusz widzi wzrost. Inżynier danych widzi incydent w dostawie danych. Obaj patrzą na ten sam KPI, ale tylko jeden ma kontekst potrzebny do jego interpretacji.
Praktyczna zasada: Nigdy nie traktuj wartości KPI jako wiarygodnej, dopóki obok niej nie widać jej aktualności, kompletności, lineage i statusu walidacji.
Tradycyjne monitorowanie często obserwuje wyłącznie końcową liczbę. Próg może wywołać alert, gdy przychód spadnie poniżej stałego celu, ale niekoniecznie zasygnalizuje opóźnione ładowanie, brakującą partycję, zmieniony typ kolumny czy częściowy eksport. Zespoły otrzymują wtedy alerty, które nie wyjaśniają, czy zmienił się biznes, czy zawiódł pomiar.
To rozróżnienie wpływa na każdą reakcję operacyjną. Rzeczywisty spadek może wymagać analizy handlowej. Spóźniony zbiór danych wymaga naprawy pipeline'u. Zmiana schematu może wymagać aktualizacji transformacji. Jeśli proces monitorowania wysyła ten sam alert we wszystkich trzech przypadkach, odpowiedzialność się rozmywa, a zespoły tracą czas na diagnozowanie niewłaściwego problemu.
Dashboardy wciąż mają znaczenie, zwłaszcza gdy zespoły muszą tworzyć wizualizacje Power BI, które prowadzą do działania. Wizualizacja jest jednak ostatnią warstwą, a nie samym systemem monitorowania. Proces bazowy musi łączyć wyświetlany KPI z warunkami danych, z których powstał.
Praktyczny dashboard do monitorowania KPI powinien więc pokazywać zarówno sygnał biznesowy, jak i dowody potwierdzające jego wiarygodność. Oznacza to rejestrowanie oczekiwanych i faktycznych czasów dostawy, liczby wierszy, wyników walidacji, wersji schematu i statusu obliczeń. Bez tych mechanizmów kontroli zielony dashboard oznacza jedynie, że dashboard poprawnie się wyrenderował.
Sześć etapów procesu monitorowania KPI
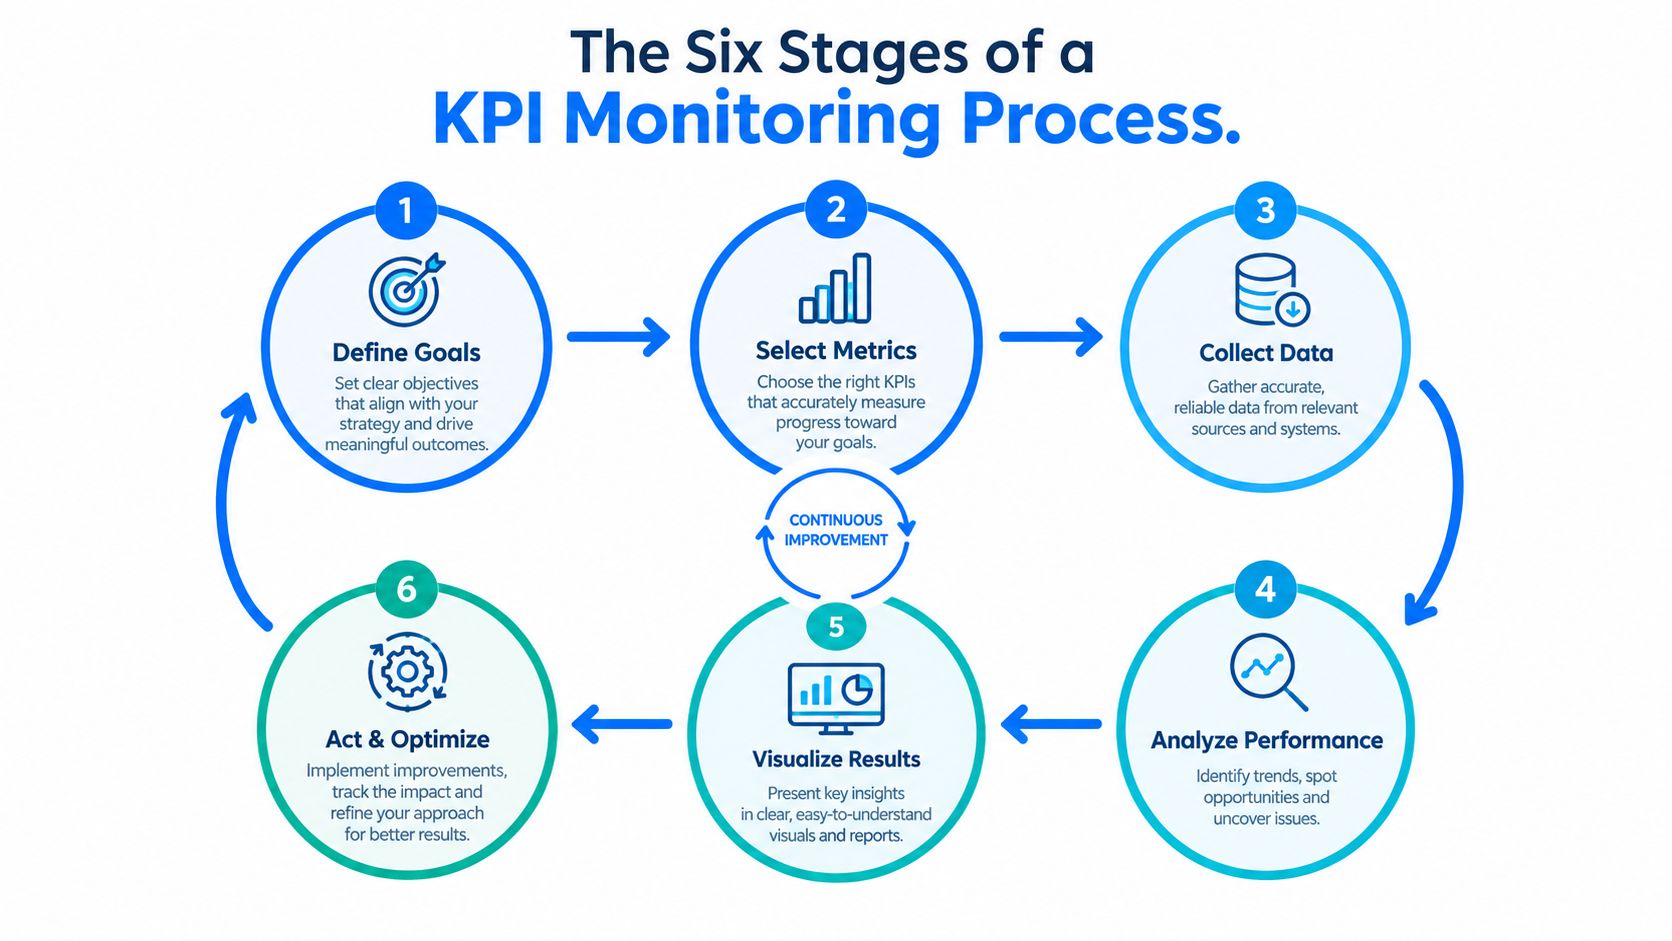
Proces, którego można bronić, jest zamkniętą pętlą. Szczegółowy model operacyjny obejmuje osiem odrębnych etapów, od zdefiniowania decyzji i właściciela po przegląd progów pod kątem fałszywych alarmów i zmieniających się warunków, co opisuje NIST AI Risk Management Framework Playbook. W praktyce te działania można ująć w sześć etapów wdrożeniowych, które zespoły są w stanie realizować na co dzień.
Zdefiniuj decyzję i właściciela
Zacznij od decyzji, a nie od wykresu. Zapisz, na jakie działanie KPI ma wpływać, kto odpowiada za wynik i kto analizuje odchylenia. Zdefiniuj licznik, mianownik, poziom szczegółowości obliczeń, filtry, oczekiwaną aktualność, dopuszczalny zakres operacyjny i ścieżkę eskalacji.
Zespół usług finansowych może przypisać KPI wolumenu rozliczeń właścicielowi operacyjnemu, a organizacja z sektora ochrony zdrowia może przypisać KPI kompletności roszczeń właścicielowi z obszaru data governance. W obu przypadkach właściciel potrzebuje wystarczającej wiedzy semantycznej, aby ocenić, czy zmiana jest istotna.
Ustal reprezentatywny punkt odniesienia
Cel to nie to samo co punkt odniesienia. Zbuduj obraz historycznego zachowania na podstawie reprezentatywnych okresów i oddziel normalną sezonowość, efekty kalendarzowe, promocje, planowane prace serwisowe i znane przestoje od rzeczywistych zmian. Stały limit może się przydać jako twarda granica zgodności, ale nie opisze normalnej zmienności.
Zweryfikuj lineage przed interpretacją zmian
Sprawdź, czy tabele źródłowe, transformacje, złączenia, filtry i zadania dostarczające dane działają zgodnie z oczekiwaniami. KPI powinien mieć lineage prowadzący do autorytatywnego źródła, a także wyniki walidacji i status przydatności danych. Jeśli źródło jest niekompletne, oznacz lub ukryj wynik biznesowy, zamiast prezentować go jako aktualny.
Obliczaj w autorytatywnym źródle
Obliczenia w bazie danych ograniczają zbędne przenoszenie danych i utrzymują logikę blisko danych objętych governance. Ułatwiają też audyt, ponieważ zespół może powiązać wynik ze znacznikiem czasu źródła, wersją zapytania, stanem schematu i wynikiem walidacji.
Wykrywaj przekroczenia limitów i nietypowe zachowania
Stosuj kontrole deterministyczne dla zdefiniowanych granic i naruszeń integralności. Dodaj monitorowanie statystyczne dla nietypowych poziomów, zmian tempa, zmienności i zmian rozkładu. Takie połączenie wychwytuje zarówno znane naruszenia, jak i zachowania niepasujące do historycznego punktu odniesienia.
Kieruj, rozwiązuj i ulepszaj alerty
Wysyłaj alerty według ważności do odpowiedzialnego właściciela. Utrzymujące się odchylenie o niskiej ważności może utworzyć zgłoszenie, a poważne naruszenie integralności może wymagać natychmiastowego powiadomienia dyżurnego. Każdy alert powinien zawierać runbook, okno wyciszenia, ścieżkę eskalacji, diagnozę, sposób naprawy i wpływ na biznes.
Proces staje się niezawodny dopiero wtedy, gdy zespoły regularnie oceniają jego skuteczność. Śledź fałszywe alarmy, przeoczone incydenty, czas wykrycia, czas potwierdzenia i czas naprawy, a następnie kalibruj progi, gdy zmieniają się warunki operacyjne.
Oddzielanie wyników biznesowych od przydatności danych
Alert dotyczący wyników biznesowych odpowiada na pytanie: „Czy biznes zachował się inaczej?”. Alert dotyczący przydatności danych odpowiada na pytanie: „Czy możemy ufać pomiarowi?”. Te pytania są powiązane, ale nie powinny mieć wspólnego statusu ani wspólnej reakcji.
Poważną luką w poradnikach dotyczących monitorowania KPI jest to, że wyjaśniają one dobór metryk, ale nie określają, jak postępować, gdy dane źródłowe są spóźnione, niekompletne lub zmieniły strukturę. Typowe rady często dopasowują częstotliwość monitorowania do możliwości działania, ale rzadko definiują, co się dzieje, gdy zaplanowane odświeżenie nie zmieści się w oknie dostawy albo gdy kolumna zostanie dodana, usunięta lub zmieni typ, jak opisano w tym przewodniku po projektowaniu KPI.
Stosuj dwie ścieżki alertów
Załóżmy, że KPI w firmie telekomunikacyjnej pokazuje nagły spadek aktywności klientów. Istnieją co najmniej dwa wiarygodne wyjaśnienia:
Sygnał biznesowy: Zmieniło się zachowanie klientów, więc sprawę powinien zbadać zespół handlowy lub operacyjny.
Sygnał dostawy: Brakuje najnowszej partycji zdarzeń, więc zespół platformy danych powinien naprawić ładowanie.
Sygnał strukturalny: Kolumna źródłowa zmieniła typ lub zniknęła, więc właściciele transformacji i governance powinni ocenić skutki.
Pojedynczy czerwony kafelek nie odróżni tych przypadków. System powinien dołączać do obliczenia KPI status aktualności, kompletności, schematu i walidacji. Jeśli dane dotarły z opóźnieniem, wynik można oznaczyć jako objęty problemem, a alert biznesowy wyciszyć do czasu, aż źródło wróci do prawidłowego stanu.
Zadbaj o audytowalność wyniku
Każde uruchomienie obliczeń KPI powinno zachowywać znacznik czasu danych, oczekiwany i faktyczny czas dostawy, liczbę wierszy, wersję schematu, status obliczeń, wersję progu i identyfikator incydentu. Dzięki tym polom analityk może wyjaśnić, dlaczego wartość się zmieniła, bez odtwarzania całej historii pipeline'u w trakcie incydentu.
To rozróżnienie jest szczególnie ważne w ochronie zdrowia i sektorze publicznym, gdzie pozornie aktualny raport może wpływać na decyzje operacyjne lub regulacyjne. Wynik oparty na częściowych danych nie powinien wyglądać identycznie jak wynik uzyskany z kompletnego, zwalidowanego ładowania.
Podejście digna do obserwowalności jakości danych odzwierciedla ten model operacyjny, łącząc metryki biznesowe z kontrolami terminowości, walidacji, anomalii i zmian schematu wewnątrz środowiska danych klienta. Praktyczną korzyścią nie jest kolejny dashboard. Jest nią jaśniejsza odpowiedź na pierwsze pytanie, które powinien zadać zespół reagujący na incydent: czy zmiana KPI jest rzeczywista, czy pomiar przestał być wiarygodny?
Tradycyjne reguły a wykrywanie anomalii oparte na AI
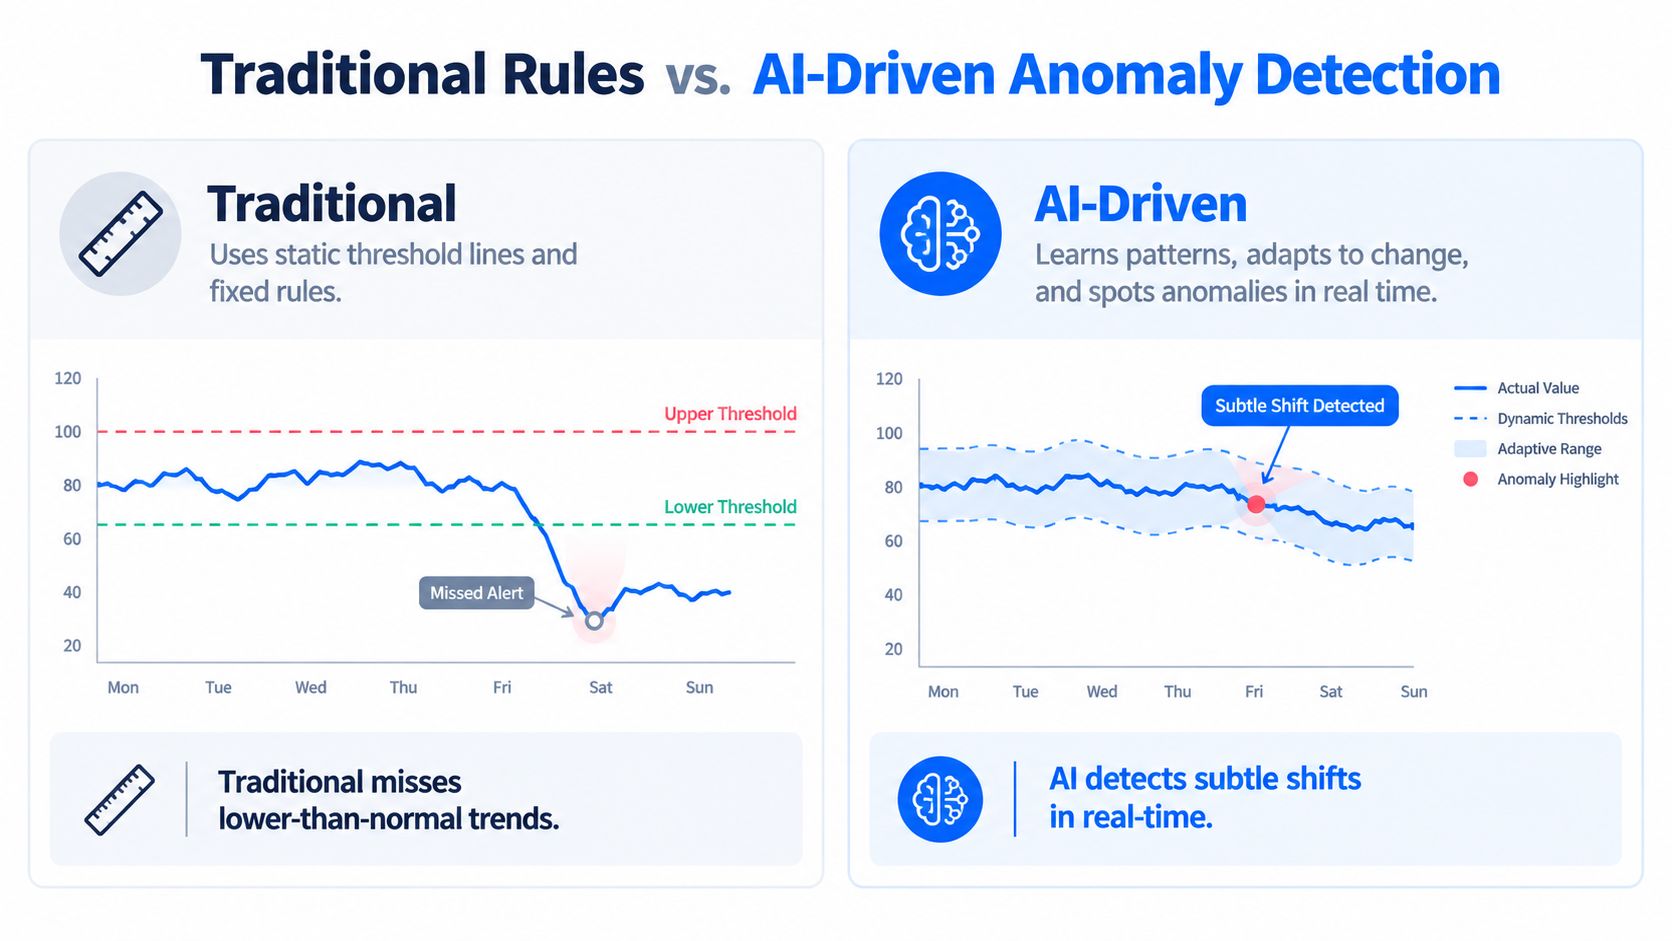
Stały próg może chronić wyraźną granicę biznesową, na przykład generując alert, gdy liczba transakcji spadnie poniżej zatwierdzonego limitu. Nie opisze jednak każdego normalnego stanu operacyjnego. Weekendy, sezonowy popyt, okresy niskiego ruchu, stopniowy dryf i zmieniająca się zmienność mogą sprawić, że ten sam próg zacznie wprowadzać w błąd.
Prowadzi to do dwóch rodzajów porażek operacyjnych. Czuły próg generuje szum, a szeroki próg przeocza istotny spadek. Zespoły zaczynają optymalizować liczbę alertów zamiast jakości decyzji. Ten problem omawia przewodnik dotyczący monitorowania złotych sygnałów SRE.
Gdzie sprawdzają się reguły deterministyczne
Kontrole deterministyczne pasują do warunków, które są jawne i testowalne:
Kontrole wartości null: Pola wymagane muszą zawierać wartości.
Kontrole unikalności: Identyfikatory nie powinny się powtarzać w ramach zdefiniowanego poziomu szczegółowości.
Kontrole integralności referencyjnej: Rekordy podrzędne muszą odpowiadać prawidłowym rekordom nadrzędnym.
Kontrole schematu: Wymagane kolumny i typy danych muszą pozostać zgodne.
Kontrole aktualności: Oczekiwane dane muszą dotrzeć w zdefiniowanym oknie dostawy.
Kontrole limitów: Nie wolno przekroczyć granicy regulacyjnej ani operacyjnej.
Te kontrole są przejrzyste, zrozumiałe i łatwo powiązać je z runbookiem. Zastąpienie ich wykrywaniem anomalii osłabiłoby kontrolę tam, gdzie oczekiwany warunek jest już znany.
Gdzie pomaga wykrywanie adaptacyjne
Monitorowanie statystyczne porównuje bieżące zachowanie z historią danego zbioru danych. Przegląd rodzajów wykrywania anomalii opisuje, jak takie podejście pozwala zidentyfikować nieoczekiwany poziom, tempo zmian, wzorzec zmienności lub przesunięcie rozkładu, bez konieczności ręcznego kodowania przez inżynierów każdego normalnego stanu. Przydaje się, gdy metryka zmienia się w okresach niskiego ruchu albo dryfuje, zanim przekroczy stały limit.
Moduł Data Anomalies w digna wykorzystuje oparte na AI uczenie się punktu odniesienia i ciągłe wykrywanie anomalii bez ręcznego konfigurowania reguł. Dzięki wykonywaniu w bazie danych obliczenia pozostają w środowisku klienta, co ogranicza przenoszenie danych i wyklucza dostęp dostawcy do danych produkcyjnych. Taka architektura pomaga też powiązać alert dotyczący metryki biznesowej z leżącym u jego podstaw problemem przydatności danych, zamiast traktować KPI jako odizolowany sygnał.
Stosuj model hybrydowy. Reguły deterministyczne powinny egzekwować znane kontrakty i warunki zgodności, a monitorowanie adaptacyjne powinno obejmować zachowania, których nie da się opisać jednym progiem. Kieruj oba typy alertów do tego samego procesu obsługi incydentów, ale zachowuj metodę wykrycia, dowody i KPI, którego dotyczy problem, aby zespół reagujący mógł odróżnić rzeczywistą zmianę w biznesie od problemu z pomiarem.
Role, obowiązki i praktyki operacyjne
Proces monitorowania KPI zawodzi, gdy odpowiedzialność kończy się na dashboardzie. Inżynierowie danych utrzymują dostawy i obliczenia, analytics engineers dbają o poprawność semantyczną, zespoły governance definiują oczekiwania jakościowe, a właściciele biznesowi decydują, jakiego działania wymaga zmiana.
NIST zaleca dobór metryk, które dają istotne wskazania stanu na odpowiednich poziomach, określenie częstotliwości monitorowania i oceny mechanizmów kontroli oraz automatyzację gromadzenia, analizy i raportowania tam, gdzie to możliwe, co opisuje jego publikacja o ciągłym monitorowaniu.
Jasno przypisz obowiązki
Inżynier danych odpowiada za kondycję pipeline'ów, harmonogramy dostaw, zmiany w źródłach i procedury odtwarzania. Analytics engineer odpowiada za definicje KPI, złączenia, filtry, logikę agregacji i poprawność dashboardów. Zespół governance lub jakości danych definiuje reguły walidacji, wymagania dotyczące dowodów i akceptowalne warunki danych.
Właściciel biznesowy interpretuje KPI i decyduje, co powinno się stać, gdy wskaźnik odbiega od normy. Może zatwierdzić reakcję handlową, zaakceptować znany wyjątek lub eskalować incydent operacyjny. Wspólny model ról i obowiązków w zakresie jakości danych pomaga uniknąć częstej sytuacji, w której wszyscy dostają alert, ale nikt nie odpowiada za decyzję.
Dopasuj częstotliwość do możliwości działania
Wskaźniki operacyjne o dużej zmienności mogą wymagać częstej oceny, a wolniej zmieniające się miary strategiczne można przeglądać rzadziej. Ważne jest, aby jawnie zapisać częstotliwość, w tym interwał pomiaru, oczekiwany harmonogram aktualizacji, znacznik czasu i grupę odbiorców.
Każde uruchomienie powinno zawierać:
Metadane dostawy: Oczekiwany i faktyczny czas dotarcia danych.
Dowody dotyczące danych: Liczbę wierszy, znacznik czasu źródła i status kompletności.
Kontekst techniczny: Wersję schematu i status obliczeń.
Kontekst kontrolny: Wersję progu i wynik walidacji.
Ślad operacyjny: Identyfikator incydentu, właściciela i status rozwiązania.
Zanim włączysz alert produkcyjny, wymagaj określenia ważności, runbooka, okna wyciszenia, właściciela i ścieżki eskalacji. Automatyzacja powinna zbierać i analizować dowody, ale za ocenę sytuacji i naprawę muszą odpowiadać ludzie.
Typowe błędy i jak ich unikać
Więcej alertów nie oznacza lepszego monitorowania. Jeśli każde drobne odchylenie generuje powiadomienie, zespoły uczą się ignorować kanał, a istotny incydent może zginąć wśród rutynowych ostrzeżeń.
Najbardziej szkodliwym błędem jest optymalizowanie liczby alertów zamiast jakości decyzji. Mierz, czy alerty prowadzą do działania, korzystając z precyzji, pokrycia incydentów (recall), średniego czasu wykrycia, średniego czasu potwierdzenia i średniego czasu naprawy. Cichy system alertów może być zdrowy, ale może też przeoczać incydenty. Potrzebujesz dowodów.
Typowe wzorce porażek
Zmęczenie alertami: Zbyt wiele powiadomień uczy zespoły ignorowania alertów. Łącz poziomy ważności, wyciszaj duplikaty w znanych oknach serwisowych i wysyłaj tylko zdarzenia wymagające działania.
Metryki próżności: Metryka może robić wrażenie, a jednocześnie nie wspierać żadnej decyzji. Powiąż każdy KPI z celem biznesowym i określ działanie, które następuje po istotnej zmianie.
Brak właściciela: Alert bez wskazanej osoby odpowiedzialnej staje się wspólnym szumem w tle. Przypisz jednego odpowiedzialnego właściciela, nawet jeśli w diagnozie uczestniczy kilka zespołów.
Statyczne progi: Stałe limity nie uwzględniają sezonowości, awarii poza godzinami szczytu i stopniowego dryfu. Łącz granice z monitorowaniem uwzględniającym punkt odniesienia.
Niezweryfikowane dane: KPI może się zmienić, bo źródło jest spóźnione lub niekompletne. Pokazuj status przydatności danych obok wartości biznesowej i rozdziel ścieżki reakcji.
Każdy alert potrzebuje z góry zdefiniowanej reakcji, zanim zostanie włączony na produkcji. Jeśli zespół nie potrafi wyjaśnić, kto prowadzi analizę, jakich dowodów potrzebuje, jak długo trwa wyciszenie i kiedy następuje eskalacja, alert nie jest gotowy operacyjnie.
Budowanie strategii monitorowania KPI z digna
Zacznij od KPI, które napędzają rzeczywiste decyzje, a nie od każdej metryki dostępnej w hurtowni. Zdefiniuj właścicieli i logikę obliczeń, ustal reprezentatywne punkty odniesienia, zweryfikuj lineage, dołącz metadane przydatności danych i połącz stałe mechanizmy kontroli z adaptacyjnym wykrywaniem anomalii.
Praktyczne wdrożenie może zacząć się od jednego krytycznego zbioru danych lub jednej domeny biznesowej. Następnie dodaj monitorowanie terminowości dla ryzyka opóźnień, walidację dla reguł biznesowych, śledzenie schematów dla zmian strukturalnych oraz obserwowalność platformy tam, gdzie obciążenie lub wydajność wpływają na raportowanie. Narzędzia do monitorowania KPI powinny pasować do modelu operacyjnego, a nie zmuszać każdego zespołu do tego samego schematu alertów.
digna działa we własnym środowisku klienta, a kontrole wykonywane są w bazie danych w hurtowniach, data lake'ach i pipeline'ach. Dzięki modułowemu licencjonowaniu zespoły mogą zacząć od jednego modułu i stopniowo się rozwijać, a Python SDK umożliwia programową integrację z istniejącymi procesami. Wspólny dashboard zaprojektowany z myślą o użytkownikach daje inżynierom danych, analitykom i interesariuszom jedno miejsce do przeglądania incydentów, trendów i statusów.
Najskuteczniejsze wdrożenie łączy projektowanie metryk z ich gromadzeniem, interpretacją, eskalacją i naprawą. Z digna zespoły mogą przejść od instalacji do pierwszych wniosków w mniej niż dwie godziny, a następnie dopracowywać progi i procesy, w miarę jak poznają zachowanie swoich danych na produkcji.
digna łączy monitorowanie biznesowych KPI z jakością danych, terminowością, walidacją, wykrywaniem anomalii i śledzeniem schematów we własnym środowisku klienta. Odwiedź digna i zobacz, jak zbudować audytowalny proces monitorowania, który odróżnia rzeczywiste zmiany wyników od niewiarygodnych danych.
Aby wycenić, ile spóźniony lub niekompletny strumień danych KPI faktycznie kosztuje Twoją firmę, wprowadź własne dane do kalkulatora kosztów przestojów danych, zanim zdecydujesz, jak intensywnego monitorowania wymaga każda metryka.
Najczęściej zadawane pytania
Czym jest proces monitorowania KPI?
To zamknięta pętla, która dla każdego KPI definiuje decyzję i właściciela, ustala reprezentatywny punkt odniesienia, weryfikuje lineage, wykonuje obliczenia w autorytatywnym źródle, wykrywa przekroczenia limitów i nietypowe zachowania oraz kieruje alerty do odpowiedzialnej osoby. Chodzi o to, aby wiedzieć zarówno, co mówi metryka, jak i czy można ufać danym, na których się opiera.
Dlaczego dashboard KPI może pokazywać mylące liczby?
Narzędzie raportowe może się poprawnie odświeżyć, mimo że ładowanie danych w źródle dotarło z opóźnieniem lub tylko częściowo. W przykładzie z artykułu przychód wyglądał na wyższy o 15%, ponieważ pipeline pominął transakcje z ostatnich dwóch dni. Bez kontroli aktualności i kompletności niekompletne dane wyglądają dokładnie tak jak lepsze wyniki biznesowe.
Czym różni się alert biznesowy od alertu dotyczącego przydatności danych?
Alert dotyczący wyników biznesowych pyta, czy biznes zachował się inaczej, więc sprawę bada właściciel handlowy lub operacyjny. Alert dotyczący przydatności danych pyta, czy można ufać pomiarowi, więc zespół platformy danych naprawia brakującą partycję lub zmieniony schemat. Dwie ścieżki alertów kierują każdy problem do właściwego zespołu.
Czy monitorowanie KPI powinno opierać się na stałych progach, czy na wykrywaniu anomalii?
Na jednym i drugim. Stałe progi sprawdzają się przy twardych, jawnych granicach, takich jak kontrole wartości null, unikalność, integralność referencyjna, zgodność schematu i okna dostaw. Adaptacyjne wykrywanie anomalii porównuje metrykę z jej własną historią, dzięki czemu wychwytuje nietypowe poziomy, zmiany tempa i dryf, które pojedynczy statyczny limit by przeoczył albo oznaczył jako szum.
Kto powinien odpowiadać za monitorowanie KPI?
Odpowiedzialność jest podzielona. Inżynierowie danych odpowiadają za kondycję pipeline'ów i harmonogramy dostaw, analytics engineers za definicje KPI i logikę dashboardów, zespoły governance ustalają reguły walidacji i wymagania dotyczące dowodów, a właściciel biznesowy decyduje, jakiego działania wymaga odchylenie. KPI bez wskazanej osoby odpowiedzialnej zwykle staje się problemem wszystkich i zadaniem nikogo.


