Porównanie 10 narzędzi do walidacji big data
|
10
min. czyt.

Najlepsze narzędzia do walidacji big data to nie te z najdłuższą listą funkcji. Platforma może oferować profilowanie, alerty, lineage i dziesiątki konektorów, a mimo to zespół finansowy nadal nie będzie w stanie udowodnić, czy krytyczna reguła transakcyjna faktycznie się wykonała, gdzie uruchomiono nieudaną kontrolę ani kto odpowiada za wyjątek.
Walidacja na dużą skalę obejmuje różne problemy. Reguły biznesowe na poziomie rekordów sprawdzają, czy wartości i relacje mają sens. Statystyczne wykrywanie anomalii identyfikuje nietypowe rozkłady. Monitorowanie aktualności wychwytuje spóźnione lub brakujące ładowania. Śledzenie schematów wykrywa zmiany strukturalne. Testy migracji porównują wyniki między systemami, a lineage i monitorowanie kondycji platformy wyjaśniają wpływ zdarzeń i kontekst operacyjny. Te mechanizmy kontroli częściowo się pokrywają, ale nie są wymienne. To rozróżnienie jest kluczowe, aby zrozumieć, dlaczego testy walidacyjne mają znaczenie.
W tym zestawieniu oceniamy dziesięć narzędzi pod kątem zakresu walidacji, modelu wykonywania, wdrożenia, odpowiedzialności operacyjnej, nakładu pracy przy wdrożeniu, governance, przejrzystości cen i dopasowania do przypadków użycia. Testy oparte na regułach i zautomatyzowaną obserwowalność traktujemy jako podejścia uzupełniające się, a nie konkurencyjne. digna to jedna z istotnych opcji dla zespołów, które potrzebują walidacji i obserwowalności wewnątrz bazy danych, we własnej infrastrukturze, ale nie jest uniwersalnym zwycięzcą dla każdego środowiska danych.
Spis treści
1. Data Validation
Miejsce digna w praktyce operacyjnej
Mocne strony i kompromisy
2. Great Expectations, GX Cloud i wersja open source
3. Soda, Soda Core i Soda Cloud
4. Monte Carlo
5. Anomalo
6. Bigeye
7. Datafold
8. AWS Deequ
9. Acceldata
10. Talend Data Quality, obecnie w ramach Qlik Talend Cloud i Talend Data Fabric
Porównanie 10 najlepszych narzędzi do walidacji big data
Dopasuj narzędzie do awarii, której chcesz zapobiec
1. Data Validation
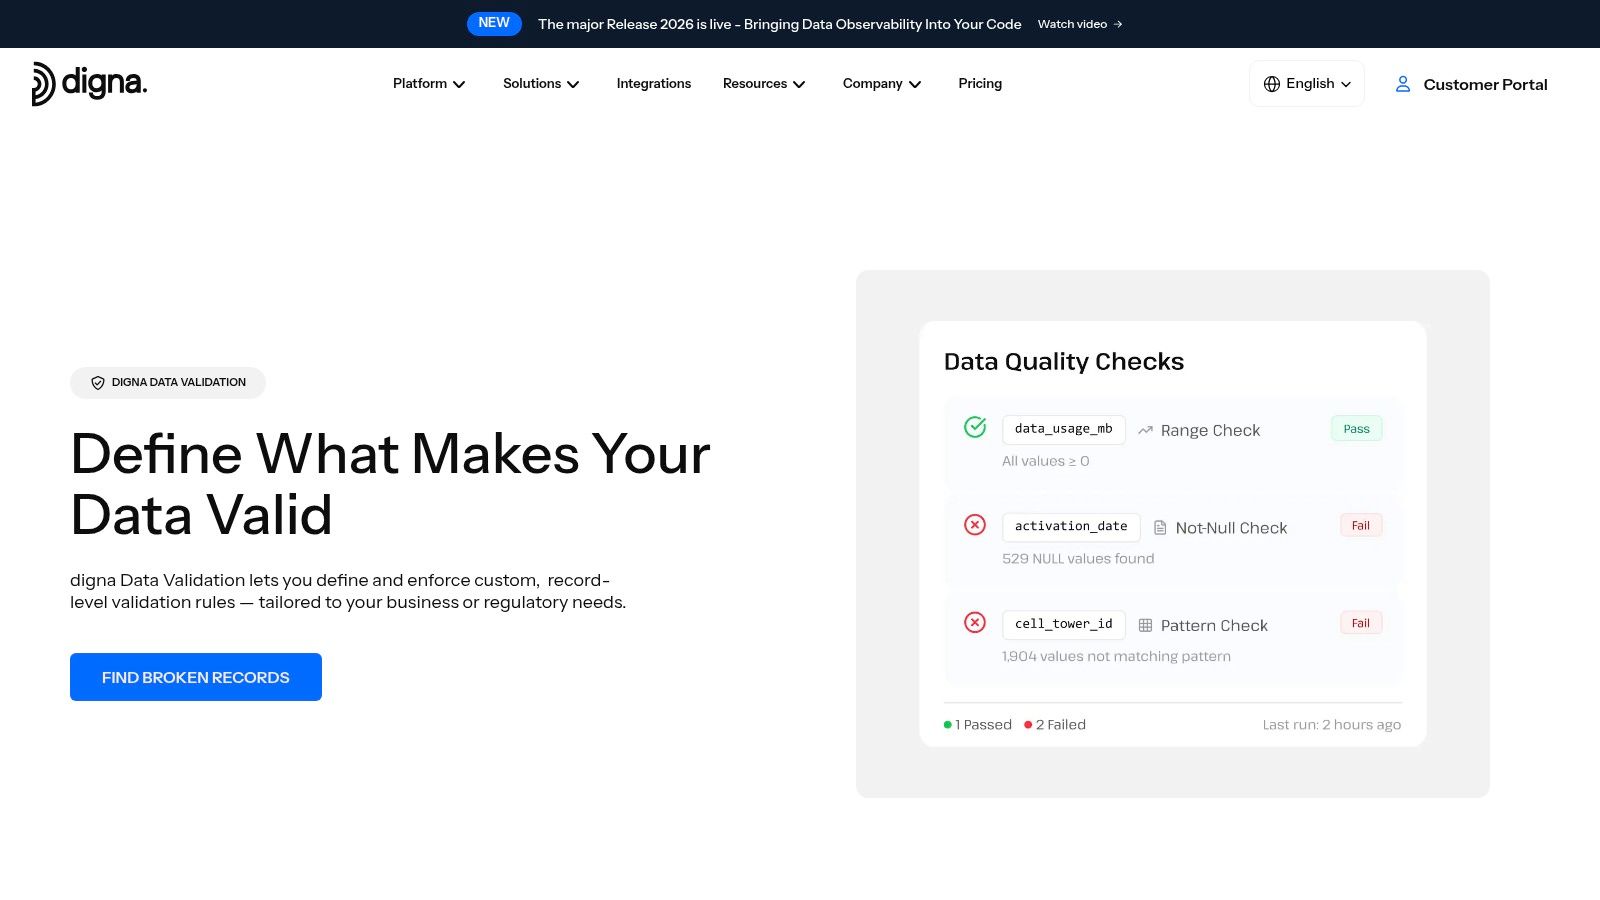
Moduł Data Validation w digna powstał z myślą o problemie, którego same wskaźniki anomalii nie rozwiążą: o udowodnieniu, że poszczególne rekordy są zgodne z jawnie zdefiniowaną logiką biznesową. Zespoły mogą definiować kontrole dokładnych wartości, progów, zakresów, obsługi wartości null, list referencyjnych i spójności między kolumnami, a następnie wykorzystywać wyniki w analityce, raportowaniu, procesach operacyjnych i przeglądach regulacyjnych. To rozróżnienie ma znaczenie, ponieważ zbiór danych może zachowywać znany wzorzec statystyczny, a mimo to naruszać krytyczną regułę biznesową.
Miejsce digna w praktyce operacyjnej
digna wykonuje walidację i obliczenia metryk wewnątrz baz danych klienta, zamiast przenosić dane produkcyjne do zewnętrznego środowiska przetwarzania. Działa w chmurze klienta, w jego VPC lub centrum danych, dlatego model wdrożenia ma znaczenie dla organizacji o rygorystycznych wymaganiach dotyczących rezydencji danych, dostępu czy governance. Materiały produktowe opisują wykonywanie kontroli w bazach takich jak Teradata, Snowflake, Databricks i PostgreSQL, z rejestrowaniem wyników pozytywnych i negatywnych oraz ścieżkami audytu.
Moduł łączy też błędy na poziomie rekordów z wykrywaniem anomalii opartym na AI, monitorowaniem terminowości i śledzeniem schematów. Taka korelacja bywa bardziej użyteczna niż pojedynczy alert. Nieudana reguła, której towarzyszy spóźnione ładowanie lub niedawna zmiana struktury, daje osobie analizującej incydent znacznie lepszy punkt wyjścia niż nieudana reguła bez kontekstu.
Praktyczna zasada: Wybierz digna, gdy dowody stojące za nieudaną kontrolą są równie ważne jak sam alert.
Mocne strony i kompromisy
Wykonywanie w bazie danych: Dane produkcyjne pozostają na miejscu, co ogranicza ich przenoszenie i dopasowuje walidację do wymogów wdrożeń prywatnych.
Kontrole gotowe do audytu: Wyniki na poziomie wierszy dostarczają dowodów dla reguł biznesowych, obsługi wyjątków i przeglądów zgodności.
Skorelowane incydenty: Anomalie, opóźnienia dostaw danych i zmiany schematów można analizować razem z błędami walidacji.
Modułowa rozbudowa: Zespoły mogą zacząć od priorytetowych tabel i dodawać kolejne moduły monitorowania wraz z rosnącym zakresem.
Kompromisem jest odpowiedzialność za wdrożenie. digna wymaga instalacji i integracji z bazami danych klienta, więc może oznaczać więcej pracy infrastrukturalnej niż usługa dostępna wyłącznie w modelu SaaS. Tworzenie i utrzymanie reguł nadal pozostaje konieczne, a rozliczanie za aktywną tabelę sprawia, że koszty i nakład operacyjny rosną wraz z zakresem. Zespoły oceniające to rozwiązanie powinny przed szerokim wdrożeniem ustalić właścicieli tabel i reguł, zasady wygasania wyjątków oraz poziomy usług dla działań naprawczych.
Więcej o wzorcach wdrożeniowych znajdziesz w przewodniku digna po regułach walidacji danych, kontrolach i ciągłej jakości danych. Aktualne informacje o wdrożeniu i licencjonowaniu znajdziesz na stronie produktu digna Data Validation.
2. Great Expectations, GX Cloud i wersja open source
Great Expectations sprawdza się, gdy zespół chce deklaratywnej walidacji opartej na regułach z fundamentem open source. Model Expectations pozwala inżynierom definiować asercje dotyczące zbiorów danych, kolumn, rozkładów i wartości, a następnie uruchamiać te zestawy na hurtowniach SQL, data lake'ach, plikach lub ramkach danych. Oddzielenie tworzenia testów od zarządzania ich uruchamianiem jest przydatne dla zespołów, które chcą kontroli przechodzących code review, a jednocześnie potrzebują wspólnego widoku operacyjnego.
Wersja open source GX lepiej pasuje do zespołów, które swobodnie utrzymują przepływy pracy w Pythonie, repozytoria i infrastrukturę wykonawczą. GX Cloud dodaje hostowaną współpracę, historię walidacji, alerty i procesy governance. Produkt jest więc nie tyle pojedynczą decyzją wdrożeniową, ile ścieżką od testowania code-first do zarządzanych operacji.
Główne ograniczenie to nakład pracy potrzebny do zapewnienia pokrycia. Bogaty katalog expectations nie zwalnia z decyzji, które reguły są krytyczne biznesowo, jak działają wyjątki i gdzie zestawy testów uruchamiane są na produkcji. Tworzenie reguł może stać się pracochłonne, gdy duże środowisko wymaga jawnego pokrycia wielu tabel. GX nie jest też przede wszystkim platformą zautomatyzowanej obserwowalności, więc zespoły szukające uczenia się wzorców bazowych, inteligentnego monitorowania aktualności czy szerokiej korelacji incydentów mogą potrzebować dodatkowych funkcji.
Aby osadzić ten framework w praktycznym kontekście rynku open source, porównaj go z przeglądem funkcji narzędzi open source do jakości danych przygotowanym przez digna. Aktualne opcje produktowe sprawdzisz na stronie Great Expectations, zwłaszcza jeśli ceny, limity wersji hostowanej lub pakietowanie chmurowe wpłyną na decyzję zakupową.
3. Soda, Soda Core i Soda Cloud
Soda oddziela silnik wykonawczy od operacyjnej warstwy sterowania. Soda Core i Soda Library pozwalają programistom zapisywać kontrole w SodaCL, składni opartej na YAML, zaprojektowanej z myślą o integracji z pipeline'ami. Soda Cloud dodaje wspólny interfejs do wyników, alertów, trendów, dostępu opartego na rolach i triage.
Taki podział odpowiada zespołom, które chcą prowadzić walidację blisko hurtowni, a jednocześnie dać analitykom i właścicielom danych chmurowy interfejs do przeglądu wyników. Integracje Soda z platformami takimi jak Snowflake i Databricks, wraz z połączeniami CI/CD, pozwalają uruchamiać kontrole jako część procesów dostarczania, a nie tylko jako zaplanowane skany widoczne na dashboardzie.
Istotnym wyróżnikiem jest dostępność. YAML może obniżyć próg wejścia dla inżynierów, którzy nie chcą osadzać każdej kontroli w kodzie aplikacji, a profilowanie i automatyczne sugestie pomagają ustalić początkowy poziom jakości. Produkt nadal wymaga jednak decyzji dotyczących ważności, odpowiedzialności i eskalacji. Kontrola, która wykonuje się poprawnie, ale nie ma odpowiedzialnego właściciela, jest jedynie zdarzeniem technicznym, a nie mechanizmem kontroli operacyjnej.
Miejsce wykonywania kontroli ma większe znaczenie niż ekran alertów. Dopracowany interfejs chmurowy nie oznacza automatycznie, że dane produkcyjne opuściły hurtownię.
Najmocniejszym przypadkiem użycia Soda jest program jakości skoncentrowany na hurtowni, łączący kontrole pisane przez programistów ze wspólnym triage. Ograniczeniem jest pakietowanie. Część zaawansowanych funkcji jest dostępna tylko w wersji Cloud, a ceny nie są publikowane, więc kupujący muszą bezpośrednio potwierdzić aktualny zakres funkcji i założenia wyceny. Zespoły porównujące Soda z digna powinny skupić się na tym, czy potrzebują chmurowej warstwy sterowania SaaS, instalacji prywatnej czy szerszego, skorelowanego monitorowania. Na stronie platformy Soda znajdziesz aktualny zakres produktu, szczegóły wdrożenia i informacje handlowe. Alternatywy nastawione na walidację i obserwowalność w miejscu przechowywania danych opisujemy w artykule digna jako alternatywa dla Soda.
4. Monte Carlo
Monte Carlo odpowiada na inny wzorzec awarii niż biblioteka reguł. Jego główną propozycją jest obserwowalność danych obejmująca aktualność, wolumen, schemat, lineage i BI, wspierana przez monitory oparte na uczeniu maszynowym i procesy obsługi incydentów. To naturalny wybór dla większych zespołów danych, które muszą wykrywać nieoczekiwane zachowania bez pisania reguły dla każdej tabeli i metryki.
Lineage i analiza wpływu są szczególnie ważne podczas dochodzenia. Problem z aktualnością danych staje się łatwiejszy do rozwiązania, gdy zespół widzi, których zasobów, dashboardów lub procesów niżej w łańcuchu dotyczy. Funkcje triage incydentów i runbooków przesuwają też produkt w stronę reagowania operacyjnego, a nie wyłącznie tworzenia testów.
Monte Carlo jest często oceniane w ramach korporacyjnych kanałów zakupowych, w tym AWS Marketplace. Model rozliczeń oparty na kredytach może uprościć zakup organizacjom, które już korzystają z tej ścieżki, ale rodzi pytania o zmienne koszty. Zespoły powinny przeliczyć, jak liczba monitorowanych zasobów, częstotliwość skanów, okres przechowywania historii i liczba incydentów wpływają na zużycie, zamiast traktować ścieżkę marketplace jako pełną odpowiedź w kwestii cen.
Ograniczeniem jest pokrycie deterministyczne. Obserwowalność może wykazać, że rozkład się zmienił lub ładowanie dotarło z opóźnieniem, ale nie zastąpi jawnej reguły dla warunku istotnego prawnie lub operacyjnie. Dobre wdrożenie łączy automatyczne monitory Monte Carlo z ukierunkowanymi testami, za które odpowiada właściwy zespół domenowy.
Aktualny zakres i opcje zakupu sprawdzisz na stronie Monte Carlo. Kupujący powinni poprosić o model kosztów oparty na faktycznie monitorowanym środowisku, a następnie porównać go z narzędziami wykonującymi kontrole we własnej infrastrukturze. Inną perspektywę produktową znajdziesz w analizie alternatyw dla Monte Carlo przygotowanej przez digna.
5. Anomalo
Anomalo jest przeznaczone dla zespołów, które chcą szybko uzyskać szerokie pokrycie dzięki automatycznemu wykrywaniu anomalii. Analizuje zachowanie tabel, kolumn, metryk i rozkładów, a dodatkowo obsługuje konfigurowalną walidację na poziomie tabel, kolumn i wierszy. To połączenie rozwiązuje częsty dylemat wdrożeniowy: zespoły potrzebują jawnych kontroli, ale często nie są w stanie ręcznie zdefiniować każdego przydatnego punktu odniesienia przed rozpoczęciem monitorowania.
Interfejs kładzie nacisk na przegląd na dużą skalę. Natywne połączenia z nowoczesnymi hurtowniami i katalogami, takimi jak Alation, pomagają pokazywać stan danych tam, gdzie konsumenci i stewardzi danych już pracują. Automatyczne wykrywanie może ujawnić nietypowe przesunięcia, które umknęłyby ręcznie dobranemu progowi, zwłaszcza w rozległych środowiskach hurtowni, gdzie właściwy punkt odniesienia nie jest oczywisty na etapie projektowania.
Kompromisem jest kalibracja alertów. Monitory oparte na uczeniu maszynowym nadal wymagają zasad triage, decyzji o wyciszaniu i przypisania odpowiedzialności. Jeśli zespoły uznają każde odchylenie za defekt, generują szum. Jeśli wyciszają zbyt agresywnie, system traci pokrycie. Właściwy model operacyjny klasyfikuje problemy według konsekwencji biznesowych i zachowuje kontrole deterministyczne dla warunków, które nigdy nie mogą być niejednoznaczne.
Automatyczne pokrycie zmniejsza nakład pracy przy tworzeniu reguł, ale nie eliminuje potrzeby podejmowania decyzji przez odpowiedzialne osoby.
Anomalo pasuje do organizacji, które stawiają na szybką obserwowalność w dużych środowiskach hurtowni i wizualny proces przeglądu problemów. Może być mniej odpowiednie, gdy głównymi kryteriami wyboru są wdrożenie prywatne, dowody generowane w bazie danych lub rygorystyczne ścieżki audytu na poziomie rekordów. Ceny ustalane są przez dział sprzedaży i nie są publikowane, więc podczas oceny warto zweryfikować zakres konektorów, granice dostępu do danych i wsparcie przy strojeniu. Aktualną ofertę znajdziesz na stronie Anomalo, a podejście oparte przede wszystkim na anomaliach możesz porównać z przewodnikiem digna o wczesnym wykrywaniu problemów z danymi dzięki detekcji anomalii.
6. Bigeye
Bigeye traktuje obserwowalność jako element modelu operacyjnego AI Trust. Monitorowanie obejmuje aktualność, wolumen, schemat i rozkłady, a lineage oraz analiza wpływu łączą nieprawidłowy zbiór danych z jego odbiorcami niżej w łańcuchu. Dzięki temu produkt jest istotny tam, gdzie zespoły governance potrzebują czegoś więcej niż powiadomienia. Potrzebują kontekstu: co się zmieniło i których obciążeń może to dotyczyć.
Praktyczną zaletą produktu jest triage uwzględniający lineage. Osoby analizujące incydent mogą wykorzystać relacje w górę i w dół łańcucha, aby zawęzić poszukiwanie przyczyny źródłowej, a funkcje bezpieczeństwa klasy enterprise i szerokie portfolio konektorów wspierają heterogeniczne środowiska. Bigeye udostępnia też przewodniki i dokumentację, które pomagają ujednolicić wdrożenie, zamiast pozwalać każdej domenie wymyślać własny proces monitorowania.
Szeroki zakres może być też wadą. Zespół szukający niewielkiej biblioteki kontroli deterministycznych może uznać platformę AI Trust za większą, niż wymaga bieżąca potrzeba. Więcej możliwości oznacza więcej decyzji dotyczących odpowiedzialności, integracji, ważności incydentów i procedur operacyjnych. Zespół zakupowy powinien oddzielić potrzebę obserwowalności od potrzeby kontroli w zakresie governance modeli i potwierdzić, które komponenty produktu są faktycznie wymagane.
Bigeye to dobry kandydat, gdy lineage odgrywa kluczową rolę w dochodzeniu, a organizacja chce uporządkowanego wdrożenia klasy enterprise. Nie jest oczywistym pierwszym wyborem, jeśli potrzebna jest natywna biblioteka dla Spark albo proces porównywania danych przy migracji. Ceny nie są publikowane, a zakup odbywa się głównie przez demo, więc ocena powinna obejmować granice wdrożenia, obsługę danych wrażliwych i przechowywanie dowodów. Aktualne informacje o produkcie znajdziesz na stronie Bigeye.
7. Datafold
Datafold wyjątkowo dobrze rozwiązuje węższy problem: porównywanie na poziomie wartości i testy regresji. Funkcja Data Diff porównuje wyniki w dużych zbiorach danych, a lineage na poziomie kolumn łączy zmiany w hurtowniach, projektach dbt i zasobach BI. Dzięki temu narzędzie przydaje się przed scaleniem pull requesta, podczas migracji hurtowni lub wtedy, gdy przepisano transformację, a zespół musi zobaczyć jej rzeczywisty wpływ na dane.
To nie to samo co ciągła obserwowalność. Datafold sprawdza się najlepiej, gdy ktoś wprowadza znaną zmianę i potrzebuje dowodu, że nowy wynik jest zgodny ze starym, lepszy od niego lub różni się od niego celowo. Integracje CI wbudowują to porównanie w proces developmentu, dzięki czemu inżynierowie mogą wychwycić regresje, zanim natrafią na nie odbiorcy produkcyjni.
Opcja wdrożenia w VPC wspiera organizacje, które potrzebują prywatnego wykonywania. Kluczowym pytaniem wdrożeniowym jest projekt porównania. Zespoły muszą określić, które wiersze, kolumny, agregaty, tolerancje i wykluczenia tworzą sensowny test zgodności. Mechanicznie kompletne porównanie może dać operacyjnie bezużyteczny wynik, jeśli test nie uwzględnia zmian zatwierdzonych przez biznes.
Datafold pasuje do środowisk z dużą liczbą migracji, opartych na dbt i wrażliwych na regresje. Nie zastąpi monitorowania aktualności, bazowych wzorców dla anomalii ani reguł zgodności na poziomie rekordów. Ceny pełnej platformy są ustalane indywidualnie przez dział sprzedaży, a projekt open source data-diff został wycofany na rzecz produktu chmurowego, więc kupujący powinni potwierdzić aktualną ścieżkę handlową. Najnowsze możliwości poznasz na stronie Datafold.
8. AWS Deequ
AWS Deequ to biblioteka dla Scali i Apache Spark, a nie pełna platforma obserwowalności. To rozróżnienie decyduje zarówno o jej atrakcyjności, jak i o kosztach utrzymania. Zespoły pracujące bezpośrednio w ekosystemie JVM i Spark mogą definiować ograniczenia dotyczące kompletności, unikalności, rozkładów i powiązanych metryk, a następnie wykonywać je razem z zadaniami ETL lub ELT na dużą skalę.
Wzorzec Metrics Repository w Deequ pozwala przechowywać profile w czasie. Tworzy to podstawę do analizy trendów, ale całe otoczenie pozostaje po stronie klienta. Inżynierowie muszą sami zbudować harmonogramowanie, alerty, prezentację wyników, procesy przypisywania odpowiedzialności i przechowywanie incydentów, jeśli nie zapewnia ich istniejąca platforma.
Biblioteka jest atrakcyjna, gdy liczy się uniknięcie uzależnienia od dostawcy, a Spark jest już środowiskiem wykonawczym. Można ją osadzić w zadaniach ETL i procesach CI, a dla zespołów potrzebujących interfejsu w Pythonie istnieją bindingi rozwijane przez społeczność. Elastyczność wiąże się jednak z wymaganiami kompetencyjnymi. Zespoły bez solidnej wiedzy o Scali lub Spark mogą poświęcać więcej wysiłku na utrzymanie warstwy walidacji niż na samo definiowanie ograniczeń.
Deequ to komponent, z którego składasz system walidacji. Nie jest gotowym procesem governance.
Używaj Deequ do natywnych dla Spark testów ograniczeń, gdy kontrola po stronie inżynierów i licencja open source są ważniejsze niż wbudowany interfejs. Wybierz platformę, gdy analitycy, stewardzi danych lub audytorzy potrzebują wspólnego kontekstu incydentów bez dodatkowego developmentu. Aktualny kod i dokumentacja projektu są dostępne w repozytorium AWS Deequ.
9. Acceldata
Acceldata łączy niezawodność danych z optymalizacją kosztów i kondycją platformy. To kandydat dla złożonych środowisk, w których zespoły nie chcą, aby alerty jakości danych były oderwane od zachowania obciążeń, sygnałów wydajnościowych i zmian w zużyciu. Zakres narzędzia wykracza poza kontrole wierszy i obejmuje warunki operacyjne decydujące o tym, czy platformy danych pozostają użyteczne i kontrolowane ekonomicznie.
Platforma obsługuje monitory niezawodności, alerty i mechanizmy kontroli w stylu kontraktów danych w heterogenicznych stosach technologicznych. Funkcje wdrożeniowe i bezpieczeństwa klasy enterprise mają znaczenie dla organizacji działających zarówno on-premises, jak i w chmurze, zwłaszcza gdy inżynierowie platformy i zespoły governance dzielą odpowiedzialność za poziomy usług.
Szeroki zakres bywa cenny, ale zwiększa też skalę wdrożenia. Zespół, który szuka jedynie kontroli wartości null, walidacji list referencyjnych lub niewielkiego zestawu kontroli schematu, może skończyć na ocenianiu funkcji, których nigdy nie wdroży operacyjnie. Proces wyboru powinien wskazać awarię uzasadniającą zakup platformy, a następnie sprawdzić, czy za sygnały kosztowe i sygnały kondycji będzie odpowiadał ten sam zespół, czy osobne funkcje platformowe.
Acceldata pasuje do środowisk, w których jakość, niezawodność i ekonomika platformy muszą być analizowane łącznie. Ceny ustalane są przez dział sprzedaży na podstawie wyceny, więc kupujący powinni poprosić o przejrzysty podział na moduły, monitorowane zasoby, wdrożenie i wsparcie. Aktualne pozycjonowanie produktu i szczegóły platformy znajdziesz na stronie Acceldata.
10. Talend Data Quality, obecnie w ramach Qlik Talend Cloud i Talend Data Fabric
Talend Data Quality to na tej liście uznana opcja klasy enterprise, z funkcjami obejmującymi profilowanie, oczyszczanie, standaryzację, wzbogacanie danych, stewardship i ocenę wiarygodności. Najwięcej sensu ma w organizacjach, które już standaryzują się na Qlik lub Talend w zakresie integracji, governance i zarządzania danymi, ponieważ wartość wynika w równym stopniu z otaczającego ekosystemu, co z pojedynczych reguł walidacji.
Zestaw narzędzi obsługuje reguły jakości i profilowanie razem z procesami stewardship. Plany subskrypcyjne są dostępne w Qlik Talend Cloud, a opcje on-premises i zarządzane przez klienta istnieją w szerszej rodzinie Data Fabric. Taka rozpiętość pomaga organizacjom o mieszanych wymaganiach wdrożeniowych, ale sprawia też, że trzeba dokładnie zweryfikować pakietowanie produktu.
Talend to mniej lekka biblioteka dla programistów, a bardziej sposób na instytucjonalizację procesów jakości w różnych rolach. Stewardzi danych mogą uczestniczyć w działaniach naprawczych, a zespoły integracyjne łączą procesy jakości z szerszym przepływem danych i governance. Kompromisem jest złożoność. Publiczny cennik nie jest dostępny, poziomy i SKU bywają trudne do porównania, a rebranding pod marką Qlik oznacza, że kupujący powinni potwierdzić, które funkcje należą do którego obecnego pakietu.
Talend dobrze pasuje do przedsiębiorstw, które już zainwestowały w ekosystem Qlik i Talend. Może być przesadą przy ukierunkowanym porównaniu danych podczas migracji, bibliotece ograniczeń dla Spark lub wdrożeniu opartym wyłącznie na anomaliach. Aktualne pakietowanie, wdrożenie, wsparcie i licencjonowanie potwierdzisz na stronie Qlik Talend Data Fabric.
Porównanie 10 najlepszych narzędzi do walidacji big data
Narzędzie | Kluczowe funkcje | UX i jakość (★) | Unikalne zalety (✨ / 🏆) | Grupa docelowa (👥) | Cena / wartość (💰) |
|---|---|---|---|---|---|
Data Validation (digna) | Walidacja na poziomie rekordów w bazie danych, zintegrowana z anomaliami, terminowością i schematami | ★★★★★ Wspólny interfejs, klasa enterprise | ✨ Działa w infrastrukturze klienta; skorelowane incydenty → szybsze RCA 🏆 | 👥 Regulowane przedsiębiorstwa (finanse, ochrona zdrowia, telekomunikacja, sektor publiczny) | 💰 Licencja modułowa + opłata za aktywną tabelę; przejrzysta, stabilna przy zmiennym użyciu |
Great Expectations (GX) | Deklaratywne zestawy expectations, profilowanie, obsługa wielu backendów | ★★★★ UX code-first; GX Cloud dodaje zarządzany interfejs | ✨ Bogata biblioteka expectations, dokumentacja i lineage testów 🏆 | 👥 Inżynierowie danych, zespoły code-first | 💰 OSS bezpłatnie; GX Cloud w płatnych planach (różne) |
Soda (Core + Cloud) | Kontrole YAML (SodaCL), profilowanie, interfejs chmurowy, wykonywanie przy danych | ★★★★ Przyjazne dla programistów; Cloud do triage i RBAC | ✨ YAML + łatwe osadzenie w pipeline, automatyczne sugestie 🏆 | 👥 Zespoły deweloperskie, które chcą CI/CD + chmurowego UX | 💰 Core OSS bezpłatnie; Cloud = wycena przez sprzedaż |
Monte Carlo | Monitory ML (aktualność, wolumen, schemat), lineage, monitorowanie BI | ★★★★★ Dojrzały triage incydentów i runbooki | ✨ Monitorowanie ML klasy enterprise + rozbudowane procesy triage 🏆 | 👥 Duże organizacje z dojrzałym data ops | 💰 Przez dział sprzedaży; model kredytowy/zużyciowy (zmienny) |
Anomalo | Wykrywanie anomalii z AI, deklaratywne walidacje, integracje z katalogami | ★★★★ Szybkie pokrycie; interfejs przeglądu problemów | ✨ Automatyczne kontrole dla szybkiego pokrycia 🏆 | 👥 Zespoły potrzebujące szybkiego wykrywania anomalii na dużą skalę | 💰 Ceny enterprise ustalane przez dział sprzedaży |
Bigeye | Automatyczne monitorowanie (aktualność/wolumen/schemat), rozbudowany lineage | ★★★★ Triage uwzględniający lineage i UX dla governance | ✨ Lineage + obserwowalność na potrzeby governance 🏆 | 👥 Zespoły skoncentrowane na governance/zgodności | 💰 Na podstawie demo/wyceny (enterprise) |
Datafold | Porównywanie danych na poziomie wartości, testy regresji w CI, lineage kolumn | ★★★★ Mocny UX walidacji przed scaleniem | ✨ Data diff + integracja CI dla PR i migracji 🏆 | 👥 Zespoły inżynierskie, procesy dbt i migracje | 💰 Przez dział sprzedaży; opcja wdrożenia w VPC |
AWS Deequ (OSS) | Deklaratywne ograniczenia Spark, repozytorium metryk, kontrole w skali Spark | ★★★ Biblioteka (bez wbudowanego interfejsu), kod/natywnie | ✨ Bezpłatna, natywna dla Spark w dużej skali dla zespołów JVM 🏆 | 👥 Inżynierowie big data JVM/Spark | 💰 Open source (bezpłatnie); tylko koszty infrastruktury/developmentu |
Acceldata | Monitory niezawodności, optymalizacja kosztów, kondycja platformy | ★★★★ Dashboardy enterprise i narzędzia SLO | ✨ Łączy jakość danych z wglądem w koszty/platformę 🏆 | 👥 Złożone przedsiębiorstwa wieloplatformowe | 💰 Ceny enterprise na podstawie wyceny |
Talend Data Quality (Qlik) | Profilowanie, oczyszczanie, stewardship, ocena wiarygodności | ★★★★ Dojrzały UX governance i stewardship | ✨ Długa tradycja w jakości danych + integracji 🏆 | 👥 Przedsiębiorstwa standaryzujące się na Talend/Qlik | 💰 Plany subskrypcyjne (przez dział sprzedaży) |
Dopasuj narzędzie do awarii, której chcesz zapobiec
Wybór narzędzia staje się prostszy, gdy zespół nazwie awarię, zanim zacznie porównywać funkcje. Jeśli głównym ryzykiem jest nieprawidłowa kwota, niedozwolony status, brakująca wartość referencyjna lub niespójna para pól, zacznij od deterministycznej walidacji rekordów. digna, Great Expectations, Soda, Talend i Deequ obsługują kontrole oparte na regułach, ale różnią się sposobem wykonywania, interfejsami, wdrożeniem i zakresem procesów, które zespół musi zbudować wokół nich.
Jeśli problemem jest nieoczekiwane przesunięcie w rozległym środowisku, postaw na automatyczne wykrywanie anomalii. Monte Carlo, Anomalo, Bigeye, Acceldata i digna podchodzą do tego problemu przez monitorowanie i kontekst zachowań. Kluczowe pytanie nie brzmi, czy narzędzie wykorzystuje uczenie maszynowe. Zapytaj, jak zespoły stroją alerty, przypisują właścicieli, wyjaśniają odchylenia i łączą zdarzenie z jego wpływem na dalsze etapy.
Awarie aktualności i schematu wymagają osobnej oceny. Zestaw reguł może przejść pomyślnie, mimo że ładowanie dotarło z opóźnieniem, a zmiana schematu może zostać technicznie zaakceptowana przez format tabeli, a jednocześnie złamać założenia odbiorców niżej w łańcuchu. Dokumentacja Apache Iceberg pokazuje, dlaczego ewolucja schematu wymaga aktywnego śledzenia: pola mogą być dodawane, usuwane, aktualizowane lub zmieniać nazwy wraz ze zmianami metadanych, a starsze dane mogą pozostawać w ramach wcześniejszych specyfikacji partycji. Nawet strukturalnie poprawna zmiana wymaga operacyjnego zapisu: co się zmieniło, od kiedy obowiązuje i którzy odbiorcy od niej zależą.
Zmiany związane z migracją i transformacjami wymagają porównywania danych i dowodów regresji, a tu Datafold pasuje wyraźniej niż ogólna platforma obserwowalności. Zespoły skoncentrowane na Spark mogą preferować Deequ, ponieważ kontrole wykonują się w tym samym środowisku przetwarzania. Organizacje, które potrzebują triage opartego na lineage, powinny ocenić Monte Carlo, Bigeye, Acceldata lub Talend pod kątem głębokości analizy wpływu i ról zaangażowanych w działania naprawcze.
Podczas oceny zastosuj następującą sekwencję:
Zdefiniuj awarię: Oddziel naruszenia na poziomie rekordów, nietypowe zachowania, opóźnione dostawy, dryf strukturalny, niezgodności po migracji i degradację platformy.
Ustal miejsce wykonywania: Potwierdź, czy kontrole działają w hurtowni, w środowisku Spark, w VPC, w chmurze prywatnej, w infrastrukturze on-premises czy w usłudze kontrolowanej przez dostawcę.
Przypisz odpowiedzialność: Wskaż, kto tworzy reguły, analizuje alerty, zatwierdza wyjątki i potwierdza naprawę.
Sprawdź dowody: Wymagaj powtarzalnych wyników, wskazania rekordów lub metryk, których dotyczy problem, znaczników czasu, kontekstu lineage i audytowalnej historii wyjątków.
Oszacuj koszt operacyjny: Porównaj aktywne tabele, sposób skanowania, zużycie mocy obliczeniowej, kredyty, moduły, wsparcie i nakład pracy wdrożeniowej, zamiast polegać wyłącznie na liczbie licencji.
Przeprowadź reprezentatywny pilotaż: Uwzględnij krytyczną tabelę, spóźnione ładowanie, zmianę schematu, znane naruszenie reguły biznesowej i celową zmianę transformacji.
Niska jakość danych to istotne ryzyko biznesowe. W raporcie IBM Institute for Business Value z 2025 roku 43% dyrektorów operacyjnych wskazało problemy z jakością danych jako swój najważniejszy priorytet w obszarze danych. Według tego samego raportu ponad 25% organizacji szacowało roczne straty na ponad 5 mln USD, a 7% zgłaszało straty w wysokości co najmniej 25 mln USD. To szacunki z ankiety, a nie uniwersalna miara księgowa, ale dobrze tłumaczą, dlaczego walidację należy traktować jako mechanizm kontroli w obszarze governance i operacji.
Ankieta przeprowadzona w 2025 roku wśród ponad 200 specjalistów od danych wykazała, że 23,4% korzystało z dedykowanych narzędzi do obserwowalności danych, wobec 39,2% stosujących testy automatyczne i 22,6% używających narzędzi walidacyjnych, takich jak Great Expectations. Ten wzorzec adopcji przemawia za podejściem warstwowym. Zespoły nie powinny wybierać między regułami a obserwowalnością, gdy krytyczne dane wymagają zarówno jawnych ograniczeń biznesowych, jak i wczesnego ostrzegania o zmianach zachowania. Mierz pokrycie produkcyjne, czas dochodzenia, obciążenie fałszywymi alarmami, odpowiedzialność za naprawy i przechowywane dowody.
digna jest szczególnie istotna, gdy kluczowymi wymaganiami są wykonywanie w bazie danych, wdrożenie prywatne, skorelowane monitorowanie i modułowa rozbudowa. Daje zespołom możliwość połączenia walidacji na poziomie rekordów z kontrolą anomalii, terminowości i schematów we własnym środowisku. Przy innych priorytetach bardziej bezpośrednim wyborem mogą być Great Expectations, Soda, Monte Carlo, Anomalo, Bigeye, Datafold, Deequ, Acceldata lub Talend.
digna łączy walidację rekordów w bazie danych z wykrywaniem anomalii, monitorowaniem terminowości i śledzeniem schematów w Twojej chmurze, VPC lub centrum danych. Jeśli Twój zespół potrzebuje kontroli gotowych do audytu bez przenoszenia danych produkcyjnych, poznaj digna i oceń platformę na reprezentatywnym, krytycznym zbiorze danych.
Jeśli budżet na razie wyklucza platformę komercyjną, nasze zestawienie bezpłatnych narzędzi do walidacji danych omawia opcje open source warte pilotażu, zanim zdecydujesz się na jeden z opisanych wyżej produktów.
Najczęściej zadawane pytania
Czym jest narzędzie do walidacji big data?
To oprogramowanie, które sprawdza, czy duże zbiory danych spełniają oczekiwane reguły i zachowują się zgodnie z oczekiwaniami. Część narzędzi weryfikuje reguły biznesowe na poziomie rekordów, takie jak zakresy, wartości null i wartości referencyjne, inne wykrywają anomalie w aktualności, wolumenie lub rozkładach, a nieliczne porównują wyniki między wersjami, aby wychwycić regresje przed scaleniem zmiany.
Które narzędzia do walidacji big data są open source?
Great Expectations, Soda Core i AWS Deequ mają fundamenty open source. Great Expectations wykorzystuje deklaratywne Expectations, Soda Core korzysta ze składni SodaCL opartej na YAML, a Deequ jest biblioteką dla Scali i Apache Spark. Każde z nich ma płatną lub zarządzaną warstwę, taką jak GX Cloud czy Soda Cloud, do współdzielenia wyników i obsługi alertów.
Czym różni się walidacja danych od obserwowalności danych?
Walidacja dowodzi, że poszczególne rekordy są zgodne z jawną logiką biznesową, na przykład z dozwolonym statusem lub prawidłową kwotą. Obserwowalność śledzi aktualność, wolumen, schemat i rozkłady, aby wychwycić nieoczekiwane zachowania bez reguły dla każdej tabeli. Monte Carlo i Bigeye skłaniają się ku obserwowalności, a Great Expectations i Soda ku regułom.
Czy walidacja danych może działać bez przenoszenia danych poza hurtownię?
Tak. digna oblicza metryki i wykonuje walidację wewnątrz baz danych klienta, w jego chmurze, VPC lub centrum danych, więc dane produkcyjne pozostają na miejscu. Deequ również działa razem z zadaniami Spark tam, gdzie dane już się znajdują, natomiast wiele platform SaaS przetwarza wyniki w środowisku hostowanym przez dostawcę.
Jak wybrać odpowiednie narzędzie do walidacji big data?
Zanim porównasz funkcje, nazwij awarię, której chcesz zapobiec. Nieprawidłowe wartości i zerwane relacje między polami wymagają deterministycznej walidacji rekordów, nieoczekiwane zmiany wolumenu lub rozkładów wymagają wykrywania anomalii, a ryzykowne zmiany w kodzie wymagają porównywania na poziomie wartości, na przykład w Datafold, przed scaleniem pull requesta.


