Co to jest Parquet: Wyjaśnienie formatu kolumnowego
|
8
min. czyt.

Prawdopodobnie zetknąłeś się z formatem Parquet, nawet o tym nie wiedząc. Zapytanie pulpitu nawigacyjnego jest uruchamiane na plikach w magazynie obiektowym, kod SQL wygląda nieszkodliwie, a jednak z pozoru prosta agregacja spędza większość czasu na odczytywaniu danych, których zapytanie nigdy nie potrzebuje. Ten sam zestaw danych może działać płynnie w DuckDB lub Sparku, a następnie zachowywać się inaczej w innym silniku, ponieważ typ logiczny, statystyka lub nowsza funkcja nie są interpretowane w ten sam sposób.
Czym więc jest Parquet? Apache Parquet to otwartoźródłowy, kolumnowy format plików danych zaprojektowany z myślą o wydajnym przechowywaniu i pobieraniu danych, szczególnie w przypadku obciążeń analitycznych. Nie jest to baza danych i nie zastępuje formatu tabeli, takiego jak Iceberg czy Delta Lake. Jest to warstwa fizycznych plików pod wieloma jeziorami danych, hurtowniami, eksportami analitycznymi i rurociągami uczenia maszynowego.
Spis treści
Dlaczego Parquet istnieje i gdzie pasuje
Gdzie Parquet pasuje w nowoczesnym stosie danych
Jak powstał Parquet
Wewnątrz pliku Parquet
Grupy wierszy to piętra
Bloki kolumn to półki
Strony to najmniejsze praktyczne jednostki odczytu
Współpraca kodowania i kompresji
Przegląd popularnych metod kodowania i kodeków Parquet
Wypychanie predykatów i dlaczego zapytania przyspieszają
Co sprawdza czytnik
Parquet vs CSV, JSON i ORC
Parquet vs CSV vs JSON vs ORC
Interoperacyjność, bezpieczeństwo i kompromisy w świecie rzeczywistym
Wsparcie silnika to kwestia kompatybilności
Koszty kryjące się za wygodą
Praktyczne wskazówki dotyczące obciążeń analitycznych
Praktyczna lista kontrolna układu
Kwestie dotyczące governance i sztucznej inteligencji
Dlaczego Parquet istnieje i gdzie pasuje
Analityk uruchamia:
W przypadku dużego pliku CSV silnik zapytań zazwyczaj analizuje wiersze w całym pliku i bada pola, których obliczenia nigdy nie wykorzystują. Odczyty z pamięci masowej i czas procesora są przeznaczane na niepowiązane kolumny. Parquet grupuje wartości według kolumn, co pozwala czytnikowi skupić się zamiast tego na kolumnach region i revenue.
Kluczową ideą jest organizacja fizyczna. Plik zorientowany wierszowo przechowuje pola każdego rekordu razem, podczas gdy plik kolumnowy grupuje wartości z tej samej kolumny. Kolumny zazwyczaj zawierają podobne typy danych i powtarzające się wartości, co nadaje metodom kodowania i kompresji bardziej przewidywalny wzorzec. Apache opisuje Parquet jako otwartoźródłowy, kolumnowy format plików danych do wydajnego przechowywania i pobierania danych w swojej oficjalnej dokumentacji.
Taka konstrukcja odpowiada kilku typowym obciążeniom:
Chmurowe jeziora danych: Pliki w Amazon S3 i podobnych magazynach obiektowych można odpytywać bez ładowania każdego pola do bazy danych.
Analityczne tabele faktów: Spark, Trino i Presto mogą skanować wybrane kolumny z dużych zbiorów danych o zdarzeniach lub transakcjach.
Eksporty operacyjne: Zespoły mogą wyodrębniać dane aplikacji i publikować kopię analityczną bez zachowywania formatu wymiany opartego na tekście.
Cechy uczenia maszynowego: Rurociągi szkoleniowe i magazyny cech mogą wymieniać typowane, skompresowane pliki zamiast wielokrotnego analizowania plików CSV lub JSON.
Parquet zajmuje również określone miejsce w stosie jezior danych. Jezioro danych przechowuje pliki i metadane. Formaty tabel dodają transakcje, migawki, śledzenie partycji i zarządzanie schematami. To porównanie jezior danych i hurtowni danych umiejscawia format Parquet w tej szerszej architekturze.
Gdzie Parquet pasuje w nowoczesnym stosie danych
Warstwa | Typowa rola | Miejsce formatu Parquet |
|---|---|---|
Systemy źródłowe | Aplikacje, interfejsy API i operacyjne bazy danych | Zwykle cel eksportu, a nie system źródłowy |
Pozyskiwanie danych (Ingestion) | Przenosi i zapisuje surowe lub przetworzone dane | Wydajny format docelowy dla partii analitycznych |
Przechowywanie | Magazyn obiektowy i pliki jezior danych | Podstawowy fizyczny format plików |
Zarządzanie tabelami | Transakcje, migawki i koordynacja schematów | Warstwa fizycznych plików pod formatami takimi jak Iceberg lub Delta Lake |
Silnik zapytań | Przetwarzanie SQL i ramek danych (dataframes) | Odczytywany bezpośrednio przez wiele silników analitycznych |
BI i ML | Pulpity nawigacyjne, modele i rurociągi cech | Kompaktowy format wymiany i skanowania |
Parquet znajduje się pod formatami tabel, takimi jak Iceberg i Delta Lake, zapewniając warstwę fizycznych plików, a nie zarządzając transakcjami czy migawkami. Ta separacja wyjaśnia, dlaczego plik Parquet może działać w kilku silnikach, podczas gdy zachowanie na poziomie tabeli nadal zależy od otaczających go metadanych i systemu zapytań.
Praktyczny model mentalny jest prosty: Parquet sprawia, że analityczne skanowanie plików jest selektywne i ekonomiczne. Jego zalety zależą od tego, jak ułożone są pliki, jak wartości przechodzą przez kodowanie i kompresję, jak filtry docierają do czytnika oraz czy wybrany silnik konsekwentnie obsługuje odpowiednie funkcje.
Jak powstał Parquet
Parquet wyłonił się z praktycznego problemu Hadoop: zapytania analityczne często wymagały tylko kilku pól z bardzo szerokich rekordów. Twitter i Cloudera opracowały go jako projekt open-source, pod wpływem prac Google Dremel nad przetwarzaniem kolumnowym dla danych zagnieżdżonych. Pierwsze wydanie miało miejsce 13 marca 2013 roku, a po nim pojawiła się wersja Parquet 1.0 w lipcu 2013 roku, co odnotowano w historii Apache Parquet.

Celem projektowym był selektywny odczyt. Jeśli zapytanie żądało pól customer_id i revenue z szerokiego rekordu zdarzenia, czytnik mógł uniknąć analizowania niepowiązanych pól. Wpływ Dremela skierował również format Parquet w stronę zagnieżdżonych danych analitycznych, a nie tylko płaskich tabel przypominających arkusze kalkulacyjne.
Format ORC rozwijał się w ekosystemie Hive wokół podobnych celów, dając użytkownikom Hadoop kolejny poważny wybór kolumnowy. Rola formatu Parquet rosła wraz z wdrażaniem kompatybilnych procesów zapisu i odczytu przez kolejne narzędzia. Format ten nadal ewoluuje. Jednym z przykładów jest BYTE_STREAM_SPLIT, zatwierdzony w linii wydań 2.8.0 w 2019 roku, który dodał standaryzowaną funkcję, zamiast pozostawiać format bez zmian.
Projekt stał się głównym projektem Apache Software Foundation 27 kwietnia 2015 r. To governance (zarządzanie) wspiera ekosystem z wieloma niezależnymi implementacjami zamiast jednego czytnika kontrolowanego przez jednego dostawcę. Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena i Redshift należą do silników i usług wymienionych w dokumentacji ekosystemu formatu. Kompatybilność nadal zależy od tego, które funkcje implementuje dany silnik oraz jak radzi sobie ze schematami, kodowaniem i metadanymi.
Ma to znaczenie na etapie pozyskiwania danych. Rurociąg pozyskiwania danych może zapisywać partie analityczne jako Parquet, podczas gdy format tabeli dodaje transakcje i migawki, a silnik zapytań decyduje o sposobie skanowania plików.
Lekcja historyczna: Parquet odniósł sukces, dopasowując się do powszechnego analitycznego wzorca dostępu, a następnie rozprzestrzeniając się na silniki, które potrafiły wydajnie odczytywać wybrane kolumny.
Jego historia wyjaśnia podział odpowiedzialności: Parquet obsługuje warstwy fizycznego pliku, kodowania i kompresji, podczas gdy systemy zewnętrzne zapewniają zarządzanie tabelami i zachowanie zapytań.
Wewnątrz pliku Parquet
Zapytanie potrzebuje tylko kilku pól z dużej tabeli, mimo to plik zorientowany wierszowo może zmuszać do odczytania każdego pola. Parquet pozwala uniknąć tego marnotrawstwa dzięki zagnieżdżonej strukturze fizycznej. Przydatną analogią jest budynek biblioteki: plik Parquet to budynek, grupa wierszy to piętro, blok kolumn to półka, a strona to stos książek na tej półce. Każdy poziom ma określone zadanie.
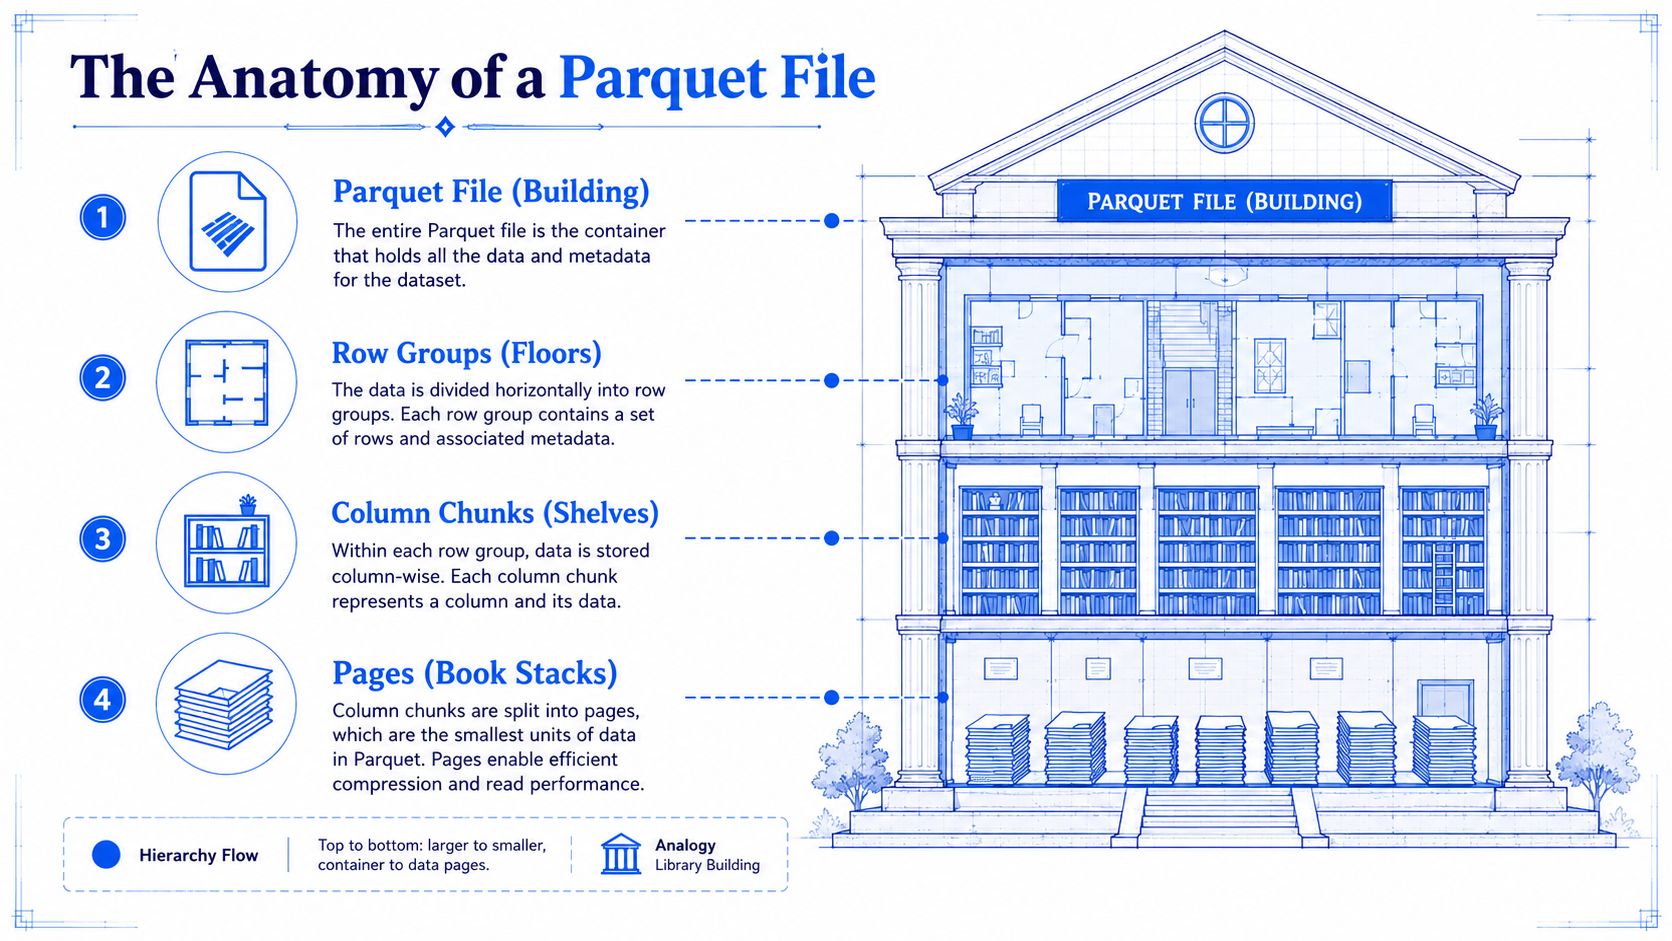
Plik Parquet zaczyna się od 4-bajtowego nagłówka magicznego, PAR1. Jego dane są zorganizowane w grupy wierszy. Każda grupa wierszy ma dokładnie jeden blok kolumny na kolumnę, a każdy blok kolumny zawiera jedną lub więcej stron. Ta hierarchia zapewnia czytnikom strukturę potrzebną do wybierania kolumn i pomijania nieistotnych danych, jak opisano w dokumentacji pojęć Parquet firmy Apache.
Grupy wierszy to piętra
Grupa wierszy zawiera poziomy wycinek wierszy tabeli. Dla kolumn takich jak event_date, region i revenue jedna grupa wierszy przechowuje część wszystkich trzech. Zakresy ich wierszy pozostają wyrównane, dzięki czemu silnik może oceniać te same rekordy, czytając tylko kolumny wymagane przez zapytanie.
Programy zapisujące zazwyczaj celują w grupy wierszy w szerokim zakresie od 128 MB do 1 GB. Odpowiednie ustawienie zależy od silnika, systemu pamięci masowej, obciążenia pracą i liczby kolumn. Większe grupy mogą zmniejszyć narzut metadanych, podczas gdy mniejsze grupy zapewniają bardziej szczegółowe pomijanie. Rozmiar grup wierszy należy traktować jako decyzję zależną od obciążenia pracą, a nie jako uniwersalną stałą.
Bloki kolumn to półki
Wewnątrz grupy wierszy każda kolumna ma swój własny blok kolumny. Blok region przechowuje zakodowane wartości regionów, podczas gdy blok revenue przechowuje zakodowane wartości przychodów. Zapytanie, które potrzebuje tych pól, może uniknąć odczytywania niepowiązanego bloku customer_notes.
Stopka rejestruje lokalizację i metadane każdego bloku. Opisuje również ścieżki schematu i metadanych kolumn, umożliwiając czytnikowi interpretację zagnieżdżonych pól i lokalizację odpowiednich bajtów bez konieczności skanowania od samego początku.
Strony to najmniejsze praktyczne jednostki odczytu
Bloki kolumn są podzielone na strony zawierające zakodowane wartości i metadane stron. Typowy domyślny rozmiar strony to 1 MB, choć programy zapisujące i silniki mogą wybierać inne ustawienia. Strony zapewniają dokładniejszą granicę dla statystyk, kompresji i selektywnych odczytów.
Plik kończy się stopką zawierającą informacje potrzebne do zdekodowania danych, po której następuje końcowy znacznik PAR1. Czytnik może przejść na koniec, odczytać stopkę, zidentyfikować schemat i lokalizacje grup wierszy, a następnie wykonać ukierunkowane odczyty wybranych bloków i stron. Ta struktura sprawia, że Parquet jest binarny, samoopisujący się i podzielny (splittable) na potrzeby przetwarzania rozproszonego.
Model mentalny czytelnika: Zacznij od stopki, zidentyfikuj przydatne grupy wierszy i kolumny, a następnie odczytaj ukierunkowane bloki i strony.
Parquet przenosi informacje strukturalne wymagane do samodzielnego odczytu, więc oddzielny katalog nie jest wymagany. Katalog może jednak ułatwić wyszukiwanie. Silne zarządzanie metadanymi pomaga w skali tabeli, zwłaszcza gdy trzeba śledzić wiele plików i wersji schematów. Przenośność plików zależy również od tego, czy czytniki obsługują funkcje używane przez program zapisujący, a nie tylko od tego, czy oba narzędzia nazywają siebie zgodnymi z Parquet.
Współpraca kodowania i kompresji
Ludzie często używają pojęć „kodowanie” i „kompresja”, jakby oznaczały to samo. W formacie Parquet są to osobne etapy w rurociągu:
Kodowanie zmienia kształt wartości w celu ujawnienia wzorców.
Kompresja zmniejsza powstały strumień bajtów.
Rozważmy kolumnę country zawierającą powtarzające się ciągi znaków. Kodowanie słownikowe (dictionary encoding) może przypisać każdej unikalnej wartości mały identyfikator całkowitoliczbowy, a następnie przechowywać te identyfikatory zamiast powtarzać pełne ciągi znaków na całej stronie. Kodowanie długości serii (run-length encoding) pozwala na kompaktowe przedstawienie sekwencji identycznych wartości. Kodowanie delta przechowuje różnice między kolejnymi wartościami, co może być skuteczne, gdy liczby są uporządkowane lub zmieniają się stopniowo. Pakowanie bitowe (bit-packing) przechowuje małe liczby całkowite, używając tylko tylu bitów, ilu wymagają.
Techniki te nie pasują do każdej kolumny. Kodowanie słownikowe jest naturalnym wyborem dla powtarzających się wartości kategorycznych, podczas gdy kodowanie delta wymaga użytecznego wzorca sekwencji. Program zapisujący wybiera kodowanie dla kolumny i strony, a metadane rejestrują ten wybór.
Dopiero po tej zmianie kształtu kodek na poziomie strony kompresuje bajty. Dokumentacja Apache opisuje kodeki takie jak Snappy, GZIP, LZ4 i ZSTD, podczas gdy PyArrow obsługuje również Brotli i nieskompresowane dane wyjściowe w swojej dokumentacji konfiguracji Parquet. Dokumentacja formatu wyjaśnia, że zawartość strony jest kompresowana w takiej postaci, w jakiej jest, bez dodatkowego obramowania czy dopełnienia, co upraszcza proces dekompresji.
Przegląd popularnych metod kodowania i kodeków Parquet
Technika | Najlepsza dla | Kompromis |
|---|---|---|
Kodowanie słownikowe | Powtarzające się ciągi znaków i wartości kategoryczne | Mniej przydatne, gdy wartości są w większości unikalne |
Kodowanie długości serii (RLE) | Długie serie tej samej wartości | Działa słabo, gdy wartości stale się zmieniają |
Kodowanie delta | Uporządkowane lub stopniowo zmieniające się wartości liczbowe | Zależy od kolejności i kształtu danych |
Pakowanie bitowe | Małe liczby całkowite i kompaktowe indeksy | Wymaga odpowiednich zakresów wartości |
Snappy | Szybki odczyt i zapis | Zazwyczaj przedkłada szybkość nad maksymalne zmniejszenie rozmiaru |
ZSTD | Większa redukcja rozmiaru pamięci masowej | Może wymagać więcej mocy procesora niż szybsze kodeki |
GZIP | Kompatybilność ze starszymi narzędziami | Często wolniejszy w przypadku interaktywnych obciążeń |
LZ4 | Kompresja i dekompresja o niskim opóźnieniu | Współczynnik kompresji zależy od danych |
Ustawienia kodowania i kodeków znajdują się w różnych częściach metadanych pliku. Wybór kodowania jest powiązany z informacjami o stronie i kolumnie, podczas gdy kodek kompresji jest rejestrowany w odpowiednich metadanych strony. Narzędzia zapisu, takie jak Apache Spark, DuckDB i PyArrow, mogą stosować różne ustawienia domyślne, więc dwa prawidłowe pliki Parquet mogą mieć różne profile wydajności.
Częstym błędem optymalizacyjnym jest wybór agresywnego poziomu kompresji bez zmierzenia obciążenia pracą. Jeśli kolumna została już wysoce uporządkowana poprzez kodowanie, wolniejsze ustawienie, takie jak ZSTD na poziomie 19, może zwiększyć obciążenie procesora bez przyniesienia użytecznej redukcji rozmiaru. Właściwy wybór zależy od tego, czy wąskim gardłem jest pamięć masowa, transfer sieciowy, procesor czy opóźnienia.
Wypychanie predykatów i dlaczego zapytania przyspieszają
Zapytanie pulpitu nawigacyjnego filtruje sprzedaż ze stycznia, grupuje wyniki według regionów i sumuje przychody. Czytnik Parquet może na nie odpowiedzieć bez dekodowania większości pliku. Mechanizm ten nazywa się wypychaniem predykatów (predicate pushdown), a dokładniej filtrowaniem i odrzucaniem (pruning) na warstwie pamięci masowej.
Silnik najpierw sprawdza minimalną i maksymalną wartość event_date zarejestrowaną dla każdej grupy wierszy. Jeśli grupa wierszy leży całkowicie poza styczniem, czytnik może ją pominąć bez otwierania jej stron danych. W przypadku grupy wierszy, która pokrywa się z zakresem dat, statystyki na poziomie strony mogą wyeliminować strony, których zakresy nadal nie mogą pasować.
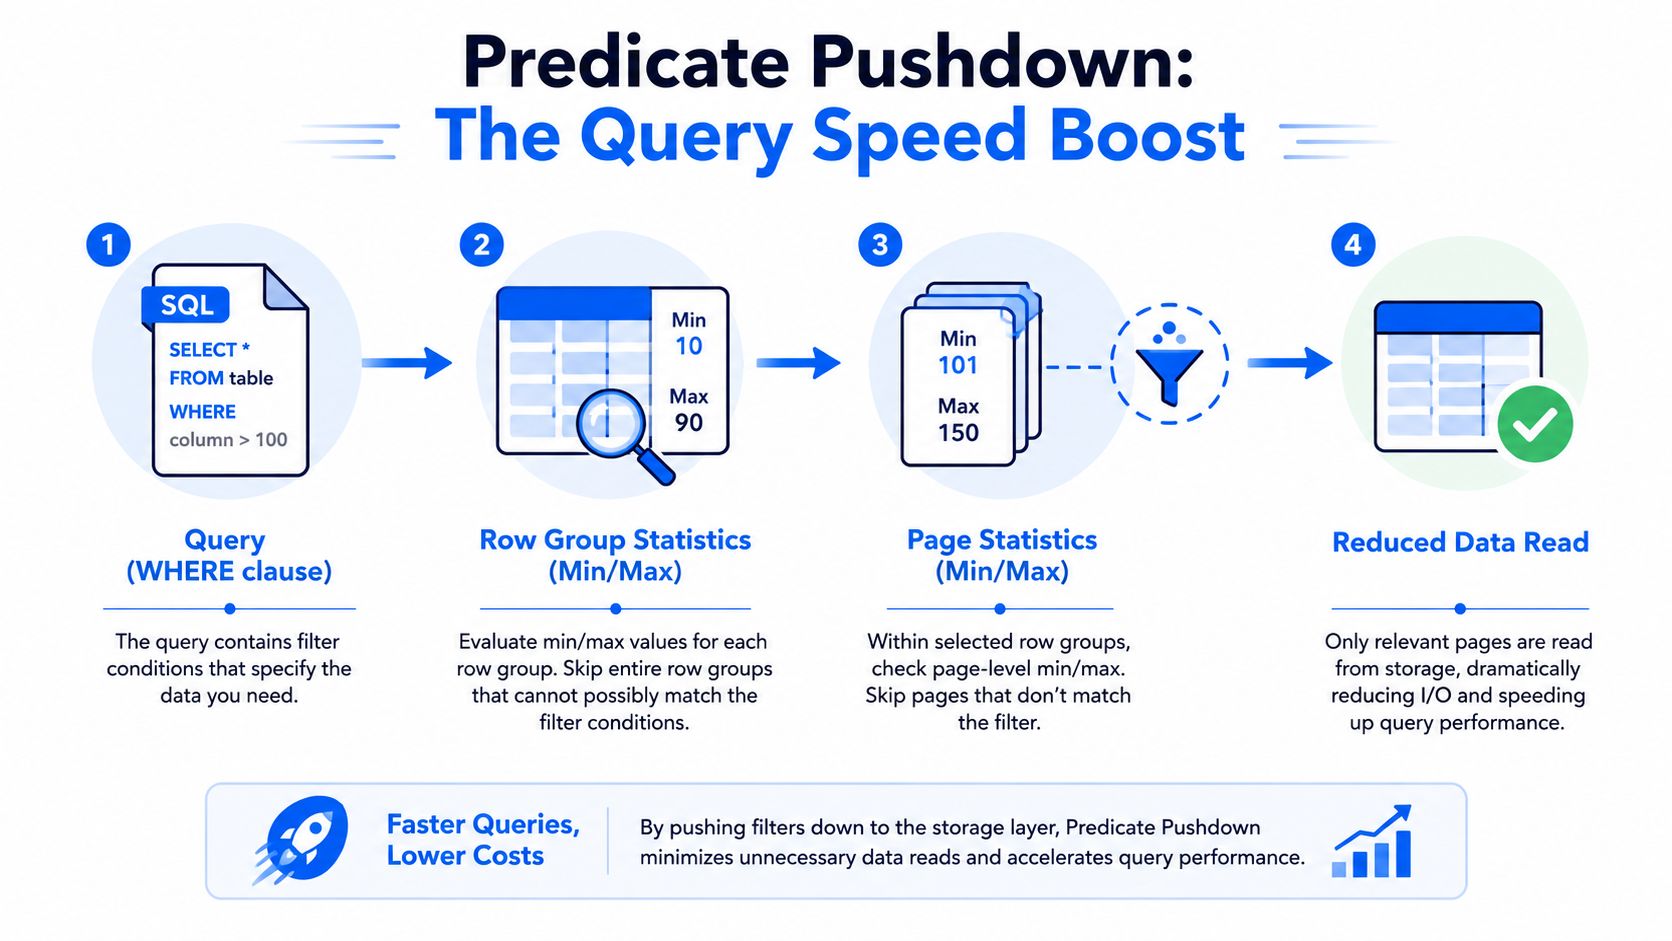
Następnie czytnik żąda tylko tych stron event_date, region i revenue, które są potrzebne do zapytania. Inne kolumny dzielą te same wiersze, ale nie muszą być dekodowane. Struktura na poziomie pliku i kolumny w formacie Parquet zapewnia układ metadanych, który umożliwia ten selektywny dostęp.
Co sprawdza czytnik
Typowa sekwencja odrzucania obejmuje:
Statystyki grup wierszy: Porównanie filtra z zarejestrowanym zakresem każdego bloku kolumny.
Statystyki stron: Badanie bardziej szczegółowych wartości minimalnych i maksymalnych w obrębie kwalifikujących się grup wierszy.
Informacje słownikowe: Rozstrzyganie niektórych filtrów kategorycznych na podstawie wartości stron słownika.
Filtry Blooma: Sprawdzanie probabilistycznych informacji o przynależności, jeśli plik je zawiera, a czytnik je obsługuje.
Wybór kolumn: Dekodowanie tylko projektowanych kolumn wymaganych do uzyskania wyniku.
Układ pliku decyduje o tym, jak dużą część pracy można pominąć dzięki odrzucaniu. Jeśli wartości są rozproszone na każdej stronie, zakresy min/max nakładają się na siebie i silnik ma niewiele do pominięcia. Sortowanie według często filtrowanej kolumny może pogrupować podobne wartości, chociaż użyteczny układ zależy od programu zapisującego i projektu tabeli.
Wypychanie (pushdown) zależy również od zachowania silnika i nie gwarantuje, że każdy predykat zostanie obsłużony identycznie. Czytniki mogą ograniczać odrzucanie dla typów zagnieżdżonych lub interpretować typy logiczne w inny sposób. Obsługa słowników i filtrów Blooma również może się różnić. W celu uzyskania szerszych wskazówek na temat optymalizacji zapytań SQL należy powiązać zachowanie pamięci masowej z planem zapytania.
Zasada operacyjna jest prosta: Parquet nie przyspiesza każdego zapytania. Sprawia, że zapytania selektywne są tańsze, gdy układ plików i metadane wspierają odrzucanie (pruning).
Parquet vs CSV, JSON i ORC
Wybór właściwego formatu zależy od zadania. CSV i JSON dobrze sprawdzają się jako formaty wymiany, ponieważ ludzie mogą je sprawdzać, aplikacje mogą je łatwo generować, a interfejsy API powszechnie je akceptują. Powtarzające się skanowania analityczne ujawniają jednak ich ograniczenia: wartości są przechowywane jako tekst, a czytniki zazwyczaj analizują rekordy jeden po drugim.
Parquet idzie na inny kompromis. Przechowuje typowane dane w binarnym, skompresowanym układzie kolumnowym, dzięki czemu silnik może czytać tylko te kolumny, które są potrzebne do zapytania. To sprawia, że jest to doskonały domyślny format dla analitycznych pamięci masowych, podczas gdy otwarcie go w edytorze tekstu lub wysłanie bezpośrednio do odbiorcy oczekującego formatu JSON staje się uciążliwe.
Rurociąg kodowania ma tutaj kluczowe znaczenie. Parquet może wspólnie kodować podobne wartości, stosować techniki słownikowe lub długości serii tam, gdzie to odpowiednie, a następnie kompresować powstałe strony. CSV i JSON zazwyczaj pozostawiają więcej analizy składniowej i wnioskowania o typach czytnikowi. ORC opiera się na podobnym modelu kolumnowym i jest najbliższym odpowiednikiem, szczególnie w środowiskach zorientowanych na Hive.
Parquet posiada bezpośrednie wsparcie w wielu narzędziach, w tym Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena i Redshift, jak opisano w dokumentacji formatu Apache. Wspólne jądro poprawia przenośność, choć nie gwarantuje identycznego zachowania dla każdego typu logicznego, struktury zagnieżdżonej czy funkcji metadanych.
Parquet vs CSV vs JSON vs ORC
Format | Przechowywanie | Szybkość zapytań | Ewolucja schematu | Najlepsze zastosowanie |
|---|---|---|---|---|
Parquet | Kompaktowy, binarny i kolumnowy | Świetny do selektywnych skanów analitycznych | Obsługuje typowane schematy i kompatybilne zmiany strukturalne | Nowoczesne jeziora danych i analityka |
CSV | Tekstowy i wierszowy | Kosztowny przy szerokich lub wielokrotnych skanach | Nieformalna i definiowana zewnętrznie | Prosty eksport i strefy lądowania danych (landing zones) |
JSON | Tekstowy, zagnieżdżony i elastyczny | Analiza składniowa może być kosztowna na dużą skalę | Elastyczna, ale słabo egzekwowana | Interfejsy API, zdarzenia i wymiana danych |
ORC | Kompaktowy, binarny i kolumnowy | Świetna, szczególnie w obciążeniach zorientowanych na Hive | Obsługa schematów typowanych | Środowiska Hadoop zorientowane przede wszystkim na Hive |
Ewolucja schematu nadal wymaga koordynacji. Parquet zapisuje informacje o schemacie w każdym pliku, podczas gdy system tabel lub katalog zazwyczaj uzgadnia wersje w całej kolekcji plików. Dodanie pola dopuszczającego wartości null jest ogólnie łatwiejsze niż zmiana znaczenia lub fizycznej reprezentacji istniejącego pola. Typy logiczne mogą również dawać różne wyniki, jeśli czytniki obsługują je w nierównym stopniu.
Używaj formatów CSV lub JSON, gdy wyjścia potrzebują ludzie, interfejsy API lub proste narzędzia do pozyskiwania danych. Wybierz ORC, gdy kompatybilność z Hive i stos skoncentrowany na ORC decydują o formacie. Wybierz Parquet dla nowoczesnych analitycznych jezior danych i wymiany danych między silnikami, a następnie przetestuj konkretne programy czytające, zapisujące i typy logiczne w swoim środowisku.
Interoperacyjność, bezpieczeństwo i kompromisy w świecie rzeczywistym
Szerokie zastosowanie formatu Parquet może stwarzać mylne wrażenie, że każdy silnik odczytuje każdy plik w identyczny sposób. Spark, DuckDB, Trino, BigQuery, Athena i Polars ogólnie zgadzają się co do podstawowego układu, ale mogą się różnić w kwestii typów zagnieżdżonych, typów logicznych, takich jak UUID i JSON, precyzji dziesiętnej, indeksów stron oraz znaczenia statystyk w stopce.
Stwarza to praktyczny scenariusz awarii: jeden program zapisujący generuje prawidłowy plik, podczas gdy inny czytnik nie obsługuje konkretnej użytej funkcji. Plik może otworzyć się pomyślnie w jednym narzędziu i ulec awarii, obniżyć wersję typu lub zignorować optymalizację w innym. Strona stanu implementacji Apache wyraźnie pokazuje te różnice. Pokazuje ona różne zestawy funkcji w poszczególnych implementacjach, w tym Parquet Java osiągający wersję 1.16.0 we wrześniu 2025 r., podczas gdy Arrow Rust, Hyparquet, DuckDB i Polars śledzą różne wersje funkcji.
Wsparcie silnika to kwestia kompatybilności
Silnik | Typy zagnieżdżone | Użycie statystyk | Załatana podatność CVE-2025-30065 |
|---|---|---|---|
Spark | Szerokie wsparcie, zależne od funkcji | Używa obsługiwanych statystyk i ścieżek odrzucania (pruning) | Zweryfikuj wdrożoną zależność Parquet |
DuckDB | Silne wsparcie analityczne, zależne od funkcji | Używa obsługiwanych metadanych plików | Zweryfikuj wdrożoną kompilację i zależności |
Trino | Szerokie wsparcie dla konektorów | Zachowanie zależy od wersji konektora i czytnika | Zweryfikuj wdrożoną zależność |
BigQuery | Odczytuje Parquet bezpośrednio | Zachowanie zarządzane przez usługę | Potwierdź aktualne wytyczne dotyczące usługi |
Athena | Odczytuje Parquet bezpośrednio | Obsługuje kompatybilne funkcje odrzucania w odpowiednich konfiguracjach tabel | Potwierdź aktualne wytyczne dotyczące usługi |
Polars | Odczytuje Parquet poprzez swoją implementację | Obsługa funkcji różni się w zależności od wersji | Zweryfikuj wdrożoną zależność |
Bezpieczeństwo zasługuje na taką samą uwagę jak interoperacyjność. W kwietniu 2025 r. krytyczna podatność na błędy deserializacji CVE-2025-30065 dotknęła bibliotekę parquet-java. Wytyczne dotyczące bezpieczeństwa ostrzegały zespoły przed używaniem niezaufanych plików i zalecały aktualizację do wersji Parquet 1.15.1, co odnotowano w wytycznych dotyczących implementacji i bezpieczeństwa Apache.
To zmienia odpowiedź na pytanie: „Czy mogę bezpiecznie odczytać dowolny plik Parquet w dowolnym narzędziu?”. Nie. Traktuj pliki z niezaufanych źródeł lub od stron trzecich jako potencjalnie niebezpieczne. Zastosuj poprawki w odpowiedniej bibliotece, izoluj czytniki tam, gdzie to stosowne, unikaj ślepego akceptowania zdalnych schematów i przejrzyj zachowanie opcjonalnych metadanych oraz indeksów stron przed włączeniem zaawansowanych funkcji. Czytnik działający w piaskownicy (sandbox) może zmniejszyć promień rażenia, ale nie zastępuje zarządzania zależnościami.
Koszty kryjące się za wygodą
Parquet ma również kompromisy niezwiązane z bezpieczeństwem:
Częste aktualizacje: Niezmienne pliki analityczne mogą powodować wzmocnienie zapisu (write amplification), gdy rekordy często się zmieniają.
Małe pliki: Wiele małych obiektów zwiększa narzut związany z listowaniem, otwieraniem i metadanymi w magazynie obiektowym.
Szerokie schematy: Metadane stopki mogą znacznie wzrosnąć, gdy pliki zawierają wiele kolumn i grup wierszy.
Debugowanie: Uszkodzone pliki binarne są trudniejsze do zbadania niż niepoprawnie sformatowane pliki CSV.
Luki w silnikach: Funkcja obsługiwana przez jedną implementację może zostać zignorowana lub odrzucona przez inną.
Zespoły muszą również wziąć pod uwagę wymogi dotyczące rezydentności danych przy wyborze lokalizacji przechowywania, czytników i ścieżek przetwarzania. Parquet usprawnia fizyczne przechowywanie i wzorce dostępu, ale sam z siebie nie rozwiązuje kwestii ładu danych (governance), izolacji ani kontroli regulacyjnej.
Praktyczne wskazówki dotyczące obciążeń analitycznych
Niezawodna konfiguracja Parquet zaczyna się od układu plików, a nie od dostrajania kodeków. W przypadku wielu chmurowych obciążeń analitycznych warto celować w grupy wierszy o rozmiarze od 128 MB do 256 MB i strony o rozmiarze bliskim 1 MB, jak pokazano w tym poradniku optymalizacji Parquet. Są to punkty wyjścia, a nie gwarancje. Przeprowadź testy z silnikiem, magazynem obiektowym i typami zapytań, z których korzysta Twój zespół.
Praktyczna lista kontrolna układu
Wybieraj grupy wierszy celowo: Zbalansuj ukierunkowane odczyty z narzutem metadanych i zachowaniem żądań magazynu obiektowego.
Utrzymuj umiarkowany rozmiar stron: Rozmiar strony bliski 1 MB to rozsądny punkt odniesienia dla kompresji i filtrowania na poziomie strony.
Sortuj przydatne kolumny filtrów: Pola
event_timeiuser_idmogą przynieść korzyści, gdy zapytania filtrują selektywnie, a wartości grupują się na stronach.Unikaj bezmyślnego sortowania: Sortowanie zwiększa nakład pracy przy zapisie, dlatego traktuj priorytetowo kolumny, które pojawiają się w ważnych predykatach.
Partycjonuj z umiarem: Partycje oparte na datach lub kategoriach są często łatwiejsze w zarządzaniu niż klucze o wysokiej kardynalności, które tworzą nadmierną liczbę katalogów.
Kompaktuj małe pliki: Tabela z wieloma malutkimi obiektami Parquet może działać słabo, nawet jeśli każdy plik z osobna jest poprawnie sformułowany.
Kompresja powinna być dostosowana do obciążenia pracą. Snappy to rozsądny wybór zorientowany na szybkość. ZSTD jest przydatny, gdy liczy się redukcja zajmowanego miejsca i dostępna jest wolna moc procesora. GZIP może nadal nadawać się do zachowania kompatybilności ze starszymi systemami, ale rzadko jest pierwszym wyborem w przypadku interaktywnej analityki, gdy obsługiwane są szybsze kodeki.
Parquet nie jest dobrym rozwiązaniem dla każdego zbioru danych. Małą tabelę referencyjną o rozmiarze poniżej kilku megabajtów może być łatwiej udostępnić jako CSV lub zapisać w małej bazie danych. Format ten przynosi korzyści wtedy, gdy powtarzające się skany analityczne, wybór kolumn, kompresja i przetwarzanie rozproszone przewyższają koszty stosowania narzędzi binarnych i zarządzania plikami.
Kwestie dotyczące governance i sztucznej inteligencji
Wymuszaj schematy na etapie zapisu, rejestruj wersje programów zapisujących i czytających oraz testuj reprezentatywne pliki na silnikach, z których korzystają odbiorcy. Użyj formatu Iceberg lub Delta Lake, gdy potrzebujesz transakcji na poziomie tabeli, migawek i zarządzanej ewolucji schematu. Parquet pozostaje użyteczną fizyczną warstwą wymiany między rurociągami szkoleniowymi a magazynami cech, ale nie należy go mylić z kompletnym systemem governance.
W przypadku zespołów zarządzających wieloma zbiorami danych Parquet, Observability powinno obejmować więcej niż tylko sam fakt istnienia plików. Monitoruj zmiany schematów, Timeliness dostarczania, walidację rekordów oraz metryki biznesowe, aby technicznie czytelny plik nie stał się analitycznie niewiarygodny. digna zapewnia funkcje jakości danych bezpośrednio w bazie danych, Timeliness, wykrywanie anomalii, walidację, śledzenie schematów oraz Observability platformy, które mogą być stosowane, gdy dane pozostają w środowisku klienta.
Zasada działania: Zoptymalizuj układ plików pod kątem filtrów uruchamianych przez użytkowników, a następnie zweryfikuj wynik w każdym istotnym silniku.
Jeśli Twoje jezioro danych zawiera pliki Parquet, ale nie możesz łatwo śledzić dryfu schematu, opóźnionych danych lub zmieniających się zachowań danych, odwiedź stronę digna, aby zobaczyć, jak Observability wewnątrz bazy danych może monitorować te ryzyka w Twoim własnym środowisku. Zacznij od modułu, który odpowiada na Twój natychmiastowy problem z niezawodnością, a następnie rozwijaj go w miarę wzrostu obciążeń analitycznych i AI.
Najczęściej zadawane pytania
Czym jest Parquet?
To kolumnowy format plików dla danych analitycznych. Kluczowa idea to organizacja fizyczna: wartości z tej samej kolumny leżą razem, dzięki czemu silnik zapytań czyta tylko kolumny dotknięte obliczeniem, zamiast parsować całe wiersze w całym pliku.
Dlaczego Parquet jest szybszy od CSV w analityce?
Dzięki temu, co potrafi pominąć. Średnia grupowana po dużym pliku CSV zmusza silnik do parsowania wierszy i oglądania pól, których obliczenie nigdy nie użyje, a układ kolumnowy pozwala odczytać wyłącznie potrzebne kolumny; typowane i skompresowane składowanie dodatkowo zmniejsza liczbę przenoszonych bajtów.
Gdzie Parquet mieści się w nowoczesnym stosie?
Jako fizyczna warstwa plików. To wydajny format lądowania przy pobieraniu danych, podstawowy format pliku w magazynie obiektowym i warstwa pod formatami tabel takimi jak Iceberg czy Delta Lake, pozostając przy tym bezpośrednio czytelnym dla wielu silników analitycznych.
Jakie obciążenia pasują do niego najlepiej?
Powtarzają się cztery: jeziora danych w chmurze, gdzie pliki w magazynie obiektowym odpytuje się bez ładowania każdego pola; analityczne tabele faktów skanowane przez Spark, Trino lub Presto; eksporty operacyjne publikujące kopię analityczną; oraz cechy uczenia maszynowego wymieniane jako typowane, skompresowane pliki zamiast wielokrotnie parsowanego CSV lub JSON.
Czy Parquet jest formatem systemu źródłowego?
Nie, zwykle jest celem eksportu, a nie miejscem powstawania danych. Aplikacje, interfejsy API i operacyjne bazy danych pozostają systemami źródłowymi, a Parquet staje się analityczną kopią, którą te systemy publikują dla silników zapytań, BI i uczenia maszynowego.



