Jak ocenić jakość danych: praktyczny przewodnik dla zespołów
|
6
min. czyt.

Spadek jakości danych da się wyczuć na długo, zanim ktokolwiek zgłosi ticket. Dashboard się odświeżył, pipeline zgłosił sukces, a liczby nadal nie zgadzają się z finansami, sprzedażą ani z tym, czego oczekiwał biznes. Zwykle właśnie wtedy zespoły uświadamiają sobie, że problemem nie jest to, czy dane dotarły, ale czy można im bezpiecznie ufać.
Większość zespołów zaczyna od kontroli świeżości i odsetka wartości null, ponieważ łatwo je zautomatyzować. Te kontrole są ważne, ale nie mówią, czy kolumna z dnia na dzień zmieniła znaczenie, czy źródło zaczęło duplikować rekordy, ani czy czysto wyglądający zbiór danych nadal jest błędny dla decyzji, którą wspiera. Dlatego ocenę jakości danych trzeba traktować jako diagnostyczny workflow, a nie lampkę statusu, i dlatego błędny raport może pochodzić z „udanego” ładowania.
Spis treści
Dlaczego większość kontroli jakości danych pomija prawdziwy problem
Typowy poranek zaczyna się od zielonego pipeline'u i czerwonego wątku na Slacku. Ładowanie się zakończyło, tabele w hurtowni są wypełnione, a dashboard przychodów na pierwszy rzut oka wygląda dobrze, dopóki ktoś nie zauważy, że suma się nie zgadza, bo źródło zmieniło typ kolumny albo reguła biznesowa przestała pasować do nowego formatu. Pipeline nie zawiódł, ale warstwa decyzyjna już tak.
Właśnie ta luka sprawia, że sukces pipeline'u i jakość danych to nie to samo. Zakończony job dowodzi jedynie, że bajty zostały przeniesione, a nie że rekordy nadal znaczą to samo co wczoraj. Jeśli Wasze kontrole kończą się na świeżości i liczbie wartości null, umkną Wam problemy z dokładnością, sprzeczności między tabelami i dryf schematu, który bez ostrzeżenia psuje dalsze raportowanie.
Praktyczna zasada: jeśli metryka może być błędna, a jednocześnie wyglądać na obecną, potrzebuje kontroli jakości wykraczającej poza samo jej istnienie.
Zespoły sparzają się, gdy mylą observability z oceną jakości. Observability mówi, że coś zmieniło się w przepływie, a ocena pyta, czy dane nadal nadają się do użycia. Ta różnica ma znaczenie w środowiskach regulowanych i w workflow AI, gdzie technicznie czyste dane mogą być operacyjnie niebezpieczne.
Najlepszy wewnętrzny model myślenia jest prosty: obecne dane to nie to samo co wiarygodne dane. Tej granicy muszą bronić Wasze alerty. Jeśli analizujecie lukę między hałaśliwymi dashboardami a kontrolami, na podstawie których można działać, ujęcie bogaci w dane, ubodzy w informacje jest przydatnym uzupełnieniem, bo opisuje dokładnie ten tryb awarii, z którym wiele zespołów żyje na co dzień.
Definiowanie krytycznych zbiorów danych i wymiarów jakości
Zanim napiszecie choćby jedną kontrolę, zdecydujcie, co jest ważne. Nie każda tabela zasługuje na taką samą uwagę i nie każde pole niesie takie samo ryzyko. Właściwy zakres to część wspólna wpływu na biznes i zależności w dalszych procesach, więc pierwsze pytanie zawsze brzmi: „Co się zepsuje, jeśli ta wartość będzie błędna?”
W środowisku regulowanym najpierw wyznaczyłbym zakres zbioru danych wokół krytycznych workflow, a potem zidentyfikował atrybuty, które faktycznie nimi sterują. Zwykle są to identyfikatory, znaczniki czasu, klucze obce, pola statusu, kody regulacyjne i każda wartość, która trafia do KPI, raportu lub modelu. Gdy zostaną nazwane, zdefiniujcie sześć wymiarów jako mierzalne wymagania, a nie abstrakcyjne ideały.
Wymiar | Co mierzy | Typowy rodzaj progu | Przykład błędu |
|---|---|---|---|
Kompletność | Wymagane wartości są obecne | Ścisły dla pól obowiązkowych, luźniejszy dla tekstu opcjonalnego | Brakuje wymaganego identyfikatora klienta |
Unikalność | Rekordy nie są zduplikowane | Zwykle zerowa tolerancja dla pól kluczowych | Ta sama transakcja trafia dwa razy |
Spójność | Wartości nie są sprzeczne między systemami lub tabelami | Kontrole uzgadniania między źródłami | Status zamówienia różni się w hurtowni i w systemie rozliczeń |
Poprawność | Wartości są zgodne z dozwolonymi formatami, zakresami lub regułami | Jednoznaczne zaliczenie lub niezaliczenie według zdefiniowanych wzorców | Numer identyfikacji podatkowej ma niewłaściwy format |
Dokładność | Wartości zgadzają się z zaufanymi danymi referencyjnymi lub rzeczywistością | Uzgadnianie z autorytatywnymi źródłami | Kod produktu istnieje, ale wskazuje na niewłaściwy artykuł |
Aktualność | Dane są wystarczająco świeże dla zamierzonego zastosowania | Okna świeżości lub oczekiwania co do dostaw | Dzienny plik dociera po terminie zamknięcia raportowania |
Pułapką jest sprowadzenie tego wszystkiego do jednego wyniku. Zbiór danych może być niemal kompletny, a mimo to bezużyteczny, jeśli poprawne wartości są błędne lub nieaktualne. Dlatego progi powinny być ważone ryzykiem, z zerową tolerancją np. dla nieprawidłowego identyfikatora regulacyjnego i pewną elastycznością dla nieistotnego pola opisowego.
Dobry dokument zakresu mieści się na jednej stronie. Jeśli nie potrafi powiedzieć, które tabele są ważne, które pola są krytyczne i dlaczego sprawdzany jest każdy wymiar, program zamieni się w teatr odhaczania pól.
Jeśli potrzebujecie praktycznego sposobu na identyfikację krytycznych pól i przypisanie ich do właścicieli, właściwym punktem wyjścia są krytyczne elementy danych. Dla zespołów, które ustalają zakres wspólnie z działami governance i inżynierii, takie uzgodnienie oszczędza wielu późniejszych dyskusji.
Stosowanie etapowej metodyki oceny
Najczystszym sposobem oceny jakości danych jest ułożenie pracy w kolejności, a nie improwizowanie. Kolejność ma znaczenie, bo każdy etap zasila następny, a pominięcie jednego zamienia cały proces w zgadywanie. Zacznijcie od profilowania, potem zdefiniujcie reguły, ustawcie progi, a na końcu uruchomcie zapytania i przeanalizujcie wyniki.

Najpierw profilujcie, potem przepisujcie
Najpierw sprofilujcie zbiór danych. Przyjrzyjcie się odsetkowi wartości null, odsetkowi duplikatów, zakresom wartości, formatom i relacjom referencyjnym, bo te wzorce pokazują, gdzie naprawdę leżą błędy. Bez tej bazy skończycie na pisaniu reguł na podstawie założeń zamiast dowodów.
Następnie przełóżcie wymagania na testy właściwe dla mierzonego wymiaru. Pole daty potrzebuje reguły formatu i reguły zakresu. Klucz obcy potrzebuje kontroli referencyjnej. Kod regulacyjny może wymagać ścisłego wzorca oraz uzgodnienia ze źródłem prawdy.
Ustawianie progów odzwierciedlających ryzyko
Progi ostrzeżenia i błędu nie powinny być takie same. Pole zasilające dashboard może tolerować niewielki odsetek błędów, natomiast pole napędzające raportowanie zgodności zwykle nie. Na tym rozróżnieniu poległo zbyt wiele programów, bo traktują każdy błąd jednakowo.
Obliczajcie wyniki na poziomie rekordu, pola, tabeli i domeny, a następnie śledźcie ich trend w czasie. Pojedynczy przebieg nie mówi prawie nic. Pogarszający się odsetek błędów wskazuje, że zmieniło się źródło, złamano kontrakt albo zespół na wcześniejszym etapie zmienił sposób działania. Właśnie tu metodyka staje się operacyjna, a nie dekoracyjna.
Chodzi o to, by wcześnie wychwycić paskudny przypadek, w którym zbiór danych jest kompletny w 99%, ale nadal istotnie błędny. Jeśli potrzebujecie odniesienia do terminologii związanej z tym podejściem, pomocnym uzupełnieniem jest definicja oceny jakości danych.
Próbkowanie, walidacja i uczciwe raportowanie
Wynik bez kontekstu to ryzyko. Jeśli pobraliście próbkę 100 rekordów, nigdy nie raportujcie metryki tak, jakby pochodziła z pełnego skanu populacji, ponieważ niepewność jest częścią wyniku. Dla każdej metryki zachowujcie licznik, mianownik, okno obserwacji, definicję populacji i metodę próbkowania, a gdy wynik jest szacowany na podstawie próbki, podawajcie przedziały ufności, co podkreślają wytyczne pomiarowe NIST w części poświęconej niepewności (NIST SP 800-55).

Raportujcie rozkład, nie tylko wynik
Oszacowanie kompletności na podstawie 100 rekordów z próbki to nie to samo co ten sam odsetek z 100 000 rekordów. Pierwsze może być przydatne, ale jest znacznie mniej stabilne i dużo łatwiej je źle odczytać. Śledźcie średnią, odchylenie standardowe, kwantyle i braki danych według segmentów, aby zobaczyć, gdzie problem się koncentruje.
Ta segmentacja ma znaczenie, ponieważ zagregowane wyniki ukrywają lokalne awarie. Tabela może wyglądać dobrze jako całość, podczas gdy jeden kraj, jeden system źródłowy lub jeden segment klientów się sypie. Jeśli nie zachowacie podziału, przeoczycie operacyjną przyczynę źródłową i stracicie czas na spory o liczbę zbiorczą.
Nie mylcie typowych trybów awarii
Poprawność to nie dokładność. Wartość może mieć właściwy format i nadal być błędna. Spóźnione dane to też nie brakujące dane, a automatyczna imputacja może poprawić wygląd kompletności, jednocześnie szkodząc identyfikowalności.
Dlatego raport powinien jasno podawać niepewność, a nie ją ukrywać. Dobry wynik jakościowy mówi, co sprawdzono, jak to sprawdzono, na ile można mu ufać i które części populacji wymagają uwagi.
Dla zespołów budujących część tego workflow odpowiedzialną za pozyskiwanie danych przeglądanie bloków do przechwytywania danych jest przydatnym punktem odniesienia przy myśleniu o dyscyplinie i strukturze danych wejściowych, zwłaszcza gdy systemy źródłowe są chaotyczne. Problemem operacyjnym zwykle nie jest matematyka, lecz uzyskanie wiarygodnych danych wejściowych.
Możecie też przypisać kontrole do jawnych reguł i logiki przeglądu dzięki regułom walidacji danych, kontrolom i ciągłej jakości danych, czyli tam, gdzie raportowanie przestaje być abstrakcyjne i zaczyna wspierać realne działania naprawcze.
Wybór właściwego połączenia narzędzi i automatyzacji
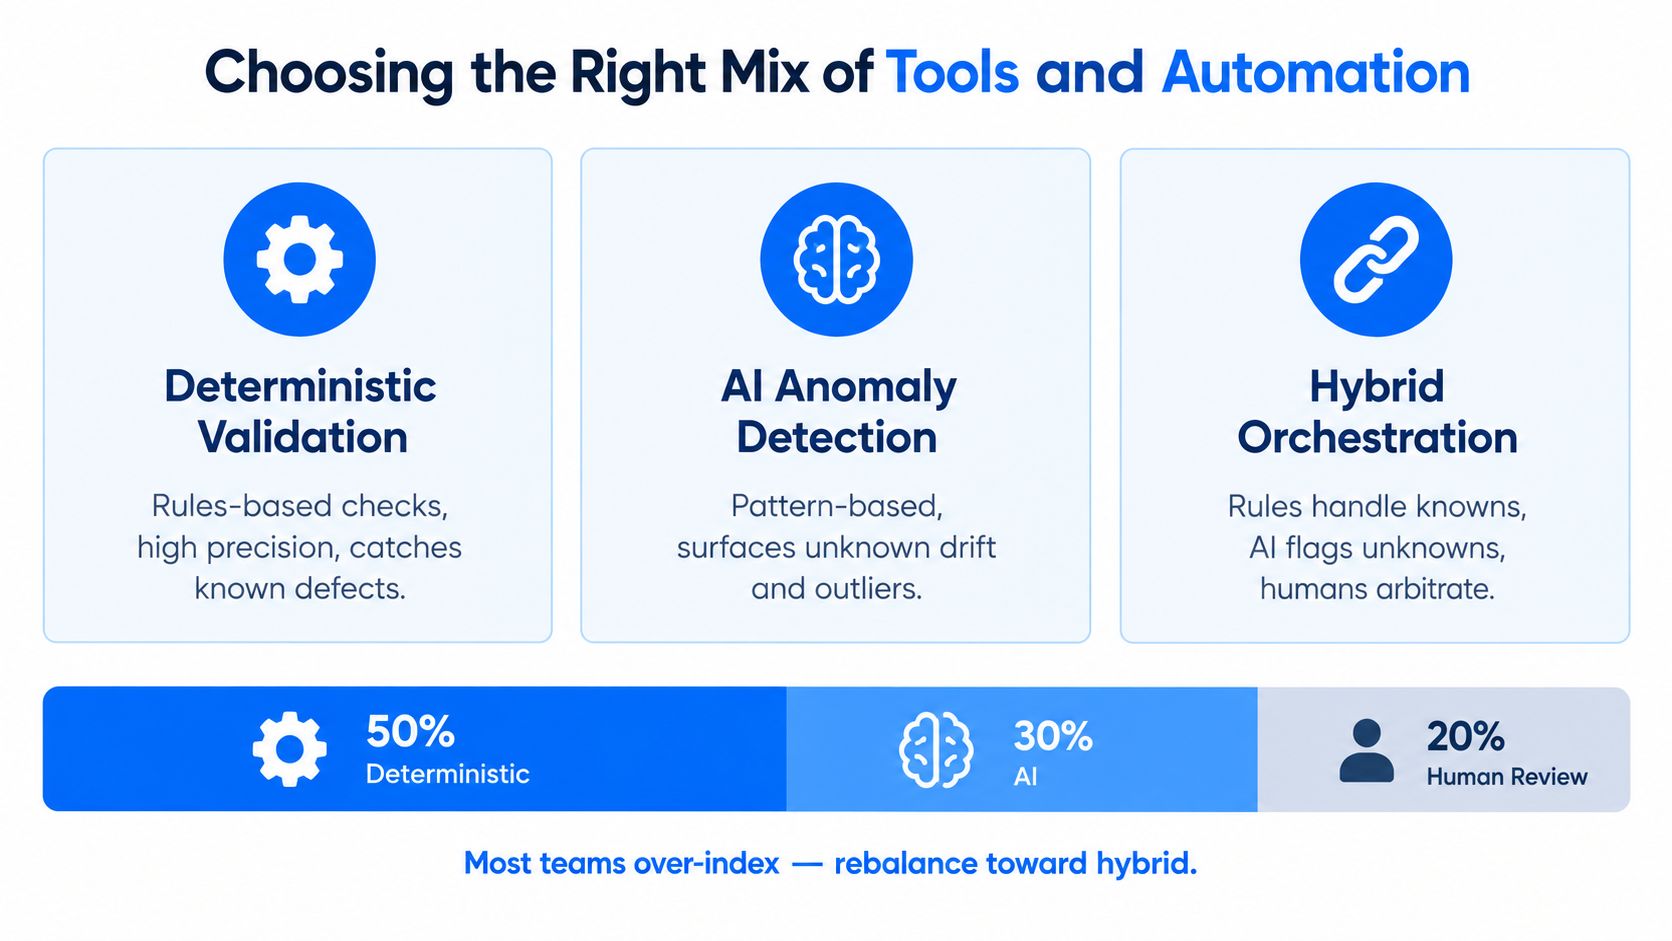
Dobre programy nie stawiają wszystkiego na jeden rodzaj sygnału. Deterministyczna walidacja wyłapuje znane błędy, wykrywanie anomalii oparte na AI wyłapuje nieznane wzorce, a kontrole schematu i aktualności wychwytują ciche awarie, zanim się rozprzestrzenią. Korzystajcie ze wszystkich trzech, ale przypiszcie każdemu problem, z którym radzi sobie najlepiej.
Dopasujcie sygnał do trybu awarii
Walidacja oparta na regułach jest właściwym narzędziem, gdy wymaganie jest jawne i audytowalne. Jeśli kod podatkowy musi mieć określony format albo klucz obcy musi istnieć, napiszcie regułę i zadbajcie o powtarzalność wyniku. To dowód, którego oczekują audytorzy, i najszybszy sposób, by znane błędy nie trafiały do Waszego środowiska danych.
Statystyczne lub oparte na AI wykrywanie anomalii sprawdza się tam, gdzie problemem jest dryf zachowania. Zmiana wzorca wolumenu, rozkładu lub czasu może nie naruszać żadnej sztywnej reguły, a mimo to wskazywać na zmianę w źródle, problem w procesie na wcześniejszym etapie lub złamane założenie. Wyuczone linie bazowe przewyższają w takich przypadkach statyczne kontrole, bo zestaw reguł nie przewidzi każdego nowego trybu awarii.
Nie ignorujcie monitorowania struktury i dostaw
Zmiany schematu i kontrole aktualności zasługują na własne miejsce w stacku. Zmiana typu kolumny, dodane pole lub opóźniona dostawa mogą zepsuć odbiorców w dalszych procesach, zanim zadziała jakakolwiek reguła na poziomie wierszy. To podstawowe kontrole, ale oszczędzają wielu problemów na produkcji.
Kompromis dotyczy governance i miejsca wykonywania. Wykonywanie w bazie danych ogranicza przenoszenie danych i trzyma kontrolę bliżej danych, co ma znaczenie w środowiskach regulowanych. Pomaga też modułowe wdrażanie, bo zespoły muszą zacząć od jednej krytycznej ścieżki i rozszerzać zakres, zamiast kupować gigantyczną platformę, której nigdy w pełni nie uruchomią.
Nie potrzebujecie jednego cudownego narzędzia. Potrzebujecie stacku dopasowanego do profilu ryzyka danych, obciążeń związanych ze zgodnością w zespole i rodzaju awarii, z jakimi mierzy się Wasza firma. Jeśli porównujecie dostawców lub kształtujecie wewnętrzny standard, narzędzia do jakości danych są praktycznym punktem odniesienia dla takiej oceny.
Kiedy czyste dane to nie to samo co bezpieczne dane
Zbiór danych może przejść każdą konwencjonalną kontrolę i nadal być niebezpieczny dla decyzji, którą zasila. W pracy z AI szybko staje się to oczywiste, bo pytanie nie dotyczy tylko tego, czy dane są czyste, ale czy są istotne, reprezentatywne i odpowiednie dla grupy, której dotyczą. Artykuł 10 unijnego AI Act wymaga, by dane treningowe, walidacyjne i testowe systemów wysokiego ryzyka były istotne, wystarczająco reprezentatywne, w możliwie największym stopniu kompletne i wolne od błędów oraz statystycznie odpowiednie dla grup i kontekstów, których dotyczą (AI Act UE, artykuł 10).
Techniczna czystość nie dowodzi przydatności do użycia
Standardowy model sześciu wymiarów tu nie wystarcza. Możecie mieć kompletne, poprawne i unikalne dane, które mimo to niedostatecznie reprezentują grupę mniejszościową, pomijają istotny obszar geograficzny lub odzwierciedlają nieaktualny kontekst operacyjny. Taki zbiór danych może wyglądać na technicznie solidny, a jednocześnie być operacyjnie niebezpieczny.
Praktycznym rozwiązaniem jest dodanie do dokumentacji oceny pokrycia podgrup, przesunięcia rozkładu i opisu zamierzonego zastosowania. W ochronie zdrowia, finansach, telekomunikacji i usługach publicznych nie jest to problem teoretyczny. Zagregowane wyniki jakości mogą wyglądać akceptowalnie, podczas gdy pokrycie lub odsetek błędów dla poszczególnych grup pozostają nie do przyjęcia.
Traktujcie reprezentatywność jako wymaganie operacyjne
Reprezentatywność musi stać się mierzalna, inaczej pozostanie ogólnikiem. Zespoły potrzebują jawnych progów pokrycia podgrup, jasnych reguł określających, kiedy dryf jest uprawnioną zmianą populacji, oraz zapisu, dlaczego zbiór danych nadaje się do konkretnej decyzji. Tylko tak można odróżnić rzeczywiście zmieniającą się populację od szkodliwego błędu próbkowania.
Tu liczy się również odpowiedzialność. Ktoś musi rozstrzygać, czy dane nadal pasują do przypadku użycia, a nie tylko, czy kontrole przeszły. Jeśli zbiór danych jest czysty, ale nieodpowiedni, właściwą odpowiedzią jest zatrzymanie workflow, a nie świętowanie dashboardu.
Raportowanie wyników i operacjonalizacja workflow
Raport powinien mówić interesariuszom, co sprawdzono, co nie przeszło, na ile zespół jest pewny wyniku i kto odpowiada za kolejny krok. Uwzględnijcie zakres, testowane wymiary, progi, podział na segmenty, wyniki z niepewnością, status działań naprawczych oraz jasno wskazanego właściciela każdego nierozwiązanego problemu. Jeśli potrzebujecie praktycznego wzorca dokumentacji operacyjnej, poradniki od Trupeer Inc. są dobrym przykładem, jak zapisać kroki procesu czytelnie i bez nadmiernej komplikacji.
Zadbajcie o powtarzalność workflow
Najbardziej niezawodne programy zamieniają ocenę w harmonogram, a nie jednorazowy projekt. Planujcie cykliczne oceny, wersjonujcie reguły i progi, ustawiajcie alerty na pogorszenie i regularnie omawiajcie wyniki z interesariuszami. Jest to zgodne z modelem governance normy ISO 8000, w którym normy są przeglądane co pięć lat, a kontrola jakości jest częścią bieżącego zarządzania, a nie jednorazowym wydarzeniem certyfikacyjnym (ISO 8000-1:2022).
Checklista do runbooka: wyznaczcie krytyczne zbiory danych, sprofilujcie dane, zdefiniujcie reguły, ustawcie progi ostrzeżenia i błędu, uruchomcie zapytania, śledźcie trend wyników, raportujcie niepewność i powtarzajcie ocenę według harmonogramu.
Unikajcie dashboardów dla próżności. Unikajcie lawiny alertów. Jedno i drugie prowadzi do tego samego: ludzie przestają ufać programowi. Workflow jakości działa tylko wtedy, gdy sygnały są na tyle konkretne, by można było na nie reagować, i na tyle stabilne, by jednocześnie wspierać audyt, inżynierię i analitykę.
Jeśli szukacie platformy, która działa w Waszym własnym środowisku i łączy walidację na poziomie rekordów, monitorowanie aktualności, śledzenie schematów i wykrywanie anomalii, digna jest jedną z opcji wartych oceny dla takiego modelu operacyjnego. Odwiedźcie digna, aby zobaczyć, jak jej podejście do jakości danych i observability pasuje do krytycznych zbiorów danych, środowisk regulowanych i workflow gotowych na AI.
W części tego stacku opartej na wyuczonych liniach bazowych zobaczcie, jak moduł digna Data Anomalies wychwytuje zmiany wolumenu, rozkładu i czasu, których nie przewidziała żadna ręcznie napisana reguła.
Najczęściej zadawane pytania
Jak krok po kroku ocenić jakość danych?
Jakość danych ocenia się w stałej kolejności: wyznaczenie krytycznych zbiorów danych, profilowanie danych, zdefiniowanie reguł dla każdego wymiaru, ustawienie progów ostrzeżenia i błędu, uruchomienie zapytań i śledzenie trendu wyników. Profilowanie jest pierwsze, bo odsetek wartości null, duplikaty i zakresy wartości pokazują, gdzie naprawdę leżą błędy, więc reguły opierają się na dowodach.
Jakie sześć wymiarów służy do pomiaru jakości danych?
Sześć wymiarów to kompletność, unikalność, spójność, poprawność, dokładność i aktualność. Każdy powinien być mierzalnym wymaganiem z własnym rodzajem progu, na przykład zerową tolerancją dla zduplikowanych pól kluczowych albo oknem świeżości dla dziennego pliku, który musi dotrzeć przed terminem zamknięcia raportowania.
Dlaczego udany pipeline może dostarczyć złe dane?
Zakończony job dowodzi jedynie, że bajty zostały przeniesione, a nie że rekordy nadal znaczą to samo co wczoraj. Źródło może zmienić typ kolumny lub zacząć duplikować rekordy, podczas gdy ładowanie wciąż świeci na zielono, więc kontrole ograniczone do świeżości i liczby wartości null pomijają problemy z dokładnością, sprzeczności między tabelami i dryf schematu.
Jak raportować wyniki jakości danych uzyskane z próbki?
Wyniki z próbki zawsze powinny zawierać informację o niepewności. Dla każdej metryki zachowujcie licznik, mianownik, okno obserwacji, definicję populacji i metodę próbkowania oraz podawajcie przedziały ufności, ponieważ oszacowanie kompletności na podstawie 100 rekordów z próbki jest znacznie mniej stabilne niż ten sam odsetek z 100 000 rekordów.
Czy czyste dane są zawsze bezpieczne dla AI?
Nie, czyste dane mogą być niebezpieczne, jeśli niedostatecznie reprezentują jakąś grupę, pomijają obszar geograficzny lub odzwierciedlają nieaktualny kontekst. Artykuł 10 unijnego AI Act wymaga, by dane treningowe systemów wysokiego ryzyka były istotne i wystarczająco reprezentatywne, dlatego ocena powinna obejmować pokrycie podgrup, przesunięcie rozkładu i opis zamierzonego zastosowania.


