Konwersja timestamp na datetime: kompletny przewodnik
|
6
min. czyt.

1700000000 to nie datetime, tylko maszynowy timestamp. Aby bezpiecznie go przekonwertować, najpierw ustal jednostkę, znormalizuj wartość do UTC, a dopiero potem wyświetl wynik z jawnym kontekstem strefy czasowej - inaczej uszkodzisz rekord.
Zepsuty dashboard o 8:05 rano zwykle wcale nie wygląda na zepsuty. Wykres się ładuje, batch się kończy, a eksport rozliczeń dociera na czas, ale jeden zespół czyta sekundy jako milisekundy, drugi zakłada czas lokalny, a trzeci formatuje moment w czasie bez zachowania oryginalnej wartości. W tej luce między maszynowymi timestampami a czytelnymi dla człowieka datami i godzinami kryje się większość problemów produkcyjnych.
Spis treści
Dlaczego konwersje timestampów zawodzą na produkcji
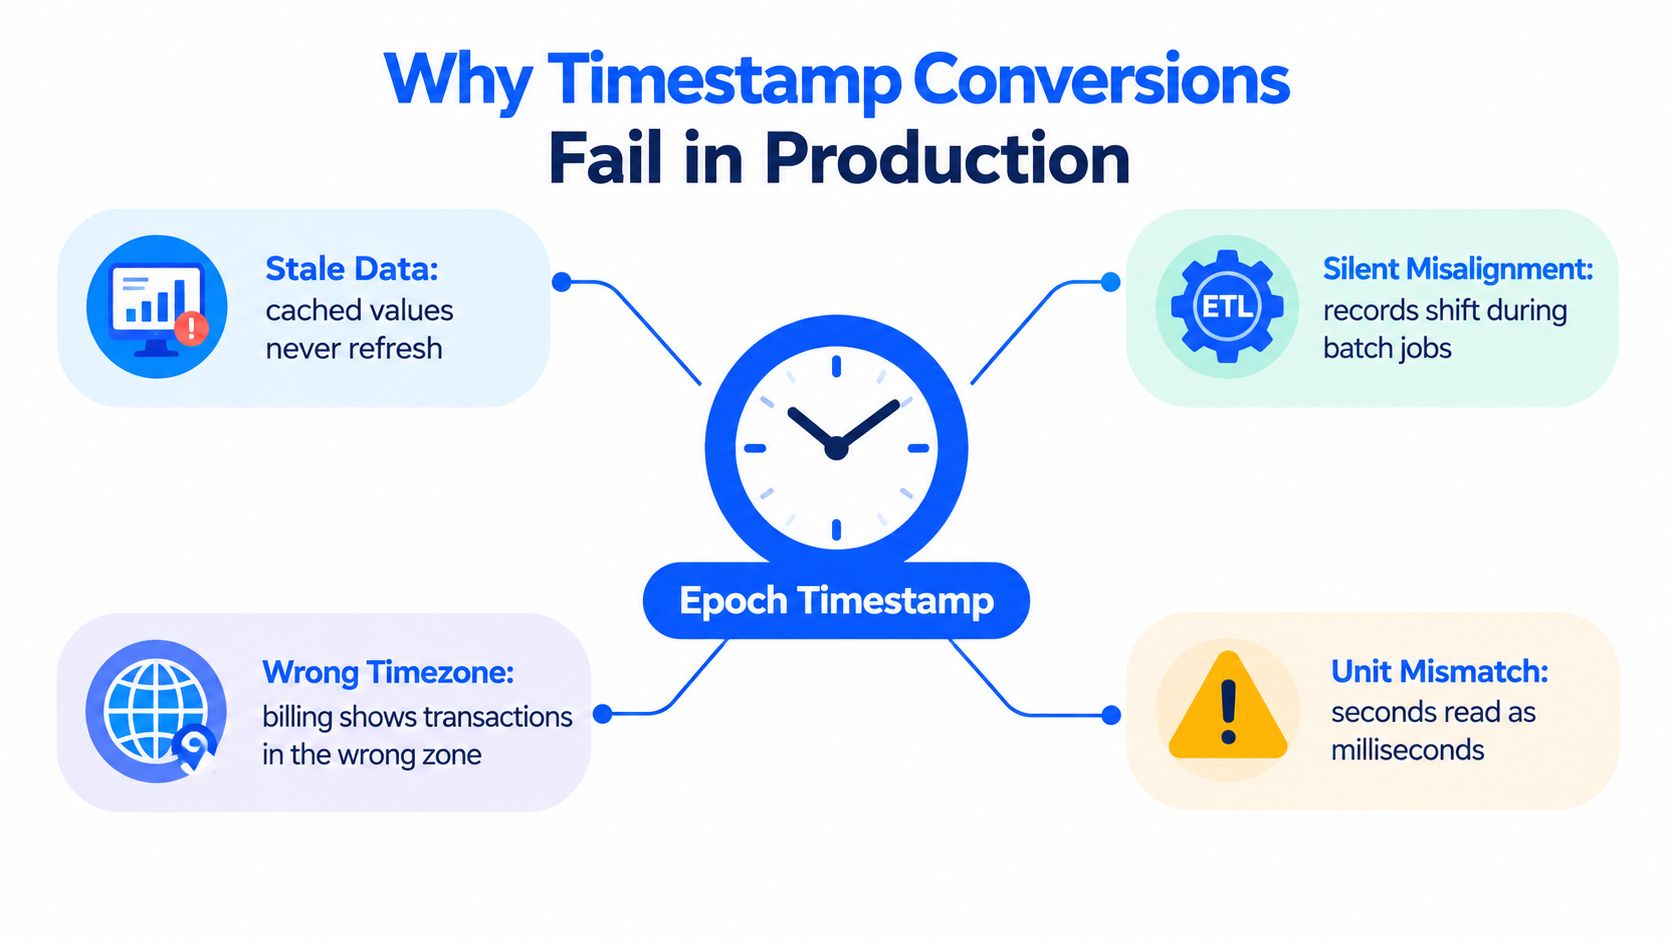
Dashboard pokazujący wczorajsze liczby, przebieg ETL przesuwający rekordy o jeden dzień albo wyciąg rozliczeniowy, który trafia do niewłaściwego regionu, zwykle wskazują na jedną przyczynę: niejednoznaczne znaczenie timestampu. Timestamp Unix wskazuje moment względem epoki Unix, czyli 00:00:00 UTC 1 stycznia 1970 r., ale sama liczba nie mówi, jak ją wyświetlić. Te same cyfry mogą oznaczać niewłaściwy moment, jeśli jeden system czyta sekundy, a drugi milisekundy, albo jeśli lokalna strefa czasowa serwera wkradnie się do kroku konwersji. Konwencja Unix traktuje też każdy dzień cywilny jako dokładnie 86 400 sekund logicznych, więc arytmetyka pozostaje prosta, ale sekundy przestępne i reguły stref czasowych nadal mają znaczenie, gdy wynik ogląda człowiek. (Materiał NASA o sekundach przestępnych)
Co psuje się najpierw
Pierwszym błędem jest zwykle niezgodność jednostek. Wartość, którą należy odczytać jako sekundy, zostaje zinterpretowana jako milisekundy, a wynikowy datetime ląduje w okolicach 1970 r. albo daleko poza oczekiwanym zakresem. Drugim błędem jest dryf strefy czasowej: timestamp zostaje poprawnie zdekodowany, ale wyświetlony w niewłaściwym kontekście lokalnym.
Praktyczna zasada: traktuj surową wartość liczbową jako źródło prawdy, a sformatowany datetime jako warstwę prezentacji.
Trzeci błąd ukrywa się w wymianie danych między systemami. Jedna usługa zapisuje UTC, inna odczytuje wartość naiwną jako czas lokalny, a pipeline nadal „działa”, bo wynik wygląda na tyle wiarygodnie, że przechodzi pobieżną kontrolę. Czwarty błąd dotyczy polityki sekund przestępnych, ponieważ zwykły czas POSIX ignoruje wstawione sekundy UTC i nie potrafi jednoznacznie przedstawić 23:59:60. Ryzyko nie ogranicza się do ładnych wyświetleń. Ujawnia się przy granicach okresów rozliczeniowych, osiach czasu incydentów i w każdym zbiorze danych, w którym liczy się kolejność. Dlaczego wczesne awarie pipeline'ów są na początku często niewidoczne to przydatne spojrzenie na takie ciche błędy w sąsiednich przepływach danych.
Jak wygląda poprawny model myślowy
Właściwa kolejność jest prosta, ale każdy krok ma znaczenie. Po pierwsze, ustal jednostkę i kontrakt semantyczny. Po drugie, znormalizuj wartość do bezwzględnego momentu w czasie. Po trzecie, wyświetl ten moment w UTC lub w nazwanej strefie cywilnej, i to dopiero wtedy, gdy wynik jest potrzebny. Jeśli pominiesz którykolwiek z tych kroków, nie konwertujesz już timestampu na datetime, tylko zgadujesz.
Konwersja timestampów w popularnych systemach
Najbezpieczniejsze są konwersje, które w kodzie jasno pokazują jednostkę i strefę czasową. Python, JavaScript i SQL mają własne ustawienia domyślne i właśnie od nich zaczynają się błędy produkcyjne. Jeśli ustandaryzujesz jawną konwersję uwzględniającą strefę czasową, ta sama surowa wartość pozostanie odtwarzalna na serwerach, w jobach i notebookach.
Python
Biblioteka standardowa Pythona oferuje czysty wzorzec: datetime.fromtimestamp(value, tz=timezone.utc) do konwersji świadomej UTC, a następnie astimezone(target_zone) tylko wtedy, gdy potrzebna jest nazwana strefa lokalna. Jeśli pominiesz tz, Python użyje czasu lokalnego platformy i zwróci naiwny datetime - i tak ten sam kod zaczyna działać inaczej na różnych hostach. Dlatego jawny krok UTC jest bezpieczniejszym wyborem domyślnym. Oficjalna dokumentacja datetime opisuje także podział na obiekty naiwne i świadome oraz zalecane użycie timezone.utc. (Dokumentacja datetime w Pythonie)
JavaScript
Obiekt Date w JavaScripcie przechowuje milisekundy od epoki Unix, więc sekundy Unix trzeba przed konwersją pomnożyć przez 1000. Operacja odwrotna wymaga dzielenia przez 1000, a gdy ma to znaczenie, należy zachować precyzję ułamkową. Drugą pułapką jest wybór akcesora, ponieważ przechowywanie w UTC nie powstrzymuje akcesorów lokalnych przed odczytem przez strefę czasową maszyny hosta. Dokumentacja MDN obiektu Date (po angielsku) dobrze przypomina, by tę różnicę utrzymywać jawnie.
SQL i silniki hurtowni danych
Silniki SQL się różnią, więc najbezpieczniej jest sprawdzić typ docelowy i zachowanie strefy czasowej, zamiast zakładać, że jeden silnik działa jak drugi. PostgreSQL rozróżnia precyzję timestampów i obsługuje rozdzielczość ułamkową, a ClickHouse udostępnia osobne funkcje dla sekund, milisekund i mikrosekund. W praktyce nie chodzi o zapamiętanie każdej nazwy funkcji, lecz o to, by przechowywany typ odpowiadał jednostce źródłowej, a strefa wyświetlania była wybrana świadomie. Dokumentacja PostgreSQL dotycząca dat i godzin jest szczególnie przydatna, gdy trzeba przemyśleć obsługę precyzji i ułamków sekund. (Typy daty i czasu w PostgreSQL)
Dla zespołów pracujących z różnymi formatami plików i ingestią do hurtowni ważne są formaty plików Parquet, ponieważ pola timestampów często przechodzą przez systemy o różnych oczekiwaniach co do precyzji. Datetime, który w jednym silniku wygląda dobrze, może stracić znaczenie, gdy parser w dalszej części przyjmie inną jednostkę lub obetnie ułamki sekund.
Obsługa stref czasowych poza podstawową konwersją
Dekodowanie epoki i konwersja strefy czasowej rozwiązują różne problemy. Dekodowanie odpowiada na pytanie, jaki moment reprezentuje rekord. Konwersja odpowiada na pytanie, jak ten moment powinien wyglądać w konkretnym miejscu i kontekście historycznym. Systemy, które zacierają te kroki, tworzą lokalne daty poprawne w jednym środowisku i błędne w innym. Baza stref czasowych IANA istnieje, ponieważ historia stref czasowych zmienia się w zależności od miejsca i w czasie. Zapisuje reguły czasu lokalnego i aktualizuje je, gdy rządy zmieniają przesunięcia i zasady czasu letniego.
Dlaczego stałe przesunięcia zawodzą
Stałe przesunięcie opisuje jeden moment, ale nie reguły, które za nim stoją. America/New_York to nie to samo co UTC-5, ponieważ nazwana strefa obejmuje zmiany czasu letniego i historyczne modyfikacje, a przesunięcie nie. Jeśli zapiszesz tylko przesunięcie, tracisz tożsamość lokalizacji wraz z powiązanymi z nią zmianami reguł.
Python obsługuje to poprawnie za pomocą tzinfo, który przechowuje razem przesunięcie i zachowanie strefy. Bezpieczniejszy wzorzec to najpierw dekodowanie w UTC, a potem konwersja do nazwanej strefy na granicy wyświetlania. Dołączenie etykiety strefy czasowej do naiwnego datetime to reinterpretacja, a nie konwersja.
Lokalna godzina zegarowa może się powtórzyć przy zmianie czasu na zimowy i zniknąć przy zmianie na letni.
Dlaczego JavaScript wymaga szczególnej ostrożności
Obiekt Date w JavaScripcie wewnętrznie opiera się na UTC, ale jego zwykłe akcesory komponentów używają lokalnej strefy czasowej maszyny hosta. Notebook do debugowania na laptopie i kontener produkcyjny w innym regionie mogą pokazywać różne pola lokalne dla tego samego momentu. Timestamp nadal jest poprawny. Zmienia się ścieżka wyświetlania, a to wystarczy, by powstały mylące błędy. W deterministycznych pipeline'ach używaj akcesorów UTC lub biblioteki świadomej stref czasowych i nie polegaj na ustawieniach domyślnych maszyny.
Audytowalność to część obsługi stref czasowych
Praca ze strefami czasowymi to nie tylko formatowanie. Systemy obsługujące finanse, ochronę zdrowia czy raportowanie transgraniczne muszą przechowywać razem oryginalny moment, wybraną strefę i status konwersji jako pola metadanych, które podróżują z rekordem, a nie obok niego w notatce w notebooku czy komentarzu w tickecie.
To rozdzielenie ma znaczenie na produkcji. Bez oryginalnego momentu nie udowodnisz, co zostało odebrane. Bez statusu konwersji nie stwierdzisz, czy wartość została znormalizowana, wyświetlona, czy później zinterpretowana na nowo.
Precyzja, wykrywanie jednostek i cicha utrata danych
Konwersja timestampu na datetime może zmienić coś więcej niż wyświetlanie. Może zniszczyć precyzję, zatrzeć kolejność zdarzeń i ukryć różnicę między dwoma rekordami, które wydarzyły się w tej samej wyświetlanej sekundzie, ale nie w tym samym momencie. Dlatego wykrywanie jednostek trzeba traktować jak kontrakt schematu, a nie zgadywanie na podstawie liczby cyfr. Praktyki dokładności w jakości danych są tu szczególnie istotne, bo błędnie dobrana precyzja nadal wygląda na „poprawną” dla systemów w dalszej części.
Dlaczego liczenie cyfr to pułapka
Długa liczba całkowita nie mówi, czy źródło podaje sekundy, milisekundy, mikrosekundy czy nanosekundy. Wartość 13-cyfrowa może w jednym strumieniu oznaczać milisekundy, a inny system może używać zupełnie innej skali. Jeśli podzielisz przez 1000, bo liczba „wygląda” na milisekundy, możesz uzyskać wiarygodny datetime, który jest subtelnie błędny.
PostgreSQL obsługuje precyzję timestampu od zera do sześciu cyfr ułamkowych, co dobrze pokazuje, dlaczego to ważne. Jeśli źródło zawiera mikrosekundy, a cel przechowuje tylko wartości z dokładnością do sekundy, tracisz informacje o kolejności, mimo że wynik wyświetla się poprawnie. Ta strata może wpłynąć na deduplikację, pomiar opóźnień, korelację incydentów i ścieżki audytu.
Co trzeba zachować
Przechowuj oryginalną wartość liczbową. Przechowuj jednostkę źródłową. Przechowuj docelową precyzję. Czytelny datetime wyświetlaj dopiero wtedy, gdy te wartości są jawne. Jeśli źródło używa ułamków sekund, zachowaj je w formie, która nie zaokrągla przez liczby zmiennoprzecinkowe, chyba że twój system może tolerować tę stratę.
Czytelny wynik jest przydatny dla ludzi, ale może ukryć operacyjną prawdę, że dwa zdarzenia były odrębne.
Timestampy w stylu POSIX również wymagają ostrożnego opisu. Są wygodne w arytmetyce, bo każdy dzień traktuje się jako 86 400 sekund, ale nie są idealnym zegarem fizycznym i nie liczą osobno sekund przestępnych. To rozróżnienie ma znaczenie w systemach observability, w których pipeline może musieć odróżnić „tę samą wyświetlaną sekundę” od „tego samego zdarzenia źródłowego”.
Budowa produkcyjnego pipeline'u timestampów
Produkcyjny pipeline powinien za każdym razem działać w tej samej kolejności. Najpierw sparsuj surową wartość i potwierdź jednostkę źródłową. Zwaliduj rząd wielkości, precyzję i dopuszczalność wartości null względem kontraktu. Znormalizuj do UTC. Konwertuj do nazwanej strefy lokalnej tylko na potrzeby prezentacji. Zwracaj jawny format, taki jak ISO 8601 z Z lub przesunięciem. Ta sekwencja sprawia, że ten sam rekord nie zmienia znaczenia, przechodząc między usługami.

Workflow, który sprawdza się na produkcji
Zacznij od kontraktu, zanim dotkniesz formatera. Pole timestampu powinno deklarować, czy zawiera sekundy, milisekundy czy inną jednostkę oraz czy reprezentuje UTC, czy lokalny czas cywilny. Umieść tę deklarację w dokumentacji schematu, w kontrolach pipeline'u i w fixture'ach testowych, aby parser i recenzent oceniali to samo.
Znormalizuj moment przed jakimkolwiek formatowaniem do wyświetlenia. JavaScript wymaga jawnego mnożenia lub dzielenia wokół przechowywania Date w milisekundach. Python powinien najpierw tworzyć świadome obiekty datetime w UTC. SQL powinien używać typów uwzględniających strefę czasową i unikać cichych rzutowań zależnych od ustawień sesji. Dopiero potem konwertuj do strefy biznesowej, i to tylko wtedy, gdy odbiorca w dalszej części potrzebuje prezentacji lokalnej.
Zespoły porównujące elementy orkiestracji i hurtowni danych mogą traktować komponenty nowoczesnego pipeline'u danych jako punkt odniesienia dla ruchomych części. Praktyczna zasada jest prostsza: każdy etap powinien przenosić surową wartość, jednostkę źródłową, strefę prezentacji i wynik walidacji. Dzięki temu można diagnozować problemy bez ponownego uruchamiania całego pipeline'u.
Oryginalny liczbowy timestamp nie powinien nigdy znikać tylko dlatego, że datetime został wyświetlony w raporcie. Zachowaj oba. Jeden to pole audytowe, drugi to warstwa wyświetlania. Kontrole jakości pipeline'ów danych są najskuteczniejsze, gdy oba przetrwają każdy etap.
Walidacja konwersji testami przypadków brzegowych
Błędy timestampów ujawniają się na krańcach. Wartości, które dobrze wyglądają w szybkim demo, często zawodzą na produkcji, więc zestaw testów musi celowo trafiać w niewygodne przypadki. Uwzględnij zero, ujemne wartości sprzed epoki, ułamki sekund, wartości null, ciągi nienumeryczne i timestampy w pobliżu zmian czasu. Ten sam zestaw powinien obejmować też maksymalne obsługiwane daty blisko limitów systemu oraz sprawdzać, czy akcesory UTC w JavaScripcie pozostają spójne z akcesorami lokalnymi w różnych środowiskach. Praktyki testowania jakości danych są najskuteczniejsze, gdy badają brzydkie przypadki, a nie tylko szczęśliwą ścieżkę.
Co testować najpierw
Zero i wartości sprzed epoki: potwierdź, że pipeline obsługuje
0i ujemne timestampy spójnie albo odrzuca je z jasnym uzasadnieniem.Precyzja ułamkowa: sprawdź, czy mikrosekundy lub milisekundy przetrwają konwersję, gdy wymaga tego kontrakt źródłowy.
Momenty zmiany czasu: testuj powtórzone i pominięte godziny lokalne, aby warstwa wyświetlania nie opisała momentu błędnie.
Wartości null i nienumeryczne: potwierdź, że pipeline odrzuca błędne rekordy bez zgadywania.
Timestampy na górnej granicy: sprawdź największy zakres dat i godzin, jaki obsługuje twoja baza danych, środowisko uruchomieniowe lub format serializacji.
Co logować
Zapisuj jednostkę źródłową, metadane strefy czasowej źródła, znormalizowany moment w UTC, status walidacji i ewentualną przyczynę błędu. Te metadane sprawiają, że analiza incydentów jest odtwarzalna, zwłaszcza gdy jedno środowisko aktualizuje dane stref czasowych, a inne pozostaje w tyle. Baza IANA zmienia się w czasie, więc odtwarzalność zależy od świadomości wersji w takim samym stopniu jak od poprawności kodu.
Konwersja, której nie da się odtworzyć z logów, nie została zwalidowana.
Końcowa kontrola powinna porównać oryginalną wartość z wyświetlonym datetime po konwersji w obie strony, jeśli jest obsługiwana. Jeśli zwrócony moment się zmienia, ścieżka konwersji nadal traci informacje. Przechowywanie surowego timestampu obok datetime znacznie ułatwia audyt, ponieważ jedno pole zachowuje wartość maszynową, a drugie pokazuje formę czytelną dla człowieka.
Jeśli chcesz, aby te kontrakty timestampów - jednostka, wiarygodny zakres, precyzja i dopuszczalność null - były egzekwowane przy każdym ładowaniu, a nie tylko w zestawach testów, digna Data Validation uruchamia je jako reguły bezpośrednio w twojej bazie danych.
Najczęściej zadawane pytania
Jak w Pythonie przekonwertować timestamp Unix na datetime?
Użyj datetime.fromtimestamp(value, tz=timezone.utc), aby uzyskać datetime świadomy UTC, a astimezone() ze strefą ZoneInfo, np. America/New_York, wywołuj dopiero wtedy, gdy potrzebujesz czasu lokalnego. Bez tz Python użyje czasu lokalnego hosta i zwróci naiwny datetime, więc wyniki będą się różnić między serwerami.
Dlaczego przekonwertowany timestamp pokazuje datę z 1970 roku?
Data bliska 1970 r. niemal zawsze oznacza niezgodność jednostek: wartość w sekundach odczytano jako milisekundy, więc moment wypada tuż po epoce Unix, czyli 00:00:00 UTC 1 stycznia 1970 r. Ustal jednostkę źródłową na podstawie kontraktu schematu, zamiast zgadywać ją po liczbie cyfr.
Czy America/New_York to to samo co UTC-5?
Nie. UTC-5 to stałe przesunięcie opisujące pojedynczy moment, a America/New_York to nazwana strefa IANA z regułami czasu letniego i historycznymi zmianami. Jeśli zapiszesz tylko przesunięcie, stracisz tożsamość lokalizacji i każdą powiązaną zmianę reguł, przez co czasy lokalne zaczną się rozjeżdżać.
Co pipeline timestampów powinien przechowywać oprócz sformatowanego datetime?
Zachowaj oryginalną wartość liczbową, jednostkę źródłową, docelową precyzję, strefę czasową użytą do wyświetlania i wynik walidacji. Surowa wartość to pole audytowe, a datetime to jedynie warstwa prezentacji, dlatego oba powinny towarzyszyć rekordowi na każdym etapie pipeline'u.
Jakie przypadki brzegowe powinny obejmować testy konwersji timestampów?
Zacznij od zera i ujemnych wartości sprzed epoki, ułamków sekund, wartości null i ciągów nienumerycznych oraz momentów zmiany czasu, gdy godziny lokalne się powtarzają lub znikają. Dodaj daty bliskie limitom bazy danych lub środowiska uruchomieniowego i sprawdź, czy konwersja w obie strony zwraca ten sam moment.


