10 problemi comuni dei dati e come individuarli nel 2026
|
9
min di lettura

Avete davanti una dashboard che sembra tranquilla, i log dei job sono verdi e nel data warehouse nulla appare visibilmente rotto. È proprio in quel momento che i problemi dei dati fanno più danni. I numeri possono scostarsi, le definizioni possono cambiare e un modello può continuare a produrre punteggi mentre l'azienda prende decisioni su input obsoleti, incompleti o incoerenti.
La maggior parte dei guasti nei dati non si annuncia. Si nasconde dietro stati di successo, colonne vuote, righe duplicate, feed in ritardo e logiche di calcolo delle metriche che nessuno ha documentato a sufficienza. Il problema di fondo raramente è “la pipeline è ferma”. È che la pipeline dice che va tutto bene mentre il report, il modello o la segnalazione regolamentare diventano gradualmente meno affidabili.
L'elenco che segue classifica dieci problemi comuni dei dati in base a quanto silenziosamente si manifestano, non a quanto spesso se ne parla. Per ciascuno trovate come si presenta nella pratica, come individuarlo per tempo e quali moduli di digna si adattano al lavoro di rilevamento o mitigazione.
Indice
7. Violazioni delle regole di business e lacune nell'integrità referenziale
9. Definizioni, unità di misura e logiche delle metriche incoerenti
10. Carichi di lavoro incontrollati e picchi di consumo della piattaforma
Trasformate questi dieci controlli in una routine stabile di data quality
1. Tempestività, dati obsoleti e dashboard compromesse
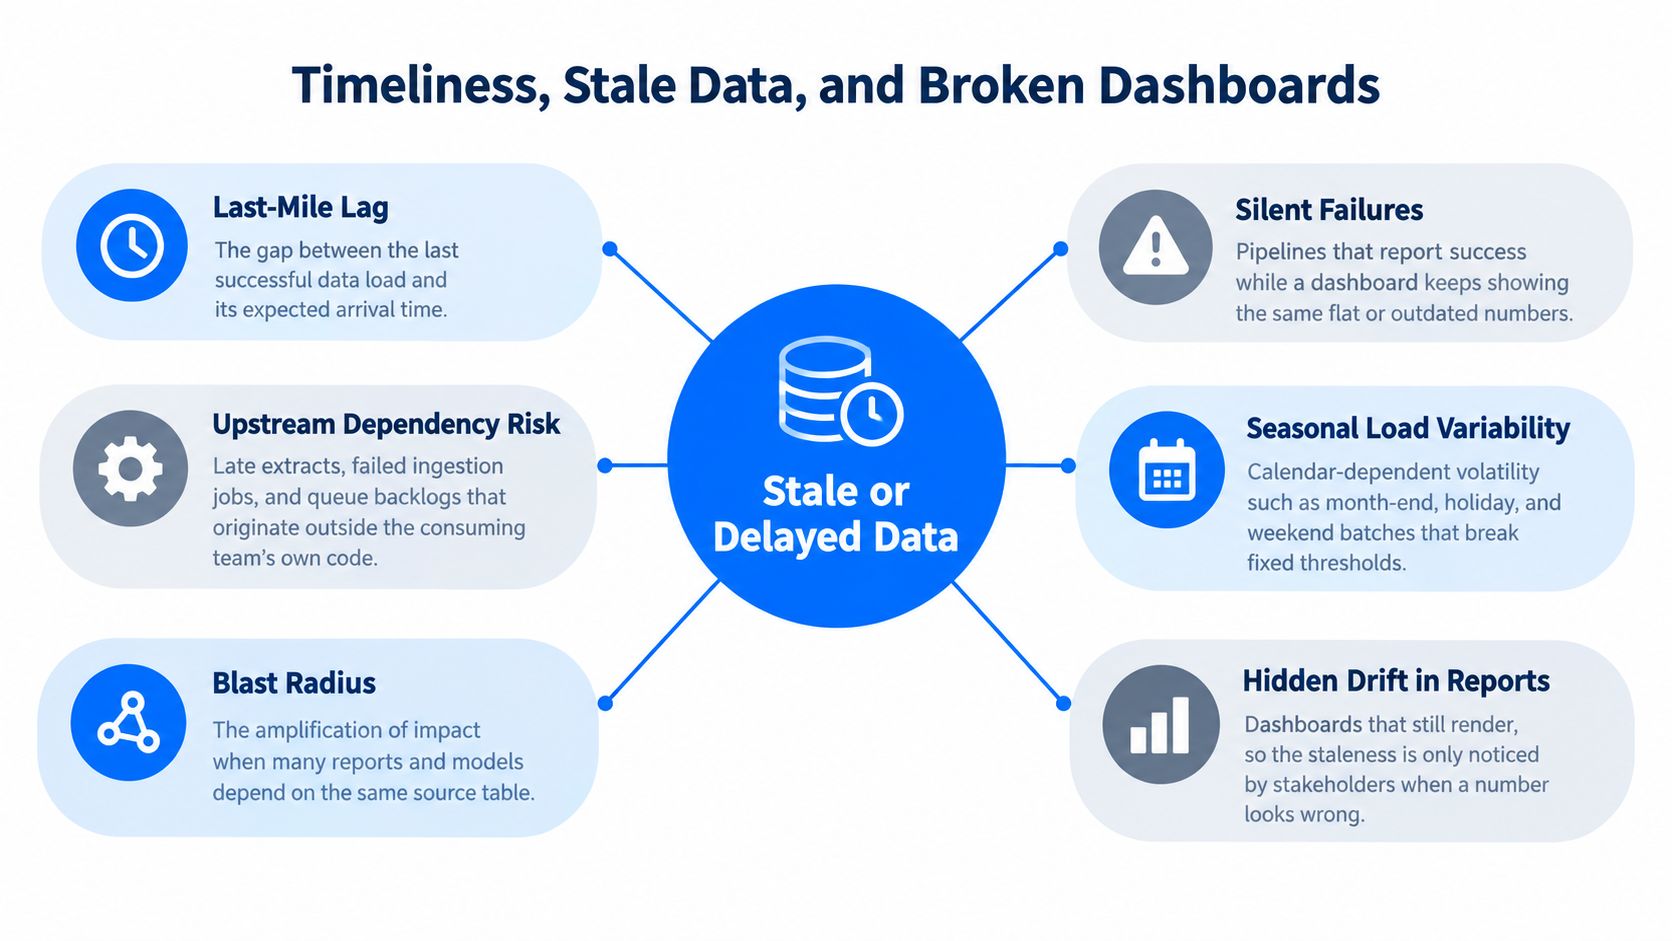
Una dashboard può caricarsi senza errori mentre i numeri al suo interno sono già vecchi. La finanza vede un report, le vendite vedono un report, il management vede un report, e il dato obsoleto resta nascosto finché qualcuno con conoscenza del dominio non nota l'incongruenza.
È così che i problemi di tempestività passano inosservati. Un feed sorgente può bloccarsi dopo un'estrazione tardiva o un accumulo in coda, mentre una tabella dimensionale si aggiorna puntualmente con la mappatura delle categorie sbagliata. La dashboard continua a essere visualizzata, ma il significato dei numeri si sposta. Una scoperta tardiva costa cara, e la ricerca di IBM sulle violazioni dei dati mostra quanto tempo può passare prima che un problema venga individuato e contenuto: identificazione e contenimento di una violazione richiedono in media 241 giorni, e rilevamento ed escalation costano in media 1,47 milioni di USD (studio IBM Cost of a Data Breach).
Regola pratica: un report è aggiornato solo quanto le tabelle che lo alimentano.
Cosa monitorare
Finestre di arrivo previste: ricavate dallo storico gli orari di consegna abituali, poi generate alert per caricamenti in ritardo, mancanti o inaspettatamente anticipati.
Mappatura delle dipendenze: tenete traccia di quali dashboard dipendono da quali tabelle, così i guasti a monte emergono prima che inizi la riunione.
Schema e tempistiche insieme: un feed che arriva puntuale ma cambia struttura è comunque un guasto.
Usate digna Timeliness per apprendere i pattern di consegna e calcolare gli orari di arrivo previsti. Abbinatelo a digna Data Quality Management per rilevamento delle anomalie, validazione e tracciamento dello schema sulle tabelle che alimentano le dashboard chiave. Per approfondire il modello operativo, consultate la guida di digna al monitoraggio della tempestività dei dati.
2. Caricamenti mancanti o incompleti
Un caricamento può concludersi senza errori ed essere comunque sbagliato. I file arrivano, lo schema corrisponde e il numero di righe sembra abbastanza vicino da superare un controllo rapido. Ciò che manca è la regione, il sistema sorgente o l'intervallo temporale che non è mai arrivato a destinazione.
È così che i totali calano senza un allarme evidente. Il caso dei report COVID-19 di Public Health England ne è un chiaro esempio: circa 16.000 risultati positivi sono stati omessi per diversi giorni perché un file superava il limite di righe del vecchio formato Excel usato per consolidare i dati (Come è andata storta la raccolta dei dati COVID-19 di Public Health England). Il guasto sembrava una normale variazione finché qualcuno non ha controllato la sorgente.
Il rilevamento deve avvenire a livello di segmento. Il numero totale di righe non basta, perché un'interruzione parziale in una regione o in una linea di prodotto può lasciare il totale apparentemente normale. Per la parte di misurazione, consultate la guida di digna su come misurare la completezza dei dati. Usate digna Anomalies per apprendere i normali pattern di volume per tabella e segnalare i caricamenti parziali anche quando il job della pipeline riporta un esito positivo.
La mitigazione è un lavoro ripetitivo, ed è proprio questo il punto. Confrontate i conteggi di sorgente e destinazione a ogni fase, registrate le righe attese rispetto a quelle effettive e conservate l'audit trail dove qualcuno possa esaminarlo in seguito. Se un feed deve contenere ogni negozio, ogni giorno, un negozio mancante in una certa data deve saltare all'occhio prima di arrivare in una dashboard o in una previsione.
3. Schema drift
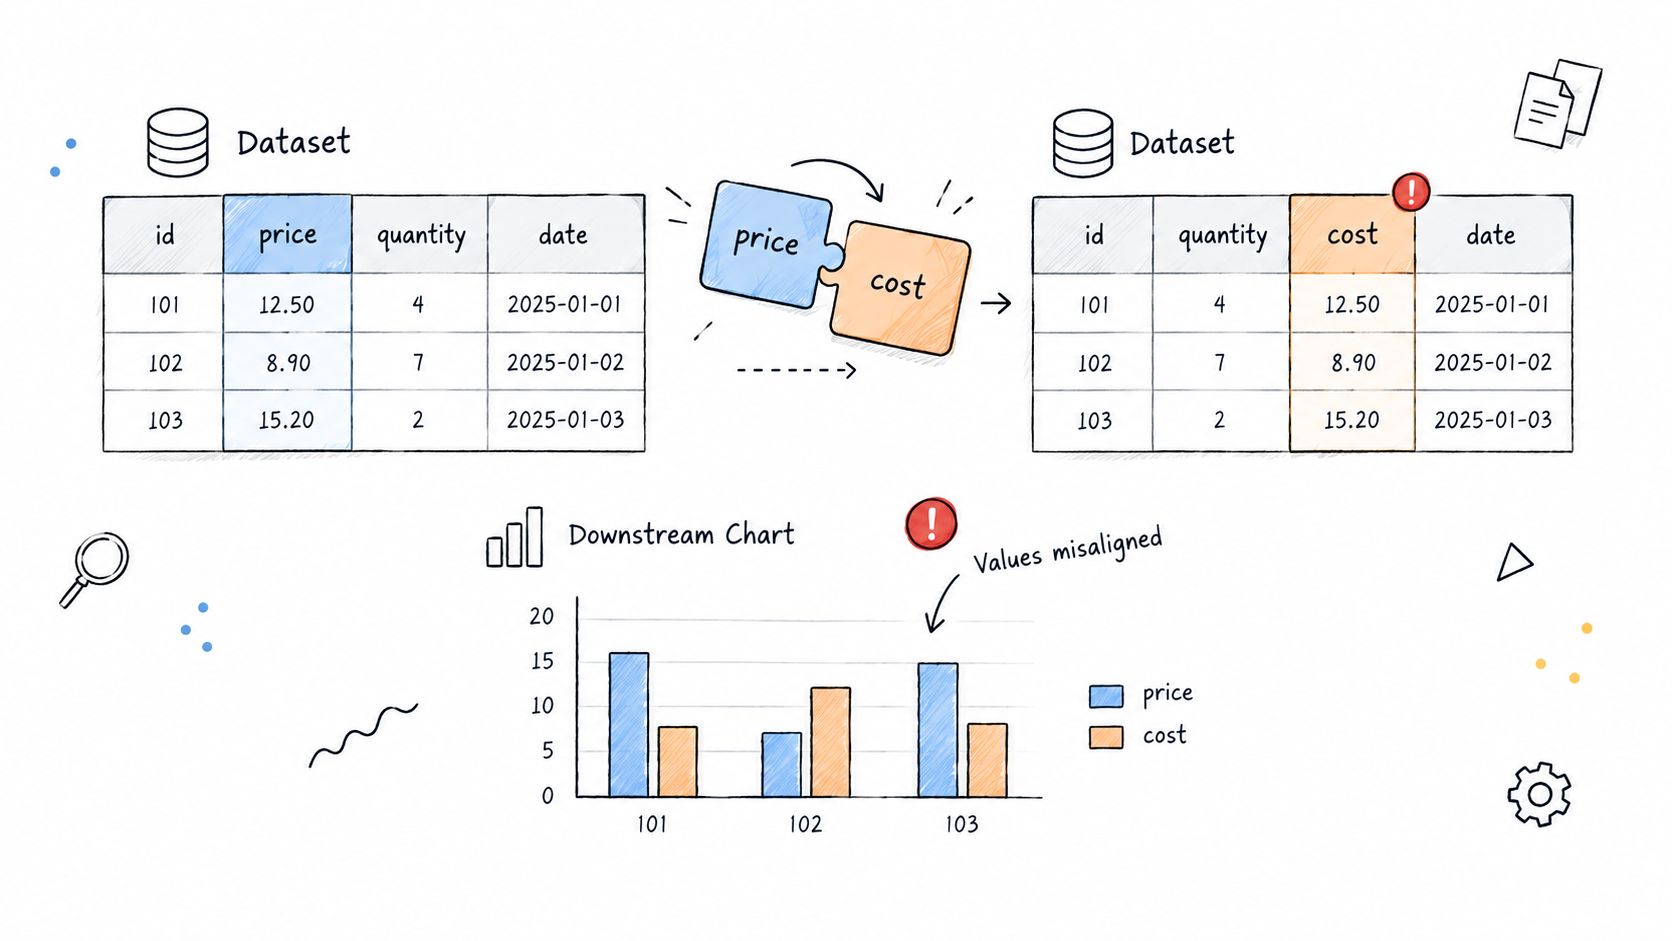
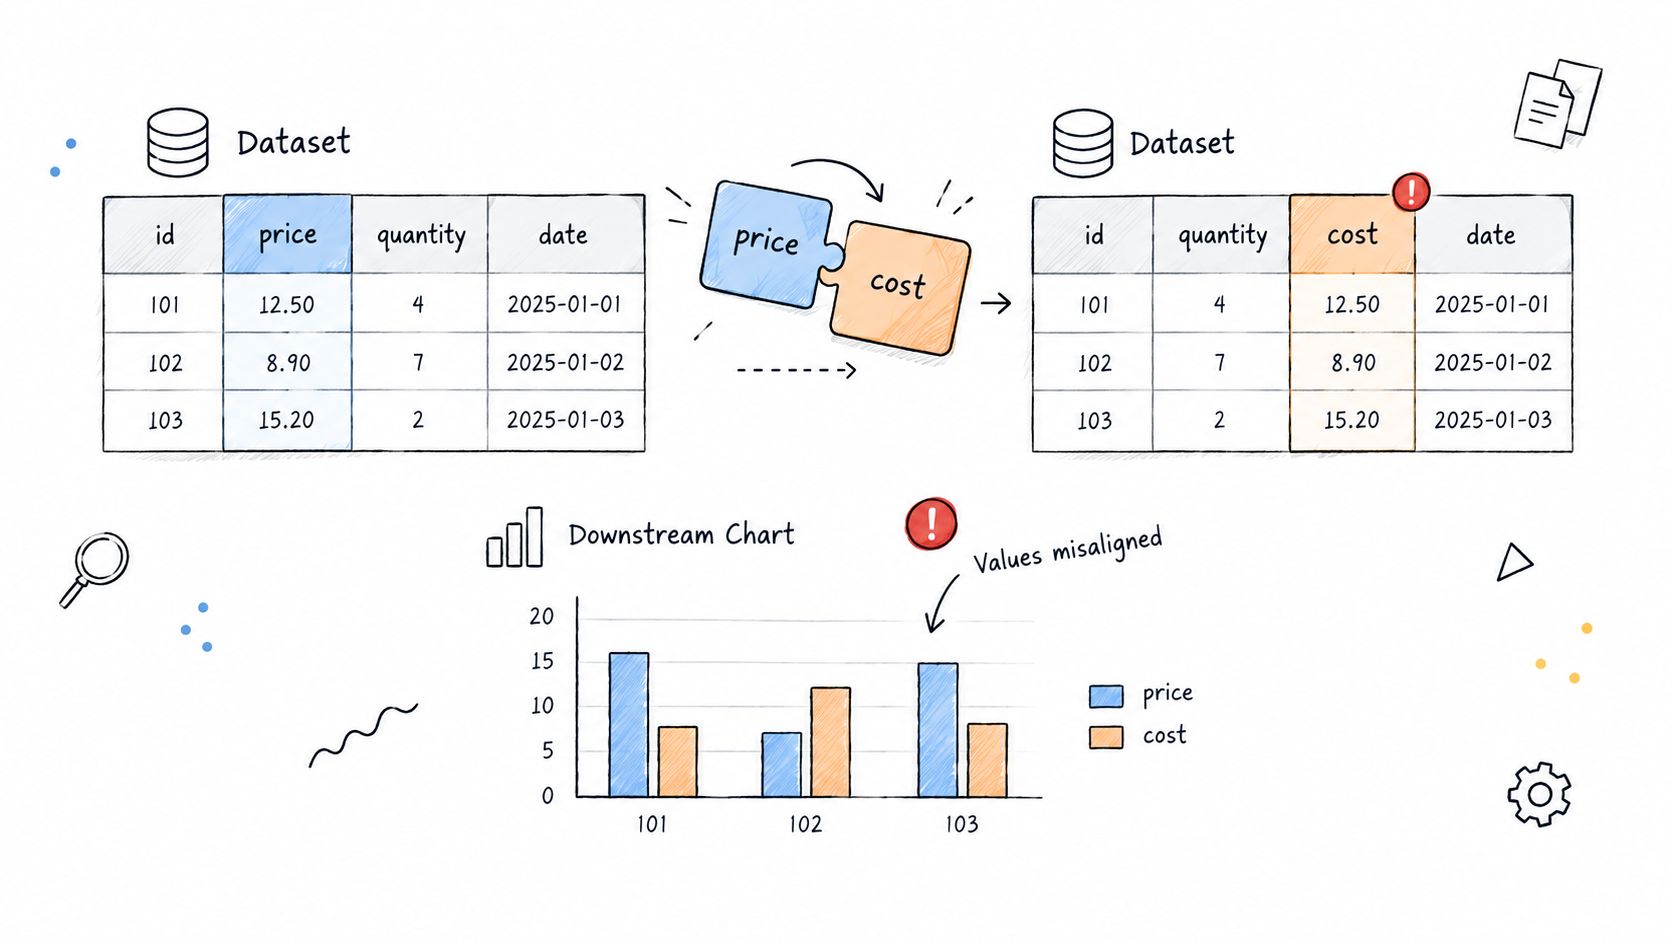
Un campo può cambiare struttura mentre la pipeline continua a segnalare successo. Una colonna viene rinominata, un tipo cambia o una sorgente elimina un campo dopo un rilascio, e la logica a valle continua a girare con presupposti sbagliati. Di solito questo emerge più tardi sotto forma di valori nulli, valori spostati, calcoli errati o un modello che assegna punteggi su input che non comprende più.
I guasti peggiori sono quelli silenziosi. Un campo monetario che passa da decimale a testo può compromettere le aggregazioni nel livello di BI mentre il job a monte sembra ancora in salute. Una colonna rimossa può anche essere sostituita da un valore predefinito, che mantiene vivo il feed e rende i numeri meno veritieri senza generare un errore evidente.
Come individuarlo per tempo
Monitorate in modo continuo le colonne aggiunte, rimosse e con tipo modificato, non solo durante il deployment.
Classificate le modifiche in base all'impatto, così le modifiche bloccanti non finiscono nella stessa coda delle aggiunte innocue.
Collegate ogni modifica alla sorgente a monte e a ogni asset a valle che ne dipende.
Usate digna Schema Tracker per individuare le modifiche strutturali nel momento in cui avvengono e associarle agli asset interessati. La panoramica di digna sui tipi di schema offre un modo pratico per raggruppare queste modifiche prima che si propaghino nella reportistica o nelle logiche di scoring. Un contratto di schema non fermerà ogni modifica, ma ferma quella forma di schema drift che emerge solo quando un report è già andato storto.
Un esempio visivo chiaro aiuta i team a vedere come un campo possa essere rietichettato senza che nessuno se ne accorga. Un diagramma che illustra disallineamenti dei dati in cui il prezzo viene erroneamente rietichettato come costo, con grafici a valle errati.
4. Record duplicati
I duplicati sono insidiosi perché ogni singola riga sembra legittima. Lo stesso cliente, la stessa transazione o la stessa polizza compare due volte, a volte per via di nuovi tentativi, a volte per sistemi sorgente sovrapposti, a volte per una logica di merge che non ha riconosciuto una corrispondenza di chiave. Nulla si blocca, ma ora i totali sono sbagliati.
Il danno operativo diventa evidente appena lo si ricostruisce. La fatturazione si gonfia, il numero di clienti supera la realtà e i report di compliance iniziano a descrivere un'organizzazione che non è mai esistita. In una migrazione, gli account duplicati possono far apparire la reportistica direzionale più sana o più ampia di quanto sia. Nei sistemi di streaming, la logica di retry può scrivere più volte la stessa transazione durante un problema di rete, con il risultato di ricavi, volumi o attività gonfiati.
Un buon modello di controllo parte da chiavi di business esplicite. Se non definite l'unicità dell'entità, lasciate al caso la regola di deduplicazione. Usate digna Data Validation per far rispettare l'unicità delle chiavi e rilevare le violazioni a livello di record, poi rendete l'ingestion idempotente in modo che i retry non creino altre righe. Per le sovrapposizioni approssimative, dove la corrispondenza esatta non basta, la guida di digna al fuzzy matching offre ai team un percorso pratico per individuare i record abbastanza simili da meritare una verifica.
Il numero assoluto di duplicati conta meno dell'andamento. Un aumento improvviso di solito dice più di una baseline stabile.
5. Valori nulli e mancanti
I valori nulli sono facili da sottovalutare, perché non ogni valore mancante è un problema. Il problema nasce quando i tassi di valori nulli cambiano senza spiegazione, o quando un campo che dovrebbe essere popolato inizia ad arrivare vuoto in una porzione significativa di record. Spesso indica un join fallito, un problema di parsing o una modifica alla sorgente che nessuno ha notato.
Una differenza di formato in una chiave di join può impedire ai record di corrispondere, e a quel punto un attributo chiave del cliente scompare a valle. Un rilascio dell'app mobile può smettere del tutto di acquisire un campo, facendo impennare i tassi di valori nulli mentre la pipeline sembra ancora in salute. Il rischio non è solo analitico: la mancanza di campi critici può distorcere i modelli e le decisioni operative.
Il controllo giusto qui si basa sui tassi, non sui valori assoluti. Una regola generica “nessun valore nullo” crea rumore, mentre una baseline misurata coglie le variazioni significative. Monitorate separatamente i campi facoltativi e quelli obbligatori, e verificate i valori mancanti mascherati, come stringhe sentinella o numeri segnaposto. Usate digna Anomalies per apprendere il normale comportamento del tasso di nulli per colonna, poi generate alert sulle deviazioni significative invece di discutere di soglie manuali. La nota di digna sulla completezza come dimensione della qualità dei dati è utile quando i team devono distinguere la completezza reale dalle supposizioni.
6. Formati non validi e valori fuori intervallo
I valori non validi spesso superano la validazione tecnica perché il tipo è corretto, ma il contenuto è sbagliato. Una data può essere interpretata senza errori pur essendo impossibile. Un prezzo può essere numerico ma espresso nell'unità sbagliata. Un codice postale può avere la lunghezza prevista e violare ogni vincolo reale da cui dipende l'azienda.
Molti team confondono il successo dell'ingestion con la correttezza dei dati. Un record sanitario con una data di nascita nel futuro può derivare da uno scambio tra giorno e mese tra sistemi. Un retailer può acquisire i prezzi in centesimi da una sorgente e in unità di valuta da un'altra, facendo sembrare lo stesso prodotto 100 volte troppo caro o troppo economico. Non si è rotta la pipeline, si è rotta la logica di business.
La risposta è un controllo esplicito del dominio. Documentate intervalli ammessi ed elenchi di codici per i campi critici, poi validateli a livello di record e conservate le righe non conformi con il motivo associato. Usate digna Data Validation per applicare queste regole alle colonne più importanti, e combinate i controlli basati su regole con il rilevamento statistico quando i valori errati risultano evidenti solo rispetto allo storico. Anche le linee guida del NIST sono utili, perché inquadrano la qualità delle informazioni in termini di utilità, integrità e oggettività, con un margine di errore accettabile che dipende dal caso d'uso (standard NIST sulla qualità delle informazioni).
7. Violazioni delle regole di business e lacune nell'integrità referenziale
Una spedizione precedente alla data dell'ordine, un prestito senza record di approvazione o una polizza che rimanda a un cliente inesistente raramente bloccano la pipeline. Minano la fiducia nei numeri. Questi guasti sfuggono alla validazione di base perché i campi sono presenti, ma la logica di business è sbagliata.
I guasti più silenziosi di solito si annidano nelle relazioni. Una controparte chiusa può comparire ancora nei report sulle esposizioni se gli aggiornamenti di stato non raggiungono tutte le tabelle a valle. I sinistri possono continuare a fare riferimento a numeri di polizza che non esistono più nell'anagrafica master. La finanza se ne accorge tardi, spesso dopo che qualcuno ha già approvato un report.
Classificateli in base a come si manifestano. Una chiave esterna mancante fa rumore. Un flag di stato obsoleto no.
1. Record padre mancanti Un record figlio non punta a nulla, ma la riga finisce comunque nella reportistica. Individuatelo verificando ogni chiave esterna rispetto alla tabella master, poi esaminate gli scarti ogni giorno. Con digna Data Validation conservate le righe non conformi con il motivo associato, così operations e audit possono ricostruire il punto di rottura.
2. Date di business che violano la sequenza Un evento arriva con date che non hanno senso in sequenza. Intercettatelo con regole di sequenza esplicite, ad esempio approvazione prima dell'erogazione o inizio polizza prima della data del sinistro.
3. Stati non allineati tra sistemi Una tabella dice chiuso, un'altra dice ancora attivo. Confrontate i campi del ciclo di vita tra le sorgenti e segnalate i record in disaccordo sullo stato attuale.
4. Riferimenti operativi orfani Una fattura, un sinistro o un'esposizione restano collegati a un record master eliminato. Eseguite i controlli referenziali dove i dati sono archiviati, non solo dopo l'aggregazione.
5. Regole che esistono solo nella testa di qualcuno Documentate la regola, indicatene il responsabile e rendete leggibile la condizione di test. Una regola che nessuno sa spiegare non supererà una revisione.
Mantenete i controlli vicini ai dati, conservate le evidenze e indirizzate i guasti alle persone in grado di correggere la sorgente.
8. Data drift silenzioso e variazioni nelle distribuzioni
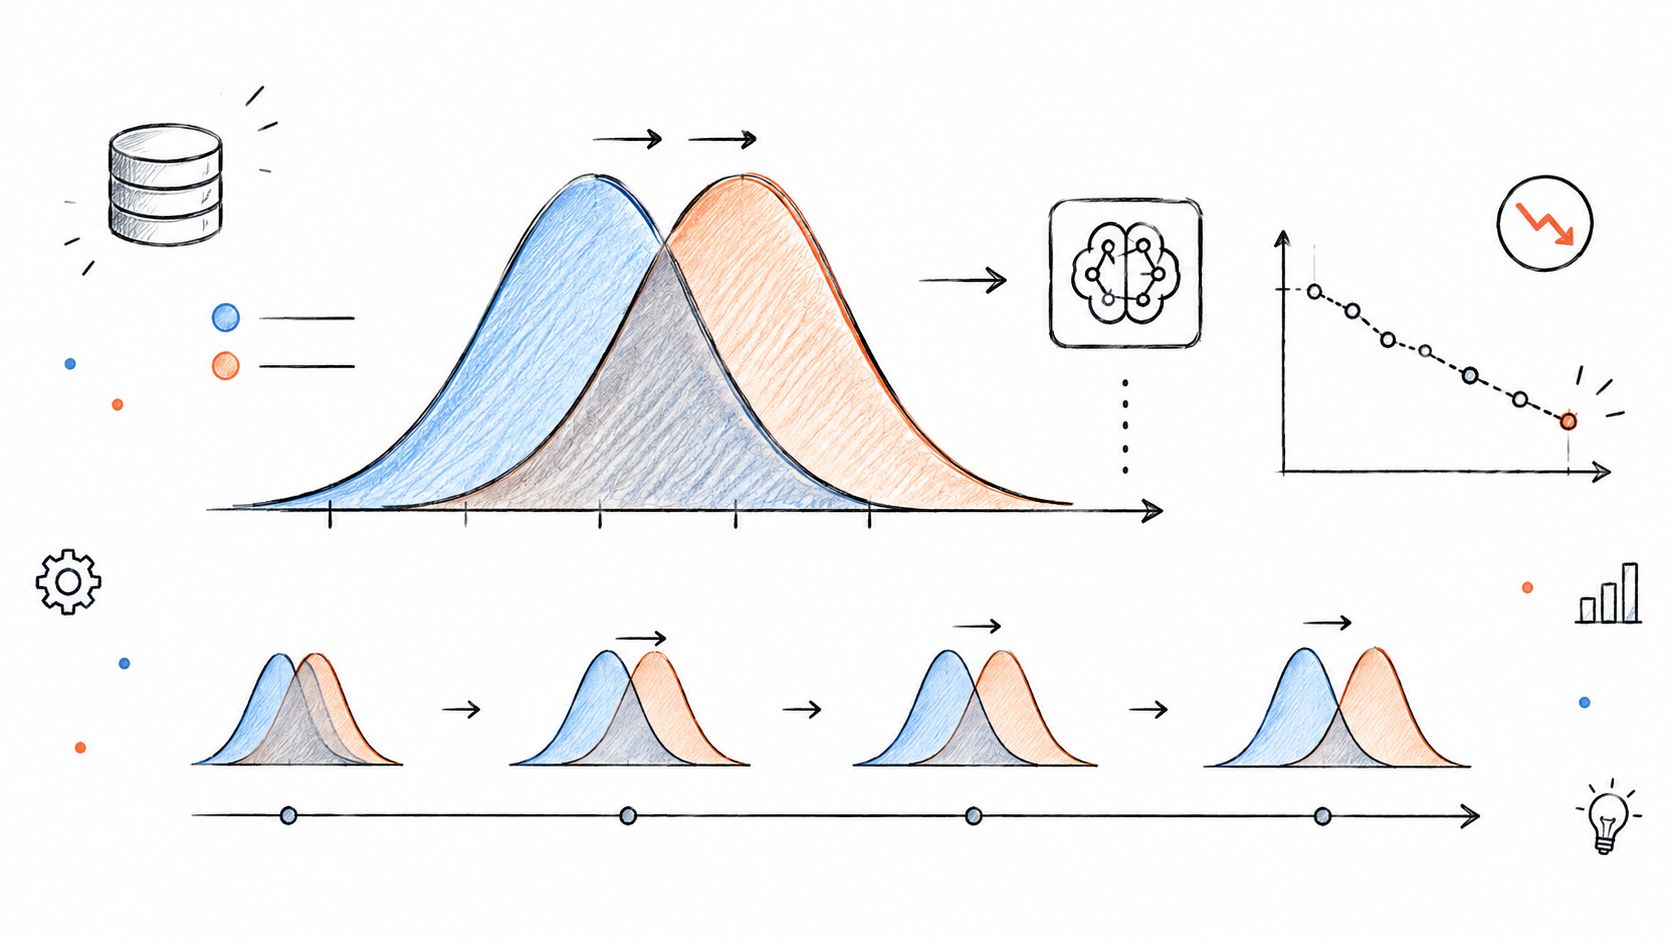
Una pipeline può restare in salute mentre i dati, lentamente, smettono di significare la stessa cosa. Le medie si spostano, il mix cambia, le correlazioni si indeboliscono, e report o modelli diventano meno affidabili senza un job fallito o uno schema rotto. Per questo il drift è facile da non notare e difficile da ignorare.
Classificate questi problemi in base a quanto silenziosamente si manifestano. Un'interruzione rumorosa attira l'attenzione. Un cambiamento silenzioso nel comportamento di solito no.
1. Drift nella distribuzione delle feature Una scorecard continua a girare, ma uno degli input ora proviene da un segmento di clientela diverso da prima. Confrontate le distribuzioni mobili con una baseline nota, poi mettetele in relazione con i rilasci recenti delle sorgenti e con le modifiche alle mappature a monte. Con digna Anomalies impostate intervalli attesi per dataset, e usate digna Data Analytics per verificare se lo spostamento è isolato o parte di una tendenza più ampia.
2. Drift delle etichette o degli esiti È il target stesso a cambiare dopo modifiche a policy, prodotti o instradamenti. Il modello può sembrare peggiorato anche se la pipeline è integra. Monitorate i tassi di esito nel tempo e confrontateli con gli eventi di business prima di trattare il cambiamento come un degrado del modello.
3. Modifiche silenziose di unità o codifiche Una valuta, un codice di stato o una mappatura di categorie cambia a monte, ma il feed supera comunque la validazione. La dashboard resta verde mentre i numeri smettono di essere confrontabili. Confrontate i deployment delle sorgenti e i log di trasformazione, poi verificate che i valori corrispondano ancora al significato atteso dagli utenti a valle.
4. Cambiamenti nel mix dei segmenti Un report viene dominato da una nuova regione, un nuovo canale o un nuovo gruppo di dispositivi, e la media complessiva si sposta di conseguenza. Scomponete le metriche per segmento prima di parlare di tendenza. Se un solo segmento spiega gran parte dello spostamento, il problema è la composizione, non la performance.
5. Perdita graduale di correlazione Due campi che prima si muovevano insieme ora non lo fanno più. Spesso accade dopo un cambio di sorgente, un feed in ritardo o una nuova regola di business. Monitorate le relazioni tra coppie di variabili e generate alert sulle deviazioni persistenti, non solo sui picchi isolati.
L'abitudine utile è semplice. Monitorate le distribuzioni, collegate gli alert agli eventi delle sorgenti e mantenete visibili le righe non conformi e il contesto, così gli analisti possono distinguere il drift da un cambiamento reale.
9. Definizioni, unità di misura e logiche delle metriche incoerenti
Due dashboard possono essere entrambe “corrette” e non coincidere comunque, ed è per questo che questa categoria danneggia così tanto la fiducia. Un team conta gli account, un altro i clienti unici, un terzo riporta i ricavi in migliaia e un quarto converte i fusi orari in modo diverso. I numeri sono coerenti internamente ma inutili quando vengono confrontati.
Questo tipo di discrepanza resta nascosto finché il management non chiede perché lo stesso trimestre appare diverso in due sistemi. Il fallimento del Mars Climate Orbiter è l'esempio classico di unità di misura non allineate, ed è ancora attuale perché l'analytics moderna ha la stessa debolezza, a velocità più elevata. Se finanza, operations e prodotto definiscono ciascuno in modo diverso il “cliente attivo”, ogni riunione diventa un esercizio di riconciliazione.
Un glossario aiuta, ma solo se a ogni metrica sono associati responsabili, logica di calcolo e unità di misura. Standardizzate le conversioni il prima possibile, poi riconciliate regolarmente le metriche critiche e analizzate le differenze oltre le tolleranze concordate. Usate digna Business Monitoring per monitorare i KPI sui dati sottostanti, così le variazioni inattese emergono anche prima che le definizioni siano del tutto armonizzate. Per i team che amano guardare al comportamento delle metriche con la lente dell'affidabilità, MTBF, MTTR e OEE spiegati è un utile riferimento complementare.
Se due team usano la stessa etichetta per logiche diverse, il problema è l'etichetta.
10. Carichi di lavoro incontrollati e picchi di consumo della piattaforma
Il rilascio di una dashboard, un backfill o un nuovo flusso self-service possono spingere una piattaforma oltre il suo carico normale prima che qualcuno se ne accorga. Il data warehouse risponde ancora, ma la latenza delle query aumenta, i costi salgono e i job pianificati iniziano a mancare le loro finestre.
I team spesso archiviano questi picchi come questioni infrastrutturali, eppure volume delle query, crescita dello storage ed espansione dei tempi di esecuzione sono anche problemi di affidabilità dei dati. Di solito si manifestano senza preavviso. Il primo sintomo raramente è un'interruzione. È un aggiornamento del modello più lento, un report in ritardo o una fattura che nessuno aveva messo a budget. Le ricerche sull'utilizzo del cloud continuano a indicare lo stesso schema, in cui la capacità inutilizzata o mal gestita si trasforma in spreco e in freno operativo: per questo la crescita dei carichi di lavoro appartiene ai controlli sui dati tanto quanto alle revisioni dell'infrastruttura.
Mantenere visibile il comportamento della piattaforma
Monitorate per responsabile del carico: attribuite i picchi a un team, una pipeline o una dashboard prima che il pattern si diffonda.
Baseline per pattern temporale: confrontate il comportamento nei giorni feriali, nel weekend e nelle finestre di rilascio prima di generare alert.
Analizzate insieme alla finanza: il controllo dei costi funziona meglio quando ingegneria e finanza leggono le stesse tendenze.
Usate digna Data Platform Observability per monitorare in un unico punto carichi di lavoro, consumi, disponibilità e metriche di performance. In questo modo è più facile individuare il guasto silenzioso, in cui il sistema resta attivo mentre costi e latenza escono dalla tolleranza. Per i team di piattaforma, questa visibilità fa spesso la differenza tra un aumento sotto controllo e una sorpresa costosa.
Confronto dei 10 principali problemi dei dati
Problema | 🔄 Complessità di implementazione | 💡 Risorse necessarie | ⚡ Velocità di rilevamento prevista | 📊 Risultati / impatto previsti | ⭐ Casi d'uso ideali / vantaggio chiave |
|---|---|---|---|---|---|
Tempestività, dati obsoleti e dashboard compromesse | Medio-alta; richiede finestre SLA & mappatura delle dipendenze | Moderate, monitoraggio, lineage, alerting | Lenta se si guardano solo le dashboard; ⚡ rapida con l'apprendimento delle finestre di arrivo | Impatto elevato su molti report; erode la fiducia degli stakeholder | Dashboard critiche & rispetto degli SLA; comunicazione rapida verso monte |
Caricamenti mancanti o incompleti | Media; richiede baseline di volume segmentate e riconciliazione | Moderate, log dei conteggi di righe, controlli per partizione | Media; i caricamenti parziali possono passare inosservati senza controlli segmentati | Rischio elevato per aggregati e tendenze; può falsare i volumi | Pipeline batch/ETL e metriche aggregate; individuazione dei segmenti mancanti |
Schema drift | Media; richiede il tracciamento continuo di schema/contratti | Da basse a moderate, schema registry o tracker | Medio-rapida con il confronto automatico degli schemi | Compromette le trasformazioni, produce valori nulli o errori a valle | Sistemi con molti produttori; applicazione di contratti di schema |
Record duplicati | Media; richiede la progettazione di chiavi di business e idempotenza | Da basse a moderate, logica di deduplicazione, strumenti di matching | Media; spesso visibile solo dopo l'aggregazione, se non monitorata | Conteggi/somme gonfiati ed errori nella fatturazione o nell'analisi dei clienti | Pipeline di ingestion, risoluzione dell'identità dei clienti, fatturazione |
Valori nulli e mancanti | Medio-bassa; monitoraggio per colonna e baseline dei nulli attesi | Basse, controlli e alert per colonna | Rapida con il monitoraggio del tasso di nulli | Distorsioni in analytics/ML e attributi mancanti per i join | Feature di ML e campi obbligatori; intercettare picchi improvvisi di nulli |
Formati non validi e valori fuori intervallo | Medio-bassa; definire regole per sintassi/semantica/intervalli | Basse, regole di validazione ed elenchi di riferimento | Rapida tramite controlli deterministici | Valori non plausibili o non conformi che distorcono le metriche | Campi con domini noti (date, codici, prezzi); controlli regolamentari |
Violazioni delle regole di business & lacune referenziali | Alta; servono logiche tra tabelle e responsabilità definite | Elevate, controlli di integrità, responsabili, audit trail | Media; può essere costosa, quindi spesso a campione | Mancata conformità, problemi di riconciliazione, rischio di audit | Processi regolamentati di finanza, rischio e riconciliazione |
Data drift silenzioso & variazioni nelle distribuzioni | Medio-alta; baseline statistiche e monitoraggio delle relazioni | Da moderate a elevate, strumenti per il drift, baseline di lungo periodo | Lenta per natura; ⚡ più rapida con rilevatori di drift continui | Degrado graduale dei modelli e tendenze fuorvianti | Modelli di ML in produzione e baseline analitiche di lungo periodo |
Definizioni, unità di misura & logiche delle metriche incoerenti | Alta; governance, glossario e allineamento tra team | Elevate, documentazione, riconciliazione, livelli di conversione | Lenta, spesso emerge in revisioni o audit | Dashboard in conflitto e perdita di fiducia nei KPI | KPI trasversali, reportistica direzionale, metriche consolidate |
Carichi di lavoro incontrollati & picchi di consumo della piattaforma | Media; baseline per carico di lavoro e attribuzione | Elevate, telemetria della piattaforma, controllo dei costi, playbook di rimedio | Medio-rapida tramite metriche e alert della piattaforma | Sforamenti di costo, job in ritardo, calo delle performance | Data warehouse condivisi, FinOps, pianificazione in produzione e backfill |
Trasformate questi dieci controlli in una routine stabile di data quality
Partite dai problemi che riguardano le dashboard più usate e i report regolamentari. Assegnate a ciascuno un responsabile, un metodo di rilevamento e un percorso di alert, perché “qualcuno dovrebbe darci un'occhiata” non è un controllo. Se i dati supportano finanza, sanità, reportistica pubblica, operations verso i clienti o pipeline di AI, il primo compito è rendere visibile il guasto prima che arrivi in una riunione, in una segnalazione ufficiale o in un modello.
Rivedete questo elenco ogni trimestre. Compaiono nuove sorgenti, gli schemi cambiano, i team costruiscono nuove dashboard e l'uso della piattaforma cresce in modi che rendono necessari controlli di cui sei mesi fa non avevate bisogno. I sistemi che invecchiano bene sono quelli in cui tempestività, completezza, modifiche allo schema, validazione e rilevamento delle anomalie sono monitorati come routine, non come risposta a una crisi.
Il punto di partenza più pratico sono i tre problemi che con maggiore probabilità metteranno in crisi i vostri report critici questo mese. Definite prima le baseline per questi, poi estendetevi alle modalità di guasto correlate una volta che gli alert sono affidabili. È qui che digna si inserisce bene, perché i suoi moduli coprono tempestività, variazioni di volume, valori nulli, modifiche allo schema, regole a livello di record, monitoraggio dei KPI di business e osservabilità della piattaforma in un unico modello operativo.
Ciò che conta di più è la costanza. Se riuscite a rilevare per tempo dati obsoleti, caricamenti mancanti e modifiche strutturali, avete già eliminato gran parte dei guasti silenziosi che fanno perdere ai team di dati la fiducia nei propri risultati. Se potete dimostrare la regola di business, la finestra di aggiornamento e l'origine della modifica, il resto diventa gestibile.
digna offre ai team un modo pratico per monitorare i dati che alimentano reportistica, operations e AI. Se avete a che fare con feed obsoleti, drift, record mancanti o modifiche allo schema, visitate digna per scoprire come i suoi moduli supportano tempestività, validazione, rilevamento delle anomalie, tracciamento dello schema e osservabilità della piattaforma nel vostro ambiente.
Quando scatta un alert, la domanda successiva è chi lo gestisce e quanto rapidamente viene risolto: il processo di gestione dei problemi di data quality descrive questi passaggi, dal rilevamento alla correzione completata.
Domande frequenti
Quali sono i problemi più comuni dei dati?
I dieci più comuni sono dati obsoleti, caricamenti mancanti o incompleti, schema drift, record duplicati, valori nulli, formati non validi, violazioni delle regole di business, drift silenzioso delle distribuzioni, definizioni incoerenti delle metriche e picchi di consumo della piattaforma. L'elenco li classifica in base a quanto silenziosamente si manifestano, non a quanto spesso se ne parla.
Come si rileva un caricamento parziale quando il job segnala successo?
Controllate i volumi a livello di segmento anziché come un unico totale. Una regione o una linea di prodotto mancante può lasciare normale il conteggio complessivo, quindi confrontate i conteggi di sorgente e destinazione per fase e per segmento, e generate un alert quando scompare un singolo negozio o una data.
Perché lo schema drift è pericoloso se la pipeline continua a funzionare?
Perché la logica a valle continua a lavorare su presupposti sbagliati. Una colonna rinominata, un campo decimale diventato testo o un campo eliminato e sostituito da un valore predefinito possono produrre nulli, aggregazioni errate e numeri fuorvianti senza errori visibili. Tracciare in continuo le colonne aggiunte, rimosse e modificate lo intercetta prima che i report vadano storti.
Le regole di data quality devono vietare del tutto i valori nulli?
No. Una regola generica che vieta i nulli crea rumore, perché alcuni campi sono legittimamente facoltativi. Monitorate invece i tassi di nulli rispetto a una baseline appresa per colonna, trattate separatamente campi facoltativi e obbligatori e cercate i valori mancanti mascherati, come stringhe sentinella o numeri segnaposto che sembrano compilati ma non lo sono.
Da dove dovrebbe partire un team per costruire una routine di data quality?
Partite dai tre problemi che con maggiore probabilità metteranno in crisi i vostri report critici questo mese. Assegnate a ciascuno un responsabile, un metodo di rilevamento e un percorso di alert, definite le baseline, poi estendetevi alle modalità di guasto correlate quando gli alert sono affidabili. Rivedete l'elenco ogni trimestre, man mano che sorgenti, schemi e dashboard cambiano.