Definire i dati aggregati: metodi, esempi e insidie
|
7
min di lettura

I dati aggregati sono informazioni ottenute raggruppando singoli record in categorie e combinandone i valori in misure di sintesi come conteggi, somme, medie o tassi. Sembra semplice, ma il consiglio "basta creare una dashboard" è quello che causa più problemi, perché l'aggregazione cambia sia il significato sia il profilo di rischio dei record sottostanti.
Indice
Perché i dati aggregati contano per analytics e observability
Rischi per la privacy e di divulgazione negli output aggregati
Un esempio pratico: dai record grezzi a un aggregato affidabile
Che cosa sono davvero i dati aggregati
I dati aggregati sono informazioni di sintesi derivate da record di livello inferiore, non un tipo di dato a sé stante che nasce da solo. Il modello mentale ha due lati: da una parte ci sono singoli eventi, transazioni o osservazioni, dall'altra totali, medie o tassi a livello di gruppo che condensano molte righe in pochi risultati.
Un esempio chiaro è un database con 1 milione di singole transazioni dei clienti riassunte in 12 totali mensili per ciascun mercato. Non vedete più ogni singolo acquisto, ma potete confrontare i mercati, seguire la stagionalità e individuare i pattern generali molto più rapidamente. L'Australian Bureau of Statistics descrive l'aggregazione come il raggruppamento delle informazioni in categorie e la combinazione dei valori all'interno di esse, spesso sotto forma di tabelle, ed è per questo che si parla anche di dati tabellari o macrodati ABS glossary.

La definizione operativa che regge alla prova dei fatti
Considerate l'aggregazione come una trasformazione applicata a osservazioni grezze. Una transazione di un cliente diventa un totale di ricavi mensile, un flusso di eventi di telemetria diventa un conteggio orario degli errori e un censimento delle famiglie diventa una tabella delle caratteristiche della popolazione. Questo è il passaggio di base: ridurre molti record a poche sintesi.
Regola pratica: se il risultato risponde a una domanda su un gruppo ma non su una persona, è aggregato. Se potete ancora ricondurre il risultato a un singolo record senza ulteriore contesto, trattatelo come un rischio per la privacy e di divulgazione.
Questa distinzione conta perché lo stesso risultato può essere utile per il reporting e allo stesso tempo abbastanza sensibile da richiedere controlli. Se cercate una seconda fonte di terminologia mentre valutate come i fornitori descrivono questo ambito, la raccolta pricing data research di Wine Labs è un utile riferimento affine su come le sintesi strutturate vengono presentate nelle ricerche di mercato.
I principali metodi di aggregazione
L'aggregazione diventa più semplice quando smettete di considerarla un'unica operazione. Nella pratica i team ricorrono a un piccolo insieme di funzioni, e ognuna risponde a una domanda diversa sulle stesse righe sottostanti.
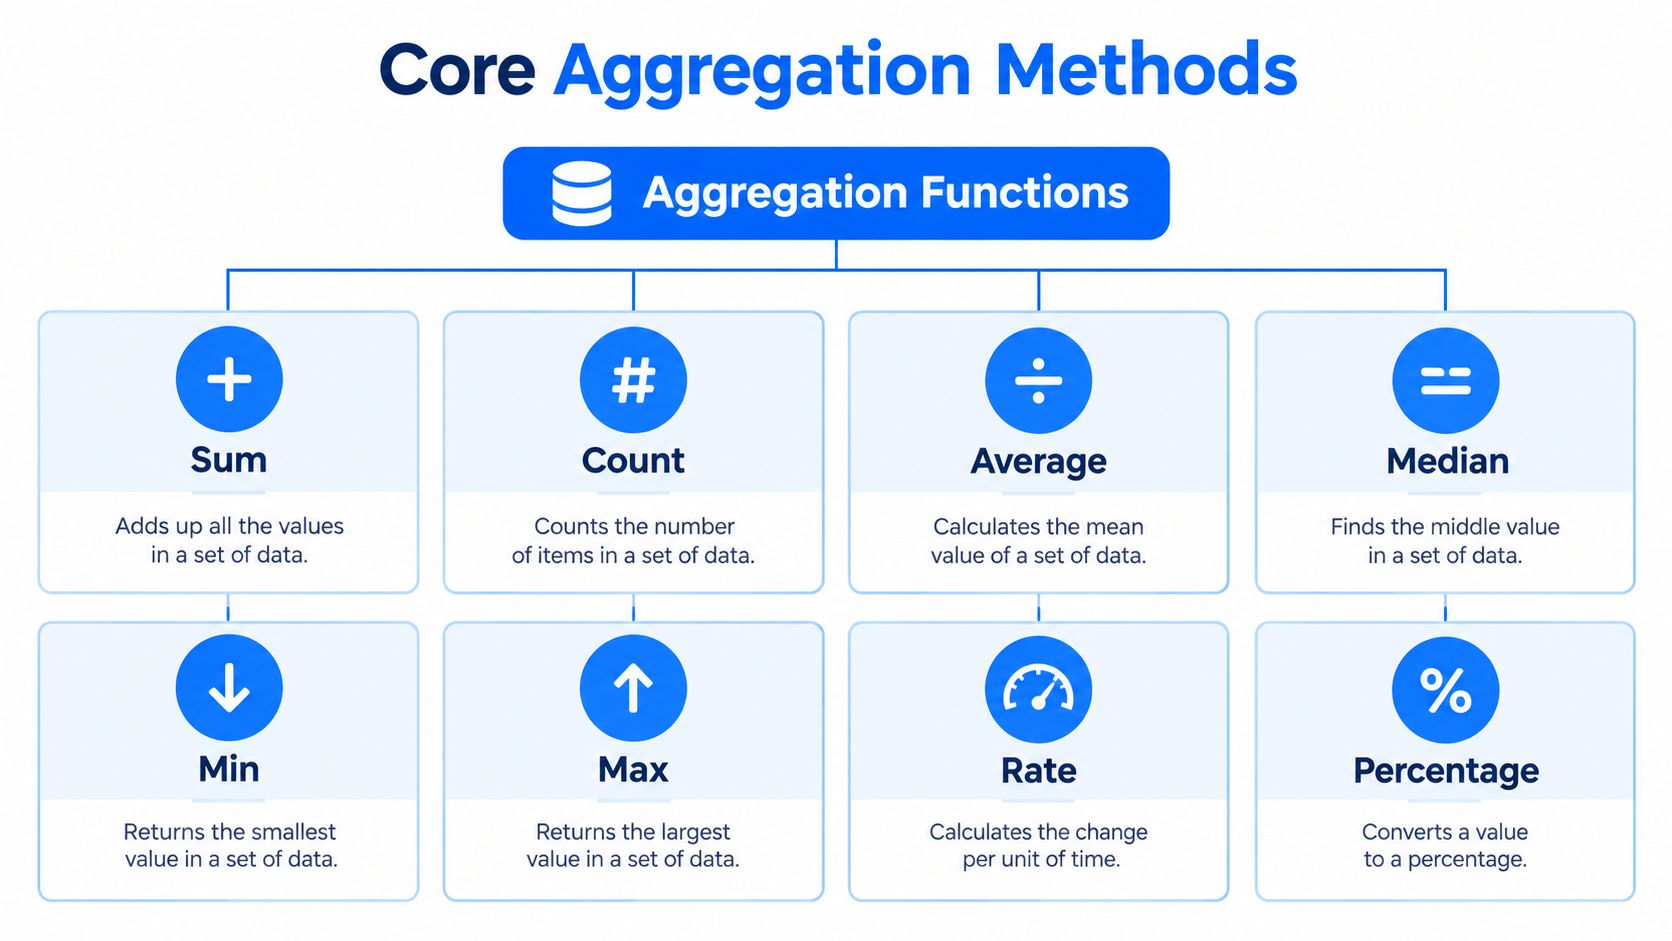
Le funzioni principali e che cosa conservano
La somma addiziona i valori. Se cinque ordini valgono 20, 30, 10, 40 e 50, la somma è 150. È la scelta giusta quando vi interessano volumi, ricavi, unità vendute o tempo totale impiegato.
Il conteggio indica quanti record ci sono nel gruppo. Conserva il volume di attività, ma non l'entità dei valori, quindi funziona per transazioni, ticket, utenti o eventi quando la domanda è "quanti?".
La media fornisce la media aritmetica. È utile quando cercate un valore tipico, ma può essere fuorviante se pochi grandi outlier allontanano il risultato da ciò che mostra la maggior parte delle righe.
La mediana fornisce il valore centrale dopo l'ordinamento. Usatela quando la distribuzione è asimmetrica, perché resiste ai valori estremi meglio della media.
Il minimo e il massimo conservano il valore più piccolo e quello più grande. Sono utili per i controlli di intervallo, ma scartano tutto ciò che sta nel mezzo.
Tassi e percentuali richiedono disciplina sul denominatore
Un tasso è un rapporto, per esempio le conversioni divise per i visitatori. Una percentuale esprime la stessa idea su una scala di 100. Entrambi hanno senso solo se il denominatore è stabile e chiaramente definito.
Un errore comune è fare la media di percentuali tra gruppi con denominatori diversi. In questo modo un gruppo piccolo pesa quanto uno grande, e il risultato viene distorto. Se la domanda è "quale quota di tutto il traffico ha convertito?", il denominatore deve essere tutto il traffico, non una media dei tassi di conversione mensili.
Regola empirica: usate la funzione più semplice che preserva la decisione da prendere, e nient'altro. Se la domanda di business riguarda la scala, usate somma o conteggio. Se riguarda il comportamento tipico, con dati asimmetrici preferite la mediana alla media.
Rollup, finestre e aggregazioni temporali
Il tempo trasforma l'aggregazione in una decisione governata, non in un semplice calcolo. La stessa tabella degli acquisti può produrre ricavi giornalieri, totali settimanali, numeri di chiusura mensile o una linea di tendenza mobile, e ogni versione risponde a una diversa domanda operativa.
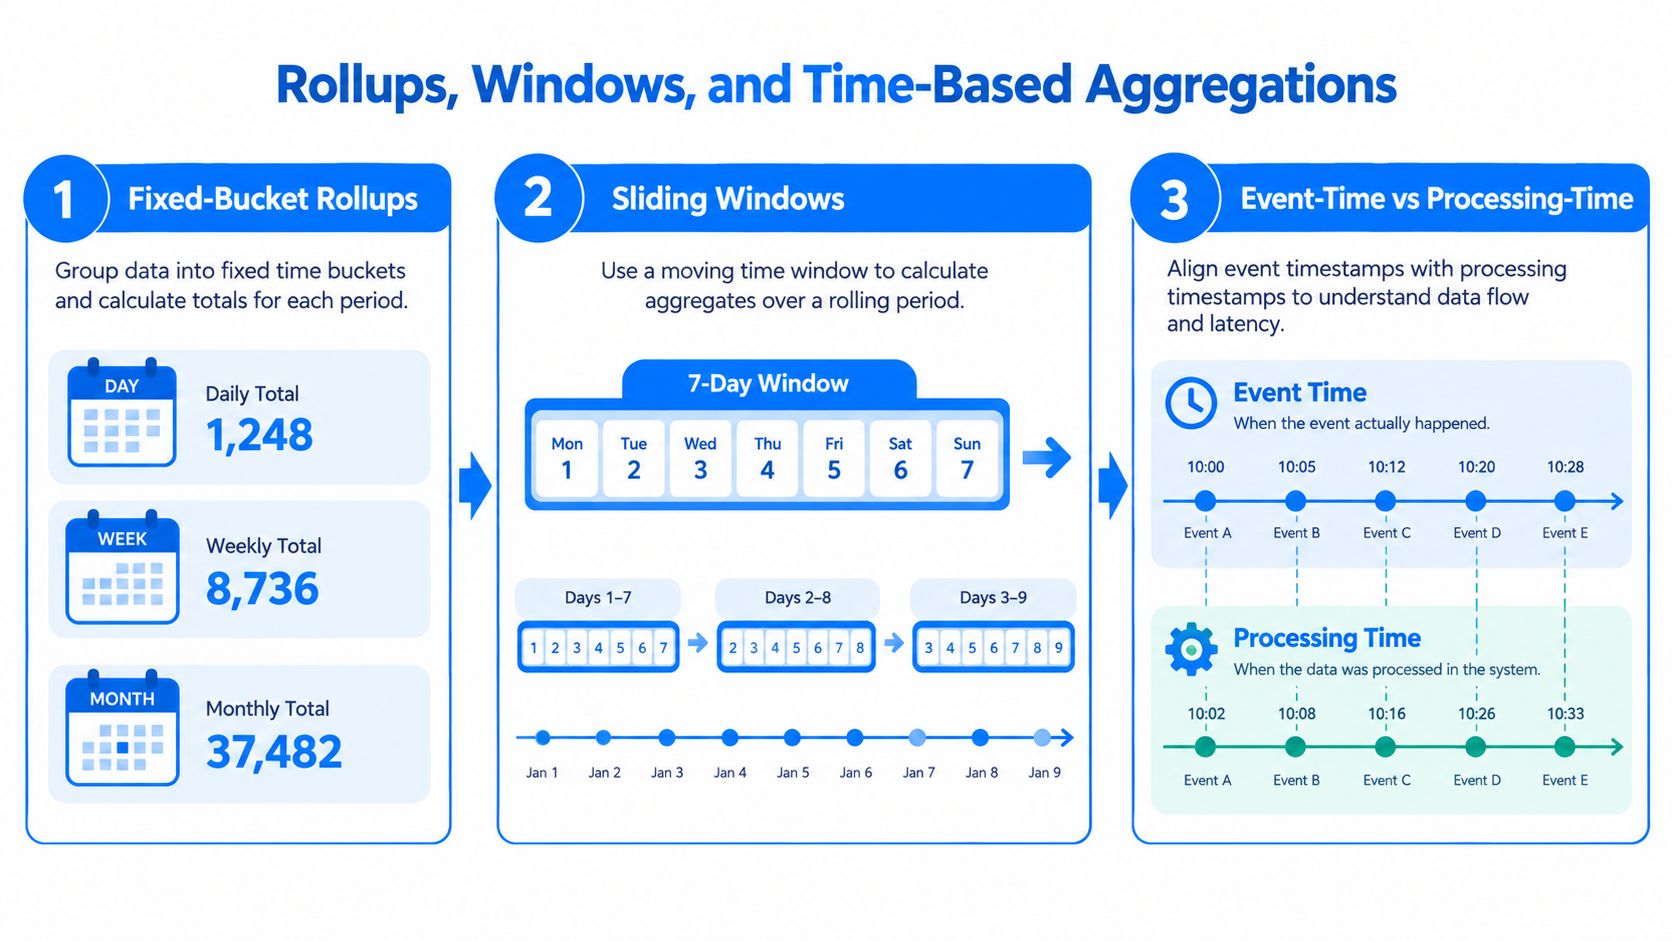
Intervalli fissi e viste mobili
Un rollup a intervalli fissi raggruppa i record in periodi di calendario come giorno, settimana o mese. Se un team vendite vuole i ricavi mensili per regione, il confine dell'intervallo è il mese, e ogni ordine finisce in un intervallo o nell'altro in base alla sua data. Questo rende facili da confrontare i report ricorrenti, ma significa anche che la regola di cut-off deve essere esplicita.
Una finestra scorrevole mantiene l'intervallo in movimento. Una media mobile a 7 giorni attenua il rumore giornaliero e mostra la tendenza che un singolo totale giornaliero nasconderebbe. Il rovescio della medaglia è che ogni nuovo giorno cambia il risultato, quindi il dato di ieri può variare quando arrivano record in ritardo.
Tempo dell'evento e tempo di elaborazione non sono la stessa cosa
Il tempo dell'evento è il momento in cui sono avvenuti la vendita, il clic o la lettura del sensore. Il tempo di elaborazione è il momento in cui il vostro sistema li ha ricevuti. Se le spedizioni arrivano in ritardo, una dashboard basata sul tempo dell'evento resta fedele alla realtà, mentre una basata sul tempo di elaborazione può sembrare completa troppo presto e poi cambiare.
Ecco perché i dati in ritardo mandano in crisi le dashboard ingenue, ed ecco perché i team abbinano i rollup ai types of anomaly detection per individuare gli aggregati che si discostano dalla propria baseline. I record grezzi possono essere corretti e l'aggregato può comunque essere sbagliato per la finestra di report scelta.
Per i team di engineering che gestiscono questi rollup all'interno di motori SQL e job di pipeline, l'in-database processing mantiene la logica vicina ai dati e riduce gli spostamenti non necessari.
Dove avviene l'aggregazione nei sistemi di dati moderni
L'aggregazione compare ovunque un utente a valle abbia bisogno di risposte più rapide o più semplici di quelle che i record grezzi possono offrire. Lo strato di storage cambia, ma lo schema resta lo stesso: raggruppare i record, sintetizzarli e servirli in una forma utilizzabile.

Le sedi abituali dei rollup
I database operativi alimentano spesso dashboard in tempo reale, soprattutto quando un team vuole visibilità sui livelli di servizio a partire dalle transazioni live. Il punto debole è la pressione sulla freschezza dei dati, perché rollup pesanti possono rallentare lo stesso sistema che deve servire il traffico applicativo.
I data warehouse ospitano di solito modelli dimensionali e tabelle dei fatti precalcolate. È lì che vivono spesso i report di finanza, vendite e management, ma i rollup del warehouse possono disallinearsi dalle tabelle di origine se la logica di aggiornamento è incompleta o il partizionamento non è coerente.
Data lake e lakehouse supportano pipeline batch e in streaming, il che li rende flessibili per carichi di lavoro misti. Il prezzo è la complessità, perché le finestre di streaming possono perdere eventi in ritardo e i job batch possono nascondere problemi fino all'esecuzione successiva.
Scegliere la sede in base alla domanda
Le piattaforme di observability usano rollup di metriche per l'alerting e l'analisi delle tendenze, perché gli alert hanno bisogno di sintesi rapide anziché di log grezzi. Se vi serve un orientamento architetturale per progettare uno stack moderno, la panoramica modern data architecture approaches di Ekipa è un riferimento utile su come questi livelli si integrano di solito.
Quando l'aggregazione gira vicino ai sistemi di produzione, la forma della query conta quanto la matematica. Una dashboard veloce costruita sul raggruppamento sbagliato può essere più pericolosa di una lenta che è palesemente incompleta.
Perché i dati aggregati contano per analytics e observability
Dashboard, reporting per il management, segnalazioni regolamentari e feature di machine learning dipendono tutti da viste aggregate. Questo significa che un solo aggregato debole può propagare errori ovunque a valle, anche quando i dati di origine grezzi sono ancora intatti.
L'aspetto dell'observability è altrettanto importante. Un totale o un tasso insolito è spesso il primo indizio che qualcosa è cambiato a monte, che si tratti di un join rotto, di una partizione mancante, di un feed in ritardo o di una modifica dello schema. Le metriche aggregate rendono questi segnali visibili rapidamente, ed è per questo che i team le monitorano per prime.
Che cosa nasconde l'aggregazione se il contesto non la accompagna
Un totale può celare una popolazione in calo. Una media può nascondere una coda lunga. Un tasso può sembrare stabile mentre il denominatore cambia. Per questo i buoni aggregati portano con sé metadati accanto al numero, tra cui il conteggio dei record, la copertura e le dimensioni di raggruppamento che hanno determinato il risultato.
Per i team che costruiscono viste di monitoraggio, la domanda non è solo "qual è la metrica?", ma anche "quali record l'hanno alimentata, che cosa è stato escluso e che cosa è cambiato dall'ultima volta?". La risposta stabilisce se il numero è affidabile o solo ordinato.
Se lavorate già con stack di monitoraggio, la pagina what is data observability è un complemento pratico a questa idea, perché presenta le metriche come qualcosa da esaminare e non solo da visualizzare.
Rischi per la privacy e di divulgazione negli output aggregati
In molti casi l'aggregazione migliora la privacy, ma non è sinonimo di anonimato. Il NIST definisce le informazioni aggregate come dati raccolti su più individui per effettuare confronti o identificare pattern, e avverte anche che la compilazione di dati può creare rischi aggiuntivi, perché l'insieme dei dati può rivelare un quadro più completo o consentire la de-anonimizzazione NIST aggregated information.
Perché i gruppi piccoli creano ancora esposizione
Le regole di controllo della divulgazione esistono perché le celle piccole possono ancora ricondurre a persone o organizzazioni. Le linee guida della statistica ufficiale turca considerano riservata una cella di una tabella aggregata quando contiene meno di 3 unità statistiche, e segnalano anche i casi di dominanza in cui un'unità contribuisce per oltre l'80% al valore della cella o due unità per oltre il 90% NIST data aggregation. La Care Quality Commission britannica cita inoltre come regola empirica di evitare gruppi di 10 o meno, ammettendo gruppi di 5 o meno solo in situazioni a rischio particolarmente basso CQC anonymisation guidance.
Non si tratta di soglie di sicurezza universali. Il rischio dipende comunque dalla geografia, dalla granularità temporale, dalle conoscenze esterne e da ciò che un osservatore determinato può dedurre combinando più viste.
I controlli da inserire nel processo di pubblicazione
La generalizzazione allarga una categoria ristretta in una più ampia, per esempio la regione invece della provincia. La soppressione nasconde del tutto il valore quando una cella è troppo piccola. La perturbazione modifica il valore pubblicato per ridurre il rischio di divulgazione senza scartare l'intera metrica. Nella pratica, questi controlli funzionano insieme, non isolatamente.
Un errore comune è pensare che una dashboard sia sicura perché non mostra più i nomi. Filtri stretti possono ricreare molto rapidamente il rischio di identificazione, soprattutto per area geografica, intervallo di date o segmento di clientela. Se consentite agli utenti di scendere troppo nel dettaglio, l'aggregato può smettere di comportarsi come un gruppo e iniziare a comportarsi come una singola riga travestita.
La Customer data protection guidance è rilevante qui, perché i controlli sulla privacy funzionano solo se vengono valutati rispetto al contesto esatto di pubblicazione, non solo rispetto all'etichetta "aggregato".
Validazione e qualità dei dati
Un aggregato può essere matematicamente corretto e comunque fuorviante. Per questo gli output aggregati hanno bisogno di controlli di qualità propri, non solo di un esito superato o non superato sulle righe di origine.
I controlli che intercettano i problemi più comuni
Le medie possono nascondere il paradosso di Simpson, in cui una tendenza si inverte dopo la suddivisione per una dimensione rilevante. Un KPI può sembrare sano nel rollup mentre una regione o un segmento sottostante peggiora. Non è un errore di calcolo, è un errore di raggruppamento.
Le protezioni pratiche sono semplici:
Dimensione minima del gruppo: verificate che ogni gruppo pubblicato sia abbastanza grande da ridurre sia il rischio di divulgazione sia le conclusioni rumorose.
Stabilità del denominatore: controllate se la popolazione dietro un tasso è cambiata in modo da rendere i confronti squilibrati.
Gestione dei valori nulli: decidete se i valori mancanti vengono esclusi, imputati o trattati come zero prima che il rollup venga eseguito.
Gestione dei duplicati: rimuovete o segnalate i record ripetuti prima che gonfino i totali.
Dati in ritardo: riconciliate il tempo dell'evento con il tempo di elaborazione, così che la dashboard non si presenti come definitiva troppo presto.
Lineage: mantenete il percorso dall'aggregato ai record di origine e alla logica di raggruppamento.
Segnali che dovrebbero far partire un'indagine
Se la popolazione aggregata si riduce all'improvviso, diventa molto concentrata o cambia dimensioni in modo da aumentare il rischio di divulgazione, qualcuno dovrebbe rivedere subito la pipeline. Non sono cambiamenti cosmetici. Di solito significano che la definizione, il feed di origine o il contesto di pubblicazione sono cambiati.
Per il lavoro sulla qualità e sull'applicazione delle regole, data validation rules, checks, and continuous data quality è un tema complementare pertinente, perché lo scopo della validazione è rendere l'aggregato affidabile, non soltanto calcolato.
Regola pratica: non chiedetevi se la metrica è "giusta" finché non avete verificato che gruppo, denominatore e lineage significhino ancora ciò che pensate.
Un esempio pratico: dai record grezzi a un aggregato affidabile
Partiamo da un flusso di eventi di acquisto dei clienti. Ogni record contiene un timestamp, una regione, il valore dell'ordine e lo stato della spedizione. Il primo aggregato è semplice: si calcola la somma dei valori degli ordini e il conteggio degli ordini per giorno e regione, ottenendo ricavi giornalieri e volume degli ordini.
Costruire la tendenza senza perdere il contesto decisionale
Poi si aggiunge una media mobile a 7 giorni sopra i totali giornalieri. Attenua le oscillazioni del fine settimana e offre al team una linea di tendenza più stabile per la revisione operativa. Se una spedizione in ritardo arriva dopo la chiusura giornaliera, la versione dell'aggregato basata sul tempo dell'evento va ricalcolata, mentre la vista basata sul tempo di elaborazione può restare come audit trail del momento in cui il sistema ne è venuto a conoscenza.
Poi arriva la decisione sulla privacy. Se una regione ha troppo pochi ordini, o se un solo esercente contribuisce quasi a tutto in quella regione, il team dovrebbe accorpare l'area geografica o sopprimere la cella invece di pubblicare un numero fragile. Così la dashboard resta utile senza rendere più facile risalire a una persona o a un fornitore.
Trattare l'aggregato come un asset monitorato
Una volta che la metrica è in produzione, entra a far parte dell'observability. Se il totale dei ricavi giornalieri crolla ma il numero di ordini no, è un segnale per controllare prezzi, rimborsi o valori mancanti. Se la popolazione dietro la metrica cambia all'improvviso, il team dovrebbe esaminare la logica dei filtri prima che chiunque si fidi del grafico.
Il senso dell'esempio è semplice. L'aggregazione non è il passaggio finale. È il punto in cui correttezza, privacy e fiducia operativa si incontrano.
Riferimento rapido per lavorare con i dati aggregati
Definizione: i dati aggregati sono informazioni a livello di gruppo create combinando singoli record in sintesi come conteggi, totali, medie, tassi o distribuzioni.
Funzioni comuni:
Somma per i volumi. Conteggio per la frequenza dei record. Media per il valore tipico. Mediana per le distribuzioni asimmetriche. Minimo e massimo per i controlli di intervallo. Tasso e percentuale per i rapporti, con un denominatore definito con cura.
Soglie di privacy da ricordare:
Anche i gruppi piccoli possono rivelare informazioni. Quando valutate il rischio di pubblicazione, fate attenzione a meno di 3 unità, a pattern di dominanza oltre l'80% o il 90% e a gruppi con pochi casi, intorno a 10 o meno.
Controlli di validazione da mantenere:
Dimensione minima del gruppo, stabilità del denominatore, gestione dei valori nulli, gestione dei duplicati, gestione dei dati in ritardo e lineage fino ai record di origine.
Approccio operativo:
L'aggregazione è una trasformazione governata, non una garanzia di privacy né una garanzia di qualità.
digna aiuta i team a monitorare i dati che stanno dietro a questi aggregati, non solo la dashboard che li mostra. Se vi servono rilevamento delle anomalie, validazione, monitoraggio della puntualità dei dati, monitoraggio degli schemi ed esecuzione in-database all'interno del vostro ambiente, visitate digna e scoprite come si inserisce nel vostro data stack.
Per un catalogo delle metriche di volume, freschezza e distribuzione che mantengono affidabili nel tempo aggregati come questi, consultate le metriche di data observability.
Domande frequenti
Che cosa sono i dati aggregati?
I dati aggregati sono informazioni di sintesi a livello di gruppo, create combinando singoli record in conteggi, somme, medie, tassi o distribuzioni. Per esempio, 1 milione di transazioni dei clienti può essere riassunto in 12 totali mensili per mercato, permettendovi di confrontare i mercati e individuare la stagionalità senza esaminare ogni singolo acquisto.
Quali sono le funzioni di aggregazione più comuni?
Somma, conteggio, media, mediana, minimo, massimo, tasso e percentuale coprono la maggior parte del reporting. Ognuna conserva qualcosa di diverso: la somma mantiene il volume, il conteggio l'attività, la mediana resiste agli outlier nei dati asimmetrici, mentre minimo e massimo servono per i controlli di intervallo. Tassi e percentuali hanno senso solo con un denominatore stabile e ben definito.
I dati aggregati sono anonimi?
Non automaticamente. L'aggregazione riduce il rischio per la privacy, ma gruppi piccoli o dominati da pochi membri possono ancora ricondurre a persone o organizzazioni. Alcune linee guida della statistica ufficiale considerano riservata una cella con meno di 3 unità o in cui un'unità contribuisce per oltre l'80% al valore, quindi può servire la soppressione o la generalizzazione.
Perché non bisogna fare la media delle percentuali tra gruppi?
Fare la media di percentuali provenienti da gruppi di dimensioni diverse dà a un gruppo piccolo lo stesso peso di uno grande, distorcendo il risultato. Se volete sapere quale quota di tutto il traffico ha convertito, dividete il totale delle conversioni per il traffico totale invece di fare la media dei tassi di conversione mensili.
Come si validano i dati aggregati?
Controllando l'aggregato stesso, non solo le righe di origine: dimensione minima del gruppo, stabilità del denominatore, gestione di valori nulli e duplicati, dati in ritardo e lineage fino ai record di origine. Poi va monitorato nel tempo. Se i ricavi giornalieri crollano mentre il numero di ordini resta stabile, controllate prezzi, rimborsi o valori mancanti.


