Processo di gestione dei problemi di qualità dei dati: come risolverli in fretta
|
10
min di lettura

La dashboard dice che i ricavi sono in calo. Il CFO chiede se è diminuita la domanda, se sono cambiati i prezzi o se il reparto finance ha caricato di nuovo la tabella sbagliata. Su Slack un analista ha già pubblicato uno screenshot con tre numeri diversi per lo stesso KPI. Qualcuno corregge un modello SQL, rilancia una pipeline e dichiara il problema risolto.
Poi, due giorni dopo, lo stesso problema si ripresenta da un'altra sorgente a monte.
È lo schema con cui convivono molti team dati. Non un singolo campo rotto, ma un ciclo ricorrente di caricamenti obsoleti, schema drift silenzioso, alert duplicati e responsabilità poco chiare. Le correzioni ad hoc sembrano rapide sul momento, ma di solito si fermano al sollievo dai sintomi. Non stabiliscono chi è responsabile del difetto, quale tempo di risposta è accettabile o come il team impedisce che la stessa classe di problemi si riapra.
Indice
Perché i problemi di qualità dei dati richiedono un processo gestito
Che cosa conta come problema di qualità dei dati e come misurarlo
Il workflow di gestione dei problemi di qualità dei dati, dal rilevamento alla prevenzione
Come smistare, dare priorità e assegnare la responsabilità con gli SLA
Integrare il processo negli strumenti, nei ruoli e nelle attività quotidiane
Prevenire i problemi ricorrenti e dimostrare che il processo funziona
Perché i problemi di qualità dei dati richiedono un processo gestito
Alle 6:10 arriva un caricamento difettoso. Alle 8:00 il reparto finance mette in dubbio i ricavi, un analista ha silenziato tre alert rumorosi e un ingegnere sta rilanciando un job senza sapere se il difetto è nato nell'ingestion dalla sorgente, in una modifica di trasformazione o in una tabella di riferimento rotta. Spesso i team chiamano tutto questo triage. In pratica è lavoro sulla coda senza un modello operativo.
La distinzione è importante. Un processo di gestione dei problemi di qualità dei dati ben gestito non è solo un modo per individuare più in fretta i record errati. Stabilisce responsabilità, gravità, SLA, percorsi di escalation e attività di prevenzione, così che la stessa classe di difetti non continui a tornare con un nuovo numero di ticket.
Le ricerche sull'impatto aziendale mostrano perché la gestione ad hoc fallisce su larga scala. La scarsa qualità dei dati è stata associata a un costo medio annuo di 12,9 milioni di dollari per organizzazione, e una ricerca del MIT Sloan ha riportato in alcuni contesti una riduzione dei ricavi annui dal 15% al 25% dovuta alla scarsa qualità dei dati, come riassunto in queste statistiche sul miglioramento della qualità dei dati. La stessa sintesi cita un risultato molto noto della Harvard Business Review secondo cui solo il 3% dei dati aziendali rispettava standard di qualità di base, mentre MIT Sloan e Thomas Redman hanno riportato che il 47% dei record appena creati conteneva almeno un errore critico.
Le correzioni ad hoc falliscono al confine della responsabilità
La prima correzione è spesso la parte facile. La parte difficile è decidere chi è responsabile della causa principale, chi della comunicazione verso valle, quale tempo di risposta il business deve aspettarsi e quale modifica impedisce che il problema si ripeta.
Senza queste regole i team puntano alla chiusura invece che alla risoluzione. Una persona corregge un modello. Un'altra sopprime l'alert. Nessuno aggiorna la soglia, aggiunge un test di contratto o assegna un responsabile permanente per il sistema sorgente. Il problema sparisce dalla coda e resta nel sistema.
Regola pratica: se un difetto può ripresentarsi, assegnate un responsabile, definite un obiettivo di risposta e decidete quale controllo l'avrebbe intercettato prima.
Per questo la gestione dei problemi va trattata come un modello operativo. Il rilevamento ne è una parte. Il resto è disciplina di processo: un solo record per ogni difetto sottostante, criteri di gravità chiari, timer degli SLA, passaggi di consegne che non si arenano su Slack e un ciclo di prevenzione che produce modifiche a codice, test, metadati o comportamento del sistema sorgente.
Ho visto team passare più tempo a discutere se un problema fosse "davvero di qualità dei dati" che a decidere chi dovesse risolverlo. Di solito significa che al processo mancano un'unità di lavoro comune e un'aspettativa di servizio. Il risultato è noto. Cresce l'alert fatigue, la responsabilità si fa sfumata e gli utenti di business iniziano a mantenere fogli di calcolo paralleli perché si fidano più dei propri controlli manuali che della piattaforma.
Processo gestito significa processo misurabile
Un team non può migliorare ciò che non conta in modo coerente. Se ogni controllo fallito diventa un incidente separato, la coda sembra peggiore di quanto sia. Se i team registrano solo i problemi visibili al management, la coda sembra più sana della realtà. In entrambi i casi le priorità vengono distorte.
La vista utile è quella operativa. Misurate il tasso di problemi rispetto a un'unità definita, poi monitorate le prestazioni sugli SLA per gravità, dominio della sorgente e classe di problemi ricorrenti. Così vedete se il problema riguarda la copertura del rilevamento, la disciplina del triage, la debolezza delle responsabilità o difetti ricorrenti a monte. Inoltre offre ai responsabili dei dati argomenti migliori per gli investimenti rispetto al dire che la qualità dei dati "sembra scarsa".
Questo business case spesso parte da una spiegazione più ampia del perché la qualità dei dati è importante per un'organizzazione, ma il vantaggio quotidiano è più semplice. Meno ticket duplicati. Tempi di presa in carico più brevi. Instradamento più rapido verso il responsabile. Più correzioni che eliminano la modalità di guasto invece di ripulirne i sintomi.
Ciò che funziona raramente è spettacolare. Soglie chiare. Responsabili con nome e cognome. Obiettivi di risposta garantiti da SLA. Regole di escalation che scattano prima che se ne accorga il management. Azioni post-incidente che cambiano il sistema.
Che cosa conta come problema di qualità dei dati e come misurarlo
I team partono troppo tardi. Si lanciano nel triage prima di essersi accordati su che cosa sia un problema.
È un errore, perché le vostre metriche crollano nel momento in cui team diversi contano cose diverse. Una squadra tratta ogni controllo fallito come un problema. Un'altra registra solo gli incidenti che toccano il business. Una terza apre cinque ticket per un unico difetto a monte perché sono falliti cinque modelli a valle. Non potete gestire bene quella coda, perché non state misurando la stessa unità di guasto.
Definite il problema prima di definire il workflow
Una metodologia pratica consiste nel contare come problema di qualità dei dati una di tre cose: un controllo di qualità fallito oltre la soglia, una violazione di freschezza o di SLA, oppure un incidente confermato. Vanno esclusi i falsi positivi e i fallimenti dei job non legati alla qualità dei dati, secondo questa metodologia del tasso di problemi.
L'elemento della soglia è importante. Una linea guida nazionale sulla gestione della qualità dei dati stabilisce che ogni metrica deve avere una soglia di accettazione espressa come percentuale o come numero di record, e inquadra la gestione dei problemi come un processo continuo di identificazione, tracciamento e risoluzione dei problemi in tutta l'entità nel documento della linea guida. In pratica, “esistono email nulle” è descrittivo, mentre “le email nulle hanno superato la soglia accettata” è operativo.
Scegliete il denominatore adatto alla vostra maturità
È sul denominatore che i team creano un KPI utile oppure una metrica di facciata. Se monitorate un gran numero di controlli, il rapporto tra controlli falliti e controlli eseguiti può funzionare. Se seguite solo un insieme di asset critici, il numero di problemi sui dataset monitorati è spesso più pulito. Se il vostro ambiente è fortemente orientato al batch e ad alti volumi, la densità di problemi per record elaborati può avere più senso.
Base di misurazione | Quando usarla | KPI di esempio |
|---|---|---|
Basata sui controlli | Eseguite molti controlli automatizzati su pipeline e tabelle | Tasso di controlli falliti |
Basata sui dataset | Monitorate un elenco selezionato di dataset critici | Problemi per dataset critico monitorato |
Basata sui volumi | Elaborate grandi volumi di record e volete monitorarne la densità | Problemi per 1 milione di record elaborati |
L'obiettivo non è trovare il denominatore migliore in assoluto. È sceglierne uno che rifletta il funzionamento della vostra piattaforma e mantenerlo stabile abbastanza a lungo da confrontare le tendenze.
Ripulite gli input prima di fidarvi degli output
Prima di calcolare i KPI sui problemi, raccogliete i dati operativi che dimostrano che cosa è successo. Di solito comprendono:
Risultati dei controlli: fallimenti di validazione, output del rilevamento anomalie, violazioni di freschezza.
Log delle pipeline: stato di esecuzione, tentativi ripetuti, fallimenti delle dipendenze a monte.
Dati dei ticket: aperto, preso in carico, mitigato, risolto, riaperto.
Metadati di lineage: che cosa si è rotto a monte e quali consumatori lo hanno ereditato.
Poi fate il lavoro meno appariscente:
Deduplicate gli alert correlati, così cinque fallimenti a valle legati a un unico difetto della sorgente diventano un solo problema.
Standardizzate le categorie di causa principale, così “schema drift”, “estrazione della sorgente in ritardo” e “mappatura di riferimento errata” significano sempre la stessa cosa.
Separate la creazione del problema dalla sua conferma se il vostro livello di alerting è rumoroso.
Monitorate gli esiti degli SLA solo dopo che la tassonomia dei problemi si è stabilizzata.
Una metrica che non potete confrontare da un mese all'altro non è una metrica di gestione. È un'istantanea.
Per i team che stanno affinando dimensioni e soglie, è utile allineare le definizioni dei problemi alle principali dimensioni della qualità dei dati e poi associare a ciascuna criteri di accettazione chiari. In questo modo engineering, analytics e responsabili di business parlano la stessa lingua prima che la coda degli incidenti inizi a muoversi.
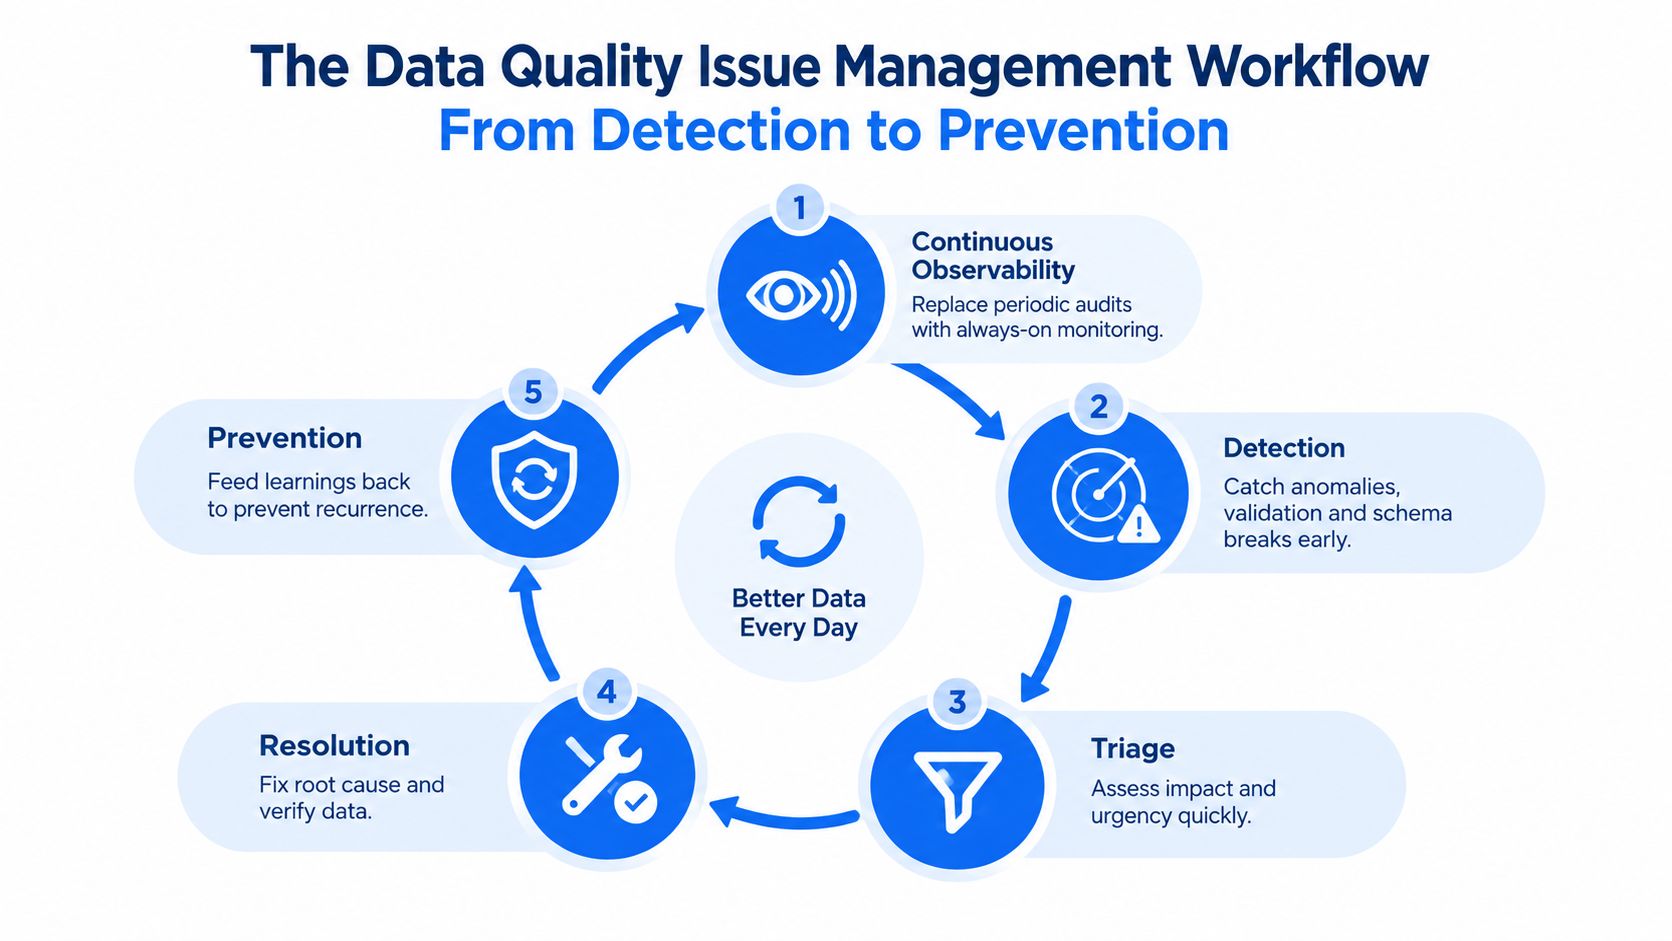
Il workflow di gestione dei problemi di qualità dei dati, dal rilevamento alla prevenzione
Alle 8:15 il reparto finance apre una dashboard prima della chiusura di fine mese e i numeri di ieri mancano. Il job di ingestion è tecnicamente riuscito. Il data warehouse è attivo. Il livello BI serve dati obsoleti perché un'estrazione a monte è arrivata con tre ore di ritardo e nessuno era responsabile del controllo di freschezza. Ecco come appare in produzione un workflow debole di gestione dei problemi. Il guasto non riguarda solo il rilevamento. È la mancanza di un modello operativo che colleghi monitoraggio, responsabilità, obiettivi di risposta e prevenzione.
Partite da un'osservabilità che generi problemi gestibili
La gestione dei problemi inizia prima che esista un ticket. I team hanno bisogno di segnali che dicano che cosa è fallito, quando è fallito, che cosa è cambiato e chi è esposto.
Le revisioni periodiche non possono svolgere questo compito. I difetti di produzione compaiono tra un ciclo di revisione e l'altro e, quando qualcuno se ne accorge, tabelle, dashboard o modelli a valle hanno già consumato i dati errati. Un buon monitoraggio e reporting per le operazioni di qualità dei dati riduce il divario tra l'introduzione del difetto e la risposta umana.
I segnali utili rientrano di solito in quattro gruppi:
Freschezza e tempestività: caricamenti mancanti, consegne in ritardo, arrivo parziale dei batch
Fallimenti di validazione: campi obbligatori, valori ammessi, unicità, regole di riconciliazione
Modifiche strutturali: colonne aggiunte, colonne eliminate, cambi di tipo, violazioni di contratto
Cambiamenti di comportamento: picchi di volume, variazioni del tasso di null, drift delle distribuzioni, movimenti inattesi delle metriche
Il compromesso è semplice. Più controlli intercettano più difetti, ma generano anche più rumore. I team che monitorano tutto con la stessa sensibilità di solito abituano chi risponde a ignorare gli alert. L'obiettivo è creare problemi che meritano di essere gestiti, non una coda piena di falsi positivi.
Separate il rilevamento dalla validazione
Un controllo fallito è un evento. Un problema è un evento validato, con un perimetro, un impatto e un responsabile.
La distinzione è importante perché i flussi di alert sono rumorosi. Una modifica di schema in una tabella sandbox non dovrebbe competere con un feed dei ricavi rotto. Se il processo crea un ticket per ogni anomalia senza validazione, il team passa la giornata a chiudere rumore e si perde l'incidente che compromette le scadenze di reporting o i prodotti rivolti ai clienti.
GitLab documenta una sequenza pratica nel suo handbook del programma di qualità dei dati: Rilevamento → Triage e validazione → Indagine → Risoluzione → Prevenzione → Chiuso. Il valore di questo flusso è il punto di decisione. Prima che un problema entri nella coda principale, qualcuno conferma che è reale, verifica se i consumatori sono coinvolti e decide se appartiene al percorso degli incidenti o al backlog standard.
Questo passaggio migliora anche la misurazione. Il volume dei rilevamenti indica quanto è rumoroso il sistema. Il volume dei problemi confermati indica che cosa devono gestire gli operatori. Monitorando entrambi i team individuano soglie deboli e tassi di problemi gonfiati.
L'indagine deve ricondurre il difetto al punto di controllo
La risoluzione rallenta quando i team inseguono il sintomo visibile invece della sorgente. Lo vedo spesso con i guasti a valle. Una dashboard fallisce e le persone iniziano a correggere la logica BI, anche se il vero guasto si trova in un'estrazione a monte, in una modifica del codice del sistema sorgente o in una dipendenza dello scheduler.
Alcuni schemi si ripetono di continuo:
Dati in ritardo: la dashboard obsoleta è il sintomo. La causa principale è di solito un ritardo a monte, una raffica di tentativi ripetuti o il fallimento di una dipendenza.
Schema drift: il modello del data warehouse si rompe dopo che una sorgente cambia un tipo o elimina un campo.
Violazione di una regola di business: una tabella di mappatura o un feed di riferimento accetta un nuovo valore che nessuna regola a valle si aspetta.
L'Australian Bureau of Statistics descrive un processo a fasi nel suo manuale di gestione e reporting degli incidenti di qualità: monitorare la qualità, identificare il problema, valutarlo, avviare il percorso di reporting appropriato, quindi valutare e attuare l'azione correttiva. Questa sequenza regge nella pratica perché la valutazione è esplicita. I team che la saltano tendono a sovra-escalare anomalie innocue o a sottovalutare difetti che si propagano a più consumatori.
La risoluzione non è completa finché la fiducia non è ripristinata
Chiudere il guasto tecnico è solo una parte del lavoro. La domanda è se i consumatori possono di nuovo fidarsi dei dati.
Un flusso di risoluzione efficace comprende di solito quattro azioni:
Contenimento. Mettere in pausa un consumatore, sospendere una dashboard rotta, annullare una trasformazione o isolare i record errati.
Correzione. Risolvere il guasto nel livello sorgente che ha introdotto il difetto.
Verifica. Rieseguire i controlli, riconciliare gli output chiave e confermare che i dati a valle si sono ripresi.
Comunicazione. Spiegare agli utenti coinvolti che cosa non andava, che cosa è stato corretto e da quale timestamp i dati sono sicuri da usare.
L'handbook di gestione degli incidenti di GitLab è utile in questo caso perché tratta gli incidenti sui dati come eventi operativi che richiedono assegnazione, documentazione e comunicazione strutturate. È uno schema migliore che affidarsi a un lungo thread su Slack che nessuno potrà verificare in seguito.
La prevenzione chiude il cerchio e dimostra che il processo funziona
La prevenzione fa parte del workflow, non viene dopo. Se la stessa classe di difetti continua a ripresentarsi, il team non ha un problema di rilevamento. Ha un problema di progettazione dei controlli.
La correzione potrebbe essere una regola di validazione più stringente in fase di ingestion, un data contract per una sorgente instabile, uno SLO di freschezza con un responsabile esplicito o un aggiornamento del runbook che elimina le ambiguità nel passaggio di consegne. La scelta giusta dipende da dove il problema è entrato nel sistema e da quanto costa intercettarlo prima.
È anche qui che la gestione dei problemi diventa un modello operativo. Misurate il tasso di problemi ricorrenti per categoria di causa principale. Misurate quanti problemi rispettano gli SLA di presa in carico, mitigazione e risoluzione. Misurate il tasso di riapertura dopo la chiusura. Questi numeri vi dicono dove investire. Una coda con chiusure rapide ma alta ricorrenza di solito ha bisogno di controlli preventivi più solidi. Una coda con bassa ricorrenza ma scarse prestazioni sugli SLA di solito ha problemi di responsabilità o di instradamento.
Come smistare, dare priorità e assegnare la responsabilità con gli SLA
Alle 9:07 il reparto finance segnala che la dashboard dei ricavi di ieri è scesa del 18 percento. Il responsabile della dashboard vede il sintomo, ma il difetto si trova tre passaggi a monte, in un'estrazione della sorgente arrivata in ritardo, e la regola per escludere le transazioni di test non è ancora documentata. Senza un modello di triage tre team iniziano a indagare, nessuno è responsabile del tempo e il business riceve aggiornamenti senza una stima del ripristino.
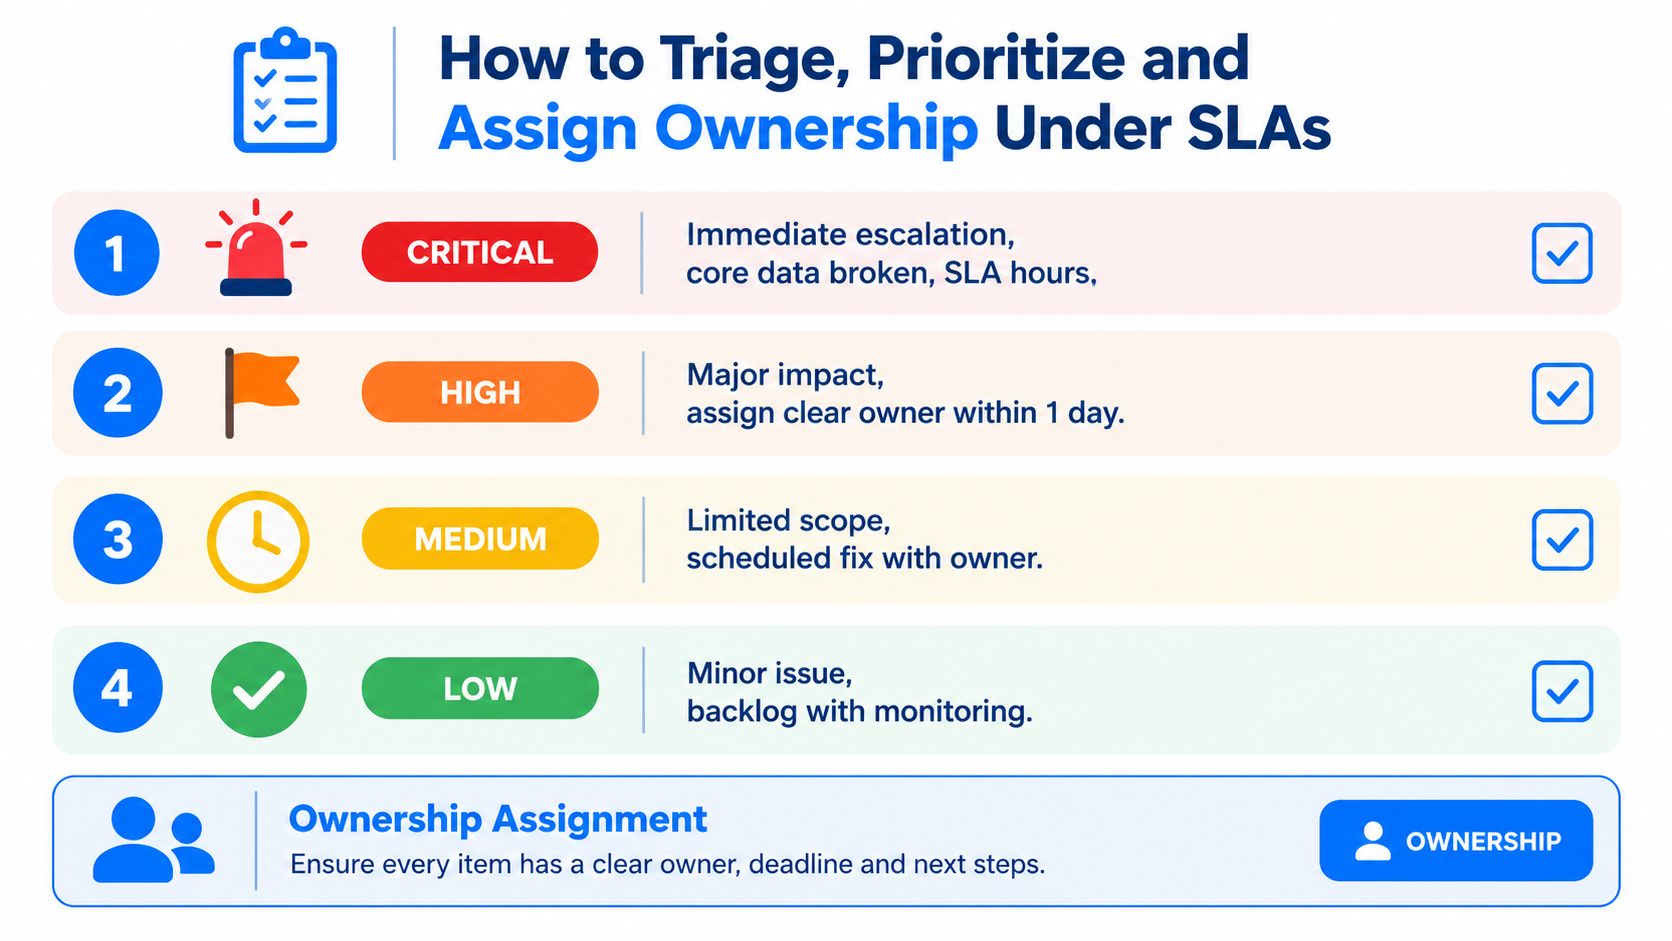
Questo è il compito di questa fase. Stabilire rapidamente la gravità, assegnare un responsabile diretto e associare al problema obiettivi di risposta e risoluzione, così che non resti a galleggiare in una coda condivisa.
Usate la gravità per rendere espliciti i compromessi
La gravità deve rispondere a una sola domanda: quanto rischio di business siamo disposti a sopportare prima che questo venga risolto?
Un modello pratico usa obiettivi separati per presa in carico, mitigazione e risoluzione finale. Spesso i team lavorano con finestre di risposta misurate in ore per gli incidenti più gravi, mitigazione in giorni e risoluzione completa su tempi più lunghi quando la correzione definitiva richiede modifiche al codice, coordinamento con il team della sorgente o backfill. Gli obiettivi precisi contano meno della coerenza. Se "alta priorità" significa in giornata per un team e nel prossimo sprint per un altro, lo SLA è solo rumore.
Stabilite la gravità in base a tre fattori:
Impatto sul business: quali decisioni, report, modelli o workflow dei clienti sono coinvolti?
Raggio d'impatto: fin dove si è propagato il problema nelle tabelle e nelle dashboard a valle?
Rischio di controllo: tocca output regolamentati, reporting per il management, fatturazione o metriche visibili all'esterno?
Mantenete il modello snello. Di solito quattro livelli bastano. Di più generano discussioni senza migliorare l'instradamento.
Assegnate la responsabilità al dominio della correzione
Il primo team che nota il problema raramente è il responsabile giusto. Il responsabile giusto è il team che può modificare il controllo, il percorso del codice o il comportamento della sorgente che fallisce.
Usate un modello di instradamento come questo:
Livello di gravità | Condizione tipica | Responsabile principale | Percorso di escalation |
|---|---|---|---|
Critico | Data product principale rotto o impatto immediato sul business | DRI della data platform o dell'engineering di dominio | Canale degli incidenti e notifica al management |
Alto | Impatto rilevante a valle ma raggio d'impatto limitato | Responsabile del dataset con supporto dell'engineering | Revisione formale dell'incidente se la mitigazione si blocca |
Medio | Problema circoscritto con soluzione alternativa disponibile | Analytics engineering o data steward | Correzione pianificata con tracciamento |
Basso | Difetto estetico, a basso impatto o isolato | Responsabile del backlog | Monitorare la tendenza e rivalutare se si ripete |
Questo colma una lacuna di responsabilità molto comune. I team di piattaforma sono responsabili di pipeline e controlli. I team applicativi del comportamento dei sistemi sorgente. I responsabili di business dell'intento delle regole e dei criteri di accettazione. Tutti e tre possono essere coinvolti, ma un solo DRI deve essere responsabile del timer dello SLA, degli aggiornamenti di stato e dell'azione successiva.
Se l'intento di una regola non ha un responsabile, gli ingegneri ne inventeranno uno sotto pressione.
Stabilite le priorità tenendo conto della capacità
Le code degli incidenti falliscono quando ogni alert rosso viene trattato come ugualmente urgente. La capacità è limitata. Alcuni difetti meritano un'interruzione immediata. Per altri è più conveniente contenerli, documentarli e correggerli nel lavoro pianificato.
Le ricerche sulle pratiche di qualità dei dati hanno indicato la frammentazione delle responsabilità e una gestione incoerente come cause ricorrenti di risultati scadenti in questo studio sui problemi sistemici. Anche la ricerca in ambito sanitario ha individuato piani d'azione poco chiari, risorse limitate e formazione carente come ostacoli nella discussione del sondaggio pubblicato. Questi risultati corrispondono a ciò che emerge nelle code di produzione. Di solito ai team non mancano gli alert. Manca un modo coerente per decidere che cosa interrompe il lavoro in corso.
Usate quattro domande di triage:
Che cosa si rompe se questo aspetta fino a domani o alla prossima settimana?
Chi consuma per primo i dati coinvolti e quale decisione prenderà su di essi?
Possiamo contenere il problema con un rollback, una quarantena, un'annotazione o un filtro temporaneo?
La ricorrenza è così alta che il lavoro di prevenzione dovrebbe avere la precedenza su un'altra correzione una tantum?
L'ultima domanda è importante. Un problema di gravità media che si ripete ogni settimana di solito merita più attenzione di un singolo difetto molto visibile che difficilmente si ripresenterà.
Gestite la coda rispetto a SLA misurabili
Un unico canale di ingresso aiuta, ma l'igiene della coda è solo una parte del modello operativo. Monitorate se il team rispetta gli obiettivi di presa in carico, mitigazione e risoluzione per gravità. Monitorate il tasso di riapertura. Monitorate il tasso di problemi per dataset, dominio e categoria di causa principale. Queste metriche mostrano se il problema è un cattivo instradamento, controlli deboli o un sottoinvestimento cronico in un'area sorgente.
Usate questi numeri per adeguare le priorità. Una coda con tempi di risoluzione accettabili ma presa in carico scarsa di solito ha problemi di alerting o di copertura della reperibilità. Una coda che rispetta gli SLA di risposta ma manca gli obiettivi di risoluzione finale spesso soffre di attriti di responsabilità tra team. I team che vogliono un modo più chiaro per definire e rivedere questi obiettivi di servizio dovrebbero definirli insieme alle pratiche di misurazione dell'affidabilità, così che tasso di problemi e prestazioni sugli SLA possano essere esaminati insieme e non in dashboard separate.
Una sola coda. Una sola decisione sulla gravità. Un solo DRI responsabile del tempo. È questo che trasforma la gestione dei problemi di qualità dei dati da triage reattivo a modello operativo.
Integrare il processo negli strumenti, nei ruoli e nelle attività quotidiane
Un workflow documentato non sopravvive al contatto con la produzione se non è integrato negli strumenti che le persone usano già.
Ciò significa che il vostro processo di qualità deve vivere dove girano i job del data warehouse, dove gli analisti validano gli output e dove la governance può vedere le tendenze e lo storico degli incidenti. Se aggiungete un silo separato per la qualità, con dashboard, tassonomie ed elenco utenti propri, di solito le responsabilità si frammentano nel giro di un trimestre.
Costruite tutto attorno a un'unica vista operativa
Lo schema pratico è semplice. Eseguite rilevamento anomalie, validazione, monitoraggio della tempestività e tracciamento dello schema sugli stessi dataset critici. Convogliate questi segnali in una dashboard condivisa. Collegate la dashboard al contesto di scheduling, ai metadati, al lineage e al ticketing, così chi risponde può passare dall'alert all'azione senza dover ricomporre le prove a mano.
La scelta di progettazione chiave è il modello di esecuzione. I controlli in-database riducono lo spostamento dei dati e semplificano la revisione di sicurezza, soprattutto negli ambienti regolamentati. Inoltre mantengono la logica di monitoraggio più vicina alle tabelle e alle trasformazioni da verificare.
I ruoli hanno bisogno di un contesto condiviso, non di strumenti separati
Ruoli diversi si interessano a segnali di guasto diversi:
I data engineer vogliono stato delle pipeline, freschezza, tentativi ripetuti e rotture di schema.
Gli analytics engineer e gli sviluppatori BI si interessano a violazioni delle regole di business, sintomi di drift dei modelli e output semantici rotti.
I responsabili di governance e qualità dei dati hanno bisogno di soglie, tendenze, stato di accettazione e prove pronte per l'audit.
Se ciascuno di questi gruppi lavora con un sistema diverso, il triage rallenta perché ogni problema inizia con una riconciliazione. Uno schema migliore è la visibilità condivisa con viste specifiche per ruolo. La piattaforma può esporre lo stesso incidente tramite log tecnici per l'engineering e sintesi dell'impatto sul business per i responsabili non tecnici.
L'adozione modulare batte i rollout big bang
La maggior parte delle organizzazioni non ha bisogno di attivare ogni capacità di monitoraggio fin dal primo giorno. Di solito conviene partire dalla modalità di guasto che crea più problemi e poi estendere la copertura attorno a essa.
È qui che le scelte sugli strumenti contano. Alcuni team iniziano con il monitoraggio della freschezza e dello schema perché questi difetti sono i più facili da rilevare e instradare. Altri partono dalla validazione deterministica perché la compliance o il reparto finance hanno bisogno di prove di controllo esplicite. Negli ambienti misti un'opzione modulare può aiutare. Per esempio, i modelli di implementazione della qualità dei dati funzionano spesso meglio quando lo stack può estendersi da un dominio monitorato a diversi domini senza imporre un nuovo modello operativo.
Un'opzione in questa categoria è digna, che gira all'interno dell'ambiente del cliente e combina rilevamento anomalie, validazione, monitoraggio della tempestività, tracciamento dello schema, supporto allo scheduler, funzionalità di catalogo, integrazioni e una dashboard condivisa. Questa configurazione è utile quando i team vogliono un'esecuzione in-database e non vogliono che i dati di produzione escano dalla propria infrastruttura.
Ciò che resta nel tempo a livello operativo raramente è il rilevatore più sofisticato. È la configurazione che mantiene visibile il processo, tiene agganciate le responsabilità e si adatta all'ambiente che i team hanno già.
Prevenire i problemi ricorrenti e dimostrare che il processo funziona
Una coda che chiude ticket ma continua a riaprire gli stessi schemi di guasto non è matura. È solo indaffarata.
La prova che il vostro processo funziona è semplice. Il rilevamento diventa più rapido. La risoluzione diventa più pulita. I difetti ricorrenti diminuiscono. Gli stakeholder smettono di discutere se possono fidarsi di un report, perché lo storico degli incidenti, il registro delle correzioni e le soglie di accettazione sono visibili.
La prevenzione richiede modifiche dopo l'incidente
Ogni incidente significativo dovrebbe lasciare dietro di sé un miglioramento duraturo. Può essere una nuova soglia, una regola di validazione mancante, un contratto di schema o un passaggio di responsabilità più rigoroso. Se la chiusura registra solo che cosa si è rotto, il sistema non ha imparato nulla.
Le revisioni post-incidente più utili si concentrano sull'individuazione delle cause principali con una precisione sufficiente a modificare i controlli, non solo a descrivere i sintomi. Se il vostro team ha bisogno di un riferimento pratico per questa disciplina, vale la pena tenere nel runbook questa raccolta sull'individuazione delle cause principali.
La domanda giusta dopo la risoluzione non è “chi l'ha sistemato?”. È “che cosa è cambiato perché non ci ritroviamo davanti a questo problema la prossima settimana?”
Monitorate le metriche che cambiano i comportamenti
Le metriche da tenere sotto gli occhi dei team sono quelle che incidono sulla qualità della risposta:
Tempo di rilevamento: quanto a lungo il difetto è esistito prima che il team lo sapesse.
Tempo di risoluzione: quanto a lungo il business è rimasto esposto.
Rispetto degli SLA: se risposta, mitigazione e chiusura hanno raggiunto l'obiettivo.
Tasso di problemi ricorrenti: se la stessa categoria di causa principale continua a tornare.
Esposizione del business: quali report, processi o decisioni critici sono stati coinvolti.
Non vi serve una scorecard enorme. Ve ne serve una stabile. Se i team vedono che un dominio manca ripetutamente gli obiettivi di freschezza o che una classe di modifiche di schema si riapre spesso, il lavoro di prevenzione diventa più facile da giustificare.
Un breve test di maturità
Usatelo come autovalutazione senza sconti:
Esiste una definizione di problema: i team concordano su che cosa conta come problema e che cosa no.
Le soglie sono documentate: le metriche diventano azionabili solo quando superano i limiti accettati.
La gravità è standardizzata: la priorità non dipende da chi è reperibile.
La responsabilità è esplicita: ogni problema ha un DRI e un percorso di escalation.
La chiusura include la prevenzione: le correzioni aggiornano regole, baseline, contratti o runbook.
Le prove vengono conservate: potete mostrare che cosa è successo, chi ha risposto, che cosa è cambiato e se gli SLA sono stati rispettati.
Se anche solo due di questi punti sono deboli, il processo è ancora fragile. È normale. I team non hanno bisogno di una nuova filosofia. Hanno bisogno di meno passaggi di consegne ambigui e di una migliore disciplina operativa sui difetti che sanno già di avere.
Se il vostro team sta cercando di trasformare controlli sparsi in un vero modello operativo, digna è pensata per questo tipo di lavoro. Aiuta i team a monitorare anomalie, tempestività, validazione e modifiche di schema all'interno del proprio ambiente, così che rilevamento, responsabilità e prevenzione dei problemi possano funzionare come un unico processo invece che con quattro strumenti scollegati.
Un processo è misurabile solo quanto i numeri che lo sostengono: affiancate a questo workflow un insieme concreto di metriche di qualità dei dati, così che la chiusura abbia un significato.
Domande frequenti
Perché le correzioni ad hoc falliscono?
Falliscono al confine della responsabilità. Qualcuno corregge un modello SQL, rilancia una pipeline e dichiara il problema risolto, ma nessuno è responsabile di verificare se la fiducia è stata ripristinata o se lo stesso difetto si ripresenta. Un processo gestito è un processo misurabile; uno ad hoc non lo è.
Che cosa conta come problema di qualità dei dati?
Definite il problema prima del workflow. Non ogni controllo fallito è un problema, e non ogni problema nasce da un controllo fallito: anche un movimento inspiegabile di un KPI rientra nella definizione. Scegliete un denominatore adatto alla vostra maturità e ripulite gli input prima di fidarvi di qualsiasi tasso calcolato su di essi.
Come si presenta il workflow dall'inizio alla fine?
Rilevamento, validazione, indagine, risoluzione e prevenzione. Rilevamento e validazione restano separati di proposito, perché un alert non è ancora un incidente. L'indagine riconduce il difetto al suo punto di controllo, e la risoluzione non è completa finché la fiducia non è ripristinata, non semplicemente finché i dati non cambiano.
Come vanno smistati e assegnati i problemi?
Usate la gravità per rendere espliciti i compromessi invece di trattare ogni problema come urgente. Assegnate la responsabilità al dominio della correzione, cioè al team che può davvero modificare il controllo, non a chi se ne è accorto. Poi stabilite le priorità tenendo conto della capacità e gestite la coda rispetto a SLA misurabili.
Come si evita che gli stessi problemi si ripresentino?
La prevenzione richiede modifiche ai controlli dopo l'incidente, non solo un ticket chiuso. Monitorate metriche che cambiano i comportamenti, come il tasso di ricorrenza e il tempo per ripristinare la fiducia, invece del semplice numero di problemi, che cala ogni volta che le persone smettono di segnalarli.


