Cos'è una data strategy e come costruirne una che funzioni
|
6
min di lettura

Il divario si percepisce prima che qualcuno lo dica ad alta voce. La presentazione del management afferma che l'azienda sta diventando data-driven, il budget della piattaforma è stato approvato, eppure continuano a tornare le stesse domande: quale dashboard è quella giusta, chi è responsabile di questo dataset e perché il report è di nuovo obsoleto? Di solito è il momento in cui si capisce che il problema non è la mancanza di strumenti, ma la mancanza di un modello operativo.
Una risposta utile alla domanda cos'è una data strategy è semplice da formulare e difficile da mettere in pratica bene. È l'approccio coordinato che un'organizzazione usa per governare, gestire, condividere, proteggere ed estrarre valore dai dati a supporto degli obiettivi di business. In pratica significa decidere chi può usare i dati, a quali condizioni, con quali controlli di qualità e sicurezza e come quei dati si muovono tra team e sistemi.
Indice
Perché la maggior parte delle data strategy fallisce prima ancora di iniziare
Come observability e controlli di qualità rendono operativa la strategia
Perché la maggior parte delle data strategy fallisce prima ancora di iniziare
Il fallimento di solito inizia in sala riunioni, non in una pipeline. Qualcuno presenta un deck impeccabile con obiettivi, riquadri di architettura e qualche frase rassicurante sulla trasformazione. Un mese dopo la dashboard finanziaria è obsoleta, il team di prodotto ha una propria definizione di ricavo e il data engineer non sa ancora dire chi sia responsabile del dataset critico che si è rotto dopo una modifica dello schema.
Ecco perché una data strategy non può essere trattata come una roadmap di strumenti. Deve funzionare come un modello operativo che collega le priorità di business a responsabilità, standard, misurazione della qualità, controlli del ciclo di vita, metadati e consegna affidabile. Se nessuno sa chi decide quando i dati attraversano il confine tra due team, alla strategia manca già la spina dorsale.
La storia della politica dei dati dell'Unione europea lo dimostra chiaramente. La Strategia europea per i dati ha trattato la disponibilità dei dati e la fiducia come infrastruttura economica, non solo come lavoro IT, e una consultazione pubblica ha rilevato che il 97,2% degli 806 partecipanti concordava sulla necessità di una data strategy complessiva per l'UE, mentre il 91,5% sosteneva l'orientamento politico (Strategia europea per i dati e risultati della consultazione). È un segnale di governance, non di tooling.
Regola pratica: se la vostra strategia non dice chi è responsabile di un dataset, come si misura la qualità e cosa succede quando le regole falliscono, non è ancora una strategia.
La definizione più solida è quella su cui i team possono agire: una data strategy collega i risultati di business al comportamento dei dati. Definisce quali dati contano, come dovrebbero comportarsi e quali evidenze dimostrano che lo fanno ancora. Per un segnale d'allarme più netto, guardate alle organizzazioni che continuano a costruire ambienti ricchi di dati e poveri di informazioni, perché è ciò che accade quando la strategia si ferma all'ambizione e non arriva mai alla responsabilità.
I componenti chiave di una data strategy moderna
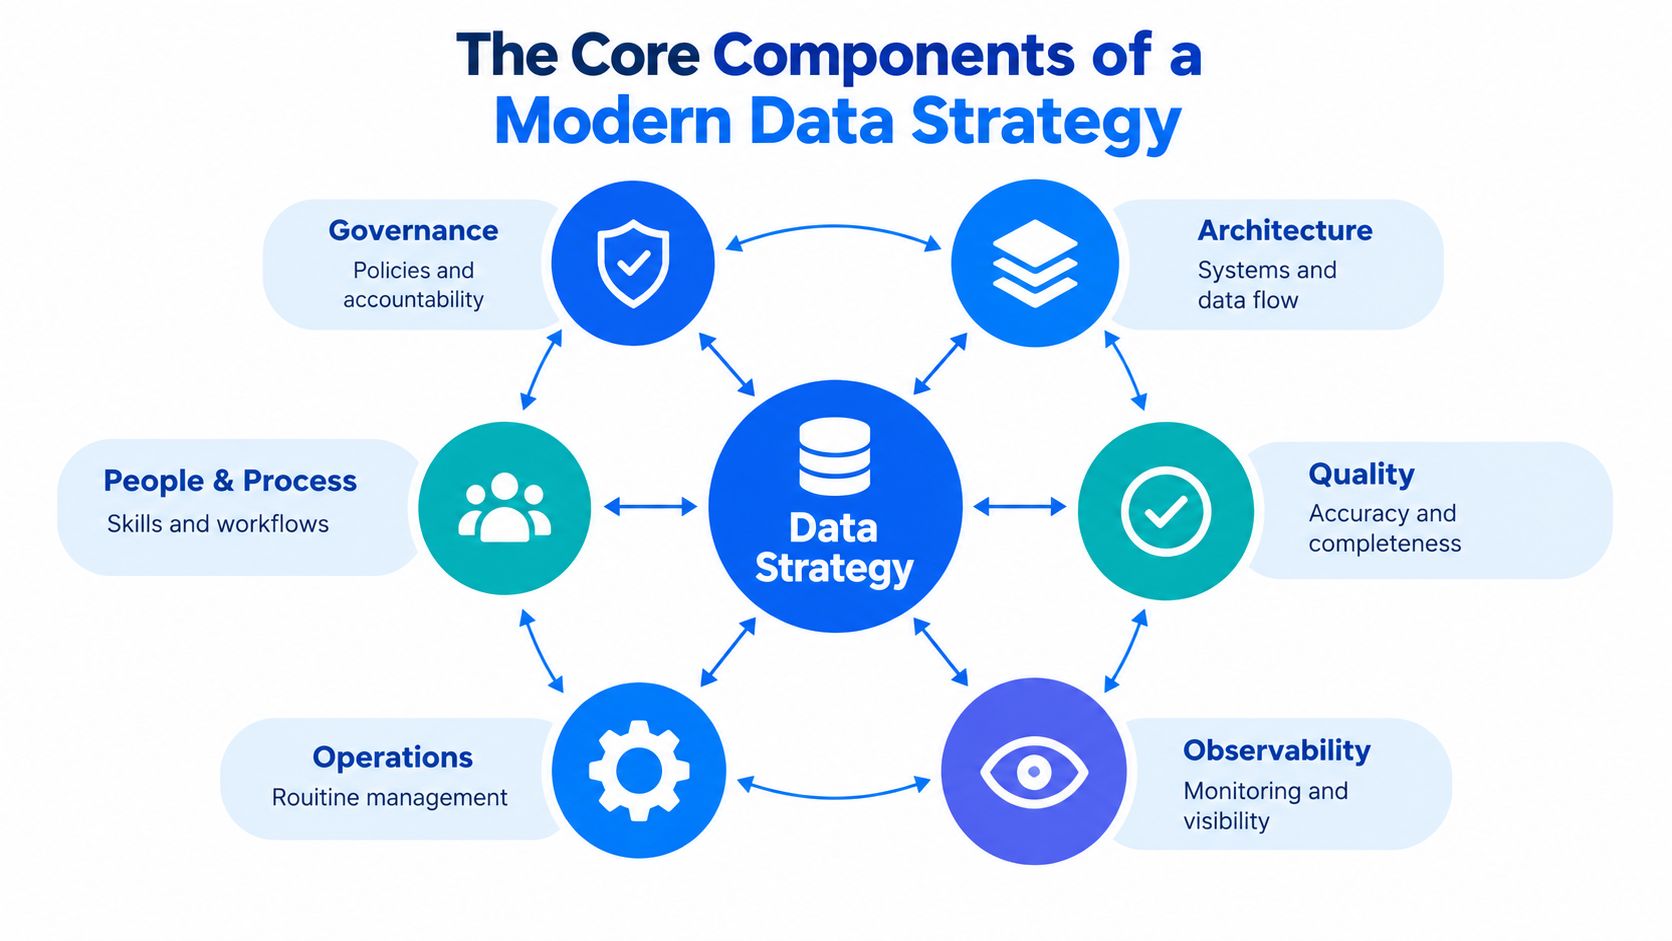
Pensate a una città. Strade, semafori, ispezioni, piani regolatori, squadre di manutenzione e residenti hanno compiti diversi, ma la città funziona solo quando queste parti si rafforzano a vicenda. Una data strategy moderna funziona allo stesso modo, perché governance, architettura, qualità, observability, operations, persone e processi devono essere allineati.
Governance e architettura fissano le regole della circolazione
La governance è il piano regolatore. Definisce diritti decisionali, responsabilità e policy, così l'organizzazione sa chi può approvare un accesso, chi è responsabile del dataset e quali condizioni si applicano. L'architettura è la rete stradale. Definisce dove risiedono i dati, come si muovono e come vi si accede tra warehouse, data lake, sistemi operativi e pipeline di AI.
Questo conta perché una strategia senza architettura diventa un documento di policy senza destinazione. Una strategia senza governance diventa un mucchio di decisioni infrastrutturali senza owner e senza percorso di escalation. Le due hanno bisogno l'una dell'altra.
Qualità, observability e operations rendono il sistema utilizzabile
La qualità è lo standard di ispezione. Indica a ogni dataset cosa significa “buono”, e l'impostazione del NIST sulla qualità è utile perché tratta accuratezza, bias, tempestività, completezza, pertinenza e coerenza come fattori distinti, non come un unico punteggio generico (NIST quality factors and control context.pdf)). L'observability è il sistema di controllo del traffico: mostra cosa sta succedendo ora e fa emergere presto le deviazioni. Le operations sono la squadra di manutenzione: trasformano le policy in lavoro ripetibile.
È nel livello di persone e processi che la maggior parte delle strategie si consolida o svanisce. Servono owner nominati, incentivi chiari, percorsi di escalation e un linguaggio condiviso sufficiente perché analisti, ingegneri e stakeholder di business possano parlare dello stesso dataset senza fraintendersi. Anche un riferimento concreto come l'architettura dei sistemi di dati funziona solo se anche queste regole umane sono esplicite.
Quando la responsabilità non è chiara, i team iniziano a compensare in modo locale. È così che un gruppo crea la propria definizione, un altro costruisce un workaround e un terzo smette del tutto di fidarsi dei numeri.
Gli equivoci più comuni che minano la data strategy
Un team dati acquista un lakehouse, uno strumento di governance o una piattaforma di AI e lo chiama strategia. In realtà ha acquistato capacità, non responsabilità.
Una piattaforma moderna può archiviare, spostare ed elaborare i dati in modo efficace e lasciare comunque senza risposta chi sia responsabile della qualità, chi approvi il riutilizzo o come vengano escalati i problemi. La definizione del MIT CISR è più vicina alla realtà: la data strategy è un concetto integrato di come i dati abilitano e plasmano la strategia di business, quindi viene prima il risultato di business, non la scelta della piattaforma.
Le metriche creano una terza trappola. I riquadri verdi su uno schermo di monitoraggio non dimostrano che un dataset sia affidabile per uno specifico caso d'uso; mostrano soltanto che un insieme ristretto di controlli è stato superato in un dato momento.
Un progetto di pulizia una tantum genera un quarto equivoco. Un dataset può essere pulito il venerdì e rotto il lunedì se cambia un sistema sorgente, una consegna arriva in ritardo o un campo viene riutilizzato senza preavviso.
L'errore più duraturo è scambiare la pulizia per controllo. Le data strategy solide assegnano le responsabilità, individuano i dataset che contano di più, definiscono come misurare ciascuno e conservano le evidenze che i controlli funzionano ancora. Senza quel modello operativo, i team finiscono sempre nelle stesse emergenze, con le stesse persone, le stesse spiegazioni e gli stessi problemi irrisolti a livello di dataset.
Come costruire una data strategy che funzioni davvero
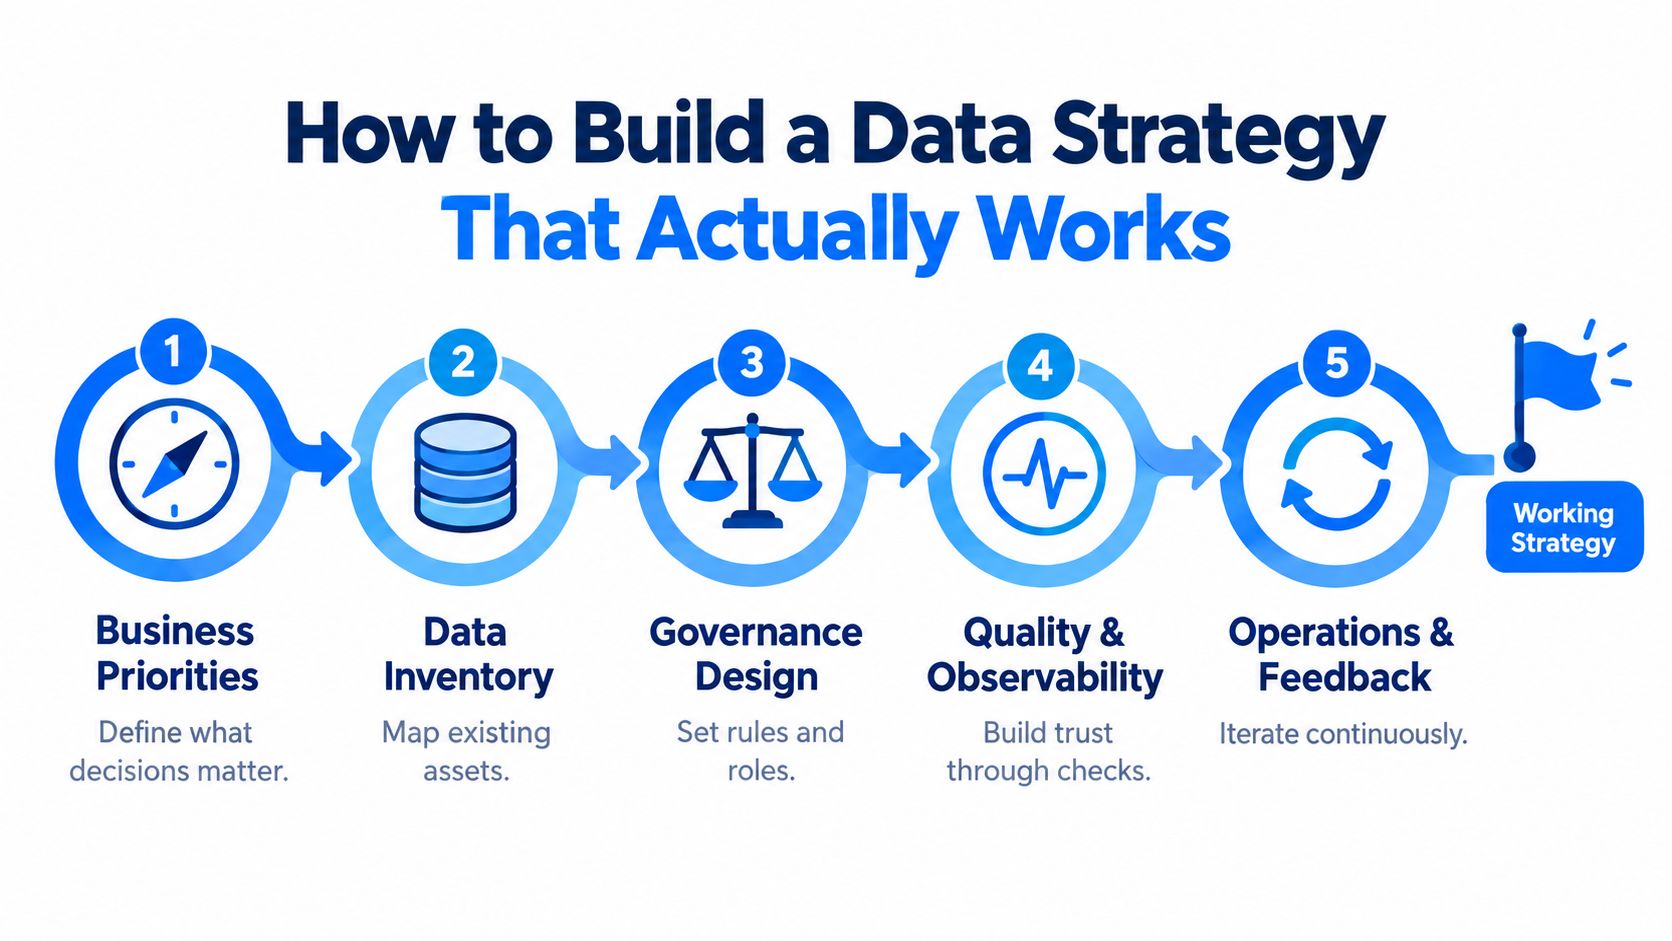
Una data strategy utile parte da una decisione di business, non da un inventario di asset. Chiedetevi quali scelte l'organizzazione vuole prendere meglio, più velocemente o con meno rischio, perché sono quelle decisioni a indicare quali dataset meritano attenzione. Se il team non sa nominare le decisioni, non può nemmeno dare priorità ai dati.
A quel punto restringete il perimetro a un piccolo portafoglio di dataset critici. La responsabilità dovrebbe essere del dirigente che risponde del relativo risultato di business, e il modello operativo dovrebbe documentare i dati necessari, la qualità accettabile, le lacune note e le risorse necessarie per mantenerlo in funzione. Questo livello di concretezza evita che i team cerchino di governare tutto e concentra lo sforzo dove un problema ha un costo reale per il business.
Per ogni dataset critico, mettete per iscritto gli elementi di base in un linguaggio semplice:
Owner nominato: la persona responsabile del risultato di business.
Consumatori previsti: i team che si affidano al dataset.
Aspettative di servizio: cosa significano “disponibile” e “utilizzabile” per questo caso d'uso.
Dimensioni di qualità: quali regole contano in questo caso.
Tempi di consegna: quando i dati devono arrivare per restare utili.
Controlli di schema: quali modifiche strutturali devono far scattare una revisione.
Poi trasformate quell'elenco in un modello operativo concreto. Il team della piattaforma, i responsabili della governance e gli owner di business dovrebbero guardare tutti lo stesso insieme di dataset strategici, invece di discutere di standard aziendali astratti che nessuno riesce a mantenere. Una strategia funziona quando orienta le decisioni quotidiane, non solo le slide delle riunioni.
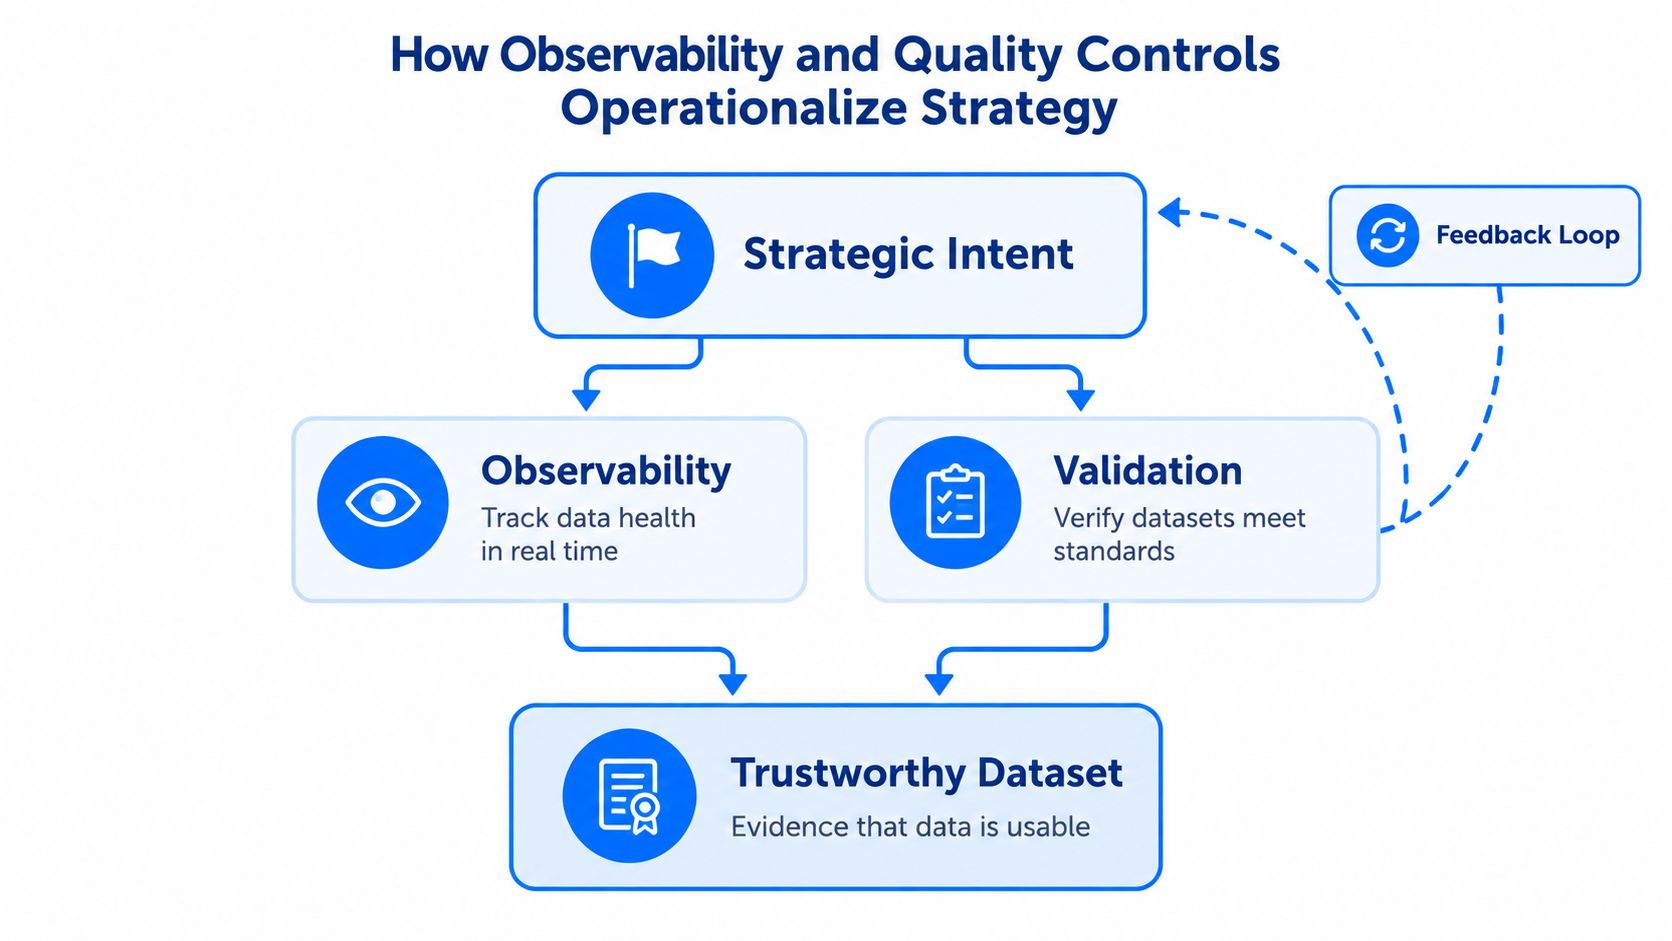
Un esempio pratico aiuta. digna monitora il comportamento dei dati, valida i record, controlla la puntualità delle consegne e rileva le modifiche di schema all'interno dell'ambiente del cliente. Lo strumento è secondario. Ciò che conta è il ciclo tra policy e prova: le evidenze devono tornare nelle revisioni della strategia, così i dirigenti possono vedere se i controlli funzionano o se sono solo documentati.
Perché la AI readiness alza la posta in gioco
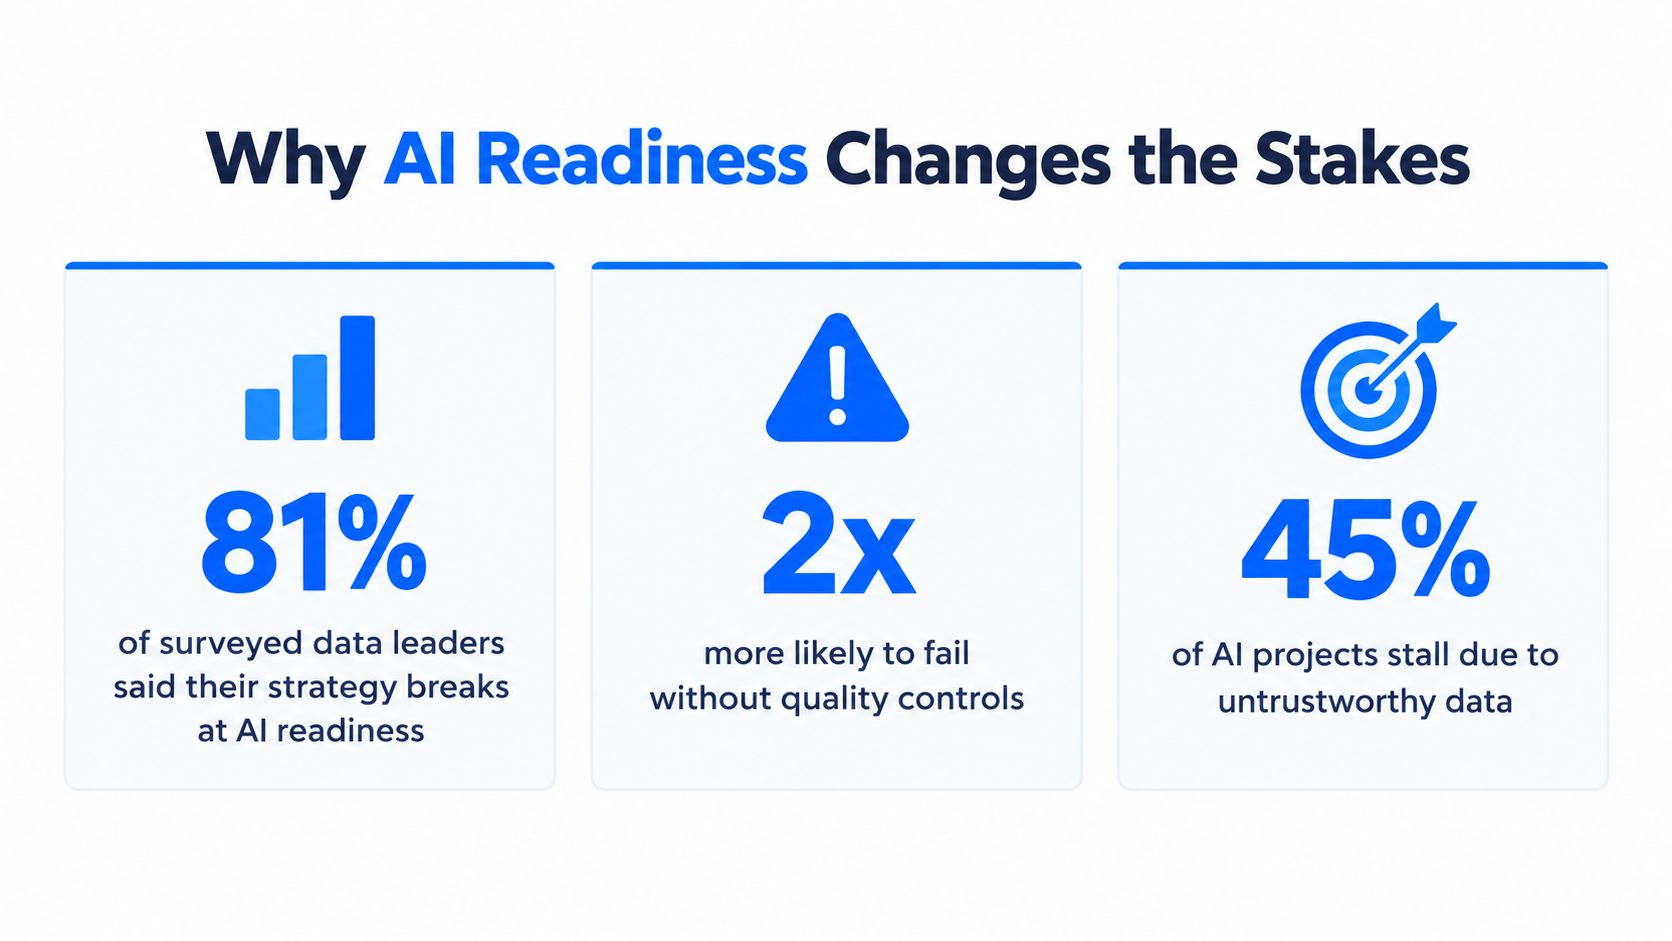
L'AI mette a nudo una strategia debole più in fretta del reporting. IBM ha rilevato che l'81% dei responsabili dei dati intervistati dichiarava la propria data strategy integrata con la roadmap tecnologica e gli investimenti infrastrutturali, ma solo il 26% era fiducioso che i propri dati potessero sostenere nuove fonti di ricavo basate sull'AI (IBM research on AI readiness and strategy). Quel divario è il campanello d'allarme. L'integrazione con la roadmap non significa che i dati siano pronti per l'AI.
Un'altra ricerca di KPMG indicava che il 62% delle organizzazioni considerava una data governance insufficiente la principale sfida sui dati che limita le iniziative di AI (KPMG su data governance e AI). Questo non indica l'ennesimo progetto di piattaforma. Indica uno standard diverso: ogni caso d'uso di AI ha bisogno di evidenze che il dataset sottostante sia completo, accurato, tempestivo, strutturalmente stabile, autorizzato e documentato.
La AI readiness è una questione di dataset, non uno slogan di piattaforma
Una piattaforma può essere moderna e far comunque fallire un caso d'uso di AI se gli input sono incoerenti o mal governati. La certificazione deve avvenire a livello di dataset, per un risultato specifico. Un modello antifrode, un assistente per il customer support e un workflow di forecasting richiedono prove diverse, anche quando girano sullo stesso stack.
Questo sposta la domanda da “Abbiamo una piattaforma di AI?” a “Possiamo dimostrare in modo continuo che questo dataset è adatto a questo caso d'uso?”. Per un dataset possono contare soprattutto freschezza e lineage. Per un altro, regole di validazione e stabilità dello schema possono decidere se ci si può fidare del modello. La strategia diventa reale solo quando queste differenze sono esplicite.
Test utile: se il vostro team AI non sa indicare i controlli esatti che mantengono un dataset adatto allo scopo, al modello si chiede di fidarsi di evidenze che non ha.
I dati pronti per l'AI vanno trattati come un asset controllato, non come un'etichetta statica. Strumenti come digna aiutano a monitorare il comportamento a livello di dataset, dove si decide la readiness.
Come observability e controlli di qualità rendono operativa la strategia
Una strategia diventa reale quando qualcuno può mostrarne le evidenze. Observability e validazione sono il livello delle evidenze: traducono le policy in un comportamento visibile dei dataset. Senza di esse, il management può solo sperare che i controlli funzionino. Con esse, i dirigenti vedono se un dataset è sano, sta derivando, è in ritardo o è rotto.
Quattro controlli fanno gran parte del lavoro
L'anomaly detection apprende il pattern normale di un dataset e segnala comportamenti insoliti senza chiedere agli ingegneri di scrivere a mano una regola per ogni caso limite. Il monitoraggio della puntualità verifica gli orari di consegna attesi, così i caricamenti mancanti, in anticipo o in ritardo non restano nascosti finché un utente non si lamenta. La validazione dei dati applica le regole di business a livello di record, esattamente ciò che serve quando conta l'auditabilità. Il tracciamento dello schema intercetta colonne aggiunte, colonne rimosse e cambi di tipo di dato prima che compromettano i consumatori a valle.
Anche la regolamentazione europea sui dati rende tutto questo più difficile da ignorare. Il Data Governance Act è entrato in vigore il 23 giugno 2022 ed è diventato applicabile dopo un periodo transitorio di 15 mesi, a settembre 2023, mentre l'EU Data Act è entrato in vigore l'11 gennaio 2024 ed è applicabile dal 12 settembre 2025 (norme e tempistiche UE sui dati). Accesso, strutture di condivisione, responsabilità ed evidenze diventano così parte del modello operativo, non optional.
Un buon esempio è un dataset finanziario critico. Una modifica di schema aggiunge un campo, un report a valle inizia a fallire, una consegna in ritardo rende obsoleta una segnalazione regolamentare e un movimento insolito di una metrica chiave passa inosservato per giorni. Un sistema di observability unificato avrebbe fatto emergere prima ciascun problema, assegnato la responsabilità e conservato la traccia necessaria per spiegare l'accaduto.
Per i team che hanno bisogno di questo livello di controllo nella pratica, la data observability è la disciplina che collega alerting, validazione e responsabilità in un unico ciclo.
Misurare se la strategia funziona
Una strategia senza misurazione è solo una lista di preferenze. I KPI giusti devono collegare le evidenze a livello di dataset ai risultati di business, e farlo per livelli, così i dirigenti possono capire se il problema è tecnico, organizzativo o finanziario.
Livello | KPI di esempio | Cosa dimostra |
|---|---|---|
Affidabilità dei dati | Rispetto dei tempi di consegna, tempo di risoluzione delle anomalie, anticipo nel rilevamento delle modifiche di schema | I controlli intercettano i problemi abbastanza presto da fare la differenza |
Fiducia e adozione | Fiducia degli stakeholder, utilizzo delle dashboard, meno richieste di pulizia estemporanee | Le persone si affidano ai dati invece di ricostruirli a mano |
Rischio e compliance | Disponibilità di evidenze di audit, puntualità delle segnalazioni regolamentari, tassi di certificazione degli input dei modelli | La strategia supporta la supervisione e decisioni difendibili |
Risultati di business | Affidabilità del reporting, minori costi legati agli incidenti, prontezza dei casi d'uso AI | La strategia migliora il lavoro che conta davvero per il business |
Il miglior design delle metriche è specifico per il dataset e il suo caso d'uso. Un input di modello richiede prove diverse da un report regolamentare, e una dashboard rivolta ai clienti prove diverse da una chiusura contabile. Per questo l'insieme delle metriche dovrebbe restare vicino al portafoglio dei dataset critici, non in una scorecard generica che sembra ordinata ma dice poco.
Se cercate un modo pratico per ragionare sulle metriche di affidabilità in questo contesto, come misurare l'affidabilità offre il giusto tipo di disciplina, anche se il vostro stack di strumenti dovesse cambiare in seguito.
Il quadro d'insieme e da dove iniziare
Una data strategy che funziona è un modello operativo basato su responsabilità, evidenze e feedback. Collega le priorità di business ai dataset critici, nomina owner responsabili, documenta le aspettative di qualità e tempestività e dimostra con controlli continui che le verifiche funzionano ancora.

Iniziate dai tre dataset più critici per le decisioni nella vostra organizzazione. Nominate gli owner, mettete per iscritto le aspettative attuali e introducete observability e validazione di base, così i dirigenti vedranno evidenze e non slide. Se il processo vi sembra difficile, il punto è proprio questo: la strategia conta solo quando cambia il modo in cui i dati vengono gestiti ogni giorno.
Se cercate un modo pratico per trasformare la data strategy in un modello operativo, digna offre ai team la possibilità di monitorare il comportamento dei dati, validare i record, controllare la puntualità delle consegne e rilevare le modifiche di schema all'interno del proprio ambiente. Visitate digna per vedere come questo livello di evidenze può supportare i vostri dataset critici, la AI readiness e la governance, senza trasformare la strategia nell'ennesimo deck di slide.
Per decidere quali campi di questi dataset critici meritano per primi i controlli più rigorosi, leggete anche la nostra guida ai critical data elements.
Domande frequenti
Cos'è una data strategy?
Una data strategy è l'approccio coordinato con cui un'organizzazione governa, gestisce, condivide, protegge e valorizza i dati al servizio degli obiettivi di business. In pratica stabilisce chi può usare i dati, con quali controlli di qualità e sicurezza e come i dati si muovono tra team e sistemi.
Perché la maggior parte delle data strategy fallisce?
Perlopiù perché viene trattata come una roadmap di strumenti anziché come un modello operativo. Una presentazione curata elenca obiettivi e architettura, ma nessuno è responsabile dei dataset critici, la qualità non viene mai misurata e manca un percorso di escalation quando una modifica di schema o una consegna in ritardo rompe un report.
Quali sono i componenti chiave di una data strategy?
Sei elementi devono allinearsi: governance, architettura, qualità, observability, operations, persone e processi. La governance fissa i diritti decisionali, l'architettura definisce dove risiedono e come si muovono i dati, la qualità stabilisce cosa significa buono, l'observability fa emergere le deviazioni, le operations rendono le regole routine e owner nominati la rendono duratura.
Come si inizia a costruire una data strategy?
Partite dalle decisioni di business che volete migliorare, poi scegliete un piccolo portafoglio di dataset critici, idealmente i tre più decisivi. Per ciascuno registrate owner, consumatori previsti, aspettative di servizio, dimensioni di qualità, tempi di consegna e controlli di schema, quindi aggiungete observability e validazione di base.
Come si misura se una data strategy funziona?
Con KPI su quattro livelli: affidabilità dei dati, fiducia e adozione, rischio e compliance, risultati di business. Alcuni esempi sono il rispetto dei tempi di consegna, il tempo di risoluzione delle anomalie, meno richieste di pulizia estemporanee, la disponibilità di evidenze di audit e la prontezza dei casi d'uso AI, sempre legati a dataset critici specifici.


