Master Data Management (MDM): che cos'è e come funziona
|
8
min di lettura
Se vi è mai capitato di estrarre il numero di clienti da due sistemi diversi e ottenere due risposte diverse, sapete già perché esiste il master data management (MDM). Ogni grande organizzazione finisce per avere lo stesso problema: lo stesso cliente, prodotto o fornitore viene inserito, modificato e archiviato in modo leggermente diverso tra CRM, ERP e piattaforme di analytics, finché nessuno si fida più dei numeri. L'MDM è la disciplina, insieme all'insieme di strumenti, che risolve il problema alla fonte invece di rattopparlo a valle.
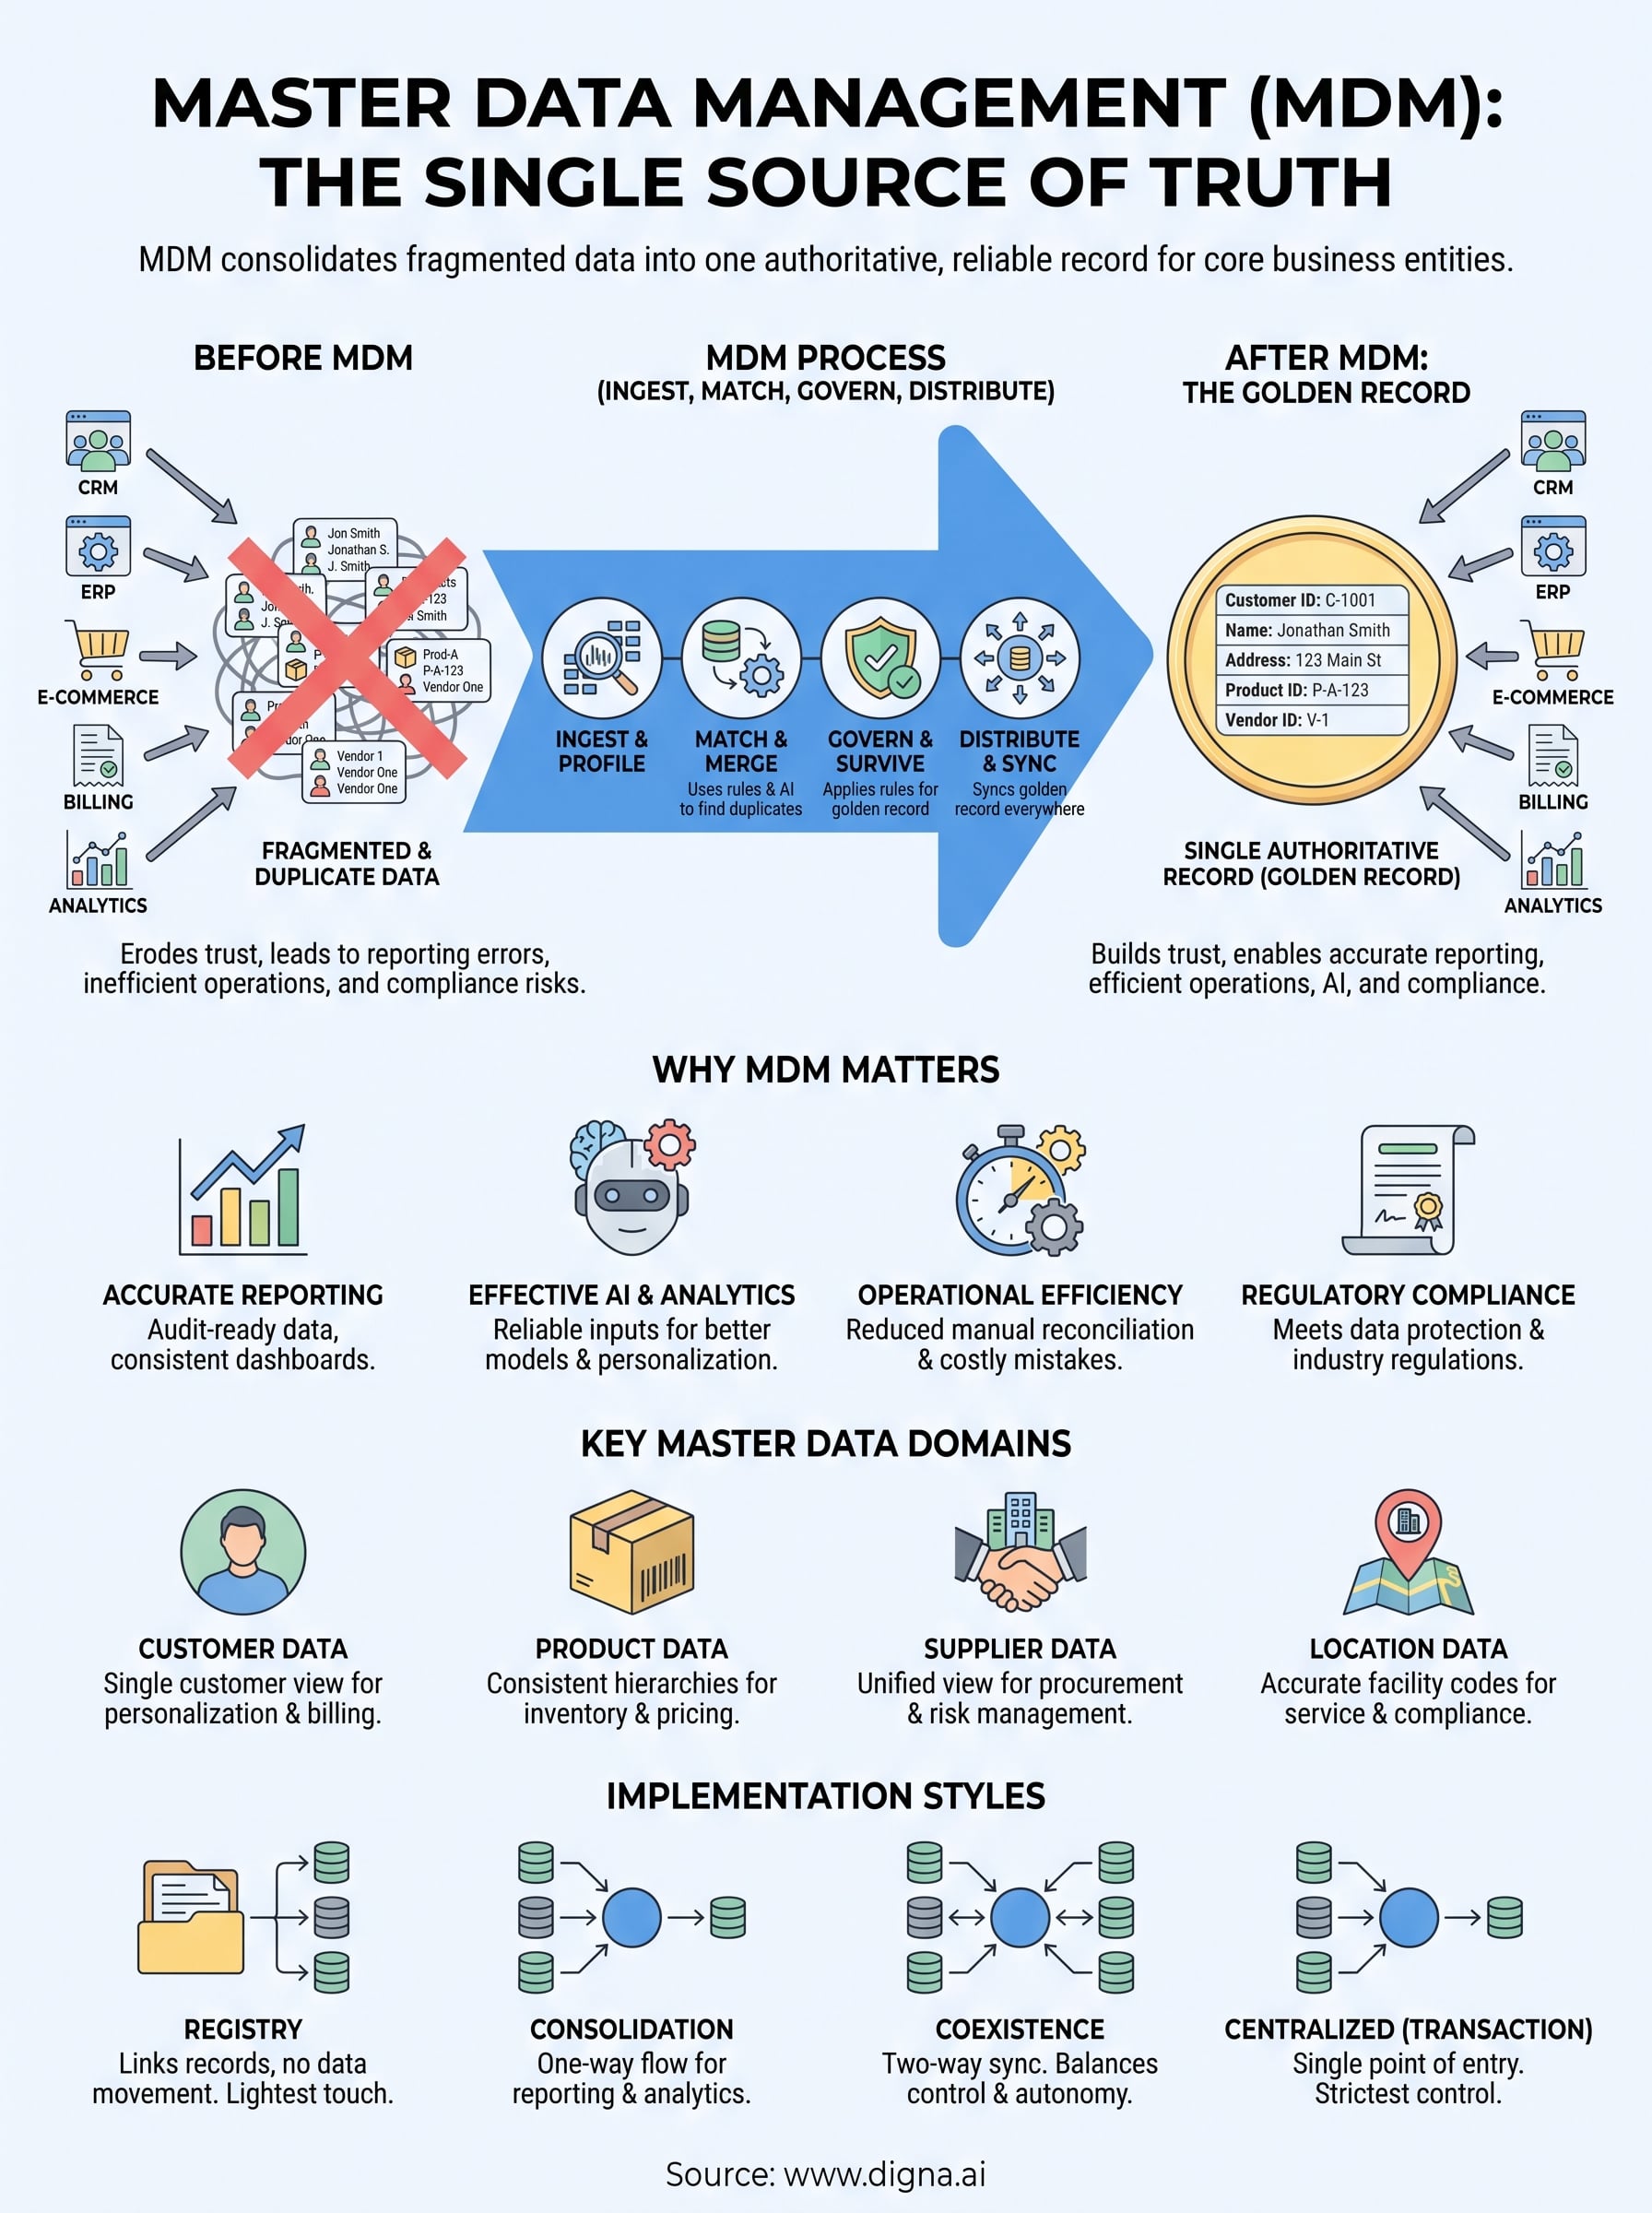
In parole semplici, l'MDM crea un record unico e autorevole per le entità di business fondamentali (clienti, prodotti, sedi, tutto ciò che conta di più per le vostre operations) e mantiene ogni sistema sincronizzato con esso. Combina regole di governance, logiche di matching e spesso machine learning per unire i duplicati, risolvere i conflitti e garantire automaticamente la coerenza. Se fatto bene, trasforma dati dispersi e contraddittori in un'unica fonte di verità affidabile.
Questo articolo spiega che cosa comporta davvero l'MDM: i componenti principali di un programma MDM funzionante, come si svolgono giorno per giorno il matching e la governance, e perché le aziende ad alta intensità di dati nei settori finanziario, sanitario e delle telecomunicazioni lo considerano un'infrastruttura fondamentale anziché un progetto facoltativo. Vedremo anche come l'MDM si collega a pratiche più ampie di data quality e observability, perché i master data puliti restano tali solo se continuate a monitorarli.
Perché il master data management è importante per le organizzazioni
Le aziende non si propongono di creare dati disordinati. Succede gradualmente, man mano che i team aggiungono nuovi sistemi, acquisiscono società o lasciano che le sedi regionali gestiscano le proprie liste di clienti. I master data frammentati erodono silenziosamente la fiducia in ogni report che li utilizza. Un team commerciale che festeggia un contratto potrebbe non rendersi conto che lo stesso cliente ha già abbandonato l'azienda in un'altra regione con un nome leggermente diverso. Moltiplicate questo per migliaia di record e decine di sistemi e otterrete il tipo di confusione che porta i dirigenti a smettere del tutto di fidarsi delle dashboard.
I settori regolamentati avvertono questa pressione più di tutti. Le banche hanno bisogno di una visione unica del cliente per rispettare le norme antiriciclaggio. Le strutture sanitarie hanno bisogno di identificativi dei pazienti coerenti per evitare pericolosi scambi nelle cartelle cliniche. Gli operatori di telecomunicazioni hanno bisogno di dati accurati sugli abbonati per fatturare correttamente e rispettare i requisiti di reporting regolamentare fissati da organismi come le autorità nazionali per la protezione dei dati. Quando i master data sono incoerenti, i team di compliance passano settimane a riconciliare record invece di svolgere un'effettiva attività di supervisione, e il rischio di errori nelle segnalazioni ai regolatori cresce a ogni correzione manuale.
Master data puliti non sono un report accessorio: sono il fondamento su cui si basa ogni report accurato.
Master data di qualità determinano anche se i vostri investimenti in AI e analytics danno davvero i loro frutti. I modelli di machine learning addestrati su record di clienti duplicati o su gerarchie di prodotto non allineate apprendono i pattern sbagliati. Un motore di raccomandazione che tratta lo stesso acquirente come tre persone diverse non può personalizzare nulla in modo efficace. I modelli previsionali costruiti su dati incoerenti dei fornitori valuteranno male tempi di consegna e fabbisogni di magazzino. L'MDM fornisce a questi sistemi una base stabile e deduplicata da cui apprendere, un aspetto sempre più importante man mano che le organizzazioni si affidano all'automazione per decisioni che un tempo prevedevano una persona a ricontrollare i numeri.
Sul piano operativo, i risparmi sono concreti. I commerciali smettono di perdere tempo a riconciliare le anagrafiche dei clienti prima di una chiamata. I team della supply chain smettono di ordinare troppo perché lo stesso fornitore compare con due codici fornitore diversi. Gli operatori del servizio clienti aprono un unico profilo accurato invece di indovinare quale dei cinque record sia quello aggiornato. Non si tratta di guadagni di efficienza astratti: si traducono direttamente in meno personale impiegato nella pulizia manuale dei dati e in meno errori costosi che derivano dall'agire sulla base di informazioni errate.
Ecco un rapido confronto tra ciò che le organizzazioni sperimentano tipicamente con e senza un programma MDM funzionante:
Area di business | Senza MDM | Con MDM |
|---|---|---|
Anagrafiche clienti | Profili duplicati tra CRM e strumenti di assistenza | Un unico record cliente autorevole condiviso ovunque |
Reporting regolamentare | Riconciliazione manuale prima di ogni audit | Dati coerenti e pronti per l'audit su richiesta |
Analytics e AI | Modelli distorti da entità duplicate o non allineate | Input affidabili che riflettono la realtà |
Supply chain | Voci fornitore ridondanti che causano ordini eccessivi | Visione unica del fornitore a supporto di una pianificazione accurata |
Servizio clienti | Operatori che devono indovinare quale record sia aggiornato | Accesso immediato al profilo corretto e completo |
In definitiva, le organizzazioni investono nell'MDM perché l'alternativa costa di più, solo in modo meno visibile. Ogni record duplicato, ogni codice prodotto non allineato, ogni ID cliente incoerente genera piccoli attriti che si sommano in ricavi persi, esposizione a rischi di compliance e decisioni prese sulla base di presupposti errati. Trattare i master data come un'infrastruttura fondamentale, così come trattereste la sicurezza della rete o la disponibilità dei sistemi, è ciò che distingue le aziende che crescono senza intoppi da quelle che continuano a rincorrere problemi di dati molto tempo dopo che avrebbero dovuto essere risolti.
Come funziona il master data management, passo dopo passo
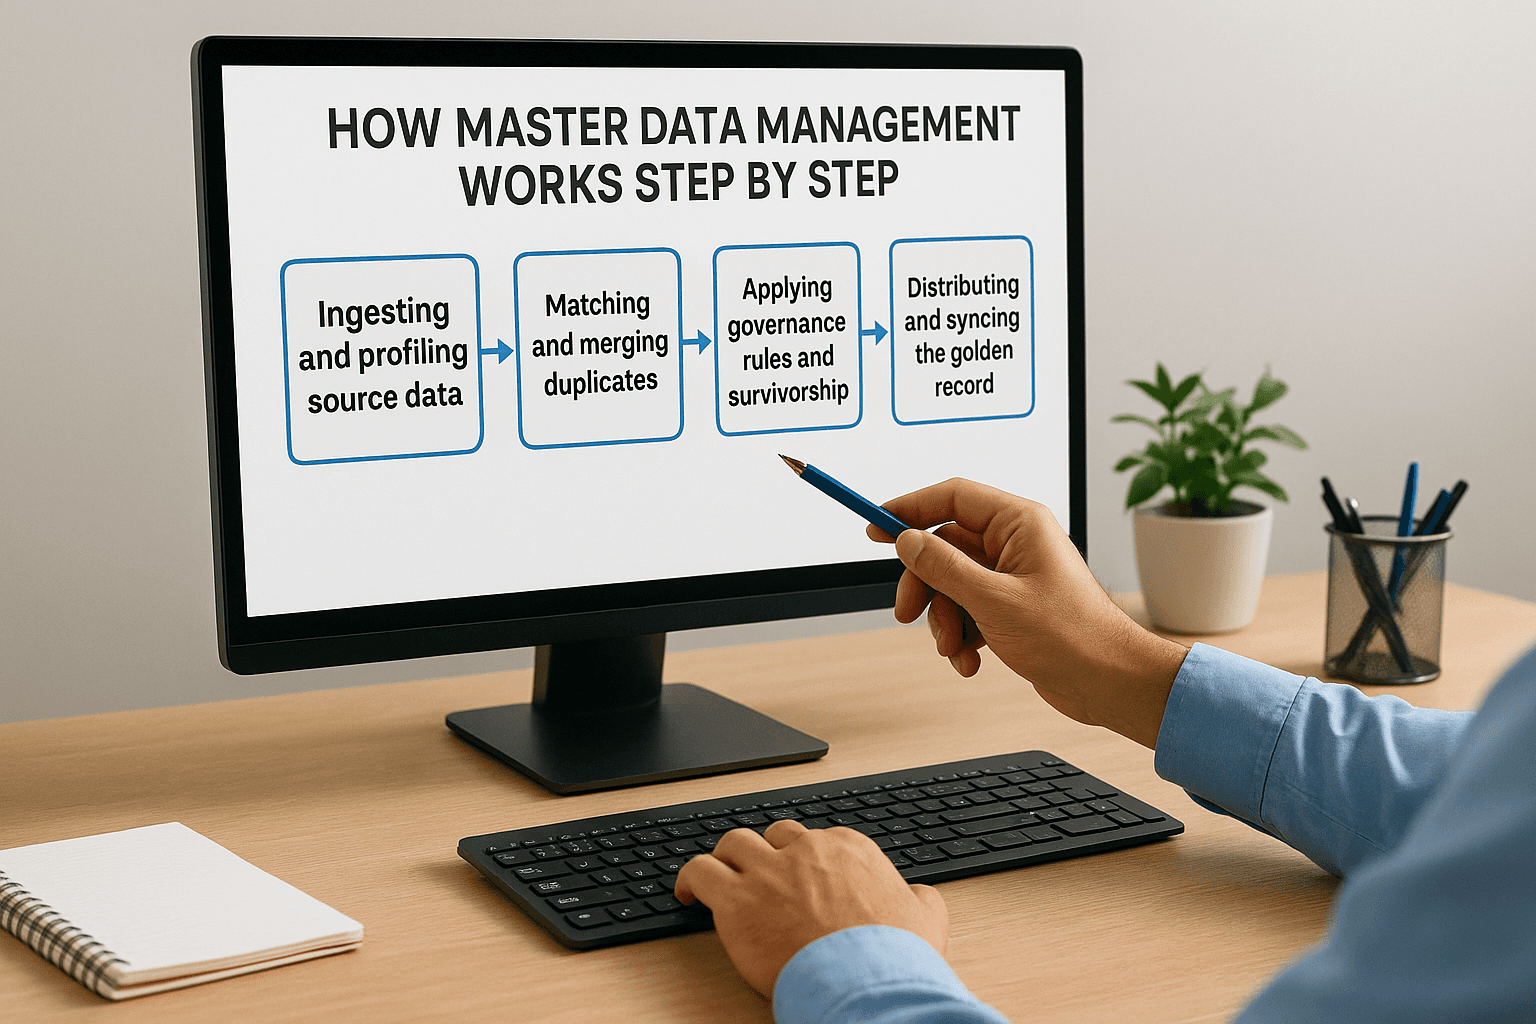
L'MDM sembra astratto finché non lo si vede all'opera su dati reali. Alla base del concetto c'è un processo piuttosto meccanico: acquisire i dati da ogni sistema che gestisce una determinata entità, decidere quale versione di ciascun campo sia corretta, unire tutto in un unico golden record e ridistribuire quel record a tutti i sistemi collegati. La magia non sta in un singolo passaggio, ma nel ripeterli tutti in modo continuo invece che come un progetto di pulizia una tantum.
Acquisizione e profilazione dei dati sorgente
Per prima cosa, la piattaforma si collega ai vostri sistemi sorgente (CRM, ERP, piattaforme di e-commerce, strumenti di fatturazione) e acquisisce ogni record legato all'entità che state gestendo, che si tratti di clienti, prodotti o fornitori. Gli strumenti di profilazione analizzano questi record per verificarne struttura, completezza ed eventuali problemi di qualità evidenti prima che venga unito qualsiasi dato. Saltare questo passaggio è il modo in cui i dati errati finiscono incorporati in modo permanente nel vostro golden record.
Matching e unione dei duplicati
Successivamente, gli algoritmi di matching confrontano i record tra i sistemi per individuare i probabili duplicati, utilizzando tecniche che vanno dalla corrispondenza esatta delle chiavi alla logica fuzzy, in grado di intercettare refusi, abbreviazioni e differenze di formattazione. Un record per "Jon Smith, 123 Main St" e uno per "Jonathan Smith, 123 Main Street" devono essere ricondotti alla stessa persona, e le moderne piattaforme MDM utilizzano sempre più spesso modelli di machine learning addestrati sulle decisioni di matching storiche per farlo correttamente senza codificare ogni regola a mano.
Un golden record è affidabile solo quanto la logica di matching che lo ha costruito.
Applicazione delle regole di governance e di survivorship
Una volta individuati i duplicati, le regole di governance decidono quali valori “sopravvivono” nel record unificato. Una logica di survivorship tipica comprende:
Per i dati di contatto prevale la sorgente aggiornata più di recente
Per i campi finanziari prevale il system of record (ad esempio l'ERP)
Una coda di revisione manuale per i conflitti che le regole automatiche non riescono a risolvere con sufficiente sicurezza
Distribuzione e sincronizzazione del golden record
Infine, il record definitivo viene sincronizzato a ritroso con tutti i sistemi collegati, così un commerciale, una piattaforma di fatturazione e una dashboard di analytics fanno tutti riferimento alla stessa versione della verità. Non si tratta di un invio una tantum. Man mano che arrivano nuove transazioni e modifiche, l'intero ciclo si ripete: per questo il monitoraggio continuo e la data observability contano quanto il lavoro iniziale di matching.
Tipi di stili di implementazione dell'MDM
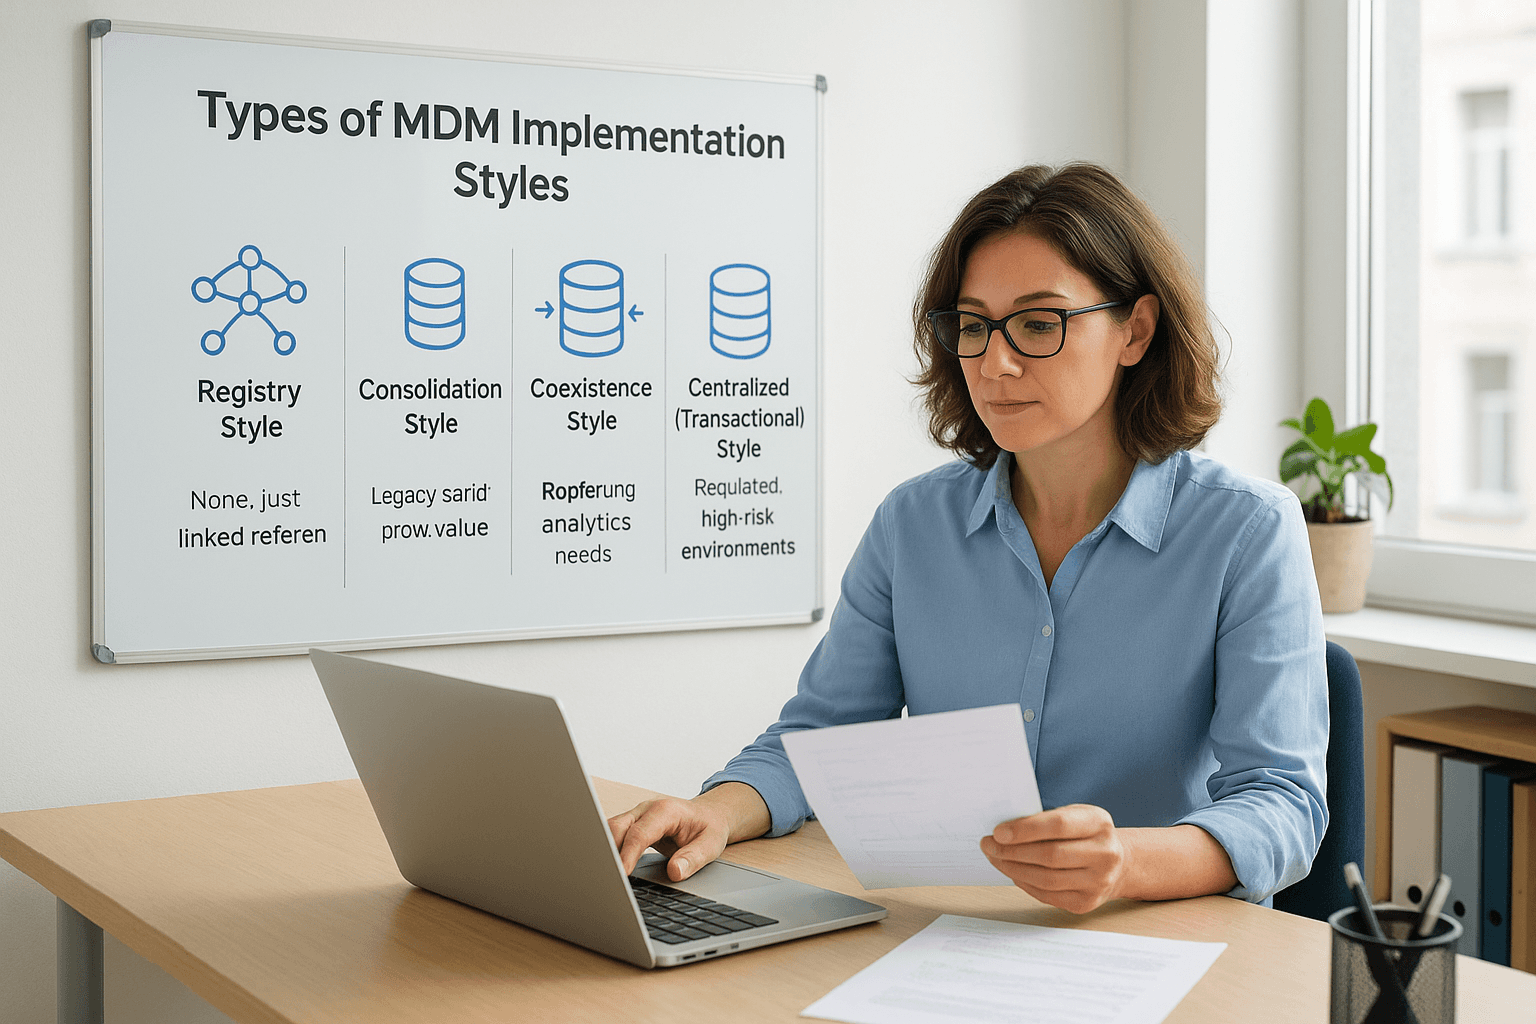
Non tutte le organizzazioni hanno bisogno dello stesso livello di controllo sui propri master data. Le implementazioni MDM rientrano generalmente in quattro stili architetturali, e quello giusto dipende da quanto siano già centralizzati i vostri sistemi e da quanto rischio il vostro settore possa tollerare. Scegliere lo stile sbagliato significa sprecare budget in infrastrutture che non servono oppure lasciare lacune attraverso cui i dati errati rientrano subito.
Stile registry
Lo stile registry lascia invariati i sistemi sorgente e si limita a costruire un indice che collega tra loro i record corrispondenti. È l'opzione meno invasiva, utile quando i sistemi non possono essere modificati facilmente ma serve comunque un modo per avere il quadro completo di un cliente o di un prodotto tra le varie piattaforme.
Stile consolidation
Lo stile consolidation porta i dati dai sistemi sorgente in un hub centrale per reporting e analytics senza riportare le modifiche nei sistemi di origine. Funziona bene per le organizzazioni che hanno bisogno soprattutto di dashboard accurate e non richiedono che ogni sistema operativo rifletta il golden record in tempo reale.
Stile coexistence
Lo stile coexistence fa un passo in più: il golden record risiede a livello centrale, ma i sistemi sorgente mantengono le proprie copie e si sincronizzano in modo bidirezionale. Le modifiche apportate in qualsiasi punto confluiscono nell'hub, e l'hub ridistribuisce gli aggiornamenti. La maggior parte delle aziende di medie dimensioni approda qui, perché questo stile bilancia il controllo con la realtà: centralizzare completamente ogni sistema è dirompente e costoso.
Stile centralizzato (transazionale)
L'MDM centralizzato, o transazionale, fa dell'hub il punto di ingresso unico per la creazione e la modifica dei master record. I sistemi sorgente non gestiscono più le proprie copie, ma leggono e scrivono direttamente sulla piattaforma centrale. È lo stile più rigoroso, ed è quello che i settori regolamentati tendono ad adottare quando i requisiti di compliance rendono troppo rischioso qualsiasi approccio meno rigido.
Più stringenti sono i vostri obblighi di compliance, meno spazio avete per uno stile MDM debolmente accoppiato.
Stile | Movimento dei dati | Ideale per |
|---|---|---|
Registry | Nessuno, solo riferimenti collegati | Sistemi legacy che non possono essere modificati |
Consolidation | Unidirezionale verso un hub centrale | Esigenze di reporting e analytics |
Coexistence | Sincronizzazione bidirezionale | Aziende che bilanciano autonomia e controllo |
Centralizzato | Tutte le modifiche avvengono nell'hub | Ambienti regolamentati e ad alto rischio |
La maggior parte delle organizzazioni non sceglie uno stile per sempre. Spesso si parte con la consolidation per dimostrare rapidamente il valore, per poi passare alla coexistence o al controllo centralizzato man mano che cresce la maturità della governance e il costo dei dati incoerenti diventa più difficile da giustificare.
I principali domini di master data ed esempi concreti
I programmi MDM raramente cercano di sistemare tutti i dataset contemporaneamente. La maggior parte delle organizzazioni parte individuando quali domini di master data incidono davvero su ricavi, compliance o rischio, e costruisce la governance prima di tutto attorno a quelli. I quattro domini seguenti coprono la grande maggioranza dei progetti MDM reali, anche se il mix esatto dipende dal vostro settore.
Dati dei clienti
Banche, operatori di telecomunicazioni e retailer dipendono tutti da un'accurata visione cliente a 360 gradi. Un operatore di telecomunicazioni che unisce i dati di fatturazione di tre sistemi regionali ha bisogno di un unico profilo dell'abbonato, non di tre profili parziali, per calcolare correttamente i consumi ed evitare contestazioni sulle fatture. I retailer usano la stessa logica per smettere di inviare allo stesso acquirente cinque promozioni diverse sotto cinque grafie leggermente diverse del suo nome.
Dati di prodotto
I produttori e le aziende di e-commerce dipendono da gerarchie di prodotto coerenti tra cataloghi, sistemi ERP e feed dei fornitori. Uno stesso SKU elencato con attributi diversi in due sistemi porta a giacenze non allineate ed errori di prezzo che i clienti notano immediatamente. Avere master data di prodotto corretti accelera anche il lancio di nuovi prodotti, perché i team non devono riconciliare le specifiche tra fogli di calcolo prima del go-live.
Dati di fornitori e vendor
I team acquisti scoprono spesso lo stesso fornitore registrato con più codici fornitore, talvolta associati a partite IVA o coordinate bancarie diverse. Questa duplicazione crea una reale esposizione finanziaria, dai pagamenti doppi agli audit non superati. Consolidare i master data dei fornitori offre agli acquisti un'unica visione accurata per negoziare i contratti e monitorare la spesa.
Ogni record fornitore duplicato è una piccola crepa attraverso cui possono passare frodi, pagamenti in eccesso o audit non superati.
Dati di sedi e dati di riferimento
Le reti sanitarie e gli enti pubblici si affidano a master data delle sedi accurati per indirizzare correttamente pazienti, servizi o prestazioni. Un sistema ospedaliero con codici di struttura incoerenti rischia di inviare le cartelle a un reparto completamente sbagliato.
Dominio | Problema comune | Impatto sul business |
|---|---|---|
Cliente | Profili duplicati tra i sistemi | Personalizzazione scarsa, errori di fatturazione |
Prodotto | Gerarchie e SKU incoerenti | Errori di prezzo, giacenze non allineate |
Fornitore | Più codici fornitore per un'unica entità | Pagamenti doppi, rischio di audit |
Sede | Codici di struttura o di sito incoerenti | Servizi indirizzati in modo errato, lacune di compliance |
Affrontare questi domini singolarmente, invece di trattare i master data come un unico blocco enorme, rende i progetti MDM molto più gestibili e offre ai team risultati misurabili già nelle prime fasi del rollout.
Le sfide più comuni dell'MDM e come superarle
La maggior parte delle iniziative di master data management (MDM) si arena per gli stessi pochi motivi, non perché la tecnologia fallisca, ma perché i processi e le persone intorno non sono pronti. Riconoscere questi schemi per tempo fa risparmiare mesi di rilavorazioni ed evita che gli stakeholder liquidino l'MDM come “l'ennesimo progetto IT”.
Resistenze organizzative e responsabilità poco chiare
I reparti spesso resistono a cedere il controllo dei “propri” dati, soprattutto quando i team regionali gestiscono da anni in autonomia le anagrafiche di clienti o prodotti. Senza un data governance council con l'autorità di prendere le decisioni finali, le regole di matching diventano battaglie politiche invece che decisioni tecniche. Risolvete il problema assegnando esplicitamente dei responsabili di dominio prima dell'inizio dell'implementazione, non dopo che sono emersi i conflitti:
Nominate un unico responsabile per ciascun dominio di master data
Date a quel responsabile l'autorità di approvare le regole di survivorship
Instradate le escalation attraverso un governance council, non tramite email estemporanee
Data quality su larga scala
I sistemi legacy raramente archiviano i dati in formati che si abbinano in modo pulito. Campi indirizzo a testo libero, formati di data incoerenti e identificativi mancanti rendono il matching automatico più difficile di quanto suggeriscano le demo dei fornitori, e il divario emerge solo quando i veri dati di produzione arrivano sulla piattaforma.
Nessuna piattaforma MDM può risolvere problemi di data quality che non è mai stata progettata per rilevare.
Abbinare l'MDM a strumenti dedicati di anomaly detection e validazione permette di intercettare questi problemi prima che corrompano il golden record, invece di lasciare che siano clienti o auditor a scoprirli per primi.
Complessità di integrazione
Collegare una dozzina di sistemi sorgente, ciascuno con le proprie particolarità nelle API e i propri cicli di aggiornamento, diventa la parte tecnica più difficile della maggior parte dei rollout. Organizzare le integrazioni in fasi in base alle priorità di business, invece di cercare di collegare tutto in una volta, mantiene il progetto in movimento e produce risultati visibili fin da subito, il che conta quando il management deve decidere se finanziare la fase successiva.
Deriva della governance nel tempo
Le regole che avevano senso al lancio smettono di rispecchiare la realtà man mano che si aggiungono nuovi sistemi, acquisizioni e prodotti. Pianificare revisioni trimestrali della governance mantiene le regole di survivorship e l'assegnazione delle responsabilità allineate al modo in cui il business opera oggi, non a come operava quando il programma è stato avviato.
Scegliere gli strumenti a supporto della vostra strategia MDM
Scegliere una piattaforma MDM non è tanto una questione di checklist di funzionalità, quanto di adattare lo strumento al modo in cui i vostri dati si muovono davvero. Una demo del fornitore con dati di esempio puliti non vi dice nulla su come si comporta il motore di matching con i vostri disordinati record di produzione, quindi, quando possibile, valutate gli strumenti sui vostri dati, non sul dataset curato della presentazione commerciale.
Deployment e residenza dei dati
I settori regolamentati spesso non possono permettere che i dati dei clienti o dei pazienti lascino il proprio ambiente per essere elaborati, il che esclude i motori di matching ospitati esclusivamente nel cloud. Cercate piattaforme che supportino l'esecuzione in-database o il deployment in private cloud, in modo che i record sensibili non debbano mai transitare su un server di terze parti solo per essere deduplicati. Questo conta tanto per la conformità al GDPR quanto per le policy di sicurezza interne.
Intelligenza e adattabilità del matching
Il matching statico basato su regole smette di funzionare nel momento in cui i pattern dei vostri dati cambiano, che sia per una fusione, per un nuovo sistema regionale o semplicemente perché nuovi dipendenti digitano gli indirizzi in modo diverso. Le piattaforme che combinano metodi statistici e machine learning si adattano a questi cambiamenti senza che qualcuno debba riscrivere le regole di matching ogni trimestre. È questa adattabilità a distinguere uno strumento che configurate una volta da uno che dovete sorvegliare all'infinito.
Un motore di matching che non riesce ad apprendere le peculiarità dei vostri dati avrà sempre bisogno di una persona che ne corregga gli errori.
Collegamento con data quality e observability
L'MDM resta utile solo se il golden record che produce rimane accurato nel tempo, il che significa che lo strumento deve intercettare modifiche agli schemi, dati in ritardo e anomalie prima che corrompano il master record. È qui che le funzionalità di data observability, come anomaly detection, monitoraggio della tempestività e schema tracking, diventano parte dei criteri di valutazione anziché un acquisto separato. Piattaforme come digna integrano queste funzioni direttamente nello stesso ambiente dei controlli di data quality, così i team non devono mettere insieme cinque strumenti per ottenere un unico record affidabile.
Una checklist di valutazione pratica
Prima di impegnare il budget, sottoponete ogni piattaforma della vostra rosa a queste domande:
Supporta il deployment in-database o in private cloud per i dati sensibili dal punto di vista della compliance?
Gli stakeholder non tecnici possono esaminare e approvare le regole di survivorship tramite una dashboard facile da usare?
Il motore di matching migliora nel tempo o richiede una continua regolazione manuale?
Integra anomaly detection e monitoraggio degli schemi, o si occupa solo del matching?
Quanto tempo dichiara il fornitore per passare dall'installazione a insight utilizzabili, e può dimostrarlo con un cliente di riferimento?
Rispondere onestamente a queste domande restringe rapidamente il campo e mantiene il processo di selezione ancorato alle vostre reali esigenze operative, non al marketing dei fornitori.
Far funzionare i master data per la vostra organizzazione
Il master data management ripaga solo se lo trattate come una disciplina operativa continua, non come un progetto di pulizia una tantum. Le organizzazioni che ne ricavano un valore reale scelgono un dominio che conta, assegnano responsabilità chiare, adottano uno stile di implementazione adatto alla propria tolleranza al rischio e continuano a monitorare il golden record dopo il lancio, invece di disinteressarsene una volta che il matching funziona correttamente. Se saltate quest'ultima parte, clienti duplicati, prodotti non allineati o anagrafiche fornitori che si discostano dalla realtà ricompariranno nel giro di un anno.
Governance e logiche di matching rendono puliti i vostri master data. Mantenerli tali richiede la stessa disciplina di observability che applichereste a qualsiasi sistema critico: tenere d'occhio modifiche agli schemi, dati in ritardo e anomalie prima che corrompano di nuovo i record. È qui che MDM e strumenti di data quality devono lavorare insieme invece di restare in silos separati.
Se siete pronti a vedere come funziona nella pratica, esplorate la piattaforma di data quality di digna e osservate da vicino come il monitoraggio automatizzato mantiene affidabili i vostri master data anche molto tempo dopo il go-live.
Per capire come il monitoraggio continuo di anomalie, schemi e tempestività impedisce a un golden record di deteriorarsi dopo il go-live, consultate la soluzione di data quality management di digna.
Domande frequenti
Che cos'è il master data management (MDM)?
Il master data management è la disciplina, con il relativo insieme di strumenti, che crea un record unico e autorevole per le entità di business fondamentali come clienti, prodotti, fornitori e sedi. Combina regole di governance, logiche di matching e spesso machine learning per unire i duplicati, risolvere i conflitti e mantenere CRM, ERP e sistemi di analytics sincronizzati con quel record.
Come funziona il processo MDM passo dopo passo?
L'MDM funziona come un ciclo continuo in quattro fasi. Acquisisce e profila i record dai sistemi sorgente come CRM, ERP e strumenti di fatturazione, individua e unisce i duplicati, applica le regole di survivorship per decidere quali valori prevalgono, quindi sincronizza il golden record risultante con tutti i sistemi collegati man mano che arrivano nuove modifiche.
Che cosa sono le regole di survivorship nell'MDM?
Le regole di survivorship decidono quali valori dei campi sopravvivono nel golden record unificato una volta individuati i duplicati. Esempi tipici citati nell'articolo: per i dati di contatto prevale la sorgente aggiornata più di recente, per i campi finanziari prevale il system of record come l'ERP e i conflitti non risolti finiscono in una coda di revisione manuale.
Quali sono i quattro stili di implementazione dell'MDM?
I quattro stili sono registry, consolidation, coexistence e centralizzato. Il registry si limita a collegare i record corrispondenti, la consolidation copia i dati in un'unica direzione verso un hub di reporting, la coexistence sincronizza un golden record centrale in entrambe le direzioni e lo stile centralizzato fa dell'hub il punto di ingresso unico, l'approccio che tendono ad adottare gli ambienti regolamentati e ad alto rischio.
Perché l'MDM ha bisogno della data observability dopo il go-live?
Un golden record resta accurato solo se qualcosa continua a sorvegliarlo. Modifiche agli schemi, dati in ritardo e anomalie possono corrompere i master record anche dopo che il matching ha funzionato correttamente e, senza monitoraggio, clienti duplicati o anagrafiche fornitori che si discostano dalla realtà ricompaiono entro un anno. Anomaly detection, monitoraggio della tempestività e schema tracking intercettano questi problemi per tempo.