Padroneggiare l'architettura dati enterprise: la guida 2026
|
6
min di lettura

Probabilmente vi state già confrontando con questo problema. La finanza si presenta a una riunione del management con un dato sui ricavi, le vendite ne portano un altro ed entrambi i team sono in grado di difendere la propria logica. La dashboard non ha fallito perché il grafico era sbagliato. Ha fallito perché l'architettura sottostante ha permesso a definizioni, pipeline e controlli diversi di crescere in parallelo, fino a far crollare la fiducia.
È in quel momento che l'architettura dati enterprise smette di essere un diagramma dell'IT e diventa un problema del vertice aziendale. Se l'architettura è debole, ogni attività a valle diventa più difficile. Le previsioni rallentano. Le revisioni di compliance diventano faticose. Il lavoro sull'AI poggia su input instabili. L'engineering passa il tempo a riconciliare dati invece di ampliare le capacità.
Un'architettura solida fa l'opposto. Offre al business un modo ripetibile di raccogliere, governare, trasformare e servire le informazioni, così i team possono muoversi più velocemente senza dover improvvisare le basi ogni trimestre.
Indice
Perché la vostra architettura dati definisce il vostro business
Costruire fiducia con data quality e observability integrate
La vostra stella polare architetturale: best practice concrete
Perché la vostra architettura dati definisce il vostro business
Un nuovo Head of Data di solito eredita i sintomi prima delle cause. I team lamentano che i report non coincidono, gli analisti continuano a ricostruire la stessa logica e gli engineer esitano a modificare i sistemi a monte perché non riescono a vedere cosa si romperà a valle. Niente di tutto questo è casuale. È l'architettura che si manifesta attraverso l'attrito quotidiano.
Nella pratica, l'architettura dati enterprise è il modello operativo delle informazioni. Definisce come i dati entrano nell'organizzazione, dove risiedono, come vengono trasformati, chi ne è responsabile, quali controlli si applicano e come le persone li utilizzano. Lo stack tecnologico conta, ma la domanda più importante è se l'architettura produce decisioni affidabili alla velocità di cui il business ha bisogno.
Quando l'architettura viene trattata come una questione di back office, le business unit colmano le lacune da sole. Il marketing esporta i dati in uno strumento. La finanza cura una versione separata. I team di prodotto creano le proprie convenzioni per gli eventi. Ogni soluzione locale sembra razionale, ma l'azienda paga in seguito il prezzo della frammentazione.
Un'azienda può tollerare dati disordinati per un po'. Non può scalare un processo decisionale disordinato.
Il beneficio di fare le cose per bene non è astratto. Un'architettura solida favorisce passaggi più puliti tra i team, una responsabilità più chiara sui dataset chiave e meno rilavorazioni quando le priorità cambiano. Cambia anche il tono delle discussioni ai vertici. Invece di discutere su quale foglio di calcolo sia corretto, i leader possono discutere su cosa fare dopo.
Ecco perché consiglio agli Head of Data di inquadrare l'architettura nel linguaggio del business fin dall'inizio:
Agilità: i team possono avviare nuovi casi d'uso senza riprogettare ogni volta la piattaforma?
Fiducia: i leader credono nei numeri abbastanza da agire sulla loro base?
Controllo: i team legali, di sicurezza e di audit riescono a vedere come si spostano i dati sensibili?
Innovazione: i team di data science e AI possono accedere a input affidabili senza pulizie eroiche?
Se la risposta è no, l'architettura sta già influenzando le prestazioni del business. Solo nella direzione sbagliata.
I principi fondamentali di un'architettura resiliente
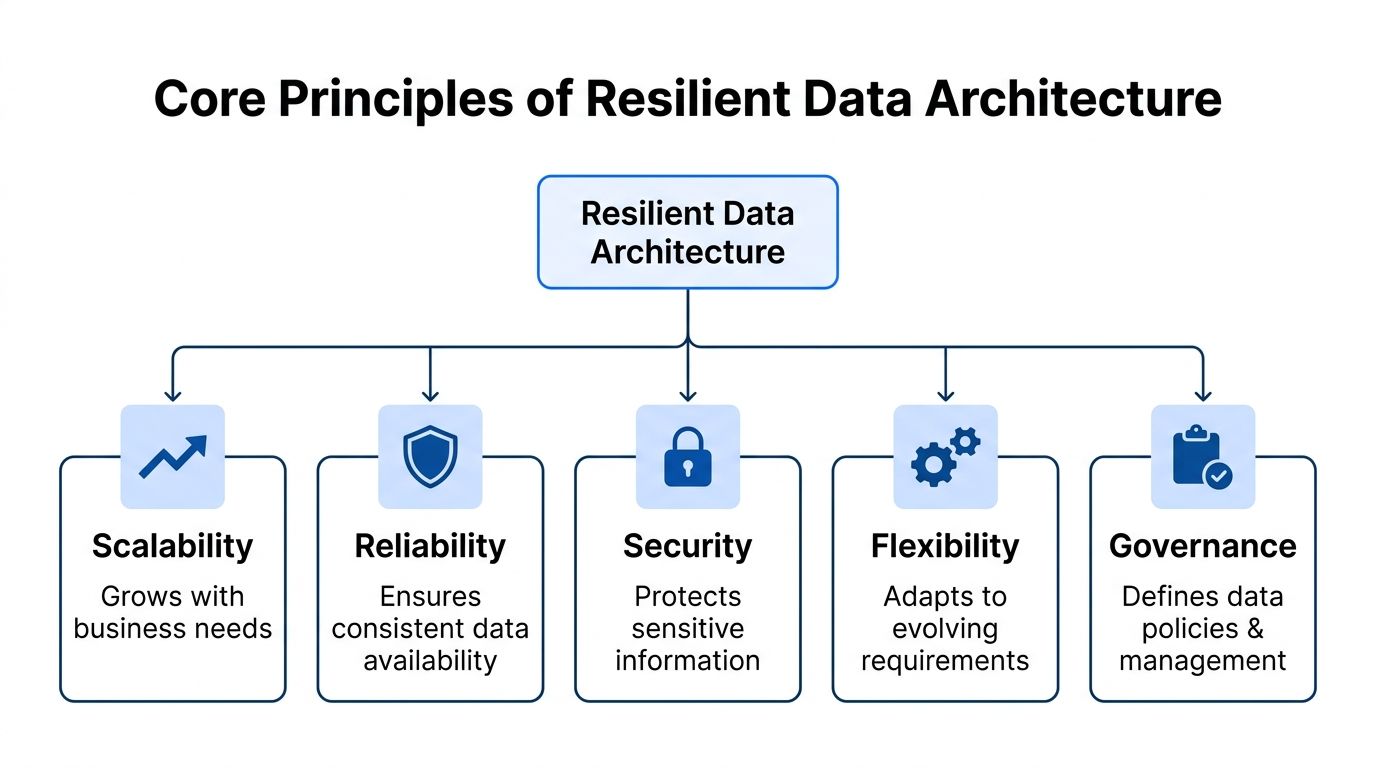
Un'architettura resiliente non si definisce in base alla scelta di Snowflake, BigQuery, Databricks, Kafka, dbt o Airflow. Queste scelte contano, ma poggiano su un insieme più ristretto di principi che determinano se il sistema resta utilizzabile man mano che l'azienda cresce e cambia.
Scalabilità e flessibilità
Scalabilità significa che la piattaforma può supportare più sorgenti, più utenti e più workload senza trasformare ogni espansione in un progetto architetturale. Il test pratico è semplice. Quando arriva una nuova business unit, il vostro team riesce a integrarne i dati attraverso i pattern esistenti, oppure ogni integrazione richiede engineering su misura?
Perché è importante: se la scalabilità dipende da lavoro su misura, i rilasci rallentano e i costi tendono a salire. I team diventano dipendenti da pochi engineer che conoscono le eccezioni.
La flessibilità è un'altra cosa. Un sistema scalabile può crescere. Un sistema flessibile può cambiare direzione. Questo conta quando il business aggiunge una nuova linea di prodotto, entra in un mercato regolamentato o passa dal reporting batch all'analytics operativa.
Un modello rigido all'inizio sembra spesso efficiente, perché standardizza tutto. In seguito diventa il motivo per cui nulla di nuovo viene rilasciato in tempi rapidi.
Sicurezza e governance by design
La sicurezza funziona meglio quando è integrata nell'architettura, non quando viene rivista dopo che le pipeline sono già in produzione. I dati sensibili dovrebbero passare attraverso controlli definiti, non attraverso eccezioni ad hoc e accordi informali tra team.
Perché è importante: una sicurezza aggiunta a posteriori crea punti ciechi. Prima o poi scoprirete dataset con regole di accesso poco chiare, copie nell'ambiente sbagliato o trasformazioni che nessuno sa spiegare all'audit.
La governance segue la stessa dinamica. Una buona governance non è un comitato che pubblica policy che nessuno usa. È un sistema pratico di responsabilità, metadati, convenzioni di denominazione, classificazione, lineage e regole di accesso adatto al modo in cui lavorano i team.
Regola pratica: se gli engineer devono aggirare la governance per consegnare in tempo, il modello di governance è progettato male.
Una configurazione resiliente di solito include:
Responsabilità chiare: ogni dataset critico ha bisogno di un responsabile di business e di un responsabile tecnico con nome e cognome.
Definizioni condivise: ricavi, cliente attivo, pipeline prenotata e termini simili non possono variare da un reparto all'altro.
Lineage visibile: i team devono sapere cosa dipende da cosa prima di modificare la logica a monte.
Applicazione delle policy: i controlli di accesso dovrebbero essere sistematici, non un'improvvisazione guidata dai ticket.
L'osservabilità come proprietà integrata
Spesso le architetture falliscono proprio per questo motivo. Presumono che, se le pipeline girano e le dashboard si caricano, il sistema sia in salute. Non è così. I dati possono arrivare in ritardo, subire drift, cambiare forma o degradarsi in modi che il monitoraggio tradizionale dei sistemi non intercetta.
Osservabilità significa che l'architettura è comprensibile mentre è in funzione. I team possono capire se i dati sono freschi, se le distribuzioni stanno cambiando in modo inatteso, se gli schemi si sono modificati e quali asset a valle sono esposti.
Perché è importante: senza un'osservabilità integrata, il business viene a sapere dei problemi dei dati solo dopo un report rotto, una riunione del management andata male o un modello che si comporta in modo strano in produzione.
Ecco perché considero l'osservabilità un principio di design, non una categoria di strumenti. Se non è integrata fin dal primo giorno, la fiducia diventa un esercizio manuale.
Scomporre il progetto: i componenti chiave
Pensate all'architettura dati enterprise come a una linea di produzione. Le materie prime arrivano da fornitori diversi. Vengono scaricate, controllate, smistate, raffinate, immagazzinate, confezionate e spedite alle persone che ne hanno bisogno. Se una stazione è debole, l'intera linea diventa inaffidabile.

Ingestion e integrazione
Questa è la banchina di carico. I dati entrano da database operativi, strumenti SaaS, flussi di eventi, file, feed dei partner e sistemi legacy. I team di solito sottovalutano questo livello, perché l'ingestion sembra semplice finché i sistemi sorgente non cambiano, le API non si comportano in modo incoerente o la logica di business non finisce incorporata nel codice dei connettori.
Un livello di ingestion maturo gestisce sia i pattern batch sia quelli in tempo reale senza trasformare ogni sorgente in un caso speciale. Inoltre separa, ove possibile, l'estrazione dalla trasformazione di business. In questo modo l'acquisizione dalle sorgenti resta stabile anche quando la logica a valle evolve.
Per le organizzazioni più piccole che stanno ancora consolidando le basi, questi consigli sui database per PMI ed e-commerce ricordano utilmente che la disciplina strutturale alla sorgente riduce molto lavoro di pulizia a valle.
Storage ed elaborazione
Lo storage è il punto in cui molte discussioni architetturali si arenano, perché si dibatte sulle piattaforme prima di chiarire i pattern di utilizzo. La domanda centrale è quali tipi di dati dovete conservare, con quale velocità devono essere accessibili e quali workload devono supportare. Zone di atterraggio dei dati grezzi, archivi analitici curati e livelli di serving esistono ciascuno per motivi diversi.
L'elaborazione è la fase di assemblaggio in cui i dati grezzi diventano utilizzabili attraverso standardizzazione, join, regole di qualità, arricchimento e logica di business modellata. Strumenti come dbt, Spark, Flink e i framework di trasformazione nativi del data warehouse possono avere tutti un ruolo. Ciò che conta di più è che la logica di trasformazione sia manutenibile, testabile e visibile agli altri team.
Un modello mentale utile è separare l'elaborazione in livelli:
Livello raw: preserva la fedeltà alla sorgente per la tracciabilità.
Livello refined: standardizza le strutture e risolve i problemi di qualità più comuni.
Livello business: codifica le definizioni su cui le persone basano i report.
Questo approccio a livelli è uno dei motivi per cui molti team valutano una piattaforma dati enterprise dedicata invece di mettere insieme servizi isolati nel tempo.
Catalogo, serving, governance e sicurezza
Una volta elaborati i dati, le persone devono comunque trovarli, fidarsene e usarli in sicurezza. È qui che conta il resto del progetto.
Un data catalog è il sistema di inventario. Aiuta analisti, engineer e team di governance a scoprire cosa esiste, chi ne è responsabile e se è approvato per l'uso. Senza di esso, il self-service si trasforma in una caccia alle tabelle e in un'archeologia su Slack.
Il data serving è la funzione di spedizione. Comprende dashboard, semantic layer, API, reverse ETL, accesso alle feature per il ML e qualsiasi altro meccanismo che consegna dati curati a un consumatore. Questo livello dovrebbe essere ottimizzato per la chiarezza, non solo per la velocità. Se i consumatori possono accedere ai dati ma non ne comprendono il significato, l'architettura fallisce comunque.
Il modo più rapido per sovraccaricare un team dati è pubblicare più tabelle di quante il business riesca a interpretare.
Gli ultimi due componenti sono trasversali. La governance definisce policy, stewardship e controllo del ciclo di vita. La sicurezza applica identità, permessi, mascheramento, conservazione e confini tra ambienti. Non dovrebbero affiancare l'architettura come funzioni di revisione esterne. Dovrebbero dare forma a ogni livello, dall'ingestion al serving.
I pattern architetturali più comuni e quando usarli
Non esiste un unico pattern corretto di architettura dati enterprise. La scelta giusta dipende dal modello operativo dell'organizzazione, dalla maturità dei dati, dalla cultura della governance e dai requisiti di velocità. L'errore è copiare un pattern perché è di moda, per poi scoprire che la struttura del team non è in grado di sostenerlo.
Data warehouse centralizzato
Il modello tradizionale del data warehouse centralizza storage, modellazione e reporting in un ambiente analitico controllato. Funziona bene quando il business ha bisogno di reporting coerente, metriche condivise e una forte supervisione centrale. Le organizzazioni con un forte peso della finanza traggono spesso vantaggio da questo modello, perché la disciplina sulle metriche conta più della sperimentazione locale.
Il compromesso è la velocità alla periferia. I team di dominio possono dover attendere la funzione dati centrale per le modifiche, e i dati semi-strutturati o in rapida evoluzione possono risultare scomodi in un'impostazione incentrata sul data warehouse.
Lakehouse
Il pattern lakehouse cerca di combinare uno storage flessibile con una struttura più solida per analytics e AI. È adatto alle organizzazioni che devono supportare workload misti tra BI, data science e trasformazioni su larga scala senza mantenere ecosistemi separati per ogni caso d'uso.
Il vantaggio è il consolidamento architetturale. Lo svantaggio è la complessità della governance, se i team interpretano la flessibilità come un permesso per saltare gli standard. Un lakehouse può diventare disciplinato ed efficiente, oppure una palude dall'aspetto più moderno.
Se il vostro team sta valutando le implicazioni pratiche dell'orchestrazione e del design dei flussi all'interno di questi pattern, questa guida all'architettura delle pipeline di dati è un utile complemento alla decisione architetturale più ampia.
Data mesh
Il data mesh è meno una scelta di piattaforma e più un modello organizzativo. Decentralizza la responsabilità verso i team di dominio, che pubblicano e mantengono data product per il resto dell'azienda. Può funzionare quando l'azienda opera già con una forte responsabilità di dominio e dispone di sufficiente maturità ingegneristica al di fuori del team dati centrale.
La modalità di fallimento è comune. Le aziende adottano il linguaggio del mesh ma mantengono una governance debole, una responsabilità di prodotto poco chiara e standard incoerenti. Il risultato è decentralizzazione senza interoperabilità.
Il data mesh funziona quando i domini sono pronti ad assumersi la responsabilità di qualità, contratti e supporto. Fallisce quando la leadership centrale vuole autonomia senza responsabilità.
Architettura event-driven
L'architettura event-driven si concentra sui flussi e sulle reazioni quasi in tempo reale. È utile quando i processi di business dipendono dallo stato corrente, come i workflow antifrode, le notifiche operative, le decisioni dinamiche sull'inventario o la telemetria di prodotto.
Offre al business reattività, ma alza anche l'asticella per la disciplina sugli schemi, la gestione dei contratti e l'osservabilità. I sistemi in tempo reale amplificano rapidamente le pratiche deboli.
Pattern di architettura dati a confronto
Pattern | Ideale per | Modello di governance | Struttura del team |
|---|---|---|---|
Data warehouse | Reporting standardizzato, finanza, metriche per il management | Forte governance centrale | Il team dati centrale gestisce la maggior parte della modellazione |
Lakehouse | Workload misti di analytics e AI, tipi di dati in evoluzione | Standard centrali con implementazione flessibile | Team di piattaforma più pratiche di engineering condivise |
Data mesh | Grandi organizzazioni con una forte responsabilità di dominio | Governance federata | I team di dominio sono responsabili dei data product |
Architettura event-driven | Casi d'uso operativi che richiedono reazioni tempestive | Governance basata sui contratti | Team di piattaforma più domini che producono eventi |
Un test pratico di selezione si riduce di solito a quattro domande:
Velocità decisionale: il business ha bisogno di reporting periodico affidabile, di azioni quasi in tempo reale o di entrambi?
Modello di responsabilità: i domini possono gestire i data product in modo responsabile, oppure il controllo centrale è ancora necessario?
Mix di workload: servite principalmente la BI, oppure supportate anche ML, applicazioni operative e casi d'uso in streaming?
Maturità della governance: gli standard possono sopravvivere al di fuori di un team centralizzato?
La maggior parte delle aziende finisce con un modello misto. È normale. Ciò che conta è scegliere consapevolmente il pattern dominante e poi definire dove sono ammesse le eccezioni.
Costruire fiducia con data quality e observability integrate
Una dashboard può caricarsi puntualmente ed essere comunque sbagliata. Un modello può assegnare punteggi ai record senza errori e usare comunque input degradati. Ecco perché data quality e observability appartengono all'architettura stessa, non a un ciclo di acquisti successivo.

Perché il solo monitoraggio non basta
Il monitoraggio tradizionale vi dice se l'infrastruttura è attiva, se i job sono stati completati o se le query sono state eseguite. Non vi dice in modo affidabile se i dati sono rimasti attendibili. I guasti silenziosi sono quelli costosi. Una sorgente inizia a consegnare i record più tardi del solito. Una modifica di schema arriva senza coordinamento. Un campo chiave inizia a subire drift perché un'applicazione a monte ha cambiato comportamento.
Questi problemi non sempre rompono la pipeline. Rompono la fiducia.
È per questo che spingo gli Head of Data a trattare freschezza, stabilità degli schemi, variazioni delle distribuzioni e conformità alle regole di business come questioni architetturali. Se il design non riesce a far emergere rapidamente queste condizioni, il sistema è operativamente fragile anche quando calcolo e storage sembrano in salute.
Cosa richiede davvero un'architettura affidabile
La fiducia integrata deriva di solito da un insieme di pratiche, non da un singolo controllo:
Controlli di puntualità: i team devono sapere quando i dati attesi non sono arrivati, non dopo che la dashboard del mattino è stata messa in discussione.
Consapevolezza dello schema: le modifiche strutturali dovrebbero essere visibili prima che job o report a valle le assorbano senza che nessuno se ne accorga.
Rilevamento delle anomalie: i cambiamenti inattesi di valori, volumi o pattern richiedono un'attenzione automatizzata.
Regole di validazione: le asserzioni critiche per il business vanno collocate vicino alla pipeline, non in routine di audit manuali.
Visibilità condivisa: engineer, analisti e stakeholder dovrebbero vedere lo stesso quadro operativo.
Per i team che costruiscono questa capacità da zero, un'introduzione chiara a che cos'è la data observability aiuta ad ancorare la discussione a requisiti operativi concreti anziché al linguaggio dei fornitori.
La fiducia non nasce da un badge di certificazione su una dashboard. Nasce quando l'architettura è in grado di dimostrare che i dati sono aggiornati, strutturalmente solidi e si comportano come previsto.
L'impatto sul business è diretto. Un'osservabilità affidabile accorcia la diagnosi degli incidenti, riduce le escalation evitabili verso il management e protegge l'analytics e l'AI a valle da un degrado invisibile. Senza di essa, i team finiscono per fare un lavoro da detective dopo che il danno ha già raggiunto chi prende le decisioni.
Dal progetto alla realtà: deployment e migrazione
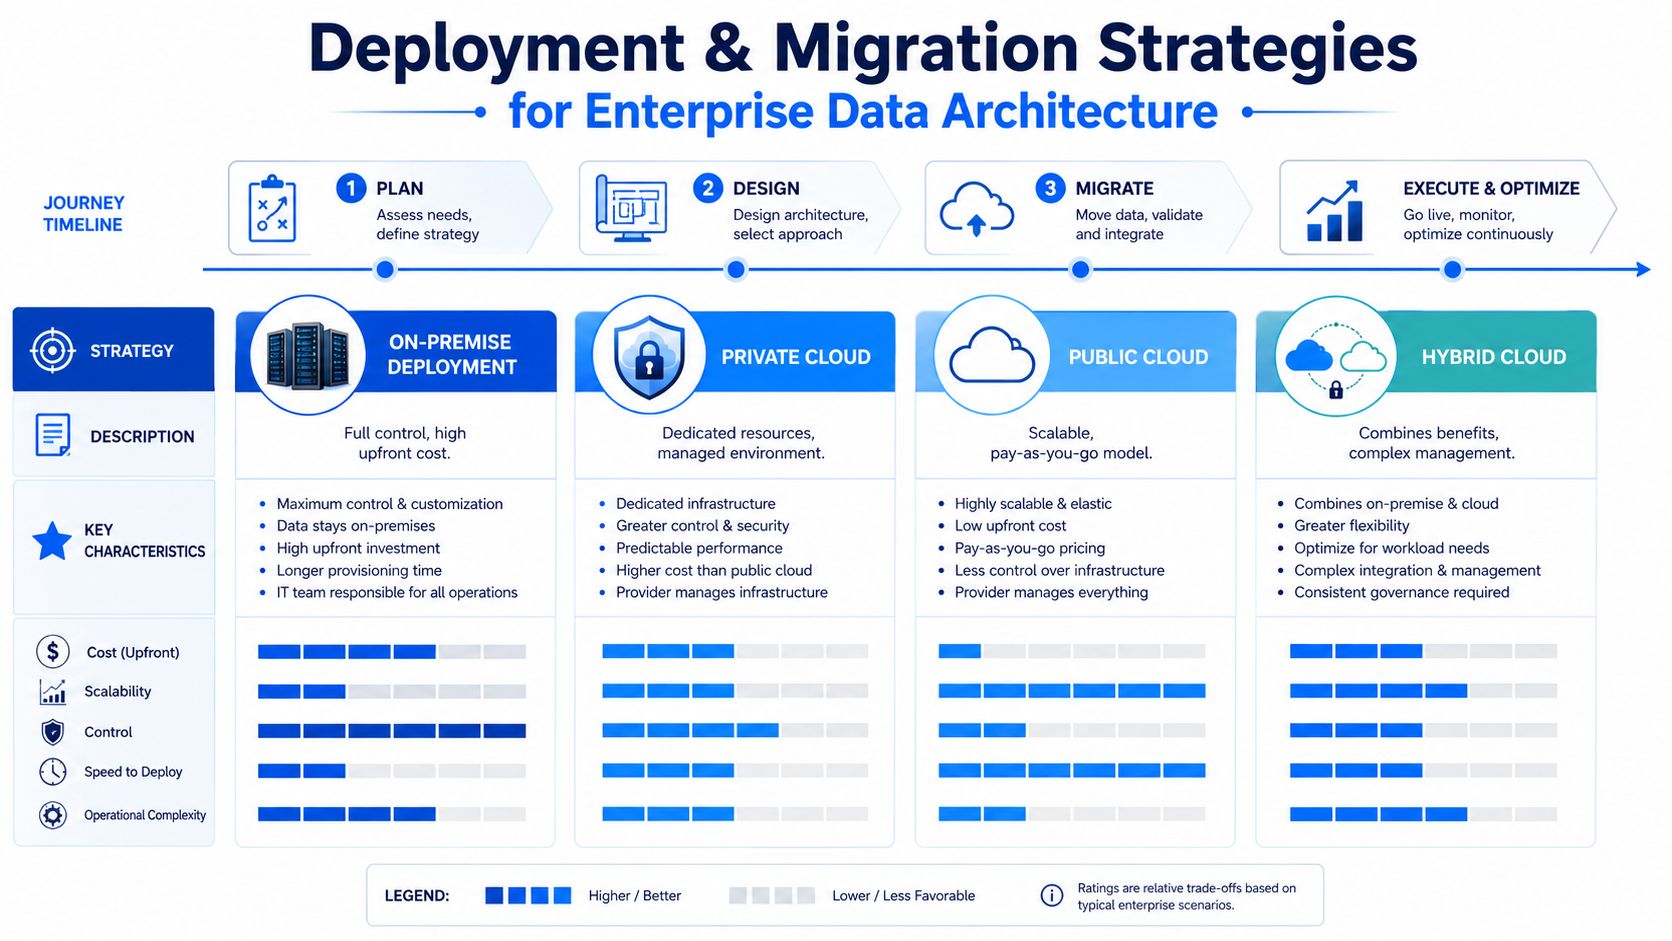
Le decisioni architetturali diventano concrete quando scegliete dove gira il sistema e come passerete dallo stato attuale allo stato obiettivo. È lì che la strategia incontra i vincoli istituzionali.
Scegliere il modello di deployment
L'on-premises offre il massimo controllo e spesso si allinea a requisiti normativi o operativi rigorosi. Può essere adatto ad ambienti in cui la residenza dei dati, i confini della rete interna o le esigenze di integrazione con sistemi legacy sono obbligatori. Il compromesso è che l'evoluzione della piattaforma tende a essere più lenta e i team interni sostengono un carico operativo maggiore.
Il private cloud offre una via di mezzo. Mantenete un controllo più stretto sul design dell'ambiente, ottenendo al contempo alcuni dei vantaggi gestionali associati alle infrastrutture di tipo cloud. Questa soluzione attrae spesso le aziende che hanno bisogno di un isolamento più forte senza possedere completamente ogni livello.
Il public cloud di solito vince per elasticità, ampiezza dei servizi e velocità di provisioning. Spesso è la via più rapida per i team che devono scalare velocemente o sperimentare su larga scala. Il compromesso è la disciplina della governance. La comodità del cloud può moltiplicare la proliferazione se ambienti, zone di storage e policy di accesso non sono gestiti in modo rigoroso.
L'hybrid cloud è il risultato più comune nella realtà. Consente alle organizzazioni di mantenere alcuni workload vicini ai sistemi regolamentati, spostando il lavoro analitico o sperimentale in ambienti più elastici. Introduce però anche complessità. Integrazione, identità, applicazione delle policy e controllo dei costi diventano tutti più difficili quando l'architettura si estende su più ambienti.
Un percorso di migrazione per fasi che funziona
Le migrazioni che falliscono di solito puntano a un taglio netto fin dal primo giorno. Sembra una scelta decisa, ma ignora quante dipendenze nascoste vivono in report, interfacce e job non documentati.
Un percorso più duraturo è questo:
Valutate il patrimonio attuale
Mappate i domini di dati critici, le dipendenze tra sistemi, le lacune di responsabilità e i problemi di fiducia noti. Non iniziate da tutti i dataset. Iniziate da quelli su cui il business non può permettersi errori.Scegliete un pilota con valore politico
Selezionate un dominio abbastanza importante da contare, ma abbastanza circoscritto da essere gestibile. Un pilota dovrebbe dimostrare che la nuova architettura migliora affidabilità o velocità, non solo che modernizza gli strumenti.Migrate a ondate
Procedete per capacità di business, dominio di dati o tipo di workload. Rendete esplicita la coesistenza. Durante la transizione i team devono sapere quale piattaforma è autorevole per cosa.Istituzionalizzate la disciplina operativa
Integrate documentazione, responsabilità, processi di supporto, controlli di qualità e osservabilità prima dell'ondata successiva. Altrimenti finirete per scalare il debito di migrazione invece di risolverlo.
Il ritmo di migrazione giusto è il più rapido che preservi la fiducia.
Il consenso degli stakeholder di solito arriva quando i leader vedono eliminato il rischio da un processo di business doloroso. L'eleganza tecnica da sola non porterà avanti il programma. La credibilità operativa sì.
La vostra stella polare architetturale: best practice concrete
Le migliori decisioni di architettura dati enterprise sono di solito noiose nel senso giusto. Riducono l'ambiguità, chiariscono le responsabilità e rendono il cambiamento più sicuro.
Usate questi principi come filtro di lavoro:
Progettate per le decisioni di business: partite dai processi, dalle metriche e dai rischi che interessano al business.
Standardizzate dove conta: definizioni condivise, lineage, modelli di accesso e controlli di qualità non dovrebbero variare da un team all'altro.
Consentite flessibilità ai margini: le esigenze specifiche dei domini sono reali, ma hanno bisogno di guardrail.
Trattate l'osservabilità come fondamentale: freschezza, modifiche di schema, anomalie e validazione devono essere visibili nelle normali operazioni.
Scegliete pattern adatti all'organizzazione: non adottate modelli mesh, streaming o lakehouse se la struttura del team non è in grado di sostenerli.
Migrate per fasi: un progresso stabile batte un passaggio drastico.
Documentate le responsabilità senza sosta: se nessuno è responsabile di un dataset, nessuno lo correggerà rapidamente quando conta.
Per i team che stanno perfezionando il livello di esecuzione, queste best practice per le pipeline di dati sono un'estensione pratica dei principi architetturali descritti sopra.
Se state costruendo un'architettura che richiede fin dal primo giorno pipeline affidabili, anomalie visibili, consapevolezza dello schema e controlli di data quality, digna merita un'attenta valutazione. È pensato per i team enterprise che hanno bisogno di osservabilità e validazione all'interno di ambienti controllati dal cliente, con supporto per deployment in private cloud e on-premises.
Per il lato operativo del trattare l'osservabilità come una proprietà architetturale integrata anziché come un ciclo di acquisti successivo, vedete come la data platform observability con digna mantiene visibili freschezza, modifiche di schema e anomalie all'interno di ambienti controllati dal cliente.
Domande frequenti
Che cos'è l'architettura dati enterprise?
Nella pratica, l'architettura dati enterprise è il modello operativo delle informazioni. Definisce come i dati entrano nell'organizzazione, dove risiedono, come vengono trasformati, chi ne è responsabile, quali controlli si applicano e come le persone li utilizzano. Il vero test è se produce decisioni affidabili alla velocità di cui il business ha bisogno.
Quali sono i componenti chiave di un'architettura dati enterprise?
L'articolo la paragona a una linea di produzione: ingestion e integrazione fungono da banchina di carico, storage ed elaborazione sono suddivisi in livelli raw, refined e business, un data catalog funge da sistema di inventario e il data serving gestisce la spedizione. Governance e sicurezza sono trasversali e danno forma a ogni livello.
Quando conviene scegliere un data mesh invece di un data warehouse centralizzato?
Scegliete il data mesh quando i team di dominio sono pronti ad assumersi la responsabilità di qualità, contratti e supporto per i propri data product, sotto una governance federata. Un data warehouse centralizzato è adatto a reporting standardizzato, finanza e metriche per il management sotto un forte controllo centrale. La maggior parte delle aziende finisce con un modello misto costruito attorno a un pattern dominante scelto consapevolmente.
Perché l'osservabilità dovrebbe essere integrata nell'architettura dati?
Le pipeline possono girare e le dashboard caricarsi mentre i dati arrivano in ritardo, subiscono drift o cambiano forma, e il monitoraggio tradizionale mostra solo se i job sono stati completati. Per questo l'articolo tratta controlli di puntualità, consapevolezza dello schema, rilevamento delle anomalie, regole di validazione e visibilità condivisa come questioni architetturali, così che i problemi emergano prima che un report per il management si rompa.
Come si migra verso una nuova architettura dati enterprise?
Migrate per fasi invece di tentare un taglio netto. L'articolo delinea quattro passaggi: valutare il patrimonio attuale, scegliere un pilota con valore politico, migrare a ondate per capacità, dominio o workload, e istituzionalizzare documentazione, responsabilità, controlli di qualità e osservabilità prima di avviare l'ondata successiva.


