Enterprise data platform: guida 2026 all'architettura
|
6
min di lettura

Le vostre dashboard sono tutte verdi, ma la tabella dei ricavi è in ritardo di sei ore. Un modello che la settimana scorsa funzionava inizia a restituire risultati scadenti perché, durante la notte, una colonna a monte ha cambiato tipo. Il team BI dà la colpa all'ingestion, il team di data engineering ai sistemi sorgente, e il management si aspetta comunque un numero affidabile la mattina seguente.
È la situazione attuale di molti ambienti enterprise. Di solito il problema non è la mancanza di strumenti. È che la piattaforma è stata costruita per spostare e archiviare dati, non per dimostrare in modo continuo che i dati sono ancora corretti, tempestivi e sicuri da usare. Nella pratica, una moderna enterprise data platform funziona solo quando controlli di qualità e observability fanno parte della piattaforma stessa, e non vengono aggiunti a posteriori dopo il primo incidente.
Indice
Che cos'è una enterprise data platform
Una enterprise data platform non è un singolo prodotto. È l'architettura operativa che consente a un'organizzazione di acquisire, archiviare, trasformare, governare, monitorare e distribuire dati attraverso molti sistemi senza perdere fiducia nel loro significato.
Il modo più semplice per pensarla è come il sistema nervoso centrale dei dati aziendali. I sistemi sorgente generano segnali. Le pipeline li trasportano. I livelli di storage li conservano. I motori di calcolo li modellano. La governance definisce chi può usare che cosa. Qualità e observability vi dicono se l'intero sistema si sta ancora comportando come previsto.
Questa distinzione è importante perché molti team confondono ancora un account di data warehouse, un bucket di data lake o uno strumento di orchestrazione con la piattaforma stessa. Quelli sono componenti. La piattaforma è il sistema coordinato che rende i dati utilizzabili su scala enterprise per BI, operations, analytics engineering e carichi di lavoro di AI.
Regola pratica: se il vostro team non riesce a rispondere alla domanda “Questi dati sono aggiornati, strutturalmente validi e sicuri da usare?” senza aprire cinque strumenti diversi, non avete ancora una piattaforma matura.
La maggior parte delle organizzazioni ricorre a una enterprise data platform dopo la stessa serie di problemi. Le metriche non coincidono tra i team. Le dashboard si rompono dopo modifiche dello schema passate inosservate. I data scientist addestrano modelli su input che hanno subito un drift settimane prima. I team di sicurezza e governance scoprono troppo tardi che dati sensibili hanno superato un confine che non avrebbero dovuto superare.
L'importanza strategica non è più in discussione. Il mercato delle piattaforme big data era valutato 101,55 miliardi di USD nel 2026 e si prevede che raggiunga 314,35 miliardi di USD entro il 2035, con un CAGR del 13,38%, e gli utenti di piattaforme avanzate hanno una probabilità 2,5 volte maggiore di superare i concorrenti nella crescita dei ricavi, secondo Business Research Insights sul mercato delle piattaforme big data.
Questa crescita non significa che ogni piattaforma funzioni bene. Significa che le aziende ora riconoscono di aver bisogno di un sistema in grado di supportare sia il reporting classico sia i nuovi casi d'uso basati sull'AI. La parte difficile è che l'AI alza l'asticella. Una dashboard non aggiornata è imbarazzante. Un modello addestrato su input sottilmente corrotti può innescare decisioni sbagliate su larga scala.
Una enterprise data platform funzionante crea un'unica disciplina a partire da molte parti in movimento. Offre ai team un modo per integrare sorgenti diverse, applicare le policy, tracciare la lineage, rilevare i guasti in anticipo e consegnare data product affidabili senza dipendere da conoscenze tacite.
I componenti fondamentali di una EDP moderna
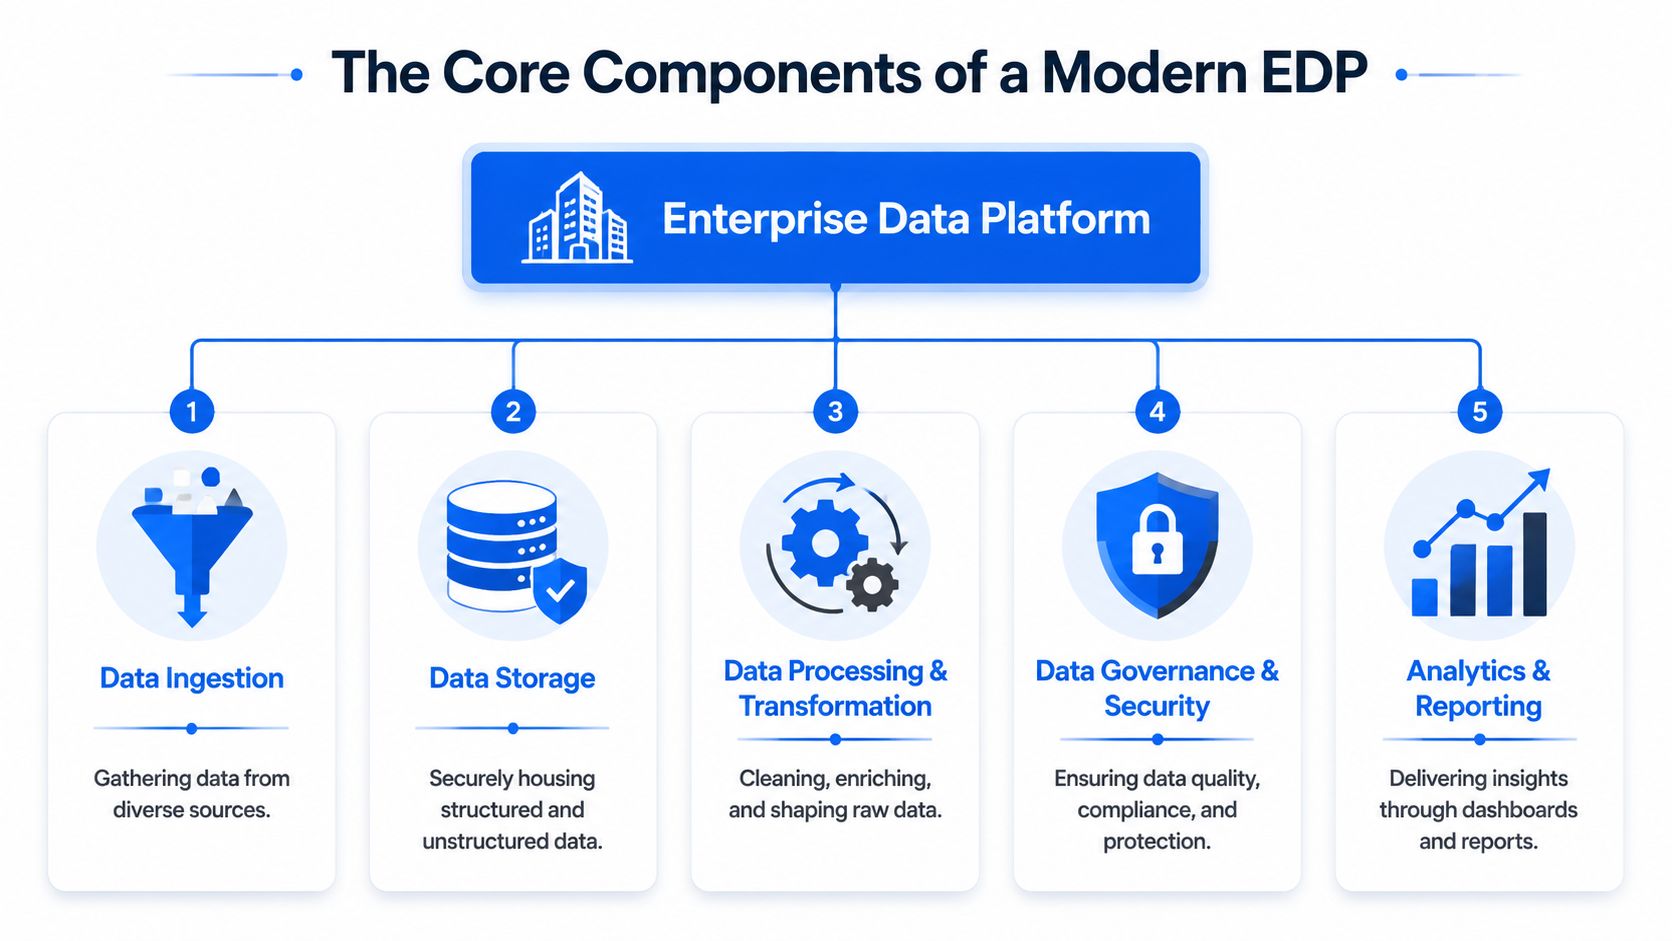
Una moderna enterprise data platform ha cinque livelli operativi. Se uno è debole, il resto dello stack inizia a compensarlo.
Perché il livello di storage non è la piattaforma
Si parte dalla data ingestion. Questo livello estrae dati da database operativi, applicazioni SaaS, stream di eventi, file flat, API e sistemi dei partner. Una buona ingestion supporta sia il trasferimento batch sia quello incrementale. Una cattiva ingestion crea latenza nascosta, caricamenti duplicati e semantiche incoerenti ancora prima che i dati arrivino a destinazione.
Poi c'è lo storage dei dati. Può essere un warehouse, un lake o una combinazione dei due. Lo storage deve accogliere dati strutturati e non strutturati, preservando una fedeltà sufficiente per la rielaborazione a valle. Spesso i team spendono troppo in questo ambito perché scelgono un pattern di storage prima di aver definito i pattern di consumo.
Segue elaborazione e trasformazione. In questa fase i dati grezzi diventano dati utilizzabili. I motori di calcolo si occupano di pulizia, arricchimento, join, conformazione delle dimensioni, logica di business e modelli pronti per la distribuzione. Se le trasformazioni non sono documentate o sono sparse tra i team, la piattaforma inizia a produrre versioni contraddittorie della stessa metrica.
Un quarto livello è governance e sicurezza. Comprende controllo degli accessi, classificazione dei dati, applicazione delle policy, limiti di conservazione e visibilità della lineage. Negli ambienti regolamentati, questo livello determina il modello di deployment spesso più dei costi. Si prevede che il mercato dell'enterprise data management raggiunga 225,97 miliardi di USD entro il 2031, e i deployment on-premises e private cloud detengono ancora una quota del 55,00% dei ricavi, a riflesso della preferenza per ambienti in cui i dati dei clienti restano privati e l'accesso dei fornitori è limitato, soprattutto nei settori finanziario e sanitario, secondo Mordor Intelligence sull'enterprise data management.
Per i team che progettano questo stack, i dettagli pratici di implementazione contano più dei diagrammi dei fornitori. Un buon punto di riferimento è questa panoramica sul data platform engineering, soprattutto quando occorre allineare ingestion, calcolo, governance e controlli operativi invece di trattarli come acquisti separati.
Il livello di controllo qualità che la maggior parte dei team aggiunge troppo tardi
Il quinto livello è quello in cui le piattaforme moderne diventano affidabili oppure restano fragili. Comprende validazione dei dati, tracciamento dello schema e observability.
Non sono la stessa cosa:
La validazione verifica se i record rispettano regole di business esplicite.
Il tracciamento dello schema intercetta i cambiamenti strutturali, come colonne aggiunte, campi rimossi o modifiche di tipo.
L'observability osserva il comportamento nel tempo, inclusi freschezza, variazioni di volume, picchi di valori nulli, drift e pattern anomali.
Di seguito un modo pratico per mappare questi livelli.
Componente | Che cosa fa | Che cosa si rompe senza di esso |
|---|---|---|
Ingestion | Sposta i dati dai sistemi sorgente | Caricamenti in ritardo, duplicati, lacune nascoste |
Storage | Conserva dati grezzi e curati | Rielaborazioni faticose, accesso frammentato |
Elaborazione | Applica la logica di business | Metriche incoerenti, pipeline fragili |
Governance | Applica policy e controllo degli accessi | Rischio di compliance, utilizzo incontrollato |
Qualità e observability | Rileva i problemi dei dati in movimento | Drift silenzioso, report non aggiornati, input AI compromessi |
La piattaforma non è in salute perché i job sono terminati. È in salute quando, dopo la fine dei job, i dati sono corretti, tempestivi e spiegabili.
È il cambio di prospettiva che molti team stanno ancora compiendo. Il monitoraggio dell'infrastruttura vi dice se una pipeline è stata eseguita. L'observability vi dice se ci si può fidare del risultato.
I principali pattern architetturali e i loro compromessi
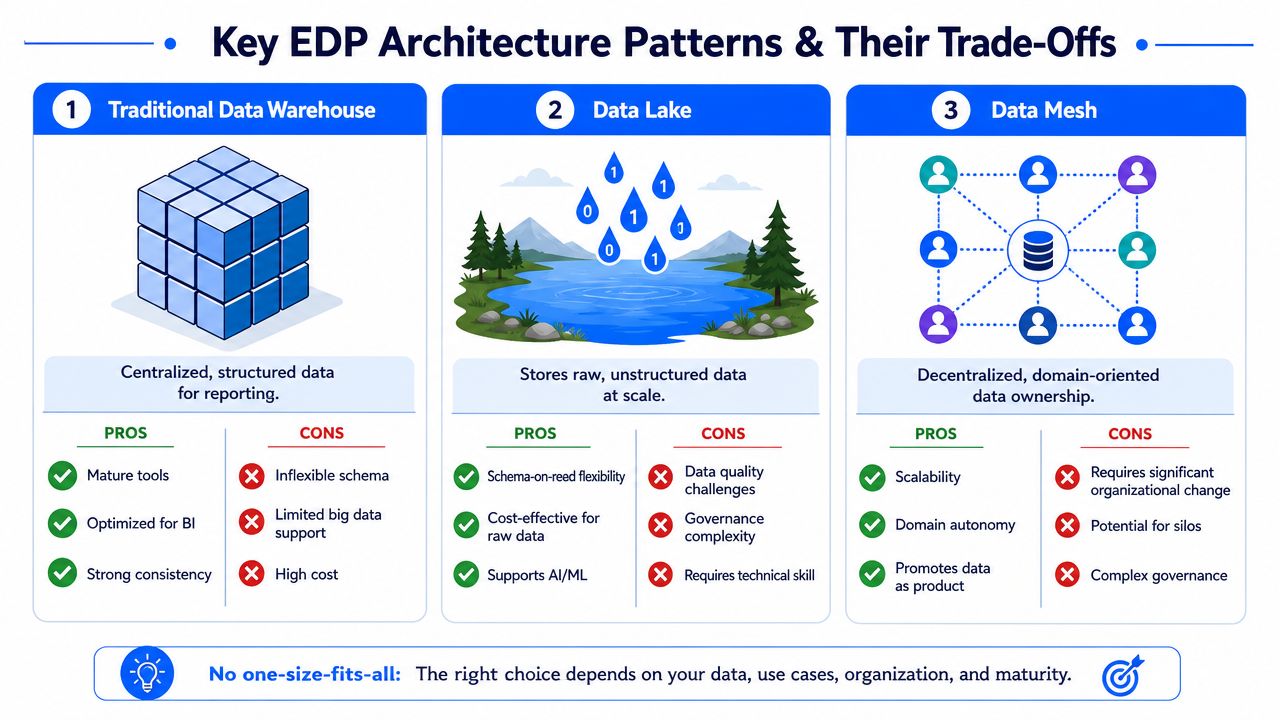
Le scelte architetturali determinano le difficoltà operative per anni. L'errore non è scegliere la buzzword sbagliata. È scegliere un pattern che non corrisponde alla struttura del team, al modello di governance e ai requisiti di latenza.
Dove funziona ciascun pattern
Un data warehouse tradizionale funziona ancora bene quando la coerenza del reporting conta più della flessibilità. Finanza, reporting direzionale e distribuzione di KPI governati rientrano spesso in questo caso. I warehouse offrono un'integrazione BI matura e un controllo rigoroso, ma diventano restrittivi quando i team devono archiviare dati grezzi, semi-strutturati o in rapida evoluzione.
Un data lake offre uno storage grezzo più economico e maggiore libertà per l'esplorazione AI e ML. Il prezzo da pagare è la disciplina operativa. Senza metadati solidi, controlli di qualità e ownership chiara, il lake si riempie di asset poco affidabili che nessuno vuole usare in produzione.
Un lakehouse si colloca spesso a metà strada. Cerca di combinare la governance tipica del warehouse con la flessibilità del lake. Nella pratica è spesso la scelta giusta per le organizzazioni che vogliono un'unica piattaforma ampia per analytics, data science e dataset di dominio condivisi, senza decentralizzare completamente l'ownership.
Un data mesh non è una tecnologia di storage. È un modello organizzativo. Può funzionare quando i domini hanno una reale maturità ingegneristica e possono gestire i data product end-to-end. Fallisce quando gli standard centrali sono deboli o quando la “ownership di dominio” diventa una scusa per semantiche frammentate.
Se state valutando come dovrebbe funzionare la modellazione strutturata all'interno di uno di questi pattern, l'articolo di PlotStudio AI sui principi di progettazione del data warehouse è utile perché ancora le decisioni architetturali alla disciplina di modellazione anziché al marketing delle piattaforme.
Ecco il confronto pratico di cui i team hanno di solito bisogno:
Pattern | Ideale per | Punto di forza principale | Rischio principale |
|---|---|---|---|
Data warehouse | Reporting standardizzato | Coerenza | Rigidità |
Data lake | Scala dei dati grezzi e sperimentazione | Flessibilità | Scarsa affidabilità |
Lakehouse | Carichi misti di analytics e AI | Equilibrio | Complessità degli strumenti |
Data mesh | Grandi organizzazioni federate | Ownership di dominio | Frammentazione della governance |
Per una pianificazione complessa della piattaforma, un diagramma dell'architettura dei dati chiaro può far risparmiare settimane di confusione, perché costringe i team a definire percorsi di movimento, punti di controllo e confini di ownership prima che inizi l'implementazione.
I pattern real-time cambiano il design
Un approccio esclusivamente batch va in crisi non appena il business si aspetta dati aggiornati. Rilevamento delle frodi, monitoraggio operativo, aggiornamenti dell'inventario e applicazioni rivolte ai clienti richiedono spesso movimenti a bassa latenza.
Secondo l'analisi di Gable sui pattern architetturali delle piattaforme dati, le moderne enterprise data platform che combinano livelli batch e speed utilizzando un'architettura event-driven e framework di stream processing come Apache Flink possono garantire sia l'integrità dei dati sia aggiornamenti a bassa latenza, ed è proprio per questo che sempre più team costruiscono sistemi a doppio percorso invece di sostituire completamente il batch.
Su questo compromesso vale la pena essere sinceri:
I percorsi batch sono più facili da comprendere, da sottoporre a backfill e da verificare.
I percorsi streaming riducono la latenza ma aumentano la complessità operativa.
I design a doppio percorso spesso funzionano meglio, ma solo se le regole di riconciliazione sono esplicite.
Se aggiungete lo streaming, aggiungete controlli più rigorosi. La bassa latenza fa emergere prima i problemi dei dati. Non li elimina.
Il pattern architetturale dovrebbe seguire il modello operativo. I team con un piccolo gruppo di piattaforma e forti esigenze di governance di solito ottengono risultati migliori con un controllo centralizzato. Le grandi organizzazioni con solide capacità di ingegneria nei domini possono distribuire maggiormente l'ownership, ma solo se investono in standard condivisi, metadati e applicazione della qualità.
Scegliere il modello di deployment
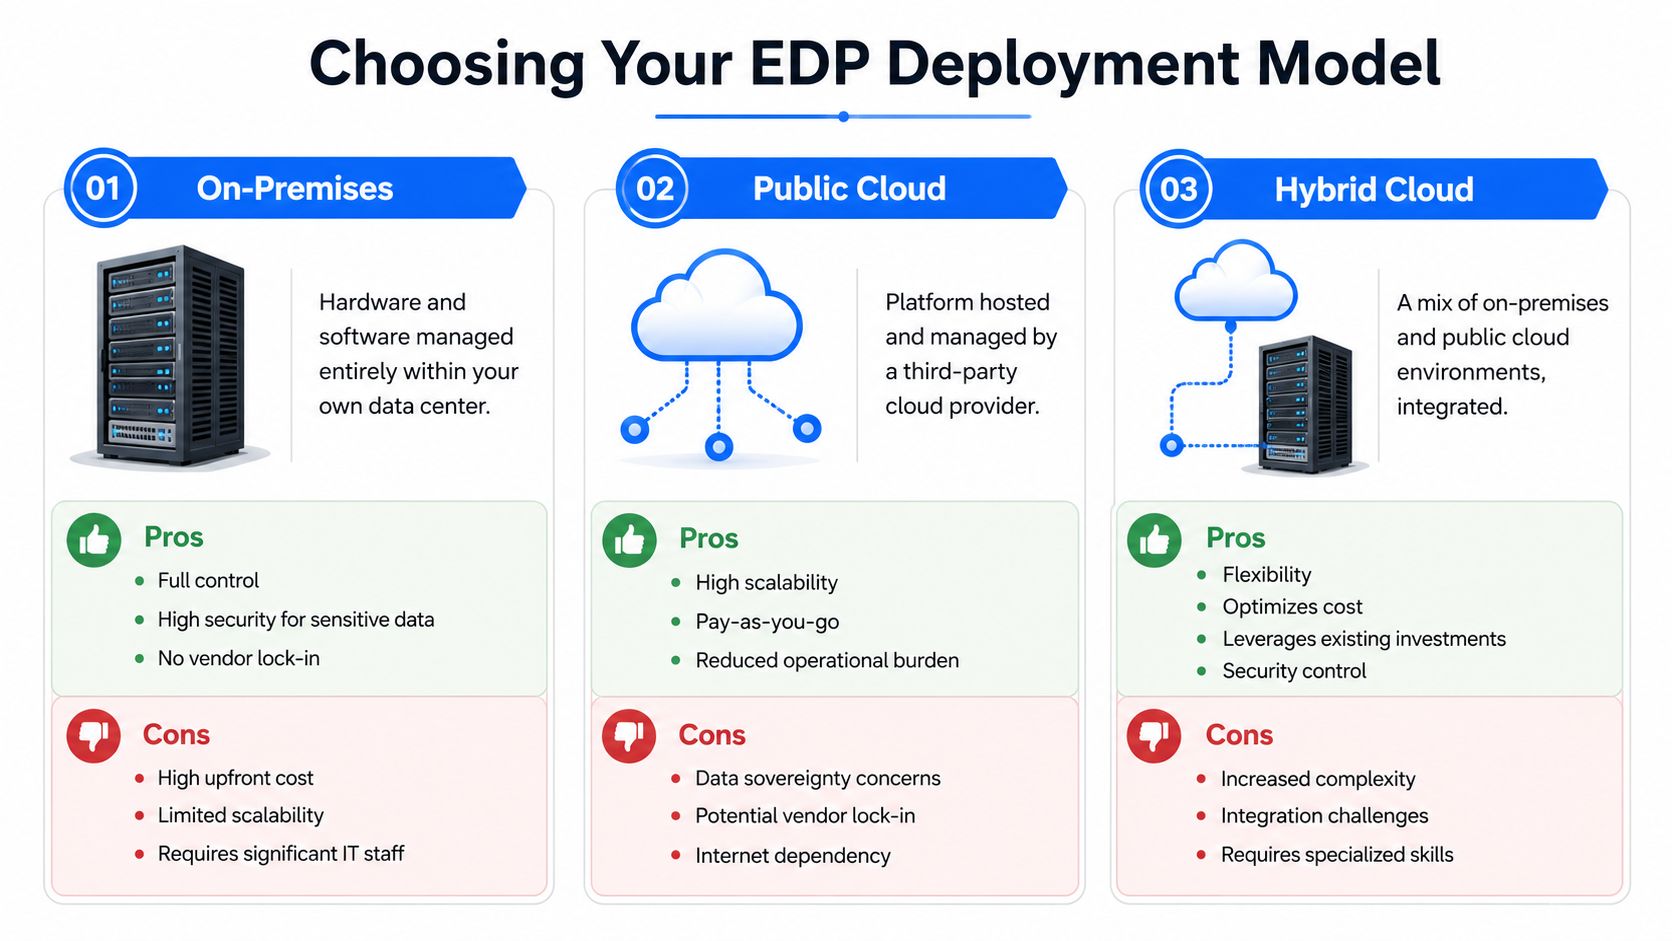
La maggior parte dei dibattiti sul deployment viene impostata come una questione di costi. In realtà riguardano di solito controllo, privacy, onere operativo e il punto in cui il vostro team di compliance traccia il limite.
Che cosa offre l'on-premises
Il deployment on-premises ha ancora senso quando la residenza dei dati, la postura di sicurezza interna o le restrizioni sull'accesso dei fornitori sono requisiti assoluti. I team del settore finanziario, sanitario e di parte del settore pubblico scelgono spesso questa strada perché hanno bisogno di confini rigidi attorno ai dati dei clienti e di un maggiore controllo interno sulle modifiche all'infrastruttura.
Il compromesso è evidente. Siete voi a gestire la pianificazione della capacità, il patching, il ciclo di vita dell'hardware e una parte maggiore dello stack operativo. Se il team di piattaforma interno è ridotto, l'on-premises può trasformarsi in una coda di aggiornamenti rimandati e soluzioni locali di ripiego.
Detto questo, il controllo ha valore quando la privacy conta più della comodità. Alcune organizzazioni preferiscono accettare approvvigionamenti e gestione dell'infrastruttura più lenti piuttosto che spostare dataset critici in un modello che non possono ispezionare completamente.
Quando cloud e ibrido hanno senso
Il public cloud funziona bene quando la domanda è elastica, i team hanno bisogno di provisioning rapido e il business può tollerare la dipendenza dai servizi nativi del provider. È spesso la via più breve verso la sperimentazione, soprattutto per i team di analytics e AI che hanno bisogno di storage e calcolo senza attendere i cicli dell'infrastruttura centrale.
Il rovescio della medaglia è che la facilità di provisioning può nascondere economie disordinate e derive nella governance. I dati vengono copiati troppe volte. I team scelgono servizi gestiti difficili da dismettere in seguito. Le policy di sicurezza diventano incoerenti tra account e regioni.
L'ibrido è spesso la risposta pratica, non quella elegante. I dataset sensibili restano in ambienti privati. I carichi di lavoro meno vincolati scalano sull'infrastruttura cloud. La sfida progettuale è mantenere coerenti governance e visibilità operativa in entrambi gli ambienti.
Secondo lo State of Modern Data Architecture benchmark report riassunto da Dataforest, le enterprise data platform devono essere progettate per gestire volumi di dati 10 volte superiori a quelli attuali senza degrado delle prestazioni, e ciò richiede la flessibilità cloud-native e funzionalità di auto-scaling che consentano ai team di dominio di operare in self-service senza creare colli di bottiglia centrali.
Un semplice confronto aiuta a chiarire la scelta:
On-premises è adatto a requisiti di controllo elevati, carichi di lavoro stabili e policy rigorose sui confini dei dati.
Public cloud è adatto a elasticità, provisioning più rapido e accesso a un'ampia gamma di servizi.
Ibrido è adatto ad ambienti normativi misti e a una modernizzazione per fasi.
Il modello di deployment dovrebbe anche corrispondere al design dell'observability. Una piattaforma che tutela la privacy e gira su infrastruttura controllata dal cliente può essere più adatta di uno strumento che richiede un'estrazione massiccia dei dati solo per monitorarne la qualità. Questo è particolarmente rilevante quando i team di sicurezza non approvano l'accesso dei fornitori ai dati di produzione.
Le decisioni di deployment invecchiano male quando i team ottimizzano solo per il budget di quest'anno e ignorano l'onere di governance dell'anno prossimo.
Il miglior modello di deployment è quello che il vostro team riesce a gestire in modo coerente con vincoli reali, non quello che appare più pulito in un'architettura di riferimento.
Perché data quality e observability non sono negoziabili
Una piattaforma può avere uno storage elegante, pipeline pulite e risorse di calcolo costose, eppure deludere comunque il business perché nessuno sa quando i dati sono diventati obsoleti, hanno subito un drift o hanno cambiato forma. Per questo qualità e observability sono oggi funzioni centrali della piattaforma.
I dati errati falliscono in silenzio
Gli alert dell'infrastruttura sono rumorosi. I guasti dei dati sono spesso silenziosi. Un job va a buon fine ma carica record incompleti. Un sistema sorgente continua a inviare righe, ma la distribuzione dei campi chiave cambia. Un file in ritardo arriva dopo che i report a valle sono già stati aggiornati.
Ecco perché l'AI alza la posta in gioco. I modelli non si lamentano quando gli input di addestramento sono sottilmente errati. Le pipeline di retrieval non annunciano che un feed di documenti ha smesso di aggiornarsi. Restituiscono semplicemente output di qualità inferiore e rendono più difficile l'analisi delle cause profonde.
L'urgenza è evidente in una proiezione. Mentre l'87% delle aziende considera la data observability essenziale per l'AI, il 99% dei dati aziendali resta inutilizzato per l'addestramento dell'AI a causa di lacune di qualità non verificate, secondo SiliconANGLE sulla resilienza dei dati enterprise AI-native. La stessa analisi indica il rilevamento delle anomalie in-database e il tracciamento dello schema come modi pratici per proteggere l'integrità dei modelli.
La lezione operativa è semplice. Se la vostra enterprise data platform non verifica in modo continuo freschezza, struttura e cambiamenti di comportamento, il vostro stack AI eredita rischi sconosciuti.
Una distinzione utile che molti team trascurano è quella trattata in questa guida su data observability e data quality a confronto. La qualità si chiede se i dati soddisfano le aspettative. L'observability si chiede se il sistema è in grado di rilevare quando quelle aspettative smettono di essere vere.
Come si presenta un'observability integrata
Un'observability moderna dovrebbe coprire almeno quattro modalità di guasto.
Ritardi di tempestività. I dati arrivano più tardi del previsto, anche se la pipeline alla fine viene completata.
Modifiche dello schema. Colonne compaiono, scompaiono o cambiano tipo senza un rilascio coordinato.
Anomalie comportamentali. Le metriche si discostano dalle baseline apprese, inclusi tassi di valori nulli, cambiamenti di distribuzione e variazioni di volume inattese.
Violazioni delle regole di business. Record specifici non superano una logica di validazione nota.
Il design della piattaforma conta più del numero di strumenti. Se il rilevamento delle anomalie richiede che gli analisti mantengano a mano centinaia di regole statiche, non scalerà. Se ogni controllo di validazione richiede l'esportazione di dati sensibili in un ambiente gestito dal fornitore, i team privacy ne bloccheranno l'adozione.
Il rilevamento delle anomalie basato sull'AI può ridurre questo carico manuale. Secondo la panoramica di digna sulle tecniche di rilevamento delle anomalie con AI, le piattaforme possono utilizzare metodi non supervisionati come Isolation Forest e autoencoder per apprendere il comportamento normale, inclusi stagionalità e trend, e quindi impostare soglie adattive senza manutenzione manuale delle regole.
Questo approccio è particolarmente utile in contesti enterprise in cui le tabelle sono numerose, i pattern cambiano nel tempo e i team non possono permettersi una taratura infinita delle soglie. Un esempio è digna, che esegue le analisi all'interno dei database dei clienti e supporta rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema in ambienti private cloud o on-premises. Questo modello è spesso più adatto ai team regolamentati perché riduce lo spostamento dei dati ed evita l'accesso dei fornitori ai dataset di produzione.
“Una pipeline andata a buon fine non equivale a dati affidabili.”
I team che trattano l'observability come un componente aggiuntivo finiscono di solito con una gestione degli incidenti frammentata. L'engineering controlla i log di orchestrazione. Gli analisti ispezionano le dashboard. La governance esamina la lineage a cose fatte. Un'observability integrata accorcia questo ciclo perché freschezza, struttura e comportamento dei dati vengono ispezionati dove la piattaforma già opera.
Come scegliere la enterprise data platform giusta
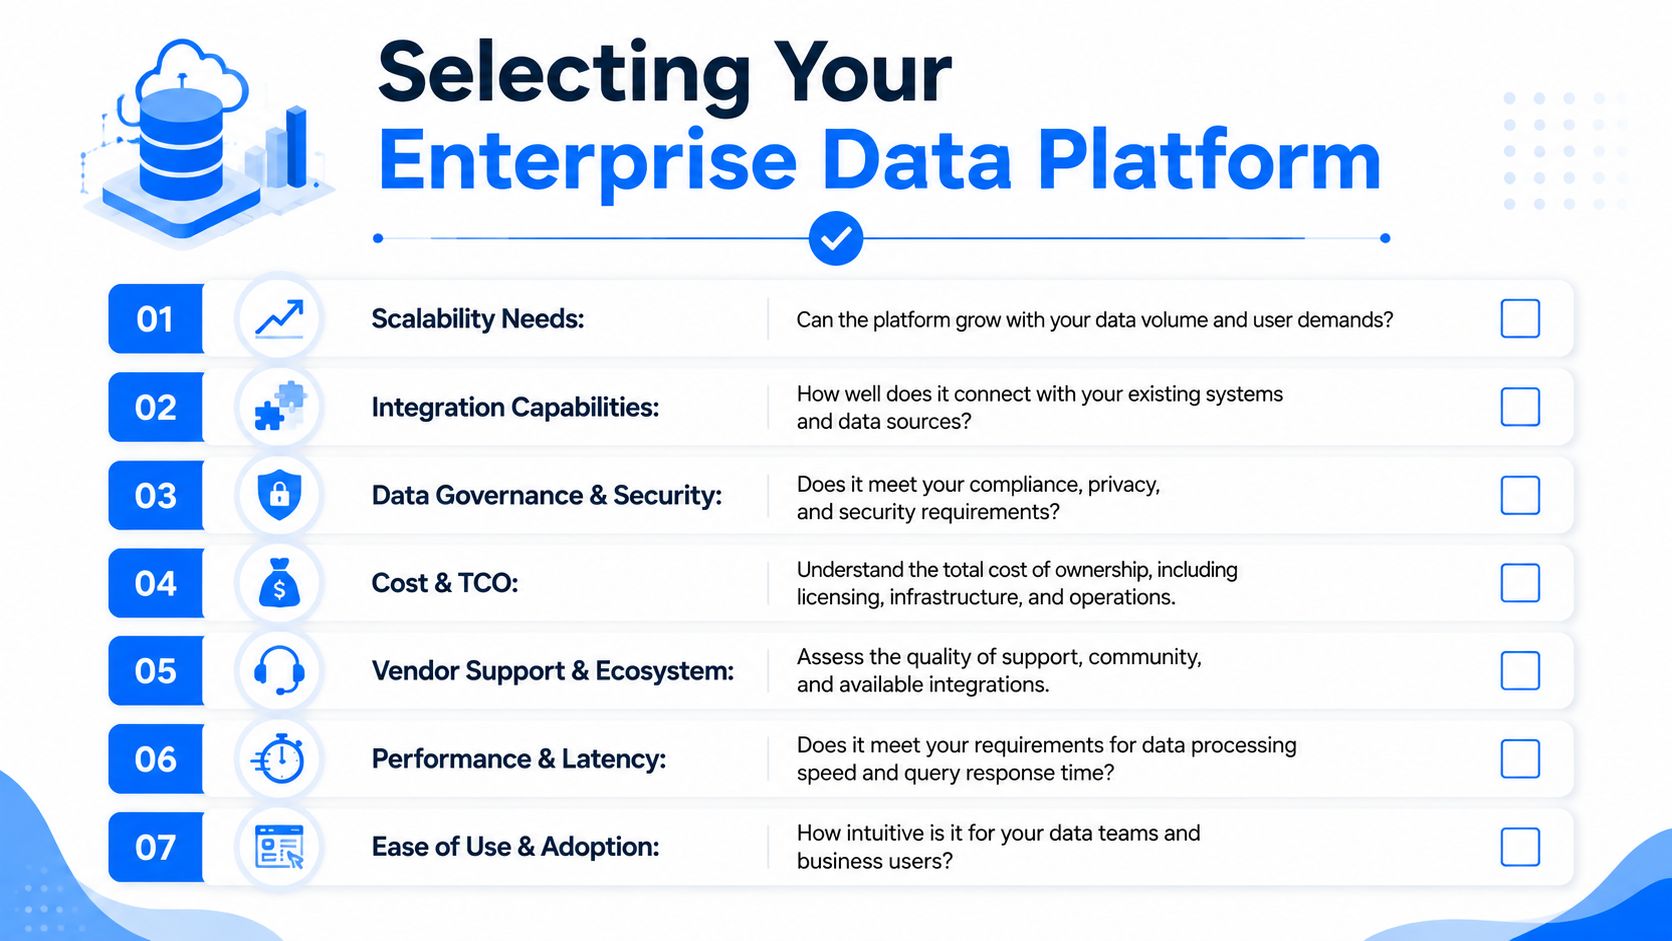
Acquistare una enterprise data platform riguarda meno l'elenco delle funzionalità e più ciò che la piattaforma costringe il vostro team a gestire. Alcuni strumenti sembrano completi in una demo perché nascondono il lavoro operativo dietro schermate curate. Le domande difficili riguardano i confini di integrazione, il comportamento della governance e il modo in cui il sistema gestisce i guasti.
Le domande che rivelano la realtà della piattaforma
Ponete a fornitori e stakeholder interni domande che rendano concreta l'architettura.
Dove avviene l'elaborazione
Se controlli, trasformazioni o profiling richiedono uno spostamento eccessivo di dati, costi e rischi per la privacy aumentano rapidamente.Come si comporta la piattaforma negli ambienti ibridi
Conta più di quanto molti acquirenti si aspettino. Secondo Forbes su AI e open source nelle enterprise data platform, una sfida chiave è la governance decentralizzata dei dati negli ambienti ibridi, e si prevede che il mercato raddoppi fino a 243,5 miliardi di dollari entro il 2032. La stessa analisi sostiene che le aziende hanno bisogno di modi per monitorare la tempestività e applicare le policy su sistemi private cloud e on-premises senza accesso ai dati da parte dei fornitori.È in grado di monitorare i tempi di consegna previsti, non solo il completamento dei job
Una pipeline può andare a buon fine e arrivare comunque troppo tardi per prendere decisioni.
Prima della scelta finale, è utile vedere in azione una prospettiva di implementazione più ampia:
Come si presenta la governance al di fuori dello scenario ideale
Chiedete come la piattaforma gestisce lacune nella lineage, eccezioni alle policy e controversie di ownership tra domini.Quanta manutenzione manuale delle regole è necessaria
Se la risposta è “i vostri analisti definiscono tutto a mano”, aspettatevi un freno operativo.
Una breve checklist per l'acquirente aiuta a distinguere le piattaforme utili da costosi assemblaggi di strumenti parziali:
Integrazione reale: si collega senza problemi al vostro warehouse, al lake, al livello di orchestrazione e al modello di identità?
Visibilità operativa: i team di engineering e di business possono vedere freschezza, drift e modifiche dello schema in un unico posto?
Postura sulla privacy: la piattaforma può operare in ambienti controllati dal cliente, se necessario?
Percorso di scalabilità: l'architettura funzionerà ancora dopo una forte crescita dei volumi e l'espansione dei domini?
Errori di acquisto comuni
L'errore più comune è acquistare pensando solo all'architettura attuale. Le aziende raramente restano su un solo pattern di storage, un solo cloud o un solo modello di governance. La piattaforma deve sopravvivere a fusioni, requisiti di compliance regionali e cambiamenti nella struttura dei team.
Un altro errore è sottovalutare il costo di strumenti frammentati. Un prodotto per l'ingestion, uno per la qualità, uno per il monitoraggio, uno per la lineage e uno per la governance possono funzionare. Ma solo se il team ha la disciplina necessaria per mantenere coerenti ownership e gestione degli incidenti. Molti non ce l'hanno.
Punto chiave: non chiedetevi se una piattaforma è in grado di acquisire e interrogare dati. Chiedetevi se il vostro team potrà fidarsi dei dati e governarli sei mesi dopo il rollout iniziale.
La enterprise data platform giusta è quella che si adatta ai vostri vincoli operativi, non quella con la pagina prodotto più lunga.
Costruire una base dati a prova di futuro
Una enterprise data platform solida non si limita a centralizzare i dati. Crea un ambiente controllato in cui ci si può fidare dei dati anche sotto pressione. Ciò significa che contano le scelte architetturali, contano le scelte di deployment e conta l'ownership della piattaforma. Ma i sistemi che reggono nel tempo condividono tutti una caratteristica: trattano data quality e observability come controlli integrati, non come extra opzionali.
Questo cambiamento trasforma il modo di lavorare dei team. I dati smettono di essere una fonte ricorrente di discussione e diventano un asset utilizzabile per reporting, operations e AI. Anche la privacy diventa più facile da gestire quando l'analisi resta in ambienti controllati dal cliente e la governance non è separata dall'esecuzione.
La piattaforma a prova di futuro non è la più complessa. È quella in grado di scalare, adattarsi alla realtà ibrida, proteggere i dati sensibili e far emergere i problemi prima che danneggino la fiducia. È la base di cui le aziende hanno bisogno se vogliono che sistemi AI, dashboard e decisioni operative si basino su dati affidabili.
Se state ripensando il modo in cui qualità e observability si inseriscono nella vostra enterprise data platform, vale la pena valutare digna. Si concentra su rilevamento delle anomalie, validazione dei record, monitoraggio della tempestività e tracciamento dello schema all'interno di ambienti controllati dal cliente, il che la rende rilevante per i team che hanno bisogno di una maggiore affidabilità dei dati senza consegnare i dati di produzione a un fornitore.
Se state progettando il livello di qualità e observability della vostra piattaforma, scoprite come la data platform observability con digna monitora freschezza, modifiche dello schema e anomalie all'interno del vostro ambiente.
Domande frequenti
Che cos'è una enterprise data platform?
Una enterprise data platform non è un singolo prodotto, ma l'architettura operativa che consente a un'organizzazione di acquisire, archiviare, trasformare, governare, monitorare e distribuire dati attraverso molti sistemi senza perdere fiducia nel loro significato. L'articolo la paragona a un sistema nervoso centrale per i dati aziendali, che abbraccia BI, operations e carichi di lavoro di AI.
Quali sono i componenti fondamentali di una enterprise data platform?
L'articolo individua cinque livelli: ingestion, storage, elaborazione e trasformazione, governance e sicurezza, qualità e observability. Quando un livello è debole, gli altri iniziano a compensare. Il quinto livello, che comprende validazione, tracciamento dello schema e observability, è quello che la maggior parte dei team aggiunge troppo tardi, di solito dopo il primo incidente.
Data warehouse, data lake, lakehouse o data mesh: quale architettura scegliere?
Scegliete il pattern che corrisponde alla struttura del team, al modello di governance e ai requisiti di latenza. I warehouse sono adatti al reporting standardizzato ma sono rigidi, i lake offrono flessibilità con scarsa affidabilità, i lakehouse bilanciano analytics e AI a costo di una maggiore complessità degli strumenti, e il data mesh è un modello organizzativo che rischia di frammentare la governance.
Una enterprise data platform dovrebbe essere on-premises, in cloud o ibrida?
Questa decisione riguarda di solito controllo, privacy e onere operativo più che i costi. L'on-premises è adatto a confini rigorosi sui dati in finanza, sanità e settore pubblico, il public cloud a una domanda elastica e a un provisioning rapido, l'ibrido ad ambienti normativi misti. On-premises e private cloud detengono ancora il 55% dei ricavi.
Perché la data observability è essenziale in una enterprise data platform?
I guasti dei dati sono spesso silenziosi: un job va a buon fine ma carica record incompleti, oppure un file in ritardo arriva dopo l'aggiornamento dei report. Secondo l'articolo, l'observability dovrebbe coprire ritardi di tempestività, modifiche dello schema, anomalie comportamentali e violazioni delle regole di business, e l'87% delle aziende considera la data observability essenziale per l'AI.


