Gestione degli asset di dati: una guida pratica per il 2026
|
7
min di lettura

Ieri la vostra dashboard direzionale sembrava a posto. Stamattina il fatturato per regione non torna, un KPI chiave è vuoto e nessuno sa dire con certezza se il problema derivi da una modifica dello schema, da una pipeline in ritardo o da una regola di business che non corrisponde più al sistema sorgente. I dati esistono ancora, ma non sono più affidabili.
È questo il momento in cui spesso le organizzazioni si rendono conto di non aver gestito i dati come un asset. Li hanno archiviati, spostati, trasformati e consumati. Ma non li hanno governati come qualcosa che ha proprietari, dipendenze, standard operativi e modalità di guasto. Nelle piattaforme moderne, la gestione degli asset di dati (data asset management) è ciò che trasforma dataset, metriche, feature e pipeline da sottoprodotti tecnici in infrastruttura di business gestita.
Indice
Oltre la cartella dei media: perché serve la gestione degli asset di dati
I pilastri della data governance moderna e del ciclo di vita
La vostra checklist per implementare la gestione degli asset di dati
Oltre la cartella dei media: perché serve la gestione degli asset di dati
Buona parte della confusione nasce dall'acronimo. Chiedete a cinque persone che cosa sia l'asset management e almeno alcune penseranno a loghi, video di campagne, immagini di prodotto o file del brand conservati in una piattaforma di digital asset management. È una disciplina reale, ma non è lo stesso problema della gestione di tabelle analitiche, logiche di trasformazione, layer di metriche, set di feature o input di ML.
La distinzione è importante perché i rischi operativi sono diversi. Un'immagine mancante può ritardare una campagna. Una modifica silenziosa del tipo di una colonna può corrompere un report finanziario, rompere un modello a valle o portare numeri sbagliati in una presentazione al consiglio di amministrazione senza provocare un errore evidente.
Per questo i team dati devono smettere di prendere in prestito la definizione centrata sui media e adottarne una più precisa. Un asset di dati non è solo un file o una tabella. È qualsiasi oggetto di dati che guida decisioni, automazione, compliance o comportamenti rivolti ai clienti, insieme ai metadati, alla lineage, ai controlli e alle aspettative necessari per potersene fidare.
Un modo utile per vedere il divario arriva dal mercato adiacente del DAM. Un report 2025 di Mordor Intelligence sul mercato del Digital Asset Management afferma che il 66,26% della spesa DAM va al tagging basato su AI e ai workflow per i media, che non fanno nulla per rilevare il drift silenzioso negli input di ML o le metriche di business compromesse. È questo il disallineamento di fondo. Il DAM per i media è ottimizzato per la reperibilità e il riutilizzo dei contenuti. La gestione degli asset di dati deve occuparsi di freschezza, stabilità dello schema, correttezza delle trasformazioni, policy di accesso e raggio d'impatto a valle.
Regola pratica: se una piattaforma sa dirvi chi ha scaricato l'ultima immagine del brand ma non quali dashboard dipendono da una colonna rinominata, non sta risolvendo la gestione degli asset di dati.
Ecco perché cartelle condivise, wiki e cataloghi statici falliscono così spesso in produzione. Documentano un'istantanea della realtà. Le piattaforme dati cambiano di continuo. Compaiono nuove colonne. Le join cambiano. Le schedulazioni slittano. Produttori e consumatori si allontanano. Senza un monitoraggio attivo, la documentazione diventa narrativa storica.
I team che gestiscono bene i dati li trattano come infrastruttura. Danno per scontato che il cambiamento sia costante, che la fiducia vada guadagnata e che la visibilità debba essere continua.
Che cos'è davvero la gestione degli asset di dati
La gestione degli asset di dati è la disciplina che rende i dati critici per il business utilizzabili, affidabili, controllati e durevoli lungo l'intero ciclo di vita. Comprende tabelle di ingestione grezze, modelli curati, metriche, dashboard, feature di ML, regole di validazione, metadati di ownership e le pipeline che li collegano.
L'analogia più semplice è quella di una città. Una città non funziona perché qualcuno ha disegnato una mappa. Funziona perché le strade vengono manutenute, la qualità dell'acqua è monitorata, il flusso di energia è controllato, l'accesso è regolamentato e gli incidenti vengono rilevati prima che si propaghino. La vostra piattaforma dati funziona allo stesso modo.
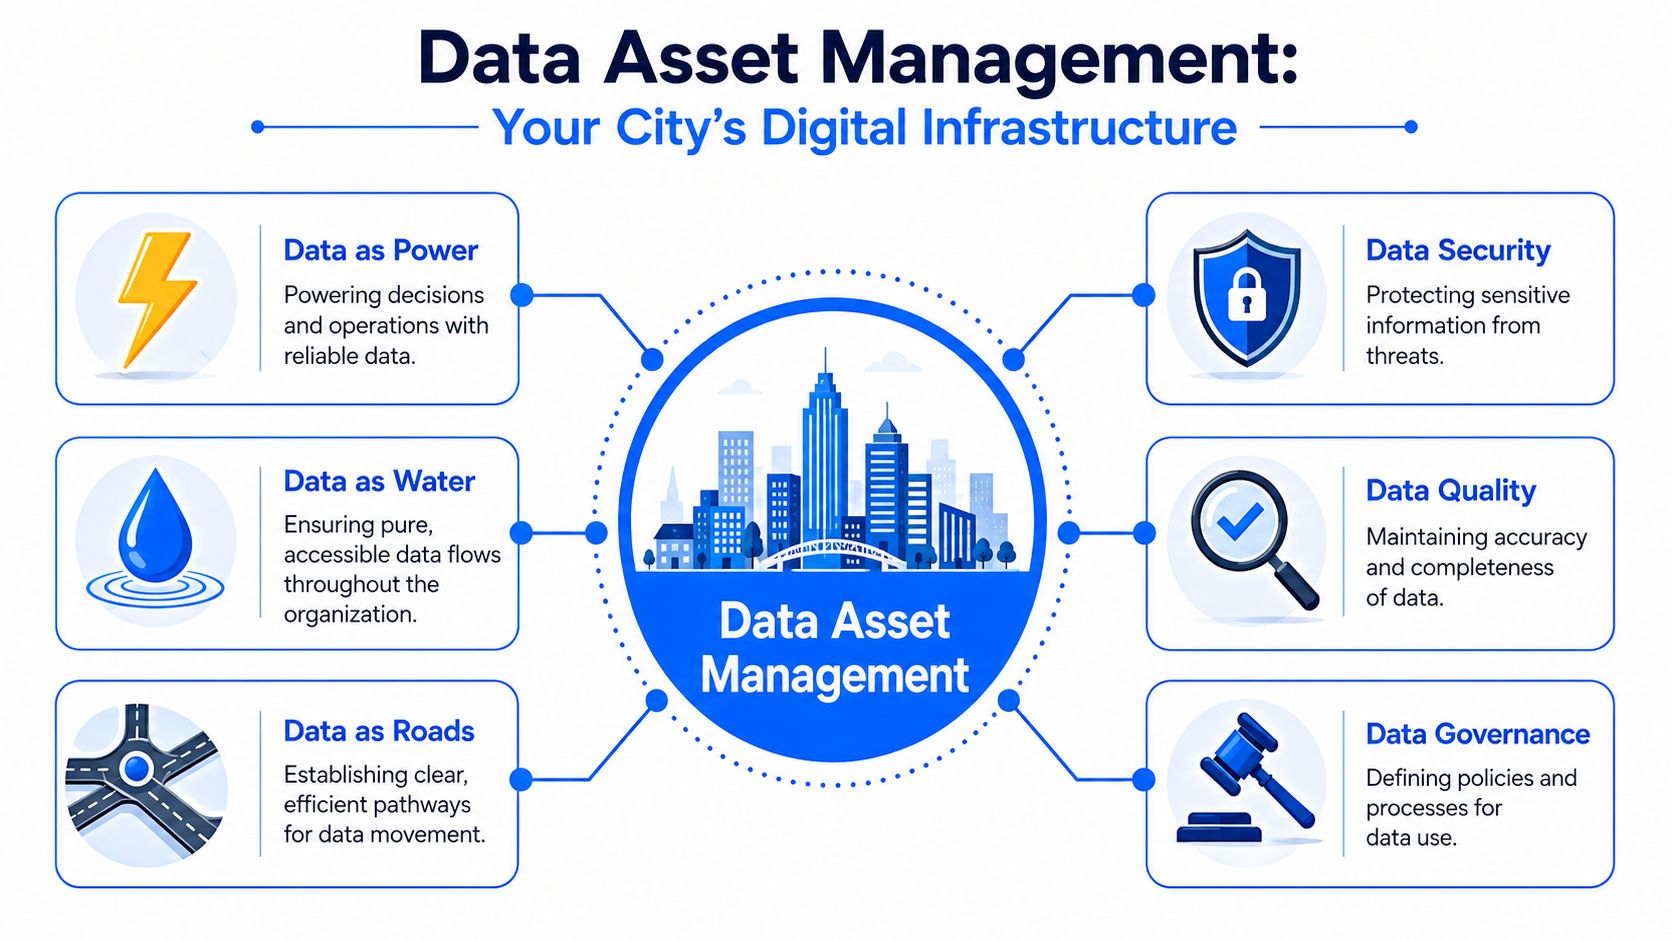
Un catalogo è solo la mappa stradale
Un data catalog è importante, ma è solo uno strato. Se tutto ciò che avete è un inventario di tabelle e descrizioni, non avete costruito una gestione. Avete costruito materiale di consultazione.
Gestire davvero significa porre domande operative e ottenere risposte affidabili:
Ownership: chi approva l'accesso, definisce l'uso consentito e dà il via libera alle modifiche che rompono la compatibilità?
Qualità: quali condizioni rendono questo asset idoneo all'uso?
Lineage: quali report, modelli e job a valle dipendono da esso?
Ciclo di vita: quando viene creato, modificato, deprecato, archiviato o dismesso?
Sicurezza: quali utenti possono visualizzarlo, modificarlo, esportarlo o metterlo in join con altri asset?
Se il vostro team tratta ancora i metadati come un lavoro amministrativo facoltativo, è utile rivedere che cosa sia un data catalog nella pratica. Il catalogo è la base della reperibilità. Da solo non è il modello operativo.
I segnali di mercato sono chiari anche se la terminologia è confusa. In un campo affine, il mercato globale del Digital Asset Management è stato valutato 4,22 miliardi di USD nel 2023 e si prevede che raggiunga 11,94 miliardi di USD entro il 2030, mentre l'Europa rappresenta il 28% di quel mercato secondo l'analisi del mercato DAM di Grand View Research. Le aziende stanno investendo molto nel controllo centralizzato degli asset. I team dati devono applicare la stessa serietà agli asset analitici, non solo alle librerie multimediali.
Che cosa rientra nel perimetro dell'asset
Uno degli errori più grandi che vedo è definire l'asset in modo troppo ristretto. I team registrano le tabelle, ma ignorano la logica e i contratti che le circondano. Questo crea una falsa sicurezza.
Una definizione matura di asset di solito include:
L'oggetto in sé. Una tabella, una vista, una metrica, un set di feature, uno stream di eventi o un report.
Il suo significato di business. Definizioni, casi d'uso approvati e limiti noti.
Il suo comportamento tecnico. Schema, modalità di aggiornamento, dipendenze e lineage.
Il suo piano di controllo. Owner, regole di accesso, controlli di qualità e procedure di modifica.
Questo conta ancora di più in ambienti operativi multilingue o distribuiti, dove la qualità dei metadati e la coerenza dei workflow incidono sull'adozione. Per i team che gestiscono sistemi trasversali e passaggi di consegne nella governance, questa guida completa per sviluppatori sui TMS offre un parallelo utile, perché mostra come il controllo strutturato dei workflow diventi essenziale quando più team e contesti toccano gli stessi asset informativi.
Un asset di dati affidabile è un asset che sa sopravvivere al cambiamento senza sorprendere chi lo consuma.
Questa è la soglia. Se un utente di business, un analista o un ML engineer può usare un dataset in sicurezza perché contesto, controlli e dipendenze a valle sono visibili, allora l'asset è gestito. Se si affidano al sapere tribale e ai messaggi su Slack, non lo è.
I pilastri della data governance moderna e del ciclo di vita
La maggior parte dei programmi di governance fallisce perché punta troppo sulle policy e troppo poco sulle operations. Si scrivono standard, si pubblicano matrici di stewardship e si lancia un catalogo. Poi la prima modifica dello schema a monte arriva il venerdì sera e il lunedì metà delle dashboard sono sbagliate.
La governance funziona solo quando è integrata nel comportamento a runtime della piattaforma.
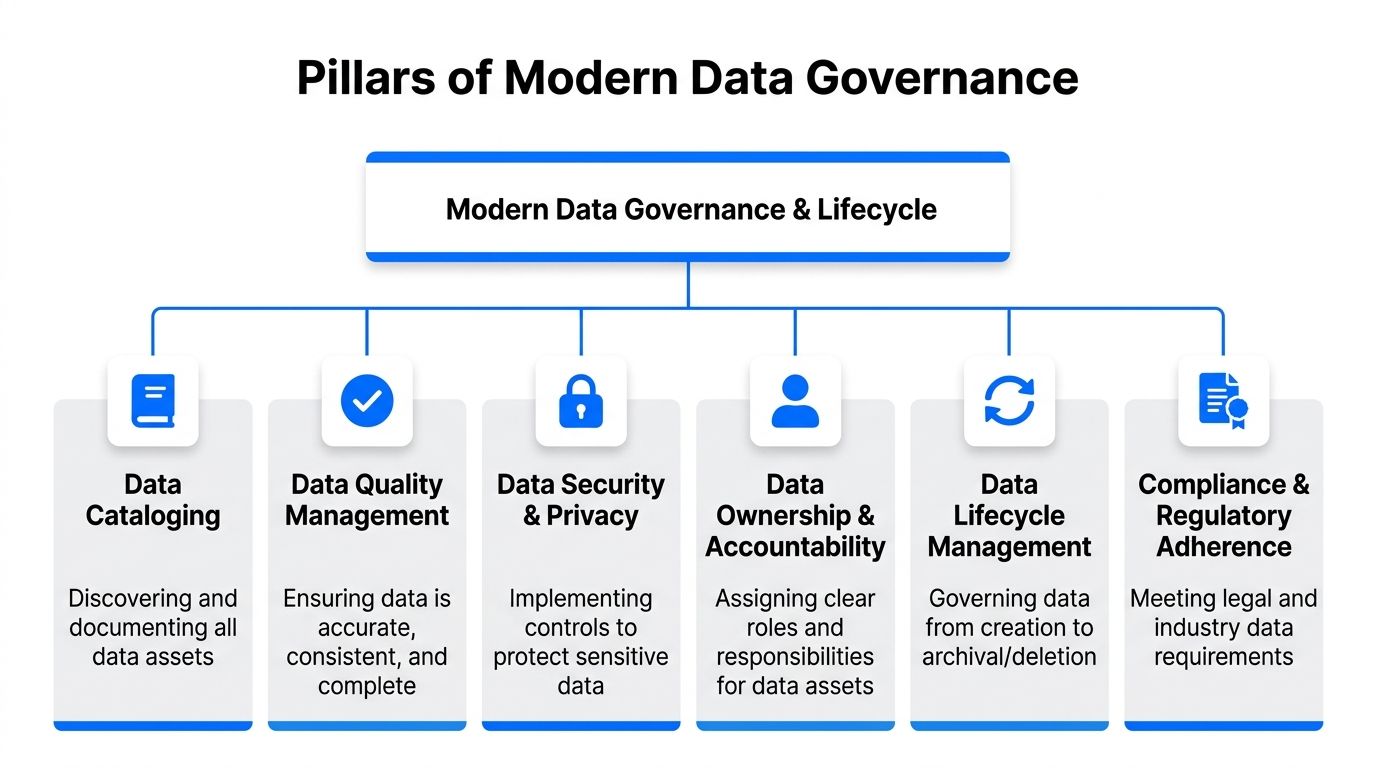
La ownership deve essere esplicita
Ogni asset critico ha bisogno di qualcuno che risponda della sua idoneità per il business e di qualcuno responsabile della sua manutenzione operativa. Quando questa divisione è sfumata, gli incidenti si bloccano. Gli ingegneri aspettano chiarimenti semantici. Gli analisti aspettano correzioni alle pipeline. Nessuno vuole approvare gli accessi o dismettere logiche obsolete.
Una ownership chiara di solito significa:
Accountability di business: un data owner decide che cosa significa l'asset, chi dovrebbe usarlo e che cosa si intende per qualità accettabile.
Stewardship operativa: uno steward o una funzione di piattaforma mantiene aggiornati definizioni, lineage, controlli e allineamento alle policy.
Esecuzione tecnica: gli ingegneri costruiscono, modificano, testano e monitorano il percorso dei dati.
Senza questa separazione, le organizzazioni confondono la creazione dei dati con la responsabilità sui dati. Non sono la stessa cosa.
La qualità senza lineage crolla in fretta
I controlli di qualità vengono spesso implementati come test isolati. Controlli sui null qui, conteggi delle righe là, magari un alert di freschezza nell'orchestrazione. È utile, ma non risponde alla domanda difficile: se qualcosa cambia a monte, chi ne subisce le conseguenze a valle?
La lineage automatizzata passa da optional a requisito obbligatorio. Secondo la guida di OvalEdge al software enterprise per la gestione degli asset di dati, le piattaforme con lineage automatizzata end-to-end e analisi d'impatto ottengono un'applicazione della governance più rapida del 40-60% rispetto agli approcci di catalogazione manuale, perché possono prevedere quali asset saranno colpiti dalle modifiche a monte prima che si verifichino i guasti. Questa velocità conta perché la governance non è solo applicazione delle policy. È prevenzione degli incidenti.
Se la lineage è manuale, sarà incompleta. Se è incompleta, l'analisi d'impatto fallirà proprio quando ne avete più bisogno.
La lineage cambia anche il modello operativo. Invece di scoprire i guasti da un reclamo su una dashboard, i team possono esaminare report, metriche e modelli interessati prima di promuovere una modifica. Questo sposta la governance dalla pulizia reattiva alla gestione controllata del cambiamento.
Sul fronte della resilienza, i team hanno bisogno anche di una protezione operativa per l'intero patrimonio di dati. Questa guida sulla protezione essenziale dei dati per le aziende è un utile complemento, perché pianificazione del ripristino e governance falliscono insieme quando le organizzazioni le trattano come questioni separate.
La gestione del ciclo di vita è operativa, non cerimoniale
Gli asset invecchiano. Le definizioni derivano. Le pipeline vengono sostituite. I requisiti normativi cambiano. Una metrica un tempo critica per il business diventa legacy ma continua ad alimentare la logica a valle perché nessuno l'ha formalmente dismessa.
Per questo la gestione del ciclo di vita ha bisogno di eventi concreti, non di etichette di stato generiche:
Fase del ciclo di vita | Come si presenta una buona gestione |
|---|---|
Creazione | Naming, ownership, policy di accesso e aspettative di qualità vengono definiti prima di un'adozione su larga scala |
Uso attivo | Monitoraggio, lineage, validazione e triage dei problemi sono operativi |
Modifica | Le modifiche, con o senza rottura della compatibilità, vengono riviste con l'impatto a valle visibile |
Deprecazione | I consumatori vengono avvisati e i percorsi di migrazione sono documentati |
Dismissione | L'accesso viene rimosso, i riferimenti vengono ripuliti e l'asset smette di generare dipendenze nascoste |
I team ottengono il massimo valore quando combinano questi pilastri invece di trattarli come filoni di lavoro separati. La ownership vi dice chi decide. La qualità vi dice se l'asset è idoneo all'uso. La lineage vi dice cos'altro si romperà. Il ciclo di vita vi dice quando e come deve avvenire il cambiamento.
Mappare ruoli e responsabilità sugli asset di dati
Il modo più rapido per indebolire un programma di gestione degli asset di dati è rendere la responsabilità collettiva. La responsabilità collettiva sembra collaborativa, ma in pratica significa che le richieste di accesso restano senza risposta, le regole di qualità dei dati non vengono mai approvate e le review degli incidenti si chiudono con "il team" come owner delle azioni da svolgere.
Un programma che funziona ha bisogno di ruoli nominativi con diritti decisionali diversi.
Una matrice RACI pratica per le piattaforme dati
La matrice qui sotto è volutamente semplice. Spesso non servono più ruoli, ma ruoli più chiari.
Per i team che stanno formalizzando l'accountability vale la pena rivedere le responsabilità del data owner in contesti enterprise, soprattutto quando la ownership è stata informale o ereditata dal controllo tecnico anziché dalla responsabilità di business.
Attività | Data Owner | Data Steward | Data Engineer | Data Consumer |
|---|---|---|---|---|
Definire il significato di business di un dataset critico | A | R | C | I |
Approvare la policy di accesso e l'uso previsto | A | R | C | I |
Mantenere l'allineamento tra metadati e business glossary | C | A/R | I | I |
Costruire e gestire le pipeline di ingestione e trasformazione | I | C | A/R | I |
Definire i controlli di qualità tecnici | C | R | A | I |
Definire le validazioni delle regole di business | A | R | C | I |
Esaminare le modifiche dello schema a monte | C | R | A | I |
Valutare l'impatto a valle su dashboard e modelli | A | R | C | C |
Gestire il triage degli incidenti che incidono su fiducia o disponibilità | A | R | R | I |
Consumare i dati e segnalare i difetti | I | I | I | R |
Alcuni pattern di solito funzionano meglio di quanto suggerisca l'organigramma:
I data owner dovrebbero essere vicini ai risultati di business. L'owner di una metrica finanziaria dovrebbe stare nella direzione finanziaria o nelle operations di dominio, non solo nel team di piattaforma.
Gli steward dovrebbero mantenere il significato e il contesto dei controlli. Sono il tessuto connettivo tra l'intento semantico e l'applicazione a runtime.
Gli ingegneri dovrebbero essere owner dell'implementazione, non della verità di business. Possono codificare le regole, ma non dovrebbero essere costretti a inventarle.
I consumatori dovrebbero avere un canale di feedback. Se analisti e team ML non possono segnalare rapidamente gli asset sospetti, i dati errati sopravvivono troppo a lungo.
Dove gli strumenti aiutano e dove no
Gli strumenti non possono creare accountability, ma possono renderla eseguibile. I sistemi con metadati, ricerca e permessi solidi riducono la quantità di coordinamento manuale necessaria per far funzionare i ruoli.
Secondo la panoramica di Aprimo sulle funzionalità del digital asset management enterprise, i sistemi di livello enterprise con ricerca basata su AI, governance approfondita dei metadati e controllo degli accessi basato sui ruoli possono ridurre del 30-50% l'onere degli specialisti per il monitoraggio di routine e ottenere un'efficienza operativa superiore del 35%. La lezione di fondo si applica bene ai dati analitici. Se l'assegnazione dei ruoli vive ancora nei fogli di calcolo e la gestione delle eccezioni avviene ancora nei thread di chat, il vostro modello di governance non scalerà.
Che cosa fanno bene gli strumenti:
Applicano i confini di accesso per team, funzione o area geografica.
Rendono visibili i metadati di ownership nel punto di utilizzo.
Instradano le attività di review quando cambiano schemi, validazioni o diritti d'uso.
Espongono ricerca e contesto in modo che i consumatori non abbiano bisogno di uno steward per ogni consultazione.
Che cosa gli strumenti non risolveranno:
Una ownership di dominio debole.
Regole di business non definite.
Conflitti tra team di piattaforma e applicazioni che producono dati.
La riluttanza della leadership a dismettere asset compromessi.
Un buon strumento di governance elimina l'attrito dalle decisioni giuste. Non prende le decisioni al posto vostro.
Pattern di implementazione concreti e metriche
La maggior parte dei programmi falliti cerca di catalogare tutto, definire ogni owner e standardizzare ogni data product in un colpo solo. Questo approccio brucia tempo, sommerge i team di attività di pulizia a basso valore e ritarda l'unica cosa che crea consenso: un miglioramento visibile sugli asset critici.
Partite in modo più mirato.
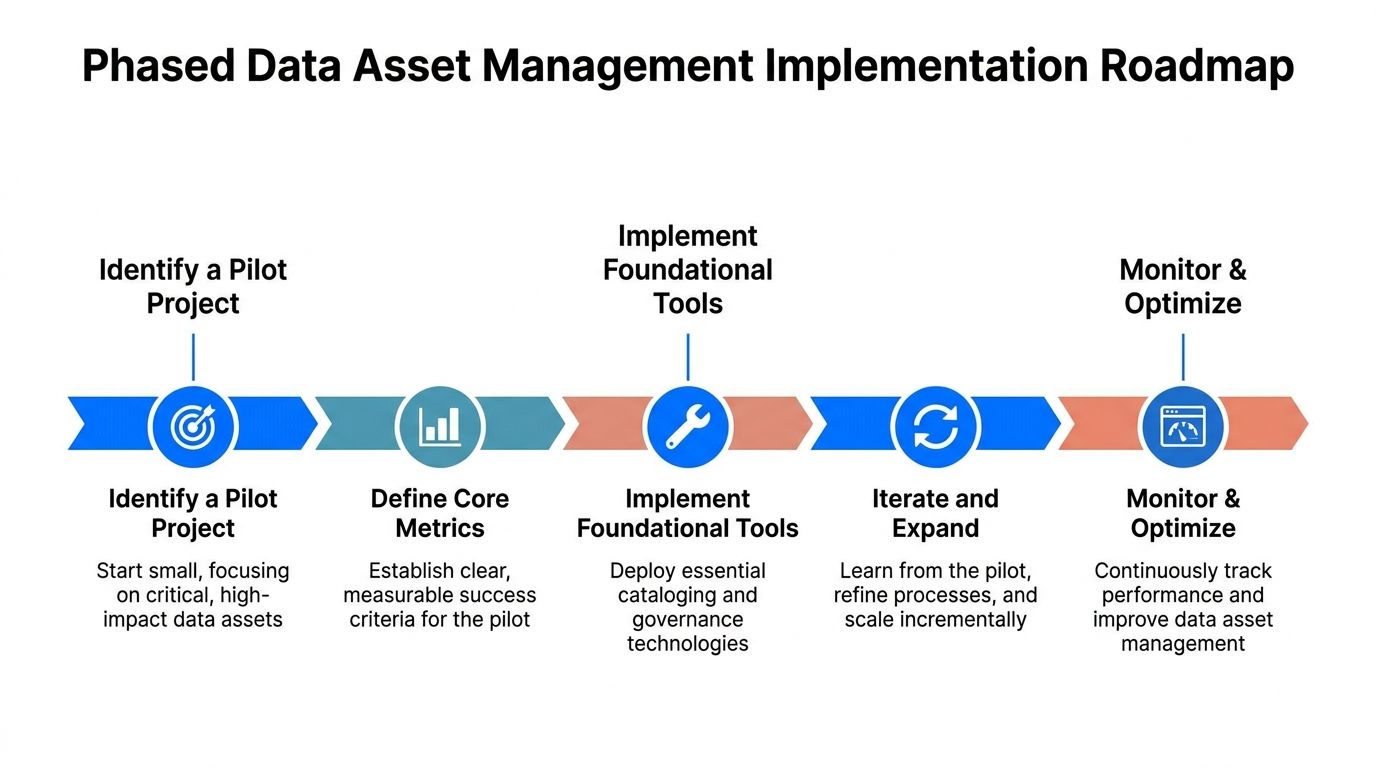
Partire da una superficie di controllo ridotta
Scegliete un insieme pilota di asset con tre caratteristiche: sono critici per il business, consumati di frequente e strutturalmente collegati a più usi a valle. In pratica possono essere fatti di fatturato, anagrafiche clienti, logiche di idoneità, eventi relativi ai sinistri, stato degli ordini o le tabelle di feature che supportano un modello in produzione.
Di solito un rollout per fasi funziona meglio:
Avviate un pilota su un dominio. Scegliete un dominio in cui i guasti sono dolorosi e visibili.
Documentate il comportamento atteso. Definite le aspettative di aggiornamento, le ipotesi sullo schema, il comportamento accettabile dei null e i vincoli delle regole di business.
Aggiungete il monitoraggio a runtime. Tenete d'occhio tempestività, modifiche dello schema, anomalie e fallimenti di validazione.
Collegate ownership ed escalation. Ogni alert ha bisogno di una persona e di un percorso di risposta.
Espandete solo dopo una review. Scalate il pattern, non il caos.
Il miglior risultato iniziale non è la "copertura completa della governance". È ridurre l'incertezza su una manciata di asset su cui dirigenti, operatori o sistemi rivolti ai clienti fanno affidamento ogni giorno.
Metriche che mostrano se il programma funziona
Non servono decine di metriche. Ne servono alcune che rivelino se fiducia, reattività e copertura stanno migliorando. Un buon punto di partenza comprende:
Data downtime: il tempo durante il quale un asset non è disponibile o non è affidabile per l'uso previsto.
Tempo medio di rilevamento: quanto tempo serve per individuare un problema di freschezza, di schema o di qualità.
Tempo medio di risoluzione: quanto tempo serve per ripristinare fiducia e servizio.
Copertura degli asset critici: la quota di asset prioritari con ownership, lineage, monitoraggio e validazione attivi.
Visibilità dell'impatto delle modifiche: se le modifiche a monte possono essere valutate prima del deployment.
Per i team che costruiscono una scorecard, queste metriche di qualità dei dati usate nella pratica sono un buon riferimento, perché mantengono la discussione sulla misurazione legata ai risultati operativi anziché a conteggi di vanità.
Alcuni anti-pattern vanno evitati:
Anti-pattern | Che cosa succede invece |
|---|---|
Catalogare tutto prima di ogni altra cosa | I team passano mesi a descrivere asset che nessuno usa |
Definire regole di qualità generiche | Gli alert scattano, ma non corrispondono a un rischio di business |
Misurare il volume degli alert | Il rumore aumenta, la fiducia nel monitoraggio diminuisce |
Considerare le dashboard come il perimetro dell'asset | Le cause profonde a monte restano invisibili |
Introdurre la ownership senza percorsi di escalation | Gli incidenti continuano a rimbalzare tra i team |
Pattern che reggono in produzione
I dettagli di implementazione variano a seconda dello stack, ma alcuni pattern si dimostrano costantemente efficaci.
Usate i data contract per i confini tra produttori e consumatori. Anche contratti leggeri aiutano i team ad accordarsi su schema, freschezza e aspettative semantiche prima che i danni a valle si manifestino.
Separate i controlli a livello di piattaforma dalle regole specifiche del dominio. Il monitoraggio di freschezza e schema può essere standardizzato. La validità di business spesso no.
Date priorità alla validazione a livello di record quando sono coinvolti compliance o finanza. I controlli aggregati non intercettano ogni difetto dannoso.
Trattate le modifiche dello schema come eventi di governance. Nuove colonne, campi rimossi e cambi di tipo richiedono una review, non solo un deployment tecnico.
Coinvolgete fin dall'inizio i consumatori BI e ML. Se progettate solo per ingestione e trasformazione, vi sfuggiranno i veri cedimenti della fiducia.
Un'ultima osservazione pratica. Non aspettate metadati perfetti prima di attivare l'osservabilità. Negli ambienti maturi, i metadati rafforzano il monitoraggio. Negli ambienti disordinati, il monitoraggio aiuta a ripulire i metadati perché mette in evidenza quali asset sono più critici.
Integrare l'osservabilità in ambienti sicuri
Alcuni dei problemi più difficili nella gestione degli asset di dati emergono nelle organizzazioni che non possono spostare liberamente i dati di produzione. I team di finanza, sanità, telecomunicazioni e settore pubblico operano spesso in private cloud o in ambienti on-prem dove residenza dei dati, controllo degli accessi e restrizioni sui fornitori sono obbligatori.
Questo cambia l'architettura. Non potete affidarvi a un modello in cui i dati grezzi vengono copiati verso un servizio esterno per essere ispezionati.
Perché i deployment sicuri cambiano l'architettura
Negli ambienti sicuri, l'osservabilità deve funzionare con uno spostamento minimo dei dati e confini di esecuzione rigorosi. È qui che molti pattern di monitoraggio generici iniziano a cedere. Presuppongono ampi diritti di estrazione, percorsi di rete generosi o copie centralizzate dei metadati operativi che i team regolamentati spesso non possono consentire.
È anche per questo che la data observability come disciplina operativa è diventata centrale in una gestione seria degli asset di dati. Un registro statico degli asset serve a poco se la piattaforma non riesce a rilevare quando la freschezza peggiora, quando arrivano modifiche dello schema o quando i pattern appresi smettono di valere.
L'osservabilità diventa il ciclo di controllo del patrimonio di asset:
Verifica che i dati arrivino quando previsto.
Rileva quando la struttura cambia senza coordinamento.
Fa emergere variazioni di comportamento che le regole statiche non colgono.
Aiuta i team a isolare il punto in cui la fiducia si è rotta per prima.
Che cosa fa davvero il rilevamento delle anomalie basato su AI
Nei sistemi dati di produzione, il rilevamento delle anomalie è utile perché non tutti i difetti si presentano come violazioni di una regola. Una distribuzione può subire un drift pur restando entro soglie grossolane. Una tabella può continuare a caricarsi secondo la schedulazione mentre il suo contenuto diventa semanticamente errato. Una dashboard può restare verde mentre il pattern sottostante è cambiato in un modo che il business non ha approvato.
È qui che i metodi basati su AI aiutano. La panoramica di Oracle sul rilevamento delle anomalie con AI spiega bene il cambiamento di fondo: invece di basarsi solo su regole statistiche statiche, il modello apprende dai dati il comportamento normale e diventa più preciso man mano che elabora volumi maggiori. In pratica, il sistema può cogliere variazioni non lineari o dipendenti dal contesto che i controlli scritti a mano spesso non vedono.
Contano anche altre tecniche. La spiegazione di MindBridge sul rilevamento delle anomalie basato su autoencoder descrive un meccanismo utile per dati transazionali complessi. Un punto viene segnalato quando il modello non riesce a ricostruirlo con precisione perché si discosta troppo dal pattern di addestramento. Questo è particolarmente rilevante nei dataset finanziari e operativi, dove un difetto non sempre rompe uno schema o viola una semplice soglia sui null.
Nelle data operations, i guasti pericolosi sono spesso quelli silenziosi. La pipeline gira, la tabella si aggiorna e il significato deriva comunque.
Il compromesso dell'elaborazione nel database è reale
Eseguire la logica di osservabilità all'interno del database del cliente è interessante perché mantiene i dati dove risiedono e riduce gli spostamenti. Solleva però anche una preoccupazione legittima: quanto costa quell'elaborazione in termini di prestazioni e di spesa per il warehouse?
Non è una preoccupazione ipotetica. Secondo l'analisi di Oliver Wyman sui trend dell'asset management per il 2025, il 68% dei data engineer indica lo spostamento dei dati come causa principale dei report non aggiornati, eppure mancano ancora dati pubblici sull'overhead prestazionale dell'apprendimento delle baseline basato su AI eseguito direttamente nei warehouse enterprise su scala 100TB+. È la questione ingegneristica ancora aperta su cui molti team di piattaforma stanno lavorando proprio ora.
La risposta giusta di solito non è "sempre nel database" né "sempre all'esterno". È l'esecuzione selettiva:
Calcolate le metriche leggere vicino ai dati quando l'estrazione è rischiosa o costosa.
Limitate baseline e rilevamento agli asset più importanti.
Evitate scansioni complete per ogni controllo quando una logica incrementale o basata sulle partizioni può fare il lavoro.
Separate i controlli strutturali dall'analisi pesante dei contenuti per non spendere il budget del warehouse nel rilevare eventi banali.
È questo il compromesso operativo che i team moderni devono valutare. La sicurezza migliora quando i dati restano sotto il controllo del cliente. La reattività migliora quando i segnali vengono calcolati vicino alla sorgente. Ma una progettazione superficiale dell'osservabilità può creare attriti di costo e di prestazioni. I team che fanno le cose per bene costruiscono l'osservabilità come parte della piattaforma, non come un ripensamento applicato a pipeline già fragili.
La vostra checklist per implementare la gestione degli asset di dati
I programmi di gestione degli asset di dati più solidi non nascono dal rollout di una singola piattaforma. Nascono da abitudini operative ripetute. I team individuano ciò che conta, assegnano le responsabilità, misurano la fiducia, reagiscono al drift e continuano a perfezionare la superficie di controllo man mano che la piattaforma cambia.
Per questo la checklist conta più della presentazione di lancio.
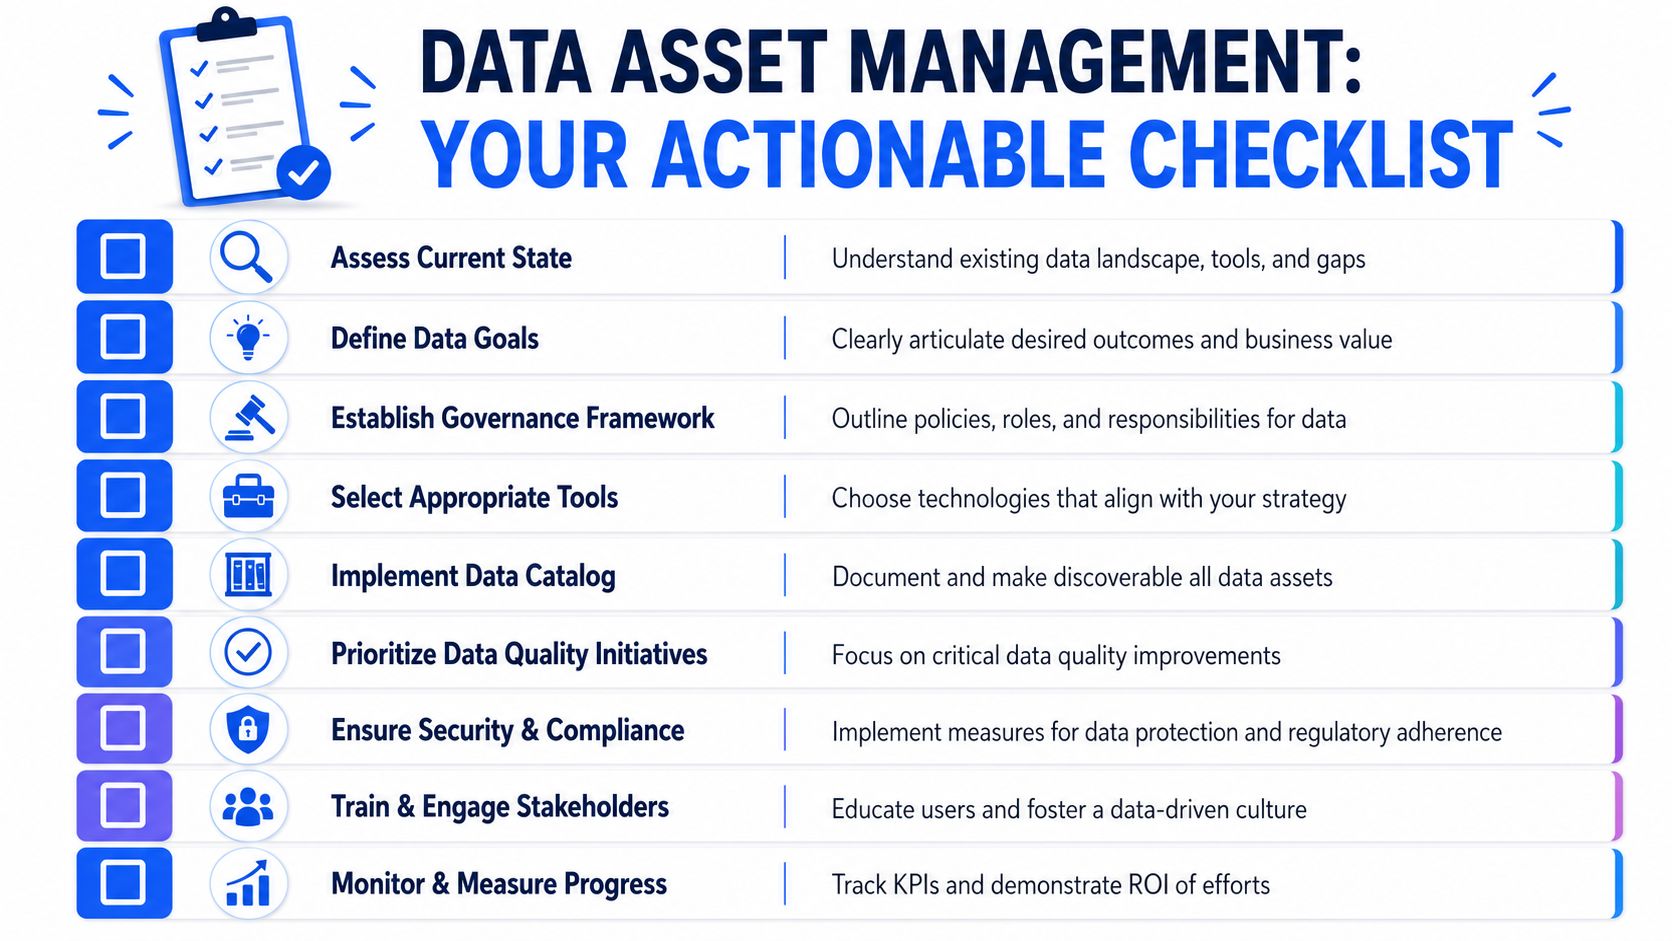
Che cosa fare per primo
Valutate lo stato attuale. Elencate gli asset di dati che già alimentano il reporting direzionale, i workflow regolamentati, le operations principali o i modelli in produzione. Non partite da tutto. Partite da ciò che farebbe male se si guastasse senza che nessuno se ne accorga.
Definite gli obiettivi sui dati. Decidete che cosa il programma deve proteggere. Una risposta più rapida agli incidenti, una migliore verificabilità, meno dashboard compromesse, input dei modelli più sicuri e una ownership più chiara sono obiettivi diversi e richiedono controlli diversi.
Stabilite un framework di governance. Assegnate data owner, steward e ingegneri per la prima ondata di asset critici. Se nessuno può approvare gli accessi, definire la validità o esaminare l'impatto delle modifiche, il resto del programma non attecchirà.
Selezionate gli strumenti adatti. Privilegiate piattaforme che supportano metadati, lineage, controllo degli accessi, monitoraggio e validazione senza imporre spostamenti di dati non necessari.
Che cosa istituzionalizzare in seguito
Una volta che i primi asset sono sotto gestione, il compito successivo è la coerenza.
Implementate un catalogo con contesto. Registrate gli asset insieme a lineage, aspettative di aggiornamento, definizioni approvate e avvertenze note.
Date priorità alle iniziative di qualità dei dati. Applicate la validazione a livello di record dove contano le regole di business e il rilevamento delle anomalie dove il drift silenzioso è più probabile di un guasto evidente.
Garantite sicurezza e compliance. Allineate permessi e flussi di review al profilo di rischio effettivo dell'asset, soprattutto negli ambienti controllati dal cliente.
Formate e coinvolgete gli stakeholder. Analisti, sviluppatori BI, ML engineer e business owner devono tutti sapere come interpretare gli alert, richiedere modifiche e segnalare problemi di affidabilità.
Monitorate e misurate i progressi. Rivedete con cadenza regolare la velocità di rilevamento, la gestione degli incidenti e la copertura degli asset critici.
Una breve checklist operativa aiuta a restare concreti:
Voce della checklist | Perché è importante |
|---|---|
Identificare prima gli asset critici | Evita una dispersione a basso valore |
Assegnare owner nominativi | Rende più rapide decisioni ed escalation |
Attivare il monitoraggio di schema, freschezza e qualità | Intercetta prima i guasti silenziosi |
Aggiungere la lineage alla review delle modifiche | Riduce le sorprese a valle |
Monitorare le metriche operative | Mostra se la fiducia sta migliorando |
Rivedere e dismettere gli asset obsoleti | Mantiene il patrimonio gestibile |
Il punto principale è semplice. La gestione degli asset di dati non è un progetto di documentazione. È un sistema di controllo continuo per i dataset, le metriche e le pipeline da cui dipende il business. I team che la trattano in questo modo procedono più velocemente perché passano meno tempo a discutere se ci si possa fidare dei dati.
Se il vostro team ha bisogno di questo tipo di controllo in private cloud o in ambienti on-prem, digna è costruita per questo. digna aiuta i team dati a rilevare anomalie, validare record, monitorare la tempestività e tracciare le modifiche dello schema all'interno di ambienti controllati dal cliente, così potete gestire i dati analitici come un asset di business attivo senza spostare i dati di produzione fuori dalla vostra infrastruttura.
Per rendere concreto il consiglio dell'articolo di trattare le modifiche dello schema come eventi di governance, digna Schema Tracker fa emergere le modifiche strutturali nelle tabelle monitorate, così gli owner possono esaminarle prima che le dashboard a valle si rompano.
Domande frequenti
Che cos'è la gestione degli asset di dati?
La gestione degli asset di dati è la disciplina che rende i dati critici per il business utilizzabili, affidabili, controllati e durevoli lungo l'intero ciclo di vita. Il suo ambito comprende tabelle di ingestione grezze, modelli curati, metriche, dashboard, feature di ML, regole di validazione, metadati di ownership e le pipeline che li collegano, non solo un inventario di tabelle in un catalogo.
In che cosa la gestione degli asset di dati differisce dal digital asset management?
Il digital asset management organizza contenuti multimediali come loghi, video e file del brand per favorirne la reperibilità e il riutilizzo. La gestione degli asset di dati si occupa di freschezza, stabilità dello schema, correttezza delle trasformazioni, policy di accesso e raggio d'impatto a valle. L'articolo cita che il 66,26% della spesa DAM va al tagging basato su AI per i media, che non è in grado di rilevare il drift silenzioso dei dati.
Chi dovrebbe essere owner di un asset di dati?
Ogni asset critico ha bisogno di un data owner nominativo che ne decida il significato di business, la policy di accesso e la qualità accettabile. Uno steward mantiene aggiornati definizioni, lineage e controlli, mentre gli ingegneri costruiscono, testano e monitorano il percorso dei dati. Nella matrice RACI dell'articolo, l'owner è responsabile della valutazione dell'impatto a valle su dashboard e modelli.
Quali metriche mostrano che un programma di gestione degli asset di dati funziona?
Basta un piccolo insieme di metriche operative: data downtime, tempo medio di rilevamento, tempo medio di risoluzione, copertura degli asset critici e visibilità dell'impatto delle modifiche. L'articolo mette in guardia dal misurare invece il volume degli alert, perché il rumore aumenta mentre la fiducia nel monitoraggio diminuisce.
Da dove dovrebbe partire un programma di gestione degli asset di dati?
Partite da un piccolo pilota su asset critici per il business e consumati di frequente, come i fatti di fatturato o le anagrafiche clienti. Avviate il pilota su un dominio, documentate il comportamento atteso, aggiungete il monitoraggio a runtime di tempestività, modifiche dello schema, anomalie e fallimenti di validazione, collegate ownership ed escalation ed espandete solo dopo una review.