Master data management dei prodotti: cos'è e perché è importante
|
8
min di lettura

Se il vostro catalogo prodotti appare diverso nell'ERP, nella piattaforma e-commerce e nel sistema di magazzino, ne conoscete già il costo. Prezzi sbagliati, SKU non corrispondenti e resi di cui nessuno riesce a risalire alla causa principale. Il master data management dei prodotti è la disciplina che risolve questo problema, assegnando a ogni prodotto un record unico e affidabile su cui ogni sistema e ogni team possono contare.
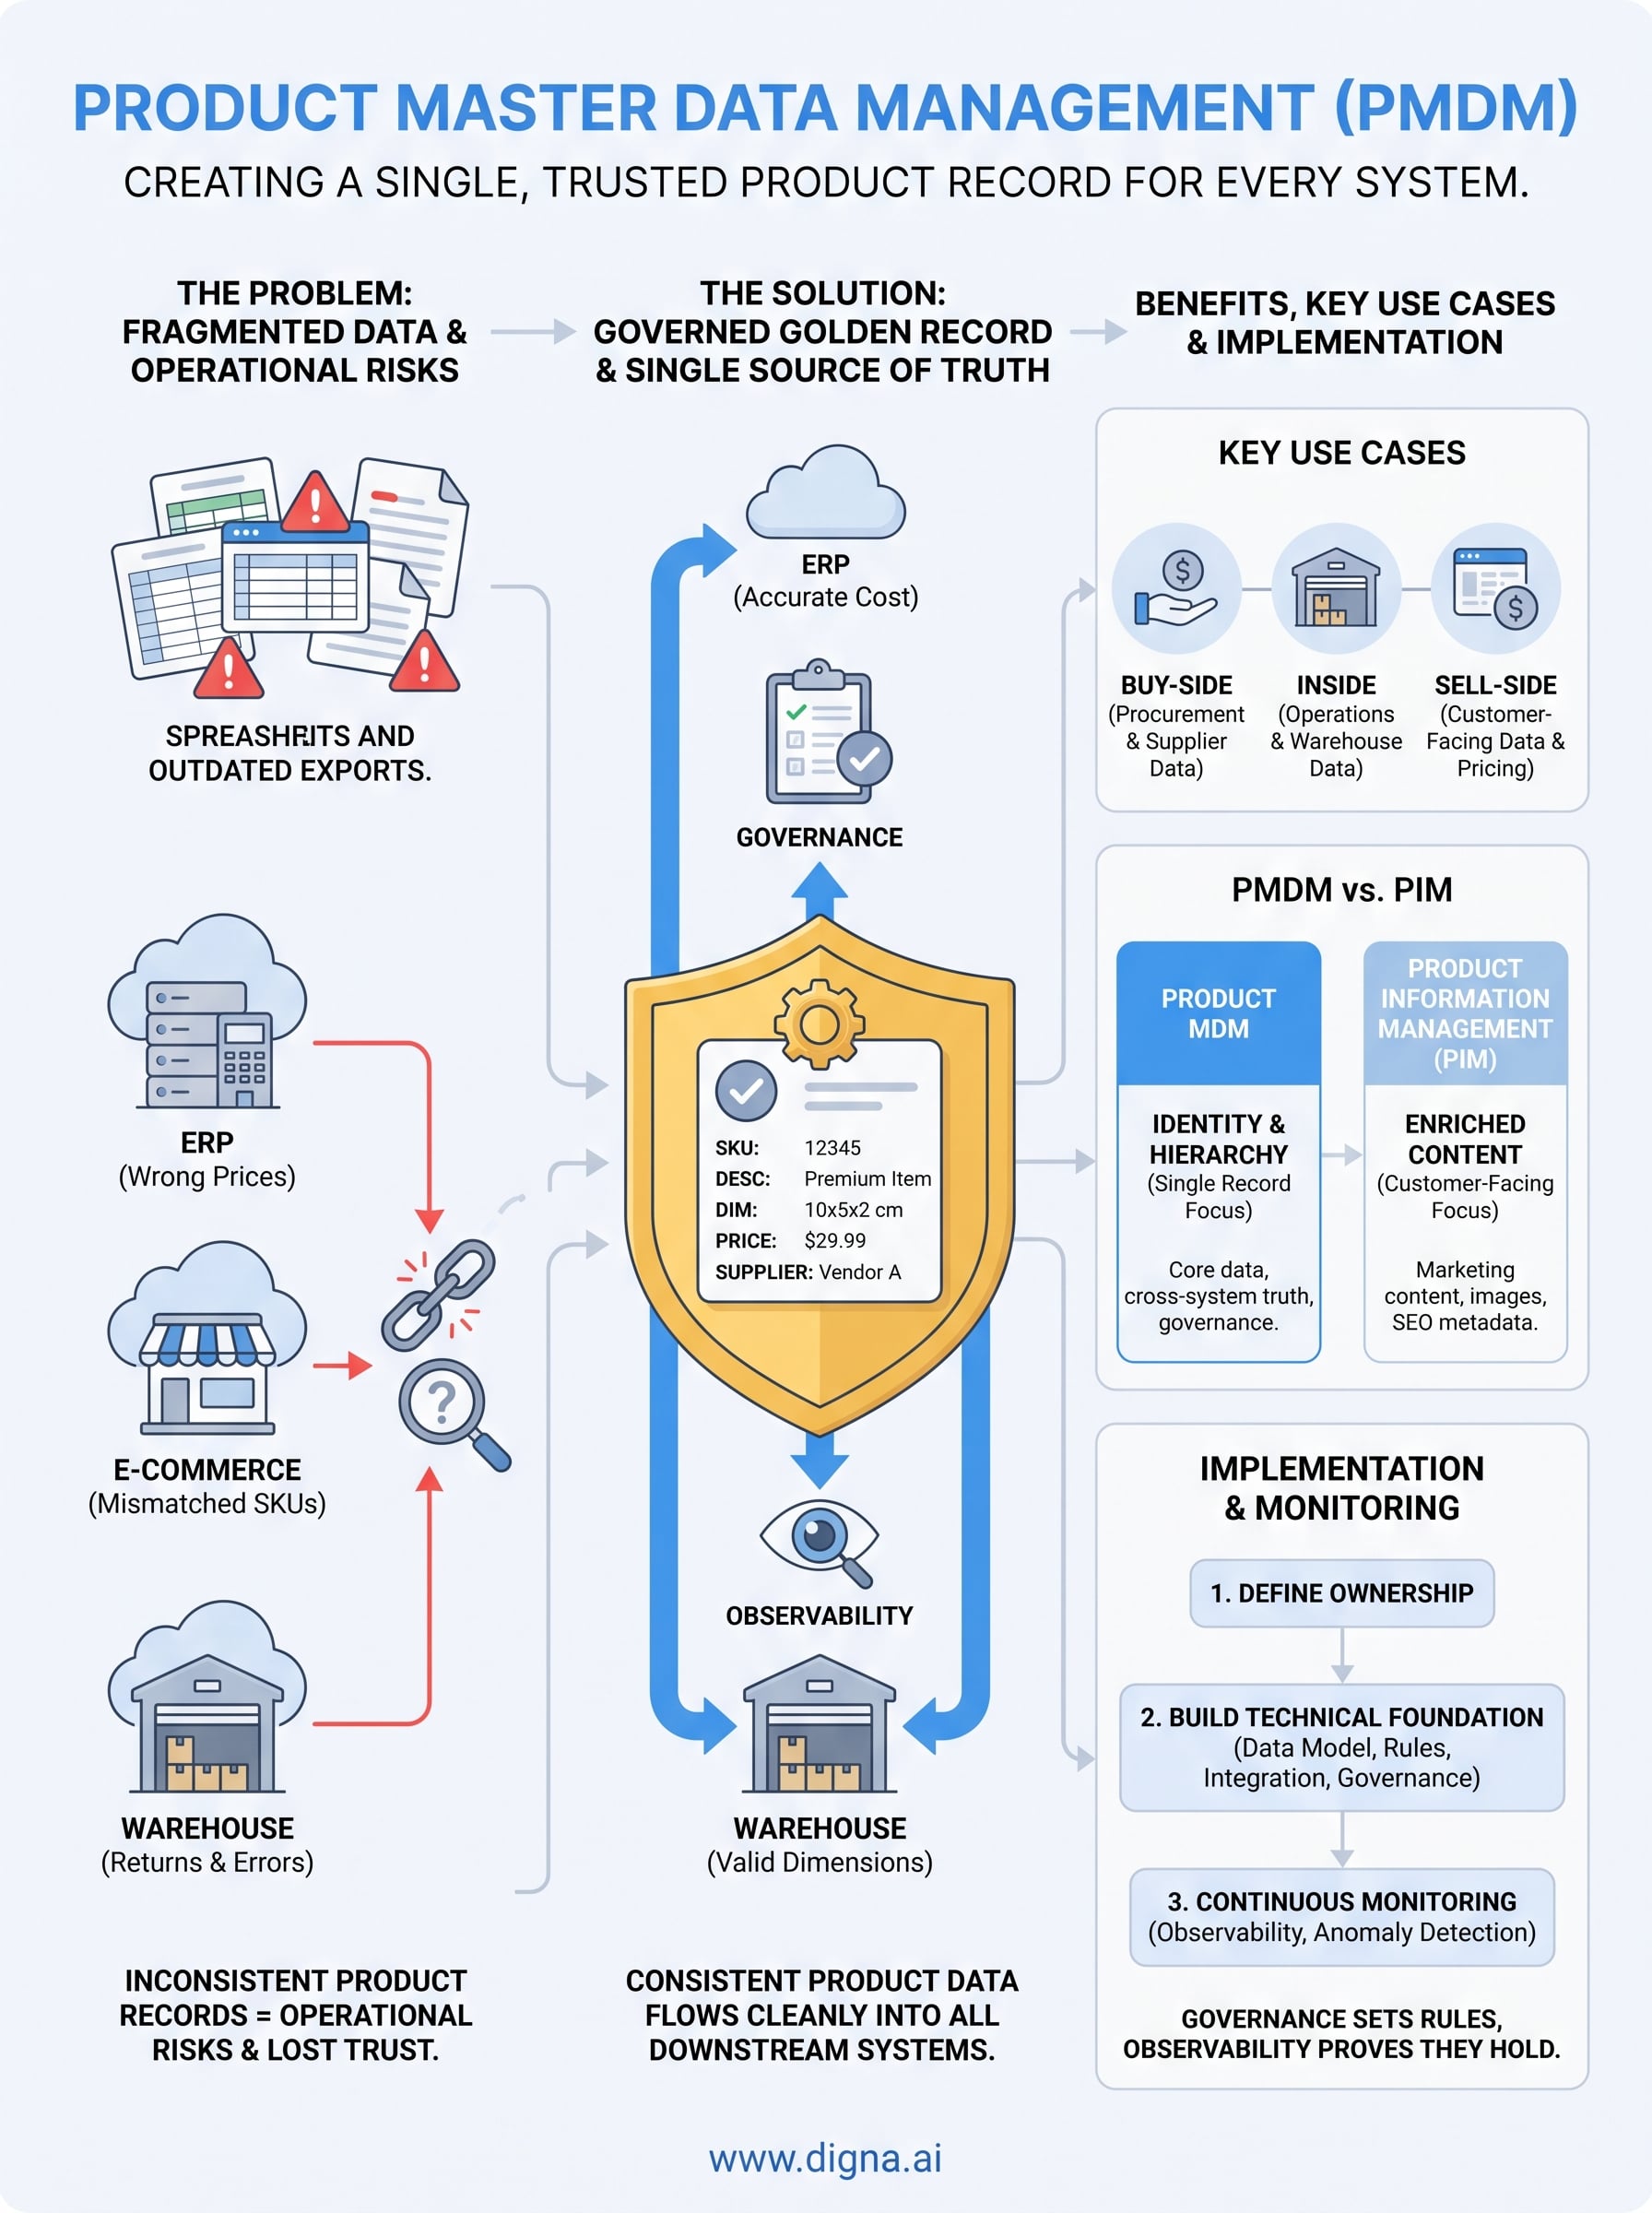
In sostanza, il PMDM significa creare un'unica fonte autorevole per gli attributi di prodotto, come descrizioni, dimensioni, prezzi e dati dei fornitori, e poi governare il modo in cui questi dati vengono creati, aggiornati e condivisi all'interno dell'organizzazione. Se fatto bene, impedisce ai team di lavorare su fogli di calcolo contrastanti o esportazioni obsolete e vi fornisce un record di prodotto coerente che fluisce senza intoppi in ogni sistema a valle, dal procurement allo storefront.
In questo articolo analizziamo cosa comporta concretamente il master data management dei prodotti, i componenti che lo fanno funzionare e perché diventa più importante man mano che crescono il catalogo e il panorama dei sistemi. Vedremo anche dove si inseriscono i controlli di qualità e il rilevamento delle anomalie per mantenere affidabili nel tempo i master data, dato che un processo di gestione vale quanto i controlli di data quality che lo sostengono.
Perché il master data management dei prodotti è importante
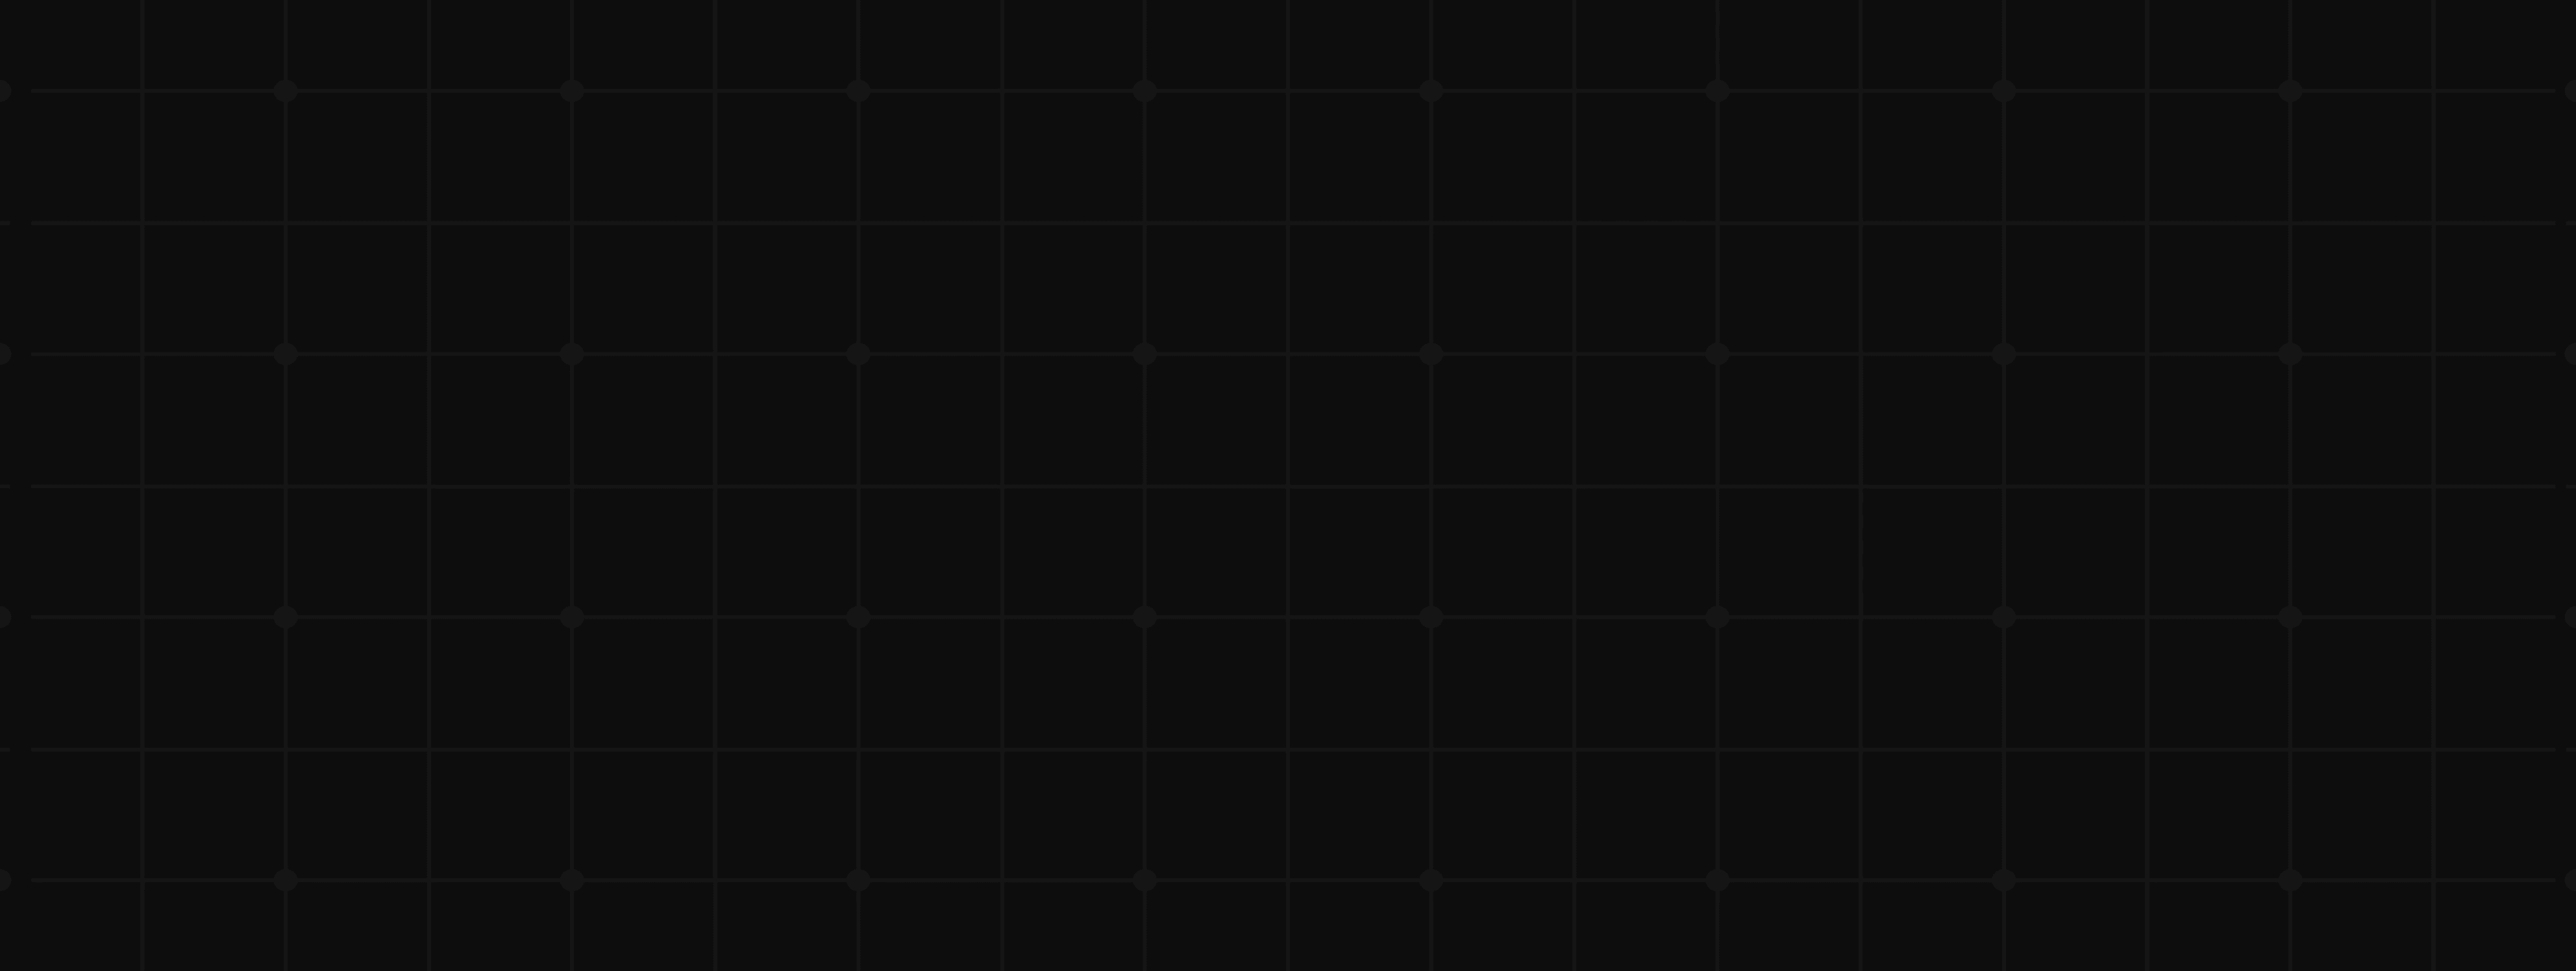
Ogni azienda con più di una manciata di sistemi prima o poi si scontra con lo stesso muro: i dati di prodotto vanno alla deriva. Un fornitore aggiorna il peso di una confezione in un sistema, un team marketing aggiunge un nuovo attributo in un altro e nel giro di pochi mesi la vostra single source of truth si è frammentata in cinque diverse versioni della verità. Non è un inconveniente tecnico, è un rischio operativo che si manifesta in ordini con prezzi errati, transazioni EDI fallite e audit di compliance che si trascinano per settimane più del dovuto. Il master data management dei prodotti esiste proprio perché la riconciliazione manuale non regge oltre qualche migliaio di SKU, figuriamoci le centinaia di migliaia che oggi gestisce la maggior parte delle aziende medio-grandi.
Il costo reale di dati di prodotto incoerenti
All'inizio i costi si accumulano in silenzio. Un team di magazzino comunica a un corriere dimensioni sbagliate e deve pagare una nuova spedizione. Un team finance riconcilia le fatture dei fornitori con condizioni contrattuali obsolete e perde uno sconto negoziato. Nessuno di questi casi sembra catastrofico preso singolarmente, ma moltiplicateli per migliaia di SKU e decine di partner commerciali e i numeri crescono rapidamente, soprattutto quando entrano in gioco il reporting normativo o i prezzi mostrati ai clienti.
Problema nei dati | Impatto tipico sul business |
|---|---|
SKU duplicati | Eccesso di scorte, previsioni della domanda imprecise |
Unità di misura incoerenti | Errori di fatturazione, transazioni EDI fallite |
Anagrafiche fornitori obsolete | Sconti persi, lacune di compliance |
Attributi non corrispondenti tra i canali | Resi, reclami, sospensioni dai marketplace |
I dati di prodotto errati non costano solo denaro: erodono silenziosamente la fiducia in ogni sistema e in ogni decisione che vi si basa.
Dove i dati di prodotto puliti ripagano
Dati di prodotto governati accelerano tutto ciò che sta a valle. I lanci di nuovi prodotti procedono più velocemente, perché i team non devono attendere l'inserimento manuale dei dati in cinque sistemi scollegati. Gli adempimenti normativi diventano meno gravosi, perché attributi come le classificazioni delle merci pericolose o i dati sul paese d'origine risiedono in un unico record governato anziché in fogli di calcolo sparsi di cui nessuno si fida. I team di reporting smettono di dubitare delle proprie dashboard, perché la dimensione di prodotto che alimenta quei report non cambia forma di nascosto durante la notte.
È qui che la data observability si guadagna un posto accanto al PMDM anziché restare in disparte. Uno schema tracker che segnala una colonna aggiunta o un tipo di dato modificato intercetta il drift strutturale prima che corrompa un report, e un rilevamento delle anomalie che apprende i pattern normali dei vostri feed di prodotto può far emergere un errore di prezzo o un caricamento fornitore non riuscito molto prima che un cliente se ne accorga. Il PMDM stabilisce le regole di governance; l'observability continua a dimostrare che quelle regole reggono davvero nella pratica, ogni giorno in cui i dati fluiscono.
Come implementare il master data management dei prodotti
L'introduzione del master data management dei prodotti funziona meglio come programma a fasi che come singolo progetto big-bang. Partite in piccolo: scegliete un dominio di prodotto, come i beni confezionati o i componenti elettronici, dimostrate che il modello funziona e poi espandetevi. Le aziende che cercano di governare ogni attributo in ogni business unit fin dal primo giorno di solito si bloccano entro un trimestre, perché il lavoro politico per concordare "chi è il responsabile di questo campo" richiede più tempo della realizzazione tecnica.
Definite le responsabilità prima di toccare gli strumenti
Stabilite chi è responsabile di ciascun attributo prima di scegliere il software. Di norma il procurement è responsabile dei dati su fornitori e costi, i team di prodotto di descrizioni e classificazioni, e la compliance degli attributi normativi come i codici delle merci pericolose. Senza questo accordo, il vostro golden record diventa un campo di battaglia ogni volta che due sistemi non concordano.
Un progetto di master data senza responsabilità chiare si limita a spostare il caos in un database dall'aspetto più gradevole.
Costruite le basi tecniche per fasi
Una volta definite le responsabilità, costruite lo stack in un ordine logico:
Modello dei dati: concordate gli attributi, le gerarchie e gli identificatori che ogni record di prodotto deve contenere.
Regole di matching e survivorship: decidete quale sorgente prevale quando due sistemi non concordano sullo stesso campo.
Livello di integrazione: collegate ERP, PIM, e-commerce e sistemi di magazzino in modo che gli aggiornamenti fluiscano in entrambe le direzioni.
Workflow di governance: definite i passaggi di approvazione per nuovi prodotti, modifiche degli attributi e dismissioni.
Monitoraggio: aggiungete rilevamento delle anomalie e tracciamento dello schema, così il drift viene intercettato subito e non al prossimo audit.
Quest'ultimo passaggio viene saltato più spesso di quanto dovrebbe. I team danno per scontato che, una volta creato il golden record, resti pulito. Non è così. I fornitori inviano feed malformati, le integrazioni si interrompono senza segnalarlo e nuovi attributi vengono aggiunti senza che nessuno aggiorni la documentazione. Gli strumenti che sorvegliano il drift strutturale e le variazioni inattese dei valori intercettano questi problemi finché sono ancora piccoli, ed è esattamente il divario che le piattaforme di data quality e observability sono progettate per colmare.
Casi d'uso principali: dati buy-side, interni e sell-side
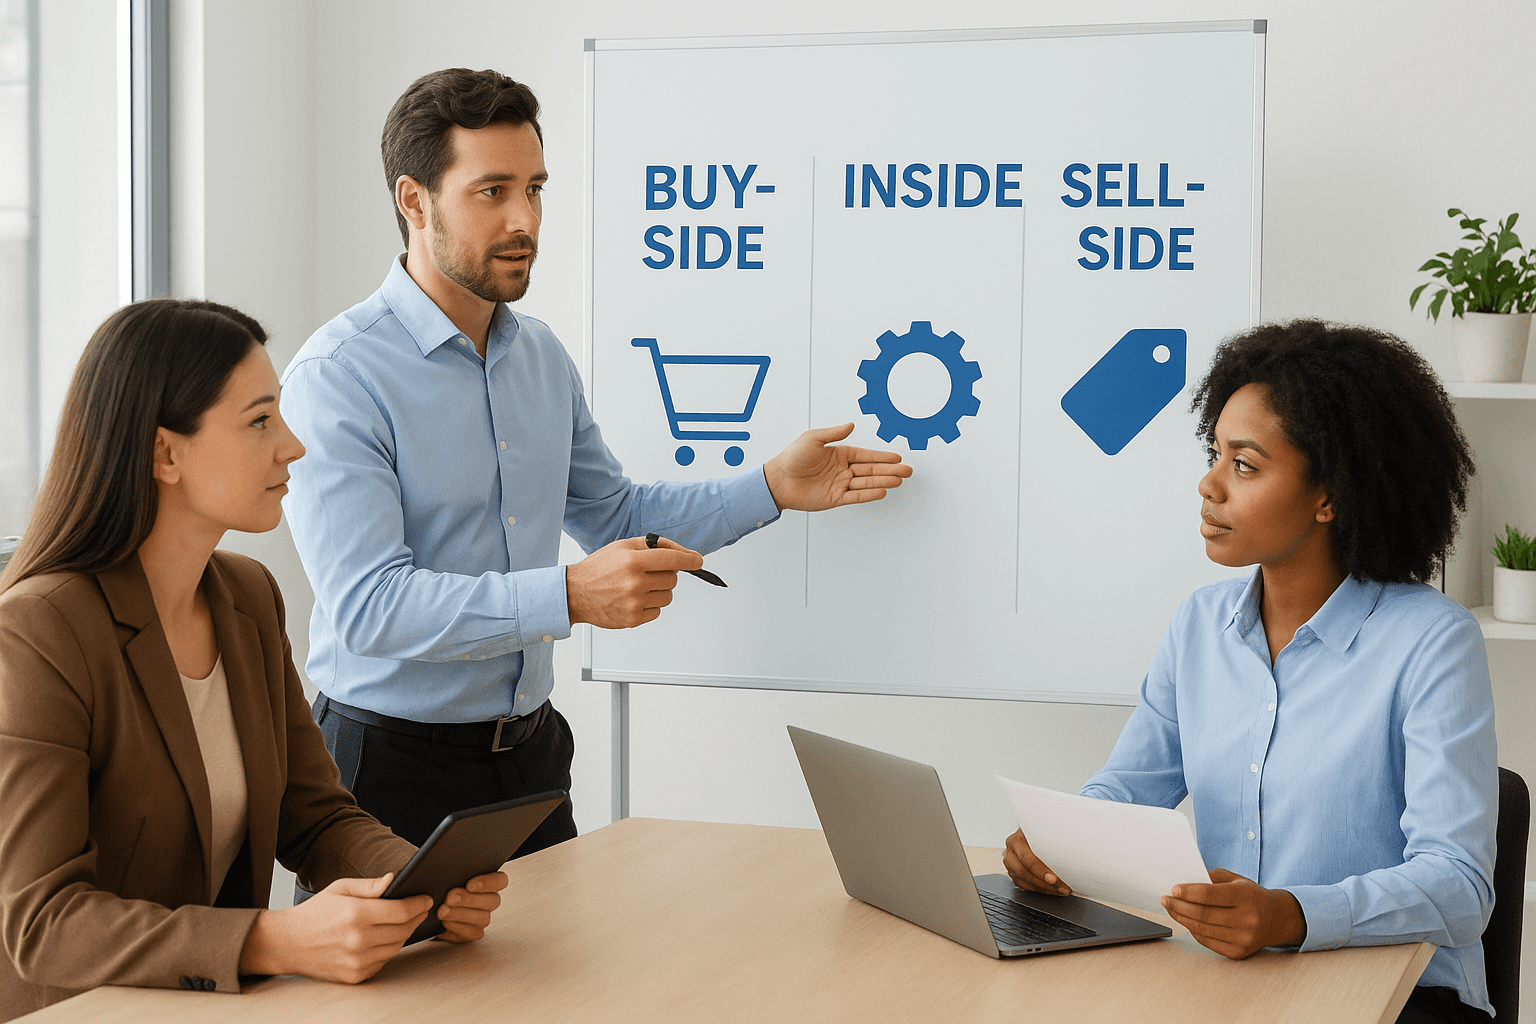
Il master data management dei prodotti genera valore in modi diversi a seconda del lato del business che si considera. I dati buy-side comprendono tutto ciò che riguarda il procurement: anagrafiche dei fornitori, condizioni di costo, prezzi contrattuali e SKU specifici dei vendor. Se li sbagliate, finite per pagare fatture in base a condizioni contrattuali scadute o perdere sconti negoziati perché due sistemi riportano costi unitari diversi per lo stesso articolo.
Buy-side: allineamento di procurement e fornitori
I casi d'uso buy-side si concentrano sul mantenere sincronizzati i dati su fornitori e costi tra i sistemi di procurement, finance e inventario. Le anagrafiche fornitori duplicate sono la classica modalità di errore: lo stesso fornitore registrato due volte con nomi leggermente diversi, che divide lo storico degli acquisti e annulla la visibilità sugli sconti a volume. Un golden record governato per ogni combinazione di fornitore e prodotto colma questa lacuna e fornisce al reparto finance un unico numero con cui riconciliare.
Interni: coerenza operativa in tutta l'azienda
I dati interni sono quelli che mantengono in funzione le vostre operations: dimensioni di magazzino, requisiti di stoccaggio, classificazioni interne e le gerarchie che alimentano la pianificazione della domanda e i sistemi di inventario. È qui che le unità di misura non corrispondenti causano i danni maggiori, perché un peso registrato in chilogrammi in un sistema e in libbre in un altro può falsare i calcoli dei noli o innescare contestazioni sui costi di spedizione. Gerarchie di prodotto interne coerenti rendono anche più affidabili le previsioni della domanda, perché i team di pianificazione lavorano su un'unica struttura invece di riconciliare cinque alberi di categorie leggermente diversi.
Sell-side: accuratezza verso i clienti
I dati sell-side sono quelli che clienti e partner di canale vedono effettivamente: descrizioni, immagini, prezzi e attributi di compliance sul vostro storefront o nelle inserzioni sui marketplace. Gli errori qui sono i più visibili e i più costosi, perché una dimensione sbagliata o una certificazione mancante possono provocare resi, reclami o la sospensione da un marketplace. Marketplace come Amazon impongono requisiti rigorosi di accuratezza delle inserzioni, ed errori ripetuti nei dati possono portare a penalità a livello di account, non solo al rifiuto di una singola inserzione. Governare gli attributi sell-side con lo stesso rigore dei dati buy-side e interni protegge direttamente il fatturato, non solo l'efficienza operativa.
I dati buy-side, interni e sell-side si rompono in modi diversi, ma riconducono tutti alla stessa governance mancante.
Product MDM vs. product information management
La confusione tra queste due discipline è profonda e fa perdere ai team tempo che non hanno. I sistemi di product information management (PIM) archiviano e arricchiscono i contenuti di marketing destinati a un sito web o a un catalogo: descrizioni, immagini, traduzioni, metadati SEO. Il master data management dei prodotti governa qualcosa di più fondamentale: l'identità, la gerarchia e la verità condivisa tra i sistemi del record di prodotto stesso. Il PIM risponde alla domanda "come appare questo prodotto a un cliente". Il PMDM risponde alla domanda "è lo stesso prodotto ovunque, e chi è autorizzato a modificarlo".
Dove le due discipline si separano
Una sovrapposizione esiste, ma la distinzione diventa importante oltre qualche migliaio di articoli. Uno strumento PIM può contenere contenuti curati e arricchiti per un prodotto che in realtà non esiste come master record governato, il che significa che il marketing pubblica un'inserzione prima ancora che il procurement abbia confermato che lo SKU sia reale. È esattamente da questa lacuna che si insinuano attributi non corrispondenti e inserzioni duplicate.
Dimensione | Product MDM | PIM |
|---|---|---|
Focus principale | Identità, gerarchia, coerenza tra i sistemi | Contenuti arricchiti rivolti ai clienti |
Responsabile tipico | Data governance, IT, team master data | Marketing, team e-commerce |
Domanda chiave | È questo il record unico e corretto? | Questo record appare corretto a un acquirente? |
Problema tipico in sua assenza | SKU duplicati, sistemi non allineati | Descrizioni incoerenti, SEO scadente |
Il PIM fa apparire corretto un prodotto. Il PMDM garantisce che lo sia davvero, ovunque e nello stesso momento.
Perché le aziende hanno bisogno di entrambi, non dell'uno o dell'altro
Le aziende che considerano il PIM un sostituto del master data management prima o poi ne pagano il prezzo in resi e ticket di assistenza, perché contenuti accattivanti costruiti su un record instabile non fanno altro che propagare gli errori più lontano e più velocemente. Gestire il PMDM come livello di governance sottostante al PIM offre al marketing una base affidabile da arricchire, invece di un bersaglio mobile da ricontrollare ogni trimestre.
Le sfide più comuni del PMDM e come risolverle
La maggior parte dei programmi di master data management dei prodotti si blocca per ragioni prevedibili, non esotiche. I sistemi legacy resistono all'integrazione, le business unit difendono la propria versione della verità e regole di governance che sembravano pulite sulla lavagna crollano nel momento in cui un vero feed fornitore non corrisponde al modello dei dati. Riconoscere presto questi pattern fa risparmiare mesi di rilavorazioni.
Silos di dati e record duplicati
I silos si formano quando le business unit creano i propri elenchi di prodotti più velocemente di quanto l'IT riesca a collegarli, e i duplicati seguono a ruota. Per risolvere il problema servono regole di matching che intercettino gli SKU quasi duplicati, non solo quelli identici, perché un codice fornitore con uno spazio in più o una descrizione abbreviata sfugge ogni volta ai semplici confronti tra stringhe. Una regola di survivorship che seleziona automaticamente il record più completo e verificato più di recente riduce la pulizia manuale che altrimenti ricade sulla scrivania di un data steward.
Una governance che nessuno segue
Le regole funzionano solo se le persone le usano. La governance fallisce quando i workflow di approvazione sono troppo lenti per il business, così i team li aggirano e creano record ombra per rispettare una scadenza. Di solito la soluzione è snellire il workflow, non allentare le regole: meno passaggi di approvazione, responsabilità più chiare e tempi più rapidi per le modifiche di routine.
Il modo più rapido per affossare un programma di governance è rendere il percorso corretto più lento della scorciatoia.
Il drift che la sola governance non può intercettare
Anche un record ben governato si deteriora nel tempo, man mano che i feed si aggiornano, gli schemi cambiano e nuovi attributi vengono aggiunti senza documentazione. È qui che il monitoraggio dimostra il suo valore:
Sfida | Causa principale | Soluzione |
|---|---|---|
SKU duplicati | Regole di matching deboli | Fuzzy matching + logica di survivorship |
Approvazioni lente | Workflow sovraccarico | Passaggi di governance semplificati |
Modifiche di schema silenziose | Nessun monitoraggio strutturale | Tracciamento automatizzato dello schema |
Variazioni di valori inspiegabili | Nessun rilevamento delle anomalie | Alert sulle anomalie basati sull'AI |
Risolvere questi problemi richiede sia disciplina sia verifiche continue, perché la governance stabilisce la regola e l'observability conferma che la regola sta reggendo.
Costruire fiducia nei vostri dati di prodotto
Il master data management dei prodotti offre alla vostra organizzazione un unico record governato invece di cinque versioni in competizione, e questo solo cambiamento modifica la velocità con cui si muovono i team. Il procurement smette di inseguire condizioni contrattuali scadute, i team di magazzino smettono di tirare a indovinare le conversioni delle unità di misura e il marketing smette di pubblicare contenuti per prodotti mai confermati come reali. Niente di tutto questo regge, però, senza controlli continui. Le regole di governance fissano lo standard, ma solo un monitoraggio continuo dimostra che quello standard regge mentre i feed si aggiornano e i sistemi cambiano sotto di voi.
È il livello che la maggior parte dei programmi PMDM sottodimensiona. Il tracciamento dello schema e il rilevamento delle anomalie intercettano il drift che la revisione manuale non vede, spesso giorni prima che raggiunga un cliente o un auditor. Se siete pronti a mettere un vero monitoraggio a protezione dei vostri dati di prodotto invece di sperare che restino puliti, scoprite come la piattaforma di data observability di digna intercetta automaticamente questi problemi, direttamente all'interno del vostro ambiente esistente.
Per il tracciamento automatizzato dello schema che intercetta le modifiche strutturali silenziose nei feed di prodotto prima che corrompano un report, scoprite come digna Schema Tracker segnala colonne aggiunte, rimosse e con tipo modificato.
Domande frequenti
Che cos'è il master data management dei prodotti?
Il master data management dei prodotti (PMDM) crea un unico record autorevole per gli attributi di prodotto, come descrizioni, dimensioni, prezzi e dati dei fornitori, e governa poi il modo in cui quel record viene creato, aggiornato e condiviso. Sostituisce fogli di calcolo ed esportazioni contrastanti tra ERP, e-commerce e sistemi di magazzino con un unico record coerente che fluisce in ogni sistema a valle.
Qual è la differenza tra product MDM e PIM?
Il PIM archivia e arricchisce i contenuti rivolti ai clienti, come descrizioni, immagini, traduzioni e metadati SEO, ed è di solito gestito dal marketing. Il product MDM governa l'identità, la gerarchia e la verità condivisa tra i sistemi del record stesso. In parole semplici, il PIM fa apparire corretto un prodotto, mentre il PMDM garantisce che sia lo stesso prodotto corretto ovunque.
Come si implementa il master data management dei prodotti?
Gestitelo come un programma a fasi, partendo da un unico dominio di prodotto, come i beni confezionati. Definite le responsabilità sugli attributi prima di scegliere gli strumenti, poi costruite per fasi: modello dei dati, regole di matching e survivorship, livello di integrazione, workflow di governance e infine monitoraggio con rilevamento delle anomalie e tracciamento dello schema, così il drift viene intercettato prima del prossimo audit.
Quali problemi causano dati di prodotto incoerenti?
Ogni problema corrisponde a un costo per il business. Gli SKU duplicati portano a eccesso di scorte e previsioni imprecise, le unità di misura incoerenti causano errori di fatturazione e transazioni EDI fallite, le anagrafiche fornitori obsolete comportano sconti persi e lacune di compliance, e gli attributi non corrispondenti tra i canali provocano resi, reclami e persino sospensioni dai marketplace.
Come si evitano gli SKU duplicati nei master data di prodotto?
La difesa principale sono regole di fuzzy matching che intercettino i quasi duplicati, non solo le corrispondenze esatte, perché un codice fornitore con uno spazio in più o una descrizione abbreviata sfugge al semplice confronto tra stringhe. Una regola di survivorship che seleziona il record più completo e verificato più di recente riduce poi la pulizia manuale lasciata ai data steward.