Che cos'è un piano di remediation
|
6
min di lettura

State fissando una dashboard che non torna, e il momento non potrebbe essere peggiore. Forse una tabella dei ricavi si è sballata dopo una modifica alla sorgente, un feed regolamentare è arrivato in ritardo o lo score di un modello si è spostato abbastanza da far perdere fiducia al responsabile di business. In quel momento la domanda non è solo che cosa si è rotto, ma quale risposta reggerà quando qualcuno chiederà se il problema è risolto, contenuto e difficilmente destinato a ripresentarsi.
Una riesecuzione o una patch veloce possono zittire il rumore per oggi. Un piano di remediation trasforma quella reazione in un processo controllato, con un responsabile, delle evidenze e un criterio chiaro di chiusura. Se vi è già capitato di vedere un ticket segnato come completato mentre il report a valle continuava a sembrare sospetto, questo tema è probabilmente già sulla vostra scrivania.
Indice
Quando un incidente sui dati richiede un vero piano
Il lunedì inizia con un messaggio su Slack, non con un report di incidente ordinato. La dashboard finanziaria è di nuovo sbagliata, il caricamento nel data warehouse è terminato e comunque i numeri non quadrano con il sistema sorgente. Qualcuno propone di rieseguire la pipeline, qualcun altro vuole applicare una patch alla trasformazione, e il responsabile di business vuole solo che il report smetta di cambiare ogni ora.
È qui che i flussi di ticket informali di solito falliscono. Una riesecuzione può essere la prima mossa giusta, ma contiene solo il sintomo. Non vi dice se la causa radice sia stata una modifica dello schema, un mapping errato, una dipendenza mancante o una regola di validazione che non è mai esistita.
Un vero piano parte dal separare la risposta temporanea dalla correzione permanente. Tratta l'incidente come un flusso di lavoro con evidenze, non come un'attività una tantum con un campo di stato. Per i team che già gestiscono pagine di problemi come digna data quality issues, il passaggio è semplice in teoria e difficile in pratica: il record deve passare da “qualcosa non ha funzionato” a “questo guasto è compreso, assegnato, corretto e verificato”.
Un ticket può registrare attività. Un piano di remediation deve dimostrare che il rischio si è ridotto.
Questa distinzione conta perché la fiducia si costruisce su una chiusura che si può difendere. Se la pipeline viene riparata ma nessuno controlla l'aggiornamento a valle, il piano non è completo, è solo più silenzioso. Il resto dell'articolo applica uno standard più rigoroso, in linea con il modo in cui lavorano i team dati esperti quando la pressione è reale.
La definizione alla base di ogni piano di remediation
Un piano di remediation è un insieme controllato di azioni basate su evidenze che elimina la causa radice di una non conformità rilevata, ripristina il processo o i dati coinvolti, previene il ripetersi del problema e dimostra che la correzione ha funzionato. Questa definizione conta perché vi costringe a porre quattro domande diverse, non una sola. Che cosa è successo, che cosa l'ha causato, che cosa abbiamo cambiato e come sappiamo che resta risolto?
Pensate a un tubo che perde. Potete asciugare il pavimento, stringere il raccordo, ispezionare la tubazione e poi osservare per un po' se esce altra acqua. Asciugare è il contenimento, stringere il raccordo è la correzione, l'ispezione è la verifica e l'osservazione è la chiusura con fiducia. Nel lavoro sui dati vale la stessa sequenza quando un caricamento malformato, una partizione obsoleta o uno schema danneggiato iniziano a compromettere il reporting.

Le quattro fasi che mantengono il lavoro onesto
Il contenimento limita ulteriori danni. Può significare congelare una tabella corrotta, interrompere la pubblicazione verso i consumatori BI o indirizzare gli utenti all'ultimo snapshot valido noto mentre il team indaga.
La correzione permanente elimina la causa sottostante. In una piattaforma dati può trattarsi di una correzione SQL, di una modifica al mapping della sorgente, di un aggiornamento del contratto di schema o di una dipendenza di orchestrazione mancante.
La verifica dimostra che la correzione regge. Qui controllate conteggi di righe, regole di business, compatibilità dello schema e aggiornamenti a valle, invece di dare per scontato che la modifica da sola sia bastata.
La chiusura avviene solo quando le evidenze esistono e il responsabile approva. Qualsiasi chiusura precedente è solo comodità amministrativa.
La separazione netta conta perché la remediation non è la stessa cosa della risposta agli incidenti, né della manutenzione ordinaria. La risposta agli incidenti ferma l'emorragia. La manutenzione mantiene i sistemi in salute. La remediation sta nel mezzo: qualcosa è già andato storto e il team deve dimostrare che il guasto è stato risolto.
Per modelli operativi di qualità dei dati più ampi, digna data quality management si integra in modo naturale con questa idea, perché la gestione della qualità fornisce il contesto di rilevamento e controllo, mentre il piano di remediation gestisce il flusso correttivo.
Gli elementi chiave di un piano che funziona
Un piano crolla in fretta quando è troppo vago per essere eseguito. “Sistemare la tabella” suona come un'azione, ma nessuno sa chi ne è responsabile, che cosa è cambiato o quando la correzione va considerata conclusa. Un piano che funziona deve contenere abbastanza contesto perché un altro engineer possa riprenderlo senza tirare a indovinare.
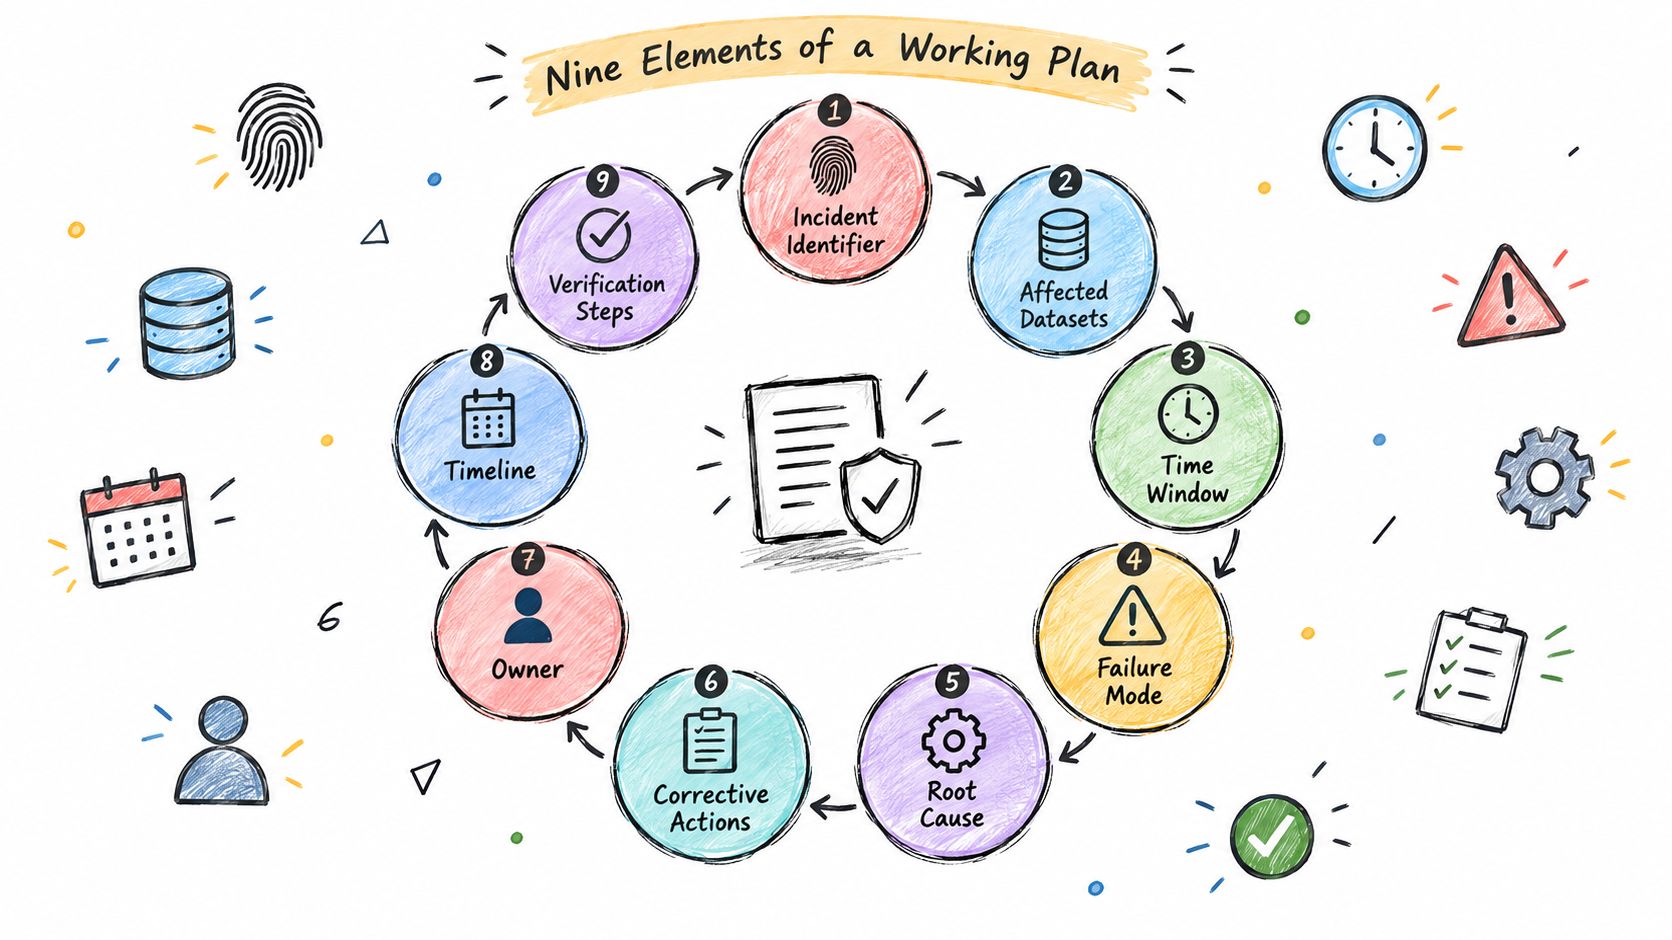
I campi che evitano ambiguità
Identificativo dell'incidente. Dà al problema un riferimento stabile, così log, thread di chat e ticket puntano tutti allo stesso evento.
Dataset e finestra temporale coinvolti. Senza questa indicazione correggerete la partizione sbagliata, vi sfuggirà una dipendenza a valle o correggerete in eccesso dati storici che non erano stati toccati.
Modalità di guasto. Indicate la natura del problema, come un arrivo in ritardo, uno schema danneggiato, valori non validi o una deriva silenziosa di una metrica.
Impatto sul business. Specificate che cosa ha colpito il guasto, perché una metrica interna errata e un feed regolamentare in ritardo non hanno la stessa urgenza.
Ipotesi di causa radice. Annotate ciò che il team ritiene abbia causato il guasto, anche se l'ipotesi è ancora in fase di verifica.
Responsabile. Una sola persona che ne risponde, non una coda di team.
Priorità. Determina l'ordine di intervento quando sono aperti più piani.
Dipendenze. Indicate che cosa deve accadere prima, come correzioni a monte, approvazioni di accesso o il coordinamento di un backfill.
Metodo di rollback. Se la correzione peggiora le cose, il team ha bisogno di una strada sicura per tornare indietro.
Data obiettivo di completamento. Le scadenze rendono espliciti i compromessi.
Criteri di accettazione. Questo è il cancello. Se non riuscite a definirli, non potete dimostrare la chiusura.
Regola pratica: se un piano non dice come verificherete il successo, non è ancora un piano di remediation, è una lista di cose da fare.
Nella pratica mancano spesso due elementi, ed entrambi costano cari. L'assenza di un responsabile genera deriva, perché tutti presumono che se ne stia occupando qualcun altro. L'assenza di un criterio di accettazione genera false chiusure, perché il ticket può essere chiuso anche quando il problema è ancora presente nei dati.
Per l'igiene del flusso di lavoro, digna's data quality issue management process è rilevante perché il piano deve sopravvivere ai passaggi di consegne, non solo al triage iniziale.
Dare priorità e suddividere in fasi più piani aperti
Raramente i team hanno una sola remediation aperta. Ne hanno diverse, e alcune competono per le stesse persone, la stessa finestra di rilascio e la stessa attenzione del management. Ordinare per età del ticket è facile, ma è un modo debole di decidere che cosa correggere per primo.
Criteri di priorità per piani di remediation in concorrenza | Perché conta | Segnale forte di urgenza |
|---|---|---|
Impatto sul business | Incide su ricavi, reporting, fiducia dei clienti o qualità delle decisioni | Il reporting chiave per il management è errato o non disponibile |
Esposizione normativa | Crea rischi di audit, compliance o segnalazione | Un feed o un controllo obbligatorio è in ritardo o inaffidabile |
Criticità dei dati | Alcuni dataset alimentano molti consumatori a valle | Sono coinvolti dati sorgente ampiamente riutilizzati |
Probabilità di ricorrenza | Una correzione che non regge genera incidenti ripetuti | Lo stesso difetto continua a ripresentarsi |
Numero di dipendenze | Più dipendenze di solito significano un raggio d'impatto più ampio | Diverse pipeline o team dipendono dal problema |
Tempo prima del danno | Alcuni problemi peggiorano rapidamente | I dati diventeranno inutilizzabili entro il prossimo ciclo |
Perché le fasi contano quando la soluzione rapida non basta
Una patch temporanea può ripristinare il servizio oggi e lasciare comunque intatta la causa radice. Per questo contenimento, correzione permanente e verifica vanno trattati separatamente. Se un feed in ritardo viene reindirizzato manualmente, il team può aver tenuto in moto il business, ma la lacuna di fondo resta finché l'automazione o la sorgente a monte non viene riparata.
La scelta più difficile arriva quando il contenimento immediato è in conflitto con una correzione duratura. Potreste riuscire a rieseguire rapidamente gli eventi, ma farlo prima di aver corretto il contratto di schema può provocare un secondo guasto. In quel caso un buon piano dice no alla scorciatoia più veloce e sì alla sequenza che riduce il rischio.
Una chiusura amministrativa non dimostra la remediation. Solo le evidenze validate lo fanno.
Questa distinzione conta nelle piattaforme dati perché il lavoro può sembrare completo molto prima che il rischio sia sparito. Una dashboard può aggiornarsi, una pipeline può smettere di fallire e un ticket può essere chiuso. Se gli output non sono stati riconciliati, in pratica il piano è ancora aperto.
Quando gli stakeholder chiedono perché un problema venga prima di un altro, spiegate il compromesso in termini di business, non di numero di ticket. Date priorità al problema che può danneggiarvi prima, propagarsi di più o far fallire un controllo, prima di occuparvi del problema estetico che sembra soltanto disordinato.
Due playbook per i problemi di data quality più comuni
Un buon piano diventa reale nel momento in cui potete applicarlo a un guasto concreto. I dettagli cambiano, ma la sequenza resta la stessa: rilevare, contenere, correggere, validare e poi dimostrare che la correzione ha retto abbastanza a lungo da potersene fidare.
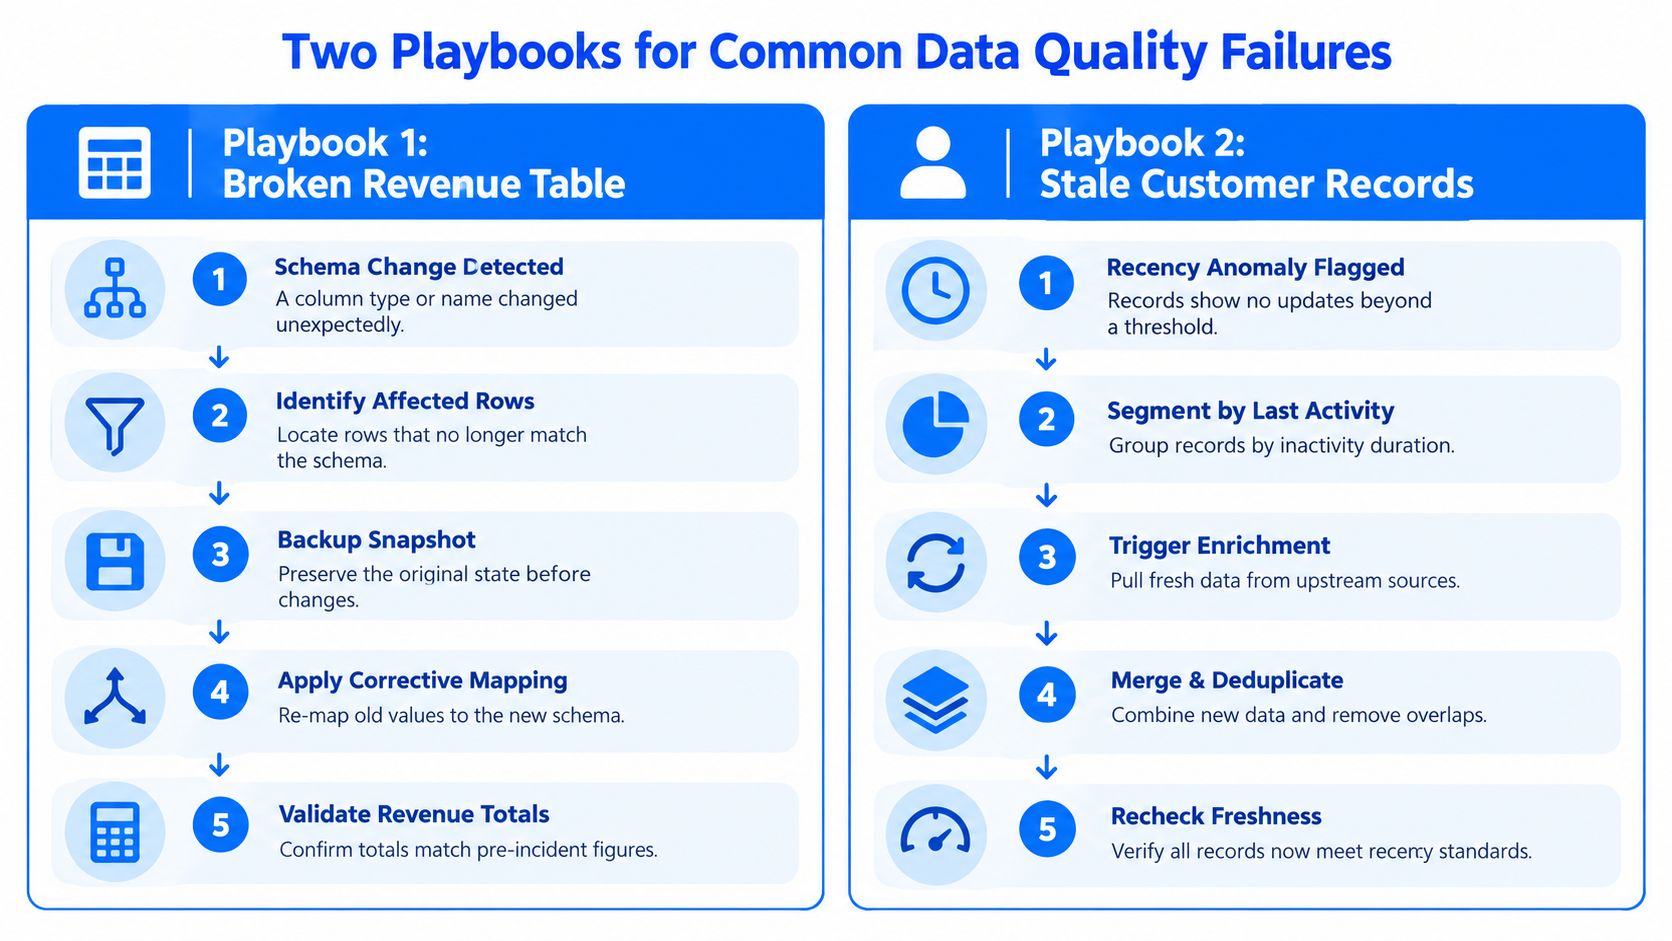
Playbook 1: tabella dei ricavi danneggiata
Un sistema sorgente cambia da un giorno all'altro il tipo di una colonna e la tabella dei ricavi inizia a caricare valori parziali o non validi. Per prima cosa il team contiene il raggio d'impatto interrompendo la pubblicazione a valle o congelando la partizione difettosa. Poi isola le righe coinvolte, conserva lo stato originale e corregge il mapping in modo che il nuovo schema venga gestito correttamente.
Segue la validazione. Il team verifica che i totali dei ricavi quadrino con la sorgente di riferimento, che i record riparati si carichino senza errori e che gli aggiornamenti a valle vadano a buon fine senza interventi manuali. La chiusura arriva solo dopo che questi controlli sono superati e il responsabile ha approvato.
I digna data completeness checks sono rilevanti in questo caso perché un arrivo incompleto o un backfill parziale possono far sembrare riparata una tabella a cui mancano ancora dei record.
Playbook 2: record clienti non aggiornati
Una perdita silenziosa di aggiornamento dei dati clienti non sempre provoca un guasto evidente. Il modello continua a girare, ma i dati in input invecchiano e diventano meno affidabili. In questo caso il primo passo è segnalare l'anomalia di aggiornamento, poi segmentare i record coinvolti per durata dell'inattività, così il team vede fin dove si estende il problema.
Successivamente il responsabile avvia l'arricchimento dalle sorgenti a monte, unisce le nuove informazioni e rimuove i duplicati. L'ultimo passo non è semplicemente “il job è terminato”, ma un nuovo controllo che conferma che i record rispettano ora lo standard di aggiornamento e che il modello a valle riceve gli input corretti.
Come devono essere le evidenze di chiusura
Tabella dei ricavi danneggiata: totali riconciliati, backfill puliti, nessun errore di validazione critico e aggiornamenti a valle riusciti.
Record clienti non aggiornati: aggiornamento ripristinato, deduplicazione completata ed esecuzioni monitorate che mostrano che il problema non si è ripresentato nel ciclo successivo.
La differenza tra un ticket chiuso e un piano chiuso è semplice. Un ticket dice che qualcuno ci ha lavorato. Un piano dice che gli output sono di nuovo affidabili.
Come digna fornisce evidenze a un piano di remediation
Un piano di remediation diventa molto più solido quando il segnale dell'incidente porta già con sé evidenze strutturate. Non significa che la piattaforma chiuda il problema al posto vostro, ma che il piano parte da input migliori e con meno congetture. Il responsabile passa meno tempo a ricostruire che cosa è successo e più tempo a decidere che cosa fare.
Quali input vanno dove
Data Anomalies e Timeliness alimentano i primi campi del piano. Aiutano a capire che cosa è cambiato, quando è cambiato e se il problema è un ritardo, un caricamento mancante o un pattern insolito che va approfondito.
Schema Tracker supporta l'ipotesi di causa radice. Se una colonna è stata aggiunta, rimossa o ha cambiato tipo, il piano può indicare la modifica strutturale esatta invece di dedurla dai sintomi a valle.
Data Validation aiuta a definire i criteri di accettazione. Se una regola di business a livello di record deve essere rispettata prima della chiusura, il piano può fare riferimento esplicito a quella regola invece di affidarsi a qualcuno che controlla una dashboard a occhio.
Business Monitoring e Data Platform Observability fanno emergere il segnale fin dall'inizio. Mostrano se la metrica di business, il comportamento dei workload o lo stato della piattaforma sono usciti dall'intervallo atteso, il che offre al responsabile un punto di partenza più pulito per il record dell'incidente.
Per i team che usano digna data quality observability, il valore pratico sta nella traccia delle evidenze. Il piano può includere dataset coinvolti, finestre di arrivo attese, differenze di schema, esiti delle validazioni e contesto storico senza dover ricostruire a mano quel contesto da log sparsi.
Che cosa cambia quando le evidenze ci sono
I responsabili decidono più in fretta perché la modalità di guasto è più chiara.
I criteri di accettazione sono più precisi perché sono legati alla validazione e al comportamento osservato.
L'escalation è più pulita perché il piano mostra se il problema è locale, sistemico o ricorrente.
La revisione di audit è più semplice perché il record include le evidenze alla base della correzione, non solo l'azione intrapresa.
La remediation smette di essere un flusso informale e diventa un flusso verificabile. Le evidenze non sostituiscono il giudizio, ma lo rendono difendibile.
Chiudere un piano nel modo giusto ed errori di valutazione comuni
Un ticket chiuso non è la stessa cosa di una remediation conclusa. I team si mettono nei guai quando considerano l'azione come una prova, perché l'azione è solo l'inizio. La domanda chiave è se i dati, il processo e i consumatori a valle siano stabili dopo la correzione.
Che cosa richiede una vera chiusura
Un piano dovrebbe chiudersi solo quando i criteri di accettazione sono soddisfatti, le evidenze sono state conservate e il responsabile ha registrato l'approvazione. Se l'incidente era abbastanza grave da richiedere un contenimento, dovrebbe essere attivo anche un monitoraggio dopo la chiusura. Quel monitoraggio è la rete di sicurezza che vi dice se il difetto è davvero scomparso.
Gli errori di valutazione più comuni si presentano in tre forme. Primo, le riesecuzioni vengono trattate come correzioni quando in realtà sono solo un passo di contenimento. Secondo, le patch di schema vengono considerate correzioni permanenti anche quando nessuno ha verificato la compatibilità a valle. Terzo, i team saltano il monitoraggio dell'efficacia e danno per scontato che l'assenza di alert significhi che il problema è sparito.
Se non potete spiegare come è stata verificata la correzione, non avete una chiusura, avete dell'ottimismo.
Una revisione migliore pone alcune domande brevi prima che qualcuno segni il piano come concluso. La correzione ha affrontato la causa radice e non solo il sintomo? I dati si sono ripresi nella finestra coinvolta? I consumatori a valle hanno superato la validazione? Il problema è rimasto silente nelle esecuzioni successive, non solo nella prima dopo la modifica?
Questo standard protegge il team dalle chiusure premature e dà al management una risposta migliore quando chiede se il lavoro ha ridotto il rischio. Crea anche un passaggio migliore verso il problema successivo, perché lo schema delle evidenze entra a far parte del modo in cui l'organizzazione impara. Il prossimo tema utile sono i criteri di accettazione per gli incidenti di data quality, perché è lì che molti piani falliscono ancora all'ultimo passo.
digna aiuta i team dati a trasformare gli incidenti in un lavoro di remediation basato su evidenze, con monitoraggio, validazione, Timeliness e tracciamento degli schemi che alimentano piani più chiari e chiusure più pulite. Se volete passare da una gestione informale dei ticket a un flusso di lavoro controllato, visitate digna e scoprite come la piattaforma supporta questo processo nel vostro ambiente.
I criteri di accettazione bloccano davvero la chiusura solo quando esistono come controlli eseguibili. Per trasformarli in regole che passano o falliscono su record reali, leggete anche come progettare le regole di validazione dei dati.
Domande frequenti
Che cos'è un piano di remediation nella data quality?
Un piano di remediation è un insieme controllato di azioni basate su evidenze che elimina la causa radice di una non conformità rilevata, ripristina i dati o il processo coinvolti, previene il ripetersi del problema e dimostra che la correzione funziona. A differenza di un ticket, che registra solo attività, deve provare che il rischio è davvero diminuito.
Quali sono le fasi di un piano di remediation?
Sono quattro: contenimento, correzione permanente, verifica e chiusura. Il contenimento limita i danni, ad esempio congelando una tabella corrotta. La correzione elimina la causa, come una modifica SQL o di mapping. La verifica controlla conteggi di righe, regole e aggiornamenti a valle, mentre la chiusura arriva solo con le evidenze e l'approvazione del responsabile.
Che cosa deve contenere un piano di remediation?
Almeno un identificativo dell'incidente, i dataset e la finestra temporale coinvolti, la modalità di guasto, l'impatto sul business, un'ipotesi di causa radice, un unico responsabile, la priorità, le dipendenze, un metodo di rollback, una data obiettivo e i criteri di accettazione. Responsabile e criteri di accettazione sono i campi che mancano più spesso.
Come si stabiliscono le priorità tra più piani di remediation aperti?
In base al rischio, non all'età del ticket. Valutate impatto sul business, esposizione normativa, criticità dei dati, probabilità di ricorrenza, numero di dipendenze e tempo prima del danno, poi risolvete per primo ciò che può nuocere prima, propagarsi di più o far fallire un controllo, prima di un problema che sembra soltanto disordinato.
Quando si può chiudere un piano di remediation?
Solo quando i criteri di accettazione sono soddisfatti, le evidenze sono conservate e il responsabile ha registrato l'approvazione. Rieseguire un processo è contenimento, non correzione, e l'assenza di alert da sola non dimostra nulla: per gli incidenti gravi serve quindi anche un monitoraggio dopo la chiusura sulle esecuzioni successive.


