Regole di validazione dei dati: guida pratica alla progettazione
|
5
min di lettura

Capite che una pipeline di dati è nei guai quando la dashboard è tecnicamente attiva, i numeri sono tecnicamente presenti e il business non riesce comunque a fidarsi di una sola riga sullo schermo. Basta un valore di riferimento errato, un campo mancante o un record che sfugge a un controllo troppo permissivo per trasformare la revisione del venerdì in uno scavo archeologico. Di solito è in quel momento che ci si rende conto che il problema non è il report, ma l'assenza di regole di validazione dei dati progettate, testate e governate come vero codice di produzione.
La validazione funziona meglio quando smettete di trattarla come un compito amministrativo e iniziate a trattarla come un contratto. L'impostazione di Eurostat è netta: se una combinazione di valori non appartiene all'insieme ammesso, il controllo fallisce, e la regola deve essere definita e documentata in modo univoco, così che produttori e consumatori condividano la stessa comprensione del controllo applicato; una base molto più solida per la verificabilità e la data governance rispetto a un vago filtro “best effort” (linee guida di Eurostat sulla validazione dei dati). Se volete vedere la stessa idea in un contesto di prodotto concreto, questa panoramica sulla validazione dei dati rende più tangibile il ciclo di vita senza edulcorare la realtà operativa.
Perché i vostri dati vi mentono in silenzio
I peggiori guasti dei dati raramente si annunciano. Un report si carica comunque, il grafico viene comunque visualizzato e tutti presumono che i numeri siano “abbastanza vicini”, finché un'anomalia non emerge durante una riunione e qualcuno deve spiegare perché i dati di ieri non coincidono con l'estrazione di oggi. I controlli manuali a campione non reggono questo tipo di problema, perché le righe errate di solito si nascondono tra quelle dall'aspetto normale.
La validazione è un patto, non un filtro
Ecco perché la validazione a livello di record è importante. Trasforma un'aspettativa vaga in una regola condivisa e offre ai team di engineering e di business lo stesso linguaggio per descrivere i guasti. Eurostat definisce la validazione dei dati come la verifica che una combinazione di valori appartenga a un insieme ammesso, e le sue linee guida stabiliscono che le regole devono essere definite in modo chiaro e univoco, documentate e adeguate allo scopo, così che tutti possano interpretare il risultato allo stesso modo (linee guida di Eurostat sulla validazione dei dati).
Una validazione fallita deve dirvi quale regola di business è stata violata, non solo che la riga ha infastidito il database.
Questa distinzione cambia il modo di lavorare dei team. Un record errato non è più semplicemente “dato sporco”: è la prova che un vincolo di business, un presupposto sullo schema o un obbligo di reporting è stato violato. È questo il valore fondamentale delle regole di validazione dei dati: creano punti di controllo misurabili invece di trasformare la qualità in una promessa generica.
Il vantaggio operativo è la prevedibilità. Quando le regole sono documentate e applicate in modo coerente, chi produce i dati sa cosa deve inviare e chi li consuma sa di quali dati può fidarsi. Se vi è mai capitato di vedere una pipeline “funzionare quasi sempre” per mesi prima che un caso limite nascosto facesse esplodere una dashboard, sapete già perché questa disciplina si ripaga da sola.
Anatomia delle regole di validazione a livello di record
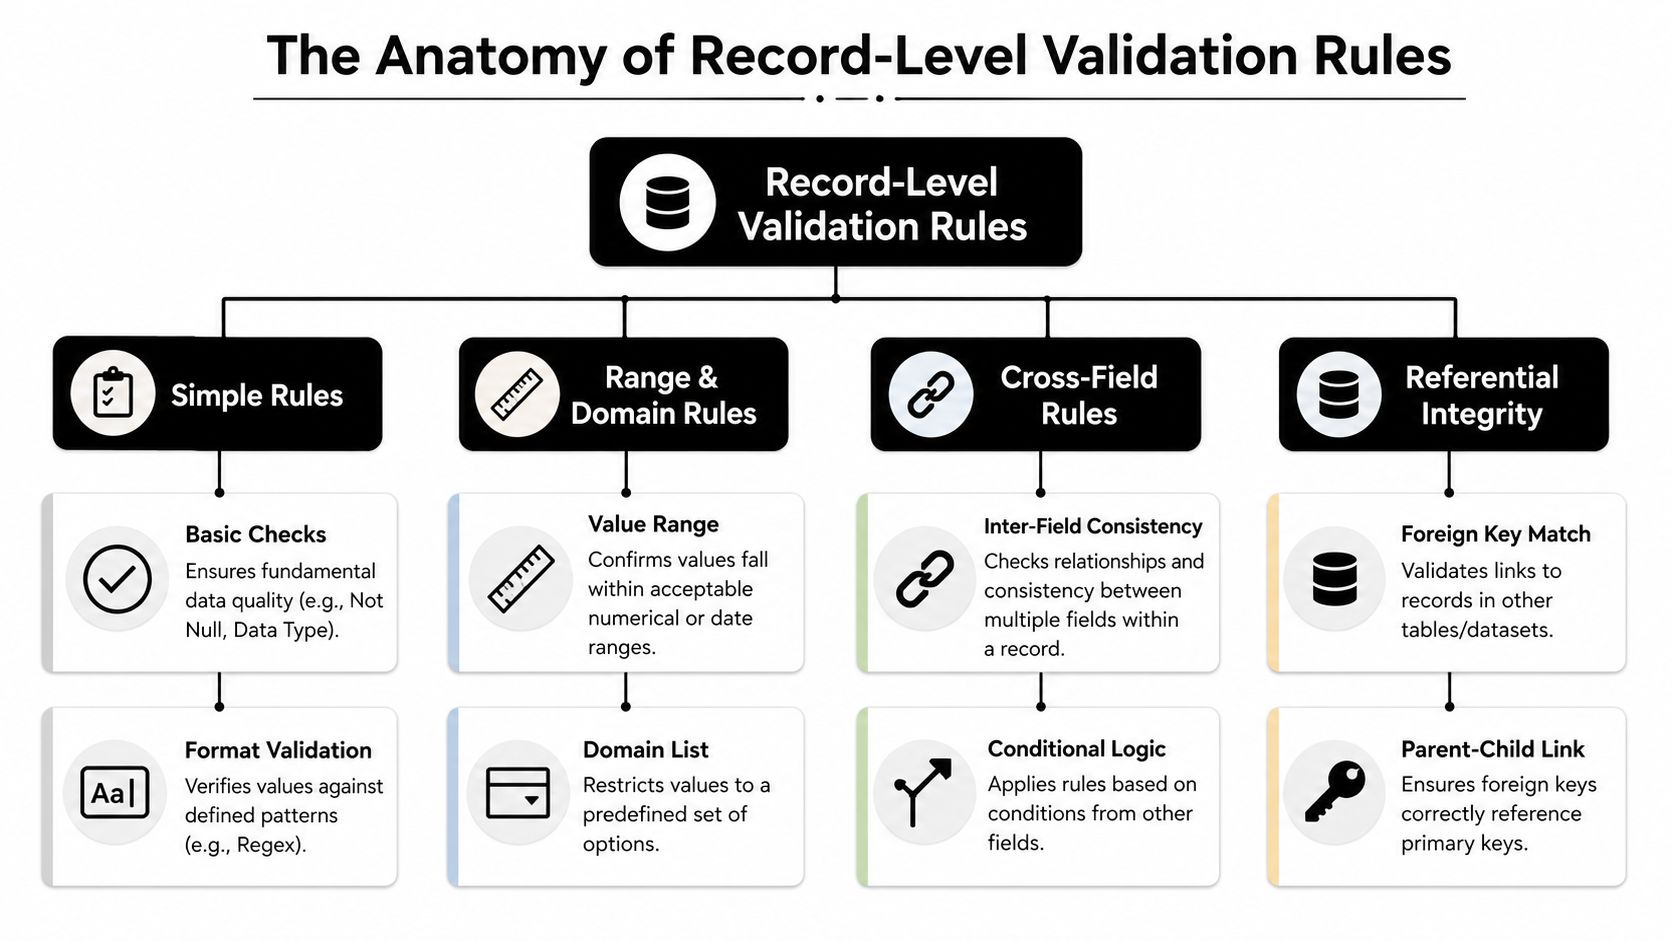
Prima di scrivere codice, vi serve una mappa delle famiglie di regole che userete. Il workflow standard raggruppa i controlli in validazione del formato, controlli di intervallo, validazione dello schema e validazione tra campi, un utile punto di partenza perché vi obbliga a separare i problemi di sintassi da quelli di logica di business (workflow di validazione dei dati di Atlan). Questa separazione mantiene il vostro framework comprensibile, il che conta più del sembrare sofisticati.
Iniziate dai controlli semplici
Le regole più semplici sono di solito le prime da mettere in produzione. I controlli su presenza di null, tipo di dato e formato intercettano quel genere di errori che costa poco rifiutare e molto ripulire in seguito. Se un indirizzo email non corrisponde allo schema previsto, o una data arriva nel formato sbagliato, non ha senso lasciare che quel record scivoli a valle solo perché il resto della riga sembra a posto.
Aggiungete poi vincoli numerici e di dominio
I controlli di intervallo sono il punto in cui la validazione inizia a somigliare a una policy di business più che a un'igiene dei campi. Un prezzo deve essere positivo, uno sconto non deve superare il prezzo e un campo età deve rientrare in un intervallo accettabile, se il dominio di business lo richiede. Nei workflow di cura degli animali domestici, la stessa logica è utile quando si tratta di garantire cartelle sanitarie degli animali conformi, perché un campo mancante o malformato può interrompere la catena di responsabilità anche quando il record “si carica”.
Non dimenticate le relazioni tra i campi
La validazione tra campi è il punto in cui di solito ci si scotta. Un paese di spedizione non può essere trattato isolatamente se un altro campo deve contenere un identificativo specifico per quel paese, e un flag di stato può avere senso solo se abbinato a una data o a un codice corrispondenti. Queste regole sono più difficili da scrivere rispetto ai controlli su un singolo campo, ma sono anche quelle che intercettano le contraddizioni sottili che altrimenti farebbero sembrare il reporting coerente al suo interno pur essendo sbagliato.
Regola pratica: se un campo ha senso solo nel suo contesto, validatelo nel suo contesto.
L'integrità referenziale si affianca alla logica tra campi, anche se sembra più una questione di database che di business. Una chiave esterna che non punta a una riga padre reale è comunque un guasto di business, non solo un problema di archiviazione. Ecco perché i set di regole di validazione specifici per dominio includono spesso controlli espliciti come prezzi positivi, assenza di osservazioni negative e osservazioni univoche, tutti scritti come condizioni verificabili dalla macchina che mantengono il QA automatizzato interpretabile per gli ingegneri (SNStatComp Domain Validation Rules).
Se vi serve uno schema enterprise più ampio, potete anche adottare una visione di piattaforma di questa anatomia. Il modello a livello di record dell'approccio di digna alla validazione enterprise è utile proprio perché collega queste famiglie di regole all'esecuzione all'interno del database, invece di lasciarle come note di policy astratte.
Dalla logica al codice
La teoria conta solo quando la regola riesce a rifiutare un ordine errato senza rendere più difficile l'elaborazione di quelli corretti. Supponiamo di validare un record orders in ingresso con order_id, customer_id, price, discount, shipping_country e nif. Volete che il codice sia abbastanza leggibile da non costringere il prossimo ingegnere a ricostruire le regole di business da un mucchio di effetti collaterali.
Rendete la regola evidente in SQL
Un vincolo CHECK pulito resta la migliore prima linea di difesa per la logica semplice sui campi.
In questo modo ottenete una modalità di errore netta per i casi ovvi. Inoltre la regola resta vicina al modello dei dati, il che è importante perché una regola di validazione nascosta nel codice applicativo è facile da dimenticare e difficile da verificare.
Usate la logica tra campi quando una colonna dipende da un'altra
Alcune regole non si adattano a un semplice CHECK perché richiedono un comportamento condizionale. In questo caso, un'espressione CASE o una logica in stile trigger è più chiara che cercare di comprimere l'intera regola di business in un unico predicato.
Questo schema rende la regola esplicita. Se il paese di spedizione è la Spagna, il record deve contenere l'identificativo previsto e, in caso contrario, ottenete un segnale di errore diretto invece di un'eccezione criptica a valle.
Verificate univocità e integrità referenziale con le query
I controlli di univocità sono più facili da mantenere quando sono scritti come diagnostiche dirette anziché come codice procedurale ingegnoso.
E l'integrità referenziale è altrettanto diretta.
Queste query sono noiose nel miglior senso possibile. Vi dicono esattamente cosa è fallito, ed è per questo che le regole di validazione specifiche per dominio vengono spesso implementate come controlli espliciti a livello di record, come prezzi positivi, assenza di osservazioni negative e osservazioni univoche, tutti eseguibili su grandi volumi pur restando interpretabili per gli ingegneri (SNStatComp Domain Validation Rules).
Se volete un esempio di piattaforma che segue questo stile, vale la pena leggere la riflessione di digna sulla manutenzione manuale delle regole insieme ai vostri schemi SQL, perché la domanda utile non è se la regola esista, ma con quanta sicurezza possa essere mantenuta nel tempo.
Fate in modo che il messaggio di errore sia utile
Una regola scadente con un messaggio vago crea solo lavoro in più. “Validazione fallita” non aiuta nessuno, mentre “shipping_country=ES richiede nif” offre all'analista e all'ingegnere lo stesso punto di partenza per il triage. In pratica, il messaggio fa parte della regola, non è una decorazione.
Oltre il “funziona”: strategie di test più intelligenti
Una regola di validazione non testata è solo una teoria con un budget di produzione. Trattatela come codice applicativo, perché è esattamente ciò che diventa nel momento in cui può bloccare dati, generare alert sui guasti o alimentare workflow di compliance. Il costo di un errore qui è pesante, perché una regola di validazione difettosa può rifiutare dati corretti o, peggio, lasciar passare dati errati con un certificato di buona salute.
Testate la regola a più livelli
Un approccio pratico parte in piccolo. I test unitari usano un insieme ridotto di record selezionati, alcuni validi e altri no, così che ogni regola possa essere verificata isolatamente. È lì che intercettate gli errori più evidenti: la soglia sbagliata di uno, il controllo sui null invertito o la regola che segnala per errore casi limite legittimi.
I test di integrazione appartengono alla pipeline stessa. Mostrano come si comportano le regole quando entrano in gioco staging, trasformazione e caricamento, ed è lì che molta logica ordinata inizia a comportarsi in modo disordinato. I test di regressione proteggono poi il comportamento esistente ogni volta che una regola cambia, così non “correggete” una validazione rompendone inavvertitamente altre tre.
Separate i guasti a livello di file da quelli a livello di record
Lo schema operativo più utile che abbia visto è quello usato nel transaction reporting dell'UE, in cui le regole di sintassi a livello di schema rifiutano l'intero file e le regole sul contenuto rifiutano solo le transazioni non valide. Questa suddivisione riduce il raggio d'impatto e limita i reinvii non necessari (regole di validazione ESMA per il transaction reporting MiFIR).
Non fate pagare a un intero batch il prezzo di una sola riga errata, a meno che non sia la struttura stessa a essere compromessa.
Questo principio è facile da enunciare e sorprendentemente facile da ignorare. Se il file è malformato, fermatevi subito. Se solo una transazione viola la logica di business, mettete in quarantena o segnalate il record e lasciate proseguire il resto, sempre che il vostro processo e i requisiti di compliance lo consentano.
Per l'analisi delle cause principali, questa guida all'analisi dei problemi dei dati con l'AI può aiutare i team a passare da “qualcosa è fallito” a “è stato questo schema specifico a causarlo”, senza trasformare ogni incidente in un'indagine manuale.
Una semplice matrice di test
Percorso valido standard: l'ordine deve superare tutte le regole.
Record errato noto: l'ordine deve fallire esattamente una regola specifica.
Caso limite: la regola deve comportarsi correttamente sul valore di confine.
Campione di regressione: un record accettato in precedenza deve restare accettato dopo la modifica di una regola.
Questo basta a mantenere onesta la regola senza complicare troppo l'infrastruttura di test. Se non sapete spiegare perché un test esiste, probabilmente non vi serve.
Distribuire e gestire le regole senza mal di testa
Scrivere le regole è la parte facile. Conviverci è il punto in cui inizia il vero lavoro di progettazione, perché ogni cambiamento della policy di business rischia di rompere vecchi presupposti. Un framework di validazione che non può essere versionato, spiegato e rieseguito in sicurezza finirà per diventare la cosa che tutti evitano di toccare.
Scegliete consapevolmente il vostro modello di deployment
Il guardiano rigoroso blocca i record errati prima che entrino nei sistemi a valle. È la scelta giusta per pipeline ad alta affidabilità, reporting regolamentare e tutto ciò che creerebbe problemi se i dati non validi si diffondessero ulteriormente.
L'osservatore attento lascia passare i dati ma segnala, mette in quarantena o instrada i guasti per la revisione. È utile quando la disponibilità conta più del rifiuto immediato, o quando dovete osservare la forma del problema prima di irrigidire il controllo.
Nessuno dei due modelli è giusto in assoluto. Il guardiano vi offre un controllo più stretto, mentre il monitoraggio vi garantisce resilienza e visibilità. La maggior parte dei team maturi finisce per usarli entrambi, perché non tutti i dataset meritano lo stesso livello di attrito.
Rendete esplicito il ciclo di vita delle regole
Una regola deve avere una versione, una nota di modifica e un responsabile chiaro. Le servono anche log che mostrino quando è stata eseguita, cosa ha valutato e come è fallita o è stata superata, perché è l'unico modo per supportare gli audit senza trasformare ogni incidente in un romanzo giallo. Anche qui le linee guida di Eurostat sono utili, perché stabiliscono che le regole e persino i loro messaggi di errore devono essere documentati, così che tutti interpretino i guasti allo stesso modo (principi di Eurostat).
Il grande problema di manutenzione è la deriva delle regole. La policy di business cambia, i sistemi sorgente evolvono e quella che un tempo era una soglia sensata può trasformarsi in un fastidio o in un punto cieco. Il workflow di validazione di ArcGIS ricorda bene che la validazione è operativa, non statica, perché le regole spesso richiedono valutazione, ispezione e rivalutazione dopo le modifiche, soprattutto quando schemi e condizioni di reporting cambiano nel tempo (regole di attributo di validazione di ArcGIS).
Dove una piattaforma può ridurre la fatica
Una piattaforma può aiutare quando il volume di regole, sistemi ed eccezioni inizia a superare ciò che fogli di calcolo e script ad hoc possono gestire. Un'opzione è digna, che usa una logica di validazione deterministica, di business e tecnica, con esecuzione delle regole in-database e audit trail completi, così che i controlli vengano eseguiti dove risiedono i dati e le evidenze vengano conservate per la compliance e le verifiche regolamentari (introduzione alla piattaforma digna).
Questo conta perché la validazione è utile solo se le persone possono fidarsi sia del risultato sia del processo. Una buona interfaccia è comoda, ma il vantaggio più profondo è la tracciabilità, cioè la capacità di rispondere a chi ha modificato cosa, cosa è fallito e perché il record è stato gestito in quel modo.
Se state anche confrontando opzioni di observability e di applicazione delle regole, proteggere i dati della vostra ricerca è una lettura affine utile, perché mantiene l'attenzione sull'integrità e non solo sull'alerting.
L'obiettivo finale: la validazione come pilastro della fiducia nei dati
Una buona regola nasce come esigenza di business, diventa codice, viene testata e alla fine vive come asset di produzione monitorato, con un responsabile e un audit trail. Questo ciclo di vita è la differenza tra controlli casuali e una vera postura di governance. Quando l'organizzazione vede la validazione come un sistema e non come una toppa, la fiducia diventa più facile da conquistare e da difendere.
I team più sani smettono di chiedersi se debbano validare i dati e iniziano a chiedersi dove debba stare ogni regola, come venga versionata e cosa succeda quando fallisce. È questo cambiamento che trasforma i data engineer in custodi dell'integrità invece che in squadre di pulizia. Se vi serve un inquadramento più ampio a livello di cultura aziendale, questa guida per costruire abitudini di qualità dei dati collega in modo utile i controlli tecnici alla responsabilità quotidiana.
L'obiettivo finale non sono dati perfetti, perché non esistono. L'obiettivo finale sono dati prevedibili, eccezioni visibili e un processo che dica la verità abbastanza in fretta da permettere ad analisti, auditor e operatori di agire. Una volta che questi elementi sono al loro posto, la validazione smette di essere un costo aggiuntivo e diventa una delle ragioni silenziose per cui analytics, compliance e automazione stanno in piedi.
Scoprite digna.
Per eseguire queste regole a livello di record all'interno del database, con un audit trail di cosa è fallito e perché, scoprite digna Data Validation.
Domande frequenti
Quali sono i principali tipi di regole di validazione dei dati?
L'articolo raggruppa le regole in validazione del formato, controlli di intervallo, validazione dello schema e validazione tra campi, con l'integrità referenziale al loro fianco. Iniziate con semplici controlli su null, tipo e formato, aggiungete vincoli numerici e di dominio come i prezzi positivi, poi scrivete regole tra campi per i campi che hanno senso solo nel loro contesto.
Come si scrive una regola di validazione dei dati in SQL?
Per la logica semplice sui campi, usate un vincolo CHECK nella definizione della tabella, come CHECK (price > 0) o CHECK (discount <= price). Le regole condizionali si adattano meglio a un'espressione CASE, ad esempio facendo fallire un ordine quando shipping_country = 'ES' e nif IS NULL, il che mantiene esplicita la regola di business.
Come si testano le regole di validazione dei dati?
Testatele come codice applicativo, a più livelli: test unitari su piccoli insiemi selezionati di record validi e non validi, test di integrazione all'interno della pipeline e test di regressione ogni volta che una regola cambia. Una semplice matrice copre un percorso valido standard, un record errato noto, un caso limite e un campione di regressione.
Un errore di validazione deve far rifiutare l'intero file?
Solo quando è la struttura stessa a essere compromessa. Secondo la prassi del transaction reporting MiFIR dell'UE, gli errori di sintassi a livello di schema fanno rifiutare l'intero file, mentre le violazioni delle regole sul contenuto fanno rifiutare solo le transazioni non valide. Questa suddivisione mantiene ridotto il raggio d'impatto ed evita reinvii non necessari quando una singola riga viola la logica di business.
Qual è la differenza tra validazione “guardiano” e validazione “osservatore”?
Il guardiano rigoroso blocca i record errati prima che raggiungano i sistemi a valle ed è adatto al reporting regolamentare e alle pipeline ad alta affidabilità. L'osservatore attento lascia passare i dati ma segnala, mette in quarantena o instrada i guasti per la revisione, il che è indicato quando la disponibilità conta di più. La maggior parte dei team maturi usa entrambi, perché non tutti i dataset meritano lo stesso livello di attrito.


