Profilage automatisé des données pour des plateformes fiables
|
7
minute de lecture

Le dashboard se charge toujours. Les traitements de nuit se sont terminés et personne n'a signalé d'erreur. Puis un analyste métier remarque qu'une catégorie de clients familière a presque disparu de la table sous-jacente. Vos contrôles sont au vert parce qu'ils vérifient que le pipeline a tourné, pas que les données se comportent toujours comme prévu.
Table des matières
Pourquoi le profilage manuel des données ne tient pas à grande échelle
Ce que mesure réellement le profilage automatisé des données
Pourquoi le profilage manuel des données ne tient pas à grande échelle
Prenons l'entrepôt de données d'un organisme de sécurité sociale où les ingénieurs maintiennent une vaste collection de contrôles écrits à la main. Certains valident des dossiers de prestations, d'autres vérifient des dates de livraison, d'autres encore imposent des hypothèses héritées de systèmes décommissionnés. Il s'agit d'un schéma opérationnel illustratif, pas d'un cas client documenté.
Chaque contrôle avait sans doute du sens au moment où il a été écrit. La difficulté consiste à préserver ce sens alors que les systèmes sources, les exigences de reporting et les responsabilités au sein des équipes évoluent.
Un ingénieur part, mais son SQL reste. Un nouveau flux arrive, et l'équipe copie un jeu de règles existant sans savoir quelles hypothèses s'appliquent. Les analystes ajoutent des contrôles après chaque incident, tandis que des contrôles obsolètes continuent de produire des alertes.
Couvrir par des règles n'est pas comprendre les données
Un jeu de règles statique répond aux questions que quelqu'un savait déjà poser. Il ne révèle pas forcément une catégorie inconnue, une distribution qui a changé ou un champ dont la signification réelle diffère de son nom.
Les symptômes opérationnels sont faciles à reconnaître :
Couverture partielle : Les tables importantes ont des contrôles, mais ceux-ci couvrent certains modes de défaillance plutôt que le comportement observé de la table.
Responsabilité floue : Les ingénieurs retrouvent la règle sans trouver personne capable d'en expliquer la finalité métier.
Fatigue d'alertes : Les relecteurs reçoivent sans cesse des notifications de faible valeur et sont de moins en moins enclins à examiner la suivante.
Ce sont des façons utiles d'aborder les problèmes opérationnels de données : non comme des valeurs erronées, mais comme des écarts entre ce que les équipes mesurent et ce dont les utilisateurs en aval ont besoin.
Découvrir avant de prescrire
Le profilage automatisé des données part d'une autre question : que contient réellement ce jeu de données ? Il transforme une table inconnue en objet mesurable avant que des analystes, des outils statistiques ou des modèles n'en dépendent.
Cela ne supprime pas les règles métier. Cela réduit la quantité de SQL exploratoire que les ingénieurs doivent écrire avant de pouvoir décider quelles règles sont justifiées.
Règle pratique : Conservez les exigences métier explicites, mais n'obligez pas les ingénieurs à anticiper chaque changement observable avant que la surveillance puisse commencer.
Le choix d'architecture compte aussi. Pour des données d'entreprise sensibles, je recommande d'apprendre et de maintenir ces mesures au sein de l'environnement du client. La découverte ne devrait pas exiger d'exporter des données de production vers un scanner hébergé.
Le résultat utile n'est pas un inventaire de contrôles plus grand. C'est une référence maintenue, un relecteur responsable et des éléments probants qui aident à distinguer un changement significatif d'une variation habituelle.
Ce que mesure réellement le profilage automatisé des données
Partez d'une table d'entrepôt inconnue. Vous pouvez lire son schéma, mais les types déclarés ne vous diront pas si les champs sont renseignés, si les identifiants se répètent ou si les valeurs textuelles suivent des motifs cohérents.
L'article de référence Data Profiling Revisited, publié en 2013, décrit le profilage comme l'examen de caractéristiques des données telles que les types de colonnes, le nombre de valeurs nulles, le nombre de valeurs distinctes et les motifs fréquents. Il explique aussi comment le profilage soutient la vérification des contraintes et la configuration ultérieure d'outils statistiques ou de data mining.
Apprendre la forme observable
Voyez un profil comme le plan d'un bâtiment accompagné d'un comptage de son occupation. Il décrit les pièces et l'endroit où se trouvent les personnes, mais n'explique pas pourquoi elles sont entrées dans le bâtiment.
De même, un profil peut montrer qu'une colonne de statut contient des valeurs inconnues. Il ne peut pas établir si ces valeurs correspondent à un changement métier approuvé.

Une première inspection doit établir :
Structure : Quelles colonnes existent et quels types de données leurs valeurs prennent en charge.
Remplissage : Où des valeurs manquent et combien de valeurs distinctes apparaissent.
Forme : Quelles plages, quels formats récurrents et quelles valeurs fréquentes caractérisent la table.
Ces mesures donnent aux ingénieurs un point de départ pour la découverte. Un champ texte ressemblant à une date peut mériter un examen plus attentif ; un identifiant client fréquemment répété peut être attendu dans des transactions, mais suspect dans un référentiel clients.
Conserver des preuves, pas seulement un rapport
Les mesures fondamentales - complétude, unicité, conformité des types, fréquence et distribution - s'appliquent aux bases relationnelles, aux entrepôts, aux data lakes et aux fichiers analytiques. La technologie de stockage change la méthode d'exécution, pas les questions posées.
Conservez le profil obtenu comme référence pour les observations suivantes. Consignez la source et les conditions dans lesquelles il a été produit, plutôt que de garder uniquement un graphique que personne ne pourra reproduire plus tard.
Pour les équipes qui formalisent cette traçabilité, le guide de Fetchin sur la provenance des données est une ressource complémentaire utile. La provenance doit accompagner les résultats statistiques, car les relecteurs doivent comprendre d'où viennent les éléments probants.
La limite pratique est importante : un comportement observé n'est pas automatiquement un comportement correct. Le profilage fournit des éléments pour une décision, pas l'autorisation de transformer chaque motif courant en exigence imposée.
Techniques de profilage et métriques de qualité
Un profileur mature doit faire plus que compter les valeurs manquantes. Dans une évaluation systématique de 13 outils de qualité des données, le profilage de base était largement pris en charge, tandis que les fonctions avancées de dépendances et multicolonnes n'apparaissaient que dans quelques outils isolés, comme le décrit l'évaluation Frontiers des outils de qualité des données.
Adapter les preuves à la question
Organisez la collecte autour de ces classes de preuves :
Classe de preuves | Calculs utiles et interprétation |
|---|---|
Cardinalités d'une seule colonne | Le nombre de valeurs distinctes et de doublons révèle les répétitions et une unicité possible. |
Distributions de valeurs | Quantiles, histogrammes de fréquence et taux de valeurs aberrantes décrivent la concentration et la dispersion. |
Types de données et motifs | Les types sémantiques inférés et les régularités de format distinguent la représentation de stockage de la signification probable. |
Domaines | Les ensembles de valeurs observés suggèrent des valeurs autorisées candidates à examiner. |
Relations entre colonnes et multicolonnes | Les clés candidates et les dépendances fonctionnelles révèlent de possibles contraintes d'intégrité. |
Incluez explicitement les taux de valeurs nulles et vides. Une chaîne vide et un null de base de données peuvent nécessiter un traitement différent ; documentez donc toute décision de les fusionner.

Arbitrer entre couverture et coût d'analyse
Versionnez les mesures par table, colonne, partition et date d'observation. Sinon, les relecteurs ne pourront pas distinguer de façon fiable un décalage durable de distribution d'un problème isolé sur une partition.
Les comptages exacts de valeurs distinctes et les tests exhaustifs de dépendances par paires peuvent coûter cher sur de grands jeux de données. Les sketches approximatifs, les échantillons stratifiés et les profils incrémentaux sont des alternatives raisonnables, mais validez les approximations par des calculs exacts sur les jeux de données critiques.
Le choix doit dépendre des conséquences d'une erreur. La découverte exploratoire tolère une incertitude qu'un contrôle d'intégrité réglementaire ne peut pas accepter.
La politique de gestion des données de Queensland Health inclut l'exactitude, la validité, la fiabilité, l'actualité, la pertinence, la complétude et l'unicité dans son périmètre qualité. Cette amplitude est un correctif utile au moment de choisir des métriques de qualité des données : les statistiques faciles à calculer ne devraient pas définir tout le programme.
Transformer les constats en contrôles
Un domaine inféré et approuvé peut devenir une règle de validation. Une clé candidate confirmée peut devenir un contrôle d'intégrité, tandis qu'une référence de distribution peut alimenter la détection d'anomalies.
Le rapprochement métier exige toujours une logique propre au domaine. Par exemple, les équipes qui rapprochent les écritures bancaires des enregistrements comptables avec Charter AI traitent une tâche d'appariement métier, et ne se contentent pas de compter des références de transaction distinctes.
Gardez cette distinction claire. Le profilage aide à identifier ce qui mérite un contrôle ; les responsables métier déterminent ce que ce contrôle doit signifier.
Quand plus de profils créent plus de bruit
Collecter toutes les statistiques disponibles n'améliore pas automatiquement les décisions. Si personne ne peut expliquer quels écarts comptent, les ingénieurs ont automatisé la production de notifications plutôt qu'une surveillance fiable.
Le comportement normal peut varier selon le jour de la semaine, la fin de mois, la saison, le cycle de mise en production ou un événement métier. Comparer chaque chargement à une moyenne historique indifférenciée peut faire passer un changement attendu pour un défaut.
Séparer données manquantes et données erronées
Le cadre de qualité des données du gouvernement britannique distingue la complétude de l'exactitude. Un jeu de données peut contenir tous les enregistrements attendus et comporter malgré tout des valeurs incorrectes.
Mesurez séparément la présence des lignes, l'absence de valeurs au niveau des champs et l'exactitude des valeurs. Si une livraison n'est pas terminée, un apparent problème de complétude peut nécessiter une enquête sur le pipeline plutôt qu'une correction des enregistrements.
Un changement de métrique est une observation. Le qualifier de défaut exige du contexte.
Les résultats 2025 réunis dans le State of Enterprise Data and AI d'Atlan illustrent ce problème de contexte : 97 % des organisations signalaient des lacunes en matière de définitions, de qualité et de confiance, tandis que 52 % citaient des préoccupations de sécurité et d'accès aux données sensibles. La même source indique que les dirigeants évaluaient la maturité data de leur organisation 12 % plus haut que les praticiens, alors que près de 90 % des professionnels de la donnée peinaient face au passage à l'échelle et à la complexité.
Ces résultats plaident pour une posture opérationnelle prudente : ne partez pas du principe que des mesures supplémentaires résolvent les désaccords sur le sens ou le niveau de préparation.

Intégrer le temps et l'impact dans le tri
Utilisez des références tenant compte du temps et des seuils adaptatifs là où le comportement attendu varie. Examinez explicitement les faux positifs, en consignant si une alerte a mené à un défaut confirmé, à un changement métier accepté ou à une investigation sans éléments suffisants.
La modélisation de l'arrivée attendue aide à distinguer des fenêtres d'observation incomplètes de chargements terminés. Un tri tenant compte du lignage doit relier l'écart aux retards de livraison, aux changements de schéma et aux rapports ou modèles en aval exposés.
Présentez ces relations dans des dashboards de qualité des données, plutôt que d'afficher un indicateur rouge inexpliqué. Un relecteur doit voir ce qui a changé, à qui cela appartient et quelle action est possible.
Être prêt pour l'IA exige plus qu'une normalité statistique. Sans définitions sémantiques, sans responsables et sans parcours de correction, un profil techniquement détaillé ne garantit pas des données d'entraînement ou opérationnelles dignes de confiance.
Comment choisir un profilage dans la base de données
Pour les charges de travail sensibles, faites de l'exécution contrôlée par le client une exigence de conception. Décidez où les requêtes s'exécutent, quelle identité les exécute et quels éléments peuvent sortir avant de comparer les fonctionnalités d'interface.
Une enquête 2025 sur l'IA en entreprise relayée par CIO Dive a interrogé 1 050 dirigeants d'entreprise et a identifié les contraintes de confidentialité et de conformité, les doublons et une intégration inefficace parmi les principaux problèmes de données. Moins de la moitié jugeaient leurs objectifs d'IA atteignables.
Où le profilage automatisé doit s'exécuter
Question de décision | Dans la base de données, au sein de l'environnement du client | Analyse hébergée en externe |
|---|---|---|
Où les valeurs sont-elles examinées ? | À l'intérieur du périmètre contrôlé de la base de données. | Dans l'environnement d'analyse hébergé, si les enregistrements y sont transférés. |
Qu'est-ce qui peut sortir ? | Définir une politique explicite pour les métriques calculées et les métadonnées. | Évaluer les enregistrements exportés, les échantillons conservés et les métadonnées dérivées. |
Quels droits d'accès s'appliquent ? | Utiliser une identité d'exécution dédiée, aux privilèges minimaux. | Examiner les permissions du connecteur et le modèle d'accès du service hébergé. |
Comment la charge est-elle gérée ? | Planifier les requêtes en fonction de la capacité de la base. | Tenir compte de la charge d'extraction, du transfert et du traitement externe. |
Qu'est-ce qui doit être audité ? | L'exécution en base et les décisions de profilage. | Extraction, accès externe, conservation et décisions de profilage. |
Un plan de contrôle hébergé n'est pas nécessairement un scanner hébergé. Demandez précisément où les enregistrements sont traités plutôt que de vous fier à une étiquette de déploiement.
Tester la vue autorisée
Le travail peut-il rester dans l'environnement d'une banque, d'un hôpital, d'un opérateur télécom ou d'un organisme public ? Quelles métadonnées peuvent sortir, et qui approuve cette décision ?
Testez séparément les entrées chiffrées, masquées, tokenisées et soumises à des autorisations au niveau des lignes. Une politique de tokenisation modifiée ou une vue de lignes restreinte ne doit pas être classée à tort comme un défaut des données sources ; le profileur ne peut décrire que la représentation que son identité est autorisée à observer.
Exigez des preuves d'audit portant sur le périmètre, l'identité, l'horodatage, la version de la règle, la décision d'accès et l'historique de correction. L'exécution dans la base ne dispense ni de contrôles d'accès ni de gestion des ressources.
Une option au sein de votre environnement
Le traitement dans la base de données de digna est une option pour ce modèle d'exécution. Les contrôles et le calcul des métriques restent dans la base de données du client, le déploiement se fait en cloud privé ou sur site, et l'éditeur n'accède pas aux données de production.
Ses modules couvrent des références d'anomalies apprises sans construire chaque contrôle à la main, les tendances historiques des métriques, les délais de livraison attendus, la validation au niveau des enregistrements et les colonnes ajoutées, supprimées ou dont le type a changé. Le module initial comprend un dashboard partagé, un planificateur, un catalogue, des intégrations et des fonctions de collaboration.
Le modèle commercial associe un forfait de base à un tarif par table active et par module, sans frais d'appels API, d'analyses ou de volume d'alertes. L'éditeur annonce des premiers résultats en moins de deux heures ; considérez-le comme une promesse d'onboarding à vérifier pendant l'évaluation au regard de votre connectivité, de vos droits d'accès et de votre charge.
Workflows d'entreprise pour le profilage et la surveillance
Commencez par un profil de référence, pas par un éditeur de règles vide. Dans une étude évaluée par les pairs de 2022 sur la surveillance par profils de référence, des chercheurs ont mis en œuvre DQ-MeeRKat et l'ont évalué sur six flux de données réels issus de dispositifs télématiques.
La méthode apprenait automatiquement des ensembles de statistiques de profilage pour modéliser la qualité cible. Elle permettait une initialisation par surveillance continue, sans exiger que des experts métier écrivent chaque règle à l'avance.
Orienter chaque observation vers le bon examen
Initialisez la référence, demandez à un expert métier d'en évaluer la pertinence et comparez les chargements entrants avec la version approuvée. Gardez la comparaison et la réponse opérationnelle reliées.
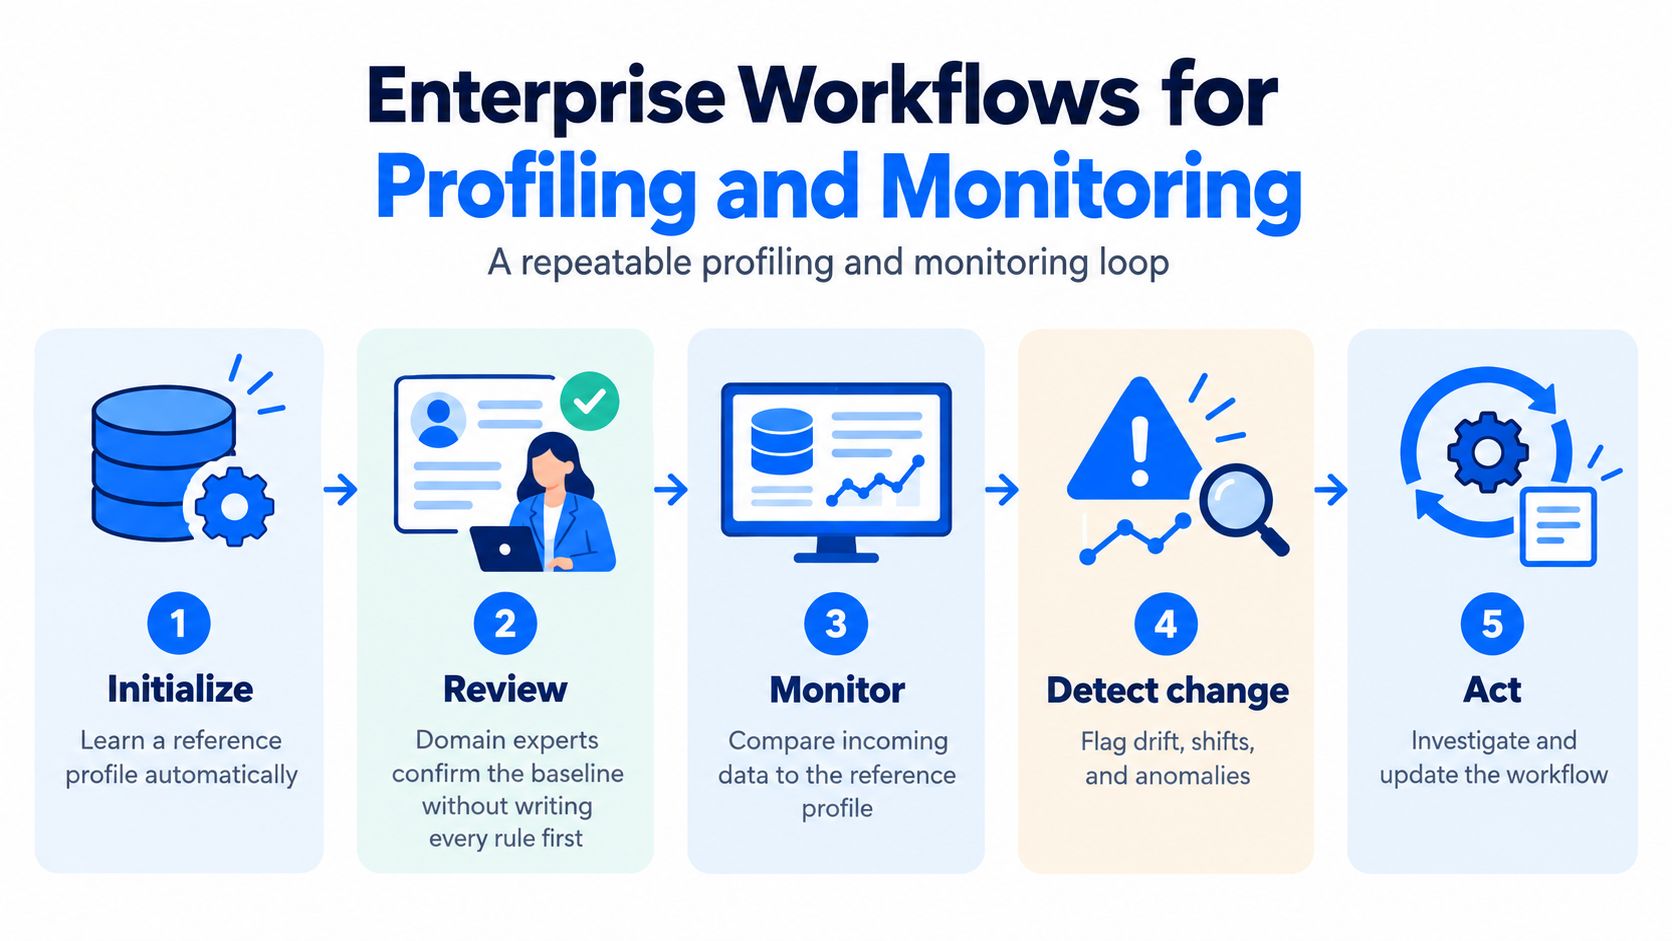
Utilisez des circuits de transmission distincts plutôt que d'envoyer chaque observation dans la même file :
Écart de distribution : Confiez un examen des anomalies pour déterminer si l'activité a changé ou si le pipeline a introduit un défaut.
Livraison manquante ou anticipée : Transmettez à un examen de ponctualité avec le délai de livraison attendu et la preuve de l'arrivée effective.
Violation présumée d'une règle métier : Lancez une validation au niveau des enregistrements pour identifier les enregistrements concernés.
Colonnes ajoutées, supprimées ou retypées : Ouvrez un examen du schéma avant que les transformations dépendantes ne se poursuivent.
Les exigences sectorielles déterminent l'escalade. Dans les services financiers, priorisez les flux de risque et réglementaires avant le reporting ; dans la santé, distinguez les besoins de livraison cliniques et opérationnels.
Les équipes télécoms doivent relier les écarts sur des données clients à fort volume aux retards du pipeline. Les équipes du secteur public doivent conserver des décisions traçables et des preuves prêtes pour l'audit.
Garder l'incertitude visible
Les valeurs manquantes peuvent produire de fausses dépendances fonctionnelles. Des travaux sur la découverte automatisée de schémas et de dépendances rapportent aussi une évaluation dans laquelle la part de schémas générés exacts et complets est passée de 60 % à 72 % lorsque le système renvoyait les cinq meilleurs candidats au lieu d'un seul résultat.
Cela plaide pour des hypothèses classées, des scores de confiance et une validation humaine, plutôt que l'acceptation automatique de la première réponse venue. Les relecteurs doivent voir les alternatives plausibles lorsque des noms, types, clés ou relations sont incertains.
Frontière d'approbation : Laissez l'automatisation proposer l'interprétation. Faites approuver les contraintes à fort impact par une personne responsable.
Une plateforme intégrée peut héberger ce flux sans devenir propriétaire du sens métier. Définissez des responsabilités de surveillance et de reporting afin que les ingénieurs gèrent l'exécution, que les responsables métier évaluent le sens et que les relecteurs de la gouvernance puissent reconstituer les décisions.
Ne clôturez un incident que lorsque quelqu'un a consigné la cause, l'action et la décision relative à la référence. Un changement métier accepté peut justifier la mise à jour de la référence ; un défaut du pipeline ne doit pas être absorbé dans le comportement normal.
Démarrer le profilage automatisé sur les tables critiques
Choisissez une table critique dont la défaillance casserait un rapport, un modèle ou une sortie réglementaire. Privilégiez une table dotée d'un responsable métier identifiable et d'un ingénieur qui connaît son circuit de livraison.
Notez la décision qu'elle soutient et ce que signifierait une défaillance. Les relecteurs disposent ainsi d'une base concrète pour prioriser les constats, au lieu de traiter chaque écart comme également urgent.
Définir le premier périmètre opérationnel
Profilez la table sur place et conservez les éléments nécessaires pour répéter l'inspection. Gardez ensemble l'instantané, la requête source ou la politique d'échantillonnage, la version de l'algorithme, le niveau de confiance et la décision d'approbation.
Ne faites pas passer directement en production une clé, un type ou une dépendance à faible confiance. Demandez au responsable d'expliquer si la contrainte proposée reflète une exigence ou simplement un motif de l'échantillon observé.

Rendre l'examen reproductible
Donnez au pilote un accord opérationnel restreint et explicite :
Nommer les relecteurs : Désignez le data engineer et le responsable métier avant d'activer les notifications.
Définir la réponse : Précisez qui examine une observation et qui peut approuver un changement de référence.
Protéger les usages en aval : Décidez quels changements de schéma doivent être examinés avant que les traitements dépendants ne consomment la table.
Conserver le résultat : Consignez si l'incident relevait d'un problème de livraison, de données défectueuses ou d'un changement accepté.
Comparez chaque nouveau chargement à la référence approuvée. Distinguez une arrivée tardive d'un véritable changement de distribution, et examinez les changements structurels avant de les juger anodins.
Examinez ensemble le premier incident explicable. L'ingénieur doit pouvoir montrer ce qui s'est passé dans le pipeline, et le responsable métier décrire la conséquence pour le processus consommateur.
N'étendez la couverture module par module qu'une fois cette boucle rodée. Plus de couverture est utile lorsque l'équipe peut enquêter et agir, pas seulement lorsqu'elle peut générer davantage d'observations.
Pour un déploiement circonscrit, installez la plateforme dans votre cloud, VPC ou centre de données existant, inspectez la table choisie et examinez les anomalies, la ponctualité et l'état du schéma dans le dashboard partagé. Gardez cet examen suffisamment ciblé pour que l'équipe puisse prendre et documenter une décision.
digna propose pour ce modèle opérationnel l'apprentissage de références au sein de votre environnement, la surveillance des anomalies, des contrôles de ponctualité, la validation des enregistrements et le suivi des schémas. Rendez-vous sur digna pour évaluer la plateforme sur une table critique, puis examinez les premiers résultats avec votre data engineer et votre responsable métier avant d'étendre la couverture.
Une fois le profil de référence établi, l'étape suivante consiste à le maintenir à jour sans écrire une règle par colonne : le module Data Anomalies de digna apprend les volumes, distributions et taux de valeurs nulles habituels de chaque table et signale les écarts à l'arrivée de chaque nouveau chargement, si bien que la référence devient une détection continue plutôt qu'un rapport ponctuel.
Questions fréquentes
Qu'est-ce que le profilage automatisé des données ?
Le profilage automatisé des données mesure systématiquement ce que contient réellement un jeu de données - types de colonnes, valeurs nulles, valeurs distinctes, motifs fréquents, plages et distributions - avant que des analystes ou des modèles ne s'appuient dessus. Il produit une référence stockée à laquelle comparer les chargements suivants, et non un rapport ponctuel impossible à reproduire.
Pourquoi les règles de qualité des données écrites à la main ne tiennent-elles plus à grande échelle ?
Les règles statiques ne répondent qu'aux questions que quelqu'un a déjà pensé à poser. Quand les sources, les rapports et les responsables changent, on obtient une couverture partielle, du SQL que plus personne ne sait expliquer après le départ de son auteur et une fatigue d'alertes liée aux contrôles obsolètes, tandis que nouvelles catégories et distributions décalées passent inaperçues.
Quelles métriques un profil de données doit-il inclure ?
Un profil utile couvre la complétude, l'unicité, la conformité des types, la fréquence et la distribution, ainsi que des taux explicites de valeurs nulles et vides, car une chaîne vide et un null de base de données peuvent exiger un traitement différent. Les profileurs matures ajoutent domaines, clés candidates et dépendances fonctionnelles, versionnés par table, colonne, partition et date d'observation.
Comment réduire les fausses alertes du profilage des données ?
En utilisant des références tenant compte du temps et des seuils adaptatifs, car le comportement normal varie selon le jour de la semaine, la fin de mois, la saison ou le cycle de mise en production. Séparez données manquantes et données erronées, modélisez l'arrivée attendue et consignez si chaque alerte a révélé un défaut confirmé, un changement accepté ou une investigation non concluante.
Le profilage des données doit-il s'exécuter dans la base de données ou dans un scanner hébergé ?
Pour des données d'entreprise sensibles, le profilage dans la base de données, au sein de l'environnement du client, est le choix le plus sûr. Les valeurs restent dans le périmètre contrôlé, une identité à privilèges minimaux exécute les requêtes et seules les métriques calculées en sortent selon une politique explicite ; un scanner externe impose d'évaluer exports, échantillons conservés et droits du connecteur.


