Observabilité vs monitoring : un guide pratique pour décider
|
7
minute de lecture

Le mauvais conseil dans ce débat est simple : choisir l'observabilité et mettre le monitoring à la retraite. Cela sonne moderne, mais c'est une erreur pour les vraies équipes data. Le monitoring est votre couche de contrôle, l'observabilité votre couche de diagnostic, et la bonne réponse dépend du coût d'une erreur pour chaque workload.
Critère de décision | Monitoring | Observabilité |
|---|---|---|
Rôle principal | Détecter des états de défaillance connus | Expliquer des pannes inconnues ou multifactorielles |
Meilleures preuves | Seuils, alertes, signaux stables | Métriques, logs, traces et contexte corrélés |
Auditabilité | Élevée lorsque les contrôles sont explicites | Plus faible si elle remplace les contrôles explicites |
Profil de coûts | Plus faible et plus ciblé | Plus élevé et plus large |
Cas d'usage idéal | Modes de défaillance stables et bien compris | Pannes complexes, distribuées ou à fort rayon d'impact |
Table des matières
Pourquoi le débat observabilité vs monitoring passe à côté de la vraie question
Là où la détection d'anomalies par IA et le suivi de schéma font leurs preuves
Fragmentation des outils et vrais obstacles à une couverture unifiée
Un modèle opérationnel hybride et ses implications par secteur
Pourquoi le débat observabilité vs monitoring passe à côté de la vraie question
Le débat est généralement présenté comme une course de chevaux, comme si une discipline devait remplacer l'autre. C'est un raccourci paresseux. Le monitoring et l'observabilité résolvent des problèmes différents, et une mauvaise substitution crée des angles morts au lieu d'apporter de la clarté.
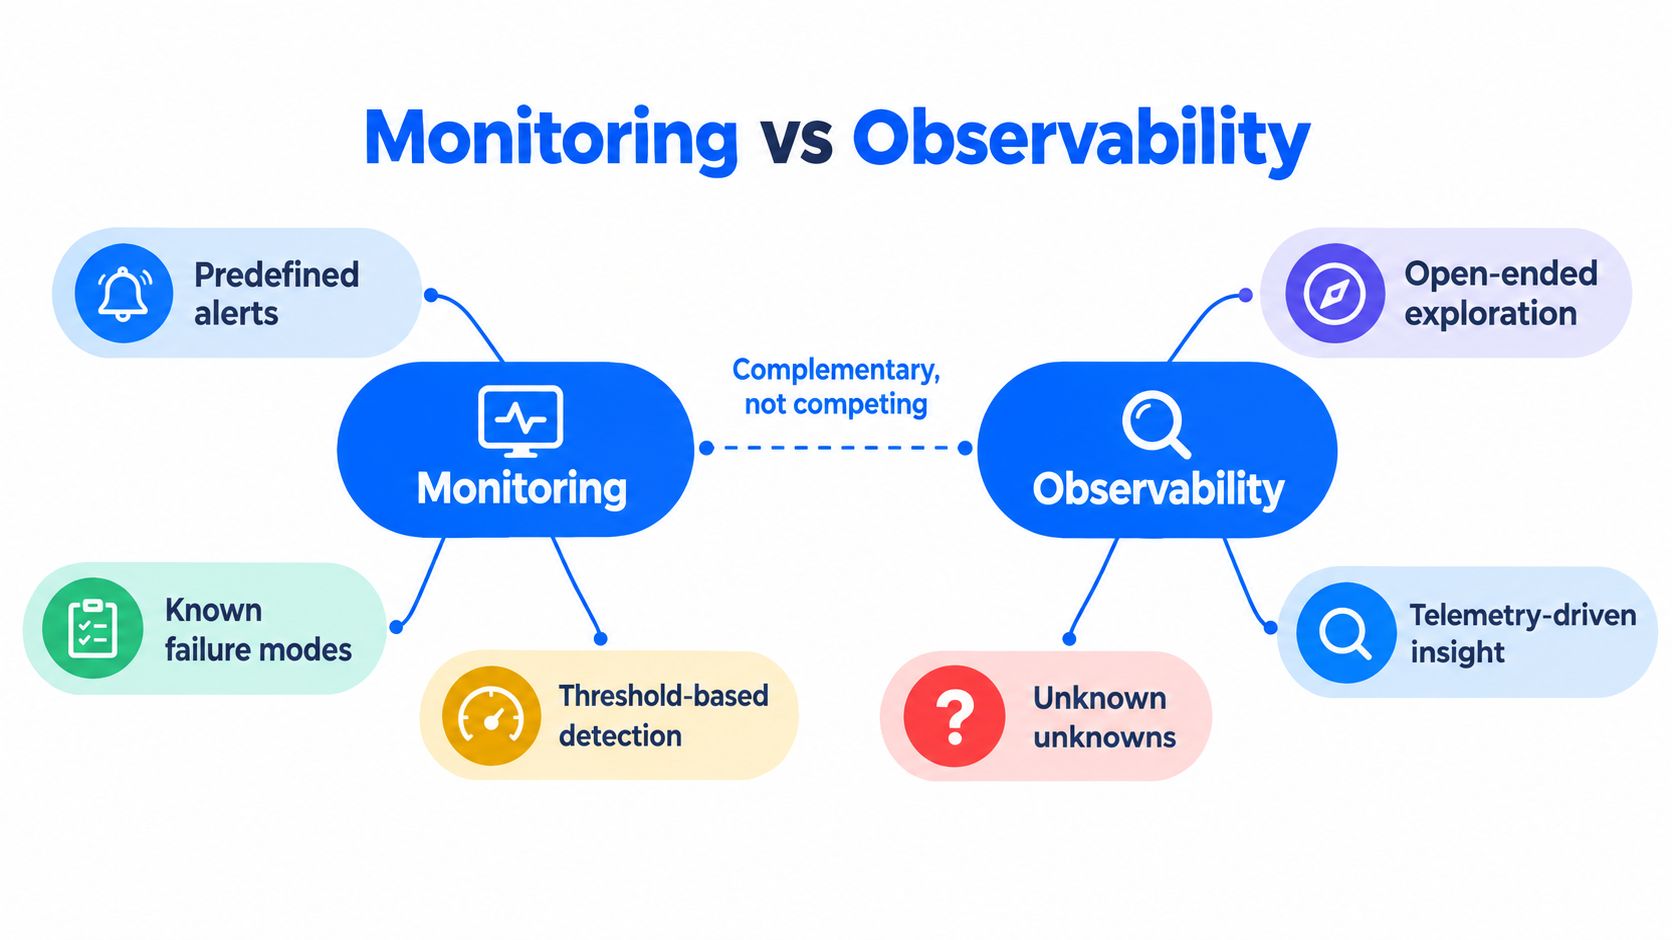
Le monitoring, c'est du contrôle explicite. Vous définissez le signal, fixez la limite et déclenchez une alerte lorsque la réalité la franchit. L'observabilité est plus large : elle vise à rendre l'état interne d'un système déductible à partir des données qu'il émet, afin que les ingénieurs puissent expliquer des pannes inédites, et pas seulement confirmer celles qu'ils avaient anticipées. La question pratique n'est pas de savoir quel terme sonne le plus actuel, mais quel niveau de profondeur de diagnostic le workload justifie.
C'est important, car remplacer des moniteurs par une observabilité généraliste peut affaiblir la gouvernance. Si vous rendez les contrôles implicites, vous les rendez plus difficiles à auditer. Pour une plateforme de données, c'est un mauvais calcul. Un chargement manquant, un schéma cassé ou une dérive de KPI n'ont pas besoin d'élégance philosophique : ils ont besoin d'un responsable explicite, d'une alerte et d'une piste de preuves.
Règle pratique : conservez des moniteurs explicites pour les modes de défaillance connus, puis ajoutez de l'observabilité uniquement là où vous avez besoin d'une analyse approfondie des causes racines, de corrélation ou d'un diagnostic exploratoire.
Le livre Site Reliability Engineering de Google a formalisé les quatre signaux d'or des services exposés aux utilisateurs : latence, trafic, erreurs et saturation. Cette base reste pertinente, car elle offre aux équipes une couche de monitoring compacte pour les problèmes connus. Mais les plateformes de données ont besoin de plus que la santé des services. Elles exigent aussi la fraîcheur, la stabilité des schémas, la validité des enregistrements, le comportement des métriques métier et la consommation des workloads.
Si vous devez décider où investir, cessez de vous demander si l'observabilité vaut mieux que le monitoring. Demandez-vous plutôt de quelles preuves vous avez besoin lorsqu'un jeu de données, un pipeline ou un rapport dysfonctionne, et combien il vous coûte d'être en retard, imprécis ou dans l'erreur.
Ce que signifient réellement monitoring et observabilité
Le monitoring est une fonction de détection prédéfinie. Les équipes choisissent des indicateurs comme le taux de requêtes, le taux d'erreurs, la latence, l'utilisation CPU ou le statut d'arrivée des données, puis déclenchent une alerte lorsque les valeurs franchissent un seuil ou sortent d'une plage attendue. Il répond à une question étroite mais essentielle : une condition connue dépasse-t-elle sa limite ?
L'observabilité est plus large. Elle cherche à savoir si vous pouvez déduire l'état interne d'un système à partir des données qu'il émet. En pratique, cela signifie corréler métriques, logs et traces pour que les ingénieurs puissent investiguer une panne qu'ils n'avaient pas prévue au moment d'écrire l'alerte.
La base de départ pour la plupart des équipes
La vision classique au niveau des services reste importante. Le modèle SRE de Google vous donne une base minimale de monitoring avec la latence, le trafic, les erreurs et la saturation. Ces signaux sont utiles parce qu'ils imposent de la discipline. Une alerte de latence indique que le service est lent, le trafic que la demande a changé, les erreurs que des requêtes ont échoué, et la saturation qu'une ressource contrainte approche de sa pleine utilisation. Inutile d'en faire une théologie.
Pour les plateformes de données, la correspondance est directe mais pas identique. Remplacez la latence des services par la fraîcheur et les délais de livraison. Remplacez le trafic par les profils de charge et de consommation. Remplacez les erreurs par les jobs en échec, les enregistrements invalides ou les transformations cassées. Remplacez la saturation par la pression sur l'entrepôt, le cluster ou le pipeline.
Le monitoring vous dit que quelque chose a franchi une limite. L'observabilité vous aide à expliquer ce qui a changé, où cela a changé et ce que cela a affecté d'autre.
Cette distinction explique pourquoi les équipes data se brûlent les doigts lorsqu'elles considèrent un tableau de bord au vert comme une preuve d'exactitude. Un tableau de bord peut être disponible tout en étant analytiquement faux, parce que les données sont obsolètes, incomplètes, dupliquées ou structurellement modifiées. Si votre activité dépend de ce résultat, vous avez besoin à la fois du contrôle et des preuves.
Pour un point d'entrée pratique, découvrez l'approche de digna en matière d'observabilité des données.
Objectifs, télémétrie et détection versus diagnostic
La façon la plus claire de distinguer ces disciplines est de comparer leur finalité, les preuves qu'elles utilisent et jusqu'où elles vous mènent. Le monitoring répond à des objectifs de contrôle. L'observabilité sert au diagnostic. L'un est conçu pour des limites connues, l'autre pour l'investigation en situation d'incertitude.
Matrice de décision
Critère | Monitoring | Observabilité |
|---|---|---|
Objectif de contrôle | Faire respecter des limites connues et les attentes de service | Expliquer le comportement interne et les schémas de défaillance émergents |
Déclencheur typique | Dépassement de seuil, job manquant, règle en échec, livraison tardive | Corrélation inhabituelle, changement de comportement, anomalie inexpliquée |
Focus de télémétrie | Métriques agrégées et alertes | Métriques, logs, traces corrélés et contexte enrichi |
Question traitée | Que s'est-il passé, et la tolérance a-t-elle été dépassée ? | Qu'est-ce qui a changé, pourquoi, et quoi d'autre peut être affecté ? |
Modèle de responsabilité | Responsable opérationnel clairement identifié pour les contrôles connus | Diagnostic transverse entre les équipes plateforme, data et applicatives |
Piste d'audit | Solide lorsque les contrôles sont explicites | Plus solide pour l'investigation que comme preuve formelle de contrôle |
Profil de coûts | Généralement plus ciblé et moins coûteux à exploiter | Plus large, plus coûteux et plus facile à surdimensionner |
La distinction de base d'OpenTelemetry est utile ici. Les métriques sont des mesures d'exécution, les logs des enregistrements d'événements et les traces les chemins des requêtes à travers les services. Tout l'intérêt réside dans la corrélation. Une métrique vous indique que la latence a augmenté, une trace montre quel chemin a ralenti, et les logs expliquent l'événement qui en est la cause. La documentation d'IBM sur l'observabilité dit la même chose simplement : les métriques alertent, les traces montrent les chemins d'exécution et les logs fournissent le contexte nécessaire à la résolution.
Pour les équipes data, cela signifie que l'on ne choisit pas la télémétrie par effet de mode, mais selon sa valeur diagnostique. Si le problème est un job batch en échec, un moniteur peut suffire. Si un modèle, un rapport ou un workflow client en aval est faux, vous avez besoin du contexte supplémentaire pour relier le symptôme à sa cause.
Utiliser les bonnes preuves pour la bonne tâche
Le monitoring pour les contrôles : utilisez-le lorsque le mode de défaillance est connu, que la limite est stable et que la preuve doit être explicite.
L'observabilité pour le diagnostic : utilisez-la lorsque la cause est incertaine, que le graphe de dépendances est complexe ou que plusieurs systèmes peuvent être impliqués.
Les deux ensemble : combinez-les lorsque le coût d'une erreur est élevé et que la défaillance peut passer inaperçue.
Pour une approche plus opérationnelle, commencez par les bonnes pratiques d'observabilité pour les équipes data. Le but n'est pas de tout collecter, mais de collecter suffisamment de preuves pour que la prochaine décision soit défendable.
Scénarios de détection dans une plateforme de données
Les définitions abstraites ne font pas bouger les équipes. Les incidents, si. Le moyen le plus simple de distinguer monitoring et observabilité est de les confronter aux pannes que produisent réellement les plateformes de données.
Chargement nocturne en échec et livraison retardée
Un job batch en échec est le cas le plus simple. Le monitoring doit détecter l'exécution ratée, la table manquante ou l'arrivée tardive. L'alerte doit être directe et actionnable. L'observabilité n'apporte de valeur que si la panne n'est pas évidente, par exemple lorsque le job s'est terminé mais qu'une dépendance s'est bloquée, qu'une partition n'a pas été chargée ou que les données sont arrivées après la fermeture de la fenêtre métier.
C'est là que le suivi de la ponctualité des données prend toute son importance. Si un flux réglementaire, une extraction financière ou un instantané opérationnel est soumis à une échéance, l'alerte doit signaler que les données sont en retard. La couche d'observabilité doit montrer si la source a été retardée, si le transfert a pris du retard ou si une étape en aval a retenu l'enregistrement.
Changement de schéma silencieux et ruptures en aval
Une dérive de schéma est précisément le cas où le monitoring seul est faible. Le pipeline peut continuer de tourner alors que le contrat de données est rompu. Le monitoring peut détecter une colonne manquante, un échec de parsing ou une violation de règle, à condition d'avoir déjà écrit le contrôle correspondant. L'observabilité a besoin du contexte de schéma, du lignage et des consommateurs concernés pour vous montrer ce qui a changé et quel rapport ou modèle n'est désormais plus fiable.
Chute d'un KPI et impact métier
Une baisse dans le reporting du chiffre d'affaires est un problème différent. Les données peuvent rester techniquement valides alors que le résultat métier a évolué. Le monitoring peut signaler l'écart du KPI si vous le suivez explicitement. L'observabilité est utile lorsque vous devez relier ce changement au volume, à la saisonnalité, à un comportement en amont ou à une évolution de la charge dans les systèmes sources.
Exécution et analyse dans la base de données
Le meilleur chemin de diagnostic aboutit souvent dans l'entrepôt ou le data lake lui-même. Si vous calculez les contrôles sur place, vous réduisez les déplacements de données et gardez les preuves au plus près des données. C'est bien plus adapté aux environnements sensibles que de disperser des copies d'enregistrements dans des outils supplémentaires.

Si vous travaillez avec des jeux de données riches en anomalies, les types de détection d'anomalies sont la bonne question à vous poser ensuite. Mais ne compliquez pas inutilement les tables de référence statiques ou les flux de conformité en ajout seul. Ces workloads ont généralement d'abord besoin d'un monitoring solide, pas d'une exploration sophistiquée.
Stacks de télémétrie et ce qu'elles coûtent réellement
C'est dans l'outillage que les bonnes intentions viennent mourir. Les équipes pensent généralement acheter de la visibilité, puis découvrent qu'elles ont acheté du travail de configuration, des frictions d'intégration et une file d'alertes de plus.
Le vrai coût, c'est la friction opérationnelle
Dans l'enquête 2025 de Grafana Labs menée auprès de 1 255 répondants, la complexité était la principale préoccupation en matière d'observabilité, la fatigue liée aux alertes le plus grand obstacle à une réponse plus rapide aux incidents, et les dépenses d'observabilité représentaient en moyenne 17 % des dépenses totales d'infrastructure de calcul. Cela vous apprend deux choses. D'abord, l'observabilité n'est pas gratuite. Ensuite, plus de télémétrie ne signifie pas automatiquement un diagnostic plus rapide. Cela peut simplement signifier plus de travail.
Les standards ouverts aident, mais ils n'effacent pas la charge. OpenTelemetry et les stacks de type Prometheus facilitent la circulation des données et la portabilité de l'instrumentation. Ils ne réduisent pas comme par magie le bruit des alertes, la mise en place des pipelines de données ou la coordination nécessaire pour transformer les signaux en actions.
Choisir la stack selon la valeur des preuves
Type de stack | Usage idéal | Principal compromis |
|---|---|---|
Monitoring centré sur les métriques | Services stables, SLO connus, alertes explicites | Profondeur de diagnostic plus limitée |
Métriques, logs et traces | Systèmes distribués et investigations en plusieurs étapes | Effort de mise en place et de corrélation plus important |
Exécution dans la base de données | Données sensibles, workloads centrés sur l'entrepôt, moins de déplacements de données | Moins de flexibilité si vous contraignez trop le modèle |
Une approche dans la base de données change l'équation économique. Elle laisse les données en place, réduit leurs déplacements et convient aux environnements où la gouvernance compte autant que la vitesse. C'est souvent la bonne réponse pour les plateformes de données d'entreprise, car la télémétrie doit vivre au plus près des données qu'elle décrit. Si vous devez copier la moitié de l'entrepôt simplement pour le mesurer, vous en faites probablement trop.

Si vous ne deviez retenir qu'une recommandation pratique : utilisez la stack la moins coûteuse qui produit encore un diagnostic défendable pour le workload. Tout le reste n'est que décoration.
Là où la détection d'anomalies par IA et le suivi de schéma font leurs preuves
La détection d'anomalies par IA est utile lorsque les seuils statiques échouent. Si un jeu de données présente un chiffre d'affaires volatil, un comportement client erratique, du bruit de capteurs ou des événements générés par des machines, les limites fixes deviennent des instruments grossiers. L'apprentissage de références et la comparaison continue permettent de repérer les écarts significatifs sans obliger les équipes à ajuster manuellement chaque règle.
Utiliser la détection statistique là où le comportement évolue
C'est ici que la détection d'anomalies pilotée par l'IA fait ses preuves. Elle est utile lorsque la forme des données évolue dans le temps et que le signal compte davantage que la valeur exacte. Un seuil peut vous dire qu'une valeur est élevée. Une référence apprise peut vous dire qu'elle est inhabituelle.
Elle est mal adaptée aux tables de référence statiques, aux clés déterministes et aux flux de conformité en ajout seul. Ces workloads n'ont pas besoin d'astuce. Ils ont besoin de contrôles fiables et de responsabilités claires.
Adapter le contrôle au jeu de données
Fraîcheur et ponctualité : utilisez le monitoring des arrivées lorsque le métier se soucie du moment où les données arrivent, et pas seulement de leur arrivée.
Suivi de schéma : utilisez-le partout où des consommateurs en aval dépendent d'une structure stable.
Validation des enregistrements : utilisez-la pour faire respecter les règles métier, en particulier lorsque les preuves d'audit comptent.
Exécution dans la base de données : utilisez-la lorsque la sécurité, la gouvernance ou le déplacement des données constituent la contrainte.
L'erreur classique consiste à traiter tous les jeux de données comme s'ils étaient aussi dynamiques les uns que les autres. Ce n'est pas le cas. Une table de dimension à évolution lente ne mérite pas la même facture d'observabilité qu'un flux transactionnel à fort volume ou un chiffre d'affaires volatil.
Je garderais aussi, dans votre esprit, le suivi de schéma séparé de la détection d'anomalies. La dérive de schéma est structurelle. La détection d'anomalies est comportementale. Vous avez besoin des deux dans un patrimoine de données sérieux, mais ils résolvent des problèmes différents et ne doivent pas être justifiés par le même argument.
Si vous devez décider où investir, la manière dont l'IA détecte les anomalies de données dans les pipelines est le bon angle d'analyse. Utilisez l'intelligence là où la variance est réelle, pas là où une règle fera proprement le travail.
Fragmentation des outils et vrais obstacles à une couverture unifiée
Si l'observabilité n'était qu'une mise à niveau d'outillage, une couverture unifiée serait déjà la norme. Ce n'est pas le cas. Une enquête 2026 de la CNCF auprès de 407 praticiens a révélé que 46,7 % des organisations utilisaient deux ou trois outils d'observabilité en parallèle, tandis que seules 7,4 % avaient atteint une expérience d'observabilité unique et unifiée. La configuration des tableaux de bord et des alertes était le principal défi de mise en place, à 54 %.

Tout est là. Le plus difficile n'est pas d'acheter une plateforme de plus. C'est d'intégrer la télémétrie dans un workflow qui produit un diagnostic actionnable plutôt que davantage d'onglets. La complexité d'intégration et la mise en place des pipelines de données ralentissent les équipes, car chaque signal supplémentaire crée du travail pour les ingénieurs, les opérateurs et les analystes.
Règle opérationnelle : instrumentez le moins de jeux de données possible au niveau le plus profond, et gardez le reste sous monitoring explicite. Une couverture tous azimuts ne crée généralement que de la fatigue liée aux alertes et une responsabilité diluée.
C'est aussi pourquoi la maturité en observabilité est un problème de workflow avant d'être un problème d'outillage. Si personne n'est responsable du moniteur, l'alerte devient du bruit. Si personne ne peut expliquer le signal, les données deviennent décoratives. Adaptez la profondeur de couverture à la criticité, pas à l'optimisme.
Pour un chemin de mise en œuvre pratique, les outils d'observabilité des données de digna s'inscrivent dans ce modèle de profondeur sélective. La bonne stack est celle que votre équipe est capable d'exploiter.
Un modèle opérationnel hybride et ses implications par secteur
Le modèle défendable est hybride. Le monitoring prend en charge les objectifs de contrôle, les preuves d'audit et les attentes stables de niveau de service. L'observabilité prend en charge le diagnostic exploratoire, l'établissement de références et les défaillances émergentes. Ce n'est pas un compromis, c'est de la discipline.
C'est d'autant plus important dans les environnements réglementés ou à fort rayon d'impact. Dans les services financiers, vous avez besoin de contrôles explicites sur les données financières, de risque, réglementaires et transactionnelles, car les preuves doivent tenir face aux auditeurs et aux équipes opérationnelles. Dans la santé, la fiabilité et la traçabilité sont essentielles, car les données cliniques et opérationnelles ne peuvent pas dériver sans que personne ne s'en aperçoive. Dans les télécommunications, les comportements à fort volume évoluent vite : il vous faut donc un monitoring solide et suffisamment d'observabilité pour expliquer les pics, les problèmes de livraison et la consommation de la plateforme. Dans le secteur public, des preuves prêtes pour l'audit et la cohérence comptent davantage qu'une couverture spectaculaire.
Une politique opérationnelle simple
Surveillez ce qui ne doit jamais échouer sans prévenir. Utilisez des contrôles explicites pour les chargements manquants, les données obsolètes, les changements de schéma et les violations de règles métier.
Observez ce que vous ne pouvez pas prévoir. Ajoutez une télémétrie plus approfondie là où le chemin de défaillance est ambigu, distribué ou coûteux à démêler.
Réévaluez chaque workload. Si les données évoluent plus vite que vos seuils, basculez une plus grande part de ce workload vers l'observabilité.
La pire erreur est de supposer qu'une discipline est la version mature de l'autre. Ce sont des partenaires aux rôles différents. Le monitoring garde la lumière allumée. L'observabilité explique pourquoi elle a vacillé.
Pour les équipes data en entreprise, toute la décision est là. Affectez chaque workload à la discipline qui correspond à son coût de défaillance, à ses contraintes de conformité et à sa maturité en télémétrie, puis révisez cette répartition à mesure que votre stack évolue. Si vous recherchez une plateforme construite précisément sur cette logique, rendez-vous sur digna et découvrez comment elle gère les anomalies de données, la ponctualité, les changements de schéma, la validation et l'exécution dans la base de données au sein de votre propre environnement.
Mettre en œuvre cette répartition hybride est plus simple lorsque les contrôles explicites et les preuves de diagnostic se trouvent au même endroit que les données. L'observabilité des plateformes de données de digna exécute la détection d'anomalies, la validation, le contrôle de ponctualité et le suivi de schéma directement dans votre propre base de données, afin que chaque workload bénéficie de la profondeur dont il a besoin, sans copier les enregistrements dans un outil de plus.
Questions fréquentes
Quelle est la différence entre observabilité et monitoring ?
Le monitoring détecte des états de défaillance connus grâce à des seuils et des alertes prédéfinis, tandis que l'observabilité explique des pannes inconnues ou multifactorielles en corrélant métriques, logs et traces. Le monitoring est la couche de contrôle, l'observabilité la couche de diagnostic, c'est pourquoi la plupart des équipes data ont besoin des deux.
L'observabilité doit-elle remplacer le monitoring ?
Non. Remplacer des moniteurs explicites par une observabilité large rend les contrôles implicites et plus difficiles à auditer, un mauvais compromis pour une plateforme de données. Conservez des moniteurs explicites pour les modes de défaillance connus, comme les chargements manquants, les schémas cassés et la dérive des KPI, puis ajoutez de l'observabilité là où il faut creuser la cause racine.
Quels sont les quatre signaux clés (golden signals) du monitoring ?
Le livre Site Reliability Engineering de Google les définit comme latence, trafic, erreurs et saturation. Sur une plateforme de données, ils correspondent à la fraîcheur et au délai de livraison, aux schémas de charge et de consommation, aux jobs en échec ou enregistrements invalides, et à la pression sur l'entrepôt, le cluster ou le pipeline, plus la stabilité des schémas.
Combien coûte l'observabilité par rapport au monitoring ?
L'observabilité est plus large et nettement plus coûteuse. Dans l'enquête 2025 de Grafana Labs auprès de 1 255 répondants, les dépenses d'observabilité représentaient en moyenne 17 % des dépenses totales d'infrastructure de calcul, et la complexité était la première préoccupation. Le monitoring est plus ciblé et moins cher, d'où le conseil de choisir la stack la moins chère qui produit encore un diagnostic défendable.
Quand utiliser la détection d'anomalies par IA plutôt que des seuils fixes ?
La détection d'anomalies par IA est rentable lorsque le comportement des données évolue, par exemple un chiffre d'affaires volatil, une consommation erratique, du bruit de capteurs ou des événements générés par des machines, où des limites fixes deviennent des outils grossiers. Elle convient mal aux tables de référence statiques, aux clés déterministes et aux flux de conformité append-only, qui exigent des règles fiables.


