10 opciones de software de monitorización empresarial comparadas
|
11
minuto de lectura

El consejo más habitual sobre software de monitorización empresarial es comparar el número de funcionalidades. Ese enfoque pasa por alto la decisión que más importa: qué capa de monitorización necesita controlar. Una plataforma que vigila los ingresos en la fuente de datos cumple un propósito distinto al de una herramienta de BI que alerta a los usuarios sobre un dashboard gobernado, una plataforma de observabilidad que relaciona los fallos en el checkout con los servicios de la aplicación o un sistema de analítica de producto que explica los cambios en conversión y retención.
Esta comparativa evalúa cada opción según su frontera de monitorización, modelo de despliegue, movimiento de datos, gobernanza, detección de anomalías, puntualidad, validación, integraciones, modelo de precios, esfuerzo de implementación y adecuación para los sectores financiero, sanitario y de telecomunicaciones. Estos criterios importan porque una alerta útil es solo el principio. Los equipos también necesitan saber si los datos de producción salen de su entorno, quién es responsable de la definición de la métrica, cómo llega un incidente al operador adecuado y si los costes crecen con las tablas, la telemetría, los usuarios, la capacidad o el volumen de datos.
La categoría se está ampliando más allá de los dashboards y las reglas de umbral. El mercado de observabilidad en sentido amplio se estimó en 2.143 millones de USD en 2023 y se prevé que alcance 4.733,2 millones de USD en 2030, con una CAGR del 12,2 % entre 2024 y 2030, según el análisis del mercado de Data Observability de Grand View Research. Para las empresas reguladas, ese crecimiento hace que la disciplina en la evaluación sea más importante, no menos. Una plataforma amplia puede ofrecer una cobertura impresionante y, al mismo tiempo, generar movimiento de datos innecesario, trabajo de gobernanza o complejidad de precios.
Índice
1. Solutions Business Monitoring
Solutions Business Monitoring es un módulo de la plataforma digna para monitorizar KPIs de negocio y operativos directamente sobre los conjuntos de datos subyacentes. En lugar de esperar a que un dashboard posterior deje al descubierto un problema, analiza el comportamiento de los datos allí donde se calcula la métrica e identifica cambios inusuales, volatilidad, tendencias, cambios de esquema, fallos de validación y retrasos en la entrega.
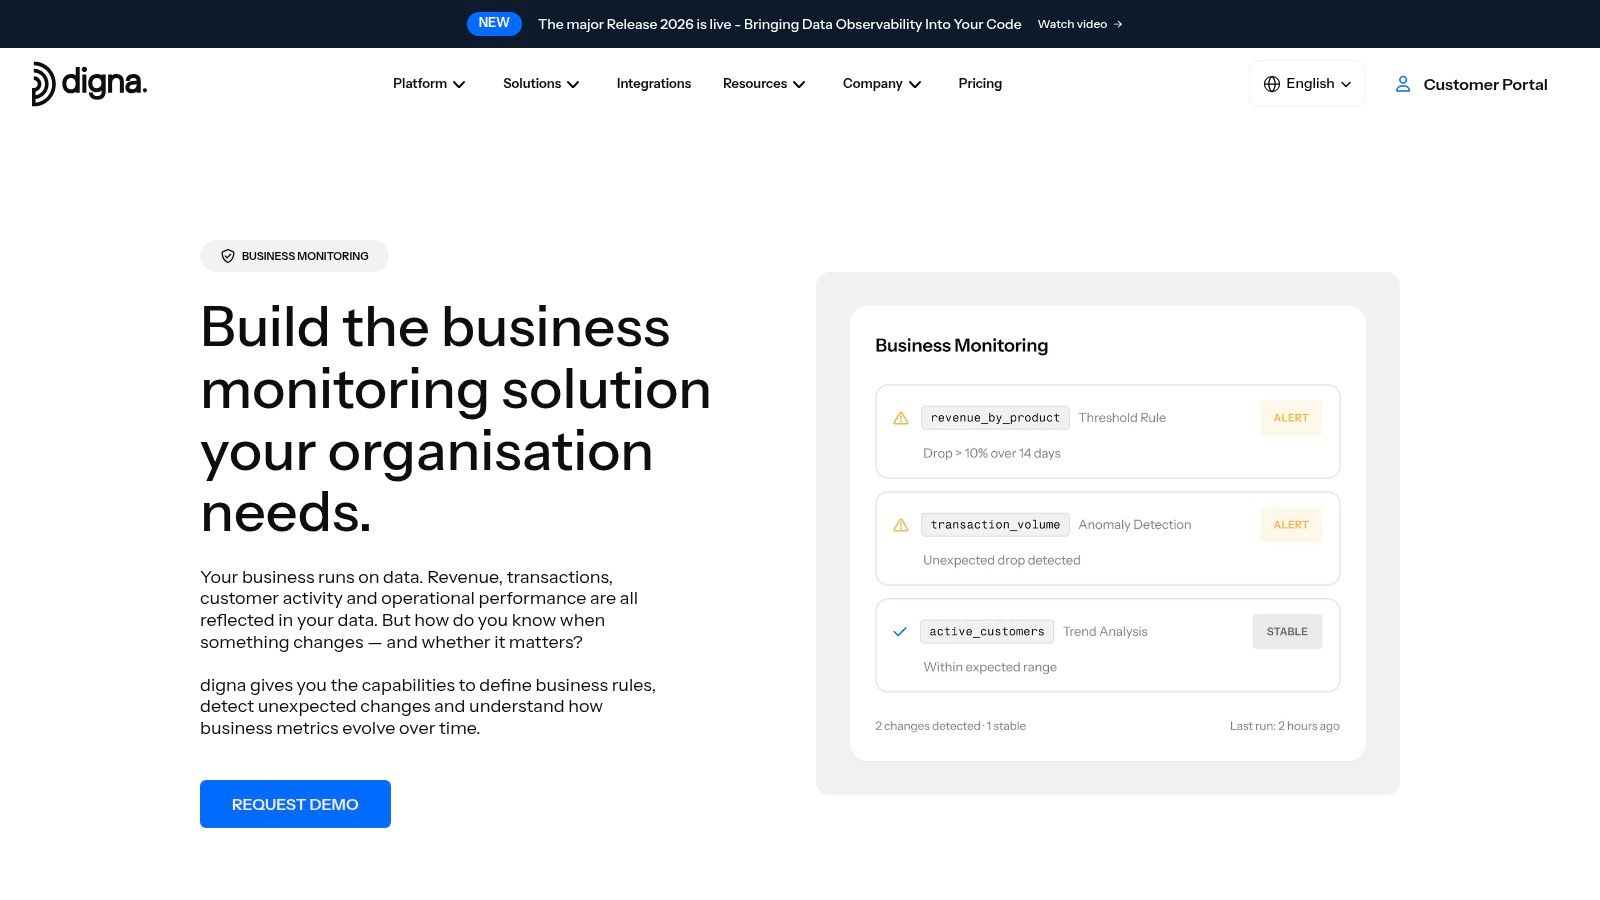
La distinción clave es la frontera de monitorización. digna ejecuta el cálculo y el análisis de métricas dentro de la base de datos o del entorno de datos del cliente, con despliegue disponible en nube privada, VPC o infraestructura on-premises. Los datos de producción permanecen bajo el control del cliente, una ventaja significativa para registros financieros, información clínica, datos de telecomunicaciones y cargas de trabajo del sector público. La ejecución dentro de la base de datos también reduce la necesidad de copiar grandes conjuntos de datos a un servicio de monitorización independiente.
La plataforma aprende el comportamiento de referencia de los conjuntos de datos y utiliza detección de anomalías basada en IA para reducir la escritura manual de reglas. Además, combina varias formas de observabilidad que a menudo se compran por separado:
Monitorización de KPIs de negocio: detecta movimientos inesperados en ingresos, ventas, transacciones, actividad de clientes e indicadores operativos.
Monitorización de Timeliness: aprende los patrones de entrega y calcula las horas de llegada esperadas para identificar cargas tardías, ausentes o anticipadas.
Validación de datos: comprueba los registros frente a reglas de negocio y controles de calidad específicos.
Seguimiento de esquemas: detecta cambios estructurales como columnas añadidas o eliminadas y modificaciones de tipos de datos.
Esa combinación hace que digna destaque allí donde una alerta de negocio debe desembocar en una investigación de datos. La interfaz compartida ofrece a analistas, ingenieros de datos y responsables de negocio un único lugar para revisar incidentes, tendencias y estado. Los equipos que evalúen flujos de trabajo de monitorización y reporting deberían comprobar si esa vista compartida reduce los traspasos entre los responsables de KPIs y los operadores de la plataforma.
Despliegue y encaje comercial
El licenciamiento modular de digna permite al cliente empezar con un módulo de monitorización y ampliarlo después. El precio se basa en una tarifa base más tablas activas por módulo, en lugar de llamadas a la API, número de escaneos o volumen de alertas. Esa estructura es más fácil de modelar para cargas de trabajo estables, aunque los inventarios de tablas muy grandes pueden aumentar los costes cuando la monitorización se extiende ampliamente entre módulos.
El compromiso de implementación es claro. El cliente debe aprovisionar y gestionar la capacidad de cómputo y almacenamiento dentro de su propio entorno, pero ese esfuerzo permite controles de seguridad y gobernanza más sólidos. digna afirma que la instalación puede generar los primeros resultados en menos de dos horas, una afirmación que conviene verificar con el data warehouse, el modelo de acceso y conjuntos de datos representativos del cliente.
Regla práctica: elija esta opción cuando la pregunta no sea solo «¿Ha cambiado el KPI?», sino también «¿Se entregaron los datos, están estructuralmente intactos, son válidos y se pueden investigar de forma segura dentro de nuestro entorno?»
En los sectores financiero, sanitario y de telecomunicaciones, digna es más adecuado para organizaciones que necesitan monitorización combinada de negocio, datos y plataforma sin enviar datos de producción a un proveedor. Su limitación es que no sustituye a una solución de monitorización del rendimiento de aplicaciones (APM). Explica el comportamiento anómalo de datos y KPIs, pero los equipos que necesitan trazas de peticiones y mapas de servicios pueden requerir una plataforma de observabilidad de aplicaciones junto a ella.
2. Anodot
Anodot está diseñado en torno a la monitorización de KPIs de negocio y la detección de anomalías. Su caso de uso más fuerte es un inventario de métricas grande y cambiante en el que los equipos necesitan detectar desviaciones relevantes en datos de ingresos, conversión, costes, engagement, partners o canales sin crear una regla estática distinta para cada métrica.
El enfoque no supervisado de la plataforma aprende los patrones normales en métricas de negocio de alta cardinalidad. Eso lo hace relevante para organizaciones en las que el mismo KPI debe segmentarse por producto, región, grupo de clientes, canal o partner. Las alertas contextuales y los indicadores de causa raíz ayudan al operador a distinguir un movimiento general de ingresos de un problema localizado de distribución o de un partner.
Anodot también hace hincapié en las alertas orientadas al impacto en el negocio, incluidas estimaciones del impacto económico, y ofrece aceleradores para casos de uso como la monitorización de ingresos en tiempo real. Su amplio modelo de ingesta puede ayudar a los equipos a centralizar una gran variedad de señales y establecer líneas base rápidamente.
La principal diferencia con digna es el alcance y el lugar de ejecución. Anodot es un candidato sólido cuando el objetivo principal es la monitorización centralizada de métricas de negocio basada en IA. digna se diferencia más cuando el mismo equipo necesita detección de anomalías combinada con puntualidad, validación de registros y monitorización de esquemas dentro de sus propias bases de datos. Los equipos que comparan enfoques de anomalías también pueden consultar la detección de anomalías en series temporales como una cuestión de diseño distinta de las alertas en dashboards.
Anodot tiene más sentido cuando la organización ya dispone de un flujo amplio y accesible de señales de KPIs y busca una capa de IA que reduzca el ruido de las alertas.
Los precios están orientados a grandes empresas y hay poca información pública de tarifas, por lo que compras debería modelar el volumen de métricas, los patrones de ingesta, la retención, los usuarios y el soporte necesario, en lugar de comparar titulares de licencias. La implementación es relativamente ligera cuando la organización puede transmitir o centralizar sus señales, pero menos atractiva cuando los datos sensibles no pueden salir del entorno del cliente o cuando la validación en origen es el requisito principal.
En finanzas, Anodot puede ayudar a detectar fugas de ingresos y cambios en los costes. En el sector sanitario, los equipos de gobernanza deberían verificar el tratamiento de datos, los controles de acceso y el movimiento de señales permitido antes de incorporar métricas clínicas u operativas. Las organizaciones de telecomunicaciones con grandes inventarios de KPIs segmentados pueden beneficiarse de su enfoque de alta cardinalidad, siempre que la plataforma pueda recibir los datos necesarios con un control aceptable.
3. ThoughtSpot
ThoughtSpot aborda la monitorización empresarial desde la capa de BI gobernado y analítica de autoservicio. Su KPI Monitor permite a los usuarios de negocio suscribirse a métricas importantes, recibir alertas de anomalías o umbrales y seguir los cambios a través de canales como Slack, Microsoft Teams, correo electrónico y notificaciones móviles.
Eso convierte a ThoughtSpot en una buena opción para los stakeholders que no quieren abrir un dashboard una y otra vez para revisar el rendimiento. SpotIQ y Spotter pueden mostrar cambios en las métricas y sus posibles causas, mientras que las fuentes de datos gobernadas aportan un contexto analítico coherente. La plataforma resulta especialmente útil cuando la empresa ya trata su entorno de BI como el lugar oficial para las definiciones de KPIs.
La limitación es de base. Las alertas de ThoughtSpot dependen de una capa de datos bien modelada y gobernada dentro de la plataforma. Si la tabla subyacente llega tarde, tiene errores o se ve afectada por schema drift, un monitor de KPIs aparentemente correcto puede seguir informando de un resultado incompleto. ThoughtSpot puede indicar a un usuario que una métrica gobernada se ha movido, pero no es principalmente un sistema de puntualidad de datos ni de validación de registros.
Esa distinción importa en entornos regulados. Un equipo financiero puede querer alertas sobre una métrica gobernada de riesgo o ingresos, mientras que los equipos de gobierno del dato pueden necesitar por separado la evidencia de que la fuente llegó a tiempo y cumplió las reglas de negocio. Los equipos sanitarios deberían definir quién es responsable del modelo semántico y quién puede distribuir alertas con contexto sensible. Los equipos de telecomunicaciones pueden valorar el flujo de colaboración, pero deberían comprobar si las métricas operativas de alta dimensionalidad siguen siendo utilizables en el modelo de BI.
Dónde funciona la frontera del BI
La fortaleza de ThoughtSpot es la adopción por parte del negocio. Un stakeholder puede seguir un KPI en el mismo entorno que usa para buscar y analizar, y coordinarse en un canal de colaboración cuando aparece un cambio. Revise la analítica de autoservicio como un requisito contrapuesto si los analistas necesitan explorar anomalías en la capa de datos subyacente en lugar de limitarse a consumir métricas gobernadas.
Los precios están orientados a grandes empresas y la plataforma no suele ser una opción económica para equipos pequeños. El esfuerzo de implementación se centra en el modelado semántico, los permisos, la responsabilidad sobre las métricas y el diseño de alertas. Para finanzas y sanidad, ese trabajo de gobernanza es una ventaja si se realiza con rigor. Para los equipos que buscan observabilidad en origen, puede convertirse en una dependencia que retrasa la obtención de valor.
4. Splunk Observability Cloud
Splunk Observability Cloud cubre la frontera entre la salud de los procesos de negocio y la telemetría de aplicaciones. Sus Business Journeys y APM Business Workflows ayudan a los equipos a mapear procesos de varios pasos, como el checkout, el onboarding u otros flujos de cliente, con los servicios que los ejecutan.
La plataforma aporta más valor cuando una organización necesita responder a una pregunta causal: un proceso de negocio se está degradando, ¿qué servicio, dependencia o transacción es responsable? Splunk combina logs, métricas y trazas, mientras que APM admite análisis de alta cardinalidad y trazas sin muestreo para un diagnóstico más profundo. Los dashboards y alertas personalizados pueden conectar los hitos de negocio con la salud de los servicios.
Se trata de una propuesta distinta de la monitorización de KPIs en origen. Splunk puede mostrar que un recorrido de checkout está fallando y ayudar a los ingenieros a rastrear el fallo a través de los componentes de la aplicación. No sustituye a una plataforma de Data Observability que valide registros del data warehouse, monitorice la entrega esperada de conjuntos de datos o detecte un cambio en el contrato de columnas antes de que falle el reporting posterior.
Profundidad técnica frente a carga operativa
Splunk encaja bien en empresas donde los equipos de ingeniería y de datos ya colaboran en torno a la fiabilidad de las aplicaciones. El trazado sin muestreo puede aportar evidencias valiosas cuando la degradación de un KPI tiene una causa técnica, pero la amplitud de logs, métricas, trazas, dashboards y flujos de trabajo también aumenta las exigencias de implementación y gobernanza.
Las organizaciones que estén considerando alternativas a Splunk deberían separar dos decisiones de compra. Si el problema principal es el diagnóstico de aplicaciones y servicios, la profundidad técnica de Splunk es relevante. Si el problema principal son datos de negocio anómalos dentro de un data warehouse regulado, su stack completo de observabilidad puede ser más de lo que el equipo necesita.
El precio y la complejidad de despliegue pueden ser elevados para una monitorización exclusivamente de KPIs. Los equipos financieros pueden beneficiarse cuando los procesos de ingresos dependen de muchos servicios y rutas de transacción. Las organizaciones sanitarias deberían examinar el contenido de las trazas, la retención, los controles de identidad y si se expone contexto sensible de las aplicaciones en los flujos operativos. Los equipos de telecomunicaciones con recorridos de cliente distribuidos pueden encontrar valioso el mapeo de procesos de negocio, sobre todo cuando la salud de las aplicaciones y la experiencia del cliente deben investigarse conjuntamente.
5. Datadog
Datadog es una plataforma de observabilidad amplia para equipos de ingeniería y SRE que necesitan correlacionar métricas de negocio personalizadas con aplicaciones, infraestructura, logs y trazas. Sus monitores pueden seguir KPIs personalizados, mientras que Watchdog ofrece insights sobre anomalías y ayuda contextual para el análisis de causa raíz.
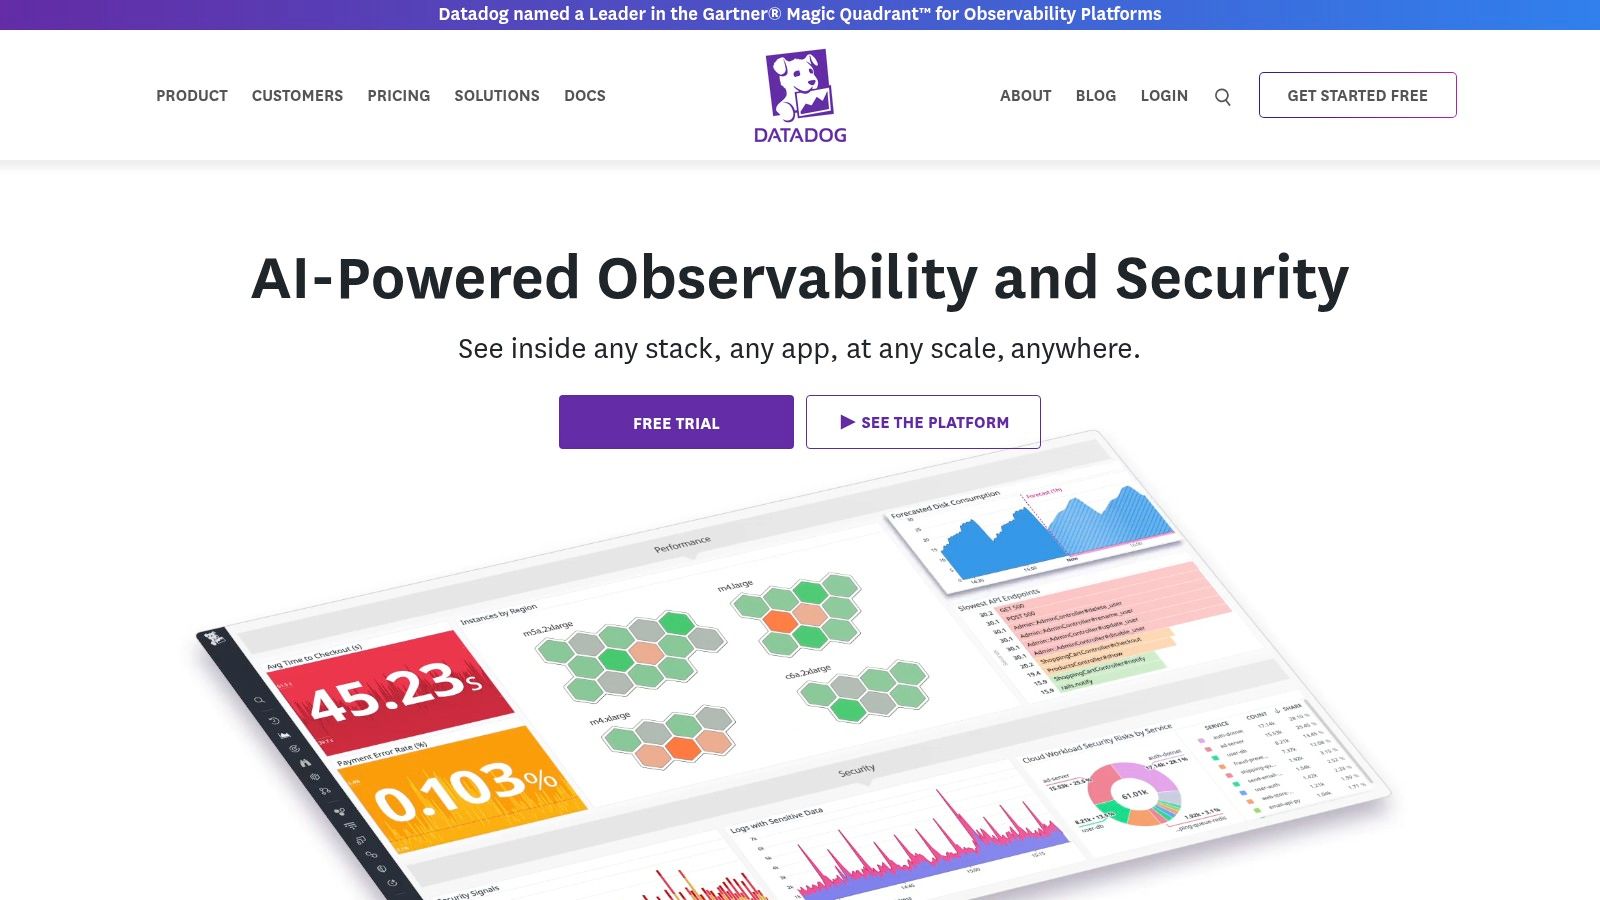
El valor de la plataforma proviene de la correlación. Un equipo puede situar una métrica de negocio junto al rendimiento de los servicios, investigar una anomalía en una serie temporal y enviar una alerta a través de PagerDuty, Slack, correo electrónico u otro canal operativo. Las previsiones y las investigaciones en dashboards añaden contexto de planificación a la monitorización en tiempo real.
Por ello, Datadog es más fuerte cuando los KPIs de negocio dependen directamente del comportamiento de las aplicaciones o de la infraestructura. Una tasa de pagos fallidos, por ejemplo, puede obligar a un equipo a examinar errores de aplicación, latencia de la base de datos y cambios de infraestructura en un mismo flujo de trabajo. En cambio, los equipos que monitorizan la calidad de los datos de negocio pueden necesitar una capacidad independiente para la validación a nivel de registro, los contratos de esquema y la entrega esperada de datos.
Datadog puede reducir los cambios de contexto, pero no puede dar significado a las métricas de forma automática. Las etiquetas, la responsabilidad, las dimensiones y los umbrales de alerta siguen necesitando gobernanza.
El precio es uno de los aspectos centrales de la evaluación. Los costes pueden volverse complejos con un uso intensivo de métricas personalizadas, ingesta de telemetría, retención, hosts e integraciones. El modelo comercial premia una delimitación cuidadosa del alcance, pero un etiquetado deficiente y la creación descontrolada de métricas pueden generar tanto despilfarro económico como ruido de alertas.
Los equipos financieros deberían comprobar si el contexto sensible de las transacciones puede representarse de forma segura en la telemetría. Los equipos sanitarios necesitan controles estrictos sobre atributos y logs. Los equipos de telecomunicaciones pueden beneficiarse del ecosistema de integraciones y de la escala de la monitorización operativa, sobre todo cuando los KPIs de cliente y los servicios de red ya los gestionan equipos de ingeniería. Consulte la monitorización de datos en tiempo real si el requisito es, en cambio, monitorizar la llegada y el comportamiento de los datos dentro de la plataforma de datos.
6. New Relic
New Relic combina observabilidad full-stack con un enfoque de observabilidad de negocio. Los equipos pueden enviar eventos y atributos de negocio personalizados, consultarlos con NRQL, crear dashboards de KPIs y configurar alertas basadas en umbrales o líneas base aprendidas.
Su principal ventaja es la consolidación. Aplicaciones, infraestructura, logs, experiencia de usuario y contexto de negocio pueden consultarse a través de una única plataforma de telemetría. Los quickstarts predefinidos, incluidos flujos orientados al ecommerce, pueden acortar el camino desde la instrumentación hasta una primera visión de negocio. Las herramientas para desarrolladores y la documentación pública también ayudan a los equipos que quieren que los ingenieros definan atributos de negocio personalizados.
El compromiso es que New Relic funciona mejor cuando la organización está dispuesta a modelar esos atributos con cuidado. Un KPI de negocio solo es útil cuando los nombres de eventos, las dimensiones, la identidad, las marcas de tiempo y la responsabilidad son coherentes. Ese esfuerzo de modelado corresponde al cliente, y las capacidades avanzadas pueden depender de la edición elegida.
El precio basado en consumo de New Relic y su nivel gratuito de entrada pueden facilitar una adopción progresiva. Esa flexibilidad es útil para un equipo que pilota una aplicación o un flujo de trabajo, pero los compradores deberían prever igualmente el volumen de telemetría, la retención, los eventos personalizados y el crecimiento. La aparente sencillez de empezar a pequeña escala no elimina la necesidad de controlar el uso.
Encaje por capa de monitorización
En finanzas, New Relic es una opción plausible cuando los resultados de las transacciones deben rastrearse a través de los servicios. Los equipos sanitarios deberían determinar si los atributos personalizados contienen información protegida y cómo se segmenta el acceso. Las organizaciones de telecomunicaciones pueden utilizarlo cuando la experiencia del cliente y el rendimiento de los servicios comparten una base de telemetría.
Es menos adecuado como única plataforma cuando el requisito es la monitorización empresarial dentro de la base de datos con validación, puntualidad y seguimiento de esquemas. Por eso, la comparación con New Relic debería centrarse en la frontera que se controla, y no solo en si ambos productos ofrecen alertas de anomalías.
7. Tableau Pulse
Tableau Pulse lleva la monitorización de KPIs asistida por IA al ecosistema de Tableau. Muestra de forma proactiva cambios, tendencias y explicaciones contextuales mediante resúmenes y digests, con opciones de entrega que incluyen Slack y correo electrónico.
El producto está pensado para responsables de negocio que quieren recibir actualizaciones relevantes de KPIs en su flujo de trabajo diario en lugar de tener que visitar otro dashboard. Su valor es máximo cuando Tableau Cloud ya es el estándar de BI de la organización y hay métricas gobernadas disponibles para que Pulse las interprete.
Esa dependencia también define su limitación. Tableau Pulse no convierte un data warehouse sin gobernanza en un sistema de monitorización fiable. La calidad de su contexto narrativo y la utilidad de las alertas dependen del modelado de datos, las definiciones de métricas, los permisos y la edición de Tableau Cloud que se utilice. La disponibilidad y la profundidad funcional pueden variar según la edición, por lo que compras debería validar la configuración exacta en lugar de basarse en una descripción general del producto.
En finanzas, Tableau Pulse puede mejorar la distribución de métricas de gestión aprobadas, siempre que los equipos de finanzas y de gobierno del dato se pongan de acuerdo sobre las definiciones y los destinatarios. Las organizaciones sanitarias deberían revisar cómo tratan los resúmenes las dimensiones sensibles y si los destinatarios de las alertas están debidamente restringidos. Los equipos de telecomunicaciones pueden valorar el flujo diario de actualizaciones de negocio, pero el diagnóstico de servicios operativos normalmente requerirá una capa de observabilidad de aplicaciones o de red.
Los precios pueden volverse complejos cuando se consideran conjuntamente las licencias de Tableau, las ediciones de Cloud, la gobernanza y el acceso de los usuarios. La implementación es moderada en un entorno Tableau ya existente y considerablemente mayor para los equipos que primero deben estandarizar su modelo de métricas. Es una sólida opción de monitorización centrada en BI, no un sustituto de los controles de anomalías, validación o puntualidad en origen.
8. Looker Google Cloud
Looker ofrece monitorización empresarial a través de un modelo de BI gobernado construido con LookML. Sus alertas pueden ejecutarse sobre resultados de series temporales o categóricos, utilizar umbrales y enviar notificaciones por correo electrónico o Slack. Las opciones de alertas públicas y privadas ayudan a las organizaciones a controlar la visibilidad.
El factor diferencial clave es la gobernanza semántica. LookML ofrece a los equipos una forma versionada de definir métricas de negocio, dimensiones, joins y reglas de acceso. Esa estructura puede crear una fuente única de verdad fiable para las alertas de KPIs, especialmente en organizaciones donde distintos departamentos calcularían de otro modo los ingresos, el margen, la utilización o la actividad de clientes de forma diferente.
Looker requiere disciplina de modelado y experiencia en LookML. Una alerta puede estar técnicamente configurada y ser operativamente débil si el modelo tiene joins ambiguos, filtros incompletos o una responsabilidad poco clara. Algunas capacidades de Slack también requieren que los administradores configuren el workspace, por lo que la preparación de las integraciones debe formar parte del plan de implementación.
Una alerta gobernada no es un contrato de datos
Looker es muy adecuado para equipos financieros que necesitan definiciones de métricas coherentes en el reporting y las alertas. Las organizaciones sanitarias pueden beneficiarse de la entrega basada en permisos y del acceso controlado a explores gobernados, aunque siguen teniendo que evaluar los controles de los datos subyacentes. Los equipos de telecomunicaciones pueden usar Looker para KPIs comerciales y operativos estandarizados, mientras otras herramientas de plataforma monitorizan los pipelines y la infraestructura.
El modelo de precios está ligado al despliegue más amplio de Google Cloud y Looker, por lo que los compradores deberían evaluar conjuntamente las licencias, el desarrollo de modelos, la administración y el consumo del data warehouse. La implementación es más pesada que una simple alerta en un dashboard, porque la capa semántica forma parte del valor del producto.
Looker es una buena elección cuando la prioridad es el consumo de métricas de confianza. No es la herramienta adecuada como solución única cuando los equipos necesitan aprendizaje de líneas base con IA sobre conjuntos de datos en bruto, validación de registros, estimaciones de entrega esperada o detección continua de cambios de esquema.
9. Amplitude
Amplitude es una plataforma de analítica de producto para monitorizar el comportamiento de los usuarios, los KPIs de producto y los embudos de crecimiento. Su detección de anomalías, previsiones, monitores de KPIs y análisis de causa raíz están diseñados para métricas como usuarios activos diarios, conversión, retención y otras medidas de producto o engagement.
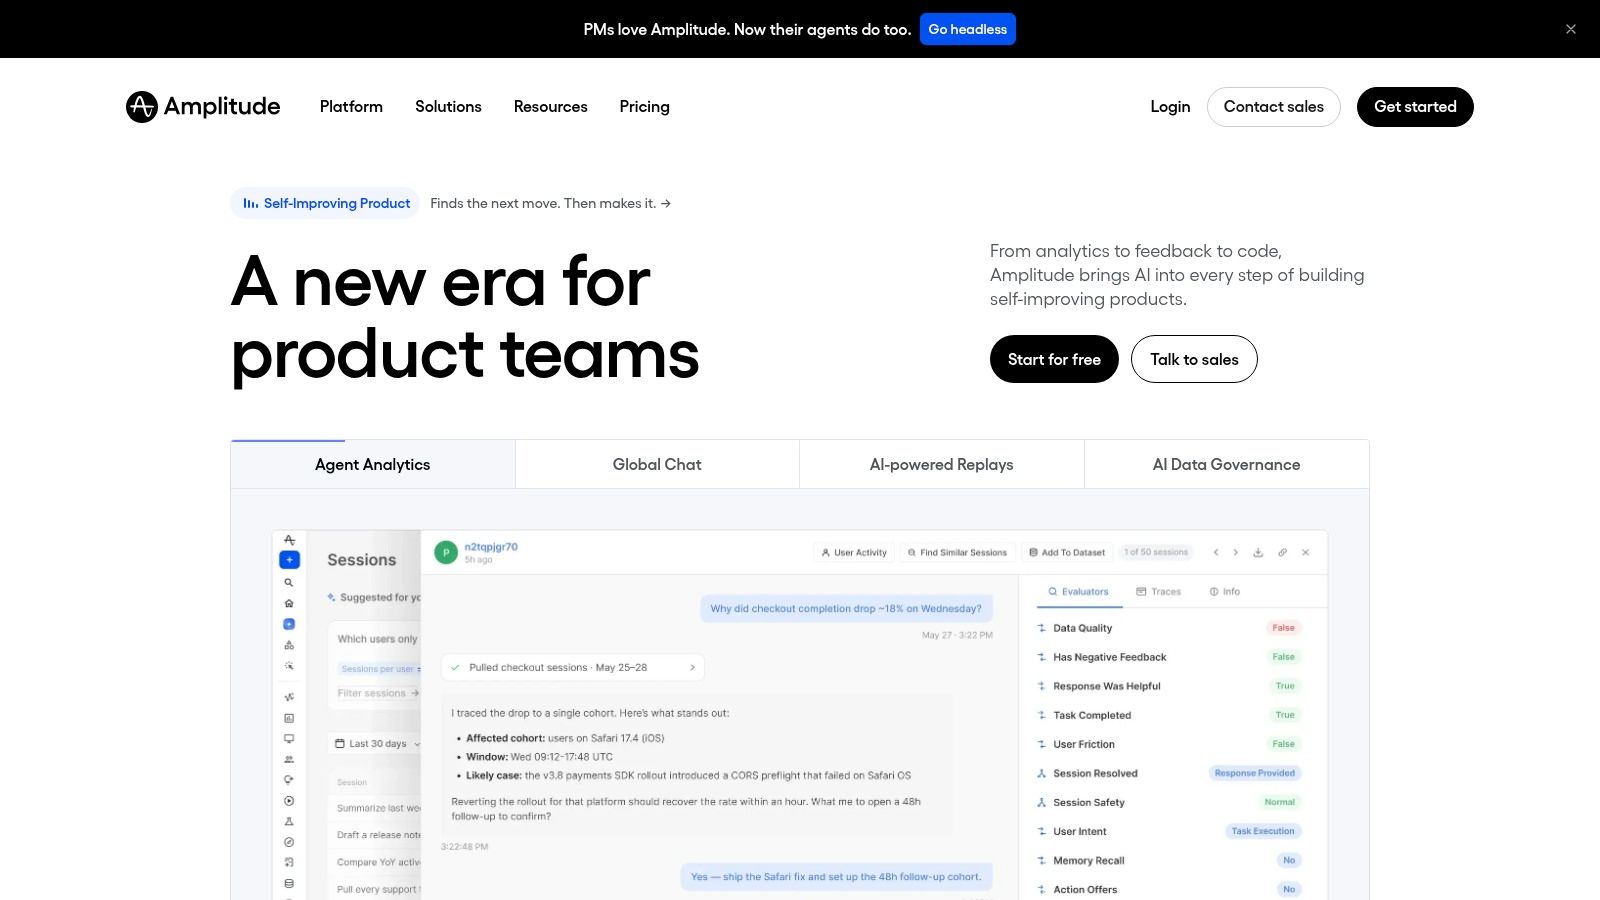
La frontera de monitorización de Amplitude es la experiencia de producto. Los equipos pueden detectar cambios en métricas de series temporales con intervalos de confianza, configurar alertas por Slack o correo electrónico e investigar sus causas mediante segmentos de comportamiento y análisis de embudos. La creación de gráficos asistida por IA facilita que los equipos de producto creen monitores sin depender por completo de los analytics engineers.
Ese enfoque da a Amplitude una ventaja práctica frente a las herramientas de observabilidad de propósito general para las preguntas de producto y crecimiento. Un product manager puede investigar si un cambio en la conversión está asociado a un paso del embudo, a un grupo de dispositivos, a una cohorte de versión o a un patrón de comportamiento de los usuarios. Ese mismo flujo no está pensado para monitorizar la frescura del data warehouse, las trazas de aplicaciones, la salud de la red ni los controles regulatorios de datos.
Amplitude ofrece niveles Free y Plus para pilotos, mientras que los volúmenes mayores y las capacidades avanzadas llevan a los compradores hacia acuerdos Growth o Enterprise. Los equipos deberían modelar el volumen de eventos, la retención, las licencias de usuario y las áreas de producto incluidas en el despliegue. Un piloto puede ser accesible, pero un despliegue a escala empresarial sigue requiriendo estándares de instrumentación y gobernanza de eventos.
En finanzas, Amplitude es relevante para la captación digital, la conversión y los recorridos de cliente, más que para los controles financieros centrales. Las organizaciones sanitarias deberían revisar con cuidado la recogida de eventos, sobre todo cuando se pueda inferir el comportamiento de pacientes o clínico. Los equipos de telecomunicaciones pueden utilizarlo para monitorizar el autoservicio, el onboarding, la selección de tarifas y la retención digital, pero las operaciones de red y facturación necesitan una monitorización complementaria.
Use Amplitude cuando la pregunta sea «¿Cómo se mueven los usuarios por el producto?». Use Data Observability cuando la pregunta sea «¿Podemos confiar en el conjunto de datos que hay detrás del KPI?»
10. Qlik Qlik Cloud y Qlik Alerting
Qlik Cloud y Qlik Alerting combinan la analítica con notificaciones basadas en condiciones de los datos, valores atípicos y anomalías. La plataforma admite alertas de datos, de sistema y de difusión, mientras que Qlik Automations puede enviar notificaciones a Slack, Teams y otros sistemas.
Qlik es más fuerte en organizaciones que se estandarizan en Qlik Cloud Analytics y necesitan una distribución flexible de insights gobernados. Las condiciones de alerta complejas permiten casos de uso operativos que van más allá de simples comprobaciones de umbral, mientras que la entrega basada en permisos ayuda a alinear las notificaciones con el acceso de cada usuario.
La diferencia de despliegue es importante. Las capacidades de Qlik Cloud y de Qlik Alerting on-premises para Windows no son idénticas, por lo que las empresas con entornos híbridos deberían validar el comportamiento específico de cada edición, la administración, la conectividad y la responsabilidad sobre las alertas antes de elegir una arquitectura.
Qlik utiliza planes de Qlik Cloud basados en capacidad que incluyen alertas. Eso puede facilitar la alineación del modelo comercial con un despliegue de analítica más amplio, pero los compradores deben planificar el volumen de datos y el uso. Un modelo de capacidad también puede hacer menos directa la imputación de costes cuando muchos equipos comparten el mismo entorno.
Los equipos financieros pueden usar Qlik para distribuir indicadores gobernados de rendimiento y riesgo. Las organizaciones sanitarias deberían probar el comportamiento de los permisos con estructuras de roles realistas y clasificaciones de datos sensibles. Las empresas de telecomunicaciones pueden beneficiarse de alertas flexibles sobre conjuntos de datos comerciales, operativos y de servicio, aunque la validación en origen y la puntualidad de los pipelines pueden requerir una plataforma complementaria.
La implementación es moderada cuando Qlik ya está implantado y más exigente cuando los equipos introducen a la vez su modelo de datos, las automatizaciones y la administración de alertas. Qlik encaja bien para alertas centradas en la analítica. Es menos adecuado como sustituto independiente de las trazas de aplicaciones o de la Data Observability dentro de la base de datos.
Las 10 mejores soluciones de monitorización empresarial: comparativa de funcionalidades
Solución / Proveedor | Funcionalidades clave ✨ | Valor / USP 🏆 | Calidad / UX ★ | Público objetivo 👥 | Precio / Valor 💰 |
|---|---|---|---|---|---|
Solutions - Business Monitoring (digna) | ✨ Detección de anomalías con IA, Timeliness, validación de registros, seguimiento de esquemas, ejecución en la base de datos | 🏆 Se ejecuta en la infraestructura del cliente + observabilidad unificada para KPIs e incidentes | ★★★★☆ Interfaz compartida, rápido time-to-value (<2 h) | 👥 Equipos de datos y analítica empresariales; sectores regulados | 💰 Modular: tarifa base + por tabla activa; transparente y estable según el uso |
Anodot | ✨ Detección de anomalías con IA no supervisada para KPIs de alta cardinalidad; aprendizaje rápido de líneas base | 🏆 Detección sólida centrada en KPIs con señales de impacto económico | ★★★★☆ Pocos falsos positivos; rápido a escala | 👥 Equipos de ingresos, operaciones y finanzas que necesitan alertas de KPIs en tiempo real | 💰 Precios enterprise (poca información pública de tarifas) |
ThoughtSpot | ✨ Monitores de KPIs, IA de SpotIQ/Spotter, alertas por Slack/Teams/móvil | 🏆 BI basado en búsqueda + alertas proactivas de KPIs para usuarios de negocio | ★★★★ Suscripción sencilla a alertas; UX pensada para negocio | 👥 Responsables de negocio y analistas | 💰 Licencias orientadas a grandes empresas |
Splunk Observability Cloud | ✨ Business Journeys, APM, correlación de logs/métricas/trazas | 🏆 Correlaciona la telemetría técnica con procesos de negocio de extremo a extremo | ★★★★ Diagnóstico robusto; interfaz compleja para equipos no técnicos | 👥 Ingeniería + operaciones de negocio en grandes empresas | 💰 Coste/complejidad elevados para casos de uso solo de KPIs |
Datadog | ✨ Monitores de métricas flexibles, motor de anomalías Watchdog, amplias integraciones | 🏆 Alertas maduras y correlación entre distintos tipos de telemetría | ★★★★ Alertas escalables; requiere gobernanza para evitar ruido | 👥 Equipos de SRE e ingeniería (pueden mostrar métricas de negocio) | 💰 Basado en el uso; puede encarecerse con una ingesta intensiva |
New Relic | ✨ Métricas/eventos personalizados, consultas NRQL, telemetría unificada | 🏆 Plataforma de telemetría única con opción de precios basados en consumo | ★★★★ Buenas herramientas para desarrolladores; dashboards NRQL flexibles | 👥 DevOps, SRE y equipos que siguen KPIs personalizados | 💰 Precios basados en consumo; entrada con nivel gratuito |
Tableau Pulse | ✨ Digests/alertas de KPIs con IA, envío a herramientas de colaboración, integrado en Tableau | 🏆 Lleva la monitorización de KPIs al flujo de trabajo diario de los usuarios de BI | ★★★★ Resúmenes pensados para negocio; depende de la configuración de Tableau | 👥 Responsables de negocio que usan Tableau | 💰 Licencias según la edición; puede ser complejo |
Looker (Google Cloud) | ✨ Alertas gobernadas sobre Looks/mosaicos, modelado con LookML, alertas por Slack/correo | 🏆 Gobernanza sólida / fuente única de verdad para los KPIs | ★★★★ Alertas fiables si las métricas están bien modeladas | 👥 Equipos de analítica y responsables de métricas | 💰 Precios enterprise; requiere experiencia en LookML |
Amplitude | ✨ KPIs de analítica de producto, detección de anomalías, previsiones, análisis de causa raíz | 🏆 Puesta en marcha rápida para métricas de producto y crecimiento | ★★★★ Fácil para equipos de producto; buena documentación | 👥 Equipos de producto, crecimiento y analítica | 💰 Niveles Free/Plus → precios Growth/Enterprise |
Qlik (Qlik Cloud + Alerting) | ✨ Lógica de alertas compleja, Automations hacia Slack/Teams, entrega conforme a la gobernanza | 🏆 Distribución flexible y alertas de nivel empresarial | ★★★★ Encaja en entornos Qlik gobernados; requiere configuración por parte del administrador | 👥 Organizaciones estandarizadas en Qlik Cloud | 💰 Planes basados en capacidad; planificar volumen/uso |
Elija la frontera de monitorización que necesita controlar
El software de monitorización empresarial adecuado depende menos del número de dashboards, integraciones o etiquetas de IA que de la frontera que su equipo debe controlar.
Elija digna cuando los datos deban permanecer dentro del entorno del cliente y el programa de monitorización necesite combinar anomalías de negocio con validación, puntualidad, seguimiento de esquemas y visibilidad de la plataforma. Su ejecución dentro de la base de datos, sus opciones de despliegue en nube privada y on-premises, su interfaz compartida y su estructura modular abordan un problema que las alertas de BI suelen dejar sin resolver: el KPI puede ser erróneo porque los registros subyacentes llegan tarde, están incompletos, han cambiado estructuralmente o se salen del comportamiento esperado. La puntualidad debería tratarse como un modelo operativo que incluye compromisos de entrega, frescura, llegada prevista, detección de fallos, variabilidad y diagnóstico por etapas, no como una simple comprobación de marcas de tiempo. La guía de digna sobre la puntualidad de los datos describe ese enfoque más amplio.
Elija una opción centrada en BI como ThoughtSpot, Tableau Pulse, Looker o Qlik cuando la prioridad sea el consumo de métricas gobernadas. Estas plataformas son eficaces cuando los usuarios de negocio necesitan actualizaciones proactivas en Slack, Teams, correo electrónico o flujos móviles y cuando la organización ya cuenta con un modelo semántico de confianza. Sus alertas solo son tan fiables como el modelo, los joins, los permisos y los datos de origen que hay detrás. No deben confundirse con contratos de datos automáticos ni con una observabilidad completa de los pipelines.
Elija observabilidad de aplicaciones como Splunk Observability Cloud, Datadog o New Relic cuando los cambios en los KPIs deban rastrearse hasta los servicios, la infraestructura, los logs, las peticiones y la experiencia de usuario. Estos productos son valiosos cuando un fallo en una transacción, un cambio de latencia o una dependencia de un servicio explican un resultado de negocio. Sus costes y su esfuerzo de implementación pueden aumentar con la telemetría, las métricas personalizadas, la retención, la instrumentación y el etiquetado, por lo que el piloto debería incluir un incidente realista y un modelo de uso previsto.
Elija analítica de producto como Amplitude cuando la pregunta central gire en torno al comportamiento de los usuarios, los embudos, la conversión, la retención o la adopción del producto. La analítica de producto puede explicar qué usuarios o recorridos provocaron un cambio, pero por sí sola no valida una tabla del data warehouse, no identifica una columna modificada ni demuestra que un feed de datos regulado llegó a tiempo.
Una evaluación práctica debería probar el mismo flujo de trabajo representativo en cada plataforma preseleccionada. En finanzas, utilice un proceso de ingresos, riesgo o transacciones. En el sector sanitario, un conjunto de datos clínico, operativo o regulatorio con los controles de acceso adecuados. En telecomunicaciones, un flujo de clientes, facturación, servicio u operaciones de gran volumen. Después, verifique seis aspectos:
Despliegue: ¿La plataforma se ejecuta donde lo exige la gobernanza y los datos de producción salen del entorno?
Responsabilidad: ¿Puede el equipo asignar cada alerta a una persona o grupo operativo con una respuesta definida?
Modelado de datos: ¿Cuánto trabajo se necesita para definir métricas, dimensiones, linaje, eventos y reglas de negocio?
Integración: ¿Pueden las alertas llegar a los sistemas que usan las personas sin crear incidentes duplicados?
Factores de coste: ¿El coste escala con tablas, métricas, eventos, usuarios, capacidad, telemetría, retención o volumen de alertas?
Evidencias: ¿Puede la plataforma mostrar qué cambió, cuándo cambió, qué datos o servicio se vieron afectados y cómo lo resolvió el equipo?
El schema drift merece especial atención porque es un incumplimiento de contrato, no solo un problema de calidad de los valores. Las columnas añadidas o eliminadas, los campos renombrados y los cambios de tipo de datos pueden romper a los consumidores posteriores incluso cuando las filas individuales parecen válidas. Las guías independientes sobre schema drift recomiendan validar los esquemas frente a una línea base esperada o una definición contractual.
La escala del mercado refuerza la necesidad de una decisión que parta de la frontera de monitorización. Una estimación sitúa el software de monitorización empresarial en 33.300 millones de USD en 2025, con una proyección de 79.300 millones de USD en 2034 y una CAGR del 10,2 %, mientras que el sector BFSI tuvo la mayor cuota con un 28,2 % en 2025, según la estimación de Dataintelo sobre el software de monitorización. Esas cifras describen una categoría amplia, no una razón para comprar la plataforma más amplia. La mejor elección es la que controla el modo de fallo que su equipo no puede permitirse pasar por alto.
digna ofrece monitorización empresarial dentro de su propio entorno con detección de anomalías basada en IA, validación de datos, seguimiento de la puntualidad, monitorización de esquemas y observabilidad de la plataforma para data warehouses, data lakes y pipelines. Visite digna para evaluar cómo una frontera de monitorización controlada y modular puede respaldar las operaciones financieras, sanitarias, de telecomunicaciones y otras con datos sensibles.
Elegir una herramienta es solo la mitad del trabajo: una vez en marcha, la monitorización en sí tiene que funcionar. Nuestra guía práctica para gestionar un sistema de monitorización empresarial explica cómo ir más allá de los umbrales fijos, relacionar la deriva de los KPIs con los datos que la generan y reducir la fatiga de alertas sin pasar por alto incidentes reales.
Preguntas frecuentes
¿Cuál es el mejor software de monitorización empresarial para sectores regulados?
Depende de qué frontera de monitorización necesite controlar. Si los datos de producción deben permanecer en su entorno, digna ejecuta el cálculo de métricas dentro de su base de datos, on-premises, en una nube privada o en una VPC, y combina la detección de anomalías en KPIs con puntualidad, validación y seguimiento de esquemas en una única interfaz compartida.
¿Cómo se fija el precio del software de monitorización empresarial?
Los modelos de precios varían mucho entre proveedores. digna cobra una tarifa base más tablas activas por módulo, mientras que Datadog y New Relic escalan con la telemetría y las métricas personalizadas, Qlik utiliza planes basados en capacidad, y Anodot y ThoughtSpot venden licencias enterprise con poca información pública de tarifas. Modele sus volúmenes reales antes de comparar precios de catálogo.
¿Pueden herramientas de BI como Tableau Pulse o Looker sustituir a la monitorización de datos?
No, no por sí solas. Tableau Pulse, Looker, ThoughtSpot y Qlik generan alertas sobre métricas gobernadas, pero esas alertas solo son tan fiables como el modelo y los datos de origen que hay detrás. Una tabla que llega tarde, con errores o afectada por schema drift puede seguir produciendo una alerta de KPI aparentemente correcta que informa de un resultado incompleto.
Datadog o digna para la monitorización de KPIs de negocio: ¿cuál elegir?
Elija Datadog cuando un cambio en un KPI deba rastrearse hasta servicios, logs e infraestructura, por ejemplo una tasa de pagos fallidos relacionada con la latencia de la base de datos. Elija digna cuando la pregunta sea si los propios datos llegaron a tiempo, mantuvieron su estructura y cumplieron las reglas de negocio. Algunos equipos utilizan ambos en paralelo.
¿Qué debería probar durante un piloto de software de monitorización empresarial?
Ejecute el mismo flujo de trabajo representativo en cada plataforma preseleccionada, como un proceso de ingresos en finanzas o un flujo de facturación en telecomunicaciones. Después, compruebe seis aspectos: despliegue y movimiento de datos, responsabilidad sobre las alertas, esfuerzo de modelado de datos, integraciones, factores de coste y si la herramienta aporta evidencias de qué cambió y cómo se resolvió.


