¿Qué es una base de datos en memoria? Claves y compromisos
|
7
minuto de lectura

Una base de datos en memoria no prescinde del disco. Utiliza la RAM como capa de trabajo principal y el almacenamiento persistente como base para la recuperación, y por eso una arquitectura aparentemente volátil puede soportar cargas de trabajo de producción duraderas. El argumento de rendimiento es igual de directo: los análisis del sector describen el acceso a memoria como unas 10 veces más rápido que el acceso a disco, y las referencias técnicas actuales asocian los sistemas en memoria con una latencia de lectura de microsegundos y una latencia de escritura de pocos milisegundos (Mordor Intelligence explica la evolución histórica, AWS describe el comportamiento actual de los sistemas en memoria).
Eso responde a la pregunta de fondo: ¿qué es una base de datos en memoria? Es una base de datos diseñada para mantener los datos activos en la memoria principal, procesarlos allí y utilizar logs, snapshots, save points u otros mecanismos de persistencia para recuperarse tras un fallo. La velocidad es real, pero también lo son los costes, los límites de capacidad, las decisiones operativas y las responsabilidades de durabilidad.
Índice
La paradoja de la velocidad - Datos en memoria, pero seguros en disco
En memoria frente a almacenamiento tradicional - El rendimiento real
Cómo resolver el dilema de la durabilidad - Persistencia sin penalización
Cómo decidir si una base de datos en memoria encaja en su stack
La paradoja de la velocidad - Datos en memoria, pero seguros en disco
El modelo mental habitual es erróneo: «en memoria» no significa «no almacenado en ningún otro sitio». Un sistema de producción mantiene en RAM los datos de uso frecuente porque la CPU puede acceder a ellos sin esperar un viaje de ida y vuelta al almacenamiento tradicional, mientras que el almacenamiento persistente conserva la información necesaria tras una caída o un corte de corriente. SAP describe la RAM como el lugar central de procesamiento en una base de datos en memoria, que aun así requiere almacenamiento en disco o SSD para la persistencia permanente (SAP explica la diferencia fundamental).
Por qué los ingenieros aceptan el sobrecoste de la RAM
Pensemos en un servicio transaccional que debe consultar repetidamente cuentas activas, eventos recientes o el inventario actual. Un diseño centrado en disco paga continuamente por la E/S de almacenamiento. Un diseño centrado en memoria paga más por la RAM y por los mecanismos que la mantienen poblada, pero acorta el camino entre una petición y los datos necesarios para responderla.
La arquitectura se volvió comercialmente viable durante los años ochenta y principios de los noventa, cuando una RAM más barata y la ampliación de la memoria direccionable de 64 bits hicieron posibles conjuntos de trabajo más grandes. La versión en memoria de IBM DB2 se lanzó a principios de los noventa y, en 2014, una encuesta de DBTA citada en el historial de mercado de Mordor Intelligence indicaba un uso de la tecnología en memoria en torno al 32 % de las empresas, mientras que el 75 % de los encuestados esperaba ampliarlo en los 3 años siguientes.
Regla práctica: trate la RAM como la superficie de trabajo rápida, no como el registro permanente.
Esa distinción resuelve el enigma del corte de corriente. Si el servidor se queda sin alimentación, la base de datos no confía en que el contenido de la RAM sobreviva. Reconstruye su estado a partir de registros duraderos y después vuelve a poblar la memoria. El diseño exacto de la recuperación varía según el producto, pero la durabilidad no es una función opcional en un sistema responsable de transacciones.
El compromiso sigue siendo importante. La RAM cuesta más que el almacenamiento persistente, y mantenerlo todo en memoria puede ser un derroche cuando solo una parte de los datos necesita acceso inmediato. Por eso los sistemas modernos combinan la ejecución en memoria con niveles de almacenamiento: mantienen los datos calientes en RAM y trasladan los más fríos a SSD NVMe cuando procede (AWS describe este enfoque por niveles).
Cómo funcionan por dentro las bases de datos en memoria
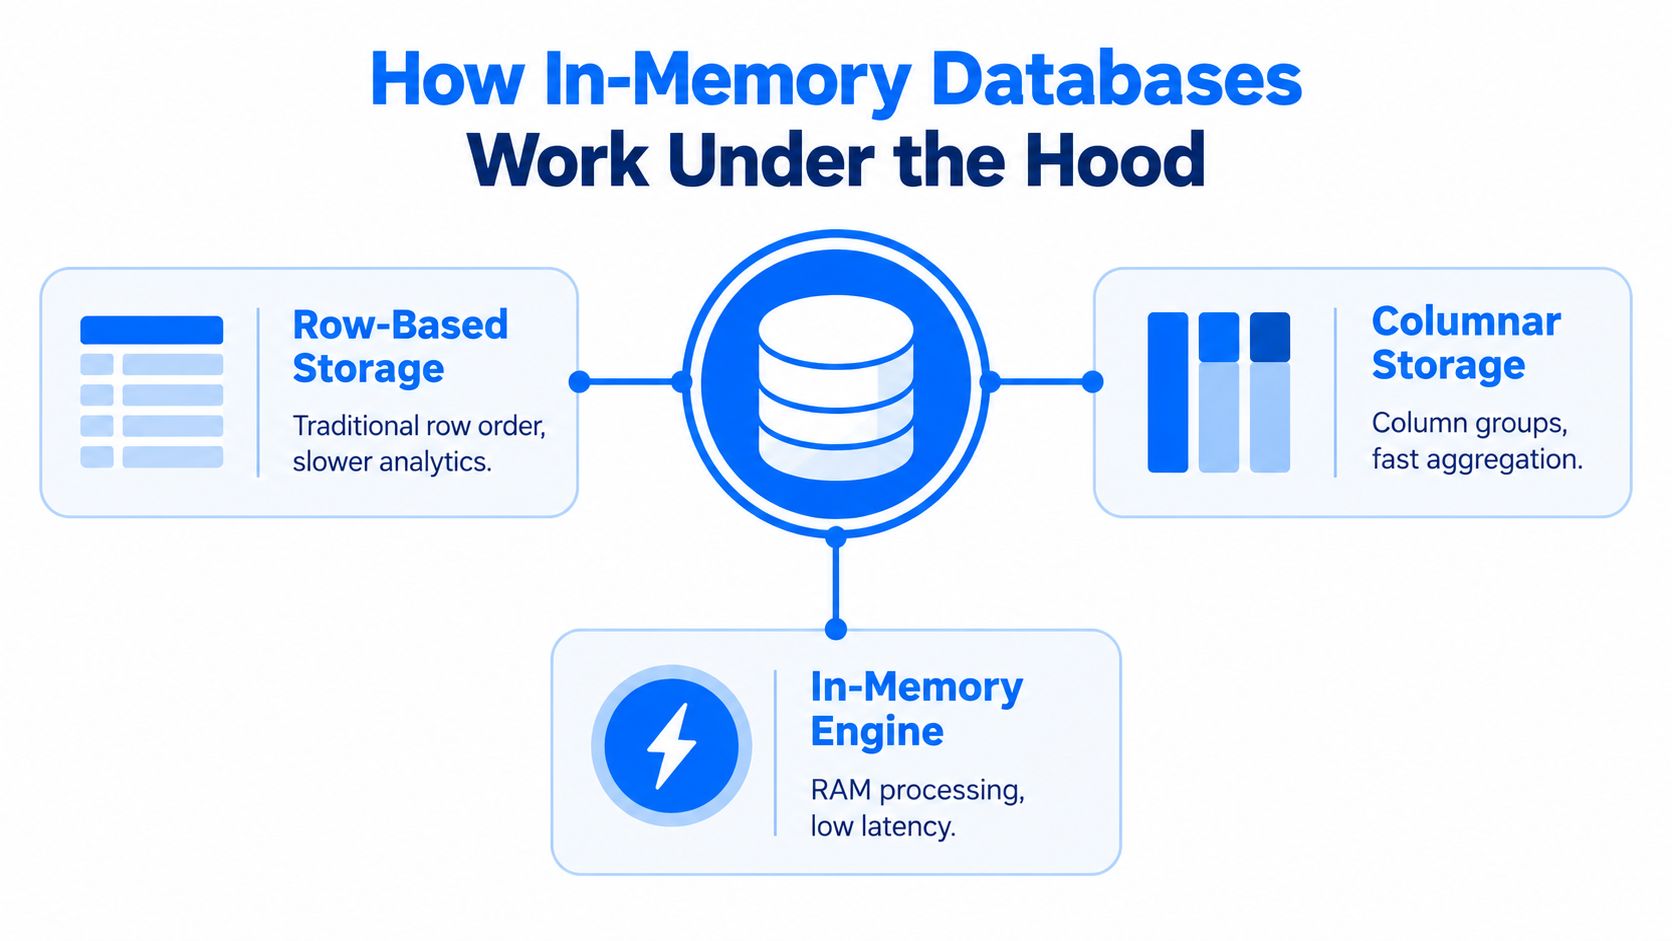
Una base de datos en memoria cambia algo más que la ubicación de los datos: cambia aquello que el motor optimiza. Un sistema orientado a disco está pensado para minimizar las lecturas de almacenamiento, gestionar páginas y aprovechar de forma eficiente un buffer pool. Un motor en memoria puede dedicar una mayor parte de su diseño a la eficiencia de CPU, el ancho de banda de memoria, la compresión, la ejecución en paralelo y las rutas de acceso rápidas.
La primera decisión de arquitectura es la disposición de los datos. El almacenamiento por filas mantiene juntos los campos de un registro, lo que encaja con muchas operaciones transaccionales que leen o actualizan registros completos. El almacenamiento columnar agrupa los valores por columna, de modo que una consulta analítica que necesita una métrica y algunos filtros no tiene que procesar todos los campos de todas las filas. SAP señala la organización por columnas y la distribución entre varios servidores como capacidades importantes de los sistemas en memoria (visión general de HANA de SAP).
Compresión y distribución
La compresión importa porque la RAM es valiosa. Los valores repetidos, las columnas ordenadas y las codificaciones compactas permiten al motor mantener más información activa en memoria y reducir la cantidad de datos que la CPU debe mover. Sin embargo, la compresión no es gratuita. El motor dedica tiempo de CPU a codificar y decodificar valores, así que la pregunta útil no es si hay compresión, sino si su coste de CPU es menor que el coste de memoria y de E/S que evita.
La distribución responde a otra limitación. Un único servidor tiene una memoria y una capacidad de cómputo finitas, por lo que los sistemas pueden particionar los datos y el procesamiento entre varias máquinas. Eso introduce coordinación, tráfico de red, decisiones de replicación y dominios de fallo. Escalar horizontalmente puede ampliar el conjunto de trabajo, pero no hace que las operaciones distribuidas salgan gratis.
La relación entre memoria y disco debe quedar explícita en el diseño. La RAM se encarga del procesamiento activo, mientras que el almacenamiento persistente da soporte a la recuperación y a los datos más fríos. Algunas plataformas usan niveles para que las aplicaciones no tengan que gestionar manualmente cada movimiento. Otras mantienen en memoria un conjunto de trabajo más pequeño y seleccionado deliberadamente, y dejan la fuente de verdad en una base de datos convencional.
Para los equipos que evalúan dónde debe realizarse el cálculo, el procesamiento en base de datos ofrece una comparación arquitectónica útil. Ejecutar el cálculo cerca de los datos puede reducir su movimiento, pero la base de datos sigue necesitando suficiente memoria, CPU y margen de concurrencia para atender tanto las consultas operativas como el trabajo analítico.
En memoria frente a almacenamiento tradicional - El rendimiento real
Las bases de datos en memoria son más rápidas porque eliminan la E/S de almacenamiento de la ruta más crítica, no porque cambien el propio SQL. El motor sigue analizando consultas, evaluando predicados, manteniendo índices u otras estructuras, coordinando workers y gestionando la contención. Una carga de trabajo limitada por la CPU o un modelo de datos deficiente puede anular la ventaja de mantener los datos en RAM.
Las referencias técnicas suelen describir las bases de datos en memoria con lecturas de microsegundos y escrituras de pocos milisegundos. La latencia real depende del motor, el hardware, la configuración de durabilidad, la forma de la consulta y la concurrencia (AWS documenta estas características de latencia). Ese perfil encaja con decisiones que deben tomarse mientras un evento sigue siendo actual.
Rendimiento de bases de datos en memoria frente a bases de datos en disco
Métrica | Base de datos en memoria | Base de datos en disco |
|---|---|---|
Latencia de lectura | Evita la mayoría de los accesos al almacenamiento, pero los fallos de caché, los bloqueos, la serialización y los saltos de red siguen afectando a la latencia de cola | El acceso al almacenamiento, los fallos de la caché de búfer, los índices y la profundidad de cola añaden un retraso más variable |
Latencia de escritura |
| La latencia depende del hardware de almacenamiento, el logging, los checkpoints, los índices y la contención de la carga de trabajo |
Perfil de rendimiento | Muy adecuada para lecturas frecuentes de baja latencia y procesamiento de transacciones activas | Muy adecuada para almacenamiento orientado a capacidad, datos de archivo y cargas de trabajo batch |
Coste de hardware | Mayor coste de memoria, con posibles requisitos de replicación y persistencia | Menor coste de capacidad por unidad de dato almacenado, con mayor dependencia de la infraestructura de almacenamiento |
Mejor encaje operativo | Dashboards en vivo, servicios de decisión, sesiones y conjuntos de trabajo que cambian rápidamente | Datos fríos, retención prolongada, grandes almacenes históricos y procesamiento batch sin plazos estrictos |
La tabla sirve para tomar decisiones de arquitectura, no para comparar productos por su etiqueta. Una base de datos en disco puede superar a un sistema en memoria cuando la consulta está mejor diseñada, y un sistema en memoria puede decepcionar si su conjunto de trabajo se desborda a niveles más lentos. Mida el patrón de acceso y el comportamiento de durabilidad a la vez.
La velocidad solo importa cuando la aplicación puede aprovechar un tiempo de respuesta más corto.
Evalúe la latencia p95 y p99, los requisitos de durabilidad de las escrituras, el uso de memoria, el comportamiento de expulsión o de niveles, el retraso de replicación y el tiempo de recuperación. El ajuste del rendimiento de bases de datos es relevante porque la forma de las consultas y el comportamiento de la carga de trabajo pueden anular la ventaja de un almacenamiento más rápido cuando los patrones de ejecución no se miden.
Cómo resolver el dilema de la durabilidad - Persistencia sin penalización
En memoria no significa sin almacenamiento. La RAM aporta el estado de trabajo de baja latencia, pero una base de datos de producción sigue necesitando registros duraderos para reinicios, failover y recuperación ante desastres. La revisión de Springer analiza la durabilidad y el benchmarking de las IMDB y trata la persistencia como parte del diseño de una base de datos en memoria, no como una salvaguarda opcional.
Logs, snapshots y save points
Un log de transacciones registra los cambios en una secuencia duradera. Tras un reinicio, el motor carga un estado base guardado y vuelve a aplicar los registros del log correspondientes. El trabajo confirmado se conserva, mientras el procesamiento activo continúa sobre los datos residentes en memoria.
Los save points y los snapshots establecen límites de recuperación. A intervalos regulares, el motor escribe en el almacenamiento persistente una representación coherente del estado de trabajo. Ante una caída, la base de datos restaura esa representación y aplica las entradas de log posteriores. Persistir con más frecuencia puede reducir la exposición en la recuperación, pero consume ancho de banda de almacenamiento y puede competir con las consultas y escrituras en curso.
El diseño suele combinar cuatro mecanismos:
Registro de transacciones: registra los cambios para la recuperación y conserva de forma duradera las transacciones confirmadas.
Save points: persisten un estado recuperable sin reescribir todo el conjunto de datos en cada operación.
Snapshots: crean una representación duradera de un momento concreto que puede acelerar el reinicio y la recuperación.
Copias de seguridad asíncronas: ejecutan las copias en segundo plano, dentro de las garantías de recuperación de la base de datos.
SAP indica que el almacenamiento en disco o SSD sigue siendo necesario para la persistencia permanente tras un corte de corriente o una catástrofe, aunque los datos estén disponibles en memoria (guía de persistencia de SAP). SAP HANA ilustra el mismo diseño con un procesamiento compatible con ACID, datos columnares comprimidos en memoria y transacciones confirmadas que se persisten mediante logging y save points para que el sistema pueda recuperarse tras un reinicio (material de administración de HANA de SAP).
Prueba de recuperación: no se quede en «la base de datos tiene persistencia». Restaure un nodo caído, reproduzca los logs y valide las transacciones confirmadas como se describe en nuestra guía de database reliability engineering, y mida el comportamiento de la aplicación durante la recuperación.
La configuración de durabilidad pone de manifiesto un compromiso directo. Una persistencia agresiva protege más escrituras recientes, pero aumenta la presión sobre el almacenamiento y el trabajo de coordinación. Una configuración más relajada puede mejorar el rendimiento de escritura, aunque deja más trabajo para la recuperación. Elija la configuración en función de las consecuencias de negocio de perder datos recientes, el objetivo de recuperación y la capacidad de almacenamiento disponible para la carga de trabajo.
Casos de uso empresariales donde la velocidad es decisiva
Una base de datos en memoria justifica su coste cuando una respuesta tardía cambia el resultado. Los mejores candidatos generan datos de forma continua, los evalúan de inmediato y no pueden esperar a una carga en el data warehouse ni a un ciclo batch largo. La pregunta adecuada no es solo lo rápido que se ejecuta la consulta, sino qué debe hacer la aplicación cuando un nodo se reinicia.
Los servicios financieros ofrecen un ejemplo claro. Llega una transacción y un servicio antifraude necesita el comportamiento actual de la cuenta, el contexto de la transacción y las señales de riesgo antes de aprobarla o cuestionarla. Mantener esas señales activas en RAM acorta el camino desde la ingesta del evento hasta la decisión. Aun así, la carga de trabajo necesita una política de durabilidad definida: las decisiones confirmadas deben poder recuperarse, mientras que las features temporales o las señales derivadas pueden reconstruirse. El análisis de riesgos se beneficia por el mismo motivo, sobre todo cuando los analistas o los controles automatizados necesitan posiciones cambiantes y no los extractos de ayer.

Adecuar el motor a la decisión
Los equipos de fabricación y logística se enfrentan a un problema similar. Sensores, pedidos, movimientos de inventario y eventos de entrega cambian continuamente el panorama operativo. Una capa centrada en memoria puede alimentar dashboards en vivo, detección de excepciones, decisiones de despacho y vistas de capacidad sin obligar a cada petición a pasar por una ruta analítica intensiva en almacenamiento. Encaja con cargas de trabajo en las que la información desactualizada puede provocar un envío perdido, un cambio de producción innecesario o una mala decisión de asignación.
Defina el conjunto de trabajo activo antes de elegir la plataforma:
Identifique la ventana de decisión. Determine qué eventos, entidades y métricas deben estar disponibles de inmediato.
Separe los datos activos de los históricos. Mantenga el contexto operativo actual en la capa rápida y conserve los registros más antiguos en sistemas persistentes adecuados.
Defina el comportamiento ante fallos. Decida qué debe sobrevivir a un reinicio, qué puede reconstruirse y con qué rapidez debe restablecerse el servicio.
Mida la ruta completa. Incluya la ingesta, la transformación, la ejecución de consultas, la persistencia, la replicación y el tiempo de respuesta de la aplicación.
SAP HANA es un ejemplo destacado de combinación de procesamiento transaccional y analítico en una sola plataforma, lo que puede eliminar un salto de movimiento de datos entre las actualizaciones operativas y el análisis. La lección general depende de la carga de trabajo: la consolidación ayuda cuando los sistemas separados añadirían un retraso inaceptable, pero también concentra en una sola plataforma las cuestiones de rendimiento, recuperación y capacidad.
La monitorización de datos en tiempo real requiere algo más que un motor de consultas rápido. Los equipos deben saber si los datos han llegado, si su estructura ha cambiado y si los valores siguen siendo plausibles. Un enfoque de monitorización de datos en tiempo real puede complementar la capa de base de datos comprobando el comportamiento y la disponibilidad de los datos de los que dependen las aplicaciones rápidas. Esa evidencia forma parte del modelo operativo, junto con las mediciones de latencia, recuperación y capacidad.
Ideas erróneas habituales sobre la tecnología en memoria
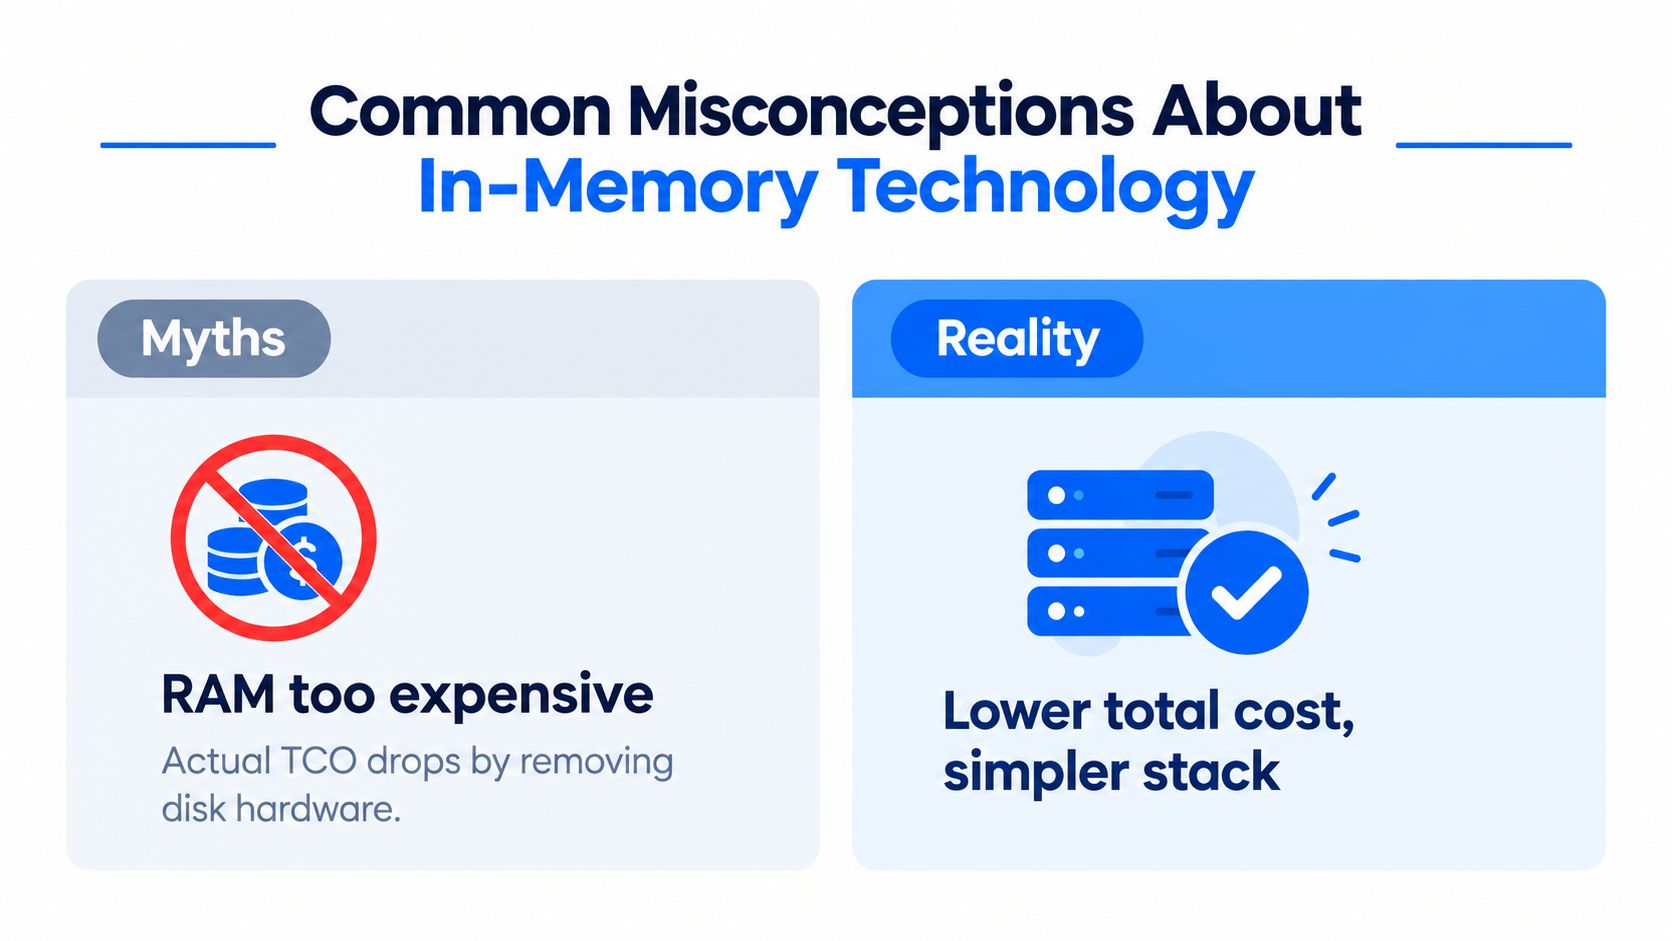
La primera idea errónea es que el coste de la RAM hace que una base de datos en memoria sea automáticamente antieconómica. La RAM es más cara que la capacidad de disco, así que la preocupación es legítima. Pero la comparación no debería quedarse en la factura de memoria. Un diseño centrado en memoria puede reducir la E/S repetida, simplificar algunas rutas de procesamiento y eliminar partes de una arquitectura fragmentada. Que el coste total baje depende del perfil de la carga de trabajo, las licencias, la replicación, la operación y la cantidad de datos que requieren acceso rápido.
Tres supuestos que conviene cuestionar
«Todo el conjunto de datos debe caber en la RAM». No necesariamente. Los diseños modernos pueden mantener los datos calientes en RAM y los más fríos en SSD NVMe, mientras que las arquitecturas distribuidas pueden repartir el procesamiento activo entre varios servidores (AWS describe los niveles de memoria y SSD). La pregunta de dimensionamiento importante es el conjunto de trabajo activo y su patrón de acceso, no solo el volumen histórico total.
«En memoria significa que los datos desaparecen ante un fallo». Un prototipo solo en memoria puede comportarse así. Una base de datos en memoria de producción utiliza mecanismos de persistencia como logs, snapshots o archivos de recuperación, y la configuración de durabilidad determina lo que el sistema puede reconstruir. Los equipos deberían probar esas garantías en lugar de deducirlas del nombre del producto.
«Un almacenamiento más rápido resuelve cualquier problema de base de datos». No es así. Los joins deficientes, la serialización excesiva, la contención de bloqueos, un modelado de datos ineficiente y una cardinalidad sin límites pueden mantener lento incluso a un motor rápido. La tecnología en memoria elimina un tipo de cuello de botella, la latencia de almacenamiento, pero deja a la vista el resto del sistema.
La pregunta correcta no es «¿Podemos poner esta base de datos en memoria?», sino «¿Qué datos y qué decisiones justifican una ejecución centrada en memoria?».
Otra idea errónea es que una única arquitectura debe atender todas las cargas de trabajo. Los archivos históricos, los grandes almacenes de retención y las transformaciones batch suelen beneficiarse de un almacenamiento persistente orientado a la capacidad. Una capa en memoria puede convivir con esos sistemas y acelerar la ruta activa sin convertirse en el único lugar donde residen los datos.
Cómo decidir si una base de datos en memoria encaja en su stack
Elija primero la carga de trabajo y después el producto. Una base de datos en memoria encaja cuando los usuarios o servicios necesitan una latencia baja y constante, las transacciones llegan de forma continua, los registros activos se reutilizan con frecuencia y las decisiones tardías generan costes operativos. Es menos adecuada para el acceso a archivos históricos, las consultas batch programadas o un conjunto de trabajo demasiado frío para justificar su consumo de RAM.
Utilice este filtro de decisión:
Elija la ejecución centrada en memoria para señales de fraude, vistas operativas en vivo, estado de sesión, decisiones de alta frecuencia y cargas de trabajo en las que la E/S de almacenamiento domina el tiempo de respuesta.
Mantenga el almacenamiento tradicional como eje central para archivos fríos, conjuntos de datos con retención prolongada, informes poco frecuentes y trabajos batch con ventanas de finalización flexibles.
Utilice un diseño híbrido cuando solo una parte del conjunto de datos necesite acceso inmediato y el resto permanezca en niveles persistentes.
El mercado ha dejado atrás la experimentación de nicho. Las estimaciones sitúan el mercado mundial de bases de datos en memoria en unos 7.200 millones de USD en 2024, 8.140 millones de USD en 2025 y 9.050 millones de USD en 2026, hasta alcanzar 15.310 millones de USD en 2031, según la estimación de mercado de Fortune Business Insights. El crecimiento del mercado respalda una adopción continuada, pero no sustituye a las pruebas con cargas de trabajo reales ni a la validación de la recuperación ante fallos.
Antes de comprometerse, haga benchmarks de consultas representativas, verifique la persistencia ante cortes de corriente y reinicios, mida la presión de memoria y compruebe el comportamiento de los niveles de almacenamiento. Ajuste la ruta SQL con la optimización de consultas SQL y compare después las mejoras de latencia medidas con los costes de memoria, licencias, replicación y operación. El resultado debería ser una decisión de infraestructura basada en el sistema que realmente opera.
digna ayuda a los equipos de datos a monitorizar anomalías, timeliness, cambios de schema y comprobaciones de calidad a nivel de registro dentro de sus propias bases de datos. Si su arquitectura en memoria depende de datos de entrada actuales y fiables, visite digna para evaluar un enfoque de observabilidad en base de datos.
Un motor rápido solo sirve si los datos que lo alimentan están al día, así que conviene comprobar si cada tabla de origen ha llegado realmente a tiempo; descubra cómo digna Timeliness aprende los patrones de llegada esperados y avisa de cargas retrasadas o ausentes.
Preguntas frecuentes
¿Una base de datos en memoria pierde datos cuando se va la corriente?
No en un sistema de producción. La RAM se trata como la superficie de trabajo rápida, no como el registro permanente, por lo que tras un corte de corriente el motor restaura un estado guardado desde disco o SSD y vuelve a aplicar su log de transacciones. SAP HANA, por ejemplo, persiste las transacciones confirmadas mediante logging y save points.
¿Cuánto más rápida es una base de datos en memoria que una basada en disco?
Se ha descrito el acceso a memoria como unas 10 veces más rápido que el acceso a disco, y las referencias técnicas citan lecturas de microsegundos y escrituras de pocos milisegundos. Aun así, la latencia real depende del hardware, la configuración de durabilidad, la forma de la consulta y la concurrencia, por lo que los equipos deberían medir la latencia p95 y p99 en lugar de fiarse de las cifras de titular.
¿Todos mis datos tienen que caber en la RAM?
No. Los diseños modernos mantienen los datos calientes en RAM y trasladan los más fríos a SSD NVMe, y las configuraciones distribuidas reparten el conjunto de trabajo entre varios servidores. La pregunta de dimensionamiento que importa es el conjunto de trabajo activo y cómo se accede a él, no el volumen histórico total de la base de datos.
¿Cuándo conviene usar una base de datos en memoria en lugar de una tradicional?
Cuando una respuesta tardía cambia el resultado, por ejemplo en señales de fraude, dashboards operativos en vivo, estado de sesión o decisiones de despacho. Los archivos fríos, los datos de retención prolongada y los trabajos batch con ventanas flexibles suelen corresponder a un almacenamiento en disco orientado a la capacidad, mientras que un diseño híbrido se adapta a cargas de trabajo en las que solo una parte de los datos está caliente.
¿Qué diferencia hay entre fsync-per-commit y group commit?
Ambos determinan cuándo llegan las escrituras al almacenamiento duradero. Fsync-per-commit vuelca cada transacción de inmediato, lo que ofrece la máxima durabilidad con un mayor coste por escritura. Group commit agrupa varios volcados, lo que aumenta el rendimiento pero añade coordinación de commits, así que la elección adecuada depende de lo costoso que sería perder las escrituras recientes.


