¿Qué es la gestión de la calidad de los datos y por qué es importante?
|
8
minuto de lectura

Ya conoce la sensación. El panel de control se ve tranquilo, el liderazgo lo está utilizando en las reuniones y nadie se ha quejado. De repente, un cambio de esquema ascendente se cuela en un flujo de pagos, la cifra de ingresos se desvía y el error permanece allí el tiempo suficiente para influir en las decisiones antes de que alguien lo note. Ese es el punto en el que la gestión de la calidad de los datos deja de ser un ejercicio teórico y se convierte en un sistema de control.
La gestión de la calidad de los datos es la práctica continua de garantizar que los datos sean aptos para las personas y los sistemas que los consumen. En producción, esto significa medir, monitorear y remediar los datos a medida que se mueven a través de pipelines, modelos, informes y flujos de trabajo operativos. El antiguo modelo de limpiar datos de vez en cuando nunca se sostuvo en las empresas reales, especialmente una vez que los datos comenzaron a alimentar la analítica, la automatización y los informes regulados.
Tabla de contenidos
Cuando los datos de confianza se convierten en una responsabilidad
Cómo funciona realmente la gestión de la calidad de los datos
Cuando los datos de confianza se convierten en una responsabilidad
Un CFO confía en el panel de ingresos. Finanzas lo ha utilizado durante meses, las cifras concuerdan la mayoría de los días y el informe llega a la revisión operativa semanal sin controversias. Luego, un pequeño cambio de esquema ascendente llega a la tubería de pagos, el trabajo de transformación se sigue ejecutando, no se activa ninguna alerta y el panel sigue siendo incorrecto durante tres semanas hasta que la queja de un cliente obliga a alguien a mirar más de cerca.
Ese tipo de falla es exactamente la razón por la cual la gestión de la calidad de los datos existe como una disciplina, no como una tarea de limpieza doméstica. El arco histórico importa aquí. El MIT lanzó el programa de Gestión de la Calidad Total de los Datos en 1988, lo que ayudó a establecer un enfoque basado en el ciclo de vida para medir, mejorar y monitorear continuamente la calidad de los datos. La investigación fundamental resumida por Harvard Business Review también informó que solo el 3% de los datos de las empresas cumplían con los estándares básicos de calidad, según 195 mediciones en integridad, precisión, coherencia y Timeliness, y que el 47% de los registros recién creados contenían al menos un error crítico (Integrate.io).
Esas cifras explican el cambio de la limpieza a la governance. El problema no es que los equipos no sepan que existen datos erróneos, sino que los datos erróneos a menudo se ocultan hasta que ya se han movido río abajo. La gestión de la calidad de los datos moderna tiene que operar a la velocidad de la tubería, porque un registro obsoleto, una unión rota o un evento de desviación de esquema pueden hacer que un panel de control confiable mienta sin llegar a activar una auditoría por lotes tradicional.
Por qué se rompe el viejo modelo
La auditoría periódica funciona solo cuando la empresa puede tolerar el retraso. Eso rara vez ocurre ahora. Un flujo roto puede envenenar modelos, capas de informes y controles mucho antes de que una revisión mensual lo detecte.
Regla práctica: si un conjunto de datos puede influir en el dinero, el riesgo o la atención al paciente, los controles de calidad corresponden a la tubería, no a una revisión de hoja de cálculo después del hecho.
La línea práctica entre "datos limpios" y calidad de datos gestionada es simple. La limpieza es reactiva, después de que el problema es visible. La gestión es continua, medida y vinculada a requisitos explícitos del consumidor. Esa es la diferencia entre solucionar un problema y prevenir un fallo silencioso.
Las Las seis dimensiones de la calidad de los datos
Muchos equipos hablan de la calidad de los datos como si fuera una sola cosa. No lo es. Un conjunto de datos puede ser aceptable para un caso de uso e inútil para otro, razón por la cual la disciplina se basa en múltiples dimensiones, no en una sola puntuación. La guía técnica alineada con el material de ISO y NPL trata la precisión, la integridad, la coherencia, la Timeliness, la trazabilidad, la disponibilidad y el Compliance como dimensiones distintas que deben medirse de forma independiente, porque el mismo conjunto de datos puede ser adecuado para un flujo de trabajo e inaceptable para otro (NPL guidance).
Para el trabajo de ingeniería diario, las seis dimensiones que la mayoría de los equipos operacionalizan son las siguientes.
Qué detecta cada dimensión
La precisión se refiere a si los datos reflejan la realidad. Si una unión duplica filas, un cálculo del valor de vida del cliente puede parecer plausible pero ser incorrecto. Mídalo con controles de integridad referencial, conciliación y controles que comparen los valores esperados frente a los observados.
La integridad se refiere a la información faltante. Los valores nulos en un campo de segmentación pueden excluir a personas de una campaña o dejar a un modelo ciego ante una parte de la población. Las comprobaciones de tasa de nulos y la validación de campos obligatorios son las herramientas básicas aquí.
La Timeliness es si los datos llegan cuando se necesitan en relación con el evento que describen. Un modelo de fraude que se ejecuta con características obsoletas puede tomar una decisión incorrecta con total confianza. Los SLA de frescura, la detección de llegadas tardías y los umbrales basados en la antigüedad son los controles prácticos.
La coherencia significa que la misma entidad no se contradice entre sistemas. Si el CRM y la facturación no coinciden en la dirección de un cliente, los flujos de trabajo posteriores entrarán en conflicto entre sí. La conciliación entre diferentes fuentes y las reglas de estandarización detectan esto.
La validez comprueba si los valores se ajustan al dominio, formato o conjunto de reglas esperados. Después de una migración de origen, un campo de estado puede comenzar a contener valores fuera de la enumeración aprobada. Las comprobaciones de dominio y la validación de formato se encargan de eso.
La unicidad se refiere a los registros duplicados. En el sector de la salud, los registros duplicados de pacientes fragmentan los historiales médicos y dificultan la coordinación de la atención. La lógica de deduplicación, las comprobaciones de clave única y la coincidencia de identidad son las defensas habituales.
Dimensiones de calidad de datos de un vistazo | Cómo se mide | Casos de uso más sensibles |
|---|---|---|
Precisión | Conciliación, integridad referencial, totales de control | Finanzas, facturación, informes ejecutivos |
Integridad | Tasas de nulos, comprobaciones de campos obligatorios | Segmentación, informes regulatorios, flujos de trabajo clínicos |
Timeliness | SLA de frescura, umbrales de antigüedad de llegada | Fraude, operaciones, analítica en tiempo real |
Coherencia | Comparación entre fuentes, reglas de estandarización | Datos maestros, operaciones de clientes, informes |
Validez | Comprobaciones de enumeración, comprobaciones de rango, comprobaciones de formato | Sistemas operativos, Compliance, automatización |
Unicidad | Detección de duplicados, coincidencia de identidad | Atención médica, CRM, resolución de identidad |
Si desea un desglose más profundo del modelo de dimensiones, vale la pena comparar el marco práctico de las dimensiones de calidad de datos de digna con su propio diseño de control.
El error que veo con más frecuencia es que los equipos construyen una puntuación agregada y la llaman governance. Eso oculta el modo de fallo que realmente importa.
La pregunta correcta no es "¿Son buenos los datos?". La pregunta correcta es "¿Buenos para qué y medidos cómo?".
Cómo funciona realmente la gestión de la calidad de los datos
La gestión de la calidad de los datos funciona como un ciclo de vida, no como una puerta de acceso. La norma ISO 8000-61:2016 lo enmarca como un ciclo de Planificar-Hacer-Verificar-Actuar: planificar la estrategia, implementar los procesos, monitorear y medir el rendimiento frente a los requisitos, y luego tomar acciones correctivas para seguir mejorando (ISO 8000-61:2016). Esa estructura es importante porque convierte la calidad en un ritmo operativo en lugar de un proyecto único.
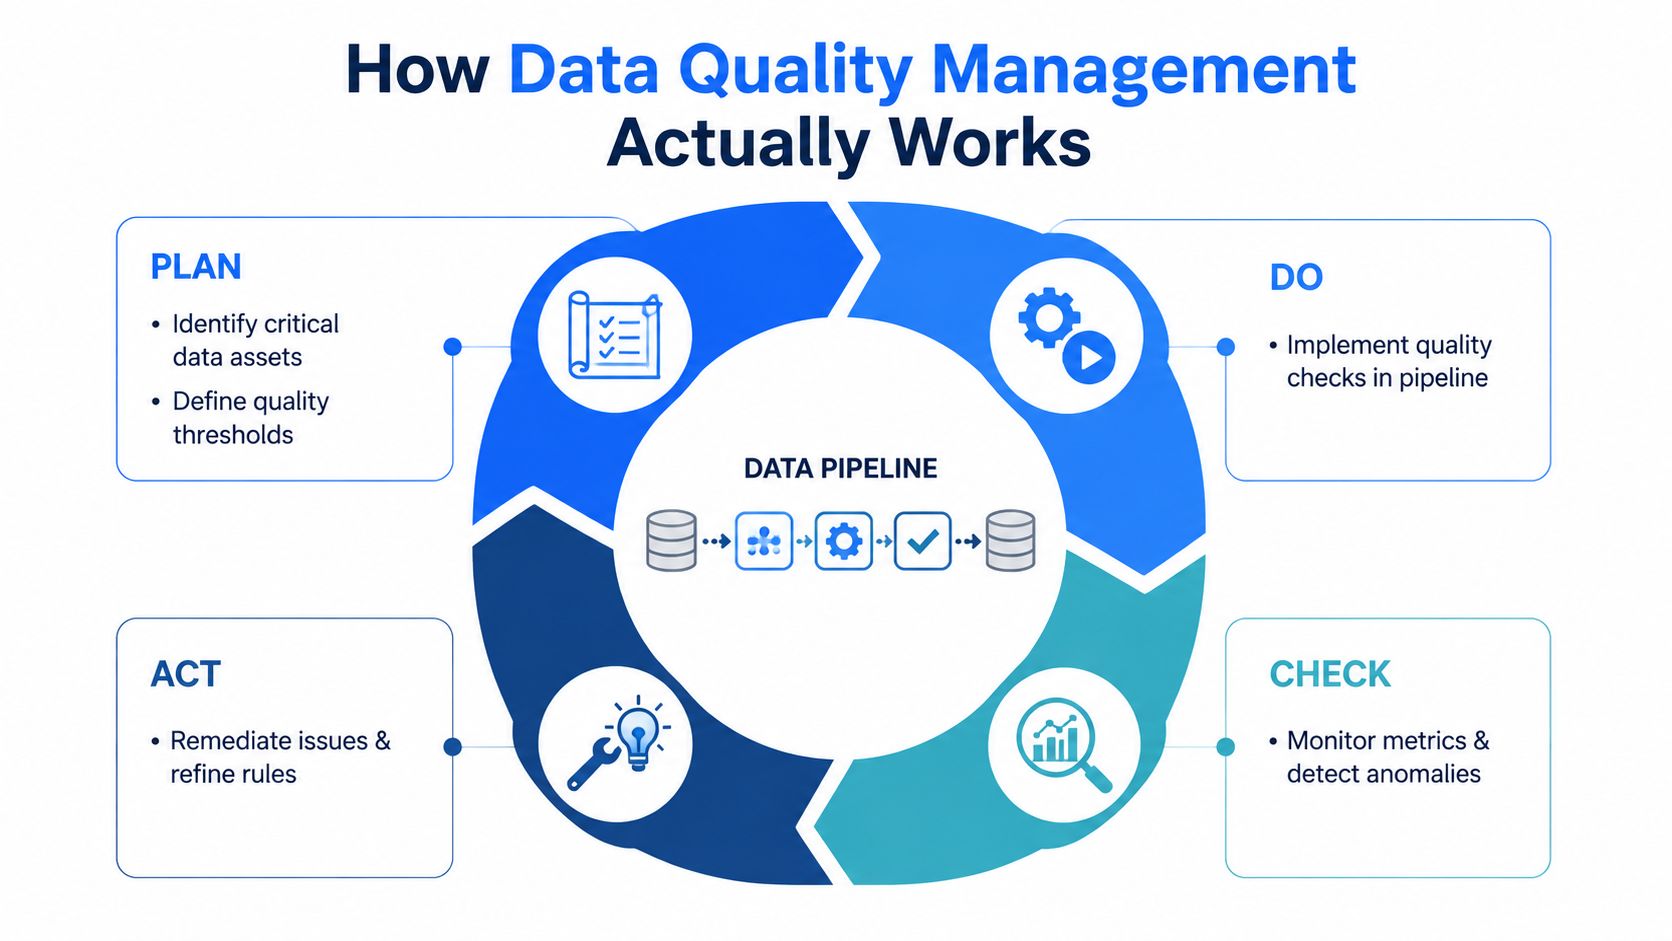
Planificar, hacer, verificar, actuar en producción
Planificar comienza con la identificación de los activos críticos, la definición de umbrales con las partes interesadas del negocio y la asignación de la propiedad. La norma ISO 8000-150:2022 se centra en las funciones y responsabilidades, que es la parte que muchos equipos omiten hasta que un incidente demuestra que no pueden permitirse no hacerlo (ISO 8000-150:2022). Alguien tiene que ser el propietario de la regla, la excepción y la corrección.
Hacer es donde reside la validación. En tuberías bien gestionadas, eso significa contratos de esquema, comprobaciones de rango, comprobaciones de dominio, comprobaciones de nulos y pruebas de transformación integradas directamente en los trabajos, no añadidas a posteriori. Una implementación práctica también puede seguir las mejores prácticas de ingeniería de datos, donde la orquestación, el control de versiones y la capacidad de prueba se integran en el flujo de trabajo desde el principio.
Verificar es el monitoreo continuo. Tanto la guía de ISO como el trabajo de implementación respaldan la medición a intervalos o de forma continua, lo cual es fundamental porque muchos defectos se muestran como desviaciones, retrasos o cambios estructurales antes de convertirse en fallas obvias (ISO 8000-61:2016, estudio de implementación de MDPI). Las alertas deben clasificar la gravedad, no solo gritar.
Actuar es la remediación. Los registros erróneos pueden ponerse en cuarentena, corregirse cuando sea viable o desviarse para su revisión manual, pero la clave es que cada excepción necesita una ruta documentada y un bucle de retroalimentación de vuelta al conjunto de reglas. Así es como los administradores de datos, ingenieros y analistas se mantienen alineados en lugar de discutir después del hecho.
Regla operativa: no construya un programa de calidad que solo bloquee las tuberías. Construya uno que le diga al equipo qué falló, qué tan grave es y qué hacer a continuación.
La elección de la plataforma es importante, pero el modelo operativo lo es más. Un buen sistema de control detecta el problema a tiempo, contiene el radio de impacto y deja un rastro de auditoría.
De reglas estáticas a la Observability continua
Los controles de calidad por lotes tradicionales detectan los errores tarde. Para cuando falla una aserción SQL diaria, los consumidores intermedios ya pueden haber tomado decisiones, entrenado modelos o publicado paneles de control basados en datos erróneos. La cobertura reciente del sector apunta a un cambio hacia la validación continua, los controles aumentados por IA y una governance que tenga en cuenta la privacidad, porque la limpieza estática no se adapta a las tuberías, modelos y métricas comerciales en tiempo real (cobertura de DZone).
Ese cambio es visible en las herramientas que utilizan los equipos. En lugar de escribir a mano cada umbral, las capas modernas de observabilidad aprenden líneas base, vigilan anomalías y rastrean cambios de esquema automáticamente. También monitorean la frescura para que los flujos obsoletos surjan como problemas operativos en lugar de sorpresas comerciales.
Qué cambia en la práctica
Una pila de observabilidad práctica suele cubrir tres cosas. Primero, la detección de anomalías busca desviaciones estadísticas del comportamiento de referencia. Segundo, el rastreo de esquemas detecta columnas añadidas, columnas eliminadas y cambios de tipo antes de que afecten a los consumidores. Tercero, el monitoreo de la Timeliness marca las llegadas tardías o faltantes para que el problema se gestione como un incidente y no como un misterio.
El punto no es solo la velocidad. Es el contexto. Una columna puede estar técnicamente presente pero ser semánticamente incorrecta, y una tabla puede superar una comprobación de validez genérica y, al mismo tiempo, estar demasiado obsoleta para confiar en ella. La capa de observabilidad le brinda la señal que el antiguo modelo de auditoría nunca pudo, especialmente una vez que los datos comienzan a impulsar agentes de IA y decisiones automatizadas.
Si está mapeando eso a una pila de productos, la descripción de la arquitectura sobre el enfoque de Data Observability de digna es un punto de referencia útil sobre cómo encajan los controles continuos en un monitoreo más amplio.
La Observability continua no reemplaza las reglas, hace que las reglas sean viables al ritmo de producción.
Se está logrando una detección más temprana. En lugar de enterarse de una mala carga después de que el negocio se queje, el equipo ve el problema casi en el momento en que aparece y puede responder mientras el radio de impacto aún es pequeño.

Elegir la arquitectura y las herramientas adecuadas
Una pila de gestión de la calidad de los datos deficiente suele fallar de una de dos maneras. Los controles se sitúan demasiado lejos de los datos e introducen latencia, o viven tan cerca de los sistemas de producción que crean una sobrecarga operativa. La ejecución en la base de datos mantiene la validación cerca del almacén o lago de datos, lo que reduce el movimiento y se adapta a entornos sensibles a la seguridad, pero puede aumentar el uso de cómputo. Las plataformas de observabilidad nativas de la nube centralizan el monitoreo y la detección gestionada, pero pueden plantear dudas sobre la residencia de los datos y la privacidad si los datos incorrectos salen del límite.
Opciones de arquitectura y compensaciones
Compensaciones de la arquitectura de calidad de datos | Ideal para | Compensaciones clave | Consideraciones de privacidad |
|---|---|---|---|
Ejecución en base de datos | Almacenes de datos, lagos de datos, tuberías reguladas | Bajo movimiento, integración más estrecha, posible aumento del costo de cómputo | Excelente opción cuando los datos deben permanecer dentro de sistemas controlados por el cliente |
Observability nativa de la nube | Equipos que desean un monitoreo gestionado y paneles compartidos | Configuración rápida, vista centralizada, posibles preocupaciones de residencia de datos | Requiere una revisión cuidadosa de la PII, la jurisdicción y el acceso de los proveedores |
Marcos personalizados | Requisitos de control altamente especializados | Máxima flexibilidad, mayor mantenimiento de ingeniería | Se pueden diseñar para un aislamiento estricto, pero la carga de la propiedad sigue siendo interna |
Pilas híbridas | Entornos de madurez mixta | Equilibrio entre velocidad y control, más trabajo de integración | Útil cuando las comprobaciones sensibles se mantienen locales mientras los metadatos se centralizan |
La arquitectura adecuada responde a la regulación, la escala y la madurez operativa. Los equipos de finanzas, salud, telecomunicaciones y del sector público suelen necesitar un control más estricto sobre dónde se ejecuta la validación, quién puede ver los resultados y cómo se documentan las excepciones. Para los equipos que desean ese control dentro de su propio entorno, una descripción general de las compensaciones de la arquitectura de sistemas de datos ayuda a enmarcar dónde deben ejecutarse la validación, la detección de anomalías, el monitoreo de la Timeliness y el seguimiento de esquemas.
La elección de la plataforma debe evaluarse como una capa de control, no solo como la compra de una herramienta. Si el equipo aún tiene que exportar datos para inspeccionarlos, se pierde parte del valor. Si la plataforma no se integra con la orquestación, los metadatos y los flujos de trabajo de incidentes, se convierte en otro panel de control en el que la gente deja de confiar. La prueba práctica es simple: si las comprobaciones se adaptan a la tubería sin obligar a transferencias adicionales, copias adicionales o revisiones manuales adicionales.
Prioritizar lo que más importa
Intentar monitorear cada tabla por igual es la forma en que mueren los programas de calidad. Comienza la fatiga por alertas, los ingenieros silencian las notificaciones y el equipo deja de creer en el sistema cuando realmente importa. El mejor patrón es priorizar por criticidad comercial, porque la tabla que alimenta los informes ejecutivos, las entradas de modelos o las presentaciones regulatorias merece un estándar diferente al de un conjunto de datos de preparación de bajo riesgo.
La evidencia de las encuestas apunta a un problema relacionado: los equipos a menudo saben que la calidad importa, pero no siempre saben cómo probar bien los datos. Eso hace que la priorización sea aún más importante, porque obliga a tomar decisiones sobre qué comprobaciones importan, dónde deben situarse los umbrales y qué nivel de falsos positivos es aceptable (encuesta de referencia de Synq).
Cómo enfocar el programa
Comience por mapear el linaje para conocer el radio de impacto de cada activo. Una sola fuente rota puede afectar a un panel de control, un pronóstico y un flujo de Compliance, pero la urgencia de la remediación no será idéntica en los tres casos. El punto es clasificar el conjunto de datos por su impacto intermedio antes de decidir qué monitorear.
La perspectiva de planificación interna sobre elementos de datos críticos es un marco útil para ese tipo de triaje.
Datos de ingresos y riesgos: Implemente comprobaciones en tiempo real o casi en tiempo real en los campos que afectan el movimiento de dinero, la exposición o la evidencia regulatoria.
Entradas de modelos: Vigile primero la frescura, la desviación del esquema y los valores faltantes, porque las entradas obsoletas o mal formadas rompen rápidamente la confianza en el modelo.
Conjuntos de datos operativos: Utilice umbrales que reflejen la tolerancia comercial, no la pureza teórica.
Tablas de analítica de bajo impacto: Acepte un monitoreo más ligero si el costo de una falla aguas abajo es bajo.
Si todo es crítico, nada lo es.
Ese es el argumento práctico del ROI. Un programa enfocado dedica la atención de la ingeniería allí donde el costo de la falla es mayor, y deja las tablas de bajo valor bajo una vigilancia más ligera sin pretender que eso sea una debilidad. La governance se fortalece porque deja de intentar ser universal.
Cómo construir su programa de calidad de datos
Un programa que sobreviva al contacto con la producción necesita fases. La primera fase es el inventario de activos y los SLA de referencia. La segunda es la validación automatizada en los límites de ingesta y transformación. La tercera es la detección de anomalías, el monitoreo de la frescura y la conciliación entre fuentes. La cuarta es la respuesta a incidentes, el escalamiento y el refinamiento continuo.
La guía de implementación sobre el equipo de calidad de datos de digna se adapta a ese enfoque por fases porque el modelo de equipo importa tanto como las propias reglas. Sin propiedad, las excepciones persisten y los mismos errores vuelven a ocurrir bajo nuevos nombres.
Una ruta de despliegue práctica
Comience con los activos que conllevan el mayor riesgo comercial. Defina lo que significa "bueno" con el negocio, no solo con la ingeniería, y escriba los umbrales. Si las partes interesadas no pueden ponerse de acuerdo sobre el SLA, el programa no tiene un problema de calidad, tiene un problema de requisitos.
Luego, agregue controles donde los datos ingresan o cambian de forma. Las comprobaciones de esquema, los umbrales de nulos y las pruebas de integridad referencial son la primera capa porque detectan las roturas de tuberías más comunes sin hacer que el sistema sea frágil. Después de eso, introduzca la detección de anomalías y las comprobaciones de Timeliness para que el programa pueda capturar desviaciones, no solo violaciones obvias de las reglas.
La capa de incidentes debería ser aburrida, y eso es un cumplido. Las alertas necesitan enrutamiento, los propietarios necesitan guías de ejecución y los incumplimientos necesitan rutas de escalamiento. El propósito no es crear más tickets, sino acortar el tiempo entre la detección y la corrección.
El éxito debe ser visible en las operaciones, no en los eslóganes. Realice un seguimiento del tiempo medio de detección, el tiempo medio de resolución, la proporción de activos críticos bajo monitoreo activo y la reducción de incidentes intermedios. Esas señales le indican si el programa está mejorando el control o simplemente generando ruido.
Los patrocinadores ejecutivos escuchan cuando se conecta la calidad con menos ciclos de retrabajo, un entrenamiento de modelos más rápido y menos hallazgos de Compliance. Dejan de escuchar cuando la conversación se mantiene abstracta.
Un buen programa hace que la calidad sea medible, tenga un propietario y sea repetible. Esa es la diferencia entre la característica de una plataforma y una disciplina empresarial.
Si está implementando o reemplazando un programa de calidad de datos, digna puede ayudarlo a monitorear conjuntos de datos críticos dentro de su propio entorno con validación, detección de anomalías, comprobaciones de Timeliness y seguimiento de esquemas en una sola capa operativa. Visite digna para ver cómo los controles continuos pueden adaptarse a sus tuberías, su modelo de governance y los sistemas comerciales que dependen de datos de confianza.


