Algoritmos de coincidencia difusa: guía práctica
|
7
minuto de lectura

Con un nivel de confianza de 0,95 o superior, un enfoque de ensamble con intervención humana (human-in-the-loop) alcanzó una precisión del 88,0 %, mientras que la similitud de Jaccard llegó al 85,0 % en el mismo rango de puntuaciones altas. La respuesta práctica es que ningún algoritmo de coincidencia difusa es el mejor en todos los casos, porque una resolución de identidades fiable depende de la normalización, la generación de candidatos, la evidencia por campo, los umbrales y la revisión.
Probablemente ya se esté enfrentando a esto. Un cliente aparece con nombres ligeramente distintos en los sistemas de facturación, soporte y producto. La dirección de un proveedor cambia de formato entre filiales. Un registro de paciente usa un alfabeto en un sistema y una versión transliterada en otro. Los joins exactos pasan por alto vínculos legítimos, mientras que una regla difusa demasiado permisiva puede fusionar a personas que solo se parecen.
Lo difícil no es obtener una puntuación de similitud. Lo difícil es decidir qué significa esa puntuación, demostrar por qué se aprobó una coincidencia y detectar cuándo el proceso de coincidencia empieza a fallar sin previo aviso.
Índice de contenidos
Fundamentos: de la distancia de edición al enlace probabilístico
Comparación de las principales familias de algoritmos y sus compromisos de rendimiento
Coincidencia multilingüe y el cuello de botella del blocking
Integrar la coincidencia difusa con la observabilidad de datos
El coste oculto de una coincidencia de datos imprecisa
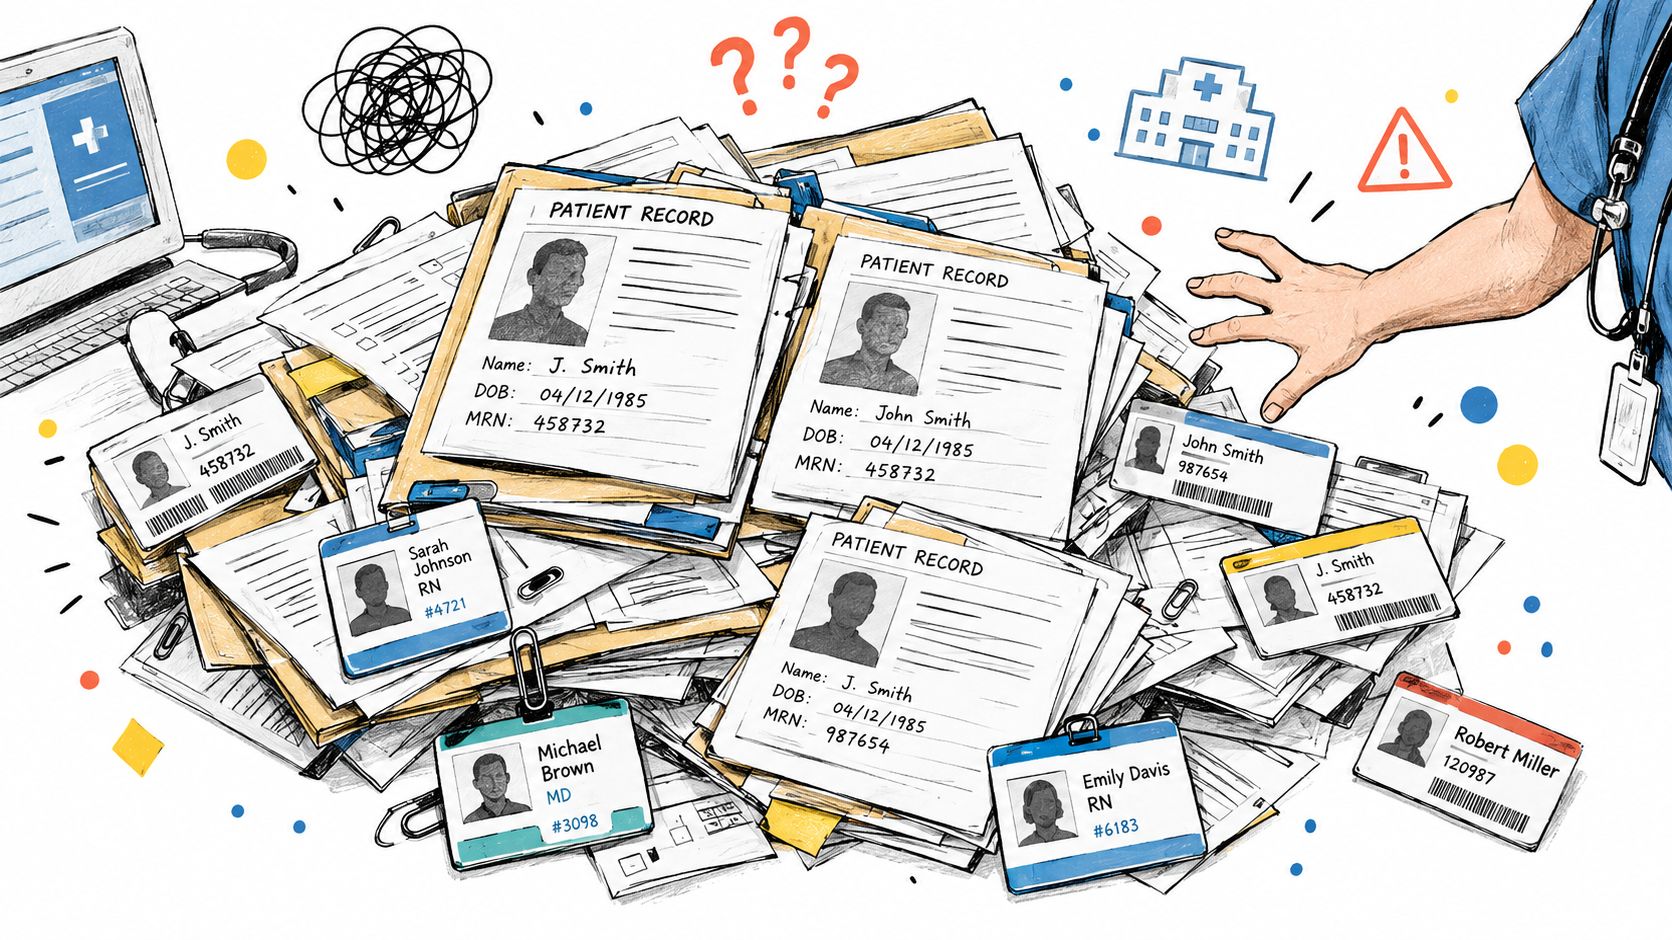
Un proveedor sanitario global puede construir una vista del paciente a partir de los sistemas de admisión, laboratorio, facturación y clínicos. Una fuente guarda «Muller», otra guarda «Miller» y una tercera incluye un segundo nombre o un formato de dirección diferente. Un join de igualdad los trata como registros separados, aunque el personal pueda reconocer al instante la probable conexión.
El error inverso es más peligroso. Dos pacientes pueden compartir apellido, dirección o un nombre parecido sin ser la misma persona. Una fusión incorrecta puede asignar resultados de laboratorio o el historial clínico al perfil equivocado. Un duplicado sin resolver puede fragmentar la información asistencial, generar trabajo administrativo repetido y debilitar los informes.
Por qué fallan los joins exactos
La coincidencia exacta da por hecho que los valores se introdujeron de forma coherente y se transmitieron sin variaciones relevantes. Los datos empresariales rara vez cumplen esa premisa. Los nombres contienen variantes ortográficas, las direcciones incluyen abreviaturas y componentes reordenados, y los identificadores pueden estar incompletos o copiados con ruido de formato.
Los algoritmos de coincidencia difusa ayudan porque miden el parecido en lugar de exigir igualdad carácter a carácter. Pero el parecido es solo un indicio. Una puntuación de nombre puede identificar un par candidato, pero no puede establecer la identidad sin el contexto de otros campos y sin tener en cuenta las consecuencias de negocio de equivocarse.
Regla de producción: trate la coincidencia difusa como un flujo de decisión, no como una versión más inteligente de un join de igualdad.
Esa distinción importa en finanzas, sanidad, servicios públicos y operaciones con clientes. Una coincidencia falsa vincula registros que no tienen relación. Una no coincidencia falsa deja fragmentada a la misma entidad. El coste de cada error depende del dominio, del campo y de lo que hagan los sistemas posteriores con la identidad resultante.
Por eso, los equipos deberían conectar el diseño de la coincidencia con una toma de decisiones basada en la calidad de los datos más amplia. La pregunta correcta no es «¿Qué cadenas se parecen?», sino «¿Qué evidencia respalda este vínculo de identidad, qué riesgo crea una fusión incorrecta y puede otra persona auditar la decisión más adelante?».
Fundamentos: de la distancia de edición al enlace probabilístico
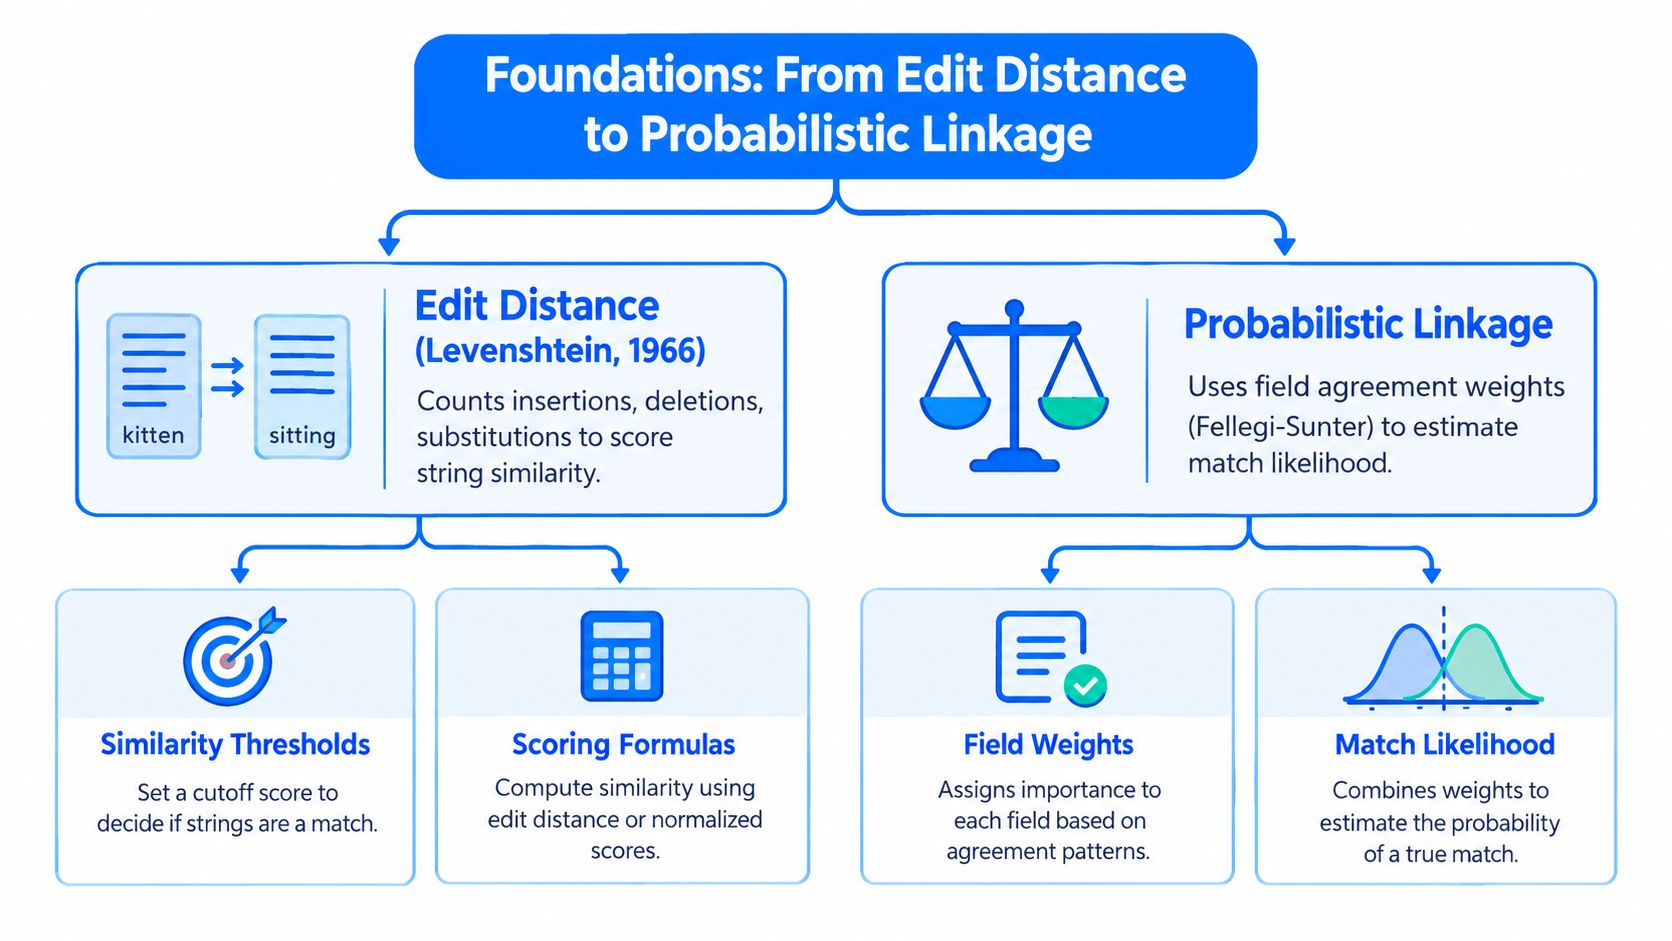
La coincidencia difusa evolucionó desde los métodos de distancia de edición hasta el enlace probabilístico formal de registros. En 1966, Vladimir Levenshtein presentó la distancia que hoy lleva su nombre, el número mínimo de inserciones, eliminaciones o sustituciones de un solo carácter necesarias para transformar una cadena en otra, tal como se describe en la literatura fundacional sobre enlace de registros publicada por Fellegi y Sunter.
Un error tipográfico de un carácter tiene distancia 1. Las cadenas que requieren más ediciones reciben distancias mayores. Como la operación no depende del idioma, resultó útil para la corrección ortográfica, la deduplicación, la normalización de direcciones y la resolución de entidades.
La distancia mide la diferencia
La distancia de Levenshtein responde a una pregunta acotada pero valiosa: ¿cuánto texto debe cambiar para obtener el otro valor? No sabe si los valores pertenecen a la misma persona, empresa, cuenta o dirección.
Eso la convierte en una capa de comparación útil. Puede detectar una errata en un nombre o una pequeña alteración en un identificador, pero no debería ejecutar por sí sola una fusión irreversible. La misma distancia puede significar cosas distintas en un nombre corto, una dirección larga o un identificador de alto riesgo.
El enlace toma una decisión
En 1969, Ivan Fellegi y Alan Sunter publicaron «A Theory for Record Linkage». Su marco trataba la coincidencia como un problema de decisión estadística y no como un único umbral de similitud. Combina evidencia de campos como nombres, direcciones, fechas de nacimiento e identificadores, y después clasifica los pares candidatos como coincidencias, no coincidencias o casos dudosos para revisión.
El marco separa de forma explícita las coincidencias falsas de las no coincidencias falsas y fija los umbrales en torno a los límites superiores deseados para esos tipos de error. Esa separación sigue siendo central en la coincidencia empresarial, porque la automatización y la revisión implican un equilibrio medible.
Capa | Pregunta principal | Resultado típico |
|---|---|---|
Distancia de edición | ¿Qué tan distintos son estos valores? | Distancia o similitud |
Comparación de campos | ¿Qué atributos coinciden? | Evidencia por campo |
Enlace probabilístico | ¿Cómo debe interpretarse la evidencia? | Coincidencia, no coincidencia o revisión |
Gobernanza | ¿Se puede defender la decisión más adelante? | Evidencia versionada y registro de auditoría |
La lección práctica es sencilla: use la distancia para medir la diferencia textual y, después, recurra a evidencia de varios campos y a umbrales gobernados para tomar una decisión de identidad. Ese es el puente entre el reconocimiento estadístico de patrones y las operaciones de datos en producción.
Comparación de las principales familias de algoritmos y sus compromisos de rendimiento
En producción rara vez existe un único algoritmo óptimo. La elección correcta depende del campo, de sus patrones de error, del volumen de candidatos y del coste de una decisión incorrecta. Un estudio comparativo evaluó siete enfoques, similitud de Jaccard, Jaro-Winkler, subsecuencia común más larga, distancia de Levenshtein, similitud del coseno, coincidencia por n-gramas y Damerau-Levenshtein, según precisión, exhaustividad (recall), medida F, exactitud y rendimiento computacional en su comparación publicada.
El experimento concluyó que la coincidencia por n-gramas ofrecía la mejor precisión, medida F y exactitud, mientras que la similitud del coseno era la más rápida. N-gramas y Damerau-Levenshtein fueron los más lentos en esa comparación. Estos resultados son evidencia de benchmark, no una regla de despliegue. Muestran el compromiso práctico: conservar más detalle local de caracteres puede mejorar la calidad de la coincidencia, pero también aumenta el coste de procesamiento.
Elija la familia según los datos
Levenshtein se adapta a cadenas cortas afectadas por errores de inserción, eliminación o sustitución. Damerau-Levenshtein añade las transposiciones adyacentes, lo que la hace útil cuando son frecuentes errores de tecleo como caracteres intercambiados.
Jaro-Winkler suele funcionar bien con nombres e identificadores cortos, porque los prefijos coincidentes pueden aportar una señal útil. Jaccard mide el solapamiento de tokens, lo que encaja con nombres de empresas y componentes de direcciones cuando el orden de las palabras importa menos. La similitud del coseno representa el texto como vectores y puede procesar campos largos de forma eficiente.
Familia de algoritmos | Fortalezas | Mejor caso de uso | Coste computacional |
|---|---|---|---|
Levenshtein | Comparación clara basada en ediciones | Erratas e identificadores cortos | Moderado |
Damerau-Levenshtein | Gestiona transposiciones adyacentes | Errores de tecleo en nombres y códigos | Alto |
Jaro-Winkler | Premia los prefijos coincidentes | Nombres de personas y campos cortos | Moderado |
Jaccard | Mide el solapamiento de conjuntos de tokens | Direcciones y nombres de empresas | Moderado |
Similitud del coseno | Comparación vectorial rápida | Campos de texto largos | Bajo en la comparación citada |
Coincidencia por n-gramas | Captura la estructura local de caracteres | Texto ruidoso y solapamiento parcial | Alto en la comparación citada |
Subsecuencia común más larga | Conserva la estructura de secuencia compartida | Variación textual ordenada | Depende de los datos |
Por qué la puntuación híbrida suele ganar
Los registros combinan campos con modos de fallo diferentes. Un nombre puede necesitar similitud de caracteres, una dirección puede beneficiarse de la comparación de tokens y un identificador puede requerir una validación determinista. Aplicar una sola métrica en todas partes genera errores evitables y desperdicia capacidad de cálculo en campos que necesitan otro tratamiento.
Asigne algoritmos por campo y combine después su evidencia con reglas vinculadas al riesgo de identidad. Ejecute las comparaciones costosas solo cuando el blocking haya reducido el conjunto de candidatos. Los resultados de benchmark pueden orientar el diseño inicial, pero son los pares etiquetados de sus propios datos los que deben determinar si el cálculo adicional mejora las decisiones lo suficiente como para justificar su coste operativo. Guarde los algoritmos elegidos, sus versiones, los umbrales y los resultados de revisión en un registro de auditoría para que los cambios posteriores sigan siendo explicables.
Por qué las puntuaciones de similitud no son probabilidades
Un sistema de coincidencia en producción puede asignar a dos registros de clientes una puntuación de similitud de 0,87 y aun así no dar ninguna respuesta directa sobre la identidad. La puntuación mide el parecido según una métrica elegida. No representa la probabilidad de que los registros pertenezcan a la misma entidad, no indica qué campos produjeron el resultado ni cuantifica el coste de fusionarlos por error.
Los umbrales ponen de manifiesto la distancia entre medición y decisión. Con 0,95 o más, un enfoque de ensamble con intervención humana alcanzó una precisión del 88,0 %, frente al 85,0 % de la similitud de Jaccard en ese rango alto. La precisión de Jaccard cayó al 53,0 % para puntuaciones entre 0,90 y 0,95, según el estudio de coincidencia difusa publicado. Como mostró el benchmark, una puntuación alta puede seguir produciendo coincidencias inseguras.
El umbral pertenece a la población
Un umbral ajustado para nombres de clientes puede ser inseguro para direcciones de proveedores. La transliteración puede cambiar el comportamiento de las puntuaciones entre países, y las identidades sanitarias y los contactos de marketing tienen consecuencias distintas cuando los registros se fusionan por error.
Ajuste los umbrales con pares etiquetados de la población que el sistema va a procesar. Mida la precisión y el recall en los umbrales que se usan en operación y desglose los resultados por campo, tipo de entidad, geografía, idioma y sistema de origen. Una puntuación agregada puede ocultar un fallo grave que afecte a un solo idioma o a una sola fuente.
Use la abstención de forma deliberada
Un sistema de coincidencia en producción necesita una vía controlada para la incertidumbre. Defina una banda de abstención que envíe los pares ambiguos a un revisor autorizado en lugar de forzar una decisión automática.
Vincular automáticamente: exigir evidencia que haya superado los controles de riesgo aplicables.
Revisar: mostrar los valores candidatos, la evidencia por campo, el umbral y la versión de la regla.
Rechazar: mantener los registros separados cuando la evidencia disponible no justifique un vínculo.
Las decisiones de los revisores deberían convertirse en datos de gobernanza y no perderse en una cola. Guarde los valores candidatos y normalizados, las puntuaciones por campo, el umbral de decisión, la versión del algoritmo, el resultado de la revisión y la marca de tiempo. Este registro de auditoría facilita las investigaciones, los cambios de umbral y las decisiones reproducibles.
Una puntuación alta es una medición. Un vínculo de identidad aprobado es una decisión gobernada.
Aquí los costes de los falsos positivos y los falsos negativos se vuelven operativos. En un dominio de alto riesgo, dejar sin resolver un posible duplicado puede ser más seguro que crear una fusión incorrecta. En otros contextos, una generación amplia de candidatos seguida de revisión humana puede ofrecer más control. La política adecuada depende de la entidad, de la evidencia y de las consecuencias del error.
Coincidencia multilingüe y el cuello de botella del blocking
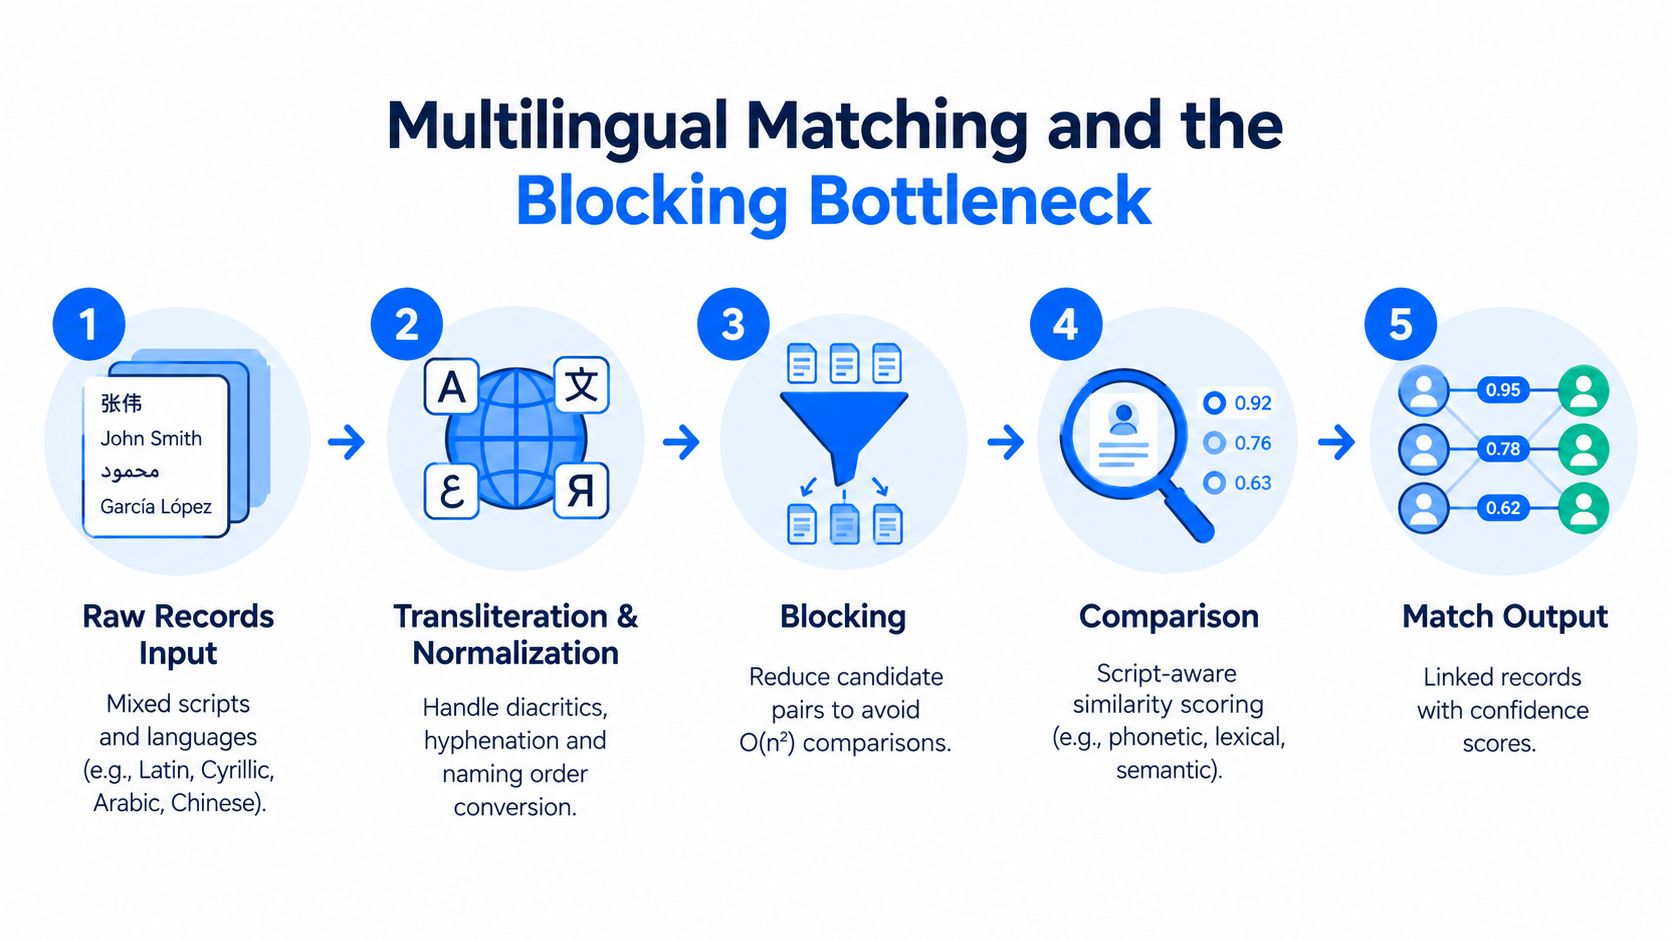
Las erratas al estilo inglés son la demostración fácil. Los datos de producción traen transliteración, múltiples alfabetos, cambios en el orden de los nombres, diacríticos, guiones e identificadores específicos de cada país. Estas variaciones afectan tanto al recall como al riesgo de falsos positivos antes de que un algoritmo de puntuación evalúe el par.
La generación de candidatos es el cuello de botella oculto. Si una estrategia de blocking coloca dos registros verdaderos en grupos distintos, ningún algoritmo de coincidencia difusa posterior puede recuperar esa relación.
Normalizar sin destruir la evidencia
Conserve los valores originales y cree representaciones normalizadas junto a ellos. La transliteración puede facilitar la comparación entre alfabetos, mientras que el alfabeto original sigue siendo esencial para la revisión y la auditoría. Normalice diacríticos, puntuación, guiones y orden de los nombres con reglas adecuadas al idioma y al tipo de entidad.
El país o la jurisdicción pueden aportar un contexto útil, pero no deberían convertirse en una regla absoluta de identidad. Una coincidencia transfronteriza puede ser legítima, mientras que una coincidencia aparentemente local puede ser errónea. Los pares entre alfabetos distintos con baja confianza merecen una revisión explícita en lugar de un rechazo silencioso o una aprobación automática.
Trabajos recientes sobre enlace de registros indican que el blocking jerárquico produce la mayor mejora en la coincidencia multilingüe de partes y que el blocking por país puede reducir los falsos positivos entre países, según el estudio descrito.
El blocking cambia velocidad por recall
La comparación por pares ingenua crece de forma cuadrática a medida que aumenta el número de registros. El blocking y la indexación reducen el conjunto de candidatos, pero introducen un nuevo modo de fallo: un par verdadero puede quedar excluido antes de la puntuación.
Use una generación de candidatos por capas en lugar de una única clave frágil:
Bloque primario: usar señales de contexto fiables como la jurisdicción, el tipo de entidad o fragmentos normalizados de identificadores.
Bloque de respaldo: permitir combinaciones más amplias para valores ausentes o dudosos.
Ruta entre alfabetos: comparar representaciones transliteradas cuando los alfabetos difieran.
Ruta de revisión: conservar los candidatos de baja confianza que crucen fronteras importantes.
Mida el recall del blocking por separado de la calidad de la puntuación. Un modelo de puntuación puede parecer excelente con los candidatos que recibe mientras la capa de blocking ya ha descartado coincidencias válidas. Las pruebas por idioma, alfabeto, país y fuente sacarán a la luz esas pérdidas silenciosas.
En el preprocesamiento, incluso tokens aparentemente menores pueden distorsionar la comparación, así que los equipos deberían definir reglas de limpieza específicas por campo en lugar de aplicar a ciegas una lista universal de palabras vacías. Una referencia práctica para ese trabajo es este recurso sobre palabras vacías, usado una sola vez como parte del diseño de normalización y no como sustituto de reglas sensibles al idioma.
Estrategias de implementación para entornos de producción
La coincidencia en producción funciona gracias al control, no solo a la elección del algoritmo. Empiece con un flujo de trabajo acotado, cree ejemplos etiquetados y defina qué puede vincular el sistema automáticamente, qué requiere revisión y qué debe permanecer separado.
Construya el pipeline de decisión
Perfile primero las fuentes. Identifique campos ausentes, variaciones habituales, patrones de duplicados y ruido específico de cada fuente.
Normalice en campos paralelos. Conserve los valores en bruto para la auditoría y cree valores normalizados para la comparación.
Aplique un blocking conservador. Mida cuántos pares verdaderos conocidos sobreviven a la generación de candidatos.
Puntúe por campo. Elija las métricas según el comportamiento del campo en lugar de aplicar una función universal.
Clasifique con abstención. Separe vínculos automáticos, candidatos a revisión y no coincidencias.
Registre las decisiones. Guarde la evidencia, las versiones de las reglas, los umbrales y los resultados de revisión.
Una coincidencia candidata no es un vínculo de identidad aprobado. Esa distinción debe existir en el modelo de datos, en la interfaz de usuario y en las API posteriores. Así se evita que recomendaciones provisionales se consuman como datos maestros de referencia.
Supervise los errores que importan
Informe de la precisión y el recall en los umbrales operativos y desglose los resultados por geografía, fuente, tipo de entidad e idioma. Mida por separado las coincidencias falsas y las no coincidencias falsas. Los revisores deberían ver los campos y las reglas que influyeron en cada recomendación, no solo una puntuación opaca.
La ejecución dentro de la base de datos puede reducir el movimiento de datos y alinear la coincidencia con los requisitos de seguridad y gobernanza. Un despliegue en nube privada o en las instalaciones (on-premises) también puede mantener el proceso dentro del entorno del cliente cuando las restricciones de cumplimiento hacen inadecuado el procesamiento externo.
Un enfoque modular es más fácil de operar que un motor de reglas desbordado. Añada una capacidad de monitorización, valide su utilidad y amplíe a medida que maduren los requisitos. El patrón de gobernanza debería estar versionado, ser revisable y poder revertirse cuando una nueva fuente cambie el comportamiento del sistema de coincidencia.
Los equipos que evalúan la gestión de datos maestros de clientes deberían prestar especial atención a la supervivencia de valores (survivorship) y al diseño de la auditoría. La coincidencia determina qué registros se vinculan, pero los procesos de datos maestros también necesitan dejar claro qué valores pasan a ser de referencia y cómo se propagan las correcciones posteriores.
Integrar la coincidencia difusa con la observabilidad de datos
Un sistema de coincidencia puede completar todos los trabajos programados y aun así degradarse. Nuevos formatos de origen, cambios en la composición de la población, convenciones de nombres modificadas y cambios de esquema pueden desplazar las distribuciones de puntuaciones sin provocar un fallo evidente en el pipeline.
Por eso la monitorización debe cubrir el comportamiento y no solo la disponibilidad. Siga las tasas de coincidencia, las distribuciones de puntuaciones, los volúmenes de revisión, los cruces de umbral, las exclusiones del blocking y los patrones confirmados de falsos positivos. Un cambio repentino en cualquiera de estas señales puede indicar una deriva en los sistemas de origen o una suposición que ya no se cumple.
Conecte las decisiones de identidad con el comportamiento de los datos
Los cambios de esquema merecen una atención especial. Columnas añadidas, tipos de datos modificados o nuevas categorías de entidades pueden alterar la disponibilidad y la ponderación de los campos. Si la lógica de coincidencia no detecta esos cambios, puede seguir funcionando mientras produce vínculos menos fiables.
Una práctica más amplia de observabilidad de datos puede conectar los resultados de la coincidencia con la puntualidad, la validación, la detección de anomalías y la monitorización de esquemas. Así los ingenieros de datos obtienen una visión compartida de si un problema de coincidencia empezó en el algoritmo, en los datos de origen, en el pipeline o en la política de decisión.
Para los equipos regulados, la base útil incluye:
Evidencia de la decisión: ¿qué valores y campos respaldaron cada vínculo?
Historial de políticas: ¿qué umbral y qué versión del algoritmo estaban activos?
Segmentos de población: ¿cambió el rendimiento por geografía, idioma o fuente?
Retroalimentación humana: ¿qué candidatos aceptaron o rechazaron los revisores?
Deriva operativa: ¿cambiaron las llegadas de datos, los esquemas o las distribuciones?
La implementación más sólida trata la coincidencia difusa como un producto de datos gobernado. No se detiene en vincular registros. Observa cómo se comportan esos vínculos con el tiempo y da a los equipos suficiente evidencia para investigar, corregir y explicar el resultado.
digna ayuda a los equipos de datos a monitorizar las señales de calidad en torno a la coincidencia difusa, como la validación de registros, las anomalías, la puntualidad y los cambios de esquema, manteniendo la ejecución dentro del entorno del cliente. Visite digna para ver cómo conectar la gobernanza de las decisiones de coincidencia con una observabilidad de datos más amplia.
Como una columna renombrada o un tipo de datos modificado pueden cambiar sin hacer ruido qué campos llegan al sistema de coincidencia, conviene vigilar las estructuras de origen con la misma atención que las tasas de coincidencia. Vea cómo el seguimiento de cambios de esquema señala esos cambios antes de que distorsionen las decisiones de identidad.
Preguntas frecuentes
¿Cuál es el mejor algoritmo de coincidencia difusa?
Ninguno es el mejor en todos los casos. En una comparación publicada de siete enfoques, la coincidencia por n-gramas obtuvo la mejor precisión, medida F y exactitud, mientras que la similitud del coseno fue la más rápida. En producción se suele asignar una métrica por campo, como Jaro-Winkler para nombres y Jaccard para direcciones, y luego combinar la evidencia.
¿Qué diferencia hay entre la distancia de Levenshtein y la de Jaro-Winkler?
Levenshtein cuenta el mínimo de inserciones, eliminaciones o sustituciones de un solo carácter necesarias para convertir una cadena en otra, por lo que encaja con erratas e identificadores cortos. Jaro-Winkler premia los prefijos coincidentes, lo que la hace muy adecuada para nombres de personas y otros campos cortos donde los primeros caracteres aportan la mayor parte de la señal.
¿Una puntuación de similitud en coincidencia difusa es una probabilidad de coincidencia?
No. Una puntuación como 0,87 solo mide el parecido según una métrica. No dice qué campos determinaron el resultado ni cuánto cuesta una fusión errónea. En el estudio citado, la precisión de Jaccard cayó al 53 % para puntuaciones entre 0,90 y 0,95, así que incluso valores altos pueden ser inseguros.
¿Qué es el blocking en el enlace de registros?
El blocking limita las comparaciones a pares candidatos que comparten una clave, como la jurisdicción o un fragmento normalizado de identificador, porque la comparación por pares ingenua crece de forma cuadrática. El precio es el recall: si dos registros verdaderos caen en bloques distintos, ningún algoritmo posterior puede recuperar el vínculo, así que conviene medirlo por separado.
¿Cómo debo fijar un umbral de coincidencia difusa?
Ajústelo con pares etiquetados de la población que el sistema procesará realmente y revise la precisión y el recall por idioma, geografía, fuente y tipo de entidad. En lugar de un único umbral, use una banda de abstención que envíe los pares ambiguos a un revisor y guarde la evidencia, el umbral y la versión de la regla para auditoría.



