Control de calidad de KPI: una guía práctica de gobernanza
|
8
minuto de lectura

Un dashboard puede cargar perfectamente y aun así contar la historia equivocada. Esa es la debilidad incómoda de la mayoría de los programas de control de calidad de KPI: los equipos validan si los datos llegaron, si las columnas coinciden con un esquema y si los informes se actualizaron, y luego toman esas validaciones técnicas como prueba de que la métrica es segura.
No lo es. Un KPI puede estar completo, actualizado y correctamente tipado y, aun así, volverse estratégicamente engañoso tras una adquisición, un cambio de precios, un movimiento de divisas, un cambio en la composición de clientes o un cambio en el denominador. Un monitoreo fiable debe evaluar la idoneidad para la decisión, no solo la salud del pipeline. Eso significa preguntarse si la métrica sigue significando lo que la dirección cree, si sigue siendo comparable con periodos anteriores y si respalda la decisión vinculada a ella.
Índice de contenidos
Entender el control de calidad de KPI en las plataformas de datos modernas
El verdadero coste de ignorar la calidad de los datos de los KPI
Entender el control de calidad de KPI en las plataformas de datos modernas
La mayoría de los equipos de datos empiezan con preguntas operativas: ¿se ejecutó el job? ¿Se actualizó la tabla? ¿Funcionó la consulta del dashboard? Esas comprobaciones importan, pero describen el estado de la plataforma de datos, no la fiabilidad de la conclusión de negocio.
Un cálculo de crecimiento de ingresos técnicamente válido puede inducir a error si una adquisición cambia la población, si las subidas de precio explican el movimiento o si el denominador excluye una cohorte que acaba de cobrar relevancia. Un KPI de retención de clientes también puede parecer estable mientras la definición de cliente subyacente ha cambiado. No tiene por qué romperse nada a nivel de esquema. El fallo se produce en la relación entre la métrica y la decisión que debe respaldar.
La limpieza técnica es solo el primer filtro
Un sistema útil de control de KPI separa tres preguntas:
¿Puede el pipeline producir el valor? Compruebe entrega, esquema, tipos, nulos, volumen y estado del procesamiento.
¿Significa el valor lo que dice la definición? Compruebe filtros, cohortes, joins, denominadores, ventanas temporales, datos de referencia y la conciliación con el sistema de registro.
¿Sigue siendo útil la métrica para la decisión prevista? Compruebe la comparabilidad, la materialidad, el contexto de negocio y los supuestos que usa la dirección al interpretar los movimientos.
Muchos programas se detienen en la tercera pregunta. Los equipos pueden alertar ante valores inusuales sin decidir si el movimiento refleja un defecto o un evento operativo legítimo. Eso crea dos riesgos opuestos. Un KPI silencioso pero distorsionado pasa sin ser detectado, mientras que un cambio estacional o estratégico válido genera ruido que los usuarios aprenden a ignorar.
Por eso, un enfoque práctico de data observability debe conectar las señales técnicas con la responsabilidad semántica. Cada KPI crítico necesita una definición aprobada, un responsable de negocio con nombre, una relación con el sistema de registro y una explicación de qué decisiones dependen de él.
Regla práctica: Un pipeline que funciona demuestra que los datos se movieron. No demuestra que la métrica de negocio siga siendo apta para decidir.
Convertir la comparabilidad en un control explícito
Empiece por documentar la población de la métrica, el numerador, el denominador, los filtros, la granularidad, la ventana temporal, el tratamiento de divisas y las exclusiones. Después registre los eventos que pueden cambiar la interpretación, como lanzamientos de productos, adquisiciones, cambios de precios, rediseños de territorios y actualizaciones de políticas.
El control debe distinguir un cambio de cálculo de un cambio de negocio. Si cambió la fórmula, el responsable debe evaluar la comparabilidad histórica y versionar la definición. Si cambió el negocio, el responsable puede aprobar la anomalía documentando por qué el KPI sigue siendo útil, o explicar por qué se necesita una serie reexpresada, una nueva cohorte o una métrica sustitutiva.
Así, el control de calidad de KPI pasa de ser una colección de pruebas de datos a un sistema que protege las decisiones. Los ingenieros siguen supervisando la maquinaria, pero los responsables de negocio validan el significado.
El verdadero coste de ignorar la calidad de los datos de los KPI
Una validación débil de las métricas rara vez provoca una caída espectacular. Lo habitual es que un valor incorrecto acabe en una presentación de planificación, una evaluación de desempeño, una previsión, un informe de cumplimiento o un flujo de trabajo de IA. La organización dedica entonces tiempo a debatir el resultado, corregir materiales posteriores, repetir análisis y recuperar la confianza en el proceso de reporting.
Gartner informa de que la mala calidad de los datos cuesta a las organizaciones al menos 12,9 millones de dólares al año de media, según una investigación de 2020, mientras que el 59 % de las organizaciones no mide la calidad de los datos, como resume la revisión de Docsumo sobre los costes de los datos erróneos. La estimación procede de una encuesta a 154 clientes de referencia de 16 proveedores de calidad de datos, por lo que no debe tomarse como un coste universal para cualquier empresa. Sí muestra por qué las organizaciones necesitan vincular los defectos con sus consecuencias de negocio en lugar de tratar la calidad como una puntuación abstracta de ingeniería.
Construir una cadena de evidencias del defecto a la decisión
Un programa de control maduro registra algo más que una alerta. Debe conservar:
El defecto, como una carga ausente, un valor no válido, un join modificado, un registro obsoleto o una discrepancia de definición.
El KPI afectado, incluidos su responsable, sus consumidores, las superficies de reporting y los modelos dependientes.
El impacto en el negocio, como una previsión distorsionada, una acción retrasada, un informe inexacto o una investigación innecesaria.
La corrección, incluidos el cambio técnico, la aprobación de negocio, la evidencia de validación y la fecha de cierre.
La medida preventiva, como una nueva regla, una definición revisada, una actualización del linaje o un ajuste de umbral.
Esta cadena da a los responsables financieros y a la dirección un motivo defendible para financiar los controles. También ayuda a ingeniería a priorizar. Un defecto en una tabla exploratoria poco utilizada no debería recibir la misma respuesta que uno que afecta al reporting regulatorio, a la gestión de ingresos o a un KPI ejecutivo.
El argumento financiero va más allá de los equipos de datos. Un informe de 2025 del IBM Institute for Business Value reveló que el 43 % de los directores de operaciones señaló los problemas de calidad de datos como su prioridad de datos más importante, y que más de una cuarta parte de las organizaciones estima pérdidas anuales superiores a 5 millones de dólares por la mala calidad de los datos. Las cifras aparecen en el análisis de IBM sobre la mala calidad de los datos, que plantea el tema como una preocupación operativa y no como un problema limitado a la plataforma.
Los equipos que evalúan el impacto comercial también pueden usar corregir datos erróneos para mejorar los ingresos como referencia práctica para conectar datos poco fiables con los procesos de ingresos. La pregunta útil no es: “¿Cuántos registros fallaron?”. Es: “¿Qué decisiones influyeron esos registros y qué hizo la organización porque el KPI era incorrecto?”.
Medir la calidad y las consecuencias a la vez
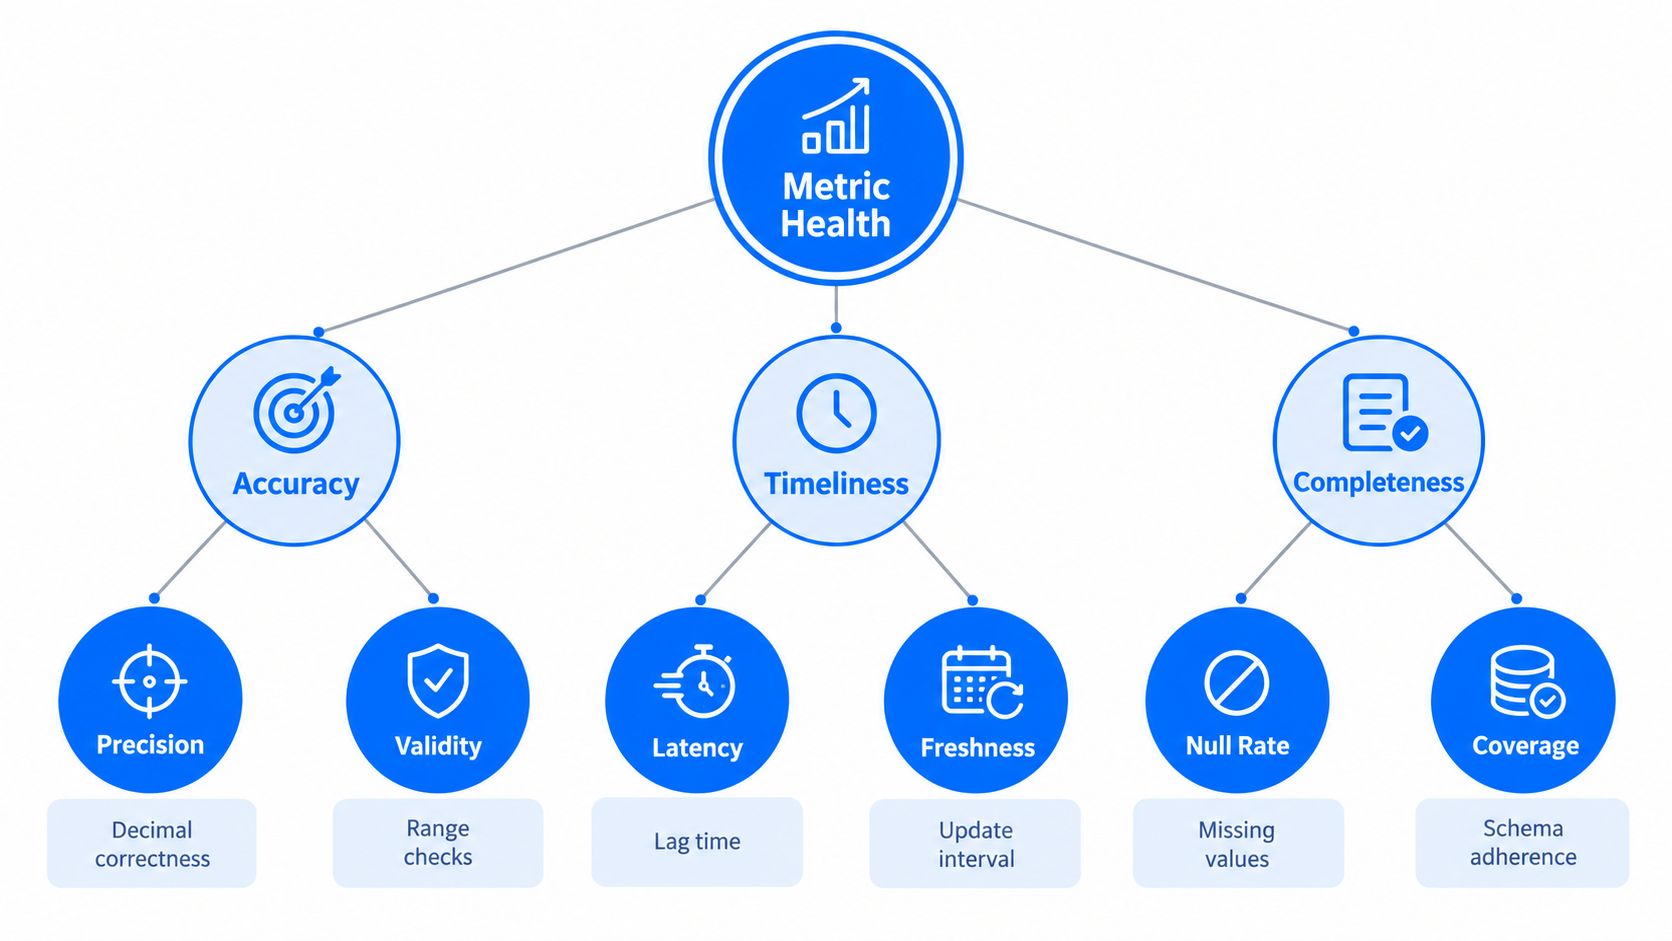
Haga seguimiento de dimensiones como exactitud, completitud, consistencia, validez, puntualidad, unicidad y relevancia. Después combínelas con medidas operativas como la gravedad de los incidentes, los informes afectados, la latencia de corrección, la recurrencia y la proporción de anomalías aceptadas frente a defectuosas.
Una única puntuación compuesta oculta compensaciones. Una alta completitud puede convivir con una baja exactitud. Una frescura excelente puede convivir con una definición de negocio rota. Las dimensiones separadas permiten diagnosticar el fallo y dejan que los responsables elijan controles según la materialidad.
Para los directivos que necesitan un business case conciso, la guía de digna sobre el business case de la calidad de datos puede apoyar la conversación. El argumento más sólido suele ser una conexión auditable entre un defecto de datos, un KPI distorsionado, una decisión retrasada o incorrecta y un control que reduce la probabilidad de que se repita.
Dimensiones clave de las métricas de negocio fiables
Un KPI no debería recibir una única etiqueta de aprobado o suspenso y luego desaparecer en un dashboard. La calidad es multidimensional y cada dimensión requiere una prueba distinta. Una columna puede ajustarse a su tipo declarado y aun así tener un significado de negocio erróneo. Un conjunto de datos completo puede contener valores incorrectos.
Separar sintaxis, significado y utilidad
La norma ISO 8000-1:2022 define conceptos de calidad que pueden llevarse a la práctica mediante controles: la calidad sintáctica se refiere a la conformidad con un formato aprobado, la calidad semántica a si los valores representan el significado previsto y la calidad pragmática a si los datos son adecuados para los usuarios y las decisiones previstos. El marco se resume en la descripción general de ISO 8000.
Aplique esos conceptos directamente:
Capa de calidad | Qué evalúa | Control práctico del KPI |
|---|---|---|
Sintáctica | Si los datos siguen la estructura aprobada | Comprobaciones de esquema, tipo, formato y valores permitidos |
Semántica | Si los valores representan el concepto previsto | Validación de definición, join, cohorte, denominador y datos de referencia |
Pragmática | Si el KPI respalda la decisión prevista | Aceptación del responsable, revisión de comparabilidad, materialidad y pruebas de uso en decisiones |
Las comprobaciones sintácticas suelen ser las más fáciles de automatizar. Valide que las fechas son fechas, que los identificadores siguen el patrón esperado, que los campos numéricos se mantienen en formatos aceptables y que existen las columnas obligatorias. Estas comprobaciones detectan pronto los fallos estructurales, pero no pueden determinar si “cliente activo” sigue usando la definición de negocio aprobada.
Las comprobaciones semánticas requieren una documentación más sólida. Concilie los totales del KPI con el sistema de registro correspondiente, pruebe por separado las poblaciones del numerador y del denominador y compare los resultados entre cohortes y ventanas temporales aprobadas. Si una métrica usa datos de referencia, supervise los cambios en esos datos con el mismo cuidado que los cambios en la tabla de hechos.
Las comprobaciones pragmáticas corresponden a quienes usan la métrica. El responsable de negocio debe confirmar si el KPI sigue siendo adecuado para decisiones de planificación, precios, riesgo, operaciones o cumplimiento. Aquí es también donde las anomalías legítimas reciben contexto en lugar de suprimirse automáticamente.
Tratar la completitud y la validez como controles distintos
El marco de calidad de datos del Gobierno del Reino Unido distingue la completitud de la validez. La completitud pregunta si están presentes los registros necesarios y los campos esenciales. La validez pregunta si los valores encajan en los rangos y formatos esperados. El marco advierte expresamente que unos datos completos no son necesariamente exactos.
Esa distinción cambia la forma en que los equipos diseñan las pruebas:
Las comprobaciones de cobertura identifican registros, periodos, entidades o fuentes de datos ausentes.
Las comprobaciones de campos obligatorios identifican valores ausentes en campos necesarios para el cálculo.
Las comprobaciones de validez imponen formatos, rangos, valores permitidos y expectativas de tipo.
Las comprobaciones de exactitud concilian los valores con una fuente de confianza o un proceso de negocio.
Las comprobaciones de consistencia comparan el mismo concepto entre sistemas, productos y capas de reporting.
Las comprobaciones de puntualidad comparan las llegadas con el comportamiento de entrega esperado, no solo con una hora fija.
Use las dimensiones de la calidad de datos de digna como referencia al convertir estas categorías en un inventario de monitoreo. La decisión de diseño importante es mantener visibles las dimensiones. Una única insignia de “saludable” puede ocultar precisamente la debilidad que invalida una decisión.
Establecer gobernanza y una responsabilidad clara
Lo más difícil del control de calidad de KPI no es escribir una regla de validación. Es decidir quién actúa cuando la regla salta, quién puede aceptar una anomalía como legítima y quién debe demostrar que la métrica vuelve a ser segura para publicarse.
La encuesta de Actian de 2025 a más de 600 profesionales de datos de empresas reveló que el 83 % se enfrentaba a retos de gobernanza y cumplimiento, aunque las organizaciones valoraban su madurez en gobernanza con un 4,13 sobre 5 y los directivos calificaban la madurez de los datos un 12 % más alta que los profesionales. Estos resultados se recogen en la encuesta de Actian sobre la madurez de la gobernanza. La brecha apunta a un problema práctico: la confianza de la dirección puede crecer más rápido que la claridad operativa.
Incluir la responsabilidad en el contrato de la métrica
Para cada KPI crítico, registre:
Responsable de negocio: Define qué significa la métrica, aprueba su interpretación y decide si sigue siendo adecuada para su propósito.
Responsable técnico: Mantiene pipelines, transformaciones, pruebas y dependencias.
Data steward: Mantiene definiciones, datos de referencia, linaje y documentación.
Consumidor: Informa de comportamientos inesperados y explica cómo se usa el KPI.
Auditor o revisor de controles: Verifica evidencias, aprobaciones e historial de correcciones.
El responsable también debe aprobar un umbral de materialidad. Una variación menor puede requerir solo observación, mientras que un movimiento brusco en un KPI regulatorio, financiero u operativo puede exigir retener la publicación y escalar a la dirección. Los umbrales deben reflejar el impacto en las decisiones, no solo la rareza estadística.
Diseñar el registro del incidente antes del incidente
Un registro de incidente útil recoge la condición detectada, el periodo afectado, la versión vigente de la definición, los cambios en la fuente, la gravedad, el responsable, el impacto en las decisiones, la resolución, la corrección y la evidencia de revalidación. Debe distinguir tres resultados:
Defecto técnico, cuando la fuente o la transformación es errónea.
Defecto semántico, cuando el cálculo ya no coincide con el significado aprobado.
Evento legítimo, cuando el negocio cambió y el KPI refleja correctamente ese cambio.
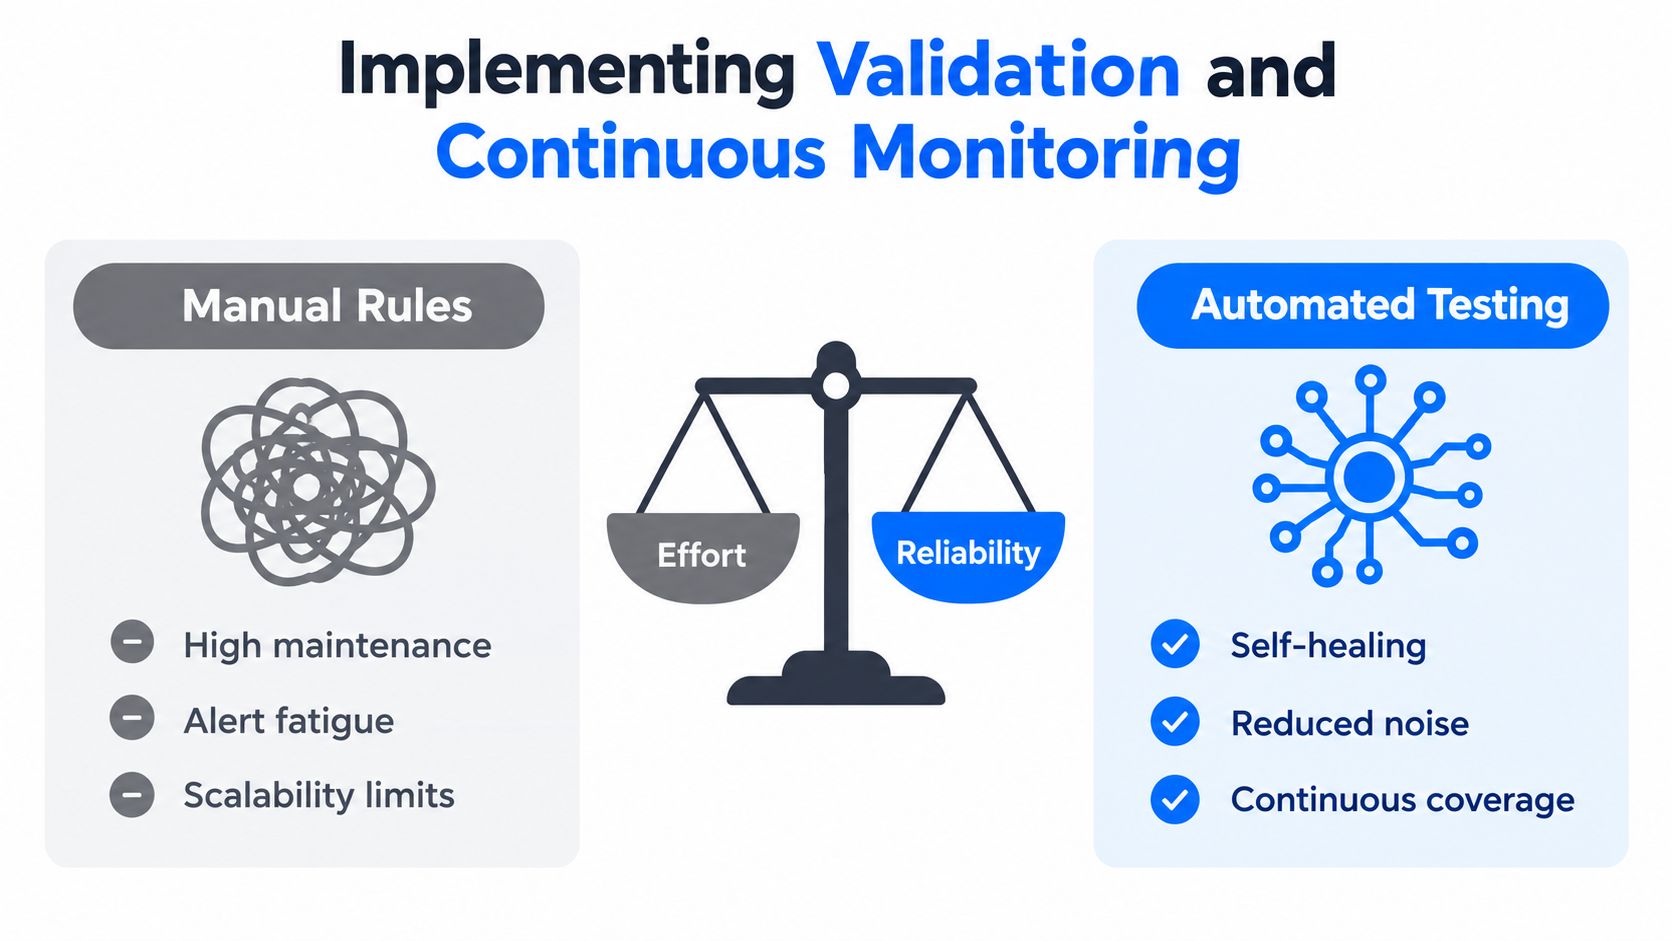
Las reglas manuales siguen siendo valiosas para afirmaciones estables y de alto impacto. Se vuelven caras cuando los equipos escriben umbrales separados para cada tabla, cohorte y contexto de reporting, y luego los ajustan tras cada cambio normal del negocio. Las líneas base automáticas pueden reducir el mantenimiento y sacar a la luz derivas desconocidas, pero no sustituyen la aprobación de negocio. Un detector de anomalías puede decir “inusual”. No puede decidir si una nueva política de precios hace que el movimiento sea correcto.
Use el recurso de digna sobre gobernanza de la calidad de datos al definir el modelo operativo. El resultado esencial es una responsabilidad medible, que incluya el tiempo hasta el triaje, el tiempo hasta la corrección, la evidencia de cierre, la recurrencia y la proporción de alertas que los responsables clasifican como eventos de negocio válidos.
Un programa de gobernanza eficaz hace visible el desacuerdo. Si los directivos ven madurez en una puntuación mientras los profesionales carecen de responsables y vías de escalado, el entorno de control aún no es maduro. Está documentado, pero no funciona en la práctica.
Implementar validación y monitoreo continuo
Las reglas escritas a mano son precisas, pero no escalan indefinidamente. Funcionan bien para condiciones contractuales, requisitos regulatorios y lógica de negocio conocida. Funcionan mal como único método para descubrir comportamientos inesperados en un conjunto grande y cambiante de pipelines.
Combinar controles deterministas y de comportamiento
La validación determinista pregunta si un valor o registro cumple una condición explícita. Por ejemplo:
Un pedido debe hacer referencia a un cliente existente.
La fecha de una transacción debe estar dentro de un periodo de reporting permitido.
El denominador de un KPI no debe ser cero.
Un campo regulado debe usar un código aprobado.
Un evento de negocio obligatorio debe llegar antes de que se ejecute la agregación dependiente.
Estas reglas son explicables y auditables. También exigen mantenimiento. Las definiciones de negocio cambian, los sistemas de origen evolucionan y las excepciones se multiplican. Sin responsables, las colecciones de reglas se vuelven frágiles y el volumen de alertas aumenta hasta que los ingenieros dejan de confiar en ellas.
El monitoreo de comportamiento adopta otro enfoque. Aprende el patrón normal de un conjunto de datos, un calendario de entregas, un perfil de volumen o un KPI de negocio, y después destaca los movimientos inusuales. Es útil para fallos desconocidos, derivas graduales, volatilidad inusual, cargas ausentes y cambios que nadie previó al escribir las reglas originales.
La contrapartida es la interpretabilidad. Una regla fija puede explicar exactamente por qué falló una fila. Una alerta de comportamiento puede identificar una desviación significativa sin identificar su causa. Por eso la arquitectura más sólida combina ambos métodos en lugar de tratarlos como competidores.
Mantener los datos sensibles donde están
En entornos empresariales, la arquitectura de monitoreo importa tanto como la lógica de detección. Ejecutar el cálculo de métricas y las comprobaciones a nivel de registro dentro de las propias bases de datos del cliente puede reducir el movimiento de datos y facilitar los requisitos de seguridad. También permite validar los datos del warehouse y del lake donde ya residen, en lugar de construir rutas de extracción adicionales para la observabilidad.
Una secuencia práctica de implementación es la siguiente:
Empiece por los KPI críticos, sus tablas de origen, definiciones, responsables y decisiones de negocio.
Añada comprobaciones deterministas para condiciones conocidas de corrección, cumplimiento y conciliación.
Establezca líneas base de comportamiento para volumen, frescura, distribuciones y movimientos del KPI.
Enrute las alertas según la responsabilidad, no a un canal compartido sin una persona responsable de responder.
Revise los resultados de las alertas y ajuste después umbrales, definiciones y gravedad según las decisiones reales.
La guía sobre validación de datos, reglas, comprobaciones y calidad continua resulta útil para organizar esta combinación de validación a nivel de registro y monitoreo continuo. La elección de plataforma importa menos que la disciplina operativa. Cada alerta necesita un destinatario, una vía de decisión y un registro de lo que ocurrió después.
Gestionar la sensibilidad de las alertas como un presupuesto operativo
Una sensibilidad alta detecta más fallos potenciales, pero también genera más ruido. Una sensibilidad baja protege la atención, pero puede pasar por alto defectos graduales o de bajo volumen. Fije la gravedad según el impacto en el negocio y revise los falsos positivos y los incidentes no detectados como parte del programa de control.
No suprima automáticamente los movimientos inusuales. Pregúntese primero si el evento es real, si la definición sigue aplicándose y si la decisión afectada requiere una métrica reexpresada. La detección estadística debe desencadenar una investigación, no anular la responsabilidad.
Diseñar flujos de corrección eficaces
Detectar sin responder es telemetría cara. Un flujo útil convierte una comprobación fallida en una decisión con responsable, con evidencia suficiente para que otra persona entienda lo ocurrido sin reconstruir toda la investigación.
Separar la reparación técnica de la revisión semántica
Un pipeline roto y un significado de negocio modificado necesitan responsables distintos. Un ingeniero puede reparar una transformación fallida, pero un responsable de negocio debe decidir si un nuevo segmento de clientes pertenece a la población del KPI. Enviar ambos incidentes a la misma cola ralentiza la recuperación y difumina la responsabilidad.
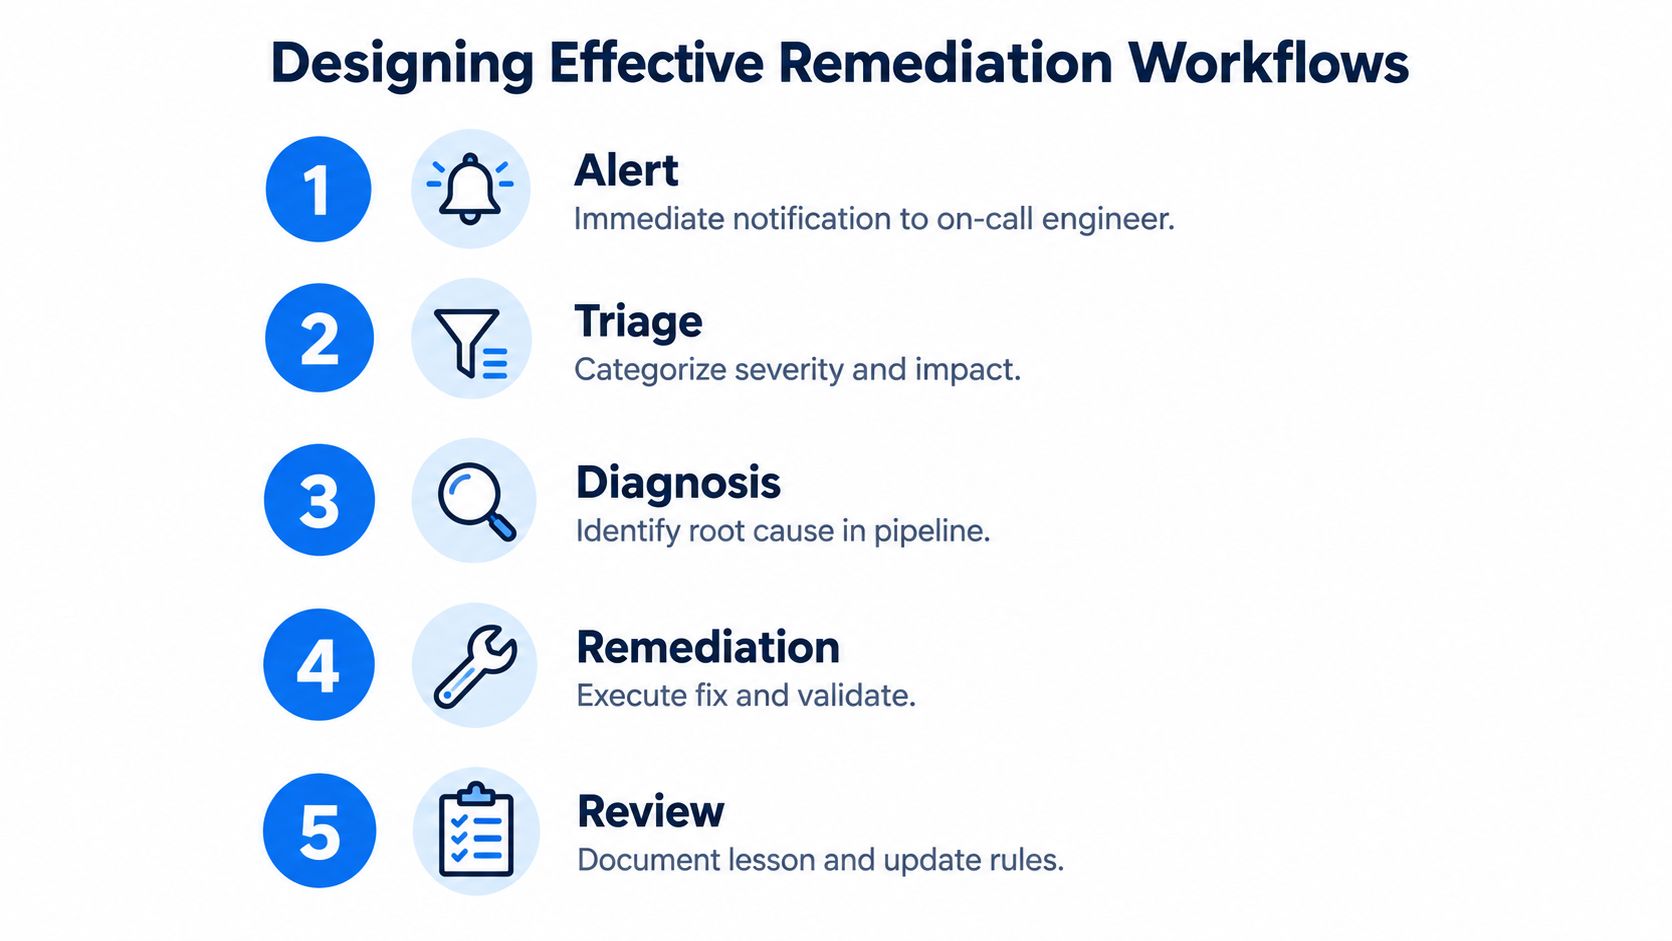
Use un flujo común con distintas ramas de decisión:
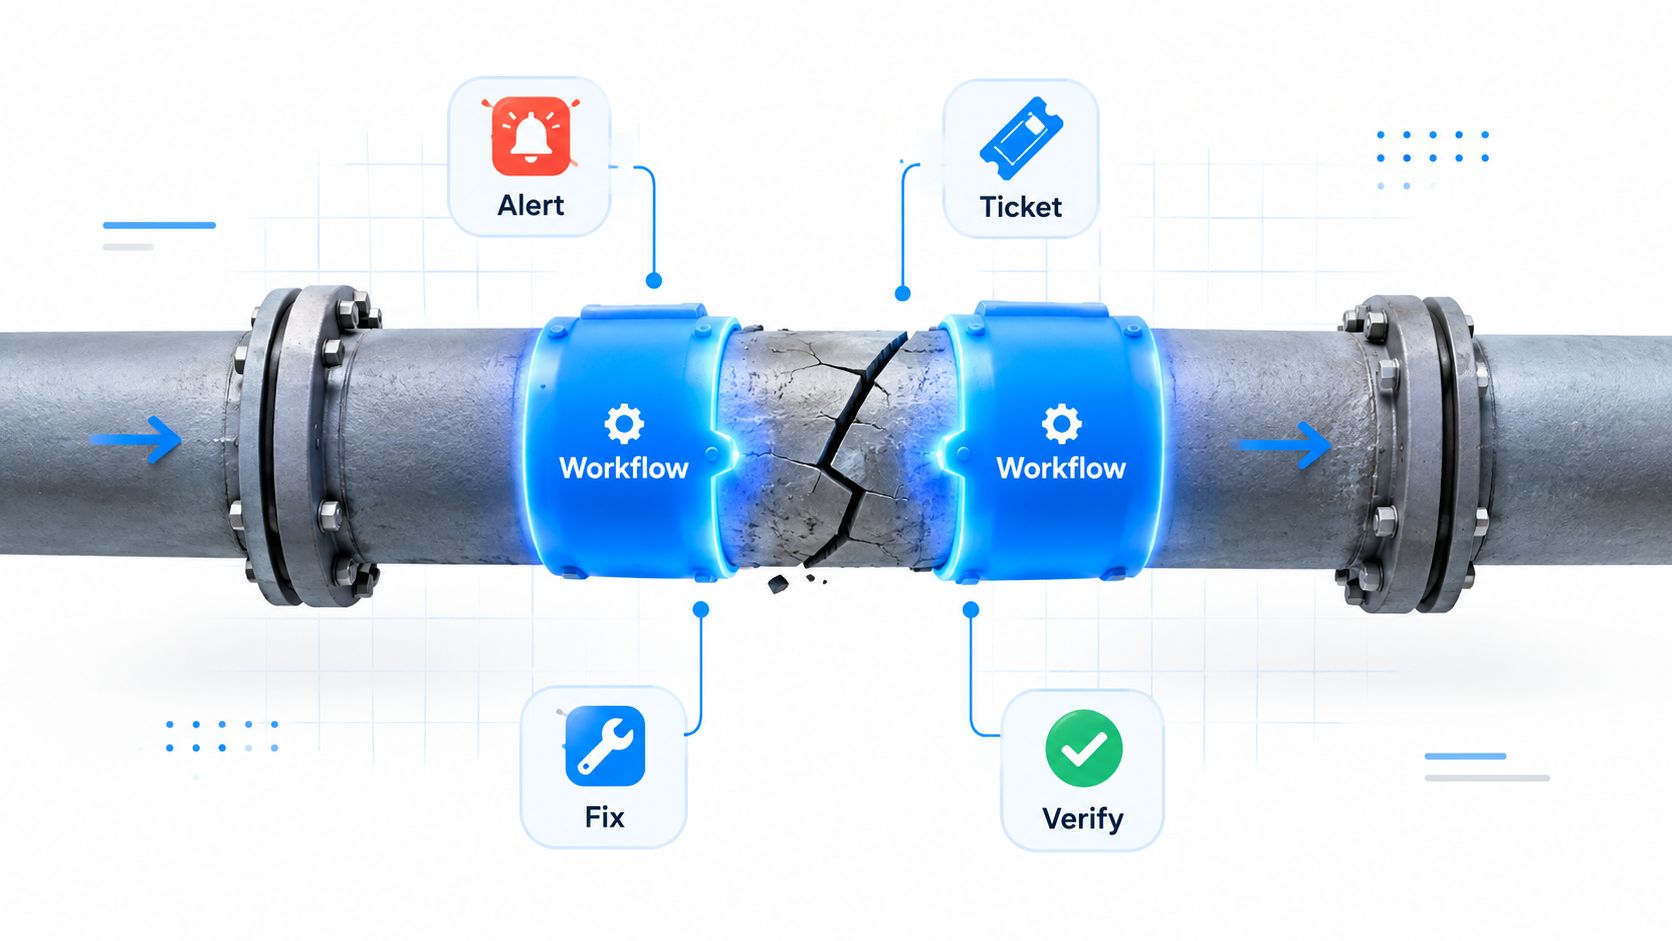
Alerta: Registre el control fallido, el KPI afectado, el intervalo de datos y el contexto de detección.
Triaje: Clasifique la gravedad, los consumidores afectados, el impacto en las decisiones y si la publicación debe pausarse.
Diagnóstico: Rastree el problema a través de sistemas de origen, transformaciones, datos de referencia, definiciones y cambios recientes del negocio.
Corrección: Corrija la fuente o la lógica, reexprese la métrica si es necesario y valide los resultados posteriores.
Revisión: Registre la causa raíz, la decisión del responsable, la evidencia, la prevención de recurrencias y el cierre.
El responsable debe registrar de forma explícita cuándo una anomalía se acepta como legítima. Esa aprobación evita que la organización reabra una y otra vez un evento de negocio conocido y conserva el razonamiento para auditores y futuros analistas.
Hacer seguimiento de las obligaciones de corrección como objetivos de servicio
Los datos personales introducen un requisito operativo concreto. Según el artículo 5 del RGPD, los datos personales deben ser exactos y, si fuera necesario, estar actualizados. Las organizaciones deben adoptar medidas razonables para rectificar o suprimir sin demora los datos inexactos, limitando a la vez los datos a lo necesario para la finalidad y conservándolos solo el tiempo necesario. El reglamento está disponible en el texto del RGPD en EUR-Lex.
La guía de la Comisión Europea sobre las solicitudes de particulares establece que, cuando una persona pide a una organización que corrija datos personales inexactos, la organización debe actuar sin dilación indebida, en principio en el plazo de un mes, o explicar por escrito por qué rechaza la solicitud. Para la gobernanza de KPI, esto crea un objetivo medible para los incidentes que afectan a datos personales.
Haga seguimiento de todo el ciclo de vida:
Campo del flujo | Pregunta operativa |
|---|---|
Recepción | ¿Cuándo se recibió el defecto o la solicitud de corrección? |
Responsabilidad | ¿Quién responde de la decisión y de la corrección? |
Alcance | ¿Qué registros, KPI, informes y resultados de IA se ven afectados? |
Corrección | ¿Qué cambió? ¿Se corrigió la fuente o solo el informe? |
Verificación | ¿Qué evidencia demuestra que la corrección funcionó? |
Cierre | ¿Se resolvió el incidente dentro del plazo aplicable? |
Un buen flujo de trabajo no promete que todos los incidentes sean sencillos. Garantiza que la complejidad no borre la responsabilidad.
Construir una estrategia resiliente de calidad de KPI
Una estrategia resiliente de calidad de KPI crece con la organización en lugar de intentar modelar todos los fallos posibles desde el primer día. Empiece por las métricas que impulsan decisiones relevantes y amplíe la cobertura a medida que maduren los responsables, las definiciones y las rutinas de incidentes.
La plataforma debe admitir varios tipos de control sin obligar a los equipos a reconstruir su modelo operativo para cada uno. El monitoreo de negocio, Timeliness, el seguimiento de esquemas, la validación a nivel de registro, la detección de anomalías y el análisis histórico abordan distintos modos de fallo. Aun así, deben generar un registro de incidentes común y un modelo de responsabilidad compartido.
Escalar por capas
Una progresión práctica es:
Base: Definir los KPI críticos, responsables, sistemas de origen, poblaciones, denominadores y uso en decisiones.
Fiabilidad: Supervisar frescura, volumen, completitud, validez, cambios de esquema y conciliación con las fuentes.
Significado: Versionar definiciones, probar cohortes y filtros, documentar eventos de negocio y exigir la aceptación del responsable.
Respuesta: Añadir gravedad, enrutamiento, plazos de corrección, conservación de evidencias e informes de cierre.
Optimización: Analizar incidentes recurrentes, precisión de las alertas, impacto en las decisiones y cobertura de los controles.
La ejecución dentro de la base de datos puede ayudar a supervisar datos sensibles sin moverlos innecesariamente. El despliegue modular también permite empezar con una capacidad concreta, como la detección de anomalías o Timeliness, y ampliar después a reglas de negocio y monitoreo de esquemas a medida que el programa de control demuestra su valor.
La medida correcta de la madurez no es el número de comprobaciones configuradas. Es si los equipos pueden responder, rápido y con evidencias, a cuatro preguntas: ¿Qué cambió? ¿Sigue significando el KPI lo que creemos? ¿Quién decide qué ocurre a continuación? ¿Cómo sabemos que el problema está cerrado?
Trate el control de calidad de KPI como un control de negocio permanente, no como una función del dashboard. Los ingenieros protegen la ruta de los datos, los responsables de negocio protegen el significado y los equipos de gobernanza hacen que la evidencia sea reutilizable en reporting, cumplimiento e IA. Ese reparto de responsabilidades es lo que impide que una métrica de aspecto impecable se convierta en una decisión equivocada y costosa.
digna ofrece data observability modular para detección de anomalías, Timeliness, validación a nivel de registro, cambios de esquema y monitoreo de KPI de negocio dentro de su propio entorno. Use digna para conectar los controles técnicos con una validación apta para decidir, flujos de incidentes con responsables claros y evidencias sobre las que sus equipos de datos y de negocio puedan actuar.
Si sus KPI críticos necesitan una supervisión continua junto a los datos que los alimentan, vea cómo el business monitoring con digna vigila el movimiento de las métricas y dirige los cambios inusuales a los responsables correspondientes.
Preguntas frecuentes
¿Qué es el control de calidad de KPI?
Es la práctica de comprobar que una métrica de negocio no solo es técnicamente correcta, sino que sigue siendo apta para la decisión que respalda. Combina comprobaciones del pipeline, como esquema, nulos y volumen, con pruebas semánticas de definiciones, denominadores y cohortes, además de una revisión de comparabilidad por parte del responsable.
¿Por qué un KPI puede ser engañoso aunque el pipeline supere todas las comprobaciones?
Porque un pipeline correcto solo demuestra que los datos se movieron. Un KPI de crecimiento de ingresos puede estar completo, actualizado y bien tipado y aun así engañar si una adquisición cambia la población, una subida de precios explica el movimiento o el denominador excluye una cohorte que acaba de cobrar relevancia.
¿Quién debe responsabilizarse de la calidad de un KPI?
La responsabilidad es compartida, pero la última palabra sobre el significado la tiene el responsable de negocio. La guía recomienda registrar cinco roles por KPI crítico: responsable de negocio, responsable técnico de pipelines y pruebas, data steward para definiciones y linaje, consumidores que informan de problemas y un auditor.
¿En qué se diferencian la calidad de datos sintáctica, semántica y pragmática?
La norma ISO 8000-1:2022 distingue las tres. La sintáctica comprueba la conformidad con un formato aprobado, como el esquema y los valores permitidos. La semántica pregunta si los valores representan el concepto previsto, mediante joins, cohortes y denominadores. La pragmática evalúa si el KPI sigue respaldando su decisión prevista.
¿Deben suprimirse automáticamente las anomalías de los KPI?
No. Un detector de anomalías puede marcar un movimiento como inusual, pero no puede decidir si una nueva política de precios lo hace correcto. Primero hay que investigar si el evento es real, si la definición sigue vigente y si la decisión necesita una métrica reexpresada. Después, el responsable registra la anomalía aceptada.



