Monitoreo en la gestión: una guía práctica
|
6
minuto de lectura

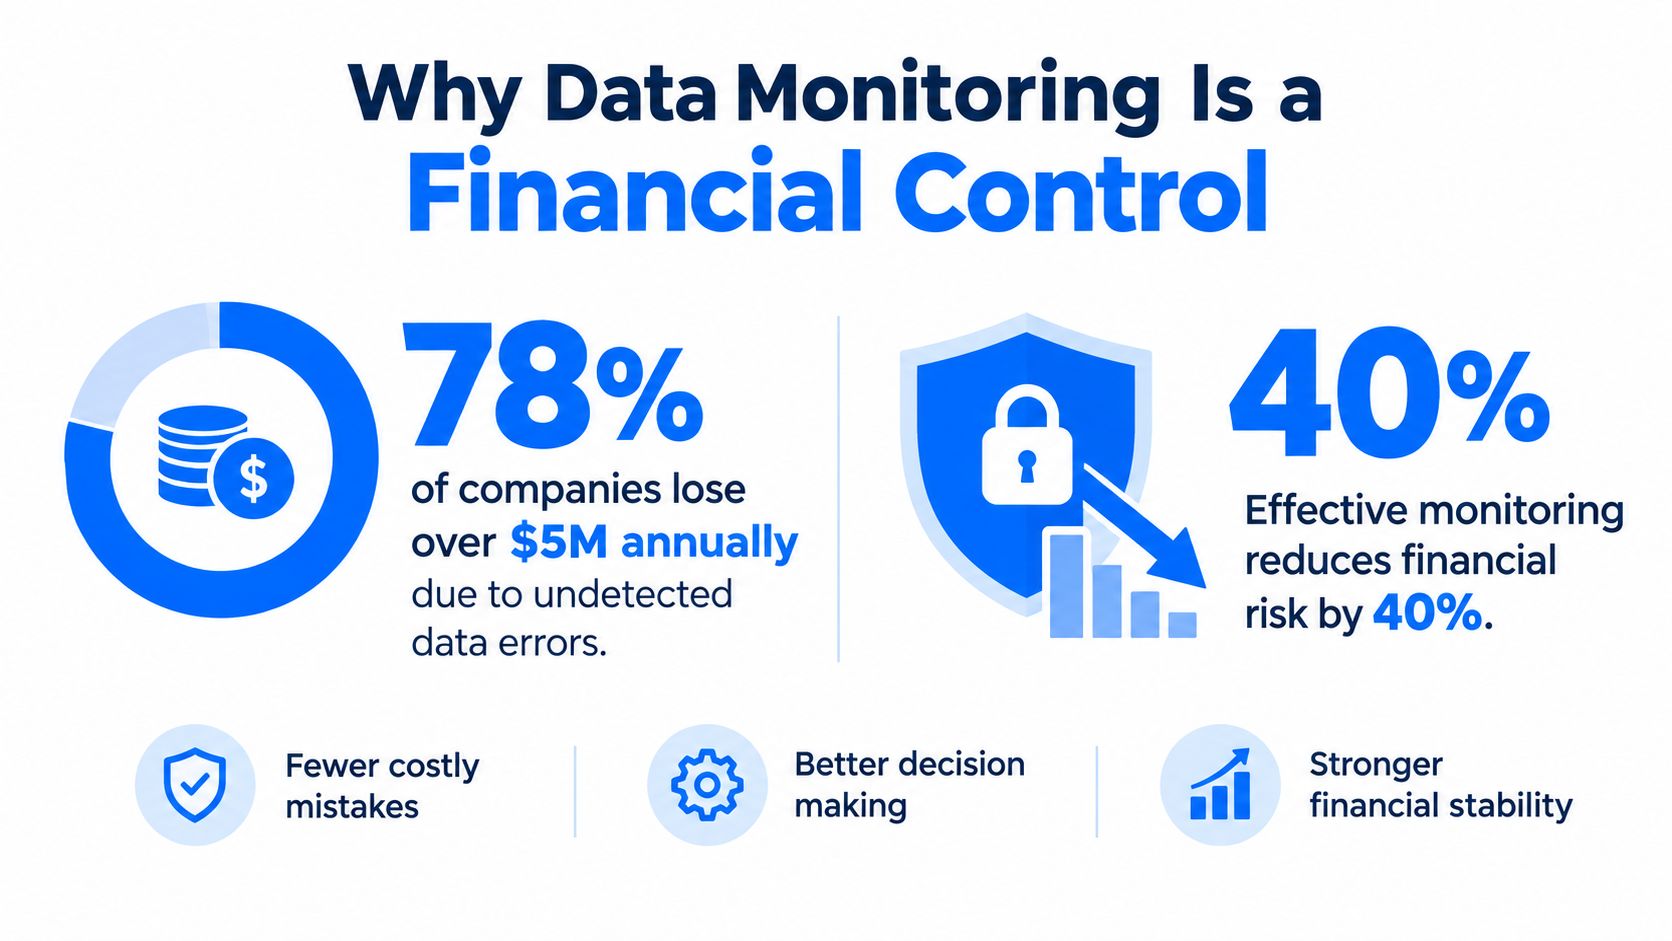
Más de una cuarta parte de las organizaciones estima pérdidas anuales superiores a 5 millones de USD por la mala calidad de los datos, y un 7 % declara pérdidas de al menos 25 millones de USD. El monitoreo en la gestión evita esa exposición al conectar las señales de datos con responsables concretos, impacto en el negocio y acciones correctivas.
Esa distinción importa porque un dashboard puede mostrar un fallo sin que nadie sea responsable de resolverlo. Un monitoreo eficaz es un sistema de control de gestión: los equipos definen las condiciones esperadas, observan el comportamiento real, comparan ambos y actúan cuando la desviación es relevante.
Índice
Por qué el monitoreo de datos es un control financiero
La mala calidad de los datos no es solo una molestia técnica. Puede distorsionar previsiones, interrumpir operaciones, socavar el reporting regulatorio y empujar las decisiones automatizadas en la dirección equivocada. El análisis de IBM sobre el coste de la mala calidad de los datos indica que más de una cuarta parte de las organizaciones estima pérdidas anuales superiores a 5 millones de USD, mientras que un 7 % declara pérdidas de al menos 25 millones de USD.
El monitoreo en la gestión es mucho más que mostrar un valor actual. Significa definir un rango o condición esperada, observar un proceso de datos o de negocio, identificar una desviación relevante, asignar la responsabilidad, conservar las evidencias y verificar que la corrección funcionó. Un dashboard apoya ese proceso, pero no lo sustituye.
Visibilidad en el dashboard frente a control de gestión
Un dashboard responde a la pregunta «¿Qué está pasando?». Un control de gestión responde a un conjunto de preguntas más completo:
Expectativa: ¿Qué debería estar ocurriendo y qué estándar lo define?
Materialidad: ¿Qué consecuencia de negocio, financiera, operativa o regulatoria se produce si cambian las condiciones?
Responsabilidad: ¿Qué persona o equipo debe investigar?
Evidencia: ¿Qué registros muestran cuándo empezó la desviación y qué cambió?
Respuesta: ¿Qué acción se requiere y cuándo puede cerrarse la incidencia?
En un banco, un conjunto de datos de riesgo que llega tarde puede afectar al reporting o a los flujos de decisión. Los equipos que trabajan en la gestión de datos en bancos necesitan algo más que el estado de los pipelines. Necesitan señales de puntualidad, validación, esquema y reglas de negocio conectadas con los procesos que esos datos respaldan.
La disyuntiva práctica es sencilla. Un monitoreo amplio aporta visibilidad, pero recopilar sin criterio genera ruido y coste. Un monitoreo centrado en tablas financieramente materiales, conjuntos de datos regulatorios, registros de clientes y pipelines críticos para las decisiones produce un conjunto de evidencias más reducido que la dirección puede usar de verdad.
La evolución de la teoría del control de gestión
La observabilidad moderna puede parecer una ruptura con la gestión tradicional, sobre todo cuando el machine learning detecta comportamientos inusuales sin una regla escrita a mano. Pero la lógica de fondo es más antigua y más estable que la tecnología. Los equipos siguen comparando las condiciones reales con las esperadas y deciden si una desviación exige actuar.
Henri Fayol formuló una definición temprana del control de gestión en 1916, al describir el control como la comprobación de que las actividades siguen el plan adoptado, las órdenes dadas y los principios establecidos, según recoge esta visión general de la teoría del control de gestión. Esa definición convirtió el control en una responsabilidad directiva recurrente, no en una inspección puntual.
Los trabajos anteriores de la gestión científica reforzaron el mismo patrón. Frederick Taylor trató el control como un objetivo en experimentos realizados en 1906, mientras que Copley describió el control como la idea central de la gestión científica en 1923. Resúmenes posteriores identifican cinco principios propuestos por Urwick en 1929: responsabilidad, evidencia, estandarización, comparación y utilidad.
El ciclo de control en una plataforma de datos
Esos principios encajan directamente con las operaciones de datos empresariales:
Fijar un estándar. Definir la frescura aceptable, los registros válidos, el esquema esperado, el comportamiento de entrega o la evolución de los KPI.
Medir el rendimiento. Recoger observaciones de tablas, pipelines, cargas de trabajo y procesos de negocio.
Comparar resultados. Evaluar el comportamiento actual frente a una línea base, una regla, un objetivo o un patrón histórico.
Evaluar la relevancia. Separar la variación inocua de una desviación que puede afectar a las decisiones.
Aplicar acciones correctivas. Asignar el hallazgo a un responsable, registrar la respuesta y comprobar si las condiciones volvieron a un estado aceptable.
La detección de anomalías basada en IA cambia la forma en que los equipos establecen líneas base e identifican desviaciones. No elimina el ciclo de control. Automatiza parte de la observación y la comparación, mientras las personas siguen decidiendo qué significa la señal y qué respuesta es aceptable.
Una síntesis académica de 2024 revisó la investigación sobre control organizativo mediante un análisis de cocitación de 1.148 artículos publicados entre 1938 y 2022. Su metaanálisis multidisciplinar abarcó 293 artículos, 310 muestras independientes y un total de 110.585 observaciones, según la introducción de Cambridge sobre el control organizativo. Esta tradición investigadora va hoy más allá de la contabilidad financiera e incluye indicadores no financieros, sistemas de información, comportamiento organizativo y desempeño estratégico.
Esa evolución explica por qué una plataforma como digna puede combinar detección de anomalías, seguimiento de la puntualidad, validación, monitoreo de esquemas y observación de KPI. No son funciones inconexas, sino implementaciones modernas de una disciplina de gestión consolidada desde hace mucho tiempo.
Los tipos fundamentales de monitoreo
El monitoreo fracasa cuando los equipos tratan cada señal como el mismo tipo de problema. Un retraso en un pipeline, un movimiento inesperado de los ingresos y una validación de privacidad fallida pueden generar alertas, pero requieren estándares, responsables, tiempos de respuesta y evidencias distintos.

Monitoreo operativo
El monitoreo operativo comprueba si el entorno de datos funciona como se espera. Abarca disponibilidad, comportamiento de las cargas de trabajo, rendimiento, throughput, frescura de los datos, exactitud, calidad y cobertura. Un job completado no es necesariamente un job exitoso. El resultado puede llegar tarde, incompleto, con cambios estructurales o no ser apto para su uso posterior.
Algunas señales útiles:
Puntualidad: ¿Llegó la tabla o partición esperada dentro de la ventana acordada?
Comportamiento del esquema: ¿Se añadieron, eliminaron o modificaron columnas de forma que afecte a los consumidores?
Salud del pipeline: ¿Falló un proceso, se reintentó de forma inusual o produjo menos registros de los esperados?
Comportamiento de la plataforma: ¿El consumo o el rendimiento de las cargas de trabajo se salió de su patrón normal?
Monitoreo de KPI
El monitoreo de KPI evalúa el significado de negocio que contienen los datos. Sigue ingresos, ventas, transacciones, actividad de clientes, volúmenes operativos u otras métricas frente a las expectativas del negocio. La decisión de diseño clave es distinguir un cambio legítimo del negocio de un defecto en los datos.
Por eso, una alerta de KPI debe aportar contexto. ¿Qué tablas de origen alimentan la métrica? ¿Hubo antes un cambio de esquema? ¿Cambiaron los recuentos de registros, las distribuciones o los resultados de validación? ¿Puede el responsable de negocio confirmar que el movimiento refleja la realidad?
Monitoreo basado en riesgos
El monitoreo basado en riesgos determina con qué detalle debe observarse cada control. La guía del NIST sobre monitoreo continuo recomienda una estrategia que ajuste la frecuencia según la volatilidad del control, la tolerancia al riesgo del sistema, las amenazas y vulnerabilidades, el nivel de impacto, las debilidades conocidas y la criticidad de la función monitorizada. También recomienda combinar indicadores adelantados, como los cambios de esquema, con indicadores retrasados, como la recurrencia de incidentes.
Tipo de monitoreo | Pregunta principal | Respuesta típica |
|---|---|---|
Operativo | ¿Se comporta correctamente el servicio de datos? | Investigar la entrega, la infraestructura o el estado del pipeline |
KPI | ¿Evoluciona el desempeño del negocio como se esperaba? | Validar la métrica e implicar al responsable de negocio |
Basado en riesgos | ¿Cuánta atención requiere este control? | Ajustar frecuencia, umbrales, escalado o aceptación |
Un programa de monitoreo necesita los tres. La observabilidad de la calidad de datos puede detectar una regla de registro que falla, pero la dirección sigue teniendo que determinar la consecuencia, asignar al responsable y documentar la decisión.
La brecha de responsabilidad en el monitoreo moderno
Muchas organizaciones han invertido en dashboards más rápido de lo que han desarrollado modelos de responsabilidad. El resultado es conocido: un equipo ve un indicador en rojo, supone que otro equipo se está ocupando y descubre más tarde que nadie conservó las evidencias ni probó la corrección.
Una encuesta de gobernanza de 2025 situó la custodia y la responsabilidad sobre los datos entre las máximas prioridades, mientras que informes independientes sobre la misma investigación constataron que algunas organizaciones aún carecen de programas de observabilidad de modelos y de capacidades básicas de calidad de datos o de gobernanza de accesos, según documenta el informe 2025 State of Enterprise Data Governance.
Ese hallazgo pone de manifiesto un desajuste habitual. Los equipos pueden hablar de observabilidad como una capacidad técnica mientras los responsables de gobernanza plantean una pregunta más operativa: ¿quién responde de la señal, de su interpretación y de su cierre?
Haga que cada alerta sea accionable
Un registro de monitoreo útil debe conectar cinco elementos:
Responsable designado: El equipo o rol encargado de la investigación.
Impacto en el negocio: La decisión, el proceso, el cliente o la obligación en riesgo.
Umbral de acción: La condición que convierte el hallazgo de una observación en un escalado.
Rastro de evidencias: El historial de la métrica, los registros fallidos, el evento de esquema o el resultado de validación que respaldan el hallazgo.
Prueba de cierre: La evidencia necesaria para demostrar que la corrección funcionó.
Regla práctica: una alerta sin responsable es telemetría, no control.
Añadir alertas puede aumentar el volumen de notificaciones sin mejorar la fiabilidad. Un conjunto más pequeño de señales de alta confianza, canalizadas a través de roles de gobernanza de datos, suele dar mejores resultados de gestión que un catálogo más amplio de eventos técnicamente interesantes.
La disyuntiva está entre cobertura y atención. Una cobertura amplia ayuda a descubrir modos de fallo desconocidos, pero cada alerta consume capacidad de revisión. Los umbrales basados en riesgos, las vías de escalado claras y el contexto histórico permiten a los responsables reservar su atención para las desviaciones que pueden cambiar una decisión de negocio.
Cómo implantar una estrategia de monitoreo práctica
Empiece por las decisiones que su organización no puede permitirse tomar con datos erróneos. Esa lista suele incluir el reporting regulatorio, los controles financieros, la elegibilidad de clientes, la capacidad operativa y los resultados analíticos o de IA que influyen en decisiones importantes. Identifique los conjuntos de datos y pipelines que hay detrás de esas decisiones antes de elegir métricas.
Elija indicadores que revelen distintos modos de fallo
Use indicadores adelantados para detectar condiciones antes de que un incidente sea visible para los usuarios. Los cambios de esquema, las particiones que llegan tarde, las desviaciones de frescura, los cambios en la tasa de nulos, el consumo inusual de cargas de trabajo y los cambios de distribución pueden revelar un deterioro de forma temprana.
Los indicadores retrasados muestran si el sistema de control funciona después de que surja un problema. La recurrencia de incidentes, las conciliaciones fallidas, las reexpresiones de informes y las excepciones de control repetidas indican a la dirección dónde siguen siendo débiles la corrección o el diseño de los controles.
Para la puntualidad, defina un objetivo de nivel de servicio en lugar de decir que los datos deben estar «casi en tiempo real». La guía SRE de Google sobre objetivos de nivel de servicio señala que los datos con más de cuatro o cinco minutos de antigüedad pueden retrasar de forma significativa la respuesta a incidentes en los sistemas de monitoreo. El umbral correcto depende del proceso, pero el principio es el mismo: mida la proporción de datos o ejecuciones de pipeline que cumplen una condición de frescura acordada dentro de una ventana definida.
Fije la frecuencia según el riesgo
No revise todas las tablas con la misma cadencia. Un conjunto de datos financieramente material, una tabla relacionada con identidades o un feed regulatorio merecen una observación más estrecha que una tabla exploratoria de bajo impacto. Ajuste la frecuencia cuando cambien la volatilidad, la exposición, las debilidades conocidas o la criticidad para el negocio.
Evite también los promedios que ocultan la cola del comportamiento operativo. El material SRE de Google considera útiles las mediciones por percentiles, como los percentiles 50, 95 y 99, porque los promedios pueden ocultar una población pequeña pero relevante de peticiones lentas. El mismo razonamiento se aplica a la latencia de los pipelines y al rendimiento de las cargas de trabajo.
Defina la vía de respuesta antes de activar alertas
Para cada métrica, registre la línea base, el responsable, el umbral, la vía de escalado, la ubicación de las evidencias y la prueba de recuperación. El monitoreo no solo debe medir el tiempo desde la desviación hasta la detección, sino también el tiempo hasta el reconocimiento y la recuperación.
Una plataforma como digna puede respaldar este modelo operativo monitorizando el comportamiento de los datos, validando registros, siguiendo la puntualidad, detectando cambios de esquema y observando métricas de negocio y de plataforma dentro del entorno del cliente. Aun así, los equipos deben validar el despliegue, la responsabilidad y los umbrales frente a su propia arquitectura y política de riesgos. La capacidad de monitoreo y reporting forma parte de ese proceso de gestión más amplio, no va al margen de él.
Aplicaciones reales en sectores regulados
Un equipo de servicios financieros podría monitorizar una tabla de riesgos en busca de cambios de esquema inesperados antes de un ciclo de reporting. Una columna eliminada o un tipo de dato modificado pueden romper la lógica posterior sin previo aviso, así que el control útil no es una simple alerta de job fallido. Combina monitoreo estructural, conocimiento de las dependencias, resultados de validación y un responsable que pueda evaluar si el informe afectado sigue siendo fiable.
Los equipos sanitarios se enfrentan a otra versión del mismo problema. Un historial de paciente puede llegar a tiempo y superar las comprobaciones técnicas y, aun así, incumplir una regla de negocio o legal. La validación a nivel de registro puede identificar el registro fallido, conservar la regla evaluada, derivar el caso para su revisión y guardar la evidencia de la resolución.
El artículo 5 del Reglamento General de Protección de Datos de la UE exige que los datos personales sean exactos y estén actualizados. También exige una seguridad adecuada, incluida la protección contra el tratamiento no autorizado o ilícito y contra su pérdida, destrucción o daño accidental. El monitoreo continuo ayuda a traducir esas obligaciones en evidencias operativas en lugar de depender de revisiones manuales periódicas.
Aplicar controles por sector
Servicios financieros: Validar datos transaccionales y regulatorios, monitorizar la puntualidad de las entregas, detectar cambios estructurales y conectar las excepciones con los responsables de reporting y de riesgos.
Sanidad: Comprobar registros clínicos y operativos frente a reglas de negocio, identificar valores inexactos o incoherentes y conservar las evidencias de revisión.
Telecomunicaciones: Observar grandes volúmenes de datos de clientes y de red, distinguir cambios reales de uso de defectos en los pipelines y escalar los fallos antes de que distorsionen el reporting operativo.
Sector público: Mantener evidencias trazables para los conjuntos de datos críticos, incluida la regla evaluada, los registros afectados, la decisión tomada y la acción correctiva.
Las organizaciones con controles financieros complejos también pueden evaluar recursos sobre aplicación automatizada de políticas en FinTech cuando necesiten conectar los requisitos normativos con controles operativos repetibles. El principio de diseño clave sigue siendo el mismo: el monitoreo debe producir evidencias que un equipo responsable pueda interpretar y sobre las que pueda actuar.
Para las organizaciones sanitarias, el cumplimiento normativo de los datos sanitarios exige la misma disciplina en calidad, puntualidad, validación y cambios estructurales. El cumplimiento no se demuestra solo con una puntuación. Depende de que los equipos puedan mostrar qué comprobaron, qué falló, quién respondió y si el resultado se corrigió.
El futuro de la gobernanza basada en evidencias
La siguiente etapa del monitoreo no es un muro de gráficos más grande. Es una relación más estrecha entre observación, criterio directivo y evidencia. La IA puede aprender el comportamiento específico de cada conjunto de datos, correlacionar señales, priorizar anomalías y reducir el mantenimiento manual de reglas. Lo que no puede es decidir si una excepción de negocio es aceptable sin una política definida y una autoridad responsable.
El ciclo operativo más duradero tiene cuatro partes:
Observar las condiciones reales en datos, plataformas, métricas de negocio y controles.
Comparar las condiciones con las expectativas mediante reglas, líneas base, objetivos de servicio o umbrales de riesgo.
Asignar y ejecutar acciones correctivas con un responsable documentado y una vía de escalado.
Verificar el resultado mediante mediciones posteriores y evidencias conservadas.
Este enfoque también ayuda a separar los problemas de datos de los problemas de modelos. Un resultado inesperado de un modelo puede tener su origen en un esquema modificado aguas arriba, datos que llegan tarde, una distribución desplazada, una regla de validación fallida o un evento de negocio legítimo. Seguir la cadena causal evita tratar el monitoreo de modelos como una solución aislada para cualquier problema de fiabilidad de la IA.
El monitoreo aporta valor de gestión cuando la evidencia cambia una decisión.
El cambio práctico va de la visibilidad pasiva a la gobernanza basada en evidencias. Los ingenieros de datos pasan a ser responsables no solo de la disponibilidad de los pipelines, sino también de la integridad, la puntualidad y la trazabilidad de la información que usan analistas, directivos, reguladores y sistemas de IA. Los responsables de negocio ganan un papel más claro, porque definen la materialidad y los resultados aceptables. Los equipos de gobernanza reciben evidencias generadas en la operativa normal en lugar de reconstruidas bajo presión.
Ese es el sentido útil del monitoreo en la gestión. Los equipos no monitorizan para acumular más telemetría. Monitorizan para detectar pronto los cambios relevantes, hacer explícita la responsabilidad y proteger las decisiones frente a datos poco fiables.
digna ofrece una plataforma empresarial de calidad y observabilidad de datos que se ejecuta dentro del propio entorno del cliente, con módulos de detección de anomalías, puntualidad, validación a nivel de registro, seguimiento de esquemas y monitoreo de negocio y de plataforma. Visite digna para ver cómo su equipo puede conectar las señales de monitoreo con una corrección responsable y evidencias fiables.
Si su mayor brecha de responsabilidad está en el monitoreo de KPI, vea cómo el monitoreo de negocio con digna distingue los movimientos reales de ingresos, transacciones y volúmenes de los defectos de datos en las tablas que los alimentan.
Preguntas frecuentes
¿Qué significa el monitoreo en la gestión?
El monitoreo en la gestión es un proceso de control, no solo un dashboard. Los equipos definen un rango esperado, observan un proceso de datos o de negocio, detectan desviaciones relevantes, asignan un responsable, conservan evidencias y verifican que la corrección funcionó. El dashboard apoya ese ciclo, pero no lo sustituye.
¿En qué se diferencia un dashboard de un control de gestión?
Un dashboard solo muestra lo que está pasando ahora. Un control de gestión añade expectativa, materialidad, responsabilidad, evidencia y respuesta: qué estándar aplica, qué consecuencia tiene para el negocio, quién debe investigar, qué registros muestran el cambio y cuándo puede cerrarse la incidencia.
¿Cuáles son los principales tipos de monitoreo en la gestión?
El artículo distingue tres tipos. El monitoreo operativo revisa frescura, esquema, salud de los pipelines y comportamiento de la plataforma. El monitoreo de KPI sigue ingresos, transacciones o volúmenes frente a las expectativas del negocio. El basado en riesgos decide con qué frecuencia y detalle se observa cada control.
¿Por qué cada alerta de monitoreo necesita un responsable?
Sin un responsable designado, una alerta es telemetría y no control. Un equipo ve un indicador en rojo, supone que otro se ocupa y descubre después que nadie guardó evidencias ni probó la corrección. Una alerta útil vincula responsable, impacto en el negocio, umbral de acción, rastro de evidencias y prueba de cierre.
¿Con qué frecuencia conviene monitorizar los datos?
La frecuencia debe depender del riesgo y no de una cadencia única para todas las tablas. Los datos financieramente materiales, las tablas de identidad y los feeds regulatorios merecen una vigilancia más estrecha que las tablas exploratorias. El NIST recomienda ajustarla según volatilidad, nivel de impacto, debilidades conocidas y criticidad.



