Modelo operativo de calidad de datos: guía práctica para la empresa
|
7
minuto de lectura

Un equipo regional de previsión abrió su panel de ingresos al cierre del trimestre y vio una cifra plausible, pero la población de clientes subyacente se había duplicado. Una migración del sistema de origen había fusionado cuentas activas e inactivas, nadie era responsable de la lógica de fusión y ninguna alerta mostró el cambio en el recuento de filas a tiempo para detener la decisión. Se revirtió una decisión de precios, una auditoría señaló la falta de linaje y los ingenieros reconstruyeron el mismo pipeline tres veces antes de que un data steward bloqueara finalmente la fuente.
Este tipo de incidente suele describirse como un problema de herramientas. Casi nunca lo es. La organización tenía pipelines, paneles, ingenieros y probablemente bastante código de validación. Lo que faltaba era una respuesta clara a cuatro preguntas operativas: quién define la calidad aceptable, quién responde por el fallo, quién puede bloquear los datos y quién decide cuándo se cierra el caso.
Un modelo operativo de calidad de datos aporta exactamente esa estructura de decisión ausente. Conecta validación, observabilidad, puntualidad, responsabilidad y escalado para que la calidad se convierta en una capacidad operativa recurrente en lugar de un conjunto de reglas desconectadas. La necesidad es cada vez más difícil de ignorar. Una estimación de mercado de 2026 situó el mercado global de gestión de la calidad de datos en 2.660 millones USD en 2025, con una previsión de 4.950 millones USD para 2030 y un CAGR del 13,2 % (Informe del mercado global de calidad de datos). El crecimiento importa, pero la pregunta operativa importa más: ¿puede su organización actuar ante una señal de calidad antes de que altere una decisión de negocio?
Tabla de contenidos
Por qué falla la calidad de datos incluso en equipos maduros
Qué es realmente un modelo operativo de calidad de datos
Los cinco componentes que lo hacen operativo
Los cuatro patrones de modelo y cómo elegir
Una guía de decisión para elegir el patrón inicial
Niveles de madurez y KPIs medibles
Conectar observabilidad, validación y puntualidad
La validación detecta incumplimientos explícitos
La observabilidad detecta lo que las reglas pasan por alto
La puntualidad merece su propio control
Hoja de ruta de implementación del piloto a la escala empresarial
Fundamentos
Dominio piloto
Expansión
Escala empresarial
Consideraciones sectoriales en industrias reguladas
Errores frecuentes y su lista de tareas para la próxima semana
Cinco acciones para la próxima semana
Por qué falla la calidad de datos incluso en equipos maduros
El incidente de previsión tenía todas las señales externas de un entorno de datos maduro. La migración estaba aprobada, el pipeline se ejecutó correctamente y el panel se actualizó según lo previsto. Aun así, ningún control preguntaba si la población de cuentas seguía representando la población de negocio prevista.
El fallo comenzó aguas arriba, pero se convirtió en un problema empresarial. El equipo de previsión confió en la vista inflada de ingresos y revirtió una decisión de precios al cierre del trimestre. Durante la revisión de auditoría, los auditores observaron que el linaje terminaba en la fuente migrada y no explicaba cómo se habían combinado cuentas activas e inactivas. Después, los ingenieros reconstruyeron el pipeline tres veces, cada intento abordando un síntoma posterior en lugar de la responsabilidad no resuelta.
El data steward acabó bloqueando la fuente. Eso eliminó el riesgo inmediato, pero también expuso la mecánica operativa que faltaba. Nadie era responsable de la lógica de fusión, no existía una vía de escalado para un cambio inusual en el recuento de filas y ninguna métrica acordada clasificaba la desviación de la población como un evento que bloquea la publicación.
Regla práctica: una ejecución exitosa del pipeline demuestra que el software se ejecutó. No demuestra que los datos resultantes sigan siendo adecuados para la decisión de negocio.
Este patrón aparece también en organizaciones con ingenieros competentes. Tras un incidente, muchos equipos añaden más pruebas, pero esas reglas nuevas se convierten en la siguiente carga de mantenimiento si nadie es responsable de sus definiciones, umbrales o excepciones. Un análisis de las razones estructurales por las que fracasan los proyectos de calidad de datos hace la misma distinción operativa: el trabajo de calidad fracasa cuando las organizaciones lo tratan como un proyecto o un despliegue de herramientas en lugar de cambiar cómo deciden los equipos.
La investigación independiente sobre gobierno explica por qué persiste la brecha. En una encuesta a 825 participantes, el 75 % señaló la calidad de datos como objetivo prioritario, mientras que otro estudio halló que solo el 10 % calificaba sus datos como excelentes y el 30 % como buenos, es decir, un 40 % con una valoración positiva (estudio de gobierno de Precisely). Los equipos tampoco suelen saber de dónde proceden los datos, cuán fiables son ni quién corrige los errores.
El modelo operativo existe para evitar precisamente esa ambigüedad. Reparte los derechos de decisión antes de la próxima migración, define la señal que desencadena la intervención y da a una persona concreta la autoridad para detener datos poco fiables.
Qué es realmente un modelo operativo de calidad de datos
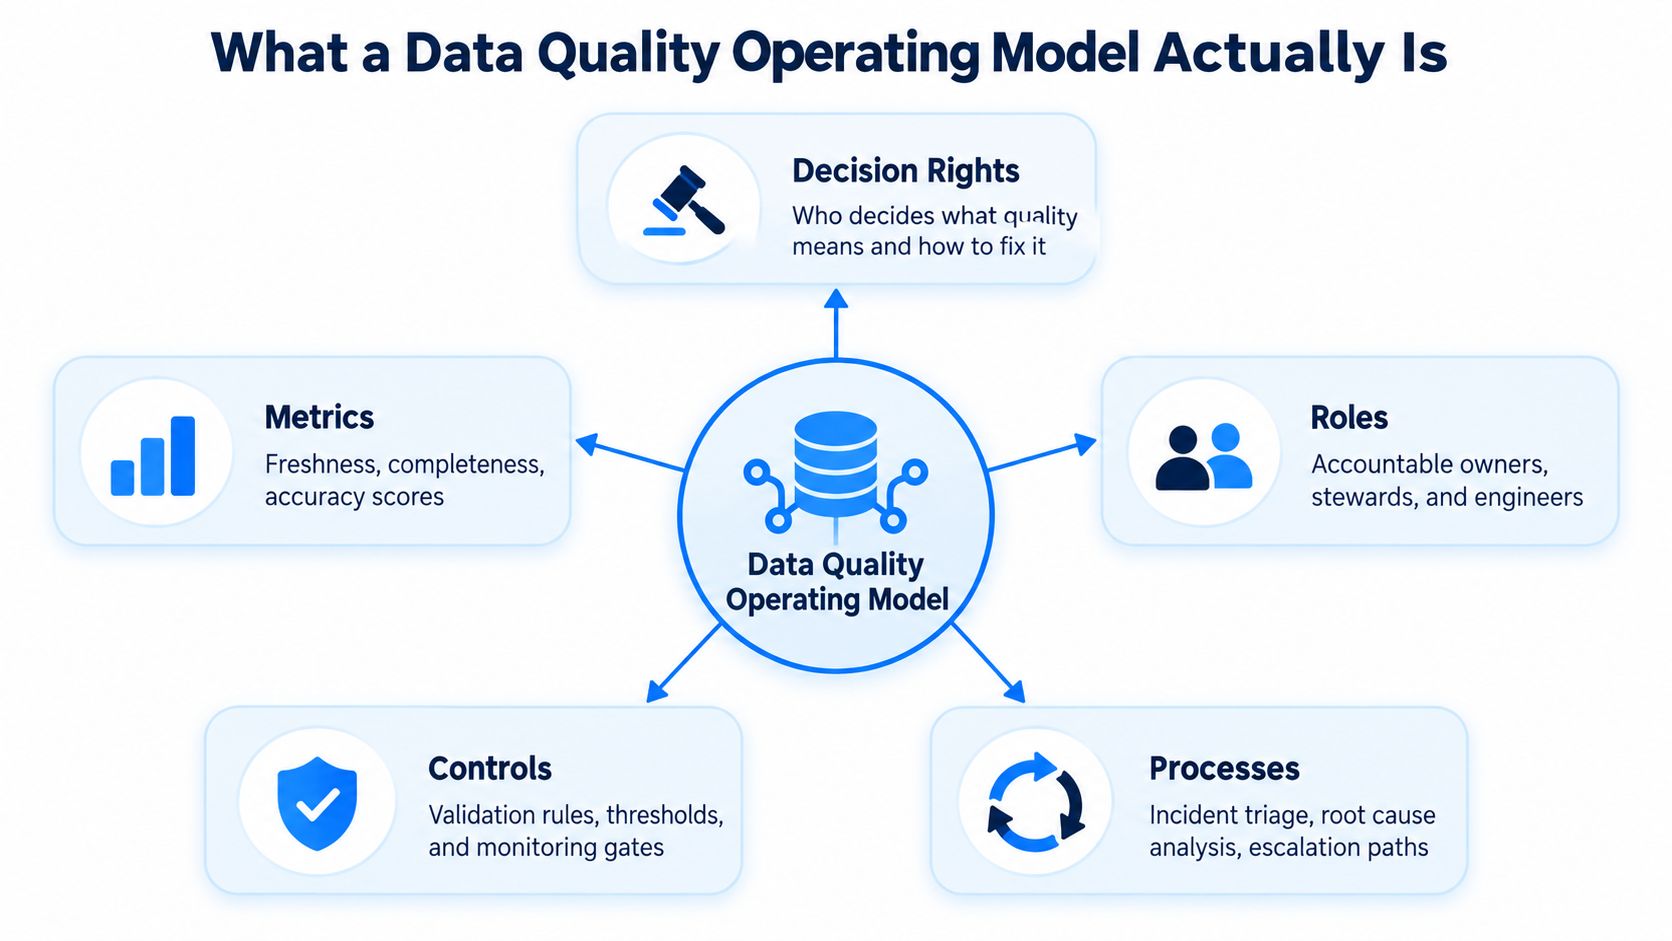
Un modelo operativo de calidad de datos es el sistema codificado de derechos de decisión, roles, procesos, controles y métricas que determina cómo se detectan, asumen, escalan y resuelven los problemas de calidad a lo largo del ciclo de vida del dato. Describe el trabajo que las personas hacen de forma repetida, no solo los estándares que publican.
Una política de gobierno expresa intención. Una biblioteca de reglas almacena pruebas. Una plataforma de observabilidad detecta cambios de comportamiento en sistemas o conjuntos de datos. Ninguno de estos componentes responde por sí solo quién aprueba un umbral, quién acepta una excepción o quién tiene autoridad para bloquear un feed defectuoso. El modelo operativo conecta esos componentes con personas responsables.
Los cinco componentes que lo hacen operativo
La responsabilidad y la propiedad identifican al responsable de negocio, al data steward, al productor, al equipo de plataforma y a quien responde ante incidentes para cada producto o elemento de datos crítico. El responsable aprueba qué significa «apto para el uso». El steward mantiene definiciones y excepciones. Los ingenieros implementan y operan los controles.
Los estándares y las reglas traducen expectativas de negocio en requisitos medibles. Pueden abarcar completitud, validez, unicidad, integridad referencial, exactitud, puntualidad y estabilidad estructural. Cada regla necesita un responsable y una respuesta documentada cuando falla.
La detección y los controles combinan validación con observabilidad. La validación comprueba si los valores cumplen criterios de negocio o estructurales explícitos. La observabilidad vigila comportamientos inesperados como cambios de volumen, brechas de frescura, variaciones de distribución y evolución del esquema.
El flujo de trabajo de incidentes define triaje, severidad, cuarentena, análisis de causa raíz, escalado, corrección y cierre. Una anomalía detectada no es un control completado. El flujo debe registrar quién la evaluó y por qué.
La medición y la retroalimentación rastrean si los controles evitan daño al negocio. Medidas útiles incluyen el rendimiento de las reglas, los tiempos de respuesta, la cobertura por responsables, los fallos recurrentes y el retrabajo. Estas métricas deben alimentar la planificación y las revisiones de producto, no quedarse en un panel que nadie usa.
Una visión práctica de la gestión de la calidad de datos ayuda a los equipos a alinear su vocabulario, pero la terminología no es el resultado. El resultado es un acuerdo operativo sobre qué ocurre cuando los datos fallan.
Los cuatro patrones de modelo y cómo elegir
En la práctica empresarial suele imponerse uno de cuatro patrones. La elección correcta depende menos de las modas organizativas que del riesgo, la complejidad de los dominios, la capacidad de ingeniería y la base de gobierno ya existente.
Patrón | Derechos de decisión | Dónde reside la responsabilidad | Fallo habitual |
|---|---|---|---|
Equipo central | Una función central de calidad de datos o del CDO define los estándares y prioriza la corrección | Equipo central de calidad, con los productores responsables de las correcciones | El centro se convierte en cuello de botella y los equipos de negocio esperan aprobación |
Dominios federados | Los equipos de dominio definen los criterios de adecuación de los datos que producen, dentro de estándares compartidos | Responsables y stewards de dominio | Las definiciones y los umbrales se desvían entre dominios |
Ingenieros integrados | Los equipos de producto o plataforma asumen las comprobaciones como parte del desarrollo y la operación | Equipos de ingeniería y producto | El significado de negocio queda infrarrepresentado en las pruebas técnicas |
Híbrido hub-and-spoke | Un centro de excelencia aporta estándares, herramientas y habilitación, mientras los dominios responden por los resultados | Responsabilidad compartida entre el equipo central y los dominios | El hub publica directrices, pero nadie exige su aplicación |
Un modelo central funciona cuando la interpretación regulatoria debe ser coherente o cuando la capacidad de ingeniería de los dominios es limitada. Se agota cuando se espera que un solo equipo entienda todos los contextos de negocio. Un modelo federado acerca las decisiones a los datos, pero requiere un vocabulario común sólido, control de cambios y un mecanismo de escalado. La propiedad integrada convierte la calidad en parte de la entrega, aunque los ingenieros no deberían tener que adivinar la definición de negocio de exactitud.
El patrón híbrido suele ser el punto de partida más viable para grandes organizaciones. Un equipo central responde por el marco de control, las herramientas compartidas y el reporte. Los responsables de dominio deciden sobre la adecuación, los productores corrigen las causas aguas arriba y los equipos de plataforma operan la infraestructura común. Esa es la lógica operativa que hay detrás del gobierno de datos federado, donde los estándares se mantienen coherentes sin forzar cada decisión a una cola central.
Una guía de decisión para elegir el patrón inicial
Dominios regulados: varios dominios regulados favorecen un modelo central o híbrido, porque las aprobaciones, la evidencia y el escalado deben tratarse de forma uniforme.
Madurez de ingeniería: equipos de producto sólidos pueden asumir propiedad integrada o federada. Los equipos sin prácticas de entrega fiables necesitan más habilitación central.
Inversión en gobierno: comités, catálogos y rutinas de stewardship existentes facilitan la adopción híbrida. Con poca inversión en gobierno, conviene un piloto central acotado antes de federar.
No copie el modelo de una empresa mayor. Elija la estructura más pequeña que dé a cada fallo crítico un responsable, una vía de respuesta y una persona con autoridad para decidir.
Niveles de madurez y KPIs medibles
Una etiqueta de madurez solo vale si cambia las decisiones diarias. «Gobierno avanzado» significa poco si los consumidores siguen encontrando los errores primero, la responsabilidad es ambigua o los ingenieros reparan una y otra vez la misma incidencia aguas arriba. Use un modelo de madurez de calidad de datos para conectar el comportamiento operativo con resultados medibles.
Nivel de madurez | Señales observables | KPIs clave |
|---|---|---|
Ad hoc | Las comprobaciones varían por equipo, la propiedad es informal y los usuarios descubren errores en los informes | Responsables nombrados para activos críticos, número de controles activos |
Reactivo | Los incidentes se registran tras el fallo, la priorización es informal y se repiten las urgencias | MTTD, MTTR, acumulación de incidentes abiertos |
Definido | Los conjuntos de datos críticos tienen reglas, responsables, niveles de severidad y vías de escalado documentados | Tasa de validación a la primera, activos críticos con responsable |
Medido | Las métricas de calidad aparecen en las revisiones operativas y los equipos analizan las causas recurrentes | Tendencia de MTTD y MTTR, tasa de recurrencia, horas de retrabajo |
Optimizado | Los controles influyen en releases, contratos, presupuestos y prioridades de mejora | Coste de la mala calidad, antigüedad de las excepciones abiertas, cobertura de controles, impacto en KPIs de negocio |
En el nivel ad hoc no construya una puntuación compuesta. Empiece por un inventario y marque los activos que sostienen ingresos, control de riesgos, reporte regulatorio o decisiones operativas. El primer KPI útil puede ser simple: cuando falla un control crítico, ¿hay alguien con autoridad para decidir?
Los equipos reactivos necesitan disciplina de respuesta. El tiempo medio de detección y el tiempo medio de corrección — MTTD y MTTR — muestran si mejoran la monitorización y la responsabilidad. Complételos con la tasa de recurrencia: un apaño rápido no demuestra que se haya corregido la causa raíz.
En el nivel definido, mida si los controles documentados se ejecutan de forma coherente y si los activos críticos tienen responsables. La tasa de validación a la primera indica con qué frecuencia los datos pasan sin intervención. En el nivel medido, la tasa de recurrencia y las horas de retrabajo revelan el coste de un análisis de causa raíz débil. El coste de la mala calidad conecta esos fallos con las conversaciones de capacidad y presupuesto.
Los KPIs deben respaldar decisiones, no decorar un panel. Un control con alta tasa de aprobación puede estar protegiendo un campo irrelevante, mientras que una tasa menor en un conjunto de datos crítico para la decisión exige inversión inmediata.
Un programa maduro mide si los controles protegen decisiones de negocio y si los equipos aprenden de los fallos. El estudio de tendencias de FP&A de EY de 2025 informó de que solo el 16 % de las organizaciones disponía de datos de alta calidad y fáciles de analizar, mientras que el 25 % describía sus datos como pobres o deficientes (estudio de tendencias FP&A de EY). En la práctica, esto implica vincular las medidas de calidad con el uso analítico y con la respuesta de los responsables, en lugar de optimizar solo tasas técnicas de aprobación.
Conectar observabilidad, validación y puntualidad
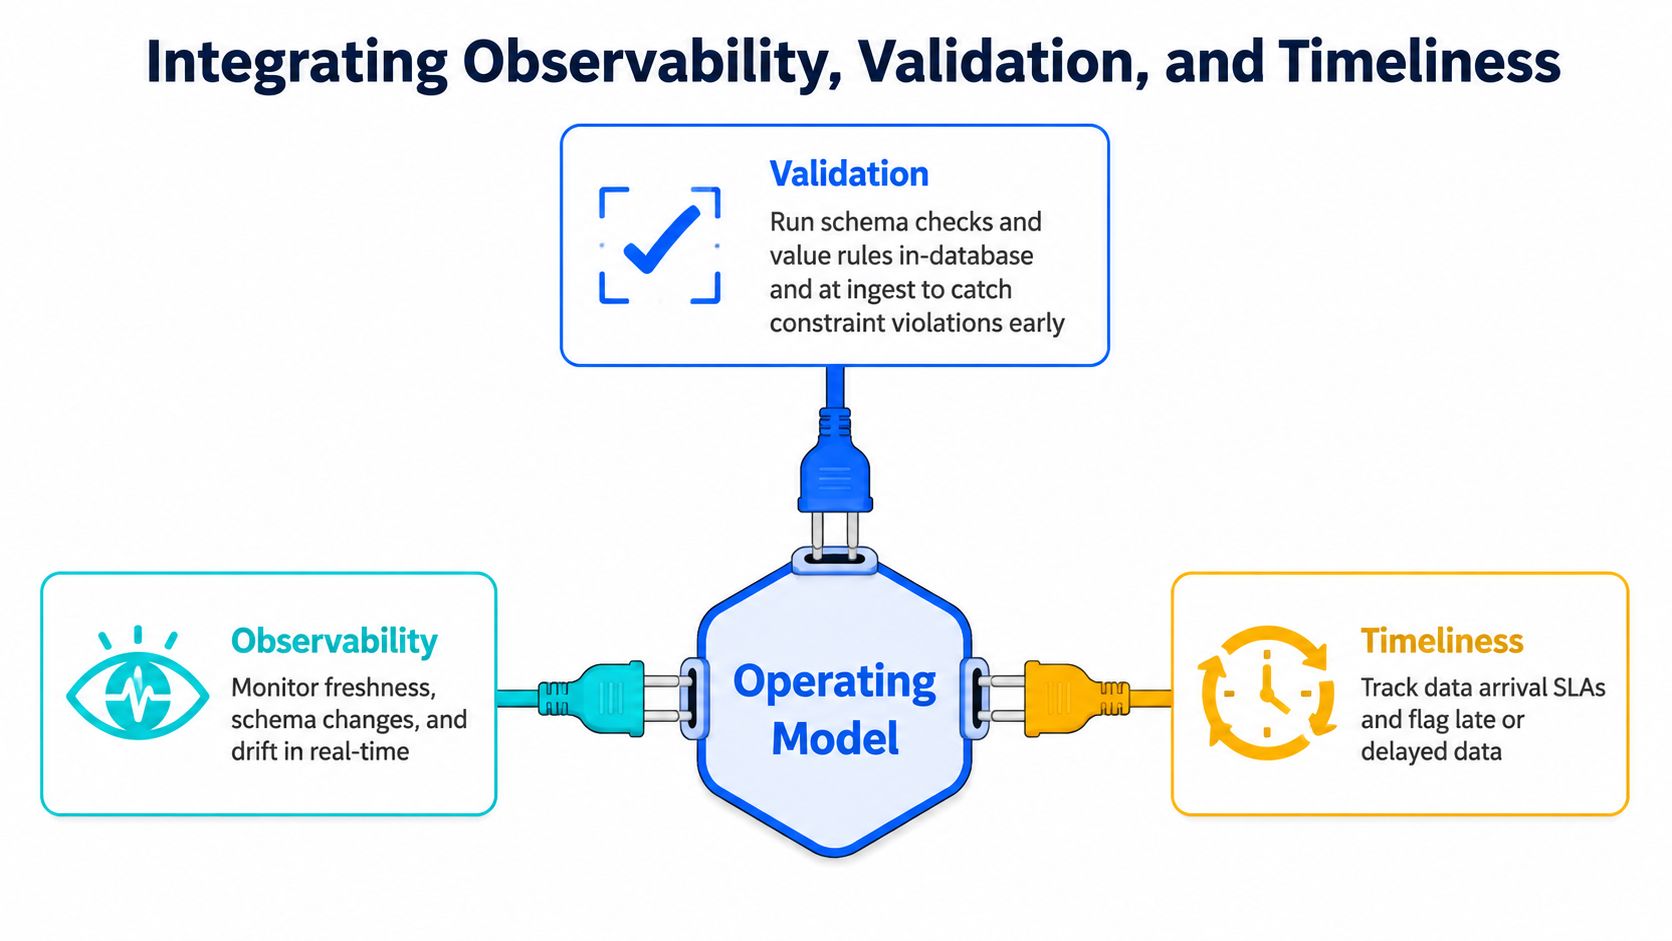
Estos controles no deberían convertirse en tres cadenas de herramientas paralelas con tres colas de alertas. Son capas complementarias de un modelo operativo, y cada capa necesita un responsable claro, un nivel de severidad y un traspaso.
La validación detecta incumplimientos explícitos
La validación comprueba si un registro cumple un requisito definido. A nivel de warehouse, una restricción NOT NULL sobre los identificadores de cliente y una comprobación referencial contra la dimensión de clientes pueden capturar registros inválidos en la escritura. El productor responde por la corrección en origen, el steward por el significado de la regla y el ingeniero de plataforma por su ejecución fiable.
Use puertas duras para fallos que hagan insegura la explotación posterior. Use puertas blandas o vías de cuarentena cuando el negocio tolere excepciones controladas. La decisión corresponde al responsable de los datos, no al ingeniero que casualmente recibe la alerta.
La observabilidad detecta lo que las reglas pasan por alto
La observabilidad vigila cómo se comportan los sistemas y conjuntos de datos a lo largo del tiempo. Detecta volúmenes, distribuciones, frescura, cargas de trabajo y cambios de esquema inesperados, aunque cada fila cumpla una regla estática. Una anomalía repentina en el volumen de transacciones puede indicar una partición de origen ausente, una carga duplicada o un evento de negocio que merece investigación.
La respuesta debe conectar la señal con el contexto. Los metadatos deberían identificar los productos de datos afectados, los informes posteriores y el productor responsable del proceso aguas arriba. Sin ese contexto, una plataforma de observabilidad genera alertas sin mejorar las decisiones. El equipo central de habilitación puede mantener el patrón de monitorización mientras el responsable de dominio valora si el cambio constituye un incidente.
La puntualidad merece su propio control
La puntualidad pregunta si los valores siguen reflejando el estado actual de los objetos reales que representan. Los equipos operativos suelen medirla como la latencia desde el origen hasta la disponibilidad, así que instrumente event_time, processed_time y available_time para distinguir retrasos de captura, procesamiento y disponibilidad (investigación sobre puntualidad en la calidad de datos).
Un umbral de frescura debería convertirse en un objetivo de nivel de servicio exigible del producto de datos. Las comprobaciones automáticas de antigüedad pueden marcar los registros que superan la edad aceptada, convirtiendo los datos vencidos en un incidente en lugar de una nota pasiva en un panel (guía de monitorización de puntualidad). El responsable decide entonces si bloquea el uso, publica un aviso o activa un plan alternativo.
La validación pregunta «¿es aceptable este valor?». La observabilidad pregunta «¿es inusual este comportamiento?». La puntualidad pregunta «¿llegó a tiempo para ser útil?». El modelo operativo asigna cada respuesta a una persona y a una vía de reacción. Por eso, los equipos que evalúan observabilidad de datos deberían examinar el flujo de trabajo y la responsabilidad tanto como la capacidad de detección.
Hoja de ruta de implementación del piloto a la escala empresarial
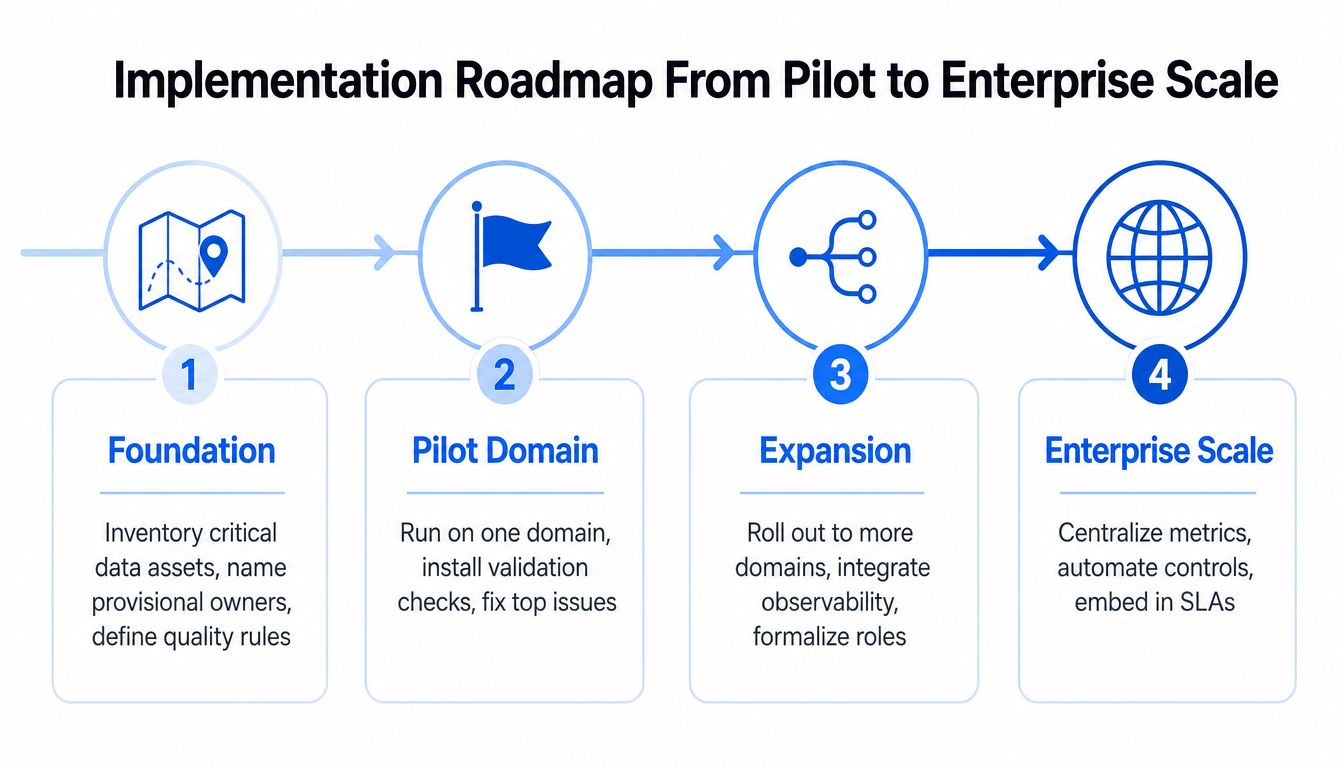
Un despliegue fiable empieza con un riesgo de negocio acotado y se amplía solo cuando el circuito de responsabilidad funciona. Los inventarios amplios y las grandes bibliotecas de reglas parecen productivos, pero a menudo generan hallazgos sin responsable que erosionan la confianza en el programa.
Fundamentos
Inventaríe los activos de datos críticos y mapee consumidores, productores, responsables y modos de fallo conocidos. Nombre responsables de negocio y stewards provisionales, defina una taxonomía de severidad y publique un flujo de incidentes que cubra detección, triaje, cuarentena, escalado, corrección y cierre.
El responsable de gobierno lidera el diseño operativo. Un responsable de plataforma se ocupa de la vía de ejecución, mientras los líderes de dominio confirman qué activos importan. La condición de salida es práctica: cada activo crítico seleccionado tiene un responsable provisional y cada incidente tiene una vía documentada.
Dominio piloto
Elija un dominio de alto valor como ingresos o Customer 360. Defina los primeros contratos de datos, implemente controles focalizados de validación y puntualidad, y conecte una señal de observabilidad con la rotación de guardia. El responsable de dominio evalúa los fallos, el productor corrige la lógica de origen y el equipo de plataforma opera el entorno de ejecución de los controles.
El piloto termina cuando el equipo puede demostrar detección, asignación, análisis de causa raíz, corrección y cierre por la misma vía operativa. No lo juzgue por el número de reglas entregadas, sino por si la responsabilidad resiste un fallo real.
Expansión
Replique el patrón en varios dominios, cree un consejo de calidad de datos y estandarice los requisitos mínimos de controles y metadatos. El consejo debería resolver conflictos entre dominios, aprobar definiciones compartidas y revisar fallos recurrentes. Los dominios conservan la responsabilidad sobre sus resultados de datos.
Criterios de salida útiles son un MTTD por debajo de 24 horas y un 80 % de los activos críticos con responsables documentados. Son objetivos operativos locales, no referencias universales. Si no se alcanzan, revise los traspasos y la autoridad de escalado antes de añadir más automatización.
Escala empresarial
Incorpore las medidas de calidad a los scorecards de productos de datos, las revisiones de release, los acuerdos de nivel de servicio y las conversaciones presupuestarias. Siga el coste de la mala calidad a través de horas de retrabajo, correcciones repetidas y decisiones retrasadas. La función central pasa a ser una capa de habilitación y aseguramiento, mientras los dominios mantienen la responsabilidad sobre sus datos.
La mejora continua significa retirar reglas que no aportan, ajustar umbrales cuando cambian los casos de uso y comprobar si los controles evitan daño al negocio. La escala empresarial no es un panel más grande. Es un sistema repetible que hace visibles las decisiones de calidad en el trabajo diario.
Consideraciones sectoriales en industrias reguladas
La columna vertebral del modelo operativo se mantiene estable entre sectores regulados, pero cambian los derechos de decisión y las obligaciones de evidencia. El sector financiero necesita evidencia de linaje para BCBS 239 y para informes sujetos a SOX, con responsabilidad próxima al libro mayor y no solo a un conjunto de datos genérico. La sanidad necesita stewards de seguridad clínica capaces de detener un pipeline cuando cambian los datos de referencia, con controles de completitud y exactitud ligados al riesgo HIPAA.
Los equipos de telecomunicaciones deberían vincular la calidad de los CDR con el aseguramiento de ingresos. Las operaciones de red deben participar en el consejo de calidad, porque los registros perdidos o corruptos pueden afectar a la facturación y al análisis de servicio. El sector público necesita controles sobre datos ciudadanos donde la frescura y la accesibilidad sostienen obligaciones de transparencia e igualdad.
Para organizaciones que operan en investigación clínica, regulación y funciones comerciales, los directorios de directivos del sector biotecnológico pueden aportar contexto útil sobre qué perfiles deberían estar representados en las decisiones de calidad. El objetivo no es crear cuatro programas de gobierno separados, sino mantener un mecanismo de responsabilidad y adaptar la evidencia, los responsables y los umbrales de escalado al entorno de riesgo.
Sector | Foco de la responsabilidad | Principal impulsor de KPIs | Capa de control específica |
|---|---|---|---|
Finanzas | Responsables del libro mayor y del reporte | Completitud del linaje y adecuación del reporte | Evidencia para BCBS 239 y SOX |
Sanidad | Seguridad clínica y data stewards | Completitud, exactitud y fiabilidad para la atención al paciente | Intervención en pipelines orientada a la seguridad |
Telecomunicaciones | Operaciones de red y aseguramiento de ingresos | Integridad de los registros y seguridad de la facturación | Validación y conciliación de CDR |
Sector público | Responsables de programas, accesibilidad y archivos | Frescura, accesibilidad y fiabilidad del servicio público | Controles de transparencia e igualdad |
Una única política puede sostener los cuatro sectores, pero los responsables locales deben mantener la autoridad sobre qué constituye un fallo inaceptable. Ese equilibrio hace que el modelo sea modular sin volverlo difuso.
Errores frecuentes y su lista de tareas para la próxima semana
Comprar software no crea un modelo operativo. Una plataforma puede detectar anomalías o ejecutar validaciones, pero las personas siguen teniendo que establecer la responsabilidad, aprobar umbrales, decidir excepciones y escalar fallos.
Los data stewards tampoco pueden corregir todos los defectos aguas arriba. Si un steward no tiene autoridad para modificar un sistema de origen, asignarle el incidente solo enmascara la brecha de responsabilidad. El productor debe responder por la corrección, el steward mantiene el significado y el órgano de gobierno resuelve el conflicto.
Los paneles en verde no demuestran que la calidad esté resuelta. Un conjunto de datos puede superar las reglas que se le aplican mientras cambia una fuente no monitorizada, se incumple un compromiso de frescura o una métrica de negocio se desvía del comportamiento esperado. Añadir más reglas puede empeorarlo si generan ruido, duplican lógica o empujan a los equipos a optimizar tasas de aprobación en lugar de confianza en la decisión.
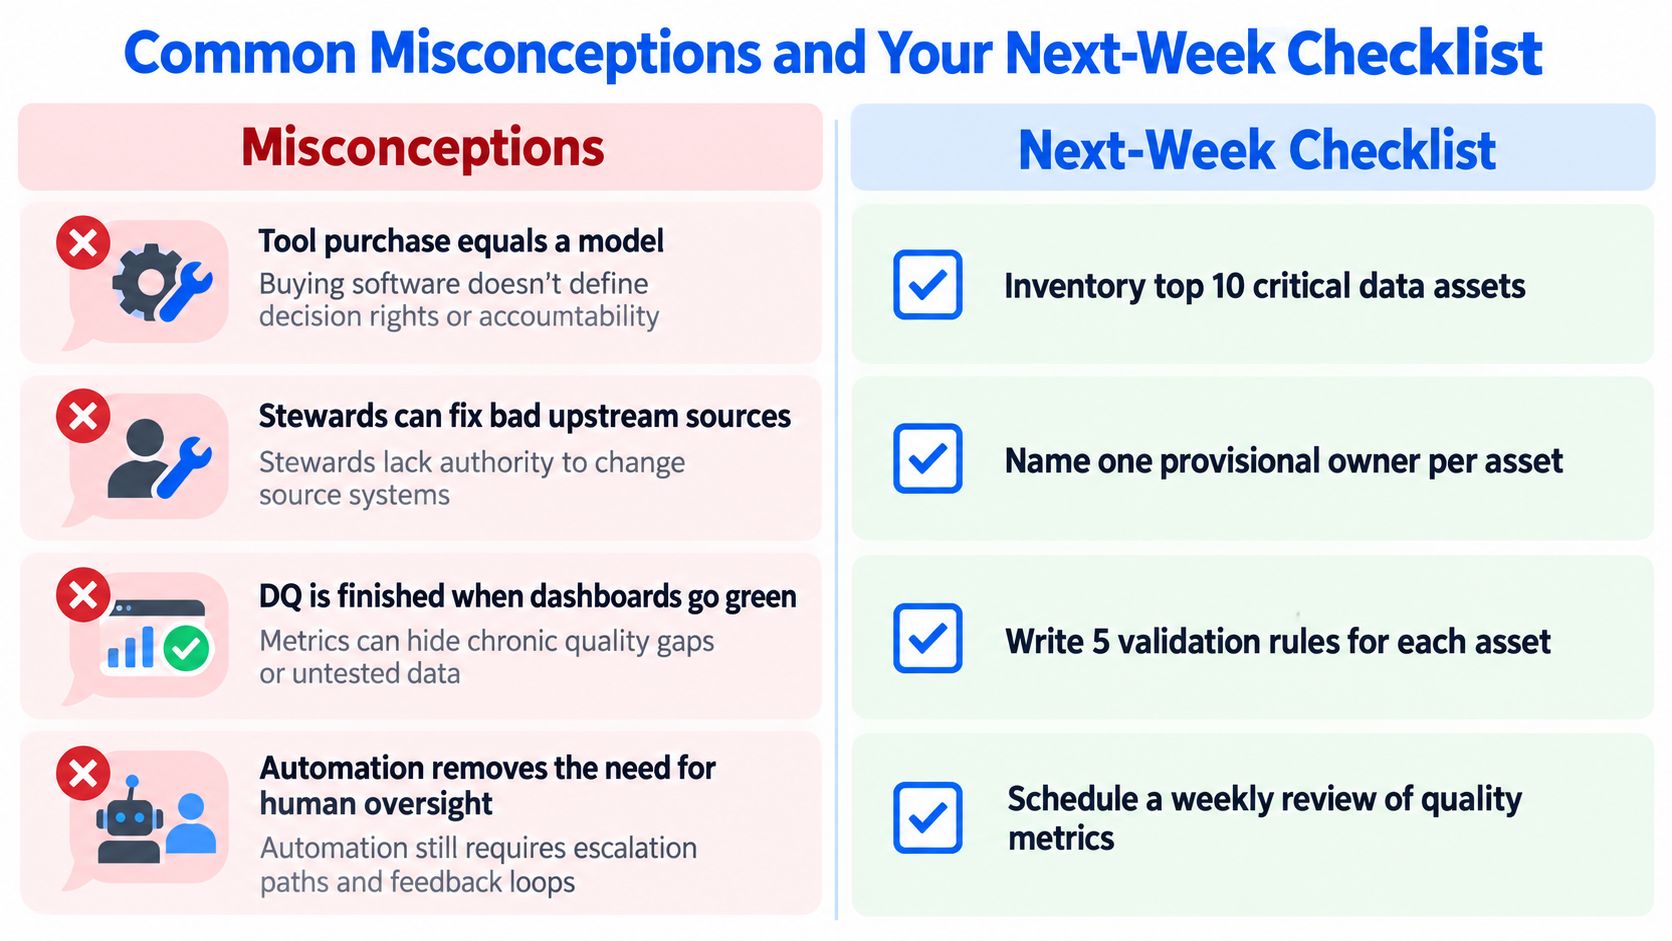
Cinco acciones para la próxima semana
Nombre responsables: confirme un responsable de calidad para cada elemento o activo de datos crítico.
Documente los derechos de cuarentena: registre quién puede bloquear, poner en cuarentena o liberar datos cuando falla un control crítico.
Conecte una señal a la guardia: enlace una alerta de observabilidad con una rotación existente de ingeniería u operaciones.
Retire una regla sin uso: elimine una comprobación que nadie revisa ni sabe explicar, y documente la decisión.
Publique un KPI de frescura: lleve una métrica de puntualidad a un foro de dirección donde alguien pueda actuar.
Un modelo operativo práctico de gobierno de datos requiere derechos de decisión, roles, órganos, rutinas, traspasos, evaluación del desempeño, control de cambios y una hoja de ruta de implementación. Mantenga ese listón al revisar su lista: si una tarea no indica quién decide y qué ocurre después, aún no es un control operativo.
digna ayuda a los equipos de datos a conectar validación en base de datos, detección de anomalías, monitorización de puntualidad y seguimiento de cambios de esquema en una vista común de incidentes dentro de su propio entorno. Visite digna para ver cómo la plataforma sostiene un modelo operativo de calidad de datos con responsables, controles medibles y escalado accionable.
Vea cómo lo hace digna en la práctica: monitorización de calidad de datos en todas sus plataformas.
Preguntas frecuentes
¿Qué es un modelo operativo de calidad de datos?
Un modelo operativo de calidad de datos es la estructura que traslada la calidad de una serie de proyectos a la operación diaria. Define quién responde por qué datos, qué controles se ejecutan, cómo se miden los resultados y qué ocurre cuando algo falla.
¿Qué componentes tiene un modelo operativo de calidad de datos?
Cinco lo hacen operativo: propiedad y responsabilidad, controles definidos de validación, observabilidad y puntualidad, KPIs que muestren si la calidad mejora, las herramientas que ejecutan los controles y las rutinas — triaje, escalado, revisión — que mantienen vivo el modelo.
¿La calidad de datos debe ser centralizada o federada?
Depende de dónde resida ya la responsabilidad. Un equipo central funciona mientras el panorama sea pequeño; un modelo federado encaja en organizaciones con fuerte propiedad de dominio; la mayoría de las grandes empresas acaban en un híbrido: estándares y herramientas centrales, ejecución en los dominios.
¿Qué KPIs miden la operación de calidad de datos?
Son útiles la cobertura de los conjuntos de datos críticos, el tiempo medio de detección y de resolución, la frecuencia y recurrencia de incidentes, y la proporción de problemas que encuentra la monitorización en lugar de un usuario de negocio.
¿Cuánto se tarda en implantar un modelo operativo de calidad de datos?
La secuencia práctica es fundamentos, dominio piloto, expansión y escala empresarial. Un piloto acotado suele mostrar una mejora medible en la detección en un trimestre, y esa evidencia es la que permite financiar la expansión.