Análisis de la confianza de datos explicado para equipos de datos modernos
|
8
minuto de lectura

Una encuesta de perspectivas de planificación de 2024 encontró que el 67% de las organizaciones no confiaban completamente en los datos utilizados para la toma de decisiones, frente al 55% del año anterior, una caída de 12 puntos en la confianza en un solo ciclo anual. El análisis de la encuesta realizado por Precisely captura el problema con claridad: se les pide a los equipos de análisis que se muevan más rápido mientras que su base de evidencia sigue siendo difícil de verificar.
Esa brecha es el territorio práctico de la analítica de confianza de datos. Conecta la calidad de los datos, la Observability, la detección de anomalías, el linaje y el contexto de negocio para que los equipos puedan responder a una pregunta más útil que "¿Se ejecutó el pipeline?". Pueden preguntar: "¿Es este conjunto de datos lo suficientemente confiable como para respaldar una decisión o un resultado de IA en este momento?".
Tabla de contenidos
Por qué la confianza de datos es el nuevo cuello de botella para la analítica y la IA
Por qué la confianza en el código no es confianza en los datos
Qué significa realmente la analítica de confianza de datos
La confianza es una señal compuesta
Los cinco pilares que producen señales de confianza
La frescura muestra si los datos están actualizados
La calidad prueba valores y reglas de negocio
El volumen detecta fallas silenciosas de completitud
El esquema protege la compatibilidad estructural
El linaje identifica a quién y qué se ve afectado
Cómo las capas de detección combinan estadísticas, ML y revisión humana
Dónde aporta valor el aprendizaje automático
Por qué las personas siguen siendo parte del sistema
Métricas que convierten la confianza en algo que se puede medir
Lea las métricas en conjunto
Agregue contexto de decisión
De la Observability a la preparación para la toma de decisiones en IA
Construya cuadros de mando en torno a los resultados
Operando la confianza dentro de las restricciones de la empresa
Mantenga el plano de control proporcional
Asigne la propiedad antes de agregar alertas
Construyendo un modelo operativo de confianza que se mantenga
Convierta los incidentes en conocimiento institucional
Revise la confianza como una práctica interfuncional
Por qué la confianza de datos es el nuevo cuello de botella para la analítica y la IA
Un líder de finanzas abre un panel de ingresos antes de una reunión ejecutiva. El gráfico muestra una fuerte disminución en las ventas regionales, por lo que el equipo retrasa un plan de contratación y revisa su pronóstico. Más tarde, un ingeniero descubre que un cambio upstream causó que parte de los datos de los clientes llegara tarde. El panel no mostraba una fabricación maliciosa. Mostraba datos que se habían vuelto incompletos sin que la falla fuera obvia.
Ese escenario es común porque los paneles, los modelos de aprendizaje automático y los copilotos de IA heredan las condiciones de sus datos de origen. Las filas faltantes pueden reducir una métrica. Una partición obsoleta puede hacer que una tendencia parezca actual cuando no lo es. Una unión rota puede eliminar clientes de un segmento. Una columna renombrada puede alterar una transformación. Sin un linaje utilizable, nadie puede establecer rápidamente qué informes, características o decisiones se ven afectados.
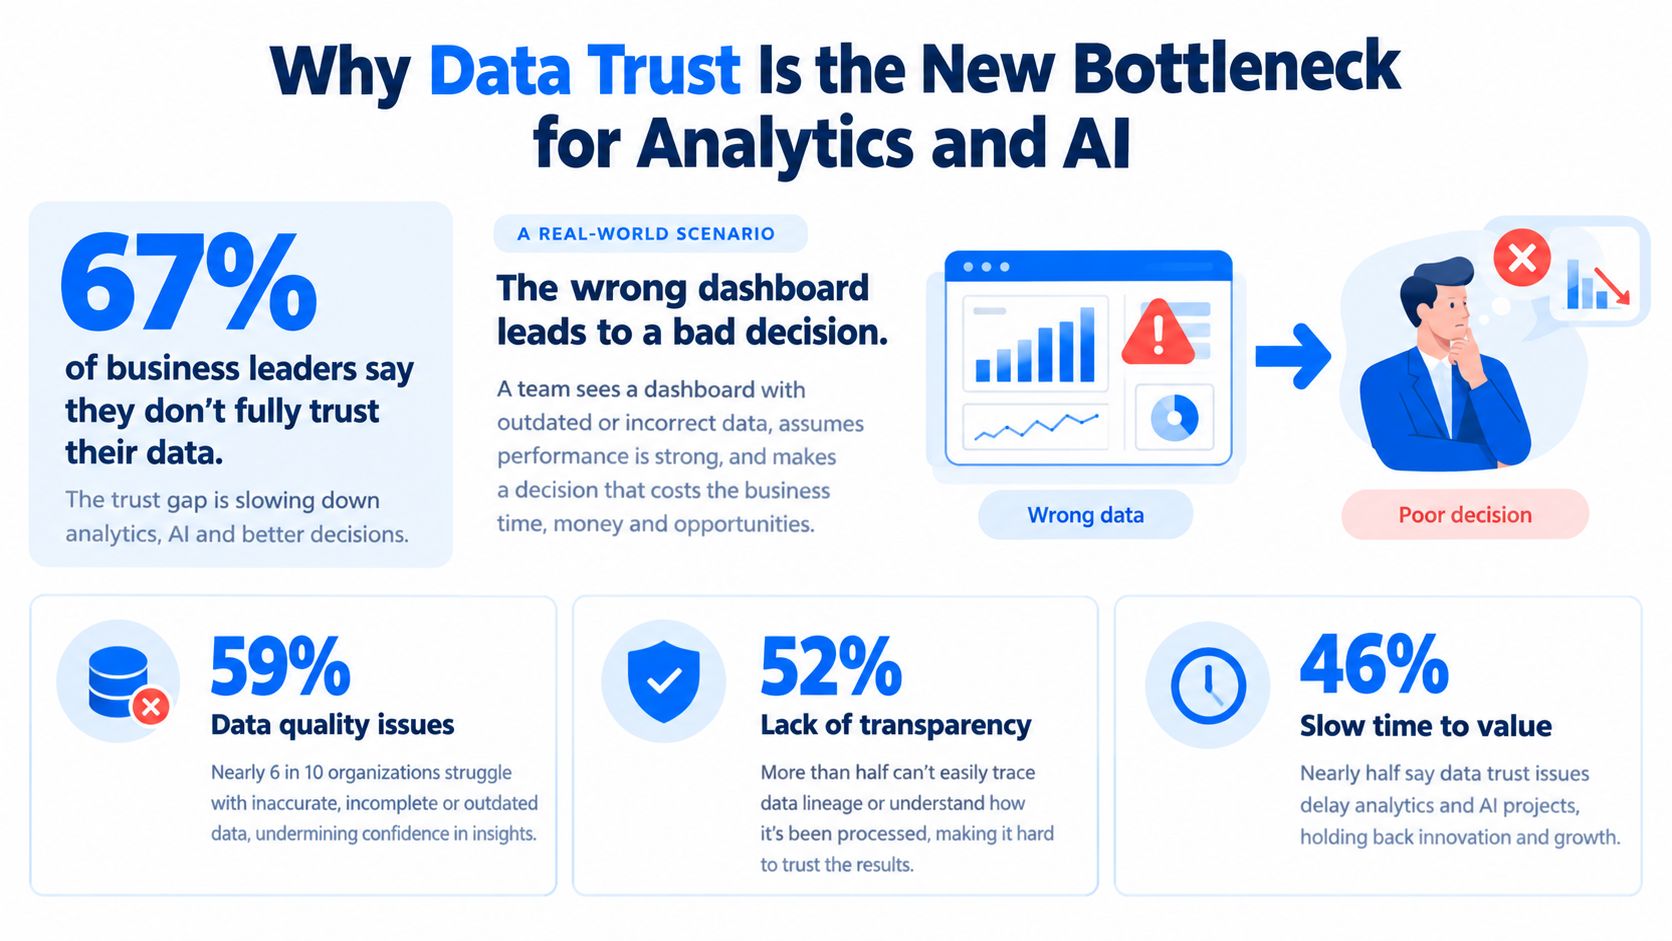
El costo empresarial se extiende más allá de un gráfico incorrecto. En un informe industrial relacionado, el 77% de los tomadores de decisiones de TI dijeron que no confiaban completamente en los datos de su organización para tomar decisiones críticas de negocio, oportunas y precisas, mientras que el 82% dijo que los empleados tuvieron que rehacer proyectos analíticos completados debido a la mala calidad de los datos. El mismo informe de Precisely vincula la baja confianza con la fricción operativa, incluyendo que la calidad de los datos sea la principal barrera para el 70% de los encuestados en organizaciones con baja confianza en los datos para la toma de decisiones.
Por qué la confianza en el código no es confianza en los datos
Un modelo puede pasar sus pruebas de implementación y aun así producir recomendaciones poco confiables si sus tablas de características se han desviado. Una consulta SQL puede compilarse con éxito mientras devuelve menos filas porque un proceso upstream dejó de cargar una fuente. La corrección del software le indica que el código se ejecutó según lo diseñado. No demuestra que las entradas fueran completas, oportunas, estables o adecuadas para la decisión.
La analítica de confianza de datos proporciona esa evidencia faltante. Trata las señales operativas como parte de la validez analítica, luego conecta las fallas con los activos afectados y los propietarios responsables. Los equipos que analizan el impacto de la mala calidad de los datos en las decisiones de negocio pueden usar esta distinción para pasar de corregir errores visibles en los paneles a evitar que los resultados poco confiables lleguen a quienes toman las decisiones.
Qué significa realmente la analítica de confianza de datos
Comience con la definición estrecha. La calidad de los datos verifica si los valores y registros cumplen con condiciones conocidas, como que un campo requerido esté completo, que una fecha se encuentre dentro de un rango permitido o que un identificador de cliente sea único. Esas comprobaciones son necesarias, pero solo cubren lo que el equipo ha pensado en especificar.
La analítica de confianza de datos amplía la pregunta. Combina la evidencia de calidad con la Timeliness, el volumen, la estabilidad del esquema, el linaje, la propiedad y el significado documentado. El consumidor de los datos necesita saber no solo si un valor parece válido, sino también si el conjunto de datos está actualizado, se comprende, es rastreable y es seguro de usar para un propósito particular.
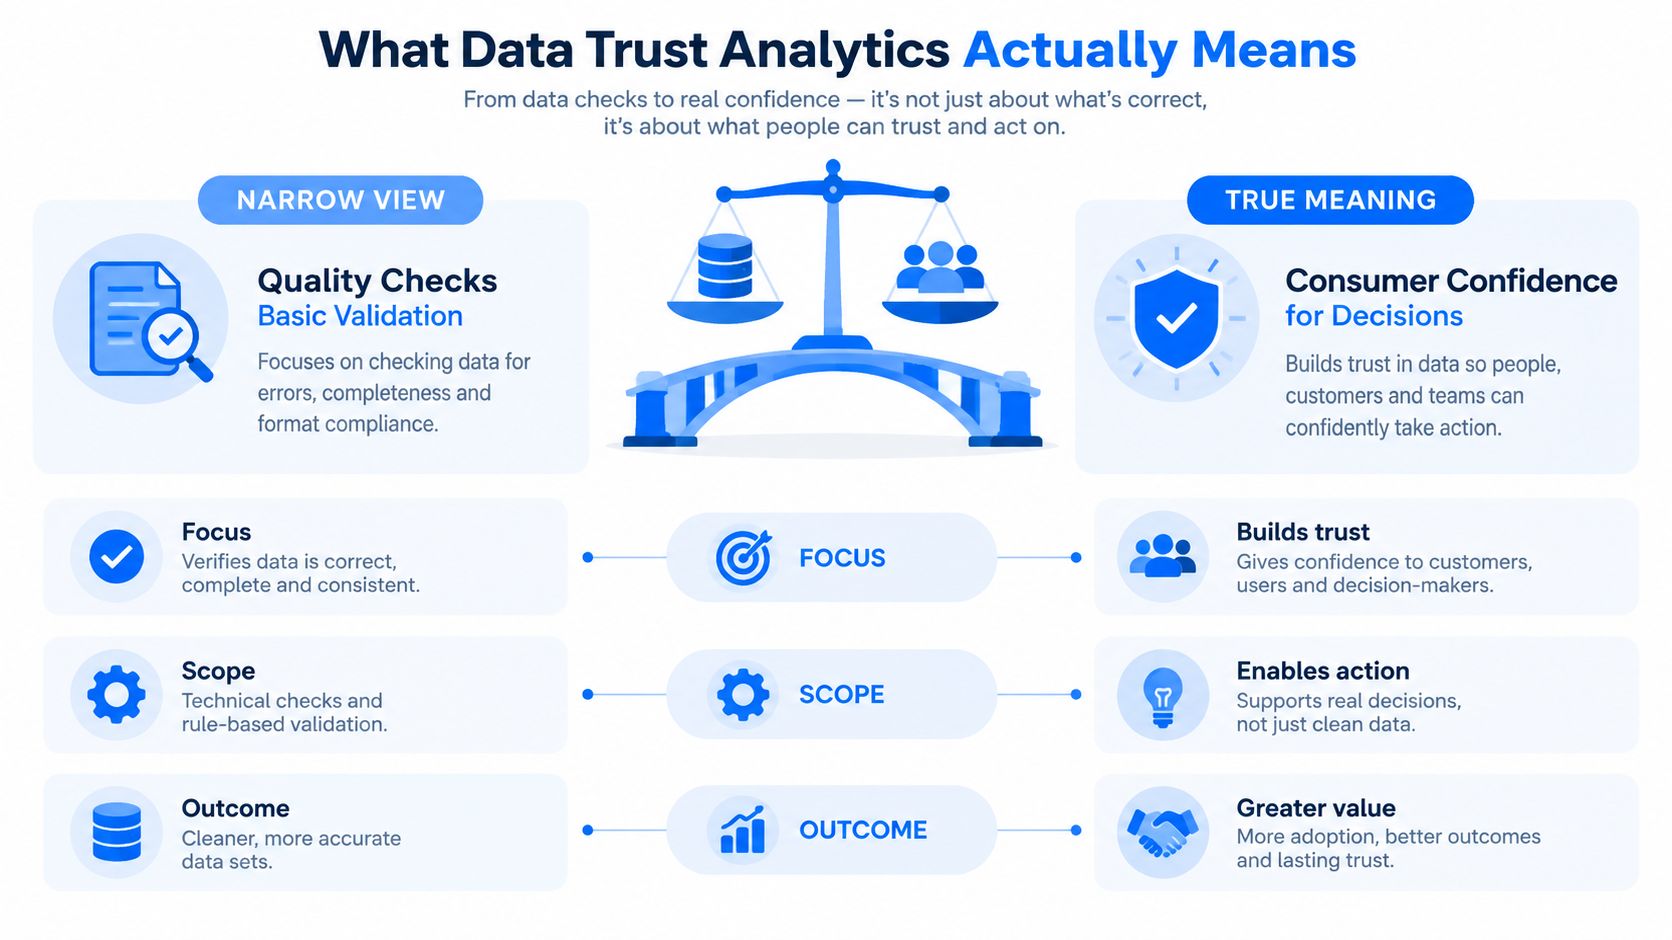
Una distinción útil es:
La calidad de los datos pregunta: "¿Cumple este valor con la regla?"
La analítica de confianza de datos pregunta: "¿Se apoyaría un tomador de decisiones en este conjunto de datos para hacer una recomendación en este mismo momento?"
Esa segunda pregunta depende del contexto. Un retraso menor puede ser aceptable para un informe de planificación mensual, pero inaceptable para una alerta operativa. Una columna puede ser técnicamente válida pero semánticamente ambigua. Una característica del modelo puede pasar las verificaciones de nulos mientras pierde su conexión con el sistema de origen que explica su significado.
La confianza es una señal compuesta
Piense en la confianza como una conclusión extraída de varios tipos de evidencia:
Evidencia operativa: ¿Llegaron los datos cuando se esperaba y se completó el pipeline?
Evidencia estadística: ¿Se asemejan los recuentos, distribuciones, promedios y patrones de valores faltantes a su comportamiento establecido?
Evidencia estructural: ¿Siguieron siendo compatibles las columnas, los tipos de datos y las relaciones?
Evidencia contextual: ¿Están documentados el propósito del conjunto de datos, el propietario, el linaje y la definición de negocio?
Un marco de Data Observability hace que estas señales sean visibles, pero la visibilidad por sí sola no es el resultado final. El paso importante es traducir las observaciones en un juicio de confianza para un panel, modelo, métrica o flujo de trabajo de IA específico.
Los Cinco Pilares Que Producen Señales de Confianza
Una falla silenciosa en un pipeline rara vez se anuncia con un error rojo. Supongamos que un proceso upstream de captura de datos modificados descarta filas durante dos días, pero el trabajo aún informa que se completó con éxito. Los paneles de ingresos comienzan a subinformar y un modelo de pronóstico recibe un historial de clientes incompleto. Cada pilar de Observability revela una parte diferente del incidente.
Los cinco pilares estándar son Timeliness, calidad, volumen, esquema y linaje. Trabajan juntos en lugar de como etiquetas intercambiables. Las dimensiones de la calidad de los datos proporcionan una forma útil de conectar las comprobaciones individuales con la pregunta más amplia de si los datos downstream siguen siendo adecuados para su uso.
La frescura muestra si los datos están actualizados
La frescura pregunta si un conjunto de datos llegó dentro de su cronograma esperado. Una carga que aparece todas las mañanas pero pierde su ventana de entrega normal debería reducir la confianza, incluso si los registros ya presentes pasan la validación. El monitoreo de Timeliness puede distinguir una carga retrasada de una carga faltante y también puede identificar una entrega anticipada inesperada que puede indicar un problema de programación o partición.
La calidad prueba valores y reglas de negocio
Las comprobaciones de calidad inspeccionan tasas de nulos, duplicados, formatos no válidos, relaciones referenciales y restricciones de negocio. En el ejemplo de las filas descartadas, los registros restantes podrían tener ID de cliente válidos, por lo que la validación a nivel de registro por sí sola podría pasar por alto el incidente. La calidad se vuelve más informativa cuando se interpreta junto con el volumen y el comportamiento histórico.
El volumen detecta fallas silenciosas de completitud
El monitoreo del volumen compara los recuentos de filas u otros indicadores de tamaño con los patrones esperados. Una reducción repentina puede revelar una extracción parcial incluso cuando el pipeline no emite ningún error técnico. El volumen no explica la causa, pero le da al equipo una señal temprana de que vale la pena investigar la completitud del conjunto de datos.
El esquema protege la compatibilidad estructural
El seguimiento del esquema detecta adiciones, eliminaciones, cambios de nombre y cambios de tipo. Una columna renombrada puede romper una transformación downstream de inmediato, o puede mapearse incorrectamente y producir resultados plausibles pero engañosos. La compatibilidad estructural es parte de la confianza porque los consumidores dependen tanto de los valores como de la forma de los datos.
El linaje identifica a quién y qué se ve afectado
El linaje conecta la tabla de origen con las transformaciones, paneles, características, modelos y métricas de negocio. Cuando se detecta la caída de filas, el linaje ayuda al equipo a identificar qué informes de ingresos y pronósticos necesitan revisión. La propiedad luego convierte ese mapa en acción al enrutar el incidente a las personas responsables de la fuente y de los productos afectados.
Ningún pilar único puede certificar la preparación para la toma de decisiones. La confianza surge cuando las señales se correlacionan, se interpretan en contexto y se entregan a los propietarios responsables.
Cómo las capas de detección combinan estadísticas, ML y revisión humana
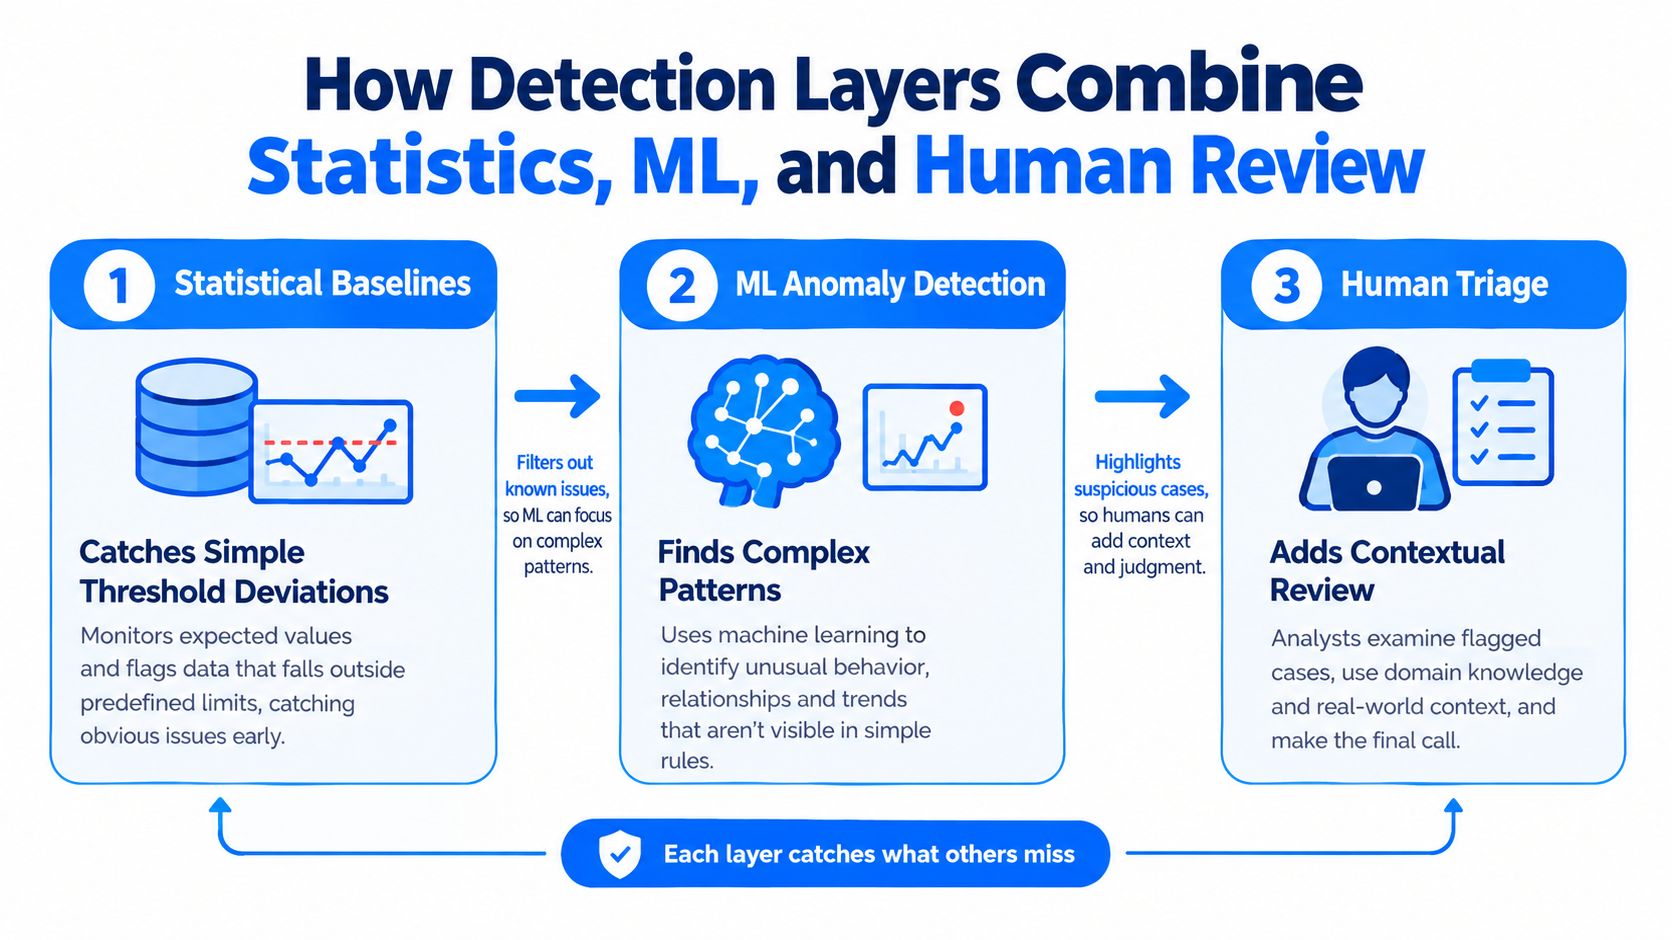
La detección funciona mejor como un sistema en capas porque cada capa responde a una pregunta diferente. Las líneas base estadísticas detectan fallas claras de manera económica y explicable. El aprendizaje automático identifica comportamientos que las reglas fijas pueden pasar por alto. La revisión humana proporciona el contexto de negocio necesario para decidir si una alerta representa un incidente, un cambio planificado o una variación inofensiva.
Comience con líneas base para la frescura, el volumen, las tasas de nulos, los promedios y otras métricas principales. Un umbral puede marcar una entrega faltante, mientras que una estadística móvil puede mostrar una desviación significativa del comportamiento reciente. Estos controles son fáciles de explicar durante la revisión del incidente, por lo que siguen siendo útiles incluso después de que un equipo agregue una detección más avanzada.
Dónde aporta valor el aprendizaje automático
Las reglas estáticas se vuelven menos confiables cuando los datos siguen patrones estacionales, de días laborables, de ciclos de Release o de segmentos de clientes. Una distribución aprendida o un modelo estacional puede identificar un patrón inusual que permanece dentro de un umbral fijo amplio, un enfoque basado en el reconocimiento estadístico de patrones. Un pipeline puede superar su regla de recuento mínimo de filas mientras produce una distribución que difiere notablemente de su perfil establecido.
Para datos operativos de alto volumen, la investigación de la Universidad de Ámsterdam describe un enfoque no supervisado basado en el consenso que combina múltiples modelos, reglas prácticas, ajuste iterativo de hiperparámetros y un experto en el dominio en el ciclo. El método del estudio respalda un principio de diseño práctico: ningún detector único debe ser responsable de todos los tipos de anomalías.
Por qué las personas siguen siendo parte del sistema
Un pipeline puede pasar comprobaciones fijas de frescura y volumen y aun así activar un modelo aprendido porque una métrica clave cae de una manera desconocida. Un analista revisa el calendario de implementaciones y confirma que una promoción planificada causó el cambio. Marcar el evento como esperado evita que alertas similares se conviertan en ruido recurrente y le da al proceso de detección un mejor contexto.
Un marco de calidad de datos independiente recomienda perfilar cada lote que llega, retener los perfiles históricos y alimentar la serie temporal resultante en modelos de anomalías. El enfoque de perfilado citado trata la desviación como una secuencia medible en lugar de una inspección única.
Regla práctica: Use reglas para modos de falla conocidos, modelos para comportamientos cambiantes y personas para el contexto de negocio.
Métricas que convierten la confianza en algo que se puede medir
La confianza se vuelve manejable cuando los equipos la expresan a través de métricas sobre las que pueden informar, alertar y mejorar. Un panel que dice "los datos parecen saludables" es difícil de defender. Un cuadro de mando que muestra el rendimiento de la frescura, las anomalías no resueltas, el tiempo de recuperación del esquema y la cobertura del linaje brinda a los ingenieros y a las partes interesadas un lenguaje operativo compartido.
Las métricas a continuación son puntos de partida, no objetivos universales. Un conjunto de datos de pago crítico debería tener expectativas más estrictas que una tabla exploratoria. Defina el punto de referencia con los propietarios y consumidores que entienden las consecuencias de una falla.
Métrica | Definición | Punto de referencia objetivo | Pilar de origen |
|---|---|---|---|
SLO de frescura | Proporción de actualizaciones esperadas entregadas dentro de la cadencia acordada | Establecido por el uso de decisión del conjunto de datos y la expectativa de entrega | Frescura |
Tasa de anomalías | Eventos anómalos detectados en relación con la población de la tabla monitoreada y el período de observación | Lo suficientemente bajo como para mantener la atención, con incidentes confirmados rastreados por separado de los eventos aceptados | Calidad, volumen, frescura |
MTTR de cambio de esquema | Tiempo medio desde un cambio de esquema no autorizado o incompatible hasta su resolución | Lo suficientemente corto como para proteger la publicación downstream y el uso del modelo | Esquema |
Cobertura de linaje | Proporción de activos downstream conectados a una fuente upstream de propiedad y monitoreada | Cobertura completa para informes, características y modelos críticos | Linaje |
Lea las métricas en conjunto
Un sólido resultado de frescura no compensa un linaje deficiente. Una baja tasa de anomalías puede significar datos estables, o puede significar que el detector es demasiado conservador. El MTTR de cambio de esquema puede parecer saludable mientras los equipos siguen sin poder identificar todos los paneles afectados.
Por esa razón, publique el contexto de la métrica junto con el número mismo. Registre el conjunto de activos monitoreados, el uso de decisión, las exclusiones, las anomalías aceptadas y el estado de propiedad. Una guía para medir la confiabilidad puede ayudar a los equipos a convertir las observaciones operativas en una conversación sobre confiabilidad que las partes interesadas del negocio entiendan.
Agregue contexto de decisión
Cada cuadro de mando debe responder a tres preguntas:
¿Qué se midió? Nombre la tabla, el conjunto de características, la métrica o la entrada del modelo.
¿Qué cambió? Muestre la señal actual frente a su línea base histórica y la expectativa acordada.
¿Qué acción sigue? Identifique al propietario, la ruta de escalada y la decisión de publicación o inferencia.
Esa estructura evita que los equipos traten la confianza como una etiqueta decorativa en un panel. Hace que la confianza sea revisable.
De la Observability a la preparación para la toma de decisiones en IA
La Observability produce evidencia, pero no le dice automáticamente al propietario de un modelo si un sistema de IA debería ejecutarse hoy. Una plataforma puede mostrar una ejecución de pipeline saludable mientras que los datos de características siguen siendo difíciles de rastrear, tienen una distribución inusual o se ven afectados por anomalías no resueltas.
La brecha es medible en el sentimiento empresarial. El 58% de las organizaciones dijeron haber implementado u optimizado programas de Data Observability, pero el 42% aún no confiaba en los resultados de sus modelos de IA o aprendizaje automático, según informes recientes sobre la confianza en la IA empresarial. Por lo tanto, la Observability puede coexistir con la desconfianza cuando los equipos monitorean la infraestructura sin demostrar que las entradas downstream están listas para la toma de decisiones.
Construya cuadros de mando en torno a los resultados
Un cuadro de mando de confianza debe vincular la evidencia a un consumidor específico. Por ejemplo, una tabla de características podría mostrar una frescura aceptable pero solo un 60% de cobertura de linaje y tres anomalías no resueltas. Esas cifras son valores de escenario, no puntos de referencia generales, pero demuestran por qué un estado genérico de pipeline en verde puede ser engañoso.
El proceso de promoción del modelo puede aplicar filtros explícitos:
Filtro de frescura: Las entradas requeridas llegaron dentro de sus ventanas esperadas.
Filtro de calidad: Se superaron las reglas críticas de validación, con las excepciones documentadas.
Filtro de esquema: No quedan cambios estructurales incompatibles sin resolver.
Filtro de linaje: El propietario del modelo puede rastrear las características críticas hasta las fuentes monitoreadas.
Filtro de incidentes: Las anomalías abiertas tienen un propietario asignado y una decisión documentada.
Un cuadro de mando no debe ocultar la incertidumbre detrás de un único número compuesto. Debe mostrar la evidencia detrás de la decisión, la aprobación del propietario del riesgo y las condiciones bajo las cuales el resultado debe retenerse o revisarse.
Esa evidencia también puede aparecer en la documentación del modelo. Los ejecutivos, reguladores, analistas e ingenieros necesitan más que una métrica del modelo. Necesitan una explicación defendible de si los datos que respaldan el resultado eran actuales, estables, validados y rastreables en el momento de su uso.
Operando la confianza dentro de las restricciones de la empresa
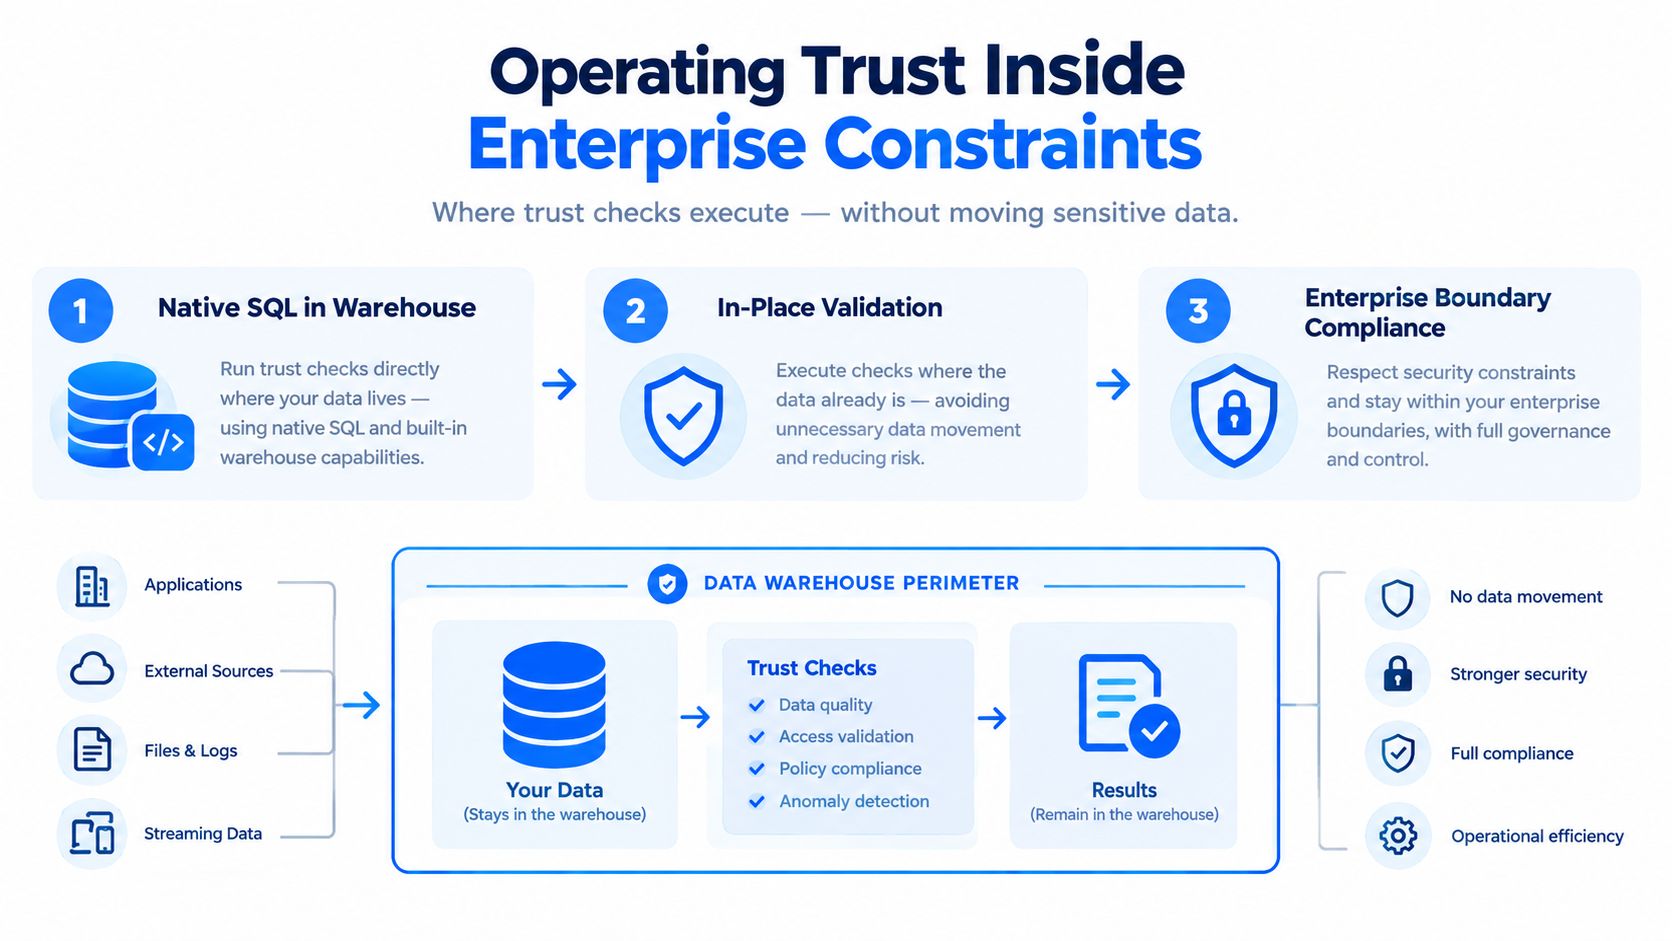
Los controles de confianza deben adaptarse al entorno donde ya viven los datos sensibles. Mover registros de producción a un servicio de monitoreo independiente puede generar inquietudes sobre privacidad, residencia de datos, control de acceso, cifrado y redes. También puede complicar el modelo de propiedad al separar la evidencia del sistema que contiene los datos.
Una arquitectura práctica a menudo separa la ejecución de la coordinación. Las comprobaciones nativas de SQL o de la base de datos pueden calcular recuentos de filas, restricciones, indicadores de frescura y resultados de validación allí donde residen los datos. Un servicio centralizado puede entonces gestionar políticas, alertas, enrutamiento de incidentes y cuadros de mando utilizando los metadatos necesarios en lugar de copias de los registros subyacentes.
Mantenga el plano de control proporcional
El modelo de implementación adecuado depende de los límites de la organización. Una instalación en nube privada o local puede ser adecuada para equipos que no pueden mover datos de producción fuera de su entorno. digna afirma que su plataforma se ejecuta dentro de la nube privada o la infraestructura local del cliente, con comprobaciones de calidad de datos y lógica de detección de anomalías que se ejecutan dentro del motor de base de datos del cliente. Su documentación describe este modelo in situ.
El diseño operativo también debe tener en cuenta la fricción de adopción. Datos de encuestas recientes revelaron que el 61% de los equipos seguían dependiendo de comprobaciones manuales o validaciones basadas en SQL, el 27% utilizaba una plataforma de Observability dedicada y solo el 14% aplicaba acuerdos de nivel de servicio en toda la organización, mientras que el 39% realizaba un seguimiento de ellos. El informe de Integrate.io muestra por qué la implementación debe respetar los flujos de trabajo existentes en lugar de asumir que cada equipo puede reemplazar sus prácticas de validación de inmediato.
Asigne la propiedad antes de agregar alertas
El mismo informe reveló que la propiedad de la calidad de los datos se compartía entre varios equipos para el 44% de los encuestados, y la visibilidad limitada de la salud del pipeline era el principal desafío para el 31%. La responsabilidad compartida puede funcionar, pero solo cuando alguien es propietario de la decisión de investigar, publicar, suprimir o restaurar un resultado.
Priorice los controles por:
Impacto de la decisión: Monitoree primero los activos que influyen en las decisiones financieras, regulatorias, clínicas, operativas o de clientes.
Sensibilidad de los datos: Minimice los metadatos retenidos y mantenga el acceso alineado con los permisos existentes.
Costo de falla: Enrute las alertas de consecuencias graves a través de los canales de incidentes establecidos.
Ajuste operativo: Pruebe las comprobaciones durante la ingesta retrasada, dependencias degradadas y cambios de esquema.
No se comprometa con una promesa para toda la plataforma antes de probar el flujo de trabajo en un dominio crítico. La adopción modular permite a los equipos validar la calidad de la señal, la propiedad de las alertas y el costo operativo antes de ampliar la cobertura.
Construyendo un modelo operativo de confianza que se mantenga
Un programa de confianza duradero es un sistema operativo de ciclo cerrado, no una colección de alertas de monitoreo. Los equipos definen objetivos de nivel de servicio para la frescura, completitud, validez, compatibilidad de esquema y cobertura de linaje, luego conectan esos objetivos con propietarios designados, rutas de escalamiento y umbrales de impacto en el negocio.
La política de respuesta importa tanto como la detección. Una comprobación fallida podría bloquear la publicación downstream o la inferencia de IA, pero solo cuando los controles documentados justifiquen la interrupción. En otros casos, la organización puede preservar el último resultado confiable conocido, etiquetar la salida como obsoleta y otorgar al propietario una ventana definida para resolver el problema.
Convierta los incidentes en conocimiento institucional
Para cada incidente material, registre:
Causa: ¿Qué cambió en el origen, transformación, cronograma, esquema o ruta de acceso?
Impacto: ¿Qué tablas, métricas, paneles, características, modelos y decisiones se vieron afectados?
Respuesta: ¿Quién investigó, qué acción se tomó y con qué rapidez se recuperó el servicio?
Evidencia: ¿Qué resultados de validación y monitoreo confirmaron que los datos eran seguros para usar nuevamente?
Después de la recuperación, incorpore esos hallazgos nuevamente a las reglas de validación, la configuración de la línea base, los mapas de propiedad, las políticas de acceso y los backlogs de ingeniería. Una falla recurrente de Timeliness puede requerir un rediseño del cronograma. Un problema repetido de esquema puede requerir contratos de compatibilidad. La ambigüedad repetida en torno a una métrica puede requerir una definición semántica más sólida.
Review trust as a cross-functional practice
Los equipos de ingeniería de datos, analítica, governance, seguridad y las partes interesadas del negocio deben revisar juntos los cuadros de mando. Cada grupo ve un modo de falla diferente. Los ingenieros entienden el comportamiento del pipeline, los analistas entienden la interpretación, la seguridad entiende la exposición, el governance entiende la responsabilidad y los propietarios de negocio entienden las consecuencias de las decisiones.
Esta disciplina respalda los esfuerzos más amplios para desbloquear el valor del negocio con datos porque los datos confiables se convierten en una capacidad operativa en lugar de un subproducto no examinado. El objetivo no es eliminar cada anomalía. Es crear evidencia repetida de que la organización conoce sus datos, sabe quién es su propietario, sabe qué decisiones dependen de ellos y puede recuperarse cuando las condiciones cambian.
La confianza se gana cuando la misma evidencia respalda la misma decisión tanto en los días ordinarios como en los días de incidentes.
digna proporciona capacidades de calidad de datos y Observability en el entorno para monitorear anomalías, Timeliness, validación, cambios de esquema y comportamiento de datos históricos sin mover los datos de producción fuera del entorno del cliente. Visite digna para ver cómo su enfoque modular puede conectar las señales operativas con la preparación para la toma de decisiones para analítica e IA.


